
คำถามเก่าที่ยังไม่มีคำตอบสมบูรณ์: “งานนี้ควรอยู่ Edge หรือ Cloud”
ตลอดหลายปีที่ผ่านมา การตัดสินใจว่า “งานไหนควรประมวลผลที่ไหน” เป็นคำถามที่ได้คำตอบแบบ binary: ถ้าต้องการเร็วให้อยู่ Edge, ถ้าต้องการ scale ให้อยู่ Cloud แต่เมื่อโรงงานหนึ่งมีทั้ง Edge Computer หลายสิบเครื่อง, on-premise server และบัญชี cloud ผู้ให้บริการหลายราย คำถามไม่ได้เป็นสองทางเลือกอีกต่อไป และเกิดปัญหาใหม่: ภาระการดูแลระบบที่กระจัดกระจาย (distributed sprawl) และ Silo ของข้อมูลที่ย้ายระหว่างกันไม่ได้
แนวคิดที่ตอบโจทย์นี้ในช่วงหลายปีที่ผ่านมาคือ Cloud Continuum — มองทรัพยากรคอมพิวติ้งทั้งหมดขององค์กรเป็น “ช่วงสเปกตรัมต่อเนื่อง” จาก on-premise edge ถึง public cloud ที่เชื่อมถึงกันด้วยเครือข่ายซอฟต์แวร์ (SDN) และ 5G แทนที่จะเป็นกล่องแยกส่วน งาน (workload) สามารถถูกวาง (place) และย้าย (migrate) ตามนโยบาย เช่น latency, อธิปไตยของข้อมูล (sovereignty) และความทนทาน
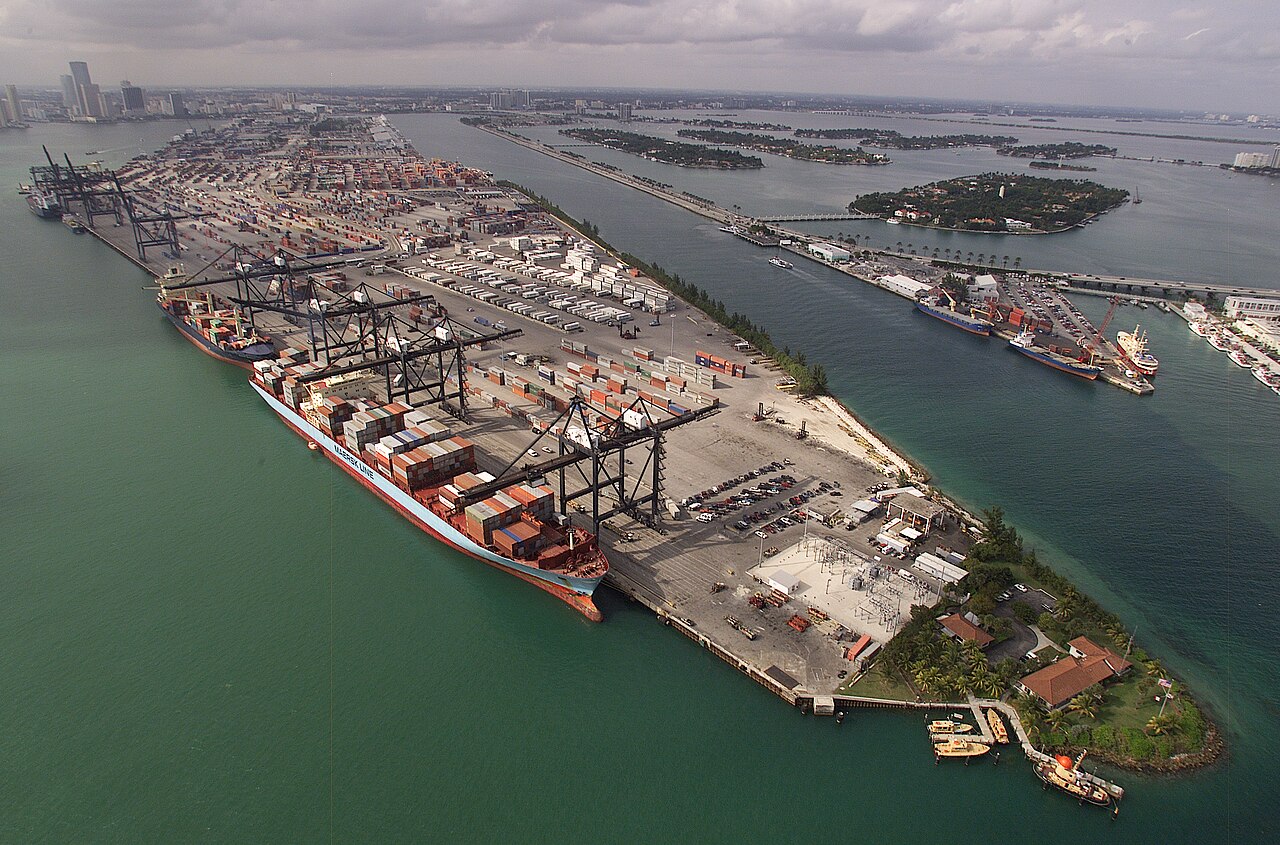
จาก “เลือกที่” สู่ “กำหนดนโยบาย”: วิธีคิดแบบ Continuum
จุดเปลี่ยนสำคัญของมุมมองแบบ continuum คือการเปลี่ยนจากคำถาม “งานนี้ควรอยู่ที่ไหน” เป็น “นโยบายอะไรกำหนดว่างานนี้ควรอยู่ที่ไหน” ตัวอย่างเช่น:
| นโยบาย | คำถามที่นโยบายตอบ | ผลลัพธ์ต่อการวางงาน |
|---|---|---|
| Latency ceiling | งานยอมรับ delay เกิน X ms ได้หรือไม่? | > 100 ms → ขึ้นคลาวด์ได้; < 10 ms → ต้องอยู่ edge/fog |
| Data gravity | ข้อมูลเกิดใหม่เร็วแค่ไหน และผู้บริโภคอยู่ไหน? | ข้อมูล 1 kHz ต้องกรองที่ edge ก่อนส่งต่อ — ส่ง raw ขึ้นคลาวด์ไม่คุ้มทั้งแบนด์วิดท์และค่าเก็บ |
| Sovereignty | ข้อมูลชุดนี้ออกนอกประเทศ/อาคารได้หรือไม่? | ข้อมูลละเอียดอ่อนต้องถูกประมวลผลและจัดเก็บในประเทศ |
| Resilience | ถ้า WAN ขาด งานนี้ต้องทำงานต่อได้หรือไม่? | งานที่โรงงานต้องผลิตต่อได้แม้เน็ตขาด → ต้องมี local fallback เสมอ |
ทำไมตอนนี้ถึงเป็นเวลาที่เหมาะสม: 3 แรงผลักดัน
1. ภาระการเชื่อมต่อระหว่างกล่องแยกส่วนสูงเกินไป — งานวิเคราะห์ของ Accenture ชี้ว่าองค์กรที่ใช้แนวคิด Cloud Continuum อย่างจริงจัง (Continuum Competitor) สามารถลดภาระการลงทุนด้านไอทีได้ 1.2–2.7 เท่า เมื่อเทียบกับธุรกิจที่ยังทำ cloud migration เป็นครั้งๆ และสร้างนวัตกรรมได้มากกว่า 2–3 เท่า
2. เครื่องมือ orchestration เพื่อการนี้เริ่มเป็นมาตรฐาน — โมเดลการจัดการแบบ declarative (GitOps) ที่ใช้ดูแล Kubernetes fleet ขยายมาถึง edge ทำให้ “นโยบาย” ถูกนิยามเป็นโค้ดที่ตรวจสอบได้ แทนความเข้าใจที่อยู่ในตัวผู้ดูแล
3. AI ทำให้ความแตกต่างระหว่างที่ตั้งสำคัญขึ้น — โมเดล AI ต้องการข้อมูลมหาศาล (อยู่คลาวด์คุ้ม) แต่การอนุมาน (inference) ที่ต้องตอบสนองเหตุการณ์บนสายการผลิตต้องอยู่ใกล้เครื่องจักร วัฏจักร “เทรนบนคลาวด์ อนุมานที่ edge” กลายเป็น pattern มาตรฐาน
มุมมองจากสนามจริง: ที่ซึ่ง continuum ชนกับพื้นโรงงาน
ในทางปฏิบัติ เราเห็นว่าโรงงานส่วนใหญ่ไม่ได้เริ่มจาก zero แต่มี “คอลเลกชันของยุคต่างๆ” — SCADA ยุค 2008, edge gateway ที่ติดตั้งปี 2022 และบัญชีคลาวด์ที่เพิ่งเปิดปีที่แล้ว ความท้าทายจึงไม่ใช่การออกแบบ continuum สวยงามบนกระดาษ แต่คือ การทำให้ของเก่าเข้าร่วม continuum ได้โดยไม่ต้องเปลี่ยนใหม่ทั้งหมด
ทีมงาน Honey Corporation มีประสบการณ์ทำงานกับโรงงานที่มีทั้งอุปกรณ์เก่าและระบบใหม่ปนกัน — เรามักเริ่มจากการทำ inventory ของ workload จริงก่อน แล้วค่อยๆ ย้ายเฉพาะงานที่ได้ประโยชน์ชัดเจนขึ้น continuum แทนการออกแบบสถาปัตยกรรมก่อนแล้วค่อยหางานมาใส่
แนวทางที่เราแนะนำคือเริ่มจาก 3 คำถามกับทุก workload: (1) latency ceiling เท่าไหร่ (2) ถ้า WAN ขาด งานนี้ต้องรอดไหม (3) ข้อมูลออกนอกอาคาร/ประเทศได้ไหม คำตอบสามข้อนี้จัดกลุ่ม workload ได้เกือบครบ และเป็นจุดเริ่มต้นของนโยบาย placement ที่เป็นรูปธรรม
Key Takeaways
- Cloud Continuum คือการมอง compute ทั้งองค์กรเป็นสเปกตรัมต่อเนื่อง ไม่ใช่กล่องแยกส่วน — งานถูกวางตามนโยบาย (latency, sovereignty, resilience) ไม่ใช่ตามความคุ้นเคย
- เปลี่ยนคำถามจาก “อยู่ที่ไหน” เป็น “นโยบายอะไรกำหนด” — นโยบายที่นิยามเป็นโค้ดตรวจสอบได้และเปลี่ยนได้เมื่อธุรกิจเปลี่ยน
- ผลกระทบที่วัดได้ — การวิเคราะห์ของ Accenture ระบุว่า Continuum Competitor ลดภาระด้านไอทีได้ 1.2–2.7 เท่า และสร้างนวัตกรรมได้ 2–3 เท่า
- Data gravity กำหนดรูปทรงของระบบ — ข้อมูล 1 kHz ต้องถูกกรองที่ edge ให้เหลือ features/events ก่อนขึ้นคลาวด์ ไม่ใช่ส่ง raw ทั้งก้อน
- เริ่มจาก workload inventory ไม่ใช่สถาปัตยกรรม — 3 คำถาม (latency ceiling, WAN-out survival, sovereignty) จัดกลุ่มงานได้เกือบครบทุกกรณีในโรงงานจริง
- โรงงานไทยส่วนใหญ่เป็น “คอลเลกชันหลายยุค” — แนวทางค่อยเป็นค่อยไปที่ดูแลของเก่าเข้าร่วมได้ มักได้ผลดีกว่า big-bang redesign
Honey Corporation พร้อมให้คำปรึกษา
ทีมงานของเรามีความเชี่ยวชาญด้านสถาปัตยกรรม Edge-to-Cloud และการวางระบบ IIoT พร้อมออกแบบและติดตั้งระบบให้เหมาะกับธุรกิจของคุณ
📞 โทร: 09-23242995 | อีเมล: support@honey.co.th
เว็บไซต์: www.honey.co.th