บทวิเคราะห์: Discrete Event Simulation — เครื่องมือหาคอขวดที่ถูกลืม ก่อนคุณซื้อเครื่องจักรเพิ่ม

บทวิเคราะห์: Discrete Event Simulation — เครื่องมือหาคอขวดที่ถูกลืม ก่อนคุณซื้อเครื่องจักรเพิ่ม

Article
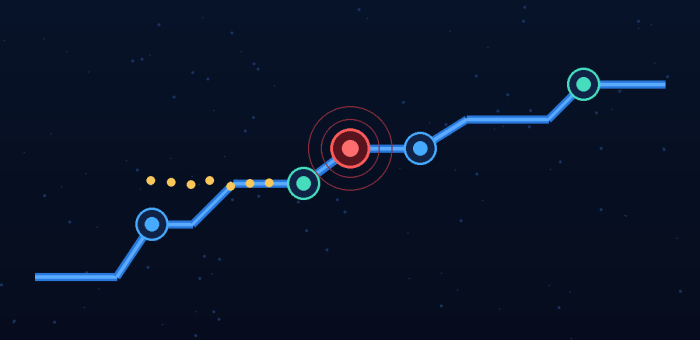
เมื่อ throughput ไม่ถึงเป้า คำตอบแรกของหลายโรงงานคือ "ซื้อเครื่องจักรเพิ่ม" แต่งานวิจัยนำเสนอที่งาน Winter Simulation Conference ปี 2025 จากโรงงานผลิตหม้อแปลงไฟฟ้าบอกเรื่องตรงข้าม: ทีมวิจัยใช้ Discrete Event Simulation (DES) จำลองไลน์ผลิตแล้วพบว่าการเพิ่มจำนวน workstation ไม่ได้ลด lead time ตามที่คาด เพราะคอขวดไม่ได้อยู่ที่จุดนั้น — สุดท้ายการเพิ่มเครื่องเฉพาะประเภทที่เป็นข้อจำกัดจริงเท่านั้นที่ลด lead time ได้ถึง 110 ชั่วโมง DES คืออะไร ในเมื่อมี Digital Twin แล้ว DES คือการจำลองระบบผลิตโดยมองว่าระบบเปลี่ยนสถานะเฉพาะเมื่อเกิด "เหตุการณ์" — ชิ้นงานมาถึง, เครื่องเสร็จงาน, เครื่องเสีย — ระหว่างเหตุการณ์ ระบบนิ่ง จึงข้ามเวลาไปยังเหตุการณ์ถัดไปได้เลย (next-event time advance) ผลคือจำลองการผลิตทั้งปีในไม่กี่นาที นี่คือความต่างสำคัญจาก Digital Twin แบบเรียลไทม์ที่ต้องเดินตามเวลาจริง: มิติ DES (จำลองอดีต-อนาคต) Digital Twin เรียลไทม์ การเดินของเวลากระโดดตามเหตุการณ์ จำลอง 1 ปีได้ในหลายนาทีเดินตามเวลาจริงหรือใกล้เคียง คำถามที่ตอบ"ถ้าเพิ่มเครื่อง 2 ตัว throughput จะเป็นเท่าไร""ตอนนี้เครื่องเบอร์ 3 สั่นผิดปกติไหม" ข้อมูลที่ต้องการการแจกแจงเวลา cycle/MTTR/MTBF จากอดีตการเชื่อมต่อข้อมูลสดจากเครื่องจักร ความสามารถพิเศษทดสอบสถานการณ์หลายร้อยแบบได้ก่อนลงทุนตรวจจับความผิดปกติ/ทำนายเหตุการณ์ขณะเกิด DES มองโรงงานเป็นลำดับเหตุการณ์ — ระหว่างเหตุการณ์ระบบนิ่ง จึงข้ามเวลาไปข้างหน้าได้อย่างรวดเร็ว (ภาพ: Honey Corporation) ทำไม DES ยังจำเป็นแม้มี AI ทุกหนแห่ง AI เก่งเรื่อง ทำนายจากข้อมูลที่เคยเกิด แต่อ่อนเรื่อง ตอบคำถามที่ไม่เคยเกิด — คุณไม่มีข้อมูลการเพิ่มเครื่อง CNC ตัวที่ 5 เพราะมันไม่เคยมีอยู่ DES ตอบโจทย์นี้ด้วยการสร้างโลกจำลองที่กายภาพของโรงงานถูกฝังอยู่ในสมการ งานวิจัยปี 2025 ใน International Journal of Advanced Manufacturing Technology ใช้ DES วิเคราะห์ไลน์ประกอบชิ้นส่วนอะลูมิเนียมแล้วลด WIP และ cycle time ลงได้พร้อมเพิ่ม throughput โดยไม่ต้องเพิ่มทรัพยากรใดๆ ส่วนงานวิจัยก่อนหน้าด้าน logistics คลังสินค้าลด throughput time ได้ 28% ด้วยการจัดระเบียบการไหลของวัสดุล้วนๆ…
Read More
Case Study: ซิงค์ Digital Twin กับเครื่องจักรจริงให้ทันใจ — ครั้งแรกที่โมเดลไม่ตามหลังความจริง

Case Study: ซิงค์ Digital Twin กับเครื่องจักรจริงให้ทันใจ — ครั้งแรกที่โมเดลไม่ตามหลังความจริง

Article
โรงงานส่วนใหญ่ที่เริ่มทำ Digital Twin วันนี้เจอปัญหาเดียวกัน: โมเดลสวยงาม แต่พอเปิดขึ้นมาดูตอนบ่ายสามโมง ข้อมูลที่เห็นเป็นของเมื่อสิบนาทีก่อน พอสถานะจริงเปลี่ยน โมเดลยังค้างอยู่ของเก่า ความเชื่อมั่นหายไปทั้งไลน์ บทความนี้เล่ากรณีศึกษาจากงานวิจัยจริงว่า "การซิงค์แบบเรียลไทม์" ทำได้จริงแค่ไหน และต้องแลกกับอะไร ปัญหา: Twin ที่ตามหลังความจริงไป 10 นาที ระบบ Digital Twin แบบดั้งเดิมใช้สถาปัตยกรรมแบบแบตช์ — เก็บข้อมูลจาก SCADA ทุก 5-15 นาที ส่งขึ้นคลาวด์ประมวลผล แล้วค่อยอัปเดตโมเดล งานวิจัยรีวิวปี 2026 ใน Applied System Innovation เรียกช่องว่างนี้ว่า prediction-action latency gap — ระยะห่างระหว่างเวลาที่โมเดลรู้ว่าจะเกิดอะไร กับเวลาที่การแก้ไขเกิดขึ้นจริงในโรงงาน ซึ่งในระบบแบบเดิมยาวถึง 28-120 นาที เพราะประกอบด้วย 4 ส่วน: การเก็บข้อมูลและซิงค์สถานะ 5-30 นาที, การที่คนต้องมาอ่านผล 10-45 นาที, การตัดสินใจและสั่งงานผ่าน DCS 5-30 นาที และเวลาที่กระบวนการทางกายภาพตอบสนอง 8-15 นาที วงจรซิงค์สถานะ: telemetry ไปทางเดียวไม่พอ — ต้องมี state estimator ชดเชยช่วงที่ข้อมูลขาดหาย และ feedback กลับเพื่อ closed-loop (ภาพ: Honey Corporation) ทางออกจากงานวิจัย: 3 ชั้นของการซิงค์ งานวิจัยล่าสุดแก้ปัญหานี้ด้วยสถาปัตยกรรม 3 ชั้น แยกตามหน่วงเวลาที่ต้องการ: ชั้น หน่วงเวลาเป้าหมาย กลไกซิงค์ ใช้ทำอะไร Field Sync1-10 msCyclic data ผ่าน Ethernet เรียลไทม์อุตสาหกรรม + acyclic event ผ่าน OPC UA A&Eควบคุม, interlock, HMI Aggregation50-200 msOPC UA Aggregation + MQTT broker (QoS 1) ที่ edge gatewayมอนิเตอร์ทั้งเซลล์, แจ้งเตือน Twin RuntimeEvent-drivenSimulation engine + state estimation รับ snapshot เมื่อมีเหตุการณ์What-if, ทำนาย, วางแผน หลักการสำคัญ:…
Read More
How-to: รวม Digital Twin หลายตัวให้คุยกันได้ — Federated Twin ตาม ISO 23247-6 ใน 6 ขั้นตอน

How-to: รวม Digital Twin หลายตัวให้คุยกันได้ — Federated Twin ตาม ISO 23247-6 ใน 6 ขั้นตอน

Article
โรงงานที่ทำ Digital Twin มาสักพักมักเจอภาพนี้: ฝ่ายผลิตมี Twin ของเครื่องจักร, ฝ่ายคลังมี Twin ของระบบวางแผนสินค้าคงคลัง, ฝ่ายซ่อมบำรุงมี Twin อีกตัว — ทุกตัวเก่งในโลกของตัวเอง แต่ไม่มีตัวไหนตอบได้ว่า "ถ้าเครื่อง CNC 2 ตัวลงพร้อมกันพรุ่งนี้ ใบสั่งผลิตชุดไหนจะช้ากว่ากำหนด" คำตอบของปัญหานี้คือ Federated Digital Twin — การประกอบ Twin หลายตัวเข้าด้วยกันโดยไม่ต้องรื้อทุกอย่างมาสร้างใหม่ มาตรฐานที่ต้องรู้: ISO 23247-6 ส่วนที่ 6 ของมาตรฐาน ISO 23247 (Digital twin framework for manufacturing) นิยามกระบวนการ Digital Twin Composition (DTC) — การรวม Twin หลายตัวเป็น Twin ที่ซับซ้อนกว่า โดยแบ่งเป็น 2 แนวทางหลัก: Integrated DTC — รวมเป็น Twin เดียวแบบรวมศูนย์ มี entity กลางคอยจัดการการแลกเปลี่ยนข้อมูล Federated DTC — Twin แต่ละตัวโต้ตอบกันแบบ peer-to-peer โดยไม่มีศูนย์กลางควบคุม แต่ละตัวขอ-ให้บริการและข้อมูลซึ่งกันและกันได้โดยตรง ยังรักษาฟอร์แมตของตัวเองไว้ และมี control logic กระจายอยู่ทั้งเครือข่าย Federated DTC: Twin แต่ละตัวเก็บฟอร์แมตเดิมไว้ คุยกันผ่าน Federation Layer ที่ทำ semantic mapping (ภาพ: Honey Corporation) แนวตั้งหรือแนวนอน — เลือกให้ถูกโครงสร้าง งานวิจัยจาก University of Antwerp ปี 2025 แบ่งสถาปัตยกรรมการรวม Twin เป็น 2 รูปแบบ ซึ่งเลือกต่างกันตามโครงสร้างอำนาจในองค์กร: มิติ Vertical Federation Horizontal Federation โครงสร้างลำดับชั้นบังคับบัญชา (hierarchical) ตาม ISA-95แบน แบบ peer-to-peer ไม่มีเจ้าของกลาง ความเป็นอิสระTwin ระดับบนต้องมี Twin ระดับล่างอยู่ครบTwin แต่ละตัวอยู่ได้แม้ตัวอื่นออฟไลน์ ความเป็นส่วนตัวของข้อมูลต่ำ — ข้อมูลไหลขึ้นเกือบหมดสูง — บางกระบวนการภายใน opaque ต่อกันได้…
Read More
บทวิเคราะห์: ซื้อฮาร์ดแวร์ Edge อย่างไรไม่ให้เสียใจภายหลัง — 5 หมวดที่ต้องประเมินก่อนเซ็น PO

บทวิเคราะห์: ซื้อฮาร์ดแวร์ Edge อย่างไรไม่ให้เสียใจภายหลัง — 5 หมวดที่ต้องประเมินก่อนเซ็น PO

Article
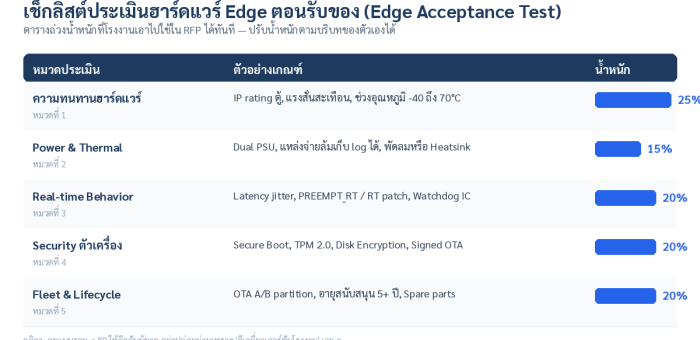
ทุกครั้งที่โรงงานไทยจะเริ่มโปรเจกต์ Edge Computing มีหนึ่งจุดที่แทบทุกแห่งตกหลุมพรางเดียวกัน: ซื้อฮาร์ดแวร์ก่อน คิดสถาปัตยกรรมทีหลัง ผลคือเครื่อง edge ที่ spec เกินความจำเป็นแต่ทนสภาพหน้างานไม่ได้ หรือแย่กว่านั้น — เครื่องที่ "ใช้ได้ในห้อง server" แต่ล้มในตู้คอนโทรลที่อุณหภูมิ 45°C ภายในสามเดือน บทความนี้คือสิ่งที่เราอยากให้ทุกฝ่ายจัดซื้ออ่านก่อนเซ็น PO ทำไม "คอมพิวเตอร์ธรรมดา" ถึงไม่รอดในโรงงาน ตู้คอนโทรลในโรงงานไม่ใช่ห้อง server มันคือสภาพแวดล้อมที่มีทั้งฝุ่น ความชื้น แรงสั่นสะเทือนจากมอเตอร์และคอมเพรสเซอร์ ไฟกระชากจากการสตาร์ทเครื่องจักรหนัก และสัญญาณรบกวน EMI จาก VFD ฮาร์ดแวร์ edge ที่ออกแบบมาสำหรับสภาพนี้ต้องผ่านการรับรองหลายด้านที่คอมพิวเตอร์สำนักงานไม่เคยถูกทดสอบ ไทม์ไลน์เหตุการณ์จริงที่พบบ่อยในอุตสาหกรรม: พัดลมเสีย → thermal throttle → silent failure → ข้อมูล QC ขาดช่วง 43 นาที (ที่มา: Honey Corporation) 5 หมวดที่ต้องประเมินก่อนเซ็นสัญญา 1. ความทนทานฮาร์ดแวร์ (Hardware Durability) เช็คช่วงอุณหภูมิทำงาน (อุตสาหกรรมจริงควรได้ -40 ถึง 70°C ไม่ใช่แค่ 0-50°C), แรงสั่นสะเทือนและแรงกระแทกตามมาตรฐานทดสอบ, การกันน้ำและฝุ่นตามระดับ IP rating ที่เหมาะกับจุดติดตั้ง และ connector แบบ lock ที่ไม่หลุดเมื่อตู้สั่น 2. Power และ Thermal คำถามที่ควรถามผู้ขายเสมอ: "ถ้าไฟดับตอนเครื่องกำลังเขียนข้อมูลลงดิสก์ จะเกิดอะไรขึ้น?" ฮาร์ดแวร์ระดับอุตสาหกรรมควรมี dual power supply, วงจรที่จ่ายไฟต่อให้เพียงพอให้ flush ข้อมูลและเขียน log ก่อนดับ และระบบระบายความร้อนที่ไม่มีพัดลมก็ยังทำงานได้ (fanless heatsink design) หรือมีพัดลมที่เปลี่ยนได้โดยไม่ต้องปิดเครื่อง 3. พฤติกรรม Real-time ถ้า edge ของคุณจะทำงานที่ใกล้ชิดกับลูปควบคุม ค่า latency jitter สำคัญกว่าค่าเฉลี่ย — ระบบปฏิบัติการทั่วไปอาจมี pause ของ scheduler นับสิบมิลลิวินาทีเป็นครั้งคราว ซึ่งไม่เป็นไรกับ dashboard แต่ทำลายงานที่ต้องตอบสนองสม่ำเสมอ ให้ถามหาการรองรับ real-time kernel patch และ watchdog IC ที่รีเซ็ตเครื่องอัตโนมัติเมื่อ software ค้าง 4. Security ระดับตัวเครื่อง…
Read More
How-to: ออกแบบ Edge Data Historian — จาก RAM Buffer ถึง Cloud Lakehouse โดยไม่ทำข้อมูลหาย

How-to: ออกแบบ Edge Data Historian — จาก RAM Buffer ถึง Cloud Lakehouse โดยไม่ทำข้อมูลหาย

Article
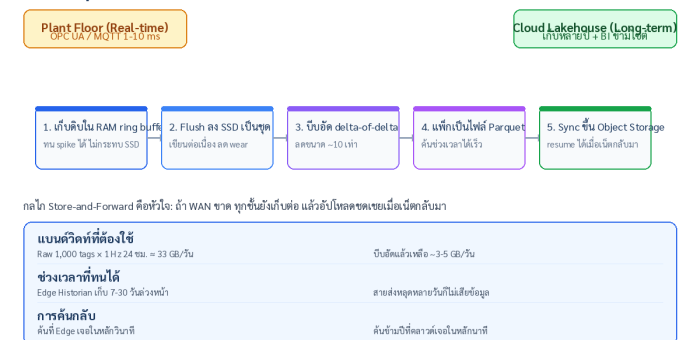
คำถามที่ดูเหมือนง่ายแต่เจ็บจริงของทุกโปรเจกต์ IIoT คือ "ข้อมูลที่เก็บมาทั้งหมดนี้ ตกลงจะเก็บไว้ที่ไหน และเก็บนานแค่ไหน?" — คำตอบที่ผิดนำไปสู่สองปลายทางเดียวกัน: ซื้อ storage ระดับ enterprise เกินจำเป็นจนงบบานปลาย หรือลบข้อมูลเก่าทิ้งแล้วเจอการตรวจสอบย้อนหลังหลังจากนั้นหกเดือน บทความนี้เดินไปทีละขั้นตามเส้นทางของข้อมูลหนึ่งจุดวัด ตั้งแต่หน้างานจนถึงคลาวด์ ขั้นที่ 1: ข้อมูลเกิดที่หน้างาน 1,000 ครั้งต่อวินาที เริ่มจากคณิตศาสตร์ง่าย ๆ: โรงงานขนาดกลางที่มี 1,000 tags × 1 Hz (เช่น อุณหภูมิ ความดัน รอบมอเตอร์) จะผลิตข้อมูลดิบประมาณ 86.4 ล้านจุดต่อวัน ถ้าเก็บเป็น JSON ตรง ๆ ขนาดจะบวมถึง ~33 GB ต่อวัน — นี่คือเหตุผลที่ทุก pipeline จริงจำเป็นต้องมีทั้งการกรองและการบีบอัดตั้งแต่ต้นทาง เส้นทางข้อมูลจาก Plant Floor ถึง Cloud Lakehouse — แต่ละขั้นมีหน้าที่ลดปริมาณและเพิ่มความทนทานต่อการขาดเน็ต (ที่มา: Honey Corporation) ขั้นที่ 2: RAM Ring Buffer — ด่านแรกที่ทุกคนมองข้าม เมื่อข้อมูลไหลเข้า edge gateway จุดแรกที่มันจอดไม่ใช่ดิสก์ แต่เป็น RAM ring buffer เหตุผลคือความเร็ว: การเขียน SSD ทุกครั้งที่ข้อมูลมาถึงจะทำให้ SSD สึกเร็วผิดปกติ (write amplification) และทำให้ระบบรับ spike ของข้อมูลไม่ไหว รูปแบบที่ใช้กันคือเก็บใน RAM ก่อน 30-120 วินาที แล้วค่อย flush เป็นชุด (batch) ลง SSD ขั้นที่ 3: บีบอัดด้วย Delta-of-Delta เทคนิคที่ทำให้ time-series ของโรงงานบีบได้มากกว่าที่คิดคือการเก็บ "ผลต่างของผลต่าง" (delta-of-delta encoding) — เพราะค่าอุณหภูมิส่วนใหญ่ไม่เปลี่ยนระหว่างการ sample สองครั้งติดกัน การเก็บเป็น "เท่ากับครั้งก่อน" ใช้พื้นที่น้อยกว่าเก็บค่าเต็มหลายเท่า ในทางปฏิบัติ pipeline ของโรงงานส่วนใหญ่บีบจาก 33 GB/วัน เหลือ ~3-5 GB/วัน ก่อนส่งขึ้นคลาวด์ ขั้นที่ 4: แพ็กเป็นไฟล์ Parquet แล้ว Sync ขึ้น Object…
Read More
Edge 3 ชั้นสำหรับโรงงาน IIoT: ออกแบบสถาปัตยกรรมตามลำดับชั้นหน่วงเวลา (Latency Hierarchy)

Edge 3 ชั้นสำหรับโรงงาน IIoT: ออกแบบสถาปัตยกรรมตามลำดับชั้นหน่วงเวลา (Latency Hierarchy)

Article
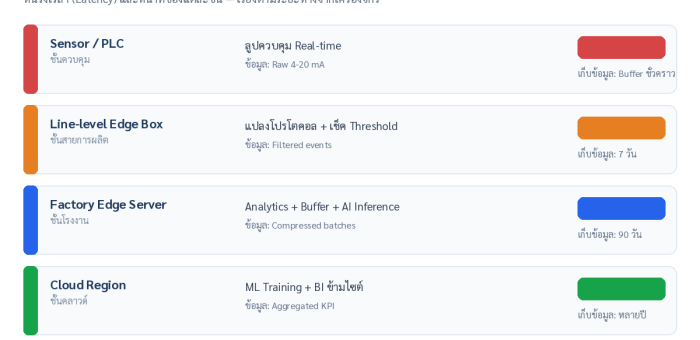
หลายโรงงานที่เริ่มทำ IIoT มักเจอคำถามเดียวกันในวันแรกของโปรเจกต์: "ข้อมูลควรส่งขึ้นคลาวด์ทั้งหมดเลย หรือเก็บไว้ประมวลผลในโรงงานก่อน?" คำตอบที่ถูกต้องในปี 2026 ไม่ใช่อย่างใดอย่างหนึ่ง — แต่คือการออกแบบสถาปัตยกรรมแบบหลายชั้น (Multi-tier) ที่ให้แต่ละงานวิ่งลงมาอยู่ใกล้แหล่งข้อมูลมากที่สุดเท่าที่ความจำเป็นของงานนั้นต้องการ แนวคิดนี้มีชื่อเรียกหลายชื่อ — Edge Continuum, Cloud Continuum หรือ Computing Continuum — แต่แก่นคือเรื่องเดียว: ลำดับชั้นของหน่วงเวลา (Latency Hierarchy) ที่กำหนดว่างานแบบไหนควรจบที่ไหน บันไดหน่วงเวลาแบบมาตราส่วน log — PLC ตอบที่ ~1 ms ส่วนคลาวด์ผ่าน WAN อยู่ที่ ~45 ms พร้อม jitter ที่สูงกว่ามาก (ที่มา: Honey Corporation) ลำดับชั้นหน่วงเวลา: งานไหนควรจบที่ชั้นไหน ลองนึกภาพข้อมูลจากเซ็นเซอร์อุณหภูมิตัวเดียวที่ถูก sample ทุก 100 ms ถ้าโรงงานมี 1,000 tags เท่ากัน จะมีข้อมูลดิบไหลเข้าระบบประมาณ 10,000 จุดต่อวินาที การส่งขึ้นคลาวด์ทั้งหมดไม่ใช่แค่เรื่องค่าแบนด์วิดท์ แต่คือการเพิ่มหน่วงเวลา 30-60 ms ให้กับทุกการตัดสินใจ ทั้งที่บางการตัดสินใจต้องการคำตอบใน 5 ms สถาปัตยกรรม Edge 3 ชั้น — ยิ่งอยู่ใกล้เครื่องจักร หน่วงเวลายิ่งต่ำ แต่ความสามารถเชิงคำนวณและระยะเก็บข้อมูลยิ่งจำกัด (ที่มา: Honey Corporation) ชั้นที่ 1: กล่อง Edge ระดับสายการผลิต (Line-level Edge Box) อุปกรณ์ขนาดเล็กที่ติดตั้งในตู้คอนโทรลของแต่ละสายการผลิต หน้าที่หลักคือการแปลงโปรโตคอล (เช่น Modbus TCP, PROFINET → OPC UA หรือ MQTT), กรองข้อมูลดิบให้เหลือเฉพาะ event ที่มีความหมาย และตรวจ threshold แบบ local หน่วงเวลาอยู่ในระดับ 1-5 ms ซึ่งเพียงพอสำหรับงาน monitoring แบบเรียลไทม์ที่ไม่ใช่ลูปควบคุม ชั้นที่ 2: Edge Server ระดับโรงงาน (Factory Edge Server) เซิร์ฟเวอร์ที่รวบข้อมูลจากทุก line-level box ในโรงงาน ทำหน้าที่หนักกว่า: aggregation, buffering ระยะ 7-90 วัน, และเป็นที่รัน AI…
Read More
บทวิเคราะห์: ตลาด Smart Manufacturing 2025–2030 — เมื่อเงินไหลจากฮาร์ดแวร์ไป AI

บทวิเคราะห์: ตลาด Smart Manufacturing 2025–2030 — เมื่อเงินไหลจากฮาร์ดแวร์ไป AI

Article
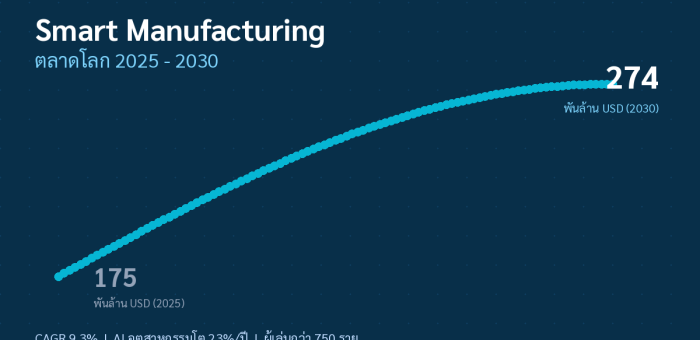
มุมมองจากงานแสดงสินค้า: เมื่อ "ป้าย Smart Factory" ไม่ใช่จุดขายอีกต่อไป ปลายเดือนตุลาคมที่ผ่านมา งาน Smart Manufacturing 2026 ที่กรุงเทพฯ ปิดฉากลงด้วยบรรยากาศที่ต่างจากทุกปีที่ผ่านมา — ทุกบูธพูดเรื่องเดียวกันแต่ต่างคนต่างพูด: AI ที่ลงมือทำงานได้จริงบนพื้นโรงงาน ไม่ใช่ AI ในสไลด์นำเสนอ ปรากฏการณ์นี้สอดคล้องกับข้อมูลตลาดล่าสุดจากรายงาน Industry 4.0 & Smart Manufacturing Market Report 2026–2030 ของ IoT Analytics ที่ระบุว่าตลาดเทคโนโลยีการผลิตอัจฉริยะทั่วโลกในปี 2025 มีมูลค่า 175 พันล้านดอลลาร์สหรัฐ และจะเติบโตเฉลี่ย 9.3% ต่อปี (CAGR) จนแตะ 274 พันล้านดอลลาร์ในปี 2030 โดยมีผู้เล่นในตลาดมากกว่า 750 ราย ตัวเลขนี้บอกอะไรมากกว่าที่เห็น เพราะเบื้องหลังอัตราการเติบโตที่ดู "เฉยๆ" คือการเปลี่ยนองค์ประกอบภายในตลาดอย่างรุนแรง — เงินกำลังไหลจากฮาร์ดแวร์ไปสู่ซอฟต์แวร์และ AI ผู้นำตลาด 10 อันดับแรกต่างเร่งเปลี่ยนตัวเองจากบริษัทขายเครื่องจักร ไปสู่สถาปัตยกรรมที่ขับเคลื่อนด้วยซอฟต์แวร์และผสาน AI (Software-defined, AI-infused architectures) ซึ่งเป็นการปรับตัวครั้งใหญ่ที่สุดของอุตสาหกรรมระบบอัตโนมัติตั้งแต่ยุค PLC ถือกำเนิด ตลาด Smart Manufacturing โลกเติบโตจาก 175 พันล้านดอลลาร์ (2025) สู่ 274 พันล้านดอลลาร์ (2030) ที่ CAGR 9.3% — ค่าเฉลี่ยที่ดูเรียบ แต่ซ่อนการเปลี่ยนโครงสร้างจากฮาร์ดแวร์สู่ซอฟต์แวร์และ AI (ที่มา: IoT Analytics, Industry 4.0 & Smart Manufacturing Market Report 2026–2030) 5 แรงกดดันที่ทำให้โรงงาน "ต้อง" ลงทุน ไม่ใช่ "อยาก" ลงทุน สิ่งที่น่าสนใจจากรายงานคือรายการแรงขับเคลื่อน — ไม่มีข้อไหนเป็นเรื่องเทคโนโลยีเลย ทั้งหมดเป็นแรงกดดันเชิงธุรกิจที่บีบให้ผู้ผลิตต้องลงมือ: ต้นทุนที่สูงขึ้นทุกด้าน: ค่าแรง พลังงาน และวัตถุดิบพุ่งพร้อมกัน เทคโนโลยีจึงกลายเป็นเครื่องมือเพิ่มประสิทธิภาพและลดความสูญเสีย ไม่ใช่ของตกแต่ง ภูมิรัฐศาสตร์และการย้ายฐานผลิต: กระแส Reshoring ผลักการผลิตกลับไปยังพื้นที่ต้นทุนสูง ระบบอัตโนมัติจึงเป็นคำตอบชดเชยแรงงานที่หายไป วิกฤตแรงงานเรื้อรัง: การขาดแคลนแรงงานทักษะและโครงสร้างประชากรที่สูงวัย บังคับให้เทคโนโลยีทำงานร่วมกับคนหรือทดแทนช่องว่าง โครงสร้างพื้นฐานที่พร้อมแล้วจริง: Edge Computing และ Cloud เสถียรพอที่การเชื่อม OT เข้ากับ IT ไม่ใช่โครงการเสี่ยงระเบิดเวลาอีกต่อไป…
Read More
How-to: เตรียมข้อมูลเครื่องจักรให้พร้อมสำหรับ Industrial AI ใน 6 ขั้นตอน — ก่อน AI ต้องมีข้อมูล

How-to: เตรียมข้อมูลเครื่องจักรให้พร้อมสำหรับ Industrial AI ใน 6 ขั้นตอน — ก่อน AI ต้องมีข้อมูล

Article
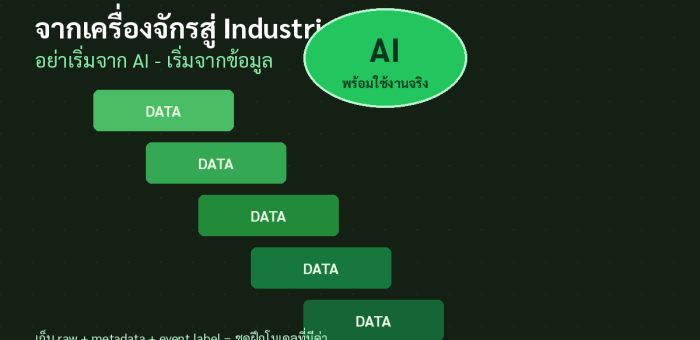
ทำไมโครงการ AI ในโรงงานถึงตายก่อนถึงไลน์ผลิต คำถามที่เราได้ยินบ่อยที่สุดจากผู้บริหารโรงงานช่วงหลังนี้คือ "อยากใช้ AI ในโรงงาน แต่ควรเริ่มจากตรงไหน" — และคำตอบที่หลายคนไม่อยากได้ยินคือ อย่าเริ่มจาก AI เริ่มจากข้อมูล รายงานล่าสุดของ IoT Analytics ระบุว่าตลาด Industrial AI จะเติบโตจาก 43.6 พันล้านดอลลาร์ (2024) สู่ 153.9 พันล้านดอลลาร์ในปี 2030 ที่ CAGR 23% แต่ปัจจุบันการใช้จ่าย AI ในภาคผลิตยังคิดเป็นเพียง 0.1% ของรายได้ สาเหตุใหญ่ไม่ใช่ AI ไม่เก่งพอ แต่คือโรงงานส่วนใหญ่ยังไม่มีข้อมูลที่ "ใช้เพื่อฝึกและใช้งาน AI ได้จริง" งานนำร่อง AI ที่ล้มเหลวมักมีร่องรอยเดียวกัน: ทีมพัฒนาได้รับไฟล์ Excel ที่ส่งออกจาก SCADA ทีละเดือน ข้อมูลขาดหายเป็นช่วงๆ เซ็นเซอร์บางตัวเซ็นสเกลผิด ไม่มีใครรู้ว่าหน่วยเป็นอะไร และไม่มีเหตุการณ์ปัญหาที่ติดแท็กไว้ให้โมเดลเรียนรู้ โมเดลที่ดีที่สุดก็ช่วยไม่ได้เมื่อข้อมูลตั้งต้นเป็นเช่นนั้น — นี่คือเหตุผลที่คู่มือนี้มุ่งเน้นเรื่องเดียว: วางรากฐานข้อมูลให้ถูกต้องก่อน AI ลงมือ เส้นทาง 6 ขั้นตอนจากเครื่องจักรถึง Industrial AI — งาน 70% อยู่ใน 3 ขั้นตอนแรกที่ไม่มีใครเห็น ไม่ใช่ตัวโมเดล (ที่มา: สังเคราะห์โดย Honey Corporation) ขั้นที่ 1–2: คัดเลือก Use Case ที่คุ้มค่า แล้วสำรวจข้อมูลที่มีอยู่จริง ขั้นที่ 1 — เลือก use case จากความเจ็บปวดทางธุรกิจ ไม่ใช่จากเทคโนโลยี: จงนึกถึงปัญหาที่เกิดซ้ำและแพงที่สุด เช่น เครื่องจักรหลักเสียกะทันหัน ของเสียจากกระบวนการอบ หรือการเปลี่ยนได้ช้ากว่าแผน ให้เลือก 1 ปัญหาที่มีเหตุการณ์เกิดขึ้นอย่างน้อยเดือนละ 2–3 ครั้ง เพราะโมเดลต้องการตัวอย่างเหตุการณ์พอสมควร จากนั้นคำนวณค่าใช้จ่ายที่เกิดจริงต่อเหตุการณ์ (ค่าหยุดไลน์ ค่าของเสีย) เพื่อเป็นตัวชี้วัดว่าโครงการจะคุ้มหรือไม่ ขั้นที่ 2 — ทำ Data Audit อย่างซื่อสัตย์: ระบุว่าปัจจุบันมีสัญญาณใดบ้างที่เก็บแล้วจริง เก็บที่ไหน (SCADA, Historian, PLC, กระดาษบันทึก) ความถี่เท่าไร และอยู่ได้นานแค่ไหน ตารางด้านล่างคือเกณฑ์เบื้องต้นที่ใช้ประเมินความพร้อมของแต่ละสัญญาณ: ระดับความพร้อมสภาพข้อมูลจริงสิ่งที่ต้องทำต่อ ระดับ 0 — กระดาษบันทึกยามเขียนมือทุก 2 ชั่วโมง สแกนเก็บเป็น…
Read More
Case Study: หุ่นยนต์ 3 ค่ายที่ไม่คุยกัน — ISO 21423:2026 ปลดล็อก Interoperability ของ IMR อย่างไร

Case Study: หุ่นยนต์ 3 ค่ายที่ไม่คุยกัน — ISO 21423:2026 ปลดล็อก Interoperability ของ IMR อย่างไร

Article
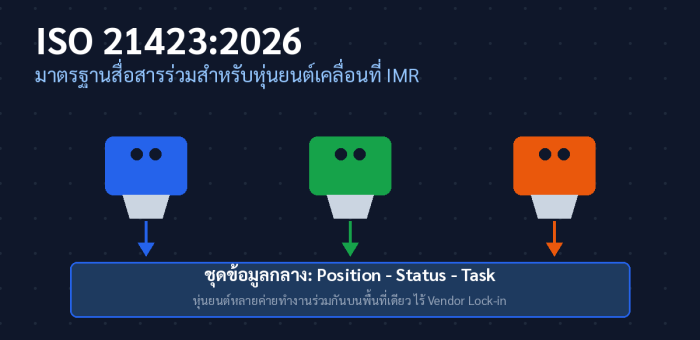
ตอนเปิดโรงงานวันจันทร์: หุ่นยนต์ 3 ค่ายที่ไม่คุยกัน สมมติสถานการณ์ที่เกิดขึ้นจริงในโรงงานประกอบอิเล็กทรอนิกส์แห่งหนึ่ง ที่ลงทุนหุ่นยนต์เคลื่อนที่ (IMR – Industrial Mobile Robot) มา 3 รุ่นจาก 3 ผู้ผลิต ช่วง 4 ปีที่ผ่านมา — ชุดแรกดูแลขนวัตถุดิบจากคลังไปไลน์ SMT ชุดที่สองลำเลียงชิ้นงานกึ่งสำเร็จรูประหว่างไลน์ และชุดที่สามดูแลโซนบรรจุภัณฑ์ แต่ละชุดมาพร้อมซอฟต์แวร์บริหารกองหุ่นยนต์ (Fleet Management System) ของตัวเอง แยกแผนที่ แยกระบบพิกัด แยกหน้าจอควบคุม ผลลัพธ์ที่ได้คือระบบที่ "ใช้งานได้แต่ไม่มีวันคุยกัน" — เมื่อหุ่นยนต์ค่าย A วิ่งผ่านทางเดียวกับค่าย B ทั้งสองฝ่ายเห็นกันเป็นเพียง "สิ่งกีดขวางไม่รู้จัก" ต้องหยุดรอให้อีกฝ่ายเคลื่อนที่ หรือเลี่ยงเป็นวงกว้างโดยไม่จำเป็น ทางเดินที่ออกแบบไว้กว้างพอสำหรับจราจรสองทาง กลายเป็นทางตันเพราะไม่มีกลไกเจรจาลำดับการส่งผ่าน พนักงานยังต้องนั่งจอทั้ง 3 จอเพื่อออกคำสั่งงานทีละระบบ และทุกครั้งที่ต้องการเพิ่มหุ่นยนต์ ทีมไอทีต้องเขียน custom middleware เชื่อมระบบใหม่ทั้งหมดอีกครั้ง นี่คือ "Vendor Lock-in แบบไม่ตั้งใจ" — โรงงานไม่ได้ถูกบังคับ แต่ถูกผูกมัดด้วยความไม่เข้ากันได้ของระบบสื่อสารที่ไม่มีมาตรฐานกลาง ISO 21423:2026 — มาตรฐานกลางที่อุตสาหกรรมรอคอย ต้นเดือนพฤศจิกายน 2026 องค์กร Association for Advancing Automation (A3) ประกาศเปิดตัวมาตรฐานสากลฉบับใหม่ ISO 21423:2026 พัฒนาโดยคณะกรรมการ ISO Technical Committee 299 เพื่อกำหนดข้อกำหนดด้านการสื่อสารร่วมกันระหว่างหุ่นยนต์เคลื่อนที่ ระบบบริหารกองหุ่นยนต์ และอุปกรณ์อื่นในสภาพแวดล้อมอุตสาหกรรม นี่คือครั้งแรกที่อุตสาหกรรมมี "ภาษากลาง" สำหรับการแลกเปลี่ยนข้อมูลระหว่างหุ่นยนต์ต่างผู้ผลิตบนพื้นที่เดียวกันอย่างเป็นทางการ สถาปัตยกรรมการสื่อสารตามมาตรฐาน ISO 21423:2026 — หุ่นยนต์ IMR ทุกค่าย ระบบ Fleet Management และอุปกรณ์โครงสร้างพื้นฐาน (ลิฟต์ ประตูอัตโนมัติ เครื่องจักร) สื่อสารผ่านชุดข้อมูลกลางแบบเดียวกัน (ที่มา: สังเคราะห์โดย Honey Corporation) ชุดข้อมูลกลางที่มาตรฐานกำหนด หัวใจของ ISO 21423 คือการกำหนดกรอบการแลกเปลี่ยนข้อมูลและคำสั่งปฏิบัติการครอบคลุม 3 กลุ่มหลัก: ข้อมูลพิกัดและทิศทาง (Position & Motion): ตำแหน่งปัจจุบัน ความเร็ว และทิศทางการเคลื่อนที่ — ทำให้หุ่นยนต์ทุกตัว "เห็น" เพื่อนต่างค่ายแบบ real-time ไม่ใช่สิ่งกีดขวางนามธรรม สถานะการทำงาน (Status): ความพร้อมของอุปกรณ์และสภาวะปฏิบัติงาน — Fleet…
Read More
How-to: สร้าง OT Detection Lab ด้วย MITRE ATT&CK for ICS v20 — จาก Log ดิบสู่ Use Case แรกใน 5 ขั้นตอน

How-to: สร้าง OT Detection Lab ด้วย MITRE ATT&CK for ICS v20 — จาก Log ดิบสู่ Use Case แรกใน 5 ขั้นตอน

Article
สัปดาห์ก่อนเราคุยกับวิศวกรของโรงงานประกอบชิ้นส่วนแห่งหนึ่งเรื่องระบบตรวจจับการโจมตี เขาพูดประโยคที่เราเจอบ่อยมาก: "เรามี SIEM แล้ว แต่ไม่รู้ว่าจะเขียน rule อะไรลงไป" นี่คือช่องว่างที่แท้จริงของ OT Security ในประเทศไทย — ไม่ใช่การขาดเครื่องมือ แต่คือการขาด "คำถามที่ถูกต้อง" ที่จะถามกับ log ที่มีอยู่ ข่าวดีคือเมื่อวันที่ 13 ตุลาคม 2026 MITRE ปล่อย ATT&CK v20 ซึ่งโดเมน ICS (Industrial Control Systems) ได้ข้อมูลใหม่ที่เป็นประโยชน์กับโรงงานไทยอย่างมาก: ตอนนี้มีถึง 106 Detection Strategies และ 302 Analytics พร้อมบริบทแพลตฟอร์มและ Asset ชัดเจน — แปลว่านี่คือจุดเริ่มต้นที่ดีที่สุดที่เคยมีมาสำหรับการสร้าง Use Case ตรวจจับการโจมตีที่เจาะจงกับระบบควบคุมของเราเอง การเดินทางของการโจมตีตามโดเมน ICS ของ MITRE ATT&CK v20 — 12 tactics และ 78 techniques (ภาพ: Honey Corporation) ขั้นที่ 1: เลือกเทคนิคที่ "เป็นไปได้จริง" กับโรงงานคุณ ความผิดพลาดที่พบบ่อยที่สุดของทีมที่เพิ่งเริ่ม คือพยายามเขียน rule ครบทุก technique ในเมทริกซ์ 78 ข้อ — แล้วเลิกกลางทาง ให้เริ่มจาก 3-5 เทคนิคที่ตรงกับช่องทางที่โรงงานคุณมีจริง: ถ้ามีช่องทาง remote สำหรับผู้รับเหมา: T0886 Remote Services — ตรวจจับการเชื่อมต่อจาก IP ที่ไม่ใช่ของทีมภายใน ถ้า HMI เป็น Windows: T0853 Scripting — ตรวจ process ที่ไม่ควรมีบนเครื่อง Engineering ถ้าใช้ Modbus TCP: T0855 Unauthorized Command Message — ตรวจ Master ID ที่ไม่อยู่ใน whitelist ถ้ามี Setpoint สำคัญต่อคุณภาพผลิตภัณฑ์: T0831 Manipulation of Control — ตรวจการเปลี่ยนแปลงค่าที่ผิดจังหวะ ขั้นที่ 2: ถามคำถามเดียวที่สำคัญ — "อะไรบอกเราว่ามันเกิดขึ้น?" Detection…
Read More