บทวิเคราะห์: Zero Trust ในโรงงาน — เชื่อใจน้อยลง เดินตรวจมากขึ้น อ่าน NIST SP 800-207 ใหม่ให้เป็นของวิศวกร OT

บทวิเคราะห์: Zero Trust ในโรงงาน — เชื่อใจน้อยลง เดินตรวจมากขึ้น อ่าน NIST SP 800-207 ใหม่ให้เป็นของวิศวกร OT

Article
เมื่อเร็วๆ นี้เราได้รับคำถามจากผู้บริหารโรงงานเครื่องจักรแห่งหนึ่ง: "Zero Trust ที่ทุกคนพูดถึงน่ะ เราโรงงานทำได้จริงหรือ เพราะไอทีบอกว่าต้องรื้อเครือข่ายใหม่ทั้งหมด" คำถามนี้สะท้อนความเข้าใจผิดที่แพร่หลายที่สุดเกี่ยวกับ Zero Trust ในภาคอุตสาหกรรม — คิดว่ามันคือโครงการรื้อสร้างเครือข่ายมหาศาล ความจริงคือ Zero Trust เป็นชุดหลักการที่ทำทีละส่วนได้ และมีแนวทางมาตรฐานรองรับอยู่แล้ว จากปราการเดียว (Castle-and-Moat) สู่การตรวจทุก session: หัวใจคือ Policy Decision Point ตามแนวทาง NIST SP 800-207 (ภาพ: Honey Corporation) Zero Trust ไม่ใช่สินค้า — มันคือการเปลี่ยนคำถาม แนวทาง NIST SP 800-207 อธิบาย Zero Trust เป็นชุดหลักการ ไม่ใช่ชิ้นส่วนที่ซื้อมาติดตั้ง หลักการสำคัญที่สุดข้อหนึ่งคือ: "การเข้าถึงทุกครั้งต้องผ่านการตัดสินใจแบบไดนามิก" โดยอิงข้อมูลตัวตนและบริบท ณ ขณะนั้น — ไม่ใช่ตำแหน่งในเครือข่ายที่เคยถูกอนุญาตไว้ แปลเป็นภาษาโรงงานง่ายๆ: วิศวกรที่เพิ่ง login จากออฟฟิศเมื่อ 10 นาทีก่อน กับวิศวกรคนเดียวกันที่ login จากที่อื่นเวลา 3 ทุ่มของวันหยุด ไม่ควรได้รับสิทธิ์เท่ากัน แม้บัญชีผู้ใช้จะเป็นบัญชีเดียวกัน ตารางเปรียบเทียบ: เครือข่ายโรงงานแบบเดิม vs แบบ Zero Trust มุมมอง แบบเดิม (Perimeter-based) Zero Trust สมมติฐานข้างในเครือข่ายปลอดภัยไม่เชื่อใครโดยอัตโนมัติ ตรวจทุกครั้ง การเข้าถึงระยะไกลVPN หลักเดียว เข้าแล้วเห็นทั้งโรงงานSession สั้น เข้าถึงเฉพาะระบบที่ขอ เครื่องจักรIP อยู่ในช่วงที่อนุญาต = เชื่อCertificate + mTLS ยืนยันตัวตนเครื่องจักร ผู้รับเหมาภายนอกบัญชีร่วมใช้กันทั้งทีม มักไม่มีวันหมดอายุสิทธิ์ชั่วคราว ผูกกับ work order หมดอายุตามงาน เมื่อถูกเจาะ 1 จุดเดินต่อได้ทั้งเครือข่าย (lateral movement)ถูกจำกัดอยู่แค่เซสชันนั้น ขยายไม่ได้ การตรวจสอบย้อนหลังรู้ว่าใคร "อยู่ใน VPN" ไม่รู้ว่าทำอะไรทุกการเข้าถึงมีบันทึกว่าใคร ทำอะไร กับเครื่องไหน หัวใจทางเทคนิค: Policy Decision Point ส่วนประกอบที่ทำให้ Zero Trust ทำงานได้จริงคือการแยก "ผู้ตัดสินใจ" ออกจาก "ผู้บังคับใช้" — ผู้ใช้หรือเครื่องจักรขอสิทธิ์เข้าถึง ระบบตัดสินใจ (PDP) ประเมินจากตัวตน สถานะอุปกรณ์ และบริบทในขณะนั้น แล้วสั่งจุดบังคับใช้ (PEP)…
Read More
Firewall ที่อ่าน Modbus เป็น: Deep Packet Inspection ระดับโปรโตคอลควบคุมสำหรับโรงงานอุตสาหกรรม

Firewall ที่อ่าน Modbus เป็น: Deep Packet Inspection ระดับโปรโตคอลควบคุมสำหรับโรงงานอุตสาหกรรม

Article
ถามวิศวกรโรงงานสิบคนว่า "ไฟร์วอลล์ของโรงงานคุณทำอะไร" — เก้าคนจะตอบว่า "เปิด-ปิดพอร์ต" คำตอบนั้นไม่ผิด แต่มันเป็นคำตอบของปี 2010 ปัญหาของโรงงานยุคนี้คือคนร้ายไม่ได้ "เจาะพอร์ต" อีกต่อไป — เขาเดินเข้ามาในพอร์ตที่เราเปิดให้เขาเอง ผ่านโปรโตคอลควบคุมที่เป็นภาษากลางของทุกโรงงาน: Modbus TCP พอร์ต 502 และ OPC UA พอร์ต 4840 บทความนี้เจาะลึกว่า Industrial-grade Firewall สมัยใหม่ต่างจากไฟร์วอลล์สำนักงานตรงไหน และทำไมการ "อ่านเป็น" โปรโตคอลควบคุม (Protocol-aware DPI) ถึงเป็นเส้นแบ่งระหว่างระบบที่ป้องกันได้จริงกับระบบที่ปล่อยให้คำสั่งอันตรายเดินผ่านด่านตรวจไปหา PLC ตรงๆ ปัญหา: พอร์ตที่ถูกต้อง แต่คำสั่งที่ผิด ไฟร์วอลล์ IT ทั่วไปทำงานที่ชั้น 3-4 ของ OSI: ดู IP ต้นทาง ปลายทาง และพอร์ต ถ้ามีการเชื่อมต่อจาก SCADA Server ไปยัง PLC ที่พอร์ต 502 มันจะอนุญาต เพราะกฎเขียนไว้แบบนั้น ปัญหาคือบน Modbus TCP พอร์ตเดียวกันนั้น คำสั่งอ่าน (Read) กับคำสั่งเขียน (Write) อยู่ในสายเดียวกัน และคำสั่งเขียนเองก็แยกได้อีกเป็นเขียนค่าธรรมดากับเขียนโปรแกรมลงตัวควบคุม สถิติจากงานวิจัย OT Security ล่าสุดชี้ตรงจุดนี้: จากการวิเคราะห์อุปกรณ์ OT ที่เปิดใช้งานและมองเห็นจากอินเทอร์เน็ตกว่า 60,000 เครื่อง พบการเชื่อมต่อระดับความเสี่ยงสูงที่เพิ่มขึ้น 332% เทียบช่วงก่อน ขณะที่เครือข่ายองค์กรกว่า 77.7% ยังเป็นแบบแบน (Flat Network) — แปลว่าการเดินทางจากออฟฟิศไปหา PLC ไม่มีด่านตรวจที่จริงจังเลย Zone และ Conduit ตามแนวทาง IEC 62443: การสื่อสารข้ามโซนต้องผ่านจุดควบคุมเดียวที่อ่านโปรโตคอลควบคุมได้ (ภาพ: Honey Corporation) DPI ระดับโปรโตคอลทำงานอย่างไร — กรณี Modbus TCP โปรโตคอล Modbus TCP แต่ละแพ็กเก็ตประกอบด้วยส่วนหัว MBAP (Modbus Application Protocol) 7 ไบต์ ตามด้วย PDU ที่เริ่มด้วย Function Code ไฟร์วอลล์ที่อ่านได้ถึงระดับนี้จะตรวจได้ 3 ชั้น มากกว่าไฟร์วอลล์ IT ธรรมดา: โครงสร้างแพ็กเก็ต Modbus TCP และจุดที่…
Read More
Case Study: Alarm Flood 340 รายการใน 90 วินาที — ฟื้นห้องควบคุมด้วย ISA-18.2 Rationalization

Case Study: Alarm Flood 340 รายการใน 90 วินาที — ฟื้นห้องควบคุมด้วย ISA-18.2 Rationalization

Article
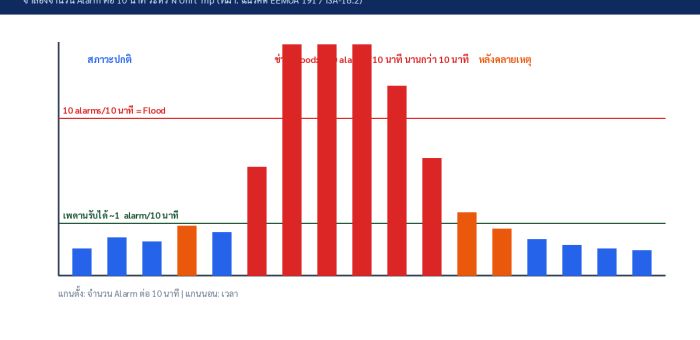
สถานการณ์สมมติที่กลายเป็นเรื่องจริงในโรงงานกระบวนการผลิตทั่วโลก: เครื่องคอมเพรสเซอร์หลัก Trip ตอนตี 2 ภายใน 90 วินาที ระบบ DCS ปล่อยสัญญาณเตือนราว 340 รายการ ลงหน้าจอ Operator เพียงคนเดียว ในจำนวนนั้นมีสัญญาณที่ต้องรีบทำอะไรสักอย่างอยู่ประมาณ 8 รายการเท่านั้น — แต่มันถูกกลบด้วย Alarm อีก 332 รายการที่เป็นแค่ "ผลพวง" ของเหตุการณ์เดียวกัน นี่คือ Alarm Flood ศัตรูตัวฉกาจของห้องควบคุม จำลอง Alarm Flood ระหว่าง Unit Trip — ช่วงกลางกราฟเกินเกณฑ์ 10 alarms ต่อ 10 นาที (นิยามของ Flood ตาม EEMUA 191) หลายเท่าตัว กลบสัญญาณสำคัญจน Operator ต้องไล่ทีละรายการ ปัญหา (Problem): ระบบ Alarm ที่โตเองตามอายุโรงงาน สืบราวที่มาของ Flood ครั้งนี้พบรากปัญหาคลาสสิก 3 ข้อ: Alarm ถูกเพิ่มแต่ไม่เคยถูกลบ — ทุกครั้งที่เกิดปัญหา วิศวกรก็เพิ่ม Alarm ใหม่ "กันพลาด" สะสมมา 15 ปี จนเกิน 4,000 จุดในหนึ่ง Unit Priority ไม่สะท้อนความรุนแรงจริง — เกือบครึ่งถูกตั้ง High Priority เพราะ "กลัวคนไม่เห็น" ผลคือไม่มีอะไรเด่นเลย Standing Alarm ค้างข้ามคืน — ชุด Alarm เดิมค้างบนหน้าจอเป็นปกติ ทำให้สัญญาณใหม่กลืนหายไปกับของเก่า ตัวเลขที่วัดได้ก่อนแก้ไข: Alarm เฉลี่ย 60 รายการต่อชั่วโมงต่อตำแหน่งงาน (เกณฑ์ EEMUA 191 แนะนำไม่เกิน ~1 รายการต่อ 10 นาที หรือราว 144-150 รายการต่อวันตามค่าอ้างอิงของ ISA-18.2 และ IEC 62682) และมีช่วง Flood ที่เกิน 10 รายการต่อ 10 นาทียาวนานกว่า 1 ชั่วโมงทุกครั้งที่มี Trip วิธีแก้ (Solution): Rationalization ตาม Alarm…
Read More
Deep Dive: Motion Control ตามมาตรฐาน PLCopen — จาก Axis State Diagram ถึง Electronic Cam แบบไร้เกียร์กลไก

Deep Dive: Motion Control ตามมาตรฐาน PLCopen — จาก Axis State Diagram ถึง Electronic Cam แบบไร้เกียร์กลไก

Article
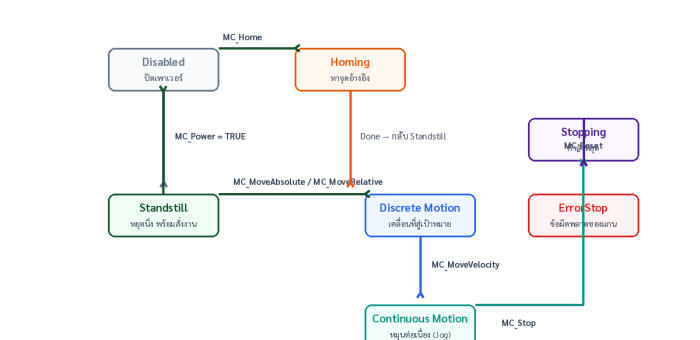
เมื่อก่อนการซิงก์แกนเคลื่อนที่ต้องพึ่งเกียร์กลไก สายพานไทม์มิ่ง และแคมกลไกที่ตัดเฉพาะงาน พอเปลี่ยนสูตรการบรรจุต้องหยุดไลน์เปลี่ยนชิ้นส่วนกันเป็นชั่วโมง วันนี้งานเหล่านั้นย้ายไปอยู่บนซอฟต์แวร์แล้ว ผ่านมาตรฐานฟังก์ชันบล็อกที่กำหนดโดย PLCopen ภายใต้ IEC 61131-3 ปัญหาเก่าของวงการคือแต่ละค่ายมีคำสั่งโมชันของตัวเอง จนย้ายโปรแกรมหรือเปลี่ยนผู้ดูแลทีมใหม่ต้องเรียนรู้ใหม่ทั้งหมด PLCopen Motion Control (Part 1–6) แก้ปัญหานี้ด้วยชุดฟังก์ชันบล็อกมาตรฐานที่ทำงานเหมือนกันทุกแพลตฟอร์ม — เรียนครั้งเดียว ย้ายได้ทุกที่ Axis State Diagram มาตรฐานของ PLCopen — ทุกคำสั่งโมชันคือการเปลี่ยนสถานะของแกน และ ErrorStop ต้องรีเซ็ตด้วย MC_Reset เท่านั้น ระบบสถานะของแกน: ทุกคำสั่งคือการเปลี่ยน State หัวใจของ PLCopen คือ Axis State Diagram ที่กำหนดว่าแกนอยู่ในสถานะใดได้บ้าง: Disabled (ปิดเพาเวอร์), Standstill (หยุดนิ่ง พร้อมรับคำสั่ง), Homing (หาจุดอ้างอิง), Discrete Motion (เคลื่อนที่สู่เป้าหมาย), Continuous Motion (หมุนต่อเนื่อง), Stopping (กำลังหยุด) และ ErrorStop (ข้อผิดพลาด) กฎสำคัญคือ: สั่งเคลื่อนที่ได้เฉพาะจาก Standstill เท่านั้น (ยกเว้นคำสั่งซ้อนทับบางประเภท) MC_Stop ล้ำลำดับทุกคำสั่ง — แกนเข้าสู่ Stopping แล้วจึงกลับ Standstill ErrorStop ต้องใช้ MC_Reset กลับสู่ Standstill ก่อนเสมอ ฟังก์ชันบล็อกหลักที่ต้องรู้จัก งานFunction Blockหน้าที่ เปิด/ปิดเพาเวอร์MC_Powerควบคุม power stage ของไดรฟ์ หาจุดอ้างอิงMC_Homeสร้างตำแหน่งอ้างอิง มีวิธี Homing หลายแบบ (สวิตช์, บล็อกกลไก, Zero Mark) เคลื่อนที่สู่ตำแหน่งMC_MoveAbsolute / MC_MoveRelativeเดินทางสู่พิกัด absolut/ระยะสัมพัทธ์ พร้อมกำหนด Velocity/Acceleration/Jerk หมุนต่อเนื่องMC_MoveVelocityเดินสายพาน/จั๊มพ์ต่อเนื่องจนกว่าจะสั่งหยุด ซิงก์แบบเกียร์MC_GearIn / MC_GearOutล็อกแกนตามให้หมุนตามแกนหลักในอัตราคงที่ ซิงก์แบบแคมMC_CamInกำหนดโปรไฟล์ความสัมพันธ์รายช่วงได้อิสระ หยุด/รีเซ็ตMC_Stop / MC_Resetหยุดควบคุมจากทุกสถานะ / ล้างข้อผิดพลาด Electronic Gear vs Electronic Cam: สองวิธีซิงก์แกนยอดนิยม Gear ใช้เมื่อความสัมพันธ์เป็นเส้นตรง ส่วน Cam เหมาะกับจังหวะที่ซับซ้อนและต้องเปลี่ยนโปรไฟล์ตามสูตรผลิต Electronic Gear เหมาะกับงานที่อัตราส่วนคงที่ เช่น สายพานคู่ที่ต้องเดินด้วยกันตลอด หรือการตัด (Cutoff) ที่ไล่ตามความเร็วสายหลัก —…
Read More
How-to: วางโครงสร้าง Batch Control ตาม ISA-88 ตั้งแต่ Recipe ถึง Phase — คู่มือเริ่มต้นสำหรับโรงงานอาหารและเคมี

How-to: วางโครงสร้าง Batch Control ตาม ISA-88 ตั้งแต่ Recipe ถึง Phase — คู่มือเริ่มต้นสำหรับโรงงานอาหารและเคมี

Article
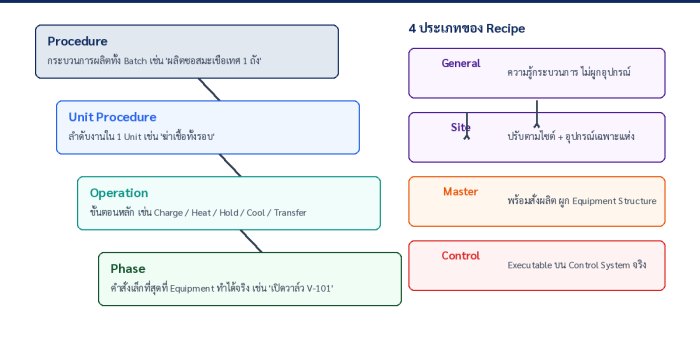
โรงงานที่ผลิตแบบ Batch เช่น อาหาร เครื่องดื่ม เคมีภัณฑ์ หรือยา มันเจอปัญหาเดียวกันเป็นประจำ โปรแกรมควบคุมการผลิตหนึ่งสูตรเขียนติดแน่นกับอุปกรณ์ชุดหนึ่ง พอจะผลิตสูตรใหม่หรือเปลี่ยนถังปฏิกรณ์ ก็ต้องกลับไปแก้โค้ดกันใหม่ทั้งบริษัท สุดท้ายโค้ดบานปลายเป็นสปาเก็ตติ และไม่มีใครกล้าแตะอีก มาตรฐาน ISA-88 (รับรองปี 1995 ปรับปรุงปี 2010 และถูกนำไปใช้เป็นมาตรฐานสากล IEC 61512-1 ตั้งแต่ปี 1997) แก้ปัญหานี้ด้วยแนวคิดเดียว คือ "แยกสิ่งที่ต้องทำ ออกจากอุปกรณ์ที่ทำ" บทความนี้จะพาไปทีละขั้นว่าเริ่มจากตรงไหน Procedural Model 4 ชั้นของ ISA-88 คู่กับ Recipe 4 ประเภท — หัวใจของการแยก Recipe ออกจาก Equipment Control ขั้นที่ 1: แยก Recipe ออกจาก Equipment Control ก่อนอื่นให้ตอบคำถามนี้ให้ได้ สูตรการผลิต (Recipe) คือ ความรู้เกี่ยวกับกระบวนการ — วัตถุดิบอะไร อุณหภูมิเท่าไร นานแค่ไหน ส่วน Equipment Control คือ วิธีที่เครื่องจักรทำงานจริง — เปิดวาล์วตัวไหน สตาร์ทปั๊มลูกไหน ทีมวิศวกรส่วนใหญ่มักผสมสองอย่างนี้เข้าด้วยกันในโปรแกรมเดียว ซึ่งเป็นต้นตอของความยืดหยุ่นที่หายไป ขั้นที่ 2: จัดโครงสร้างอุปกรณ์ตาม Physical Model ISA-88 กำหนดลำดับชั้นอุปกรณ์ไว้ชัดเจน: Enterprise → Site → Area → Process Cell → Unit → Equipment Module → Control Module โดย Unit คือชั้นที่ตัดออกไม่ได้ เพราะ Recipe ทุกใบจะจับคู่กับ Unit เสมอ เช่น ถังปฏิกรณ์ 1 ถัง พร้อมอุปกรณ์ประจำถัง Physical Model ของ ISA-88 — Unit คือหน่วยผลิตหลักที่ Recipe อ้างถึง ส่วน Equipment Module และ Control Module คือชิ้นส่วนที่ประกอบเป็น Unit ขั้นที่ 3: เขียนขั้นตอนการผลิตเป็น Procedural Model 4 ชั้น…
Read More
บทวิเคราะห์: Graph Neural Network — เมื่อ AI เริ่มอ่านโรงงานเป็น “โครงข่าย” ไม่ใช่ตารางตัวเลข

บทวิเคราะห์: Graph Neural Network — เมื่อ AI เริ่มอ่านโรงงานเป็น “โครงข่าย” ไม่ใช่ตารางตัวเลข

Article
เมื่อพูดถึง AI ในโรงงาน ภาพที่เข้ามาในหัวส่วนใหญ่คือกล้องตรวจคุณภาพหรือโมเดลทำนายจากข้อมูลชุดหนึ่ง แต่มีคลาสของปัญหาที่โมเดลแบบ "หนึ่งแถวข้อมูล หนึ่งคำทำนาย" จัดการได้ยากโดยธรรมชาติ: ความผิดปกติของกระบวนการผลิตทั้งระบบ ที่เซ็นเซอร์หลายสิบตัวในหน่วยผลิตต่างๆ เชื่อมโยงกันผ่านท่อ วาล์ว และลำดับขั้นของกระบวนการเคมี Graph Neural Network (GNN) คือคำตอบที่งานวิจัยปี 2026 ชี้ชัดแล้วว่าเป็นทิศทางหลักของงาน fault diagnosis ยุคใหม่ — บทวิเคราะห์นี้ถอดประเด็นว่าทำไม และโรงงานไทยควรมองไว้ตั้งแต่ตอนนี้ ข้อมูลโรงงานไม่ใช่ตาราง — มันคือกราฟ ภาพที่ 1: มุมมองเดียวกัน สองแบบ — ตารางแบนราบมองไม่เห็นความสัมพันธ์ กราฟเห็น topology ของทั้งกระบวนการ โมเดล time-series ทั่วไป (LSTM, Transformer) ประมวลผลข้อมูลของแต่ละจุดวัดเป็นอิสระหรือรวมทั้งหมดเป็นเวกเตอร์เดียว แต่ความผิดปกติในโรงงานเคมี/กระบวนการต่อเนื่องมักปรากฏเป็น "รูปแบบเชิงพื้นที่" — อุณหภูมิ reactor เพี้ยนเล็กน้อย ทำให้ pressure ขาลงระบายตามมา แล้วระดับใน stripper สั่นในอีก 15 นาทีถัดมา ความสัมพันธ์แบบนี้ฝังอยู่ใน topology ของ process ซึ่ง GNN เข้าถึงได้โดยตรงผ่านการสร้าง graph จาก P&ID (แผนผังท่อและเครื่องมือวัด) หรือ Pearson correlation ระหว่างตัวแปร หัวใจคือ Message Passing ภาพที่ 2: Message Passing — แต่ละโหนดรับข้อมูลจากเพื่อนบ้าน รวมเป็น representation ใหม่ แล้วทำนายร่วมกัน GNN ทำงานเป็นรอบ (layer) แต่ละรอบ โหนดหนึ่งๆ — ไม่ว่าจะแทนเซ็นเซอร์ อุปกรณ์ หรือหน่วยผลิต — จะรวบรวม feature จากโหนดที่เชื่อมต่อโดยตรง (aggregate ด้วย sum/mean/max) แล้วอัปเดต representation ของตัวเอง ยิ่งหลาย layer ข้อมูลยิ่งเดินทางไกลขึ้นในกราฟ โหนดปั๊มจึง "รับรู้" สภาพของ reactor ที่อยู่ห่างออกไปสองขั้นโดยไม่ต้องอาศัย feature engineering แบบ manual ผลที่ตามมามีสองด้านที่สำคัญกับโรงงาน: แม่นขึ้น เพราะ fault ที่เกิดจริงมักส่งผลต่อเพื่อนบ้านหลายตัวพร้อมกัน โมเดลที่เห็นความสัมพันธ์นี้จะแยก "fault จริง" ออกจาก "เซ็นเซอร์ตัวเดียวเพี้ยน" ได้ และ ตีความได้…
Read More
How-to: Transfer Learning ข้ามเครื่องจักร — เริ่ม Predictive Maintenance ด้วย Fault จริงแค่ 20-50 ตัวอย่าง

How-to: Transfer Learning ข้ามเครื่องจักร — เริ่ม Predictive Maintenance ด้วย Fault จริงแค่ 20-50 ตัวอย่าง

Article
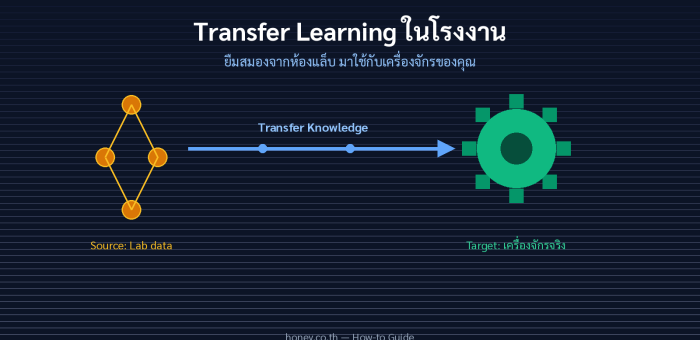
คำถามที่ทีมวิศวกรของเราเจอบ่อยที่สุดจากโรงงานที่อยากเริ่ม Predictive Maintenance คือ "โมเดลเราต้องการข้อมูล fault ของเครื่องจักรตัวนี้กี่ตัวอย่าง กว่าจะใช้งานได้จริง?" คำตอบตรงๆ คือหลายพันตัวอย่าง — จำนวนที่โรงงานส่วนใหญ่ไม่มีทางรอให้เกิดขึ้นเองโดยไม่เจอ breakdown ก่อน Transfer Learning คือทางออกที่ถูกที่สุดและงานวิจัยล่าสุดยืนยันแล้วว่า ยืมความรู้จากข้อมูลสาธารณะมาใช้กับเครื่องจักรจริงได้ ด้วยตัวอย่างเพียง 20-50 ตัวอย่าง หลักการ: Source Domain → Target Domain ภาพที่ 1: แนวคิด Transfer Learning ข้ามเครื่องจักร — freeze ชั้นพื้นฐาน เทรนเฉพาะชั้นท้ายด้วยข้อมูลจริงจำนวนน้อย แนวคิดคือการแยกโมเดลเป็นสองส่วน: ชั้น feature extractor (คอนโวลิวชัน) ที่เรียนรู้ลักษณะพื้นฐานของสัญญาณแรงสั่น — harmonic ของ BPFO/BPFI, รูปแบบ modulation เมื่อแบริ่งเสียหาย ซึ่งเหมือนกันข้ามเครื่องจักรไม่ว่าจะเป็นปั๊มหรือมอเตอร์ กับ ชั้น classifier ปลายทางที่จำเพาะกับเครื่องจักรแต่ละตัว เราจึง pre-train ทั้งหมดบนชุดข้อมูลสาธารณะ แล้ว freeze ชั้นแรกไว้ ปรับแต่งเฉพาะชั้นท้าย งานวิจัยใน Scientific Reports (2025) พิสูจน์แนวทางนี้บนงานจริง: ทีมวิจัยสร้าง Siamese-WDCNN จากชุดข้อมูล CWRU แล้วโอนย้ายไปยัง hydrodynamic transmission testbed กำลังสูง — อุปกรณ์ที่มีโครงสร้างและลักษณะสัญญาณต่างจากแบริ่งทดสอบในแล็บอย่างมาก ผลคือ FSL+TL ทำได้ 85.30% บนสภาวะผสม และเมื่อเติม attention mechanism ขึ้นเป็น 88.75% เทียบกับ WDCNN เดี่ยวๆ ที่ตกไปอยู่ระดับ 70% ต้นๆ 5 ขั้นตอนนำไปใช้จริงในโรงงาน ภาพที่ 2: กระบวนการ 5 ขั้นตอน — ขั้นที่ 4 (ตรวจ negative transfer) คือขั้นที่มักถูกข้ามและทำให้โครงการล้ม ขั้นที่ 1: เก็บสัญญาณ baseline ให้ถูกวิธี ก่อนคุยเรื่อง AI ต้องมีข้อมูลที่เปรียบเทียบได้ก่อน ติดเซ็นเซอร์แรงสั่น 3 แกนที่จุดวัดตามมาตรฐาน ISO 20816 (ผิวแบน สะอาด ใกล้ bearing load zone) พร้อมไมโครโฟนหรือ acoustic sensor…
Read More
Synthetic Data บำลุยข้อมูลตำหนิขาดแคลน: สร้างภาพ Defect ด้วย Diffusion Model เพื่อเทรน AI ตรวจคุณภาพ

Synthetic Data บำลุยข้อมูลตำหนิขาดแคลน: สร้างภาพ Defect ด้วย Diffusion Model เพื่อเทรน AI ตรวจคุณภาพ

Article
โจทย์คลาสสิกของ AI ตรวจคุณภาพในโรงงานคือ "ของเสียไม่พอเทรน" — ระบบที่ผลิตชิ้นงานถูกต้อง 99.5% จะมีตำหนิให้เก็บภาพเพียง 5 ภาพต่อพันชิ้น และเมื่อรวบรวมได้เป็นร้อยภาพ ก็มักเป็นตำหนิประเภทเดียวกันซ้ำๆ โมเดล deep learning ที่ต้องการภาพหลายพันใบจึง overfit กับความหลากหลายที่แทบไม่มีอยู่จริง บทความนี้ดำน้ำลึกสู่แนวทางที่งานวิจัยปี 2026 ยืนยันแล้วว่าได้ผลจริง: สร้างภาพตำหนิสังเคราะห์ด้วย Diffusion Model แล้วมาเสริมชุดข้อมูลฝึก ทำไม GAN ยุคก่อนยังไม่พอ Generative Adversarial Network (GAN) เคยเป็นคำตอบมาตรฐานของปัญหานี้มานานกว่าห้าปี แต่งานวิจัยที่ตีพิมพ์ใน Multimedia Tools and Applications (2026) สรุปข้อจำกัดที่โรงงานเจอตรงๆ สามข้อ: ปัญหา mode collapse ที่ทำให้ภาพที่สร้างซ้ำซากจำเจ ความละเอียดเท็กซ์เจอร์ความถี่สูงที่ไม่พอสำหรับงานตรวจสอบอุตสาหกรรม และความขัดแย้งพื้นฐานที่สุด — GAN ต้องการข้อมูลปริมาณมากอยู่ด่วนในการเทรนให้เสถียร ซึ่งขัดกับสถานการณ์ low-shot ตั้งแต่ต้น Diffusion Model เปลี่ยนกระบวนทัศน์จากการต่อสู้สองโครงข่าย มาเป็นการ ถอด noise ทีละขั้น (iterative denoising) ที่ optimize ด้วย objective แบบ likelihood ที่เสถียรกว่า ผลคือควบคุมโครงสร้างตำหนิและความหลากหลายได้ดีกว่าอย่างมีนัยสำคัญ — งานเปรียบเทียบโดยตรงในโครงการ CINNABAR 2 ของ DLR MRO Institute (เยอรมนี) พบว่า Diffusion Model ให้คะแนน LPIPS ดีกว่าและยก performance ของตัวตรวจจับขึ้น 12% เมื่อเทียบกับ GAN บนงานตรวจคราบบนผิวเครื่องบิน Pipeline ที่งานวิจัยยืนยันแล้ว ภาพที่ 1: Pipeline การสร้างภาพตำหนิสังเคราะห์ด้วย Latent Diffusion Model — เริ่มจากภาพจริงเพียง 3-5 ใบต่อชนิดตำหนิ แนวทางที่ทรงพลังที่สุดในปัจจุบันคือการ fine-tune Latent Diffusion Model (LDM) ที่ pre-train มาแล้วด้วยเทคนิค DreamBooth + LoRA — ฝัง concept ของตำหนิชนิดใหม่ลงโมเดลด้วยภาพอ้างอิงเพียงไม่กี่ใบ โดยปรับเฉพาะ cross-attention layers เพื่อลดภาระคำนวณ จากนั้นใช้ Differential Diffusion แปะตำหนิที่เรียนรู้ได้ลงบนภาพพื้นผิวปกติ โดยไม่เกิดรอยต่อ (boundary…
Read More
บทวิเคราะห์: Wi-SUN FAN 1.1 Low Energy กับใบรับรองใหม่ ก.พ. 2026 — เมื่อ Mesh ของมิเตอร์นับล้านโหนดหันมามองโรงงานไทย

บทวิเคราะห์: Wi-SUN FAN 1.1 Low Energy กับใบรับรองใหม่ ก.พ. 2026 — เมื่อ Mesh ของมิเตอร์นับล้านโหนดหันมามองโรงงานไทย

Article
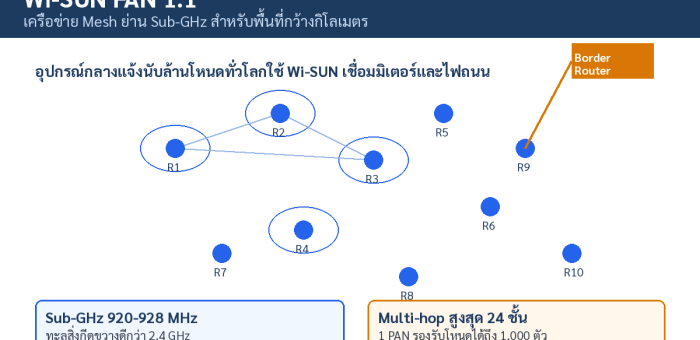
วันที่ 2 กุมภาพันธ์ 2026 Wi-SUN Alliance ประกาศเปิดตัวใบรับรองใหม่ FAN 1.1 Low Energy Certification — ข่าวที่ดูเหมือนเล็กแต่สำคัญมากสำหรับผู้วางระบบ IoT กลางแจ้ง เพราะเป็นครั้งแรกที่อุปกรณ์แบตเตอรี่และ Energy Harvesting สามารถทำงานอยู่ในเครือข่าย Mesh มาตรฐานเดียวกับอุปกรณ์สมรรถนะสูงได้ โดยไม่ต้องวางเครือข่ายขนานสองระบบอีกต่อไป Wi-SUN คืออะไร และทำไมเราควรสนใจ Wi-SUN FAN (Field Area Network) คือมาตรฐานเครือข่ายไร้สายย่าน Sub-GHz ที่สร้างบน IEEE 802.15.4g/4e พร้อมชั้น IPv6 เต็มรูปแบบผ่าน 6LoWPAN และการหาเส้นทางแบบ Mesh ด้วย RPL จุดเด่นเชิงวิศวกรรมคือการกระโดดความถี่ (Frequency Hopping) ที่ช่วยทนสัญญาณรบกวน และการทำ multi-hop ได้ถึง 24 ชั้น โดยแต่ละ PAN รองรับโหนดได้ราว 1,000 ตัว — เหตุผลที่สาธารณูปโภครายใหญ่ทั่วโลกใช้มันเชื่อมมิเตอร์และไฟถนนนับล้านโหนด ล่าสุดย่านความถี่ที่รองรับครอบคลุม 863–876, 865–868 และ 920–928 MHz ซึ่งรวมย่าน 920 MHz ที่ใช้ได้ในประเทศไทย โครงสร้างชั้นมาตรฐานของ Wi-SUN FAN — จาก PHY IEEE 802.15.4g ถึง IPv6 พร้อมความปลอดภัยระดับ EAP-TLS เส้นทางวิวัฒนาการที่ควรรู้ก่อนตัดสินใจ FAN 1.0 (2019) ใช้การระงับสัญญาณแบบ FSK ที่ 50–300 kbps เหมาะกับมิเตอร์ที่ส่งข้อมูลน้อยครั้ง FAN 1.1 เพิ่มการระงับแบบ OFDM ที่เร็วขึ้นราว 20 เท่า สูงสุดถึง 2.4 Mbps พร้อมลด latency ให้เหมาะกับงาน Distribution Automation ที่ต้องสั่งการสวิตช์ในเสี้ยววินาที ใบรับรองชุดแรกออกเมื่อต้นปี 2025 โดยกลุ่มวิจัยมหาวิทยาลัยในญี่ปุ่นร่วมกับผู้ผลิตอุปกรณ์สื่อสาร ก่อนที่รอบล่าสุดจะเพิ่มโหนดพลังงานต่ำเข้ามาในปี 2026 เส้นทางพัฒนาของ Wi-SUN จาก FAN 1.0 ปี 2019 สู่ FAN 1.1 และ FAN 1.1 Low Energy ที่ประกาศใบรับรองเมื่อ ก.พ.…
Read More
How-to: เชื่อมเซ็นเซอร์ I2C/SPI เข้าสู่ระบบ IIoT ใน 6 ขั้นตอน — จาก Pull-up Resistor ถึง MQTT บน Edge Gateway

How-to: เชื่อมเซ็นเซอร์ I2C/SPI เข้าสู่ระบบ IIoT ใน 6 ขั้นตอน — จาก Pull-up Resistor ถึง MQTT บน Edge Gateway

Article
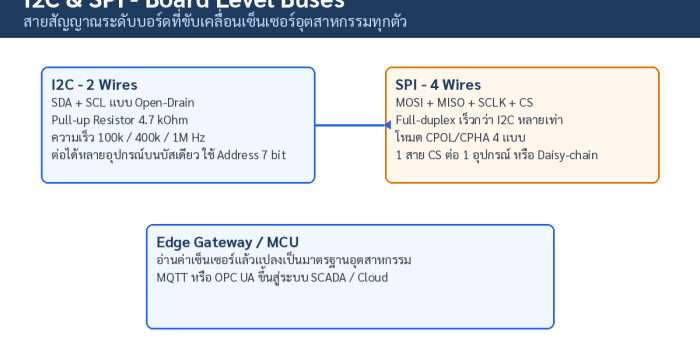
ก่อนข้อมูลเซ็นเซอร์ตัวเดียวจะไปถึงหน้าจอ SCADA หรือ Dashboard บนคลาวด์ได้ มันต้องเดินทางผ่านสองบัสเล็กๆ ที่วิศวกรอิเล็กทรอนิกส์ทุกคนรู้จัก — I2C และ SPI ทั้งคู่เกิดในยุค 80s แต่ยังเป็นปากทางของเซ็นเซอร์อุตสาหกรรมส่วนใหญ่ที่ขายในท้องตลาดทุกวันนี้ บทความนี้สรุปวิธีเชื่อมสองบัสนี้เข้าสู่ระบบ IIoT อย่างเป็นขั้นตอน พร้อมกับดักที่เจอบ่อยในโรงงานจริง เข้าใจสองบัสให้ชัดก่อนออกแบบ I2C ใช้สายแค่ 2 เส้น (SDA, SCL) แบบ open-drain ต้องมีตัวต้านทาน pull-up เสมอ ระบุอุปกรณ์ด้วย address 7 หรือ 10 bit จึงต่อหลายเซ็นเซอร์บนบัสเดียวได้ แลกมาด้วยความเร็วที่ต่ำกว่า SPI และข้อจำกัดเรื่องความจุบัสรวมประมาณ 400 pF ซึ่งแปลว่าสายควรสั้นกว่า 1 เมตร ฝั่ง SPI ใช้ 4 เส้น (MOSI, MISO, SCLK, CS) สื่อสารแบบ full-duplex เร็วได้หลักสิบ MHz แต่ต้องมีสาย CS แยกทุกอุปกรณ์ ทำให้จำนวนขาโตตามจำนวนเซ็นเซอร์ ตารางเทียบ I2C กับ SPI แบบที่วิศวกรใช้ตัดสินใจก่อนลงมือออกแบบบอร์ด 6 ขั้นตอนจากบอร์ดต้นแบบสู่ระบบจริง เลือกเซ็นเซอร์และบัสให้ตรงงาน — ถ้าต้องการอ่านค่าถี่สูงเช่น ความสั่น 100 kHz ของ I2C อาจไม่พอ ให้ใช้ SPI หรือเซ็นเซอร์ที่มี ADC ในตัวแล้วส่งค่าสำเร็จรูป ออกแบบวงจรให้ถูกหลัก — คำนวณค่า pull-up ของ I2C จากความเร็วและความจุบัส (ยิ่งเร็วยิ่งต้องลดค่าตัวต้านทาน) จัดเส้นสัญญาณให้สั้นและห่างจากแหล่งสัญญาณรบกวนเช่นสายมอเตอร์ ทดสอบ signal integrity ก่อนขยายระบบ — ใช้ oscilloscope ดู rise time ของ SDA/SCL และ noise margin ปัญหาที่เจอบ่อยคือ pull-up อ่อนเกินไปทำให้ waveform ไม่ถึง threshold ในเวลาที่กำหนด ต่อระยะไกลอย่างถูกวิธี — เมื่อเซ็นเซอร์อยู่ไกลกว่าที่บัสบอร์ดรับได้ อย่ายืดสาย I2C ตรงๆ ให้ใช้ตัวแปลงระดับบัสเป็นลิงก์ทนทานก่อน เช่น differential transceiver หรือย้ายฝั่ง controller ไปอยู่ใกล้เซ็นเซอร์แล้วส่งข้อมูลดิจิทัลแทน เขียนไดรเวอร์ตาม register map…
Read More