
หลายโรงงานตั้ง schedule งาน preventive maintenance (PM) ด้วยเหตุผลเดียว: “เคยทำมาอย่างนี้” ทุก 3 เดือน ทุก 6 เดือน ทุกปี — คำถามคือ ตัวเลขเหล่านี้มีที่มาจากข้อมูลความล้มเหลวจริง หรือเป็นเพียงความเคยชิน? เครื่องมือสถิติที่ตอบคำถามนี้ตรงที่สุดคือ Weibull Analysis — การวิเคราะห์การแจกแจงความล้มเหลวที่ใช้ในอุตสาหกรรมการบินและอวกาศมาตั้งแต่ทศวรรษ 1950 และวันนี้กลายเป็นหัวใจของ data-driven maintenance ในโรงงานอุตสาหกรรมทั่วโลก
และเมื่อรวมกับเซ็นเซอร์ IIoT ที่เก็บ condition data ได้ต่อเนื่อง Weibull ไม่ได้แข่งกับ Predictive Maintenance — แต่เป็น ชั้นข้อมูลที่บอกว่าเครื่องจักรแต่ละแบบควรถูกเฝ้าดูแบบไหน
Weibull ใน 60 วินาที: สองพารามิเตอร์ที่อธิบายทุกเรื่องราว
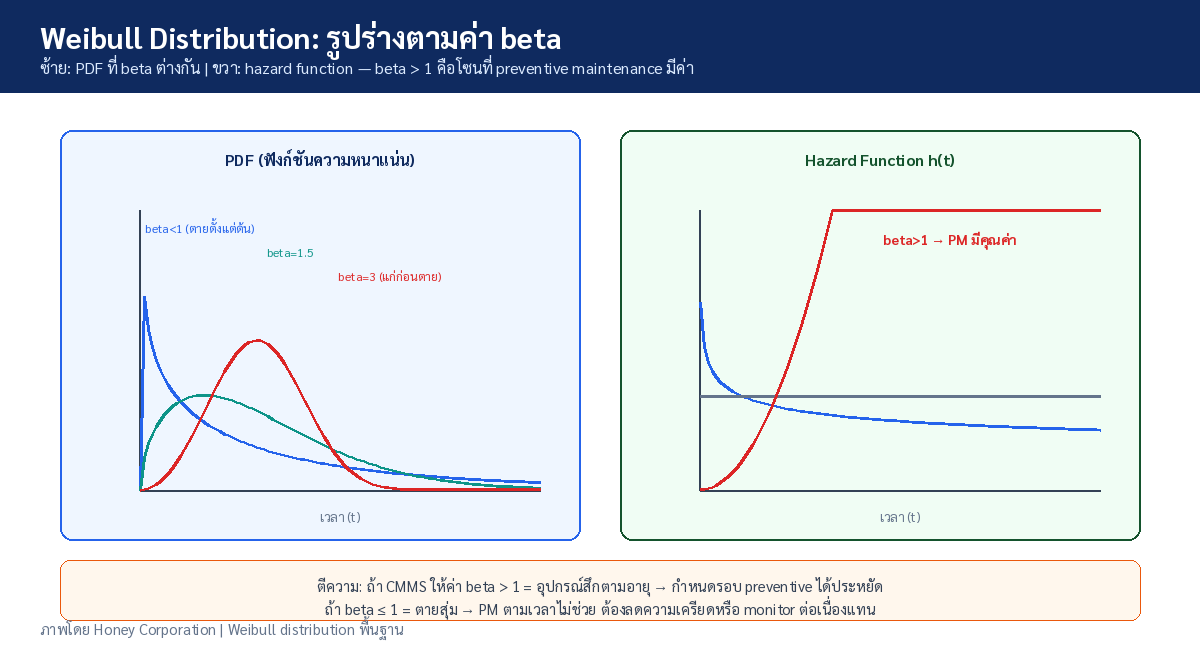
การแจกแจง Weibull อธิบายด้วยพารามิเตอร์สองตัว: β (beta) shape parameter และ η (eta) characteristic life โดย β บอก “รูปแบบการตาย” ของอุปกรณ์:
- β < 1: อัตราการล้มเหลวลดลงตามอายุ (Infant Mortality) — พบในอุปกรณ์ใหม่ที่มี defect จากการผลิต/ติดตั้ง
- β = 1: ล้มเหลวสุ่ม (Random) — ไม่มีอายุขัยที่ “ควรซ่อม” การตั้ง PM เป็นการทำให้แย่ลง (PM ตัวเองคือความเสี่ยง)
- β > 1: ล้มเหลวเพิ่มตามอายุ (Wear-out) — แน่นอนว่าเครื่องจักรกลไกส่วนใหญ่อยู่ในกลุ่มนี้ และเป็นกลุ่มที่ PM ทำงานได้ดี
เมื่อโรงงานเก็บ CMMS Data แต่ไม่เคยวิเคราะห์
ปัญหาที่พบซ้ำๆ ในโรงงานไทย: ข้อมูล failure อยู่ใน CMMS เป็นพันๆ แถว แต่ไม่เคยถูกแปลงเป็นการตัดสินใจ ขั้นตอนวิเคราะห์มีแค่ 4 ขั้น:
- รวบรวม Time-to-Failure (TTF): จาก work order ประวัติ — ต้องแยกให้ชัดว่า failure จริง (Functional Failure) หรือ PM ที่ทำตาม schedule (Censored Data)
- เลือกอุปกรณ์เป้าหมาย: อย่ารวมปั๊ม 20 รุ่นในชุดข้อมูลเดียว — วิเคราะห์รายกลุ่มอุปกรณ์ที่เหมือนกันจริง
- ประมาณค่า β, η: ด้วย Least Squares บน Weibull plot หรือ Maximum Likelihood Estimation (MLE)
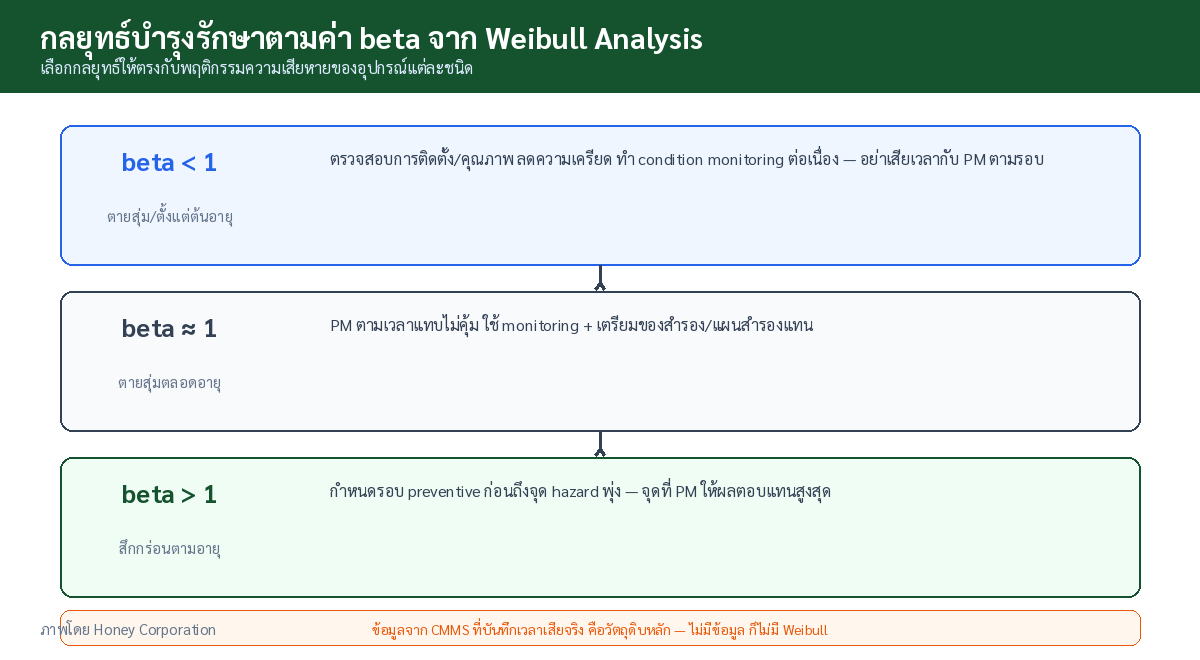
- แปลผลเป็นกลยุทธ์: β > 2 และ η ชัดเจน → PM interval ที่เหมาะสม; β ≈ 1 → ยกเลิก PM ไปใช้ condition-based; β < 1 → แก้ปัญหาที่ commissioning
จุดที่มักถูกมองข้ามคือ censored data — ถ้าคุณนับเฉพาะเครื่องที่พังจริง แต่ละเมินเครื่องที่รอดมาได้ (suspended) ค่า η จะถูกประมาณต่ำกว่าความจริง ทำให้ PM interval สั้นเกินไป คือ over-maintenance ที่มองไม่เห็น
ตารางการตัดสินใจ: จาก β สู่กลยุทธ์บำรุงรักษา
| ค่า β | ลักษณะความล้มเหลว | กลยุทธ์ที่เหมาะสม |
|---|---|---|
| β < 1 | Infant mortality — พังตั้งแต่เริ่มใช้ | แก้ที่ procurement/commissioning, burn-in test, ไม่ใช่เพิ่มความถี่ PM |
| β ≈ 1 | สุ่ม — อายุไม่ใช่ตัวทำนาย | ยกเลิก time-based PM, ใช้ condition monitoring + design-out |
| 1 < β < 2 | เริ่ม wear-out แต่กระจายมาก | PM ร่วมกับ condition monitoring ช่วยครอบคลุมความไม่แน่นอน |
| β > 2 | wear-out ชัดเจน กระจุกตัวรอบ η | time-based PM ทำงานได้ดี — ตั้ง interval ที่ 0.6-0.8 η ตามระดับความเสี่ยง |
ตาราง: แปลงค่า β เป็นกลยุทธี — ค่า β ที่ได้จากข้อมูลจริงของโรงงานคุณจะบอกว่า budget PM ที่ทุ่มไปถูกที่จริงหรือไม่
จุดเชื่อมกับ IIoT: จากสถิติย้อนหลังสู่การเฝ้าระวังแบบเรียลไทม์
Weibull ตอบว่า “เครื่องกลุ่มนี้พังแบบไหน” แต่ไม่ได้บอกว่า “เครื่องตัวนี้กำลังจะพังเมื่อไหร่” — ช่องว่างนี้แหละที่เซ็นเซอร์ IIoT เข้ามาเติม: เมื่อรู้ว่าอุปกรณ์กลุ่มหนึ่งมี β = 1.2 (ค่อนข้างสุ่ม) ความพยายามที่ถูกต้องคือ ติด condition monitoring ดู upstream signal เช่น การสั่นสะเทือน อุณหภูมิ หรือ motor current แทนการเพิ่ม PM schedule ที่ไม่ได้ลดความเสี่ยงลงจริง
ในทางกลับกัน อุปกรณ์ β = 3.5 ที่พังตามอายุชัดเจน การทำ PM ตาม interval ก็เพียงพอ ไม่จำเป็นต้องติดเซ็นเซอร์ราคาแพง — งบ Predictive Maintenance ควรถูกลงทุนเฉพาะที่ที่สถิติบอกว่า “มันสุ่มเกินกว่า schedule จะช่วยได้”
มุมมองของเรา: ก่อนติดเซ็นเซอร์ ให้ข้อมูลพูดก่อน
ทีมวิศวกรรมของ Honey Corporation เห็นโครงการ IIoT จำนวนมากที่เริ่มจากการเลือกซื้อเซ็นเซอร์ก่อนคำถามทางธุรกิจ เรามองว่าลำดับที่ถูกคือ: วิเคราะห์ failure data ที่มีอยู่ → จัดกลุ่มตาม β → จึงเลือกว่ากลุ่มไหนควร time-based PM, กลุ่มไหนควร condition monitoring และกลุ่มไหนควร run-to-failure — แนวทางเดียวกับที่เราใช้ออกแบบระบบ IoT monitoring ให้ลูกค้าอุตสาหกรรม ที่เริ่มจากคำถามว่าข้อมูลควรตอบอะไร ไม่ใช่ติดเซ็นเซอร์ให้ครบทุกจุด
Key Takeaways
- β < 1 = แก้ที่ต้นทาง ไม่ใช่เพิ่ม PM — ปัญหาอยู่ที่ procurement และ commissioning
- β ≈ 1 = อันตรายของ time-based PM — การแทรกแซงเองคือความเสี่ยงใหม่ ควรย้ายไป condition-based
- β > 2 = PM ทำงานได้ — ตั้ง interval 0.6-0.8 η ตามระดับ criticality
- อย่าลืม censored data — ตัดเครื่องที่ยังไม่พังออก η จะ under-estimate ทำให้ over-maintenance
- Weibull + IIoT คือคู่หู ไม่ใช่คู่แข่ง — สถิติบอกกลยุทธ์ เซ็นเซอร์ปิดช่องว่างความสุ่ม
- ข้อมูลอยู่ใน CMMS ของคุณอยู่แล้ว — วิเคราะห์เชิงลึกครั้งเดียวเปลี่ยนโครงสร้างต้นทุนบำรุงรักษาได้ทั้งโรงงาน
Honey Corporation พร้อมให้คำปรึกษา
ทีมงานของเรามีความเชี่ยวชาญด้านการวิเคราะห์ความน่าเชื่อถือและ Reliability Engineering พร้อมออกแบบกลยุทธ์บำรุงรักษาบนข้อมูลจริง ให้เหมาะกับธุรกิจของคุณ
📞 โทร: 09-23242995 | อีเมล: support@honey.co.th
เว็บไซต์: www.honey.co.th