
โจทย์คลาสสิกของ AI ในโรงงานคือ “ข้อมูลไม่พอเทรน” เครื่องจักรแต่ละตัวผลิต defect ที่หลากหลายและหายาก การเก็บชุดข้อมูลตัวอย่างที่ครอบคลุมทุกรูปแบบความผิดพลาดในไซต์เดียวอาจใช้เวลาเป็นปี ทางออกที่ตรงไปตรงมาคือรวมข้อมูลจากหลายโรงงานเข้าด้วยกัน — แต่แผนภาพสถานการณ์ของข้อมูล สูตรการผลิต และภาพถ่ายชิ้นงานจริง มักถูกจัดเป็นความลับทางการค้าที่แบ่งปันกันไม่ได้ บทความนี้ถอดบทเรียนจากงานวิจัยจริงที่ใช้ Federated Learning (FL) แก้ปัญหานี้ในงาน Metal Additive Manufacturing (การพิมพ์โลหะสามมิติ)
ปัญหา: โมเดลตรวจ defect ที่ “ฉลาดเฉพาะบ้านตัวเอง”
ในกระบวนการพิมพ์โลหะด้วยเลเซอร์ (Laser-Based Powder Bed Fusion) defect เกิดจากปัจจัยเชิงกายภาพมากมาย — พลังงานเลเซอร์, ความหนาผงโลหะ, อุณหภูมิแผ่นรองรับ และพฤติกรรมของ melt pool ระหว่างการพิมพ์ แต่ละไซต์ผลิตมีเครื่องพิมพ์คนละรุ่น ใช้ผงโลหะคนละล็อต และเจอ defect pattern ที่ไม่เหมือนกัน ผลคือโมเดลที่เทรนจากข้อมูลไซต์เดียว (Isolated Learning) ทำนายได้ดีในบ้านตัวเองแต่พลาดเมื่อเจอรูปแบบใหม่ ขณะที่การรวมศูนย์ข้อมูล (Centralized Learning) กระทบทั้งความเป็นส่วนตัวและขนาดข้อมูลที่ต้องเคลื่อนย้าย
ทางออก: เทรนร่วมกันโดยข้อมูลไม่ต้องย้ายบ้าน
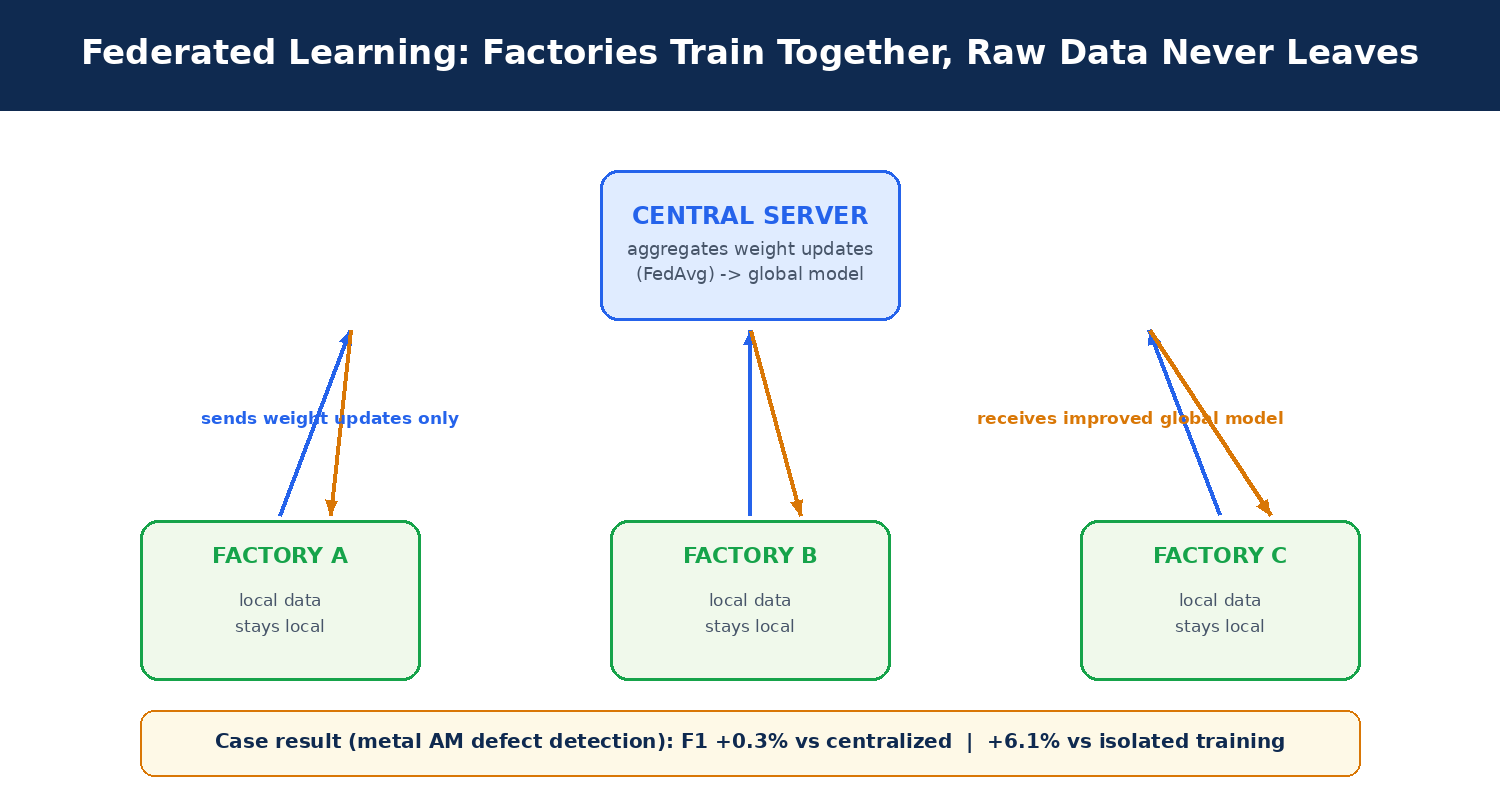
Federated Learning กลับสูตรการเทรนแบบเดิม แทนที่จะย้าย “ข้อมูล” ไปหาโมเดล ก็ส่ง “โมเดล” ไปหาข้อมูล แต่ละโรงงาน (client) เทรนโมเดลสำเนาของตัวเองด้วยข้อมูลในพื้นที่ แล้วส่งเฉพาะ ค่าน้ำหนักที่อัปเดต (weight updates) กลับไปยังเซิร์ฟเวอร์กลาง เซิร์ฟเวอร์รวม (aggregate) การอัปเดตจากทุกไซต์ด้วยอัลกอริทึมอย่าง FedAvg ให้กลายเป็นโมเดลร่วม (global model) แล้วส่งกลับไปให้ทุกไซต์ในรอบถัดไป วนซ้ำแบบนี้จนโมเดลลู่เข้า
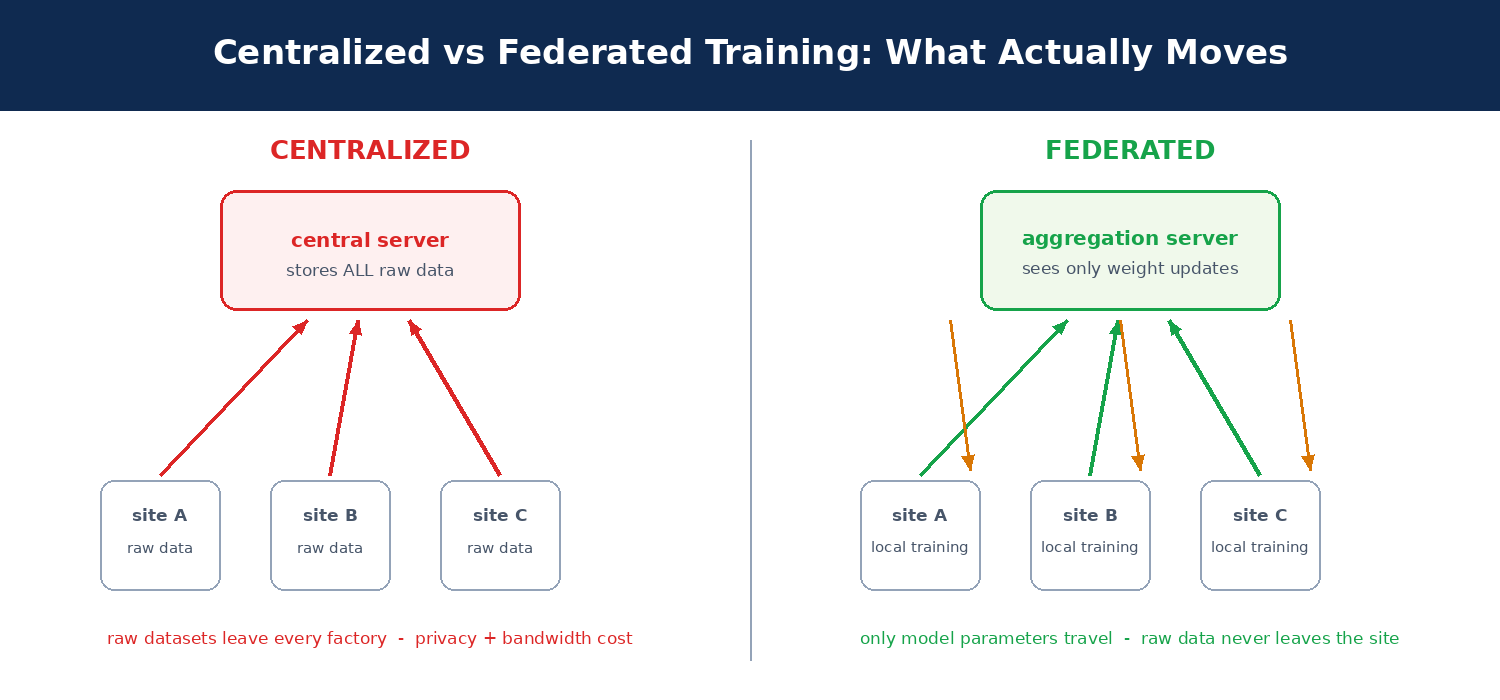
ความต่างจากการเทรนรวมศูนย์เห็นได้ชัดเมื่อเปรียบเทียบว่า “อะไรเดินทางออกจากโรงงาน” ในแบบรวมศูนย์ ชุดข้อมูลดิบทั้งก้อนต้องออกจากทุกไซต์ไปอยู่บนเซิร์ฟเวอร์เดียว แต่ในแบบ federated สิ่งเดียวที่ออกจากไซต์คือพารามิเตอร์โมเดลขนาดกิโลไบต์ถึงหลักเมกะไบต์ต่อรอบ ข้อมูลภาพ melt pool หรือสูตรกระบวนการที่อ่อนไหวยังอยู่หลังไฟร์วอลล์ของเจ้าของข้อมูลเหมือนเดิม
ผลลัพธ์จากงานวิจัยจริง
งานวิจัยด้าน Privacy-Preserving Process-Defect Modelling สำหรับ Metal-Based Additive Manufacturing ทดลองเปรียบเทียบ 3 โหมดการเทรน ได้ผลที่น่าสนใจมาก:
| โหมดการเทรน | ข้อมูลดิบออกจากไซต์? | ประสิทธิภาพ (เทียบฐาน) |
|---|---|---|
| Centralized Learning (รวมข้อมูลที่เซิร์ฟเวอร์) | ใช่ — ทั้งหมด | ฐานอ้างอิง (สูงสุดแต่แพงเรื่อง privacy) |
| Isolated Learning (แยกเทรนตามไซต์) | ไม่ | F1 ต่ำกว่า FL ถึง 6.1% |
| Federated Learning (เทรนร่วมแบบกระจาย) | ไม่ — เฉพาะ weight updates | F1 สูงกว่า centralized 0.3% + โบนัสความเป็นส่วนตัว |
ตัวเลขชุดนี้บอกเรื่องสำคัญ 2 ข้อ ข้อแรก FL ได้ประสิทธิภาพใกล้เคียงกับการเทรนรวมศูนย์ (ดีกว่าเล็กน้อยด้วยซ้ำในการทดลองนี้ — F1 สูงกว่า 0.3%) และข้อสอง มันดีกว่าการเทรนแยกไซต์อย่างชัดเจนถึง 6.1% นั่นแปลว่า “ความรู้ร่วม” จากหลายไซต์ช่วยกันขยายมุมมองของโมเดลโดยที่ไม่มีใครต้องเปิดเผยข้อมูลดิบของตัวเอง
ความท้าทายที่ทีมวิศวกรต้องรับมือ
- Non-IID data — ข้อมูลแต่ละไซต์ไม่ได้กระจายแบบเดียวกัน (เครื่องต่างรุ่น ผงต่างล็อต) ทำให้การรวมน้ำหนักแบบธรรมดาอาจลู่เข้าช้าหรือแกว่ง งานวิจัยล่าสุดจึงพัฒนาต่อยอดเป็นเทคนิคอย่าง clustered FL ที่จับกลุ่ม client ที่เหมือนกันก่อนรวม ร่วมกับ differential privacy แบบ heterogeneous
- การโจมตีระหว่างทาง — weight updates ที่ส่งขึ้นลงอาจถูกป่วนด้วย label-flipping attack ที่ client ประสงค์ร้ายส่งอัปเดตกลับกัน งานวิจัยด้าน defect detection ใน AM ชี้ว่าจุดนี้ต้องมีกลไกป้องกันประกอบ
- ธรรมาภิบาลข้อมูล — ใครเป็นเจ้าของ global model ผลประโยชน์กระจายอย่างไรเมื่อบางไซต์มีข้อมูลมากกว่า คำถามเหล่านี้เป็นเรื่อง governance ไม่ใช่แค่เทคนิค
- ค่าใช้จ่ายการสื่อสาร — FL แลก bandwidth กับ privacy แต่จำนวนรอบ (rounds) ที่มากเกินไปก็กินเน็ตเหมือนกัน ต้องออกแบบเลือกสัดส่วน client ที่ร่วมต่อรอบให้พอดี
สำหรับ Honey Corporation แนวทางนี้สอดคล้องกับปรัชญาที่เราใช้ออกแบบระบบ IIoT ให้ลูกค้ามาโดยตลอด — ข้อมูลดิบควรประมวลผลใกล้จุดเกิดเหตุและอยู่ในการควบคุมของเจ้าของข้อมูล เฉพาะข้อมูลที่ถูกย่อยแล้วเท่านั้นที่ควรเดินทาง เมื่อลูกค้าหลายรายในอุตสาหกรรมเดียวกันต้องการโมเดล AI ตรวจสอบคุณภาพที่แข็งแรงขึ้น Federated Learning คือรูปแบบความร่วมมือที่เป็นไปได้โดยไม่ต้องแลกความลับทางการค้ามาเป็นตัวประกัน
Key Takeaways
- ปัญหา: โมเดลตรวจ defect เทรนจากไซต์เดียวมองไม่เห็น pattern ที่หลากหลาย แต่การรวมข้อมูลดิบกระทบความลับทางการค้า
- ทางออก: FL ส่งโมเดลไปหาข้อมูล — client เทรนในพื้นที่ ส่งเฉพาะ weight updates ไป aggregate ด้วย FedAvg
- ผลจริงจากงานวิจัย Metal AM: FL ได้ F1 สูงกว่า centralized 0.3% และสูงกว่า isolated learning ถึง 6.1%
- สิ่งที่เดินทางออกจากโรงงานลดจาก “ทั้งก้อนข้อมูลดิบ” เหลือ “พารามิเตอร์โมเดลต่อรอบ” — privacy และ bandwidth ดีขึ้นพร้อมกัน
- ระวัง Non-IID: ข้อมูลไซต์ไม่เท่ากันต้องใช้เทคนิกขั้นสูง เช่น clustered FL + differential privacy
- อย่าลืมความปลอดภัย: มีงานวิจัยชี้ชัดว่า FL เปราะบางต่อ label-flipping attack — ต้องมีกลไกกรอง client
- เริ่มได้จากเล็ก: ทดลองกับ 2–3 ไซต์ในเครือก่อน วัดผลเทียบกับ isolated learning แล้วค่อยขยายวงร่วมมือ
Honey Corporation พร้อมให้คำปรึกษา
ทีมงานของเรามีความเชี่ยวชาญด้านระบบ AI และ IIoT สำหรับงานตรวจสอบคุณภาพในโรงงาน พร้อมออกแบบสถาปัตยกรรมการเทรนโมเดลแบบกระจายที่เคารพความเป็นส่วนตัวของข้อมูลแต่ละไซต์ ตั้งแต่การจัดเตรียมข้อมูล ออกแบบรอบการเทรน ไปจนถึงการ deploy โมเดลลงสายการผลิตจริง
📞 โทร: 09-23242995 | อีเมล: support@honey.co.th
เว็บไซต์: www.honey.co.th