
เมื่อพูดถึง AI ในโรงงาน ภาพที่เข้ามาในหัวส่วนใหญ่คือกล้องตรวจคุณภาพหรือโมเดลทำนายจากข้อมูลชุดหนึ่ง แต่มีคลาสของปัญหาที่โมเดลแบบ “หนึ่งแถวข้อมูล หนึ่งคำทำนาย” จัดการได้ยากโดยธรรมชาติ: ความผิดปกติของกระบวนการผลิตทั้งระบบ ที่เซ็นเซอร์หลายสิบตัวในหน่วยผลิตต่างๆ เชื่อมโยงกันผ่านท่อ วาล์ว และลำดับขั้นของกระบวนการเคมี Graph Neural Network (GNN) คือคำตอบที่งานวิจัยปี 2026 ชี้ชัดแล้วว่าเป็นทิศทางหลักของงาน fault diagnosis ยุคใหม่ — บทวิเคราะห์นี้ถอดประเด็นว่าทำไม และโรงงานไทยควรมองไว้ตั้งแต่ตอนนี้
ข้อมูลโรงงานไม่ใช่ตาราง — มันคือกราฟ
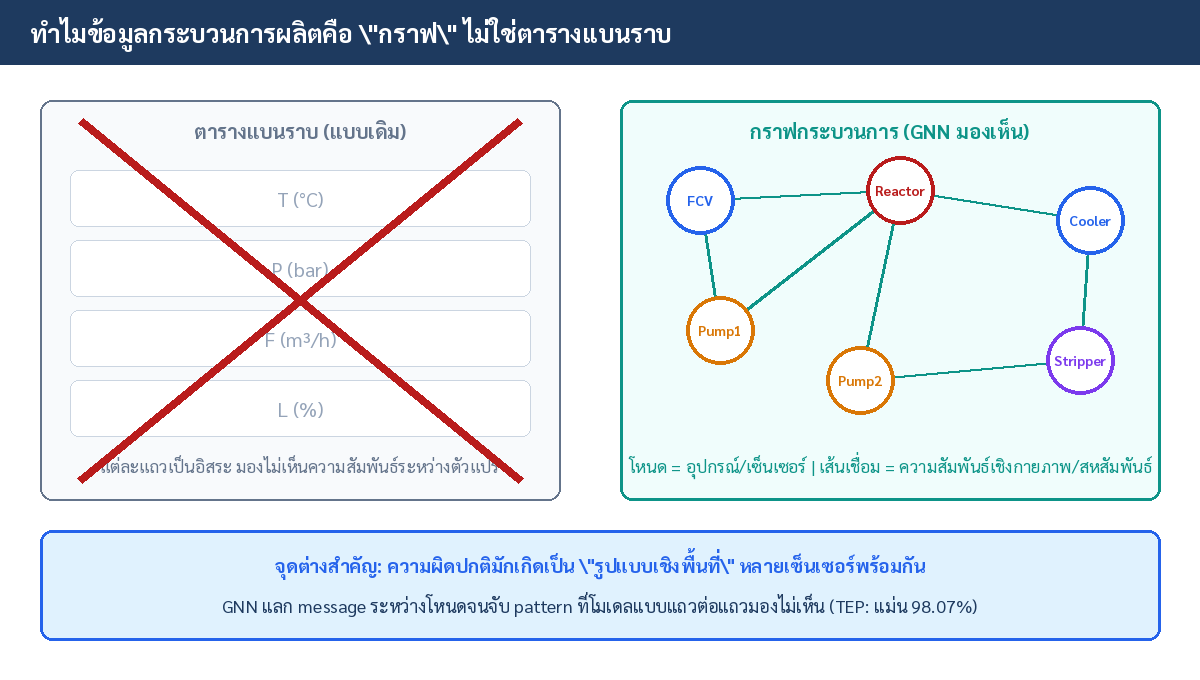
โมเดล time-series ทั่วไป (LSTM, Transformer) ประมวลผลข้อมูลของแต่ละจุดวัดเป็นอิสระหรือรวมทั้งหมดเป็นเวกเตอร์เดียว แต่ความผิดปกติในโรงงานเคมี/กระบวนการต่อเนื่องมักปรากฏเป็น “รูปแบบเชิงพื้นที่” — อุณหภูมิ reactor เพี้ยนเล็กน้อย ทำให้ pressure ขาลงระบายตามมา แล้วระดับใน stripper สั่นในอีก 15 นาทีถัดมา ความสัมพันธ์แบบนี้ฝังอยู่ใน topology ของ process ซึ่ง GNN เข้าถึงได้โดยตรงผ่านการสร้าง graph จาก P&ID (แผนผังท่อและเครื่องมือวัด) หรือ Pearson correlation ระหว่างตัวแปร
หัวใจคือ Message Passing
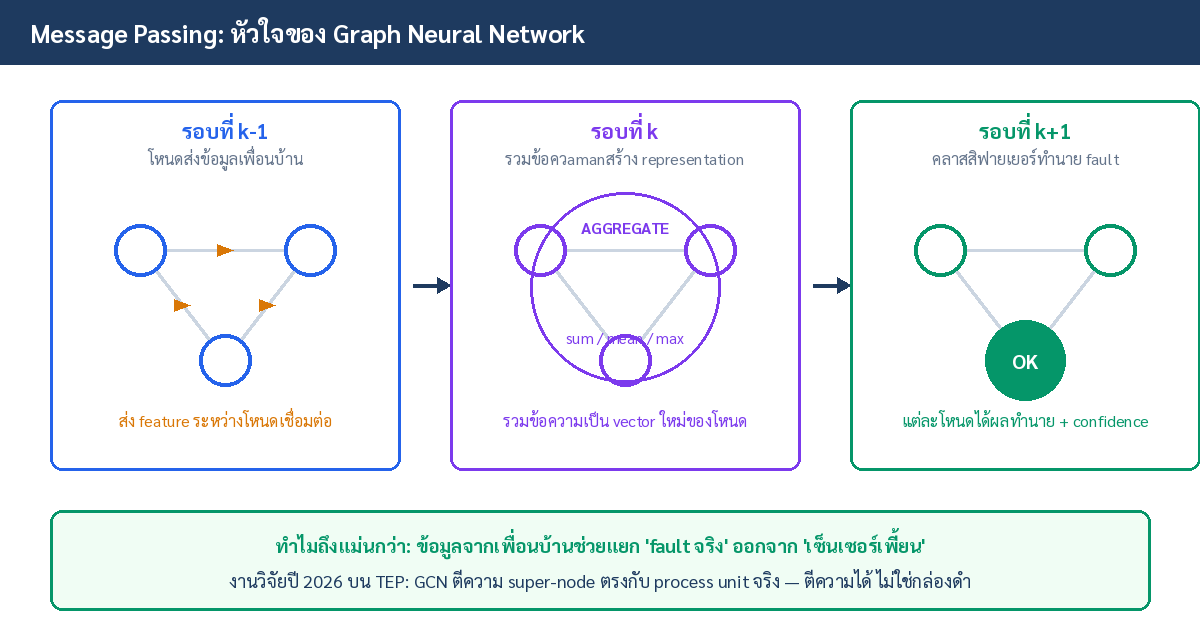
GNN ทำงานเป็นรอบ (layer) แต่ละรอบ โหนดหนึ่งๆ — ไม่ว่าจะแทนเซ็นเซอร์ อุปกรณ์ หรือหน่วยผลิต — จะรวบรวม feature จากโหนดที่เชื่อมต่อโดยตรง (aggregate ด้วย sum/mean/max) แล้วอัปเดต representation ของตัวเอง ยิ่งหลาย layer ข้อมูลยิ่งเดินทางไกลขึ้นในกราฟ โหนดปั๊มจึง “รับรู้” สภาพของ reactor ที่อยู่ห่างออกไปสองขั้นโดยไม่ต้องอาศัย feature engineering แบบ manual
ผลที่ตามมามีสองด้านที่สำคัญกับโรงงาน: แม่นขึ้น เพราะ fault ที่เกิดจริงมักส่งผลต่อเพื่อนบ้านหลายตัวพร้อมกัน โมเดลที่เห็นความสัมพันธ์นี้จะแยก “fault จริง” ออกจาก “เซ็นเซอร์ตัวเดียวเพี้ยน” ได้ และ ตีความได้ เพราะลำดับชั้นของ graph สะท้อนโครงสร้างทางกายภาพของโรงงานจริง
ตัวเลขจากงานวิจัยบอกอะไร
เกณฑ์มาตรฐานของสายนี้คือ Tennessee Eastman Process (TEP) — โมเดลจำลองโรงงานเคมีที่ใช้กันมากว่า 30 ปี มี fault ที่กำหนดไว้ 28 รูปแบบ งานวิจัยล่าสุดหลายชิ้นปี 2026 ชี้แนวโน้มเดียวกัน:
| แนวทาง (ปี 2026) | จุดเด่น | ผลบน TEP |
|---|---|---|
| Multi-level temporal graph + local-global fusion (IOP 2026) | รวม pattern ระยะสั้น-ยาว + super-node clustering | เหนือกว่า baseline ทุกตัว โดยเฉพาะ fault ซับซ้อน |
| Spatiotemporal fusion + graph จาก P&ID (Chem. Geol. 2026) | ใช้ความรู้กระบวนการจริงสร้าง graph + ตีความได้ | แม่นสูง + ตรวจสอบบนโรงงานจริง Cranfield ด้วย |
| LHTRN lightweight (PSEP 2026) | พารามิเตอร์เพียง ~5% ของโมเดลเทียบ | 98.07% ด้วยพารามิเตอร์น้อย เหมาะ edge |
ประเด็นที่น่าสนใจที่สุดจากงาน IOP คือ super-node clustering แบบ unsupervised จัดกลุ่มเซ็นเซอร์อัตโนมัติ แล้วพบว่า กลุ่มที่จัดได้ตรงกับ process unit ทางกายภาพจริง — แปลว่าโมเดลเรียนรู้โครงสร้างโรงงานเองโดยไม่ต้องบอก นี่คือคำตอบของคำถาม “กล่องดำ” ทางธุรกิจที่ถามกันมานาน
มุมมองของเรา: ทำไมโรงงานไทยควรติดตามตั้งแต่ตอนนี้
กระบวนการต่อเนื่องในไทย — ปิโตรเคมี ปูนซีเมนต์ อาหาร กระดาษ พลังงานชีวภาพ — มีลักษณะเดียวกับ TEP ทุกประการ: ตัวแปรสองสามสิบตัวเชื่อมโยงกันเป็นเครือข่าย ระบบ DCS/SCADA เก่ามักมี alarm แบบ threshold ที่ตั้งไว้นานแล้ว ทำให้ alarm flood เวลาเกิดเหตุ และ operator ต้องไล่หาสาเหตุทีหลัง ทั้งที่ข้อมูลบอกอยู่แล้วว่ารูปแบบผิดปกติกำลังก่อตัว
ปัจจัยที่ทำให้เทคโนโลยีนี้ “สุก” พอดีสำหรับการลงมือตอนนี้: โมเดล lightweight อย่าง LHTRN ใช้พารามิเตอร์เพียง 5% ของโมเดลเทียบ แต่ได้ 98% บน TEP หมายความว่ารันได้บน edge gateway ในโรงงานจริงไม่ใช่แค่ในแล็บ และการสร้าง graph จาก P&ID ที่โรงงานมีอยู่แล้วทำให้ไม่ต้องเริ่มจากศูนย์ — นี่คือจุดที่ทีม System Integration ของ Honey Corporation เห็นโอกาสชัด: ข้อมูลและแผนผังมีอยู่แล้วในทุกโรงงาน เสียแต่ยังไม่มีใครเปลี่ยนมันเป็นกราฟที่ AI เรียนรู้ได้ เราเคยเห็น pattern เดียวกันนี้ในงานติดตั้งระบบ SCADA และ IoT monitoring หลายแห่ง — ขั้นแรกของการใช้ประโยชน์คือการทำ data model ให้ถูก ไม่ใช่การเลือกโมเดลแพงๆ
ข้อจำกัดที่ควรรู้ก่อนตัดสินใจ
GNN ไม่ใช่เวทมนตร์: คุณภาพของ graph ที่สร้างกำหนดเพดานของทุกอย่าง — สร้างจาก correlation ล้วนๆ จะเปราะต่อ spurious correlation สร้างจาก P&ID ล้วนๆ อาจพลาด dynamics ที่ไม่ได้เขียนไว้ในแผนผัด แนวปฏิบัติที่ดีที่สุดในปัจจุบันคือผสมทั้งสอง และต้องมีข้อมูล fault จริงบ้างสำหรับ validation แม้จะไม่ต้องเยอะเท่าแนวทาง supervised ล้วน (แนวทาง hybrid กับ physics-based model ช่วยได้อีกทาง)
Key Takeaways
- ข้อมูลกระบวนการผลิตมีธรรมชาติเป็นกราฟ: GNN ใช้ topology นี้โดยตรง โมเดลตารางแบนราบมองไม่เห็น
- Message passing จับ spatial pattern ของ fault: แยก fault จริงจากเซ็นเซอร์เพี้ยนได้ดีกว่า
- ผล TEP ปี 2026 น่าประทับใจ: lightweight 5% พารามิเตอร์ก็ได้ 98.07% — รันบน edge ได้จริง
- ตีความได้: super-node clustering จัดกลุ่มตรง process unit จริง — ตอบโจทย์ “กล่องดำ”
- โรงงานไทยมีวัตถุดิบพร้อม: P&ID + ข้อมูล DCS/SCADA เดิม เปลี่ยนเป็น graph ได้ทันที
- graph คุณภาพดี = เพดานสูง: ผสม P&ID + correlation ดีกว่าพึ่งแหล่งเดียว
Honey Corporation พร้อมให้คำปรึกษา
ทีมงานของเรามีความเชี่ยวชาญด้านระบบ SCADA และ Industrial AI พร้อมออกแบบสถาปัตยกรรมข้อมูลและระบบตรวจจับความผิดปกติของกระบวนการผลิตให้เหมาะกับโรงงานของคุณ ตั้งแต่การทำ data model จาก P&ID ที่มีอยู่ จนถึงการวาง AI บน edge gateway
📞 โทร: 09-23242995 | อีเมล: support@honey.co.th
เว็บไซต์: www.honey.co.th