
คำถามที่ดูเหมือนง่ายแต่เจ็บจริงของทุกโปรเจกต์ IIoT คือ “ข้อมูลที่เก็บมาทั้งหมดนี้ ตกลงจะเก็บไว้ที่ไหน และเก็บนานแค่ไหน?” — คำตอบที่ผิดนำไปสู่สองปลายทางเดียวกัน: ซื้อ storage ระดับ enterprise เกินจำเป็นจนงบบานปลาย หรือลบข้อมูลเก่าทิ้งแล้วเจอการตรวจสอบย้อนหลังหลังจากนั้นหกเดือน บทความนี้เดินไปทีละขั้นตามเส้นทางของข้อมูลหนึ่งจุดวัด ตั้งแต่หน้างานจนถึงคลาวด์
ขั้นที่ 1: ข้อมูลเกิดที่หน้างาน 1,000 ครั้งต่อวินาที
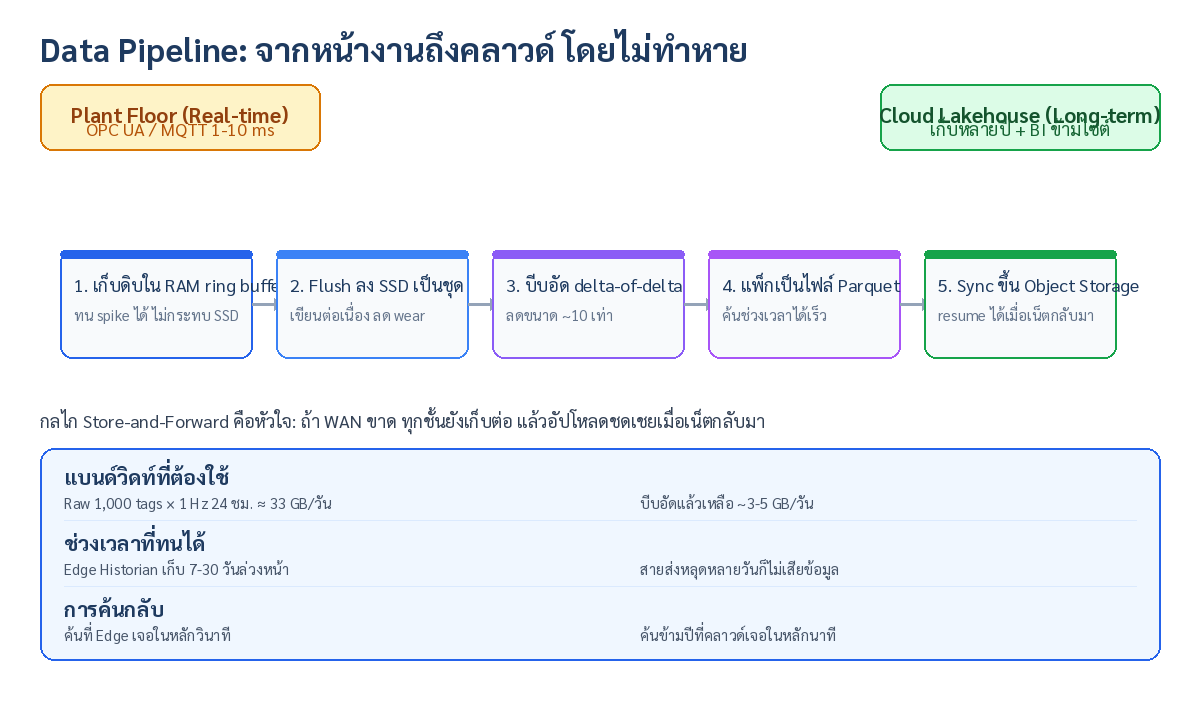
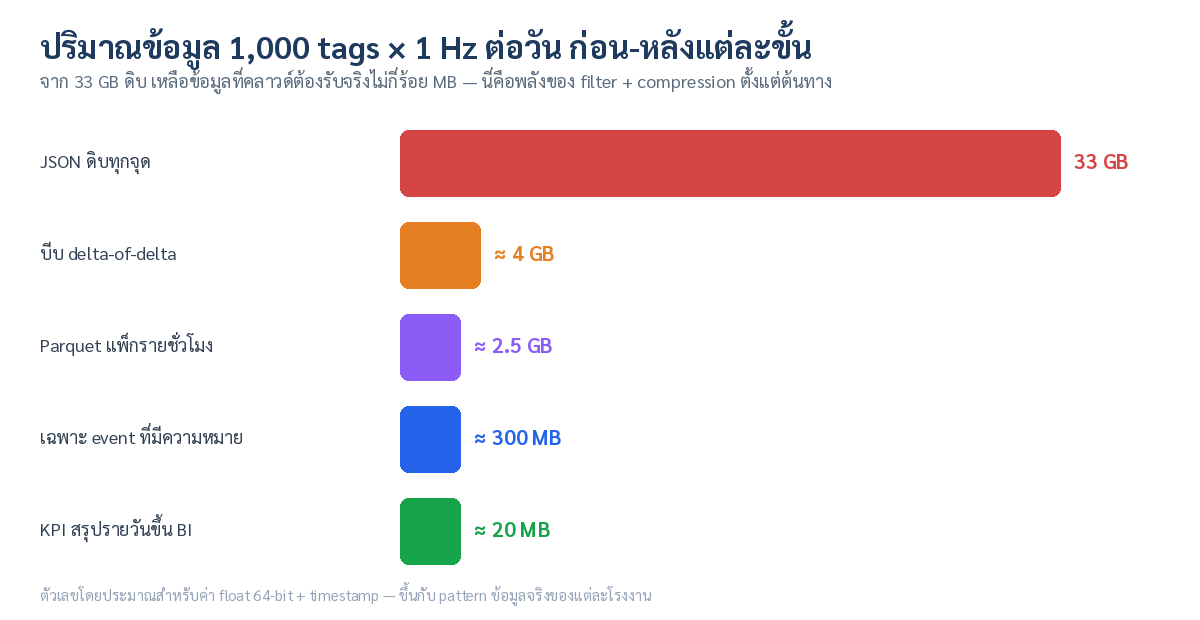
เริ่มจากคณิตศาสตร์ง่าย ๆ: โรงงานขนาดกลางที่มี 1,000 tags × 1 Hz (เช่น อุณหภูมิ ความดัน รอบมอเตอร์) จะผลิตข้อมูลดิบประมาณ 86.4 ล้านจุดต่อวัน ถ้าเก็บเป็น JSON ตรง ๆ ขนาดจะบวมถึง ~33 GB ต่อวัน — นี่คือเหตุผลที่ทุก pipeline จริงจำเป็นต้องมีทั้งการกรองและการบีบอัดตั้งแต่ต้นทาง
ขั้นที่ 2: RAM Ring Buffer — ด่านแรกที่ทุกคนมองข้าม
เมื่อข้อมูลไหลเข้า edge gateway จุดแรกที่มันจอดไม่ใช่ดิสก์ แต่เป็น RAM ring buffer เหตุผลคือความเร็ว: การเขียน SSD ทุกครั้งที่ข้อมูลมาถึงจะทำให้ SSD สึกเร็วผิดปกติ (write amplification) และทำให้ระบบรับ spike ของข้อมูลไม่ไหว รูปแบบที่ใช้กันคือเก็บใน RAM ก่อน 30-120 วินาที แล้วค่อย flush เป็นชุด (batch) ลง SSD
ขั้นที่ 3: บีบอัดด้วย Delta-of-Delta
เทคนิคที่ทำให้ time-series ของโรงงานบีบได้มากกว่าที่คิดคือการเก็บ “ผลต่างของผลต่าง” (delta-of-delta encoding) — เพราะค่าอุณหภูมิส่วนใหญ่ไม่เปลี่ยนระหว่างการ sample สองครั้งติดกัน การเก็บเป็น “เท่ากับครั้งก่อน” ใช้พื้นที่น้อยกว่าเก็บค่าเต็มหลายเท่า ในทางปฏิบัติ pipeline ของโรงงานส่วนใหญ่บีบจาก 33 GB/วัน เหลือ ~3-5 GB/วัน ก่อนส่งขึ้นคลาวด์
ขั้นที่ 4: แพ็กเป็นไฟล์ Parquet แล้ว Sync ขึ้น Object Storage
รูปแบบไฟล์แบบ columnar (เช่น Parquet) ทำให้การค้นข้อมูลย้อนหลังเร็วขึ้นมาก เพราะค้นเฉพาะคอลัมน์ที่ต้องการแทนที่จะไล่ทั้งแถว แล้วจึง sync ขึ้น object storage บนคลาวด์แบบ resumable — ถ้าอัปโหลดครึ่งทางแล้วเน็ตหลุด ระบบจะจำตำแหน่งไว้แล้วเริ่มต่อจากจุดเดิมเมื่อเน็ตกลับมา ไม่ต้องเริ่มส่งไฟล์ใหม่ทั้งไฟล์
ตาราง: นโยบายเก็บข้อมูลที่แนะนำตามชั้น
| ชั้นจัดเก็บ | ระยะเก็บแนะนำ | สิ่งที่เก็บ | เหตุผล |
|---|---|---|---|
| RAM ring buffer (Edge) | 30-120 วินาที | ข้อมูลดิบทุกจุด | ทน spike ไม่ทำ SSD สึก |
| SSD Edge Historian | 7-30 วัน | ข้อมูลดิบ + event | ค้นหน้างานได้ทันทีไม่ต้องรอคลาวด์ |
| Factory Server Disk | 90 วัน | ข้อมูลบีบอัด + aggregate | รองรับการหยุดของ WAN หลายวัน |
| Cloud Object Storage | 1-7 ปี | Parquet files + snapshot | การตรวจสอบย้อนหลัง + ML training |
| Cloud Data Warehouse | ไม่จำกัด | ข้อมูลสรุป KPI รายวัน/เดือน | BI ระดับบริษัท ข้ามหลายไซต์ |
บทเรียนจากหน้างาน: กฎที่ใช้ได้ดีในทางปฏิบัติคือ “ข้อมูลดิบเก็บสั้น ข้อมูลสรุปเก็บยาว” — อย่ากลับสูตร เพราะการเก็บข้อมูลดิบหลายปีบน storage ชั้น premium คือวิธีเผางบโดยไม่จำเป็น ในขณะที่การลบข้อมูลสรุปที่ใช้ทำ BI จะทำให้เสียความสามารถในการมองย้อนหลังทั้งระบบ
Honey Connection: จากหน้างานจริงของเรา
ทีมวิศวกรรมของ Honey Corporation ใช้หลักการ pipeline แบบนี้ในงานออกแบบระบบเก็บข้อมูลอุณหภูมิตู้แช่และห้องแช่สำหรับลูกค้าโรงงานอาหาร — จุดสำคัญที่เราพบคือความสัมพันธ์ระหว่างความถี่ในการ sample กับอายุการเก็บ: ยิ่ง sample ถี่ ยิ่งต้องออกแบบการบีบอัดให้ดีตั้งแต่ต้นทาง ไม่อย่างนั้น storage จะเต็มก่อนที่โปรเจกต์จะครบรอบปีแรก
Key Takeaways
- 1,000 tags × 1 Hz = ~33 GB/วัน ถ้าเก็บแบบดิบ — ต้องกรองและบีบอัดตั้งแต่ต้นทาง
- RAM ring buffer ก่อน SSD ลด write amplification และทน spike ได้
- Delta-of-delta encoding บีบ time-series ของโรงงานได้เหลือ ~10% ของขนาดเดิม
- Parquet + resumable sync ทำให้การอัปโหลดคลาวด์ไม่พังกลางทางเมื่อเน็ตหลุด
- ข้อมูลดิบเก็บสั้น ข้อมูลสรุปเก็บยาว — กฎที่กันงบบานปลายได้จริง
- ออกแบบนโยบาย retention ตามชั้น ตั้งแต่วันแรกของโปรเจกต์ ไม่ใช่หลัง storage เต็ม
Honey Corporation พร้อมให้คำปรึกษา
ทีมงานของเรามีความเชี่ยวชาญด้านการออกแบบ Data Pipeline และระบบเก็บข้อมูล IIoT สำหรับโรงงานอุตสาหกรรม พร้อมประเมินหน้างานและออกแบบนโยบายการจัดเก็บที่เหมาะกับธุรกิจของคุณ
📞 โทร: 09-23242995 | อีเมล: support@honey.co.th
เว็บไซต์: www.honey.co.th