
คำถามที่วิศวกรขายของทุกคนได้ยินบ่อยที่สุดจากโรงงาน: “เรามีเครื่องจักร 300 ตัว จะเริ่ม Predictive Maintenance ที่ตัวไหนก่อน” คำตอบที่ถูกต้องไม่ใช่ “ทั้งหมด” และไม่ใช่ “ตัวที่ดังที่สุด” แต่คือ ตัวที่ความเสียหายต่อธุรกิจสูงสุดเมื่อหยุด บทวิเคราะห์นี้เสนอมุมมองว่าทำไมหลายโครงการ PdM ถึงล้มเหลวเพราะเลือกเครื่องจักรผิด และกรอบวิธีคิด Criticality + Bad Actor ที่ใช้ได้จริงในสนาม
ทำไมโครงการ PdM จำนวนมากถึงตายกลางทาง
ลองนึกภาพโครงการที่ซื้อเซ็นเซอร์ 50 ชุดมาแจกกระจายทั่วโรงงานเพราะ “อยากให้ครบ” สามเดือนถัดมา Dashboard เต็มไปด้วยกราฟสวยงาม แต่ไม่มีใครรู้ว่าจะทำอะไรกับสัญญาณเตือนที่โผล่ขึ้นมา 42 รายการต่อสัปดาห์ อีกหกเดือน ทีมซ่อมบำรุงเริ่มมอง Dashboard เป็น “ตู้เย็นกระจก” — ดูได้แต่ไม่มีเวลาแก้ และโครงการจบลงด้วยคำพิพากษาว่า “PdM ไม่เวิร์ค” ทั้งที่ปัญหาจริงคือการกระจายทรัพยากรไปที่เครื่องจักรที่ไม่ควรเฝ้าตั้งแต่แรก
หลักคิดจากสนามจริง: เครื่องจักรที่ควรติดเซ็นเซอร์คือเครื่องที่ (1) ผลกระทบต่อการผลิตสูงเมื่อหยุด และ (2) มี Failure Mode ที่ตรวจจับได้ด้วยเทคโนโลยี ไม่ใช่เครื่องที่ “พังบ่อยที่สุด” — บางเครื่องพังบ่อยเพราะมันไม่สำคัญ ซ่อมเที่ยวละ 20 นาที มีตัวสำรอง
ขั้นที่ 1: ให้คะแนน Criticality ทุกเครื่อง
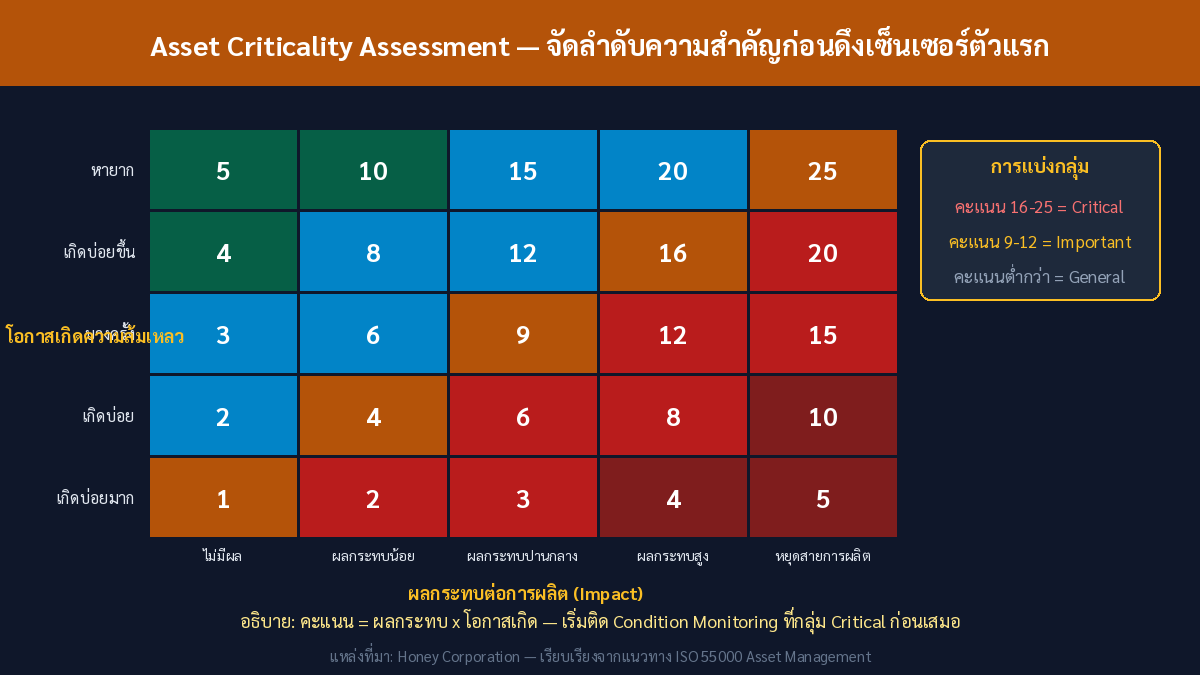
สร้างเมทริกซ์ 5×5 ระหว่าง “ผลกระทบต่อการผลิต” (จากไม่มีผล ถึงหยุดสายการผลิต) กับ “โอกาสเกิดความล้มเหลว” (จากหายาก ถึงเกิดบ่อยมาก) คะแนนคือผลคูณของสองแกน เครื่องที่ได้ 16–25 คือกลุ่ม Critical ที่ต้องได้เทคโนโลยีเฝ้าระวังก่อนใคร 9–12 คือกลุ่ม Important ที่ทำ Route-Based Monitoring พอ ที่เหลือปล่อย Run-to-Failure ได้อย่างมีเกียรติ
เกณฑ์ให้คะแนน “ผลกระทบ” ควรมาจากหลายมุม ไม่ใช่แค่ความเร็วในการซ่อม: มีเครื่องสำรองหรือไม่, หยุดแล้วกระทบสายการผลิตหรือคลังสินค้า, ความปลอดภัยและสิ่งแวดล้อม, ต้นทุนซ่อมทีเดียวจบหรือบานปลาย ส่วน “โอกาสเกิด” ดึงจากประวัติ CMMS 12 เดือนย้อนหลัง ไม่ใช่ความรู้สึกของช่างประจำเครื่อง
ขั้นที่ 2: Bad Actor Analysis ด้วย Pareto
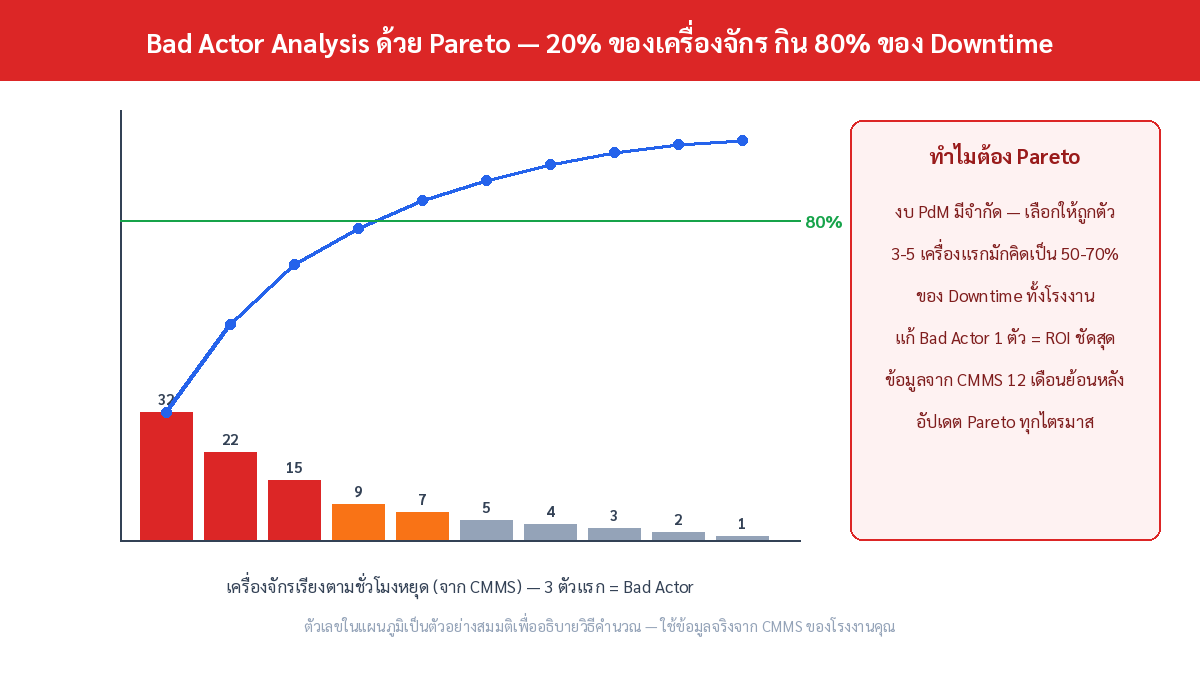
ส่งออกประวัติ Work Order 12 เดือนจาก CMMS มาคำนวณชั่วโมงหยุดต่อเครื่อง แล้วเรียงลำดับและสะสม ทุกครั้งที่เราทำกับลูกค้า ผลลัพธ์หน้าตาเหมือนกันหมด: 3–5 เครื่องแรกกินเวลาหยุด 50–70% ของทั้งโรงงาน กลุ่มนี้คือ Bad Actor ตัวจริง และเป็นเป้าหมายแรกที่คุ้มค่าที่สุดสำหรับการลงทุนเซ็นเซอร์และการวิเคราะห์เชิงลึก
จุดสำคัญที่มักถูกมองข้าม: Bad Actor ที่พัง “บ่อยแต่เบา” (เช่น ปั๊มขนาดเล็กที่สลับกับตัวสำรองได้) อาจไม่คุ้มติดเซ็นเซอร์ถาวร แต่คุ้มกับการแก้ที่ต้นเหตุ (Design Out) เช่น เปลี่ยนวัสดุอุปกรณ์ประกอบ หรือเปลี่ยนชนิดอุปกรณ์ไปเลย — Criticality บอกว่า “สำคัญแค่ไหน” ส่วน Pareto บอกว่า “เสียเวลามากแค่ไหน” ต้องใช้คู่กัน
ขั้นที่ 3: จับคู่กลยุทธ์บำรุงรักษาให้ถูกตัว
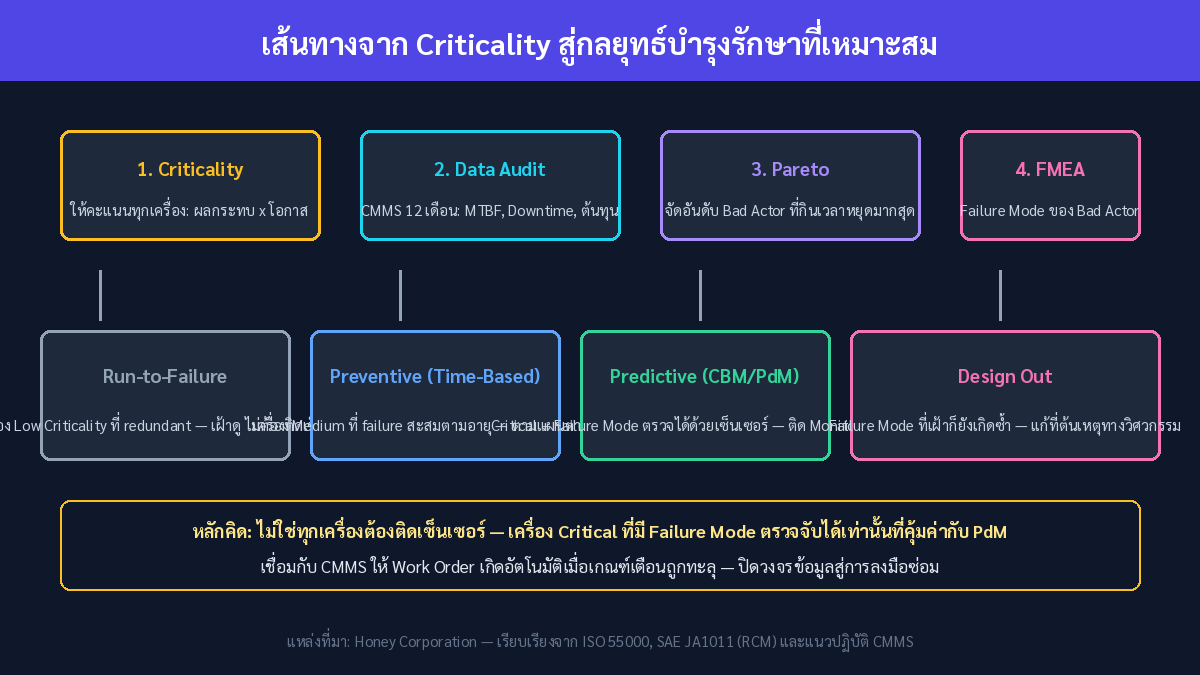
| กลุ่มเครื่องจักร | กลยุทธ์ที่เหมาะ | เครื่องมือหลัก |
|---|---|---|
| Critical + Failure Mode ตรวจจับได้ (แบริ่ง ความไม่สมดุล อุณหภูมิ) | Predictive (PdM/CBM) | เซ็นเซอร์ถาวร + Vibration/Thermal Analysis + แจ้งเตือนอัตโนมัติ |
| Critical + Failure Mode ตรวจไม่ได้ล่วงหน้า (เบรกกลไก ไฟกระชาก) | Preventive / Redundancy | ตรวจตามรอบ + ออกแบบสำรอง (N+1) ให้หยุดไม่กระทบสายการผลิต |
| Important (คะแนน 9–12) พังเป็นครั้งคราว | Condition-Based แบบ Route | เดินวัดด้วยเครื่องมือมือถือทุก 2–4 สัปดาห์ |
| General + มีตัวสำรอง ซ่อมเร็ว | Run-to-Failure | เก็บอะไหล่ยืนยันการสั่งซื้อ ไม่ต้องติดเซ็นเซอร์ |
| Bad Actor ที่พังซ้ำแม้เฝ้าดีแล้ว | Design Out | วิเคราะห์ RCA เปลี่ยนการออกแบบ/วัสดุ/ชนิดอุปกรณ์ |
มุมมองของเรา: เริ่มเล็ก พิสูจน์ค่า แล้วค่อยขยาย
จากประสบการณ์ติดตั้งระบบ IoT ให้โรงงานอุตสาหกรรม Honey Corporation เห็นแพทเทิร์นชัด: โครงการที่สำเร็จเริ่มจาก Bad Actor 2–3 ตัวแรก ทำให้เห็นค่าชัดเจน (เตือนก่อนพัง ประหยัดชั่วโมงหยุดจริง) แล้วขยายตามความพร้อมของทีม ไม่ใช่กระจายทั่วโรงงานตั้งแต่วันแรก ระบบเฝ้าระวังที่ดีต้องเชื่อมกับ CMMS ให้ Work Order เกิดอัตโนมัติเมื่อเกณฑ์เตือนถูกทะลุ — ปิดวงจรจากข้อมูลสู่การลงมือซ่อมโดยไม่ต้องรอมนุษย์คัดกรองเอง
Key Takeaways
- อย่าติดเซ็นเซอร์ทุกเครื่อง — เริ่มจากกลุ่ม Critical (คะแนน 16–25) ที่ Failure Mode ตรวจจับได้เท่านั้น
- Criticality มาจากผลกระทบ x โอกาส โดยพิจารณาความปลอดภัย สิ่งแวดล้อม และความมีตัวสำรอง ไม่ใช่แค่ความเร็วในการซ่อม
- Pareto จาก CMMS 12 เดือน เกือบทุกโรงงานพบว่า 3–5 เครื่องแรกกิน 50–70% ของ Downtime — นี่คือเป้าแรก
- Bad Actor ที่พังซ้ำแม้เฝ้าดีแล้ว ต้อง Design Out ด้วย RCA ไม่ใช่เพิ่มเซ็นเซอร์
- เชื่อมเข้า CMMS ให้ Work Order เกิดเอง เมื่อเกณฑ์เตือนถูกทะลุ — ข้อมูลที่ไม่นำไปสู่การลงมือคือภาระ ไม่ใช่สินทรัพย์
- อัปเดต Criticality และ Pareto ทุกไตรมาส — เครื่องจักรเปลี่ยนบทบาทตามสายการผลิต การจัดลำดับเมื่อวานอาจไม่ใช่คำตอบของวันนี้
Honey Corporation พร้อมให้คำปรึกษา
ทีมงานของเรามีความเชี่ยวชาญด้าน Asset Criticality Assessment และการออกแบบโครงสร้าง Predictive Maintenance ตั้งแต่การวิเคราะห์ CMMS จนถึงการติดตั้งเซ็นเซอร์และเชื่อมข้อมูลเข้าระบบเฝ้าระวัง
โทร: 09-23242995 | อีเมล: support@honey.co.th
เว็บไซต์: www.honey.co.th