
สถานการณ์สมมติที่กลายเป็นเรื่องจริงในโรงงานกระบวนการผลิตทั่วโลก: เครื่องคอมเพรสเซอร์หลัก Trip ตอนตี 2 ภายใน 90 วินาที ระบบ DCS ปล่อยสัญญาณเตือนราว 340 รายการ ลงหน้าจอ Operator เพียงคนเดียว ในจำนวนนั้นมีสัญญาณที่ต้องรีบทำอะไรสักอย่างอยู่ประมาณ 8 รายการเท่านั้น — แต่มันถูกกลบด้วย Alarm อีก 332 รายการที่เป็นแค่ “ผลพวง” ของเหตุการณ์เดียวกัน นี่คือ Alarm Flood ศัตรูตัวฉกาจของห้องควบคุม
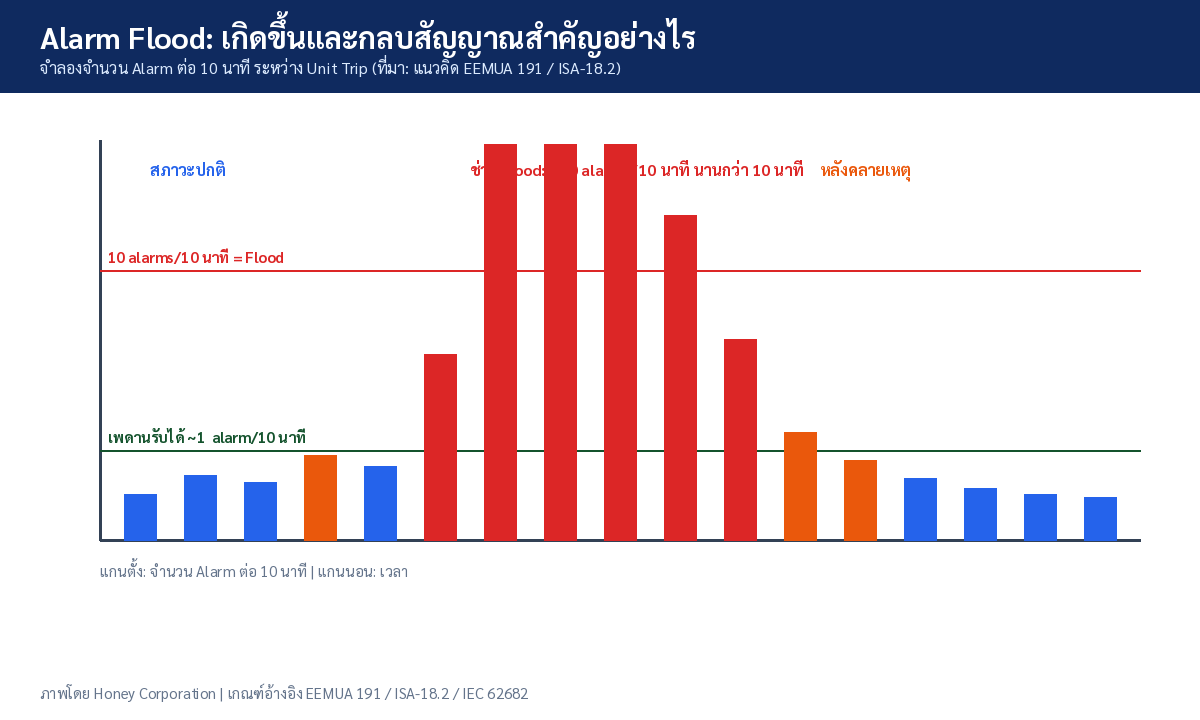
ปัญหา (Problem): ระบบ Alarm ที่โตเองตามอายุโรงงาน
สืบราวที่มาของ Flood ครั้งนี้พบรากปัญหาคลาสสิก 3 ข้อ:
- Alarm ถูกเพิ่มแต่ไม่เคยถูกลบ — ทุกครั้งที่เกิดปัญหา วิศวกรก็เพิ่ม Alarm ใหม่ “กันพลาด” สะสมมา 15 ปี จนเกิน 4,000 จุดในหนึ่ง Unit
- Priority ไม่สะท้อนความรุนแรงจริง — เกือบครึ่งถูกตั้ง High Priority เพราะ “กลัวคนไม่เห็น” ผลคือไม่มีอะไรเด่นเลย
- Standing Alarm ค้างข้ามคืน — ชุด Alarm เดิมค้างบนหน้าจอเป็นปกติ ทำให้สัญญาณใหม่กลืนหายไปกับของเก่า
ตัวเลขที่วัดได้ก่อนแก้ไข: Alarm เฉลี่ย 60 รายการต่อชั่วโมงต่อตำแหน่งงาน (เกณฑ์ EEMUA 191 แนะนำไม่เกิน ~1 รายการต่อ 10 นาที หรือราว 144-150 รายการต่อวันตามค่าอ้างอิงของ ISA-18.2 และ IEC 62682) และมีช่วง Flood ที่เกิน 10 รายการต่อ 10 นาทียาวนานกว่า 1 ชั่วโมงทุกครั้งที่มี Trip
วิธีแก้ (Solution): Rationalization ตาม Alarm Management Lifecycle
ทีมวิศวกรใช้กรอบ ISA-18.2 / IEC 62682 Alarm Management Lifecycle ซึ่งครอบคลุม 10 ขั้นตอนตั้งแต่กำหนด Philosophy, Identification, Rationalization, Detailed Design ไปจนถึง Audit — โดยเวทีหลักคือการ Rationalization ครั้งใหญ่:
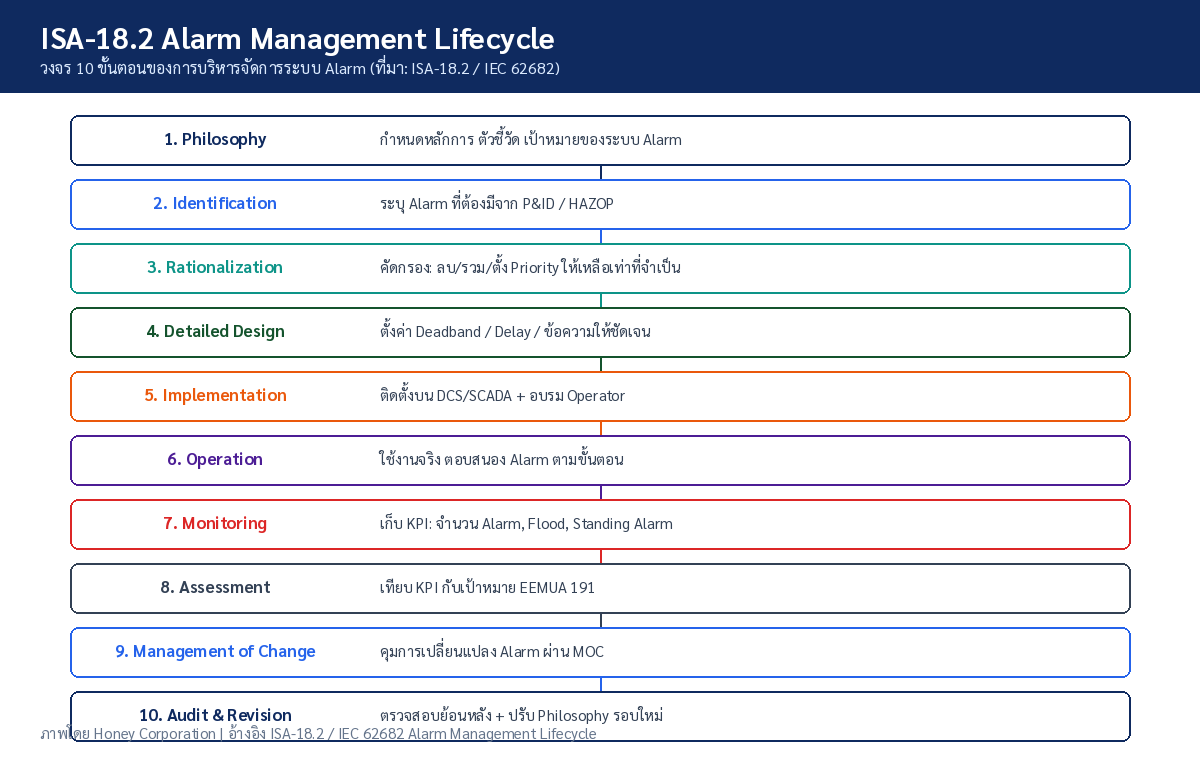
- ตั้งหลักการร่วมกัน (Philosophy) — นิยามว่า Alarm คืออะไร ต้องมี Action ของ Operator ชัดเจนเสมอ ไม่มี Action = ไม่ใช่ Alarm
- ไล่ทีละรายการ (Rationalization) — ทบทวน Alarm ทั้ง 4,000+ จุด ใช้เกณฑ์: มีสาเหตุที่เข้าใจได้ / มีผลกระทบต่อกระบวนการ / มี Action ชัดเจน / ไม่ซ้ำกับที่มีอยู่ ผลคือเหลือราว 1,100 จุด และจัด Priority ใหม่เป็น 3 ระดับตามระดับความเร่งด่วนของการตอบสนอง
- ออกแบบรายละเอียด (Detailed Design) — ตั้ง Deadband กัน Alarm สั่นระหว่างค่าขาด ๆ เกิน ๆ, ON-Delay สำหรับสัญญาณชั่วคราว, และเขียนข้อความให้บอก “อะไรเสีย ที่ไหน ต้องทำอะไร”
- จัดการ Flood เชิงรุก — ใช้เทคนิค Alarm Shelving (พัก Alarm ที่รู้สาเหตุแล้วชั่วคราว) และ Flood Suppression ที่รวมกลุ่ม Alarm ผลพวงให้แสดงเป็นเหตุการณ์เดียว
| ตัวชี้วัด (KPI) | ก่อนแก้ | หลังแก้ 6 เดือน | เกณฑ์อ้างอิง EEMUA 191 / ISA-18.2 |
|---|---|---|---|
| Alarm เฉลี่ย (ต่อชั่วโมง) | ~60 | ~8 | ไม่เกิน ~6 ต่อชั่วโมง (~144-150 ต่อวัน) |
| Standing Alarm ค้าง >24 ชม. | 40+ | <5 | น้อยกว่า 5-10 รายการ |
| ช่วง Flood (>10 ต่อ 10 นาที) | ทุกครั้งที่ Trip | ลดเวลาลง ~80% | ไม่ควรเกิน 1 ช่วงต่อวัน |
| สัดส่วน High Priority | ~45% | ~8% | แนะนำ ~5% |
ผลลัพธ์ (Results): ที่จริงคือเวลาตอบสนองที่เร็วขึ้น
ตัวเลข KPI ที่ดีขึ้นไม่ใช่จุดจบ แต่สิ่งที่วัดได้จริงคือ Mean Time to Respond — เวลาตั้งแต่สัญญาณสำคัญปรากฏจน Operator เริ่ม Action แรก ลดลงจากหลักนาทีเป็นหลักวินาที เพราะสัญญาณที่ต้องดำเนินการไม่ถูกกลบอีกต่อไป นี่คือเป้าหมายจริงของ ISA-18.2: ไม่ใช่ลดจำนวน Alarm ให้ตัวเลขสวย แต่คืนสมรรถภาพการตัดสินใจของ Operator ในจังหวะที่สำคัญที่สุด
Honey Corporation ให้บริการประเมินและปรับปรุงระบบ Alarm Management สำหรับโรงงานกระบวนการผลิต ตั้งแต่การเก็บสถิติ Alarm จาก DCS/SCADA การวิเคราะห์ KPI เทียบเกณฑ์สากล ไปจนถึงการ Rationalization และวางระบบ Monitoring ระยะยาว
Key Takeaways
- Alarm Flood คือปัญหาการออกแบบ ไม่ใช่ปัญหาอุปกรณ์ — เกิดจาก Alarm ที่สะสมโดยไม่มีการคัดกรอง
- เกณฑ์ที่วัดได้: เฉลี่ยไม่เกิน ~1 Alarm ต่อ 10 นาที, Flood = >10 ต่อ 10 นาทีนานเกิน 10 นาที, Standing Alarm <5-10 รายการ
- Rationalization ใช้เกณฑ์ 4 ข้อ: สาเหตุเข้าใจได้ / มีผลกระทบ / มี Operator Action / ไม่ซ้ำซ้อน
- Priority ที่ดีไม่ควรมี High เกิน ~5% — ถ้าทุกอย่างสำคัญ แปลว่าไม่มีอะไรสำคัญ
- ISA-18.2 Lifecycle 10 ขั้น บังคับให้ระบบถูกดูแลต่อเนื่อง ไม่ใช่โครงการครั้งเดียวจบ
- ตัวชี้วัดปลายทางคือ Mean Time to Respond ของ Operator ไม่ใช่จำนวน Alarm ที่ลดลง
Honey Corporation พร้อมให้คำปรึกษา
ทีมงานของเรามีความเชี่ยวชาญด้านระบบ Alarm Management และระบบควบคุมกระบวนการผลิตตามมาตรฐาน ISA-18.2 พร้อมประเมินระบบของคุณและวางแผนปรับปรุงให้เหมาะกับโรงงาน
📞 โทร: 09-23242995 | อีเมล: support@honey.co.th
เว็บไซต์: www.honey.co.th