
เรื่องนี้เล่าถึงโรงงานอาหารแห่งหนึ่งในนิคมอุตสาหกรรมภาคตะวันออก ที่เดิมใช้เกตเวย์ IoT แบบ standalone จำนวน 24 ตัวกระจายอยู่ทุกสายการผลิต แต่ละตัวเก็บค่าอุณหภูมิห้องเย็น ความชื้น และสถานะเครื่องจักร แล้วส่งขึ้นคลาวด์ผ่าน MQTT ทุกอย่างทำงานได้ดี… จนกระทั่งคืนหนึ่งที่เกตเวย์ตัวหนึ่งหยุดทำงานเพราะการ์ดหน่วยความจำเสีย และไม่มีใครรู้ตัวจนกระทั่งเช้าวันรุ่งขึ้น ข้อมูลห้องเย็นหายไป 7 ชั่วโมงเต็ม ซึ่งในธุรกิจอาหารแปลว่าต้องเขียนรายงานเหตุการณ์ deviation ยาวเหยียด และต้องประเมินความเสี่ยงต่อสินค้าที่เก็บในช่วงเวลานั้น
ปัญหา: ความล้มเหลวแบบเงียบ (Silent Failure)
การตรวจสอบย้อนหลังพบว่าปัญหาไม่ได้อยู่ที่ตัวเกตเวย์ แต่อยู่ที่สถาปัตยกรรม ระบบเดิมไม่มีกลไกใดตรวจจับว่าเกตเวย์ “ยังมีชีวิต” หรือไม่ และเมื่อเกตเวย์หนึ่งตัวตาย ก็ไม่มีตัวไหนรับหน้าที่แทน ทีมวิศวกรรมจึงเสนอแนวคิดที่ตอนนั้นดูเกินจำเป็นสำหรับโรงงานอาหาร นั่นคือการนำ container orchestration แบบ Kubernetes รุ่นเบา ลงมาวางที่ระดับสายการผลิต — ไม่ใช่เพื่อความสวยงามทางเทคนิค แต่เพื่อให้ได้สามอย่าง: self-healing, declarative configuration และ rollback ที่ทำได้ในไม่กี่วินาที
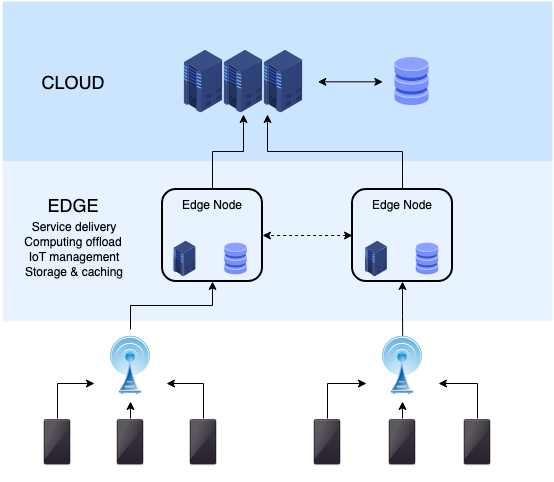
ทางออก: Single-node Cluster ที่ทุกสายการผลิต
แนวทางที่เลือกไม่ใช่คลัสเตอร์กลางขนาดใหญ่ แต่เป็น คลัสเตอร์เล็กๆ อยู่กับสายการผลิต แต่ละสายมี industrial computer ตั้งแต่ 2 โหนดขึ้นไป รัน Kubernetes distribution แบบ lightweight ที่ตัดส่วนประกอบที่ไม่จำเป็นออก ตัว workload หลักมีสามชนิด:
- Collector — อ่านค่าจาก PLC ผ่าน OPC UA และเซ็นเซอร์ผ่าน Modbus TCP เขียนลง local time-series storage
- Rule engine — ประเมินเงื่อนไข alarm เช่น อุณหภูมิห้องเย็นเกิน -18°C นานเกิน 10 นาที แล้วส่งแจ้งเตือนผ่านหลายช่องทาง
- Forwarder — ส่งข้อมูลแบบ batch ขึ้นคลาวด์ พร้อม store-and-forward เมื่อลิงก์หลุด
จุดเปลี่ยนที่สำคัญคือการตั้งค่า liveness/readiness probe ให้กับทุก workload — collector ที่ค้างไม่อ่านค่า PLC เกิน 60 วินาที จะถูก restart อัตโนมัติ และถ้าโหนดหนึ่งล้มทั้งตัว workload จะถูก reschedule ไปโหนดคู่ขนานภายในไม่กี่วินาที นี่คือสิ่งที่สถาปัตยกรรมเดิมไม่เคยมี
ผลลัพธ์ที่วัดได้
| ตัวชี้วัด | ก่อนปรับปรุง | หลังปรับปรุง |
|---|---|---|
| เวลารับรู้ว่าเกตเวย์เสีย | เฉลี่ย 2–7 ชั่วโมง (พอเช้ามาเห็น gap ในกราฟ) | < 60 วินาที (probe ล้มเหลว trigger restart + แจ้งเตือน) |
| ข้อมูลสูญหายเมื่อโหนดล้ม | ทั้งช่วงจนกว่าช่างจะเปลี่ยนอุปกรณ์ | เหลือเพียงช่วง reschedule ไม่กี่วินาที (workload ขยับไปโหนดคู่ขนาน) |
| เวลา deploy config ใหม่ทั้ง 24 สาย | 2–3 วัน (นั่งรีโมตทีละเครื่อง) | < 30 นาที (push ผ่าน GitOps pipeline เดียว) |
| การกู้คืนเมื่อ deploy พัง | ต้องจำว่าแก้อะไรไปก่อนหน้า | rollback เป็น revision เดิมได้ใน 1 คำสั่ง |
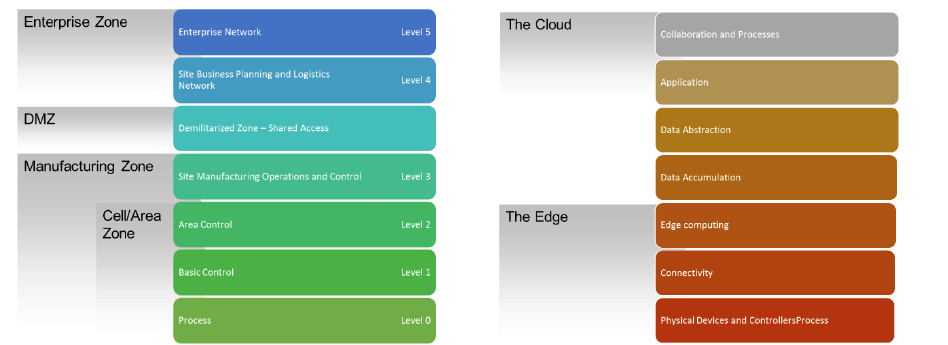
บทเรียนสำหรับโรงงานที่กำลังพิจารณา
หนึ่ง — อย่าเริ่มจากคลัสเตอร์ใหญ่กลางโรงงาน ให้เริ่มจากสายการผลิตเสี่ยงสูงสายเดียว พิสูจน์ pattern ให้เห็นผลจริงก่อน แล้วค่อยขยาย สอง — กำหนด eviction threshold ให้เหมาะกับฮาร์ดแวร์อุตสาหกรรม ค่า default ของ kubelet เช่น memory.available ต่ำกว่า 100Mi บน Linux ออกแบบมาสำหรับเซิร์ฟเวอร์ทั่วไป ไม่ใช่ industrial computer ที่หน่วยความจำจำกัดและต้องรันงานเรียลไทม์ สาม — วางแผนกลยุทธ์ node failure ให้ชัด ความจริงของ Kubernetes คือเมื่อโหนดทั้งตัวหายไป workload จะถูก reschedule หลังจากที่ control plane รอจนหมด grace period ที่กำหนดไว้ ซึ่งถ้าไม่ตั้งค่า อาจนานเกินความต้องการของงาน monitoring
ประสบการณ์จากงานติดตั้งจริงหลายไซต์ของทีม Honey Corporation สะท้อนบทเรียนเดียวกัน — เราเคยออกแบบระบบ IoT monitoring ให้ตู้แช่ Freezer และห้องเย็นของลูกค้าโรงงานอาหาร ที่ข้อกำหนดสำคัญที่สุดไม่ใช่ประสิทธิภาพ แต่คือ “ข้อมูลต้องไม่หายแม้ว่าอุปกรณ์จะเสีย” แนวทาง store-and-forward ร่วมกับ orchestration ที่ระดับสายการผลิตเป็นคำตอบที่พิสูจน์แล้วว่าได้ผลจริงในสภาพแวดล้อมโรงงานไทย
Key Takeaways
- Silent failure คือความเสี่ยงอันดับหนึ่ง ของระบบ IoT แบบ standalone — orchestration ให้ self-healing ผ่าน liveness/readiness probe
- Single-node หรือ 2-node cluster ต่อสายการผลิต เพียงพอสำหรับงาน collector/rule engine/forwarder ไม่จำเป็นต้องเริ่มใหญ่
- ปรับ eviction threshold ของ kubelet ให้เหมาะกับฮาร์ดแวร์อุตสาหกรรม ค่า default อย่าง memory.available<100Mi ไม่เหมาะกับทุกสภาพแวดล้อม
- Declarative config + GitOps ลดเวลา deploy ทั้ง 24 สายจาก 2–3 วันเหลือไม่ถึง 30 นาที พร้อม rollback ได้ทันที
- ข้อมูล HACCP/audit ต้องรอดแม้เน็ตหลุด — store-and-forward ที่ระดับ forwarder คือกันชนสุดท้ายของ compliance
Honey Corporation พร้อมให้คำปรึกษา
ทีมงานของเรามีความเชี่ยวชาญด้านระบบ Edge Computing และ Container Orchestration สำหรับโรงงานอุตสาหกรรม พร้อมออกแบบและติดตั้งระบบให้เหมาะกับธุรกิจของคุณ ทั้งการวางโหนด Edge ระดับสายการผลิต การเชื่อมต่อ PLC ผ่าน OPC UA และการออกแบบ data pipeline ที่ทนต่อการหลุดออฟไลน์
📞 โทร: 09-23242995 | อีเมล: support@honey.co.th
เว็บไซต์: www.honey.co.th