คำสารภาพจากวงการ: โรงงานไม่ได้ขาดข้อมูล — โรงงานจมอยู่ในข้อมูล
ตลอดหลายปีที่ผ่านมา วงการอุตสาหกรรมพูดเรื่อง “Data Lake” กันจนเป็นมาตรฐาน คำสัญญาฟังดีเสมอ: ทุกอย่างไหลมารวมที่เดียว ทีมวิเคราะห์เปิดมาใช้ได้ทันที การตัดสินใจยึดตามข้อมูล แต่หลังจากที่ทีม Honey Corporation ได้เข้าไปประเมินแพลตฟอร์มข้อมูลของโรงงานหลายสิบแห่ง เราพบว่าคำถามที่แท้จริงของปี 2026 ไม่ใช่ “เราจะเก็บข้อมูลอย่างไร” อีกต่อไป แต่คือ “ทำไมข้อมูลที่เก็บมาทั้งหมดนี้ ไม่มีใครกล้าใช้”
นี่คือบทวิเคราะห์มุมมองของเราต่อปรากฏการณ์ “Data Swamp” — ทะเลข้อมูลที่เน่าเสียเพราะไม่มีใครรู้ว่าข้อมูลแต่ละก้อนมาจากไหน หมายถึงอะไร และเชื่อถือได้แค่ไหน
อาการสามข้อที่บอกว่าโรงงานคุณกำลังกลายเป็นหนองน้ำข้อมูล
จากประสบการณ์เข้าประเมินงานจริง เราสรุปอาการวินิจฉัยได้ 3 ข้อ:
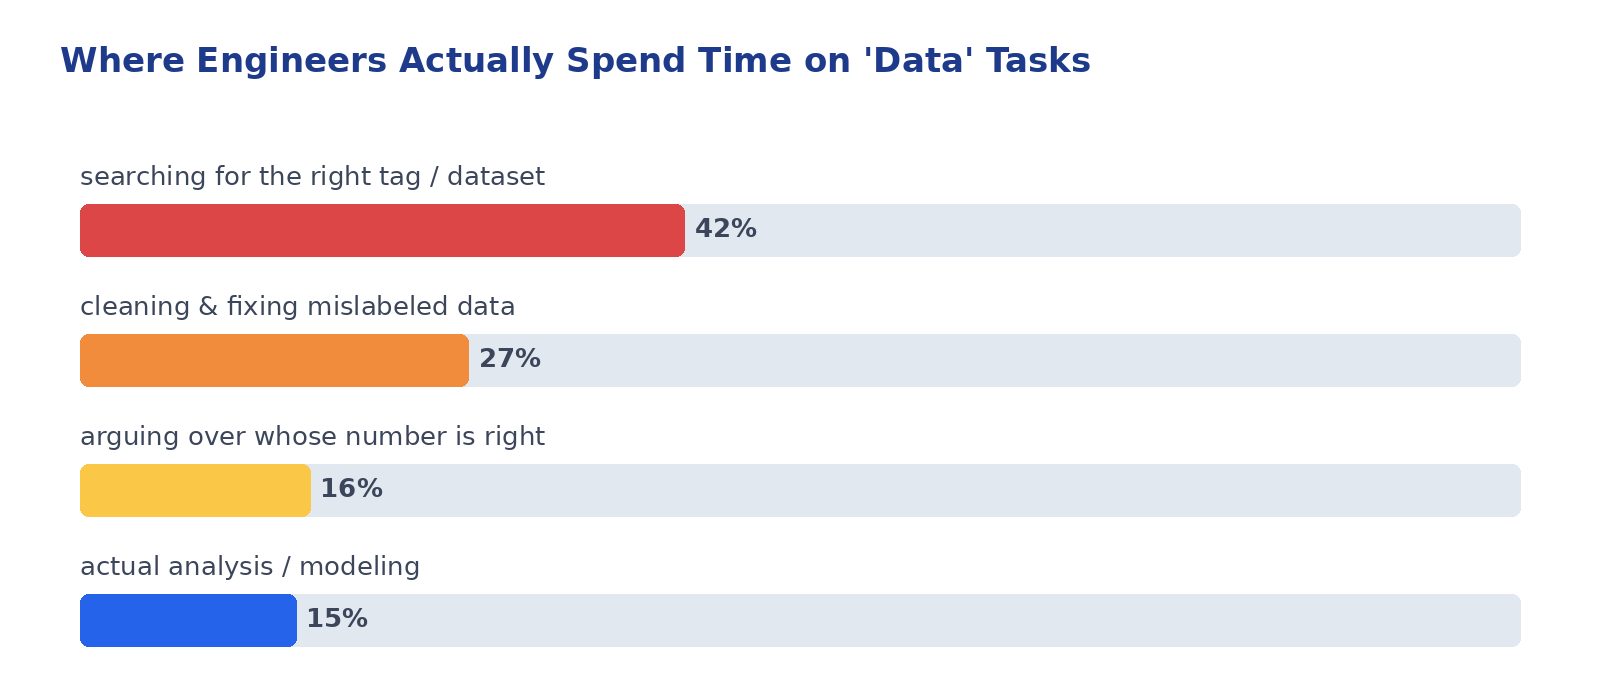
อาการที่ 1: หา tag ไม่เจอ — วิศวกรอยากรู้อุณหภูมิถังหมัก B-7 เมื่อสัปดาห์ก่อน แต่ไม่รู้ว่าในระบบมีชื่อจุดวัดกว่า 40,000 รายการ กระจายอยู่ในเซิร์ฟเวอร์เก็บข้อมูล 4 ตัว จะค้นด้วยคำว่าอะไร ระบบตั้งชื่อโดยผู้รับเหมาเก่าสมัย 8 ปีก่อนด้วยรูปแบบที่ไม่มีเอกสารอธิบาย เวลาที่ใช้หาแค่จุดวัดเดียวกินไปเกือบ 45 นาที ผลคือเขาเลือกที่จะติดเทอร์มอมิเตอร์มือถีบขึ้นไปวัดเอง แล้วบันทึกในสมุด — เทคโนโลยีที่ลงทุนมาทั้งระบบย้อนกลับไปเป็นกระดาษ
อาการที่ 2: ตัวเลขเดียว สามคำตอบ — ปริมาณผลิตเมื่อวานบนหน้าจอเฝ้าระวัง ในรายงานสรุปประจำวัน และในไฟล์นำเสนอฝ่ายบริหาร ให้ค่าสามค่าที่ไม่เท่ากัน ต่างกัน 1-3% ทั้งที่มาจากทะเลข้อมูลก้อนเดียวกัน ต้นเหตุมักตื้นๆ นิดเดียว: เขตเวลาที่ใช้ต่างกัน การปัดเศษต่างกัน หรือนิยาม “ชิ้นงานดี” ต่างกันตามคนเขียน query แต่ผลลัพธ์คือความเชื่อมั่นที่ตาย
อาการที่ 3: โครงการ AI ตายก่อนเกิด — ทีมข้อมูลวิเคราะห์ว่าปัญหาคุณภาพที่เกิดซ้ำมาเป็นเวลา 6 เดือนน่าจะมาจากอุณหภูมิ แต่ตอนจะหยิบข้อมูลมาสอนโมเดล พบว่าข้อมูลช่วงที่สนใจมีช่องว่างหายไปถึง 8 เดือน จากจุดวัดราว 300 tags เพราะเกตเวย์ของเครื่องจักรตัวหนึ่งถูกปิดการเก็บไปตั้งแต่ครั้งทำโครงการย้ายระบบ และไม่มีใครรู้ตัวเพราะไม่มีการเฝ้าระวังความครบถ้วนของข้อมูล โมเดลที่ดีที่สุดในโลกก็ไม่มีทางเรียนรู้จากข้อมูลที่ไม่มีอยู่
มุมมองของเรา: ปัญหาไม่ได้อยู่ที่เทคโนโลยี — แต่อยู่ที่สิ่งที่ถูกละเลย
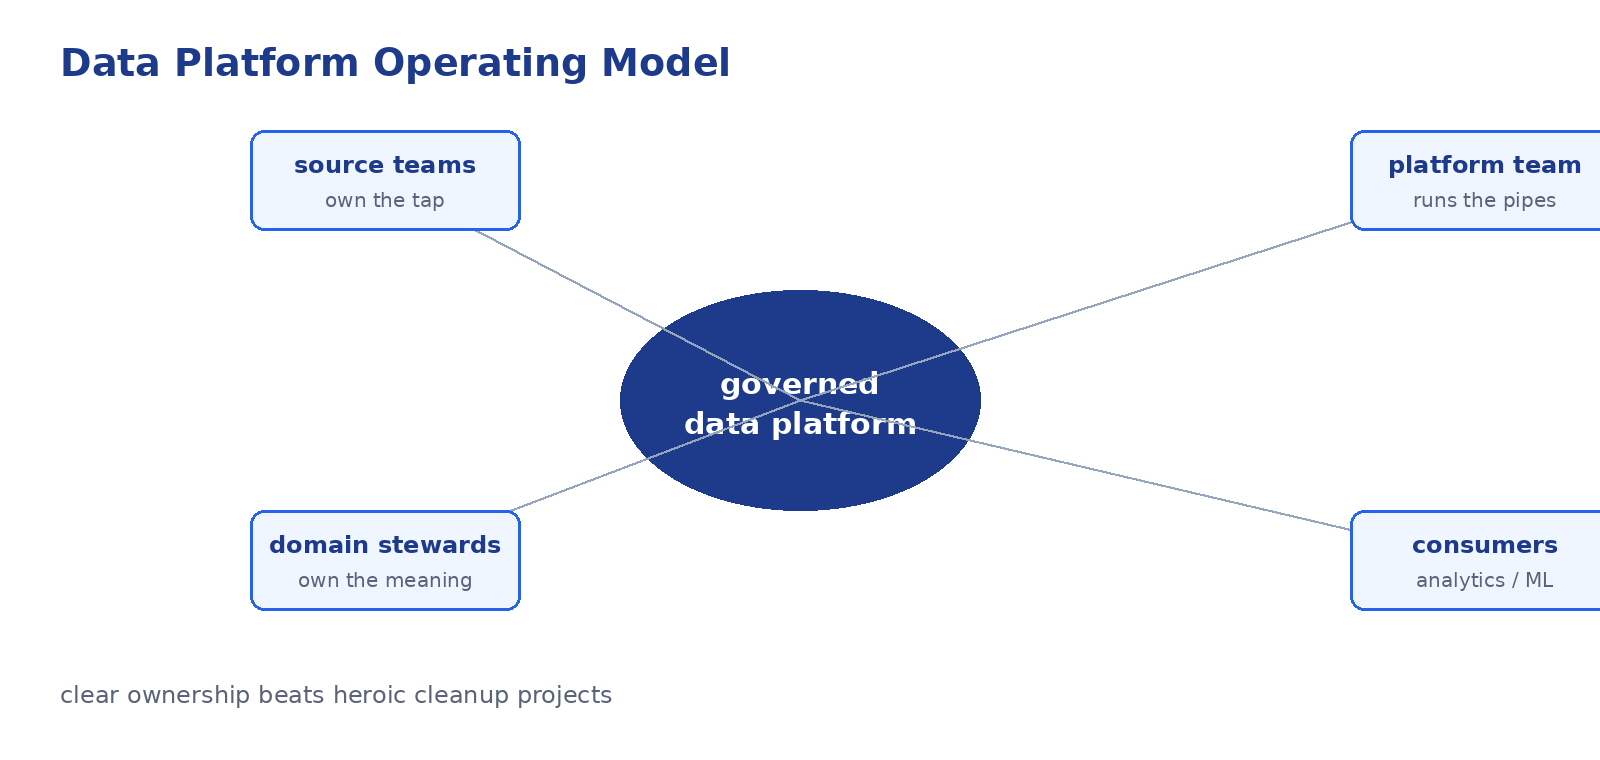
ถ้าถามว่าอะไรทำให้ทะเลข้อมูลกลายเป็นหนองน้ำ เราจะตอบไม่ใช่เพราะเลือกฐานข้อมูลผิด แต่เพราะสามสิ่งที่ทุกโครงการรู้ว่าสำคัญแต่ไม่มีใครทำ เพราะ “ไม่มีเวลา”:
- Metadata และการตั้งชื่อที่มีความหมาย — ข้อมูลที่ไม่มีบริบท (เครื่องไหน หน่วยอะไร ใครเป็นเจ้าของ อัปเดตล่าสุดเมื่อไร) ไม่ใช่ข้อมูล มันคือไบต์ที่กินพื้นที่
- ความต่อเนื่องของท่อข้อมูล — การตรวจว่าข้อมูลยังไหลครบทุกจุดวัดเหมือนเมื่อวาน เป็นงานประจำวันที่ต้องมีระบบ ไม่ใช่ความทรงจำของวิศวกรคนเดียว
- เจ้าของข้อมูลที่มีตัวตน — เมื่อเกิดคำถามว่าตัวเลขนี้น่าเชื่อไหม ต้องมีชื่อคนที่ตอบได้ ไม่ใช่ “ฝ่ายไอที” หรือ “ผู้รับเหมาเก่า”
| มิติ | หนองน้ำข้อมูล (Data Swamp) | แพลตฟอร์มข้อมูลที่มีชีวิต |
|---|---|---|
| การค้นหา | ต้องรู้ชื่อไฟล์/คนถาม หรือเดา | ค้นจากความหมายและตำแหน่ง เจอในไม่กี่วินาที |
| ความน่าเชื่อถือ | ตัวเลขเดียวหลายค่า ต้องเลือกเฟเวอริตกันเอง | แหล่งความจริงเดียวต่อชุดข้อมูล พร้อมที่มาชัดเจน |
| การตรวจสุขภาพ | รู้ตัวเมื่อมีคนมาขอใช้ (หรือไม่รู้เลย) | เฝ้าระวังความครบถ้วนต่อเนื่อง เตือนเมื่อขาด |
| ผู้รับผิดชอบ | ไม่มีใคร หรือ “ทุกคน” | เจ้าของข้อมูลรายชื่อ พร้อมช่องทางติดต่อ |
| การเติบโต | ยิ่งเก็บยิ่งเน่า ต้นทุนโต มูลค่าลด | ยิ่งใช้ยิ่งดี ข้อมูลใหม่เข้าอย่างมีระเบียบตั้งแต่วันแรก |
จุดยืนของ Honey Corporation: เริ่มที่ “ข้อมูลหนึ่งชุด” ไม่ใช่ “ทั้งทะเล”
ในงานประเมินและออกแบบแพลตฟอร์มข้อมูลให้ลูกค้า เราไม่เคยเริ่มโครงการด้วยการเลือกเทคโนโลยีระดับพระเอก แต่เริ่มด้วยคำถามธุรกิจที่จับต้องได้หนึ่งข้อ เช่น “อยากลดการสูญเสียคุณภาพของไลน์บรรจุ” แล้วไล่ย้อนกลับไปว่าข้อมูลชุดไหนที่จำเป็น ต้องมีคุณภาพระดับไหน ใครเป็นเจ้าของ และเก็บพอดีๆ ไม่เกินจำเป็น — วิธีนี้ทำให้ทุกบาทที่ลงไปกับโครงสร้างพื้นฐานข้อมูลผูกกับผลลัพธ์ที่วัดได้ ไม่ใช่ศรัทธา
เราเชื่อว่าโรงงานไทยจำนวนมากไม่ได้ต้องการแพลตฟอร์มข้อมูลขนาดยักษ์แบบบรรษัทข้ามชาติ แต่ต้องการระบบข้อมูลที่เล็กพอ สะอาดพอ และมีเจ้าของชัดพอที่จะตอบคำถามธุรกิจที่สำคัญที่สุดของตัวเองในวันนี้ แล้วค่อยขยายตามความจำเป็นจริง หนองน้ำไม่ได้เกิดจากการเก็บข้อมูลน้อยเกินไป — มันเกิดจากการเก็บโดยไม่มีคำถาม
Key Takeaways
- สัญญาณเตือนที่แท้จริงของ Data Swamp คือพฤติกรรมคน — เมื่อวิศวกรเลือกใช้เทอร์มอมิเตอร์แทนระบบหลายล้าน นั่นคือจุดที่ต้องย้อนกลับมาดูรากของปัญหา ไม่ใช่ซื้อเครื่องมือเพิ่ม
- ข้อมูลไม่มีบริบท = ไม่มีมูลค่า — การลงทุนใน metadata การตั้งชื่อที่มีความหมาย และทะเบียนข้อมูล ให้ผลตอบแทนสูงกว่าการเพิ่มความจำหรือซื้อฐานข้อมูลใหม่เสมอ
- ตัวเลขเดียวหลายค่ามาจากการไม่มีแหล่งความจริงเดียว — กำหนดเจ้าของข้อมูลรายชุดให้ชัด ปัญหานี้จะหายไปเองส่วนใหญ่
- ความต่อเนื่องของข้อมูลต้องถูกเฝ้าระวัง ไม่ใช่ถูกคาดหวัง — การมีช่องว่างข้อมูล 8 เดือนโดยไม่มีใครรู้ คือความเสี่ยงที่ฆ่าโครงการ AI เงียบๆ
- เริ่มจากคำถามธุรกิจหนึ่งข้อเสมอ — แพลตฟอร์มที่โตจากความจำเป็นจริงจะแข็งแรงกว่าแพลตฟอร์มที่สร้างล่วงหน้าเพื่อรอความฝันเสมอ
- ความเล็กที่มีระเบียบ ชนะความใหญ่ที่ไร้ระเบียบ — เป้าหมายปี 2026 ของโรงงานส่วนใหญ่ไม่ใช่ Data Lake ที่ใหญ่ที่สุด แต่คือข้อมูลที่ทีมกล้าใช้และเชื่อได้ทุกวัน
Honey Corporation พร้อมให้คำปรึกษา
ทีมงานของเรามีความเชี่ยวชาญด้านการออกแบบแพลตฟอร์มข้อมูลอุตสาหกรรมและการวางระบบธรรมาภิบาลข้อมูลโรงงาน (Industrial Data Platform and Governance) พร้อมช่วยประเมินสุขภาพข้อมูลของคุณ จัดลำดับความสำคัญของชุดข้อมูล และวางรากฐานที่ทีมของคุณเชื่อถือและใช้งานได้จริงทุกวัน
📞 โทร: 09-23242995 | อีเมล: support@honey.co.th
เว็บไซต์: www.honey.co.th