
โมเดล AI ทำนายความเสียหายของเครื่องจักรได้แม่นระดับ 90%+ แต่พอถูกถามว่า “ทำไมถึงบอกว่าเครื่องนี้เสี่ยง” กลับตอบไม่ได้ — นี่คือปัญหา black box ที่ทำให้ AI จำนวนมากติดอยู่ใน pilot ไม่มีวันถูกใช้จริงในสายการผลิต วิศวกรซ่อมบำรุงจะไม่มีวันเชื่อคำสั่งหยุดเครื่องที่ไม่มีเหตุผลรองรับ และผู้จัดการโรงงานก็ไม่กล้าเสี่ยงตัดสินใจตามตัวเลขที่อธิบายไม่ได้ บทความนี้เป็นคู่มือปฏิบัติ 5 ขั้นตอน สำหรับเพิ่มความโปร่งใสให้โมเดล predictive maintenance ด้วยเทคนิค Explainable AI (XAI)
ปัญหา: ความแม่นยำไม่ใช่ข้ออ้างของความไว้วางใจ
สถานการณ์มาตรฐานที่เราพบบ่อย: ทีม data scientist สร้างโมเดล gradient boosting ทำนายความเสี่ยงแบริ่งพังใน 14 วัน ได้ F1 สูงมากใน test set แต่พอ deploy จริง ช่างเทคนิคกลับแค่ “ดูเลข” แล้วเดินผ่าน เพราะโมเดลไม่เคยบอกว่าสัญญาณมาจากไหน — ความร้อน? การสั่น? หรือค่าไฟฟ้าที่ปนเปื้อน? ผลคือระบบถูกละเลยจนถูกถอดออกในที่สุด
งานวิจัยด้าน XAI ในภาคอุตสาหกรรมชี้ตรงกันว่า การนำ AI ไปใช้กับงาน maintenance ล้มเหลวไม่ใช่เพราะโมเดลไม่แม่น แต่เพราะ คนในสายการผลิตไม่มีเครื่องมือตรวจสอบเหตุผลของโมเดลได้ ซึ่ง XAI แก้ปัญหานี้ตรงจุด
2 เทคนิคหลัก: LIME และ SHAP
โมเดล gradient boosting หรือ neural network รุ่นใหม่แม่นกว่า linear model มาก แต่แลกมาด้วยความอธิบายไม่ได้ XAI จึงเข้ามาเป็น “สะพาน” ระหว่างความแม่นกับความเข้าใจ:
- LIME (Local Interpretable Model-agnostic Explanations) — สร้างโมเดลลินแมร์ตัวจิ๋วมาลอกเลียนพฤติกรรมของโมเดลใหญ่ “ในบริเวณใกล้” การทำนายหนึ่งๆ แล้วอ่านค่าสัมประสิทธิ์ จะรู้ทันทีว่า feature ไหนดันความน่าจะเป็นขึ้น ตัวไหนฉุดไว้
- SHAP (SHapley Additive exPlanations) — ยืมแนวคิด Shapley value จากทฤษฎีเกม คำนวณ “ส่วนแบ่งความดีความชั่ว” ของ feature แต่ละตัวอย่างเป็นธรรม โดยเฉลี่ยผลจากทุก combination ที่เป็นไปได้ ให้ค่าที่ consistent และมีหลักทฤษฎีรองรับ
คู่มือ 5 ขั้นตอน: ทำ XAI ให้โมเดล Predictive Maintenance
ขั้นที่ 1 — จัดระเบียบ feature ให้เป็นภาษาคนห้องเครื่อง
อย่าป้อนค่า raw เช่น “rms_vib_6kHz_band_3” เข้าโมเดลแล้วคาดหวังว่า XAI จะอธิบายได้ ให้แปลง feature ให้ตรงกับสิ่งที่ช่างเห็นจริง: อุณหภูมิแบริ่งฝั่ง DE/NDE, ค่า overall vibration แนว radial/axial, envelope ความผิดปกติของลูกกลิ้ง, ค่ากระแสมอเตอร์ ชื่อ feature ที่อ่านแล้วเข้าใจทันที คือครึ่งหนึ่งของความโปร่งใส
ขั้นที่ 2 — คำนวณ SHAP ทุกครั้งที่โมเดลทำนาย
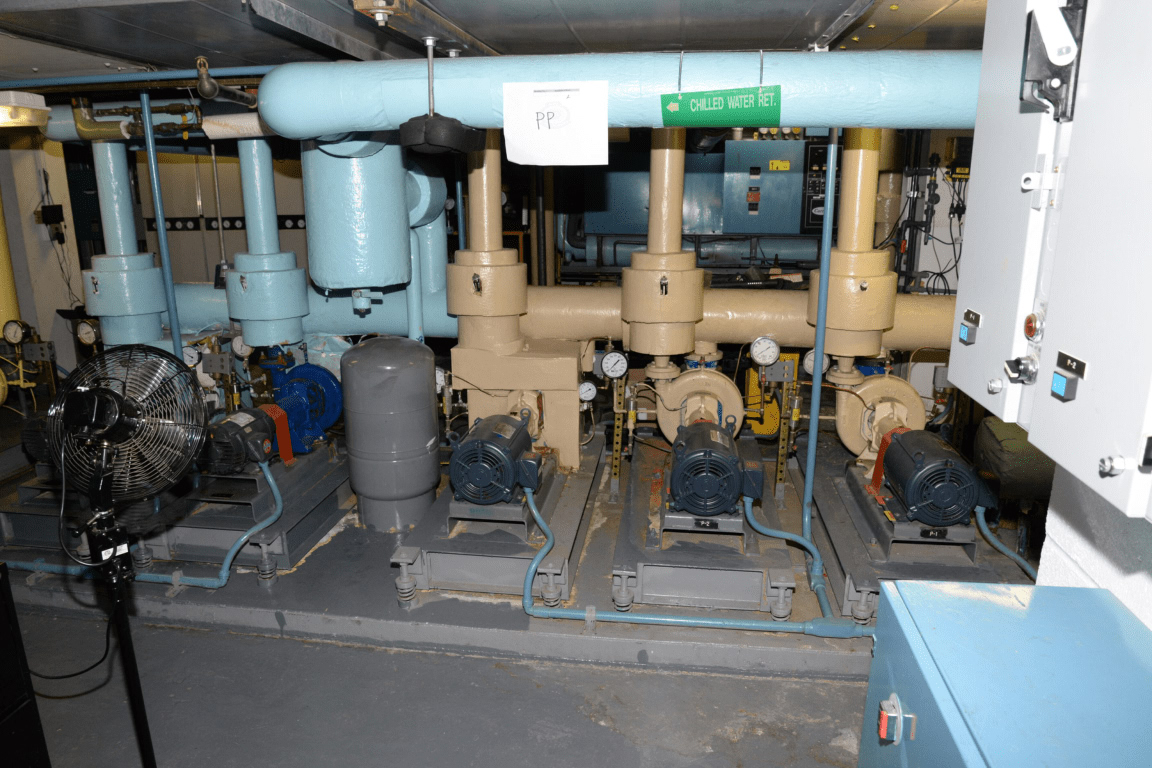
เมื่อโมเดลแจ้งเตือนว่า “ปั๊ม P-204 เสี่ยงสูง” ให้ระบบคำนวณ SHAP values ของการทำนายนั้นๆ พร้อมกันไปเลย แล้วแสดงเป็นแถบสี: แดง = ดันความเสี่ยงขึ้น, น้ำเงิน = ฉุดความเสี่ยงลง เรียงจากแรงไปอ่อน ช่างเห็นแล้วเข้าใจได้ใน 3 วินาทีว่า “อ๋อ ความร้อนฝั่ง NDE ผิดปกติมา 3 วัน บวกกับ envelope สูงขึ้น 40%”
ขั้นที่ 3 — ตรวจ cross-check กับ vibration domain knowledge
ค่า SHAP ไม่ใช่ความจริงสุดท้าย แต่คือสมมติฐานที่ตรวจสอบได้ ถ้า SHAP บอกว่า “แถบความถี่ 1× เด่นสุด” ช่างจะนึกถึง unbalance ทันที, 2× เด่น = misalignment, high-frequency envelope = bearing defect นี่คือจุดที่ XAI กับ domain knowledge เสริมกันเป็นวงจร: AI ชี้เป้า → ช่างตรวจยืนยัน → ข้อมูล feedback กลับไปปรับโมเดล
ขั้นที่ 4 — ทำ summary report ต่อเดือน
นอกจาก explanation รายเหตุการณ์ ให้รวบรวม SHAP values ทั้งเดือนเป็น global view: อะไรคือ driver หลักของการเตือนทั้งโรงงาน? ถ้าพบว่า 60% ของการเตือนมาจาก sensor ตำแหน่งเดิมซ้ำๆ อาจถึงเวลาวางเซ็นเซอร์เพิ่มหรือทำ sensor fusion ใหม่
ขั้นที่ 5 — ทำ XAI report เป็นส่วนหนึ่งของ maintenance decision
สุดท้าย ผูก explanation เข้ากับ workflow จริง: work order ที่สร้างจาก AI ต้องแนบ SHAP summary ไปด้วย ผู้อนุมัติงานหยุดเครื่องเห็นเหตุผลก่อนเซ็น ไม่ใช่เชื่อกันปากเปล่า
เปรียบเทียบเครื่องมือ XAI ที่ควรรู้
| เครื่องมือ | หลักการ | จุดแข็ง | ข้อจำกัด |
|---|---|---|---|
| SHAP | Shapley value จากทฤษฎีเกม | consistent มีทฤษฎีรองรับ มี TreeSHAP คำนวณเร็ว | ช้ากับโมเดลใหญ่/feature เยอะ (ถ้าไม่ใช่ tree) |
| LIME | local surrogate model | เร็ว ใช้ได้กับทุกโมเดล ง่ายต่อการเริ่มต้น | ผลไม่เสถียร ขึ้นกับ sampling แต่ละรอบ |
| Perm. Importance | สลับค่า feature แล้ววัดผลกระทบ | เข้าใจง่าย เหมาะทำ global view | biased กับ correlated features |
| Grad-CAM | gradient ของ heatmap บนภาพ | เห็น “ตำหนิอยู่ตรงไหนของภาพ” | ใช้ได้เฉพาะงาน computer vision |
ข้อควรระวัง: XAI ไม่ใช่เครื่องพิสูจน์ความจริง
สิ่งสำคัญที่ต้องย้ำ: explanation ที่สวยงามไม่ได้แปลว่าถูกต้อง SHAP บอกว่า “โมเดลตัดสินใจเพราะอะไร” ไม่ใช่ “ความจริงทางฟิสิกส์คืออะไร” ถ้าเซ็นเซอร์ drift หรือมี data leakage ตอนเทรน ค่า SHAP จะอธิบาย “ความผิดพลาด” ได้ลื่นไหลเช่นกัน ดังนั้น XAI ต้องคู่กับ data governance และการ validate โมเดลเป็นระยะ ไม่ใช่ตัวแทนของการตรวจสอบ
Key Takeaways
- ความล้มเหลวของ AI ในงาน maintenance ส่วนใหญ่ไม่ใช่เรื่องความแม่น แต่เป็นเรื่อง ความไว้วางใจ — และความไว้วางใจซื้อไม่ได้ ต้องอธิบายได้
- SHAP ยืม Shapley value จากทฤษฎีเกม ให้ explanation ที่ consistent ที่สุดในบรรดาเทคนิค XAI ปัจจุบัน
- LIME เร็วและใช้ได้กับทุกโมเดล แต่ผลอาจไม่เสถียรขึ้นกับ sampling — เหมาะเป็นจุดเริ่มต้น
- แปลงชื่อ feature ให้เป็นภาษาของช่างห้องเครื่องก่อน — ความโปร่งใสครึ่งหนึ่งมาจากการตั้งชื่อ
- อ่าน SHAP คู่กับ domain knowledge (1× unbalance, 2× misalignment, envelope = bearing) เพื่อยืนยัน root cause
- แนบ XAI report ใน work order จริง — ให้ explanation กลายเป็นส่วนหนึ่งของ decision chain ไม่ใช่ dashboard สวยๆ ที่ไม่มีใครเปิด
- XAI อธิบายเหตุผลของโมเดล ไม่ใช่ความจริงของโลก — ยังต้องคู่กับ data validation เสมอ
ในงานติดตั้งจริง ทีม Honey Corporation ให้ความสำคัญกับการออกแบบ data pipeline ที่ตั้งชื่อ signal และ tag ให้สอดคล้องกับสภาพจริงของเครื่องจักรตั้งแต่แรก เพราะเข้าใจดีว่าโมเดล AI จะอธิบายได้ดีแค่ไหน ขึ้นอยู่กับคุณภาพของ “ภาษา” ที่เราฝังลงไปในข้อมูลตั้งแต่วันแรกของโครงการ
Honey Corporation พร้อมให้คำปรึกษา
ทีมงานของเรามีความเชี่ยวชาญด้านระบบ Predictive Maintenance และ Condition Monitoring พร้อมออกแบบและติดตั้งระบบให้เหมาะกับธุรกิจของคุณ
📞 โทร: 09-23242995 | อีเมล: support@honey.co.th
เว็บไซต์: www.honey.co.th