
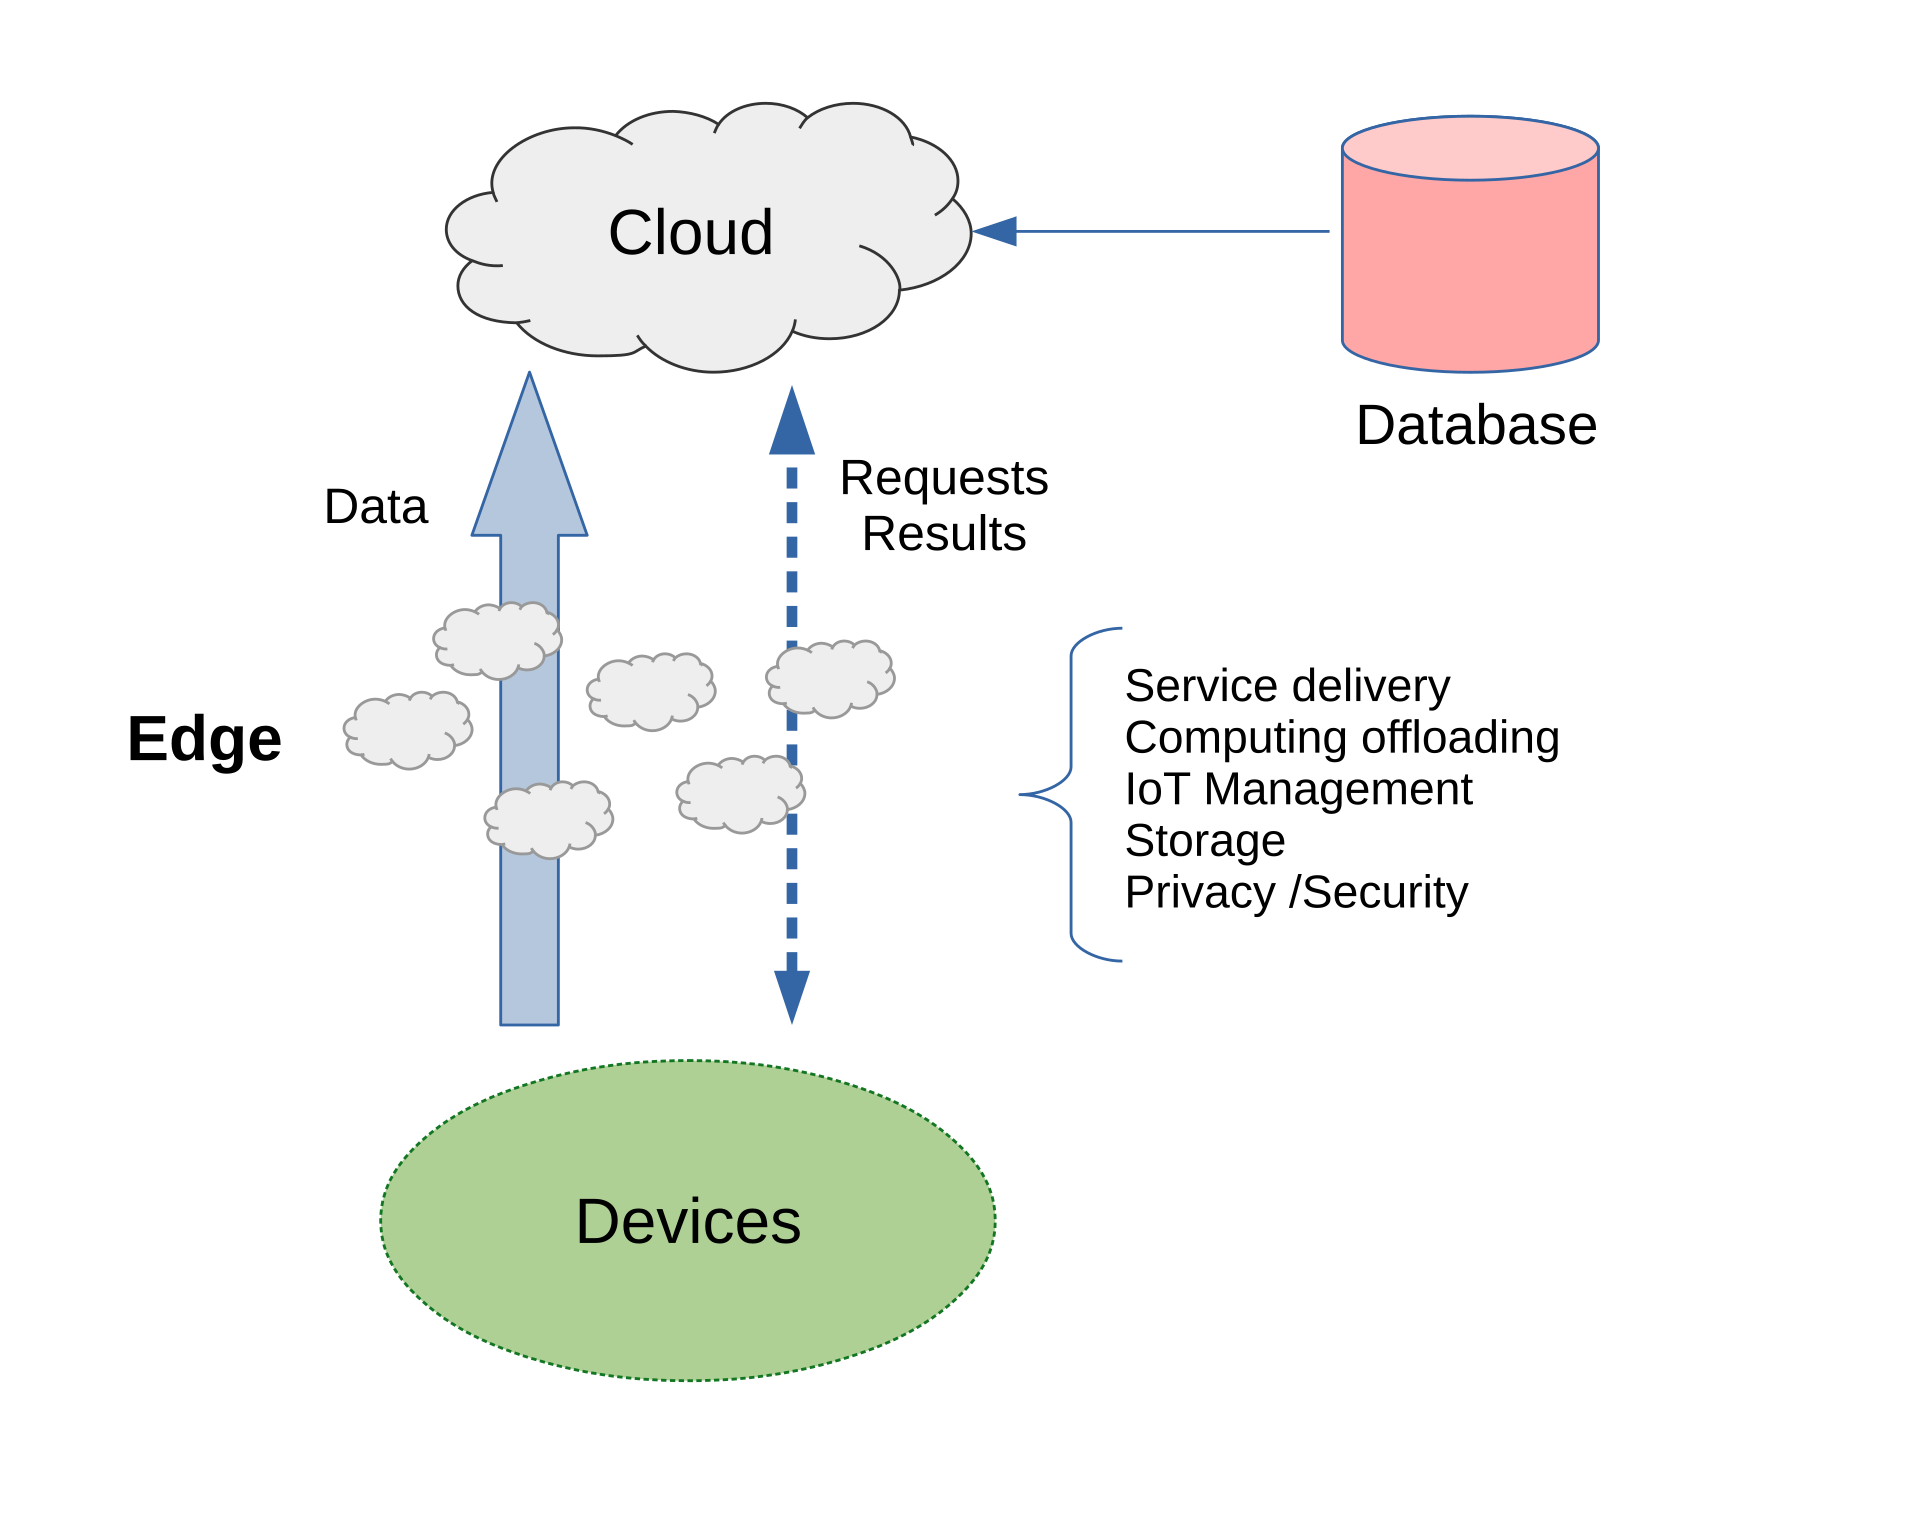
หลายโรงงานในไทยวางแผนธุรกิจดิจิทัลของตัวเองแบบสองขั้ว คือมีอุปกรณ์ IoT และ PLC อยู่ปลายทาง แล้วส่งข้อมูลขึ้นคลาวด์เพื่อประมวลผลทั้งหมด แต่เมื่อปริมาณข้อมูลเพิ่มขึ้นเป็นสิบเท่า และ AI เริ่มถูกใช้ตัดสินใจแบบเรียลไทม์บนพื้นโรงงาน สถาปัตยกรรมแบบสองขั้วนี้ก็เริ่มสะดุด คำตอบที่ถูกที่สุดไม่ใช่การย้ายทุกอย่างกลับมาอยู่ในโรงงาน แต่คือการเพิ่ม ชั้นคำนวณระหว่างกลาง ที่เรียกว่า Fog Computing ซึ่งกำลังกลับมาเป็นที่พูดถึงอีกครั้งในวงการอุตสาหกรรมปี 2026
ทำไมสองขั้วไม่พออีกต่อไป
ลองนึกภาพสายการผลิตที่มีกล้องตรวจคุณภาพ 16 ตัว ส่งภาพความละเอียดสูงกลับคลาวด์เพื่อรันโมเดล Computer Vision ที่ 30 เฟรมต่อวินาที เสียงวิเคราะห์คลื่นเสียงเครื่องจักร และข้อมูล vibration ที่สุ่มที่ 10 kHz — แบนด์วิดท์ที่ต้องใช้ไม่ใช่แค่ “เยอะ” แต่แพงและเปราะ ถ้าเน็ตหลุดแม้เพียง 30 วินาที งานตรวจคุณภาพช่วงนั้นก็หายไปตลอดกาล
ในทางกลับกัน การเอาทุกอย่างมาไว้ในเซิร์ฟเวอร์กลางในโรงงานล้มเหลวในอีกแบบ ทีม IT ต้องดูแลฮาร์ดแวร์ ทำ backup อัปเดต patch และขยายระบบทุกครั้งที่เพิ่มสายการผลิต Fog Computing เสนอทางที่สาม — กระจายการคำนวณลงไปในหลายๆ โหนดที่อยู่ใกล้แหล่งข้อมูล แต่ยังจัดการแบบรวมศูนย์ ตามแนวคิดที่ OpenFog Consortium (ซึ่งต่อมาควบรวมเข้ากับ Linux Foundation Edge) เคยสรุปไว้ใน Reference Architecture ว่าต้องมีคุณสมบัติ 8 ด้าน ตั้งแต่ Security, Scalability, Openness, Autonomy, Manageability, Agility, Hierarchical Organization ไปจนถึง Programmability
ข้อกำหนดทางเทคนิคที่ต้องรู้ก่อนออกแบบ
| ประเด็นออกแบบ | โจทย์จริงในโรงงาน | แนวทาง Fog |
|---|---|---|
| Latency budget | ปิดสวิตช์ฉุกเฉินภายใน 10–50 ms หลังตรวจพบความผิดปกติ | ประมวลผลและตัดสินใจที่โหนด Fog ในสายการผลิต ไม่รอ round-trip ไปคลาวด์ |
| แบนด์วิดท์ | กล้องตรวจคุณภาพ 16 ตัว ที่ 30 fps กินลิงก์ WAN เกินกว่าที่ลิงก์สำรองจะรับไหว | สกัดเฉพาะผลลัพธ์และภาพที่พบ defect ขึ้นคลาวด์ ลดปริมาณข้อมูลขาออกได้ 90% ขึ้นไป |
| การทำงานตอนออฟไลน์ | เน็ตหลุด 30 นาที ต้องยังเก็บข้อมูล HACCP/audit ให้ครบถ้วน | Store-and-forward ที่โหนด Fog เก็บข้อมูลไว้ระดับท้องถิ่น แล้วซิงก์ขึ้นคลาวด์เมื่อลิงก์กลับมา |
| การขยายระบบ | เพิ่มสายการผลิตที่สอง ต้องรอจัดซื้อและติดตั้งเซิร์ฟเวอร์กลาง | เพิ่มโหนด Fog ต่อสายการผลิต ใช้ pattern เดิม deploy ซ้ำได้ทันที |
| ความเป็นส่วนตัวของข้อมูล | ภาพพนักงานและสูตรการผลิตไม่ควรออกนอกไซต์ | anonymize/กรองข้อมูลก่อนออกจากโรงงาน ส่งเฉพาะ aggregate ขึ้นคลาวด์ |
เส้นแบ่งระหว่าง Edge, Fog และคลาวด์
หลายคนใช้คำ Edge กับ Fog ปนกัน ขอแยกให้ชัด: Edge คือการคำนวณบนอุปกรณ์หรือเกตเวย์ที่ต่อกับเซ็นเซอร์โดยตรง เช่น gateway ที่แปลง Modbus TCP เป็น MQTT พร้อมรัน logic กรองข้อมูลเบื้องต้น Fog คือชั้นของโหนดคำนวณหลายตัวที่ทำงานร่วมกันเป็น hierarchy มีการ migrate workload ระหว่างโหนด มี resource management และ orchestration ส่วน คลาวด์ เป็นชั้นที่ดูแล governance, ML training และการวิเคราะห์ข้ามไซต์ ในทางปฏิบัติโรงงานหนึ่งแห่งอาจมีทั้งสามชั้นอยู่ในระบบเดียวกัน
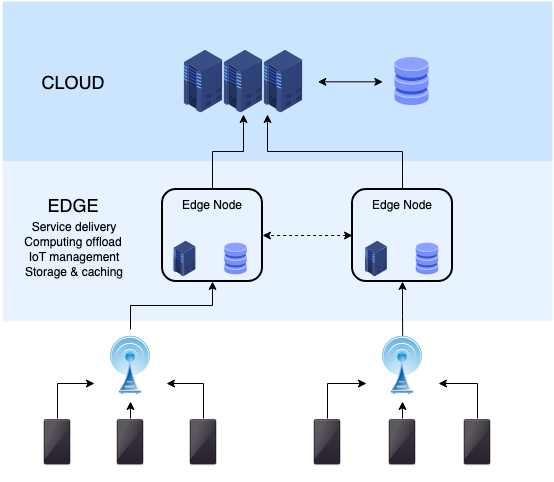
จากประสบการณ์ติดตั้งจริงของทีมงาน Honey Corporation ในโครงการ IIoT หลายไซต์ เราพบว่าจุดตัดสินความสำเร็จของสถาปัตยกรรม Fog ไม่ได้อยู่ที่ตัวฮาร์ดแวร์ แต่อยู่ที่การออกแบบ latency budget ให้ตรงกับงานจริงของแต่ละสายการผลิต — สิ่งที่ต้องหยุดภายใน 50 มิลลิวินาที กับสิ่งที่ทำ dashboard รายชั่วโมง ควรอยู่คนละชั้นของระบบตั้งแต่วันแรกของการออกแบบ
Key Takeaways
- Fog ไม่ใช่คลาวด์ย่อส่วน แต่คือชั้นจัดการ workload แบบกระจายที่มี hierarchy ชัดเจน ออกแบบตามแนวทาง OpenFog RA ที่มีคุณสมบัติ 8 ด้าน
- ตัวเลขที่ต้องจำ: งาน safety interlock ต้องตัดสินใจภายใน 10–50 ms ซึ่ง round-trip ไปคลาวด์ (มัก 50–200 ms) ไม่สามารถรับประกันได้
- ลดปริมาณข้อมูลขาออกได้ 90%+ ด้วยการสกัดผลลัพธ์ที่โหนด Fog แทนการส่ง raw data ทั้งหมดขึ้นคลาวด์
- Store-and-forward คือกันชนของ compliance ข้อมูล HACCP และ audit trail ต้องครบแม้เน็ตหลุดเป็นชั่วโมง
- อย่าลืมชั้น orchestration การมีโหนด Fog 10 ตัวกระจายกันโดยไม่มีระบบจัดการรวม เท่ากับสร้าง silo ใหม่แทนที่จะแก้ปัญหาเดิม
Honey Corporation พร้อมให้คำปรึกษา
ทีมงานของเรามีความเชี่ยวชาญด้านระบบ Edge/Fog Computing และสถาปัตยกรรม IIoT แบบหลายชั้น พร้อมออกแบบและติดตั้งระบบให้เหมาะกับธุรกิจของคุณ ตั้งแต่การสำรวจ latency budget ของสายการผลิตจริง ไปจนถึงการวางโหนด Edge และเชื่อมข้อมูลขึ้นคลาวด์อย่างปลอดภัย
📞 โทร: 09-23242995 | อีเมล: support@honey.co.th
เว็บไซต์: www.honey.co.th