
ทำไมโครงการ AI ในโรงงานถึงตายก่อนถึงไลน์ผลิต
คำถามที่เราได้ยินบ่อยที่สุดจากผู้บริหารโรงงานช่วงหลังนี้คือ “อยากใช้ AI ในโรงงาน แต่ควรเริ่มจากตรงไหน” — และคำตอบที่หลายคนไม่อยากได้ยินคือ อย่าเริ่มจาก AI เริ่มจากข้อมูล รายงานล่าสุดของ IoT Analytics ระบุว่าตลาด Industrial AI จะเติบโตจาก 43.6 พันล้านดอลลาร์ (2024) สู่ 153.9 พันล้านดอลลาร์ในปี 2030 ที่ CAGR 23% แต่ปัจจุบันการใช้จ่าย AI ในภาคผลิตยังคิดเป็นเพียง 0.1% ของรายได้ สาเหตุใหญ่ไม่ใช่ AI ไม่เก่งพอ แต่คือโรงงานส่วนใหญ่ยังไม่มีข้อมูลที่ “ใช้เพื่อฝึกและใช้งาน AI ได้จริง”
งานนำร่อง AI ที่ล้มเหลวมักมีร่องรอยเดียวกัน: ทีมพัฒนาได้รับไฟล์ Excel ที่ส่งออกจาก SCADA ทีละเดือน ข้อมูลขาดหายเป็นช่วงๆ เซ็นเซอร์บางตัวเซ็นสเกลผิด ไม่มีใครรู้ว่าหน่วยเป็นอะไร และไม่มีเหตุการณ์ปัญหาที่ติดแท็กไว้ให้โมเดลเรียนรู้ โมเดลที่ดีที่สุดก็ช่วยไม่ได้เมื่อข้อมูลตั้งต้นเป็นเช่นนั้น — นี่คือเหตุผลที่คู่มือนี้มุ่งเน้นเรื่องเดียว: วางรากฐานข้อมูลให้ถูกต้องก่อน AI ลงมือ
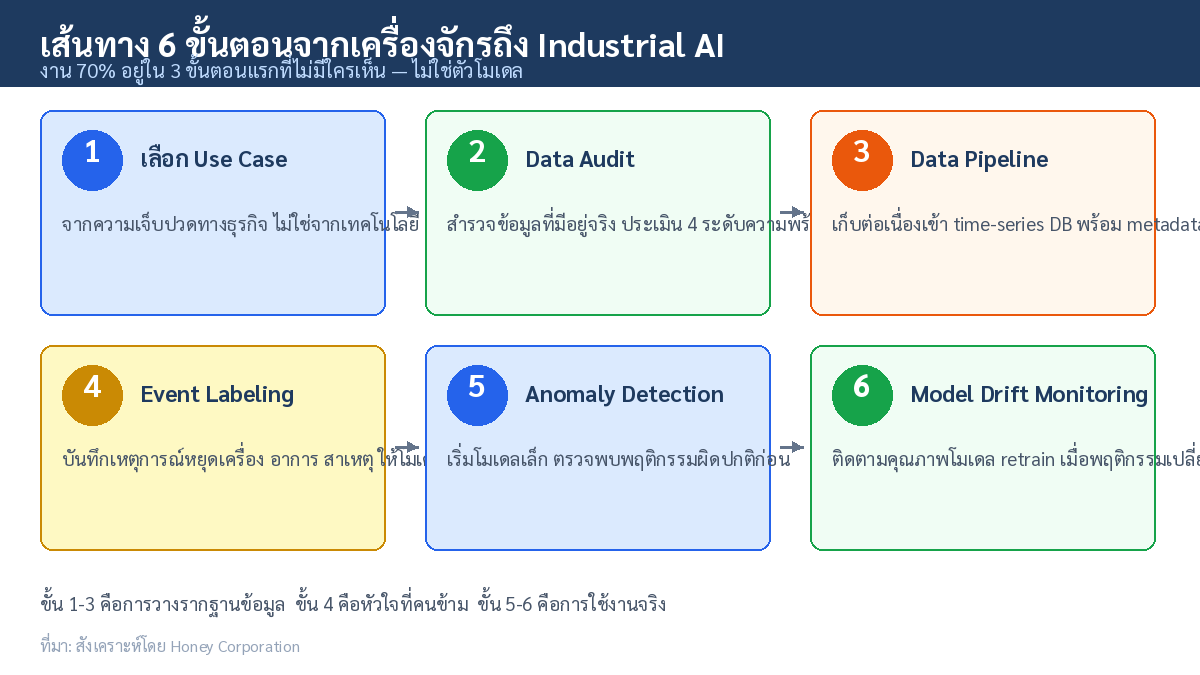
ขั้นที่ 1–2: คัดเลือก Use Case ที่คุ้มค่า แล้วสำรวจข้อมูลที่มีอยู่จริง
ขั้นที่ 1 — เลือก use case จากความเจ็บปวดทางธุรกิจ ไม่ใช่จากเทคโนโลยี: จงนึกถึงปัญหาที่เกิดซ้ำและแพงที่สุด เช่น เครื่องจักรหลักเสียกะทันหัน ของเสียจากกระบวนการอบ หรือการเปลี่ยนได้ช้ากว่าแผน ให้เลือก 1 ปัญหาที่มีเหตุการณ์เกิดขึ้นอย่างน้อยเดือนละ 2–3 ครั้ง เพราะโมเดลต้องการตัวอย่างเหตุการณ์พอสมควร จากนั้นคำนวณค่าใช้จ่ายที่เกิดจริงต่อเหตุการณ์ (ค่าหยุดไลน์ ค่าของเสีย) เพื่อเป็นตัวชี้วัดว่าโครงการจะคุ้มหรือไม่
ขั้นที่ 2 — ทำ Data Audit อย่างซื่อสัตย์: ระบุว่าปัจจุบันมีสัญญาณใดบ้างที่เก็บแล้วจริง เก็บที่ไหน (SCADA, Historian, PLC, กระดาษบันทึก) ความถี่เท่าไร และอยู่ได้นานแค่ไหน ตารางด้านล่างคือเกณฑ์เบื้องต้นที่ใช้ประเมินความพร้อมของแต่ละสัญญาณ:
| ระดับความพร้อม | สภาพข้อมูลจริง | สิ่งที่ต้องทำต่อ |
|---|---|---|
| ระดับ 0 — กระดาษ | บันทึกยามเขียนมือทุก 2 ชั่วโมง สแกนเก็บเป็น PDF | ติดตั้งเซ็นเซอร์/เพิ่มจุดวัดดิจิทัลก่อนพูดถึง AI |
| ระดับ 1 — เก็บเป็นรอบ | SCADA ส่งออก CSV รายวัน/รายเดือน เก็บในโฟลเดอร์รวม | เปลี่ยนเป็นการเก็บต่อเนื่องเข้าฐานข้อมูล time-series |
| ระดับ 2 — เก็บต่อเนื่อง | Historian เก็บสัญญาณหลักไว้ 1–2 ปี แต่สัญญาณรองขาดช่วง | เพิ่มจุดวัดที่สำคัญ ทำ backfill และตรวจสอบคุณภาพสัญญาณ |
| ระดับ 3 — พร้อมฝึกโมเดล | ข้อมูลต่อเนื่อง สะอาด มีหน่วยชัดเจน มีป้ายเหตุการณ์ปัญหา | เริ่มพัฒนาโมเดล anomaly detection / predictive ได้ทันที |
ขั้นที่ 3–4: วางโครงสร้างการเก็บข้อมูล และติดแท็กเหตุการณ์
ขั้นที่ 3 — ออกแบบ data pipeline ที่ทนทาน: ให้ข้อมูลไหลจาก PLC/เซ็นเซอร์ผ่าน gateway เข้าสู่ฐานข้อมูล time-series โดยอัตโนมัติ ไม่พึ่งการ export มือ หลักการสำคัญคือ (1) เก็บ raw data ก่อนแปลงหน่วย เพื่อตรวจย้อนได้ (2) บันทึก metadata ของทุกจุดวัด — หน่วย ช่วงสเกล ตำแหน่งติดตั้ง วันที่สอบเทียบ (3) เก็บด้วยความถี่ที่สูงพอจับพฤติกรรมเครื่องจักร โดยทั่วไป 1–10 วินาทีต่อจุดวัดสำหรับงาน condition monitoring และ (4) กำหนด retention ให้ยาวพอสำหรับฤดูกาลการผลิตอย่างน้อย 1 รอบเต็ม
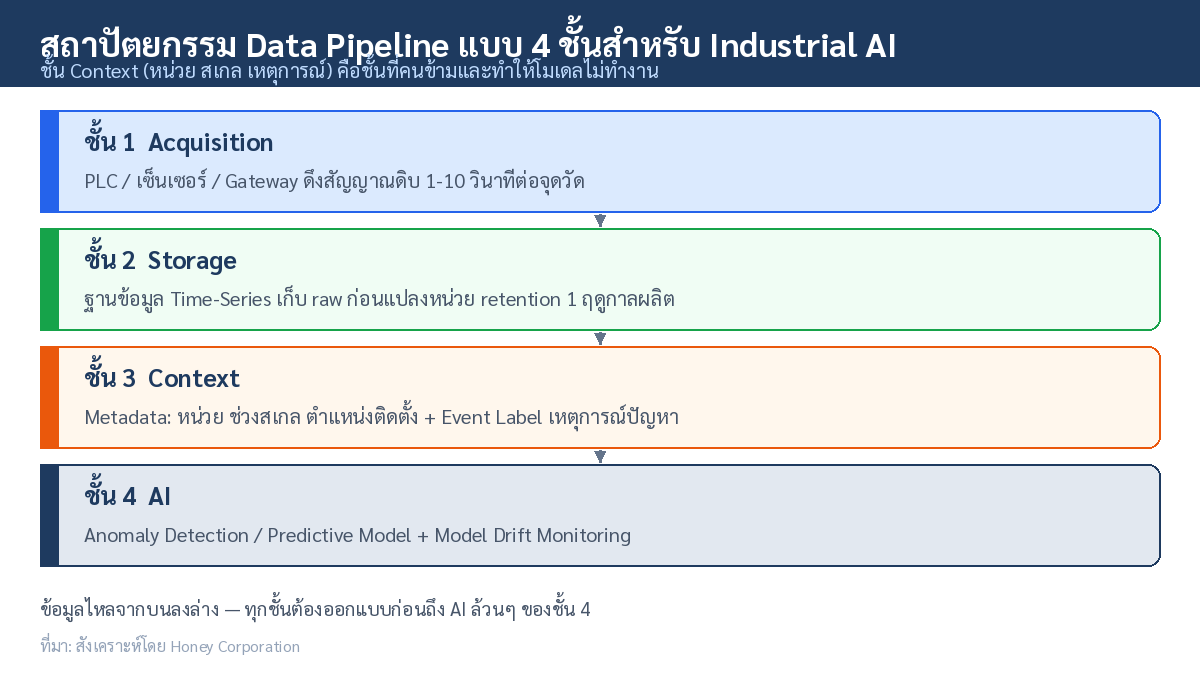
ขั้นที่ 4 — ติดแท็กเหตุการณ์ให้โมเดลมีอะไรเรียนรู้: นี่คือขั้นที่แยกระหว่างโครงการที่สำเร็จกับล้มเหลว ข้อมูลเซ็นเซอร์เปล่าๆ ไม่บอกว่า “เมื่อไรเครื่องเสีย” — ต้องมีการบันทึกเหตุการณ์ (event labeling) ควบคู่ไป ให้ช่างบันทึกทุกครั้งที่มีการหยุดเครื่องไม่ตามแผน ลักษณะอาการ สาเหตุ และชิ้นส่วนที่เปลี่ยน แม้เพียงบันทึกสั้นๆ ในแอปหรือแบบฟอร์มดิจิทัล ก็เปลี่ยนข้อมูลธรรมดาให้เป็นชุดฝึกสอน AI ที่มีค่าทันที
ขั้นที่ 5–6: เริ่มจากโมเดลเล็ก และวางระบบติดตามคุณภาพ
ขั้นที่ 5 — เริ่มจาก anomaly detection ก่อน prediction: อย่าเพิ่งฝันถึงโมเดลทำนายเวลาเสียล่วงหน้า 30 วัน ให้เริ่มจากโมเดลตรวจจับพฤติกรรมผิดปกติ (anomaly detection) ที่เรียนรู้จากข้อมูลปกติของเครื่องจักร แล้วแจ้งเตือนเมื่อสัญญาณเบี่ยงจากฐาน วิธีนี้ไม่ต้องการป้ายเหตุการณ์ย้อนหลังจำนวนมาก ให้ผลใช้งานได้เร็ว และสร้างความเชื่อมั่นให้ทีมหน้างานก่อนที่จะก้าวไปสู่โมเดลที่ซับซ้อนกว่า
ขั้นที่ 6 — วางระบบดูแล model drift: เครื่องจักรมีอายุ สภาพแวดล้อมเปลี่ยน วัตถุดิบเปลี่ยน โมเดลที่เก่งวันนี้จะเสื่อมถอนวันหน้า ต้องติดตามอัตราการแจ้งเตือนที่ถูกต้อง อัตรา false alarm และเปรียบเทียบการกระจายของข้อมูลใหม่กับตอนฝึก ถ้าพฤติกรรมข้อมูลเปลี่ยนไปจากเดิมมาก ถึงจุดที่ต้อง retrain
Key Takeaways
- อย่าเริ่มจาก AI — เริ่มจากข้อมูล งานนำร่อง AI ที่ล้มเหลวส่วนใหญ่ตายเพราะข้อมูลตั้งต้น ไม่ใช่ความสามารถของโมเดล
- ตลาด Industrial AI กำลังโต 23% ต่อปี (43.6 → 153.9 พันล้านดอลลาร์ ปี 2024→2030) แต่การใช้จ่ายจริงยังคิดเป็นแค่ 0.1% ของรายได้ภาคผลิต — ช่องว่างคือโอกาสของผู้ที่เตรียมข้อมูลไว้ก่อน
- ประเมินความพร้อมข้อมูลเป็น 4 ระดับ (กระดาษ → ส่งออกเป็นรอบ → ต่อเนื่อง → พร้อมฝึกโมเดล) และระบุช่องว่างเป็นรายสัญญาณก่อนลงทุนเทคโนโลยีใดๆ
- หลักการ pipeline: เก็บ raw ก่อนแปลงหน่วย บันทึก metadata ทุกจุดวัด ความถี่ 1–10 วินาทีสำหรับ condition monitoring และ retention อย่างน้อย 1 ฤดูกาลผลิตเต็ม
- Event labeling คือขั้นวิกฤต — การบันทึกเหตุการณ์หยุดเครื่อง อาการ สาเหตุ และชิ้นส่วนที่เปลี่ยน คือสิ่งที่เปลี่ยนข้อมูลเซ็นเซอร์ธรรมดาให้เป็นชุดฝึกโมเดลที่มีค่า
- เริ่มจาก anomaly detection ก่อน predictive model ที่ซับซ้อน และอย่าลืมวางระบบติดตาม model drift ตั้งแต่วันแรก
Honey Corporation พร้อมให้คำปรึกษา
ทีมงานของเรามีความเชี่ยวชาญด้านระบบเก็บข้อมูลเครื่องจักรและ Industrial AI พร้อมออกแบบและติดตั้งระบบให้เหมาะกับธุรกิจของคุณ
📞 โทร: 09-23242995 | อีเมล: support@honey.co.th
เว็บไซต์: www.honey.co.th