
คำถามที่ทีมวิศวกรของเราเจอบ่อยที่สุดจากโรงงานที่อยากเริ่ม Predictive Maintenance คือ “โมเดลเราต้องการข้อมูล fault ของเครื่องจักรตัวนี้กี่ตัวอย่าง กว่าจะใช้งานได้จริง?” คำตอบตรงๆ คือหลายพันตัวอย่าง — จำนวนที่โรงงานส่วนใหญ่ไม่มีทางรอให้เกิดขึ้นเองโดยไม่เจอ breakdown ก่อน Transfer Learning คือทางออกที่ถูกที่สุดและงานวิจัยล่าสุดยืนยันแล้วว่า ยืมความรู้จากข้อมูลสาธารณะมาใช้กับเครื่องจักรจริงได้ ด้วยตัวอย่างเพียง 20-50 ตัวอย่าง
หลักการ: Source Domain → Target Domain
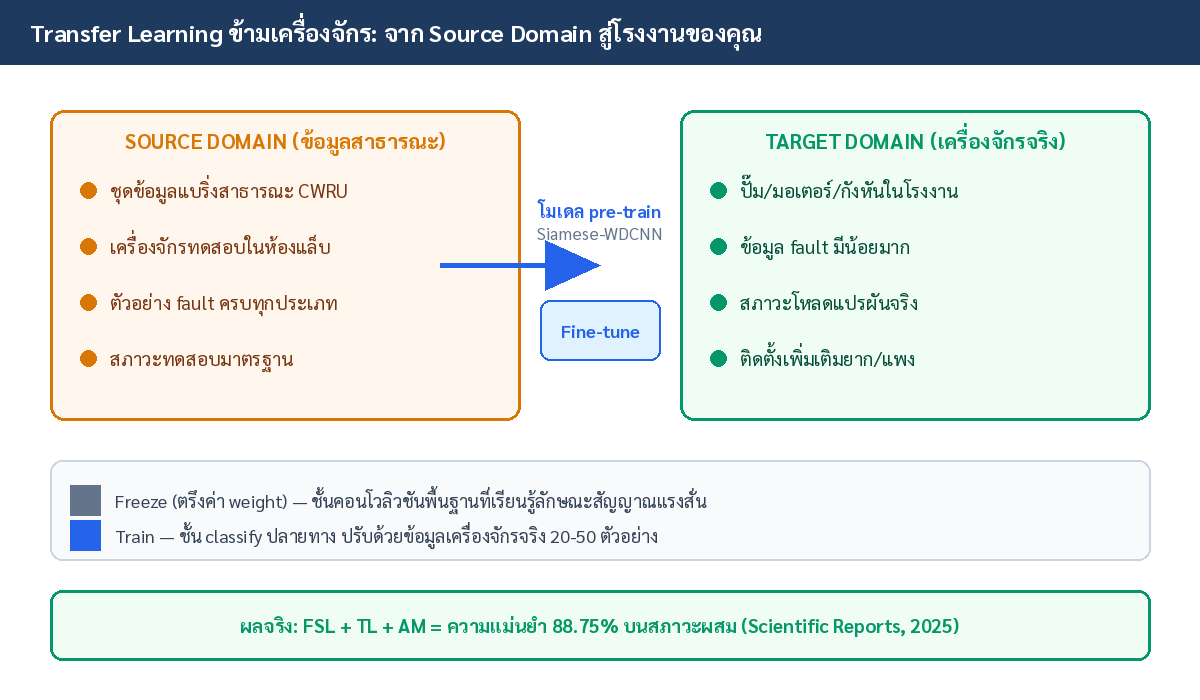
แนวคิดคือการแยกโมเดลเป็นสองส่วน: ชั้น feature extractor (คอนโวลิวชัน) ที่เรียนรู้ลักษณะพื้นฐานของสัญญาณแรงสั่น — harmonic ของ BPFO/BPFI, รูปแบบ modulation เมื่อแบริ่งเสียหาย ซึ่งเหมือนกันข้ามเครื่องจักรไม่ว่าจะเป็นปั๊มหรือมอเตอร์ กับ ชั้น classifier ปลายทางที่จำเพาะกับเครื่องจักรแต่ละตัว เราจึง pre-train ทั้งหมดบนชุดข้อมูลสาธารณะ แล้ว freeze ชั้นแรกไว้ ปรับแต่งเฉพาะชั้นท้าย
งานวิจัยใน Scientific Reports (2025) พิสูจน์แนวทางนี้บนงานจริง: ทีมวิจัยสร้าง Siamese-WDCNN จากชุดข้อมูล CWRU แล้วโอนย้ายไปยัง hydrodynamic transmission testbed กำลังสูง — อุปกรณ์ที่มีโครงสร้างและลักษณะสัญญาณต่างจากแบริ่งทดสอบในแล็บอย่างมาก ผลคือ FSL+TL ทำได้ 85.30% บนสภาวะผสม และเมื่อเติม attention mechanism ขึ้นเป็น 88.75% เทียบกับ WDCNN เดี่ยวๆ ที่ตกไปอยู่ระดับ 70% ต้นๆ
5 ขั้นตอนนำไปใช้จริงในโรงงาน
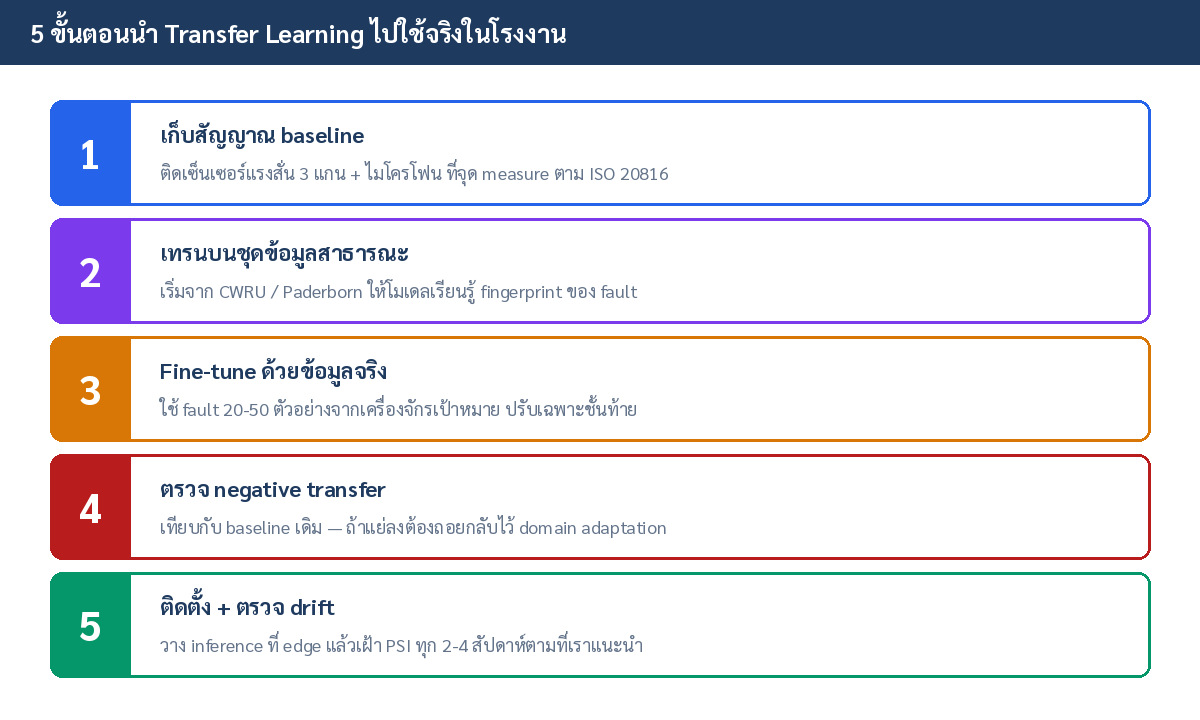
ขั้นที่ 1: เก็บสัญญาณ baseline ให้ถูกวิธี
ก่อนคุยเรื่อง AI ต้องมีข้อมูลที่เปรียบเทียบได้ก่อน ติดเซ็นเซอร์แรงสั่น 3 แกนที่จุดวัดตามมาตรฐาน ISO 20816 (ผิวแบน สะอาด ใกล้ bearing load zone) พร้อมไมโครโฟนหรือ acoustic sensor เสริม ตั้ง sampling rate ≥ 25.6 kHz เพื่อให้จับ signature ความถี่สูงได้ เก็บข้อมูลสภาวะปกติของเครื่องจักรเป้าหมายไว้ก่อนแม้ยังไม่มี fault — มันคือ negative class ที่จำเป็น
ขั้นที่ 2: Pre-train บนชุดข้อมูลสาธารณะ
เลือก source domain ที่ใกล้เคียงเครื่องจักรเป้าหมายมากที่สุด สำหรับแบริ่ง CWRU เป็นจุดเริ่มที่ดี ถ้าเป็นกังหัน/เกียร์ Paderborn เหมาะกว่า เทรนโมเดลให้เรียนรู้ fault ครบทุกประเภท (inner race, outer race, ball, combination) แล้วเก็บ weights เป็น starting point
ขั้นที่ 3: Fine-tune ด้วย fault จริง 20-50 ตัวอย่าง
เมื่อมี fault เกิดขึ้นจริงบนเครื่องจักรเป้าหมาย (จากการทดสอบ หรือครั้งแรกที่เจอแล้วเก็บไว้) ให้ fine-tune เฉพาะ classifier head ด้วย learning rate ต่ำ (1e-4 ถึง 1e-5) ระวังอย่าปรับทั้งโมเดล — ข้อมูลน้อยเกินไปจะทำให้ catastrophic forgetting ทำลายความรู้เดิมทั้งหมด
ขั้นที่ 4: ตรวจ negative transfer ก่อนเสมอ
สิ่งที่มักไม่มีใครพูด: transfer ไม่เสมอไปทางที่ดี ถ้า source กับ target ห่างกันเกิน (เช่น จากแบริ่งเล็ก 6205 ไปกังหันกำลังสูง) โมเดลอาจแย่กว่าเทรนใหม่แบบ scratch ต้องเทียบ accuracy กับ baseline เดิมทุกครั้ง ถ้าแย่ลงต้องถอยไปใช้ domain adaptation แบบมี adversarial alignment แทน (แนวทาง PPO-MSDATL, 2026)
ขั้นที่ 5: วาง inference ที่ edge + เฝ้า drift
โมเดลที่ fine-tune แล้วมักเล็กพอจะรันบน edge gateway ในโรงงาน ให้ latency ต่ำและไม่ต้องส่งข้อมูลดิบออกนอกเครือข่าย แต่อย่าลืมว่าเมื่อเครื่องจักรผ่านการ overhaul หรือเปลี่ยนแบริ่ง การกระจายของสัญญาณจะเปลี่ยน — ตรวจ PSI ของ distribution ทุก 2-4 สัปดาห์ ถ้าเกิน 0.2 แปลว่าโมเดลเริ่มเพี้ยนและต้อง retrain
เทียบวิธี: เทรนเอง vs Transfer
| มิติ | เทรนเองจาก zero | Transfer Learning (FSL+TL) |
|---|---|---|
| fault samples ที่ต้องมี | หลายพันตัวอย่าง | 20-50 ตัวอย่าง |
| เวลาถึง deployment | 6-18 เดือน (รอ fault เกิดจริง) | 2-4 สัปดาห์หลังมี fault แรก |
| ความแม่นยำสภาวะผสม | สูง (ถ้าข้อมูลพอ) | 85-89% (FSL+TL+AM) |
| ความเสี่ยง | โครงการเนิ่ช้า อาจไม่ถึงจุดใช้งาน | negative transfer (ตรวจได้ แก้ได้) |
Key Takeaways
- อย่ารอข้อมูล fault พันตัวอย่าง: Transfer Learning ทำให้เริ่มได้ด้วย 20-50 ตัวอย่างจากเครื่องจักรจริง
- ผลงานวิจัยรองรับ: FSL+TL+AM = 88.75% บนสภาวะผสมของ hydrodynamic transmission จริง (Scientific Reports 2025)
- Freeze/Train คือหัวใจ: ตรึง feature extractor เทรนเฉพาะ classifier head ด้วย LR ต่ำ
- ตรวจ negative transfer ทุกครั้ง: ถ้า accuracy ต่ำกว่า baseline ให้ถอยไป domain adaptation
- เฝ้า drift หลัง overhaul: PSI > 0.2 แปลว่าต้อง retrain — อย่าปล่อยโมเดลแช่แข็ง
- เริ่มเก็บ baseline วันนี้: ข้อมูลสภาวะปกติคือ negative class ที่จำเป็นและเก็บได้ทันทีไม่ต้องรอ
Honey Corporation พร้อมให้คำปรึกษา
ทีมงานของเรามีความเชี่ยวชาญด้านระบบ Predictive Maintenance และ Condition Monitoring พร้อมออกแบบและติดตั้งระบบวัดแรงสั่นและ AI วินิจฉัยให้เหมาะกับเครื่องจักรของคุณ ตั้งแต่การเลือกจุดติดตั้งเซ็นเซอร์ตาม ISO 20816 จนถึงการ fine-tune โมเดลด้วยข้อมูลจริงของโรงงาน
📞 โทร: 09-23242995 | อีเมล: support@honey.co.th
เว็บไซต์: www.honey.co.th