
หลายโรงงานที่เราเจอในประเทศไทยมีปัญหาเดียวกัน — ระบบทำความเย็น ระบบปรับอากาศ หรือชุดหม้อไอน้ำ ถูกตั้งค่าพารามิเตอร์ไว้ตั้งแต่วัน commissioning แล้วก็ไม่เคยถูกปรับอีกเลย ทั้งที่โหลดจริงเปลี่ยนไปตลอดเวลา ทั้งจากฤดูกาล สูตรการผลิต และปริมาณคำสั่งผลิต บทความนี้เราจะเจาะลึกว่า Reinforcement Learning (RL) จะเข้ามา “เรียนรู้” วิธีควบคุมที่ดีที่สุดจากข้อมูลจริงของโรงงานคุณเองได้อย่างไร และทำไมมันถึงไม่ใช่แค่ hype แต่เป็นเทคโนโลยีที่ถูกพิสูจน์แล้วในงานจริงมานานกว่า 8 ปี
RL ต่างจาก AI แบบที่โรงงานเคยใช้อย่างไร
งาน AI ส่วนใหญ่ในโรงงานตอนนี้คือการ “ทำนาย” — ทำนายว่าแบริ่งจะพังเมื่อไหร่ ทำนายว่าชิ้นงานจะเสียหรือไม่ แต่ RL ไม่ได้ทำนาย RL ทำหน้าที่ ตัดสินใจลงมือทำ โดยตอบคำถามว่า “ถ้าสถานการณ์เป็นแบบนี้ ควรตั้งค่าอะไรเท่าไหร่ถึงจะดีที่สุดในระยะยาว”
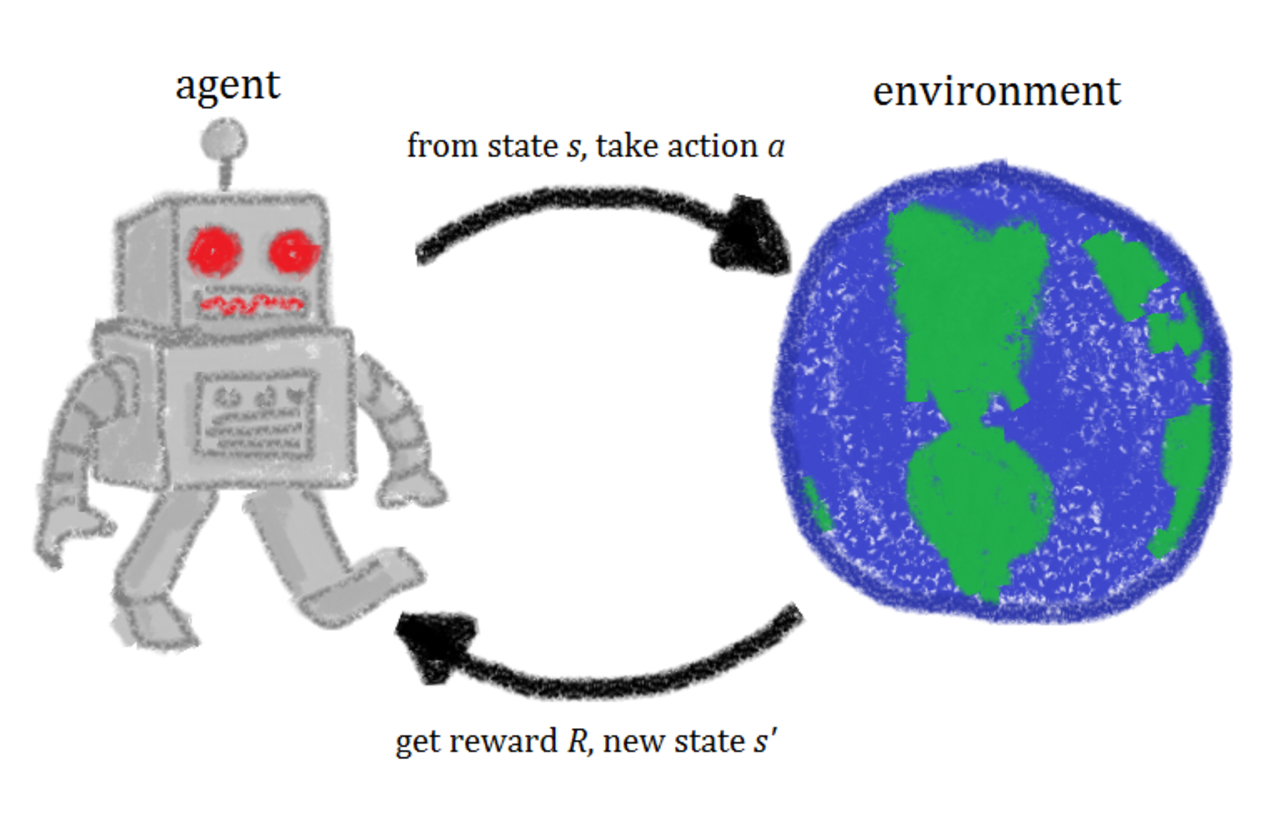
กลไกหลักของ RL คือการเรียนรู้ผ่านการลองผิดลองถูกภายใต้กรอบที่เรียกว่า Markov Decision Process (MDP) — ตัวควบคุม (agent) สังเกตสถานะปัจจุบัน เช่น อุณหภูมิน้ำเย็น โหลด แรงดัน แล้วเลือก action เช่น ปรับความถี่ปั๊ม เปิด-ปิด chiller จากนั้นระบบให้ reward กลับมา (เช่น พลังงานที่ประหยัดได้ในชั่วโมงนั้น) และวนซ้ำแบบนี้หลายล้านครั้งจนโมเดลเรียนรู้นโยบาย (policy) ที่ดีที่สุด
กรณีศึกษาที่เปลี่ยนเกม: ระบบทำความเย็น Data Center
ตัวอย่างที่ถูกอ้างถึงมากที่สุดคือโครงการนำร่องปี 2016 ของบริษัทเทคโนโลยีระดับโลกที่นำ Deep RL มาควบคุมระบบทำความเย็นของ data center ของตัวเอง ผลลัพธ์คือพลังงานที่ใช้ในส่วน cooling (PUE ลดลงจาก 1.12 เหลือ 1.10) โดยระบบปรับพารามิเตอร์หลายสิบตัวพร้อมกันที่มนุษย์ทำได้ยาก เพราะตัวแปรทั้งหมด interlock กันหมด ต่อมาปี 2018 มีการต่อยอดให้ระบบส่งคำสั่งควบคุมโดยตรงสู่ระบบจริงทุก 5 นาทีอัตโนมัติ กลายเป็น “operator ที่ไม่มีวันเหนื่อย” ที่คอยหาจุด sweet spot ของระบบตลอด 24 ชั่วโมง
ทำไมโรงงานไทยถึงควรสนใจ — ตัวเลขที่ต้องรู้
สำหรับโรงงานทั่วไป ระบบ utility อย่าง chiller plant ปั๊ม และ air compressor มักกินพลังงานรวมกัน 40-60% ของทั้งโรงงาน และจากประสบการณ์ตรวจเช็คของทีมสอบถามระบบ พบว่าระบบเหล่านี้ถูก tune ไว้แบบ conservative เกินจำเป็นอยู่เสมอ เพราะวิศวกรต้องการ margin ความปลอดภัย ซึ่งเข้าใจได้ แต่ margin นั้นแปลว่าพลังงานสูญเปล่าทุกวัน 365 วันต่อปี
| แนวทาง | วิธีตั้งค่า | ปรับตัวตามโหลดจริง | รอบระยะเวลาปรับ |
|---|---|---|---|
| Manual Tuning | ประสบการณ์วิศวกร + ค่ามาตรฐาน | ไม่ได้ คงที่ตลอดปี | เมื่อมีคนสั่งปรับ (บางทีเป็นปี) |
| PID / Rule-based APC | สมการควบคุม + กฎ if-then | ได้ในกรอบที่กำหนดไว้ | วินาทีถึงนาที ตาม setpoint |
| Reinforcement Learning | เรียนรู้จาก historical + simulation | ได้ หา policy ใหม่เมื่อสภาพเปลี่ยน | ต่อเนื่อง ทุก 5-15 นาที |
3 เทคนิคที่ทำให้ RL “ปลอดภัยพอ” สำหรับโรงงาน
ข้อกังวลอันดับหนึ่งของทุกโรงงานคือ “ถ้า AI ลองผิดลองถูกบนเครื่องจริงแล้วพังล่ะ” คำตอบคือ RL ยุคใหม่ไม่ได้ลองบนเครื่องจริงอีกต่อไป:
- Offline RL — เทรนโมเดลจากข้อมูล historical ที่บันทึกไว้ใน PI historian หรือ SCADA ล้วนๆ โดยไม่แตะเครื่องจริงเลย เหมือนให้นักเรียนอ่าน log เก่าเพื่อเรียนรู้ ก่อนส่งต่อ
- Sim-to-Real Transfer — สร้าง digital twin เป็นสนามซ้อม ให้ agent เทรนนับล้าน episode ใน simulation จนมั่นใจ ค่อย deploy ลงระบบจริงแบบมี guardrail
- Safety Layer / Action Constraint — คำสั่งจาก RL ต้องผ่านชั้นกรองที่บังคับขอบเขตการทำงาน เช่น อุณหภูมิต้องไม่เกิน 7°C แรงดันต้องอยู่ในแถบปลอดภัย ถ้า AI สั่งเกิน ระบบจะ clamp หรือ fallback ไป PID เดิมทันที
แนวโน้มปี 2026: RL + Sequence Model
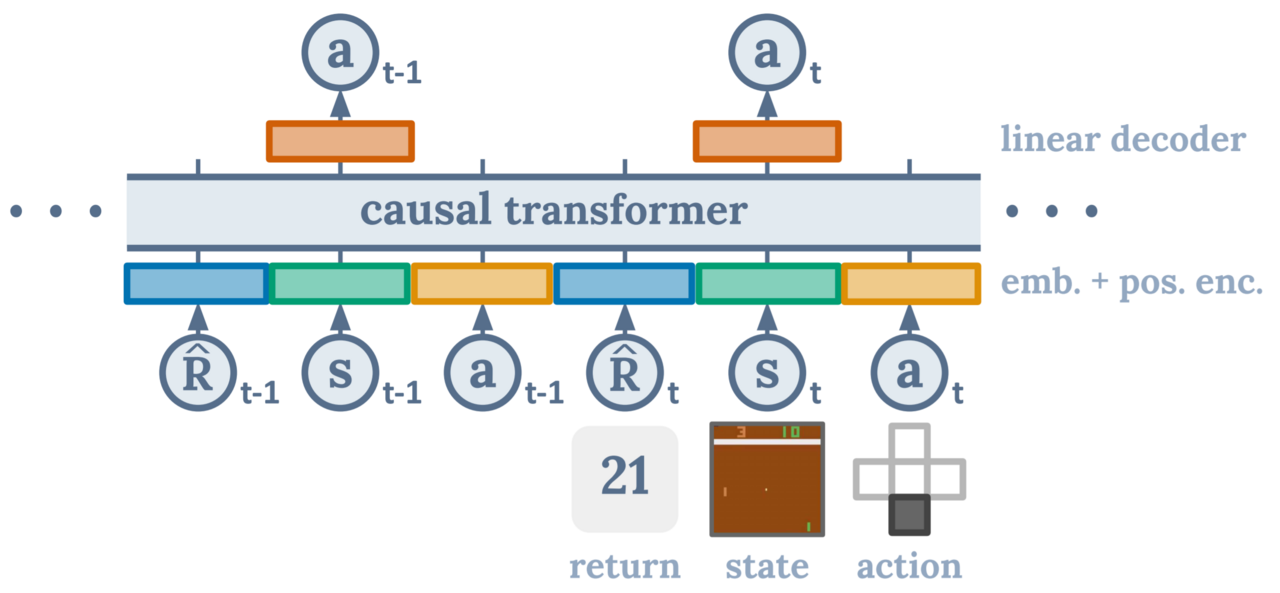
สิ่งที่น่าสนใจคือ RL กำลังรวมตัวกับโมเดล sequence ยุคใหม่ Decision Transformer เปลี่ยนมุมมองของ RL จาก “ประมาณค่า action-value” เป็นการทำนาย action ถัดไปจาก sequence ของ state และ reward ที่ต้องการ (return-to-go) ซึ่งเปิดทางให้ใช้สถาปัตยกรรมแบบเดียวกับ LLM กับงานควบคุม แปลว่าอนาคตอุปกรณ์ edge ที่รัน LLM ตัวเล็กอยู่แล้ว อาจรัน policy RL ได้ในตัวด้วย
Roadmap 6 ขั้นตอนสำหรับโรงงานไทย
- เลือก target ที่ “คุ้ม” — เริ่มจากระบบ utility ที่กินพลังงานสูงและมีข้อมูลย้อนหลัง ≥ 1 ปี เช่น chiller plant หรือระบบลมอัด
- ตรวจคุณภาพข้อมูล — RL ต้องการข้อมูลที่มีทั้งช่วงโหลดสูง-ต่ำ ครบทั้งฤดูกาล ถ้า sensor หลายตัว dead ต้องแก้ก่อน
- สร้าง simulator หรือใช้ offline RL — จำลองพฤติกรรมระบบจาก historical data ก่อนเสมอ
- กำหนด reward function ให้รอบคอบ — อย่าให้ reward เฉพาะด้านพลังงานเดียว ต้องถ่วงน้ำหนักความเสถียรและความเสี่ยงอุปกรณ์ด้วย ไม่งั้น AI จะหา “ช่องโหว่” ของฟังก์ชันเป้าหมาย
- Shadow mode 30-60 วัน — ให้ AI สั่งจำลองคู่ขนานกับระบบจริง เทียบผลลัพธ์ ไม่ส่งคำสั่งจริง
- Deploy แบบมี guardrail — ค่อยๆ ขยายสิทธิ์การสั่งงาน พร้อม fallback อัตโนมัติ และ kill switch ที่ทีมห้องควบคุมกดได้ตลอด
Key Takeaways
- RL ไม่ใช่ AI แบบทำนาย แต่คือ AI ที่ ตัดสินใจตั้งค่าระบบ — ตอบคำถามว่าควรทำอะไร ไม่ใช่แค่จะเกิดอะไร
- กรณีศึกษา data center ปี 2016 พิสูจน์แล้วว่า RL ลดพลังงานส่วน cooling ได้จริง (PUE 1.12 → 1.10) และปี 2018 ต่อยอดสู่การควบคุมอัตโนมัติทุก 5 นาที
- ระบบ utility ของโรงงานไทย (chiller, ปั๊ม, ลมอัด) มักถูก tune แบบ conservative ตั้งแต่วัน commissioning — แหล่งพลังงานสูญเปล่าที่มองไม่เห็นทุกวัน
- Offline RL + Sim-to-Real + Safety Layer ทำให้ไม่ต้อง “ลองผิดลองถูกบนเครื่องจริง” อีกต่อไป
- Reward function คือหัวใจ — ถ้านิยามไม่รอบคอบ AI จะ optimize สิ่งที่คุณเขียน ไม่ใช่สิ่งที่คุณตั้งใจ
- เริ่มจาก shadow mode 30-60 วันก่อนเสมอ และ fallback กลับ PID เดิมต้องทำงานได้ทันทีทุกสถานการณ์
ทีมงาน Honey Corporation มีประสบการณ์ติดตั้งระบบเก็บข้อมูลพลังงานและ IIoT monitoring ในโรงงานอุตสาหกรรมหลายแห่ง ซึ่งเป็น “วัตถุดิบ” สำคัญที่สุดของการนำ RL มาใช้ — เพราะไม่ว่าโมเดลจะเก่งแค่ไหน ถ้าไม่มีข้อมูลคุณภาพดีจาก field sensor ก็ไม่มีอะไรจะเรียนรู้
Honey Corporation พร้อมให้คำปรึกษา
ทีมงานของเรามีความเชี่ยวชาญด้านระบบ IIoT Monitoring และ Energy Management พร้อมออกแบบและติดตั้งระบบให้เหมาะกับธุรกิจของคุณ
📞 โทร: 09-23242995 | อีเมล: support@honey.co.th
เว็บไซต์: www.honey.co.th