
โจทย์คลาสสิกของ AI ตรวจคุณภาพในโรงงานคือ “ของเสียไม่พอเทรน” — ระบบที่ผลิตชิ้นงานถูกต้อง 99.5% จะมีตำหนิให้เก็บภาพเพียง 5 ภาพต่อพันชิ้น และเมื่อรวบรวมได้เป็นร้อยภาพ ก็มักเป็นตำหนิประเภทเดียวกันซ้ำๆ โมเดล deep learning ที่ต้องการภาพหลายพันใบจึง overfit กับความหลากหลายที่แทบไม่มีอยู่จริง บทความนี้ดำน้ำลึกสู่แนวทางที่งานวิจัยปี 2026 ยืนยันแล้วว่าได้ผลจริง: สร้างภาพตำหนิสังเคราะห์ด้วย Diffusion Model แล้วมาเสริมชุดข้อมูลฝึก
ทำไม GAN ยุคก่อนยังไม่พอ
Generative Adversarial Network (GAN) เคยเป็นคำตอบมาตรฐานของปัญหานี้มานานกว่าห้าปี แต่งานวิจัยที่ตีพิมพ์ใน Multimedia Tools and Applications (2026) สรุปข้อจำกัดที่โรงงานเจอตรงๆ สามข้อ: ปัญหา mode collapse ที่ทำให้ภาพที่สร้างซ้ำซากจำเจ ความละเอียดเท็กซ์เจอร์ความถี่สูงที่ไม่พอสำหรับงานตรวจสอบอุตสาหกรรม และความขัดแย้งพื้นฐานที่สุด — GAN ต้องการข้อมูลปริมาณมากอยู่ด่วนในการเทรนให้เสถียร ซึ่งขัดกับสถานการณ์ low-shot ตั้งแต่ต้น
Diffusion Model เปลี่ยนกระบวนทัศน์จากการต่อสู้สองโครงข่าย มาเป็นการ ถอด noise ทีละขั้น (iterative denoising) ที่ optimize ด้วย objective แบบ likelihood ที่เสถียรกว่า ผลคือควบคุมโครงสร้างตำหนิและความหลากหลายได้ดีกว่าอย่างมีนัยสำคัญ — งานเปรียบเทียบโดยตรงในโครงการ CINNABAR 2 ของ DLR MRO Institute (เยอรมนี) พบว่า Diffusion Model ให้คะแนน LPIPS ดีกว่าและยก performance ของตัวตรวจจับขึ้น 12% เมื่อเทียบกับ GAN บนงานตรวจคราบบนผิวเครื่องบิน
Pipeline ที่งานวิจัยยืนยันแล้ว
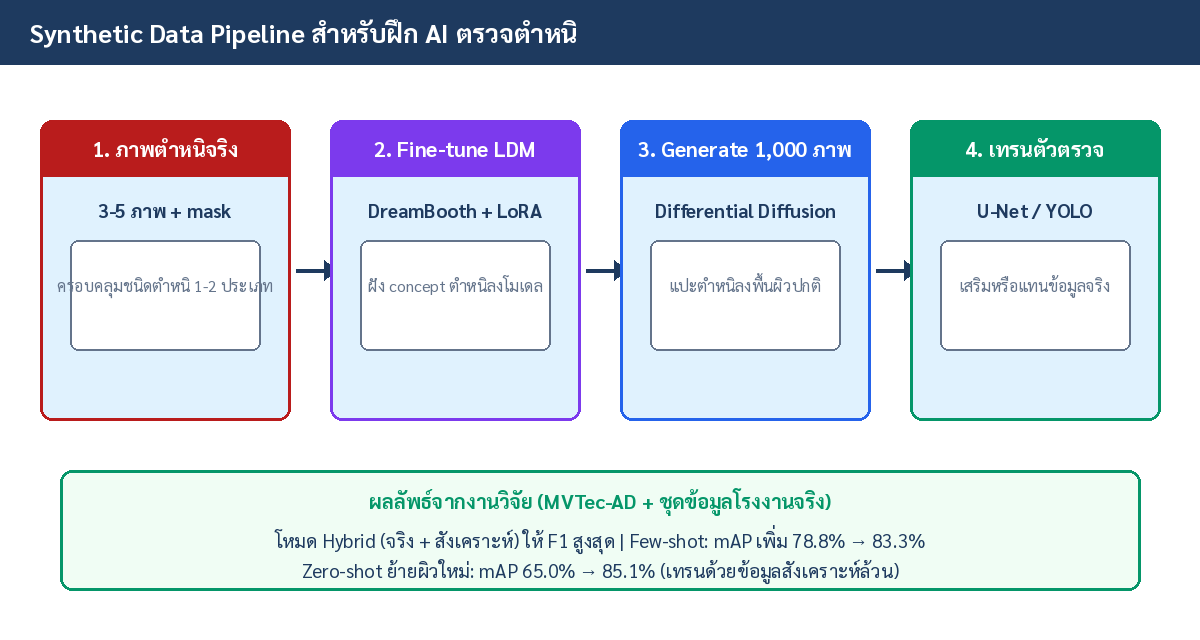
แนวทางที่ทรงพลังที่สุดในปัจจุบันคือการ fine-tune Latent Diffusion Model (LDM) ที่ pre-train มาแล้วด้วยเทคนิค DreamBooth + LoRA — ฝัง concept ของตำหนิชนิดใหม่ลงโมเดลด้วยภาพอ้างอิงเพียงไม่กี่ใบ โดยปรับเฉพาะ cross-attention layers เพื่อลดภาระคำนวณ จากนั้นใช้ Differential Diffusion แปะตำหนิที่เรียนรู้ได้ลงบนภาพพื้นผิวปกติ โดยไม่เกิดรอยต่อ (boundary artifacts) ที่ทำให้ตัวตรวจจับ “จำทาง” ผิด
จุดสำคัญที่มักถูกมองข้ามคือ spatially weighted loss ระหว่าง fine-tune: บังคับให้โมเดลโฟกัสเฉพาะคุณลักษณะของตำหนิ ไม่พยายามสร้างพื้นหลังที่ไม่มีตำหนิซ้ำ ทำให้เรียนรู้ตำหนิได้เร็วและแม่นยำกว่า
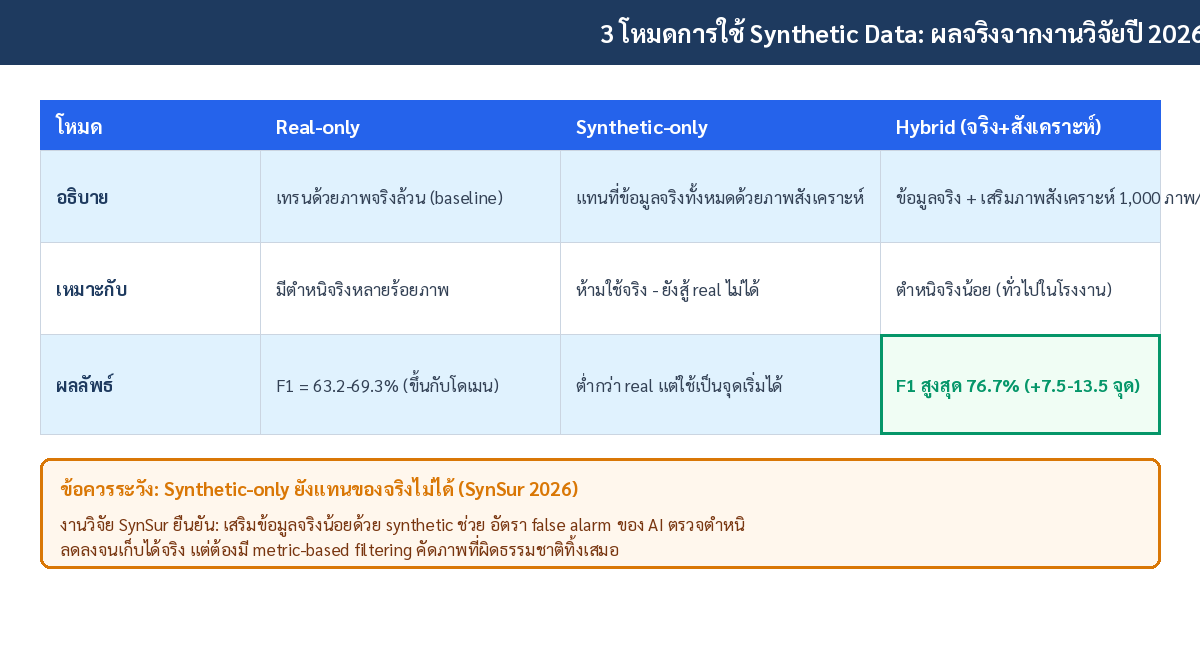
ผลลัพธ์จริง: 3 โหมดการใช้งาน
| สถานการณ์ | วิธีที่งานวิจัยแนะนำ | ผลลัพธ์ที่วัดได้ |
|---|---|---|
| มีตำหนิจริงน้อย (few-shot) | เสริมภาพจริงด้วย synthetic 1,000 ภาพ/ประเภท | mAP เพิ่ม 78.8% → 83.3% |
| ย้ายไปผิวใหม่ (NPI/zero-shot) | เทรนด้วย synthetic ล้วนของผิวเป้าหมาย | mAP 65.0% → 85.1% |
| ต้องการ label อัตโนมัติ | SynSur: VLM สร้าง prompt + mask-guided inpainting + auto label | ชุดข้อมูล 1,000 ภาพที่ label เองได้ทั้งหมด |
กับดักที่ต้องรู้ก่อนใช้จริง
งานวิจัย SynSur (2026) ให้ข้อความระวังที่ตรงประเด็น: synthetic-only ยังแทนข้อมูลจริงไม่ได้ ประสิทธิภาพจะมาเมื่อใช้เสริม ไม่ใช่แทน และภาพสังเคราะห์ที่ “ผิดธรรมชาติ” แม้เพียงส่วนน้อยก็พาโมเดลเบี่ยงได้ จึงต้องมี metric-based filtering คัดกรองภาพก่อนเข้าชุดฝึกเสมอ — องค์ประกอบนี้คือความต่างระหว่าง pilot ที่ได้ผลกับที่เงียบหาย
อีกประเด็นคือ compute: LDM ทำงานใน latent space ที่มีมิติต่ำกว่า pixel space หลายเท่า ทำให้รันได้บน workstation ในโรงงานโดยไม่ต้องพึ่ง server-grade GPU — สำคัญมากสำหรับโรงงานที่ข้อมูลภาพต้องอยู่ในเครือข่ายภายในตามข้อกำหนด IEC 62443
ทีมวิศวกรของ Honey Corporation มีประสบการณ์ติดตั้งระบบ machine vision ตรวจคุณภาพในสายการผลิตจริง และเข้าใจดีว่าข้อจำกัดของข้อมูลตำหนิคือคอขวดแรกที่ต้องแก้ก่อนคุยเรื่อง architecture ใดๆ — การนำ synthetic data เข้ามาเสริมชุดฝึกจึงเป็นก้าวที่เรามักแนะนำให้ลูกค้าที่เริ่มโครงการ AI inspection ด้วยข้อมูลจริงไม่ถึงร้อยภาพ
Key Takeaways
- ปัญหา low-shot แก้ได้จริง: few-shot + synthetic เพิ่ม mAP จาก 78.8% เป็น 83.3% โดยใช้ภาพจริงแค่ 3-5 ใบต่อชนิดตำหนิ
- Diffusion > GAN สำหรับตำหนิอุตสาหกรรม: LPIPS ดีกว่า + performance ตัวตรวจ +12% (CINNABAR 2, DLR)
- โหมด Hybrid คือ default: synthetic เสริมของจริงเสมอ อย่าแทนทั้งหมด (SynSur 2026)
- NPI scenario คือ killer app: ผลิตภัณฑ์ใหม่ที่ยังไม่มีตำหนิเลย เทรนล้วน synthetic ได้ mAP 85.1%
- ต้อง filter เสมอ: ภาพผิดธรรมชาติส่วนน้อยพอทำให้โมเดลเบี่ยง — metric-based filtering จำเป็น
- ตอบโจทย์ security: LDM รันใน latent space บน workstation ภายใน สอดคล้อง network segmentation ตาม IEC 62443
Honey Corporation พร้อมให้คำปรึกษา
ทีมงานของเรามีความเชี่ยวชาญด้านระบบ AI Machine Vision ตรวจคุณภาพการผลิต และการออกแบบชุดข้อมูลฝึกที่มี Synthetic Data Augmentation พร้อมออกแบบและติดตั้งระบบให้เหมาะกับธุรกิจของคุณ
📞 โทร: 09-23242995 | อีเมล: support@honey.co.th
เว็บไซต์: www.honey.co.th