How-to: เตรียมข้อมูลเครื่องจักรให้พร้อมสำหรับ Industrial AI ใน 6 ขั้นตอน — ก่อน AI ต้องมีข้อมูล

How-to: เตรียมข้อมูลเครื่องจักรให้พร้อมสำหรับ Industrial AI ใน 6 ขั้นตอน — ก่อน AI ต้องมีข้อมูล

Article
ทำไมโครงการ AI ในโรงงานถึงตายก่อนถึงไลน์ผลิต คำถามที่เราได้ยินบ่อยที่สุดจากผู้บริหารโรงงานช่วงหลังนี้คือ "อยากใช้ AI ในโรงงาน แต่ควรเริ่มจากตรงไหน" — และคำตอบที่หลายคนไม่อยากได้ยินคือ อย่าเริ่มจาก AI เริ่มจากข้อมูล รายงานล่าสุดของ IoT Analytics ระบุว่าตลาด Industrial AI จะเติบโตจาก 43.6 พันล้านดอลลาร์ (2024) สู่ 153.9 พันล้านดอลลาร์ในปี 2030 ที่ CAGR 23% แต่ปัจจุบันการใช้จ่าย AI ในภาคผลิตยังคิดเป็นเพียง 0.1% ของรายได้ สาเหตุใหญ่ไม่ใช่ AI ไม่เก่งพอ แต่คือโรงงานส่วนใหญ่ยังไม่มีข้อมูลที่ "ใช้เพื่อฝึกและใช้งาน AI ได้จริง" งานนำร่อง AI ที่ล้มเหลวมักมีร่องรอยเดียวกัน: ทีมพัฒนาได้รับไฟล์ Excel ที่ส่งออกจาก SCADA ทีละเดือน ข้อมูลขาดหายเป็นช่วงๆ เซ็นเซอร์บางตัวเซ็นสเกลผิด ไม่มีใครรู้ว่าหน่วยเป็นอะไร และไม่มีเหตุการณ์ปัญหาที่ติดแท็กไว้ให้โมเดลเรียนรู้ โมเดลที่ดีที่สุดก็ช่วยไม่ได้เมื่อข้อมูลตั้งต้นเป็นเช่นนั้น — นี่คือเหตุผลที่คู่มือนี้มุ่งเน้นเรื่องเดียว: วางรากฐานข้อมูลให้ถูกต้องก่อน AI ลงมือ เส้นทาง 6 ขั้นตอนจากเครื่องจักรถึง Industrial AI — งาน 70% อยู่ใน 3 ขั้นตอนแรกที่ไม่มีใครเห็น ไม่ใช่ตัวโมเดล (ที่มา: สังเคราะห์โดย Honey Corporation) ขั้นที่ 1–2: คัดเลือก Use Case ที่คุ้มค่า แล้วสำรวจข้อมูลที่มีอยู่จริง ขั้นที่ 1 — เลือก use case จากความเจ็บปวดทางธุรกิจ ไม่ใช่จากเทคโนโลยี: จงนึกถึงปัญหาที่เกิดซ้ำและแพงที่สุด เช่น เครื่องจักรหลักเสียกะทันหัน ของเสียจากกระบวนการอบ หรือการเปลี่ยนได้ช้ากว่าแผน ให้เลือก 1 ปัญหาที่มีเหตุการณ์เกิดขึ้นอย่างน้อยเดือนละ 2–3 ครั้ง เพราะโมเดลต้องการตัวอย่างเหตุการณ์พอสมควร จากนั้นคำนวณค่าใช้จ่ายที่เกิดจริงต่อเหตุการณ์ (ค่าหยุดไลน์ ค่าของเสีย) เพื่อเป็นตัวชี้วัดว่าโครงการจะคุ้มหรือไม่ ขั้นที่ 2 — ทำ Data Audit อย่างซื่อสัตย์: ระบุว่าปัจจุบันมีสัญญาณใดบ้างที่เก็บแล้วจริง เก็บที่ไหน (SCADA, Historian, PLC, กระดาษบันทึก) ความถี่เท่าไร และอยู่ได้นานแค่ไหน ตารางด้านล่างคือเกณฑ์เบื้องต้นที่ใช้ประเมินความพร้อมของแต่ละสัญญาณ: ระดับความพร้อมสภาพข้อมูลจริงสิ่งที่ต้องทำต่อ ระดับ 0 — กระดาษบันทึกยามเขียนมือทุก 2 ชั่วโมง สแกนเก็บเป็น…
Read More
บทวิเคราะห์: ตลาด Smart Manufacturing 2025–2030 — เมื่อเงินไหลจากฮาร์ดแวร์ไป AI

บทวิเคราะห์: ตลาด Smart Manufacturing 2025–2030 — เมื่อเงินไหลจากฮาร์ดแวร์ไป AI

Article
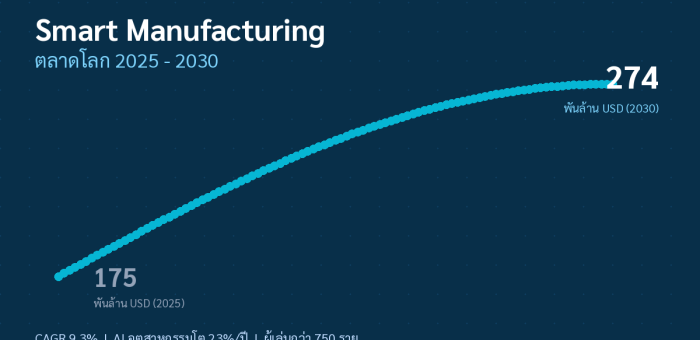
มุมมองจากงานแสดงสินค้า: เมื่อ "ป้าย Smart Factory" ไม่ใช่จุดขายอีกต่อไป ปลายเดือนตุลาคมที่ผ่านมา งาน Smart Manufacturing 2026 ที่กรุงเทพฯ ปิดฉากลงด้วยบรรยากาศที่ต่างจากทุกปีที่ผ่านมา — ทุกบูธพูดเรื่องเดียวกันแต่ต่างคนต่างพูด: AI ที่ลงมือทำงานได้จริงบนพื้นโรงงาน ไม่ใช่ AI ในสไลด์นำเสนอ ปรากฏการณ์นี้สอดคล้องกับข้อมูลตลาดล่าสุดจากรายงาน Industry 4.0 & Smart Manufacturing Market Report 2026–2030 ของ IoT Analytics ที่ระบุว่าตลาดเทคโนโลยีการผลิตอัจฉริยะทั่วโลกในปี 2025 มีมูลค่า 175 พันล้านดอลลาร์สหรัฐ และจะเติบโตเฉลี่ย 9.3% ต่อปี (CAGR) จนแตะ 274 พันล้านดอลลาร์ในปี 2030 โดยมีผู้เล่นในตลาดมากกว่า 750 ราย ตัวเลขนี้บอกอะไรมากกว่าที่เห็น เพราะเบื้องหลังอัตราการเติบโตที่ดู "เฉยๆ" คือการเปลี่ยนองค์ประกอบภายในตลาดอย่างรุนแรง — เงินกำลังไหลจากฮาร์ดแวร์ไปสู่ซอฟต์แวร์และ AI ผู้นำตลาด 10 อันดับแรกต่างเร่งเปลี่ยนตัวเองจากบริษัทขายเครื่องจักร ไปสู่สถาปัตยกรรมที่ขับเคลื่อนด้วยซอฟต์แวร์และผสาน AI (Software-defined, AI-infused architectures) ซึ่งเป็นการปรับตัวครั้งใหญ่ที่สุดของอุตสาหกรรมระบบอัตโนมัติตั้งแต่ยุค PLC ถือกำเนิด ตลาด Smart Manufacturing โลกเติบโตจาก 175 พันล้านดอลลาร์ (2025) สู่ 274 พันล้านดอลลาร์ (2030) ที่ CAGR 9.3% — ค่าเฉลี่ยที่ดูเรียบ แต่ซ่อนการเปลี่ยนโครงสร้างจากฮาร์ดแวร์สู่ซอฟต์แวร์และ AI (ที่มา: IoT Analytics, Industry 4.0 & Smart Manufacturing Market Report 2026–2030) 5 แรงกดดันที่ทำให้โรงงาน "ต้อง" ลงทุน ไม่ใช่ "อยาก" ลงทุน สิ่งที่น่าสนใจจากรายงานคือรายการแรงขับเคลื่อน — ไม่มีข้อไหนเป็นเรื่องเทคโนโลยีเลย ทั้งหมดเป็นแรงกดดันเชิงธุรกิจที่บีบให้ผู้ผลิตต้องลงมือ: ต้นทุนที่สูงขึ้นทุกด้าน: ค่าแรง พลังงาน และวัตถุดิบพุ่งพร้อมกัน เทคโนโลยีจึงกลายเป็นเครื่องมือเพิ่มประสิทธิภาพและลดความสูญเสีย ไม่ใช่ของตกแต่ง ภูมิรัฐศาสตร์และการย้ายฐานผลิต: กระแส Reshoring ผลักการผลิตกลับไปยังพื้นที่ต้นทุนสูง ระบบอัตโนมัติจึงเป็นคำตอบชดเชยแรงงานที่หายไป วิกฤตแรงงานเรื้อรัง: การขาดแคลนแรงงานทักษะและโครงสร้างประชากรที่สูงวัย บังคับให้เทคโนโลยีทำงานร่วมกับคนหรือทดแทนช่องว่าง โครงสร้างพื้นฐานที่พร้อมแล้วจริง: Edge Computing และ Cloud เสถียรพอที่การเชื่อม OT เข้ากับ IT ไม่ใช่โครงการเสี่ยงระเบิดเวลาอีกต่อไป…
Read More
Synthetic Data บำลุยข้อมูลตำหนิขาดแคลน: สร้างภาพ Defect ด้วย Diffusion Model เพื่อเทรน AI ตรวจคุณภาพ

Synthetic Data บำลุยข้อมูลตำหนิขาดแคลน: สร้างภาพ Defect ด้วย Diffusion Model เพื่อเทรน AI ตรวจคุณภาพ

Article
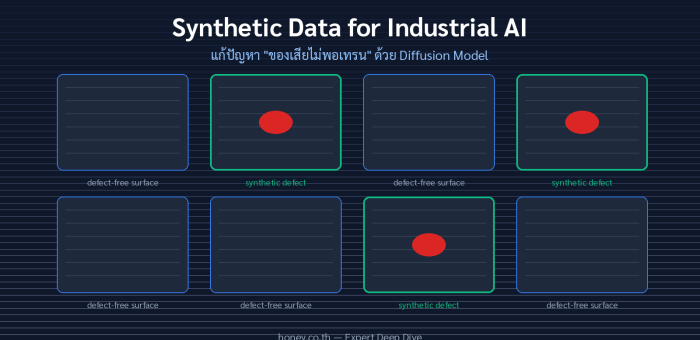
โจทย์คลาสสิกของ AI ตรวจคุณภาพในโรงงานคือ "ของเสียไม่พอเทรน" — ระบบที่ผลิตชิ้นงานถูกต้อง 99.5% จะมีตำหนิให้เก็บภาพเพียง 5 ภาพต่อพันชิ้น และเมื่อรวบรวมได้เป็นร้อยภาพ ก็มักเป็นตำหนิประเภทเดียวกันซ้ำๆ โมเดล deep learning ที่ต้องการภาพหลายพันใบจึง overfit กับความหลากหลายที่แทบไม่มีอยู่จริง บทความนี้ดำน้ำลึกสู่แนวทางที่งานวิจัยปี 2026 ยืนยันแล้วว่าได้ผลจริง: สร้างภาพตำหนิสังเคราะห์ด้วย Diffusion Model แล้วมาเสริมชุดข้อมูลฝึก ทำไม GAN ยุคก่อนยังไม่พอ Generative Adversarial Network (GAN) เคยเป็นคำตอบมาตรฐานของปัญหานี้มานานกว่าห้าปี แต่งานวิจัยที่ตีพิมพ์ใน Multimedia Tools and Applications (2026) สรุปข้อจำกัดที่โรงงานเจอตรงๆ สามข้อ: ปัญหา mode collapse ที่ทำให้ภาพที่สร้างซ้ำซากจำเจ ความละเอียดเท็กซ์เจอร์ความถี่สูงที่ไม่พอสำหรับงานตรวจสอบอุตสาหกรรม และความขัดแย้งพื้นฐานที่สุด — GAN ต้องการข้อมูลปริมาณมากอยู่ด่วนในการเทรนให้เสถียร ซึ่งขัดกับสถานการณ์ low-shot ตั้งแต่ต้น Diffusion Model เปลี่ยนกระบวนทัศน์จากการต่อสู้สองโครงข่าย มาเป็นการ ถอด noise ทีละขั้น (iterative denoising) ที่ optimize ด้วย objective แบบ likelihood ที่เสถียรกว่า ผลคือควบคุมโครงสร้างตำหนิและความหลากหลายได้ดีกว่าอย่างมีนัยสำคัญ — งานเปรียบเทียบโดยตรงในโครงการ CINNABAR 2 ของ DLR MRO Institute (เยอรมนี) พบว่า Diffusion Model ให้คะแนน LPIPS ดีกว่าและยก performance ของตัวตรวจจับขึ้น 12% เมื่อเทียบกับ GAN บนงานตรวจคราบบนผิวเครื่องบิน Pipeline ที่งานวิจัยยืนยันแล้ว ภาพที่ 1: Pipeline การสร้างภาพตำหนิสังเคราะห์ด้วย Latent Diffusion Model — เริ่มจากภาพจริงเพียง 3-5 ใบต่อชนิดตำหนิ แนวทางที่ทรงพลังที่สุดในปัจจุบันคือการ fine-tune Latent Diffusion Model (LDM) ที่ pre-train มาแล้วด้วยเทคนิค DreamBooth + LoRA — ฝัง concept ของตำหนิชนิดใหม่ลงโมเดลด้วยภาพอ้างอิงเพียงไม่กี่ใบ โดยปรับเฉพาะ cross-attention layers เพื่อลดภาระคำนวณ จากนั้นใช้ Differential Diffusion แปะตำหนิที่เรียนรู้ได้ลงบนภาพพื้นผิวปกติ โดยไม่เกิดรอยต่อ (boundary…
Read More
บทวิเคราะห์: WEF Global Lighthouse Network 2026 — โรงงานต้นแบบ 238 แห่ง เมื่อ AI กลายเป็นศูนย์กลางการผลิตโลก

บทวิเคราะห์: WEF Global Lighthouse Network 2026 — โรงงานต้นแบบ 238 แห่ง เมื่อ AI กลายเป็นศูนย์กลางการผลิตโลก

Article
เมื่อวันที่ 22 มิถุนายน 2026 World Economic Forum (WEF) ประกาศรายชื่อโรงงานต้นแบบ Global Lighthouse Network รุ่นล่าสุด โดยเพิ่มสมาชิกใหม่ 16 แห่ง ส่งผลให้เครือข่ายโรงงานต้นแบบด้านการผลิตอัจฉริยะมีจำนวนรวม 238 แห่งทั่วโลก — และสิ่งที่น่าสนใจที่สุดไม่ใช่ตัวเลข แต่คือธรรมชาติของเทคโนโลยีที่ถูกใช้: AI ไม่ได้เป็น "โครงการทดลอง" อีกต่อไป แต่กลายเป็นหัวใจของการบริหารโรงงานและซัพพลายเชนไปแล้ว เครือข่าย Global Lighthouse Network ปี 2026: สมาชิกเดิม 222 แห่ง + รุ่นใหม่ 16 แห่ง = 238 แห่งทั่วโลก (ที่มา: World Economic Forum) AI ก้าวจากโครงการนำร่องสู่ศูนย์กลางการผลิต WEF สรุปว่าโรงงาน Lighthouse รุ่นล่าสุดสะท้อนการเปลี่ยนแปลงสำคัญ 3 ประการ ได้แก่ การใช้ AI และข้อมูลแบบ End-to-End Intelligence เพื่อสนับสนุนการตัดสินใจ การสร้าง Human-Machine Collaboration ผ่านการพัฒนาทักษะแรงงาน และการผสานความยั่งยืน (Sustainability) เข้ากับกลยุทธ์ธุรกิจโดยตรง "โรงงานชั้นนำในปัจจุบันไม่ได้มุ่งเพียงปรับปรุงกระบวนการผลิตทีละส่วน แต่กำลังออกแบบระบบการดำเนินงานใหม่ทั้งหมด โดยมี AI เป็นศูนย์กลางของการเรียนรู้และการเพิ่มประสิทธิภาพอย่างต่อเนื่อง" — Kiva Allgood, กรรมการผู้จัดการ, World Economic Forum 3 การเปลี่ยนแปลงสำคัญจากโรงงาน Lighthouse รุ่นล่าสุด (ที่มา: World Economic Forum, 2026) ถอดรหัส 3 การเปลี่ยนแปลง: มองผ่านมุมของโรงงานไทย การเปลี่ยนแปลง ความหมาย ตัวอย่างการใช้งานจริง ตัวชี้วัดที่ควรมี 1. End-to-End AI Intelligenceรวมข้อมูลจากทั้ง Value Chain มาประมวลผลด้วย AI เพื่อตัดสินใจแบบ real-timeวางแผนการผลิต บริหารคลังสินค้า โลจิสติกส์ และพลังงานในระบบเดียวOEE, On-Time Delivery, พลังงานต่อหน่วยผลผลิต 2. Human-Machine Collaborationพัฒนาทักษะแรงงานให้ทำงานร่วมกับระบบอัจฉริยะ ไม่ใช่ถูกแทนที่ช่างเทคนิคใช้ข้อมูล predictive analytics ตัดสินใจบำรุงรักษาแทนการซ่อมเมื่อพังชั่วโมงอบรมต่อคน/ปี, จำนวน digital skill roles 3. Sustainability Integrationผนวกเป้าหมายความยั่งยืนเข้ากับ KPI การผลิตลด…
Read More
บทวิเคราะห์: Remaining Useful Life (RUL) — เมื่อคำถามเปลี่ยนจาก ‘พังหรือยัง’ เป็น ‘เหลือกี่สัปดาห์’

บทวิเคราะห์: Remaining Useful Life (RUL) — เมื่อคำถามเปลี่ยนจาก ‘พังหรือยัง’ เป็น ‘เหลือกี่สัปดาห์’

Article
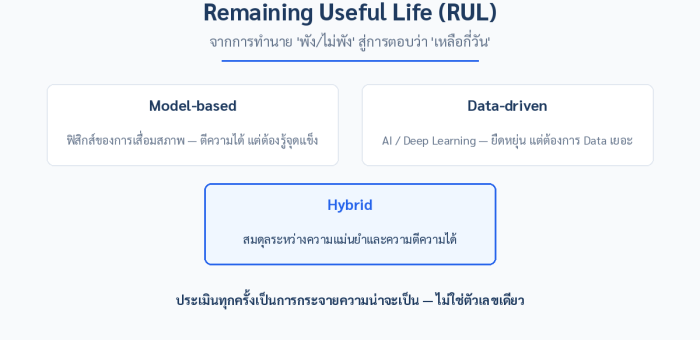
ระบบ Predictive Maintenance ส่วนใหญ่ตอบคำถามได้แค่ "เครื่องนี้กำลังจะพัง" — แต่คำถามที่ Planner และ Production Manager ถามจริงคือ "อีกกี่สัปดาห์จะพัง" เพราะคำตอบนั้นแหละที่ตัดสินได้ว่าจะเลื่อนงานซ่อมไปรวมกับ Shutdown ครั้งถัดไปได้หรือไม่ คำถามนี้คืออาณาเขตของ Remaining Useful Life (RUL) ซึ่งกำลังเปลี่ยนจากงานวิจัยสู่เครื่องมือจริงในโรงงาน RUL ไม่ใช่ตัวเลขเดียว — มันคือการกระจายความน่าจะเป็น ความเข้าใจผิดที่พบมากที่สุดคือคาดหวังให้โมเดลตอบ "เหลืออีก 23 วัน" แบบเด็ดขาด ในความเป็นจริง RUL ที่ถูกต้องคือ ช่วงความเชื่อมั่น เช่น "มีโอกาส 90% ที่จะถึงเกณฑ์เสียหายภายใน 18–26 วัน" เพราะเครื่องจักรสองเครื่องรุ่นเดียวกันภายใต้โหลดต่างกันย่อมเสื่อมสภาพไม่เท่ากัน โมเดลที่ดีจึงต้องรู้จักบอกความไม่แน่นอนของตัวเองด้วย สามเส้นทางของการทำนาย RUL แนวทางหลักการจุดแข็งข้อจำกัด Model-basedสมการฟิสิกส์ของกลไกเสื่อมสภาพ เช่น Paris Law ของรอยแตกตีความได้ ใช้ Data น้อยต้องรู้พารามิเตอร์เครื่องจักรชัดเจน ยืดหยุ่นต่ำ Data-drivenMachine Learning เรียนจากข้อมูลวงจรชีวิตเครื่องจักรจริงแม่นยำ ปรับตัวได้กับระบบซับซ้อนต้องการ Data เสื่อมสภาพจริงจำนวนมาก ตีความยาก Hybridผสมข้อจำกัดทางฟิสิกส์เข้าไปในโมเดล Data-drivenสมดุลความแม่นยำกับการตีความพัฒนาซับซ้อนที่สุด บน P-F Curve — RUL คือการประเมินความกว้างของหน้าต่างทอง ทุกความเสียหายเชิงกลมี ช่วง P-F คือระยะจากจุดที่ตรวจพบได้ครั้งแรก (Potential Failure) ถึงจุดที่พังจริง (Functional Failure) เทคโนโลยีต่าง ๆ เห็นจุด P ไม่พร้อมกัน — Ultrasound มักเห็นก่อนสุด ตามด้วย Oil Analysis แล้วจึง Vibration การทำนาย RUL คือการประมาณว่าจากตำแหน่งปัจจุบันบนเส้นเสื่อมสภาพ ยังเหลือเวลาเท่าไรก่อนแตะเส้น Threshold ซึ่งยิ่งตรวจจับได้เร็ว หน้าต่างการวางแผนก็ยิ่งกว้าง ภาพที่ 1: P-F Curve — ช่วง P-F คือหน้าต่างวางแผนซ่อม และ RUL คือการประมาณเวลาที่เหลือก่อนแตะ Failure Threshold แบบกระจายความน่าจะเป็น (ภาพประกอบเชิงแนวคิด) Deep Learning ไปได้ไกลแค่ไหน — หลักฐานจาก Benchmark จริง ชุดข้อมูล IEEE PHM 2012 Data Challenge (แบริ่งหมุนความเร็วสูงพร้อมข้อมูล Vibration จนถึงวันพังจริง)…
Read More
How-to: วางระบบ AutoML ในโรงงาน 6 ขั้นตอน — สร้าง ML Pipeline ได้โดยไม่ต้องมี Data Scientist ประจำโรงงาน

How-to: วางระบบ AutoML ในโรงงาน 6 ขั้นตอน — สร้าง ML Pipeline ได้โดยไม่ต้องมี Data Scientist ประจำโรงงาน

Article
โรงงานไทยจำนวนมากอยากใช้ Machine Learning กับข้อมูล production ที่มีอยู่ — ข้อมูล SCADA ย้อนหลัง 3 ปี, ค่า energy รายชั่วโมง, สถิติ scrap rate รายล็อต — แต่ติดที่ "ไม่มี data scientist ประจำโรงงาน" งานวิจัย review ปี 2025 ใน International Journal of Machine Learning Studies (Quaranta et al.) ระบุว่า AutoML คือแนวทางที่ promising ที่สุดในการลดการพึ่งพา ML professional โดยตรง และตลาด AutoML โลกเติบโต CAGR 44.5% ช่วง 2026-2030 จากมูลค่า 3.34 พันล้านดอลลาร์ในปี 2025 (Technavio) แต่ AutoML ในบริบทโรงงานไม่ได้ "กดปุ่มเดียวแล้วจบ" บทความนี้คือคู่มือ 6 ขั้นตอนติดตั้ง AutoML บนข้อมูล industrial แบบที่ทีมวิศวกรโรงงานทำเองได้จริง ขั้นที่ 1: จัดแนวปัญหาให้ถูกประเภท AutoML ทำงานได้ดีกับปัญหา tabular ล้วน เช่น ทำนาย scrap rate จากพารามิเตอร์กระบวนการ, จำแนกล็อตที่มีความเสี่ยง, พยากรณ์ demand ราย SKU สิ่งที่มัก fail คือโจทย์ที่ยังเป็นภาพหรือ signal ดิบ — อันนั้นต้องแปลงเป็น feature ก่อน (ดูขั้นที่ 3) ตั้ง objective ให้ชัดว่าต้องการ accuracy หรือ recall — งานตรวจจับของเสียควร optimize recall เพราะปล่อยของเสียหลุดแพงกว่า reject ของดี ขั้นที่ 2: เตรียมข้อมูลให้ AutoML กินได้ ข้อมูลโรงงานมี 3 ปัญหาคลาสสิกที่ AutoML แก้ให้ไม่ได้ ต้องแก้เอง: Time alignment — ค่าจาก sensor กับผล QC ไม่ได้อยู่บน…
Read More
Multimodal Sensor Fusion: ลดจุดบอดของ Predictive Maintenance ด้วยการผสาน Vibration + Acoustic + Thermal + SCADA

Multimodal Sensor Fusion: ลดจุดบอดของ Predictive Maintenance ด้วยการผสาน Vibration + Acoustic + Thermal + SCADA

Article
หลายโรงงานที่เริ่มทำ Predictive Maintenance (PdM) มักเริ่มจากสิ่งที่ง่ายที่สุด: ติดเซ็นเซอร์วัดการสั่น (Vibration) ที่มอเตอร์หรือลูกปืน แล้วปล่อยให้ AI ทำนายว่าเครื่องจักรจะพังเมื่อไหร่ แนวทางนี้ได้ผลจริง แต่งานวิจัยช่วง 2025-2026 เริ่มชี้ชัดว่า โมเดลที่ฟัง "เสียงเดียว" กำลังถึงเพดานความแม่นยำ โดยเฉพาะเมื่อระบบผลิตมีหลายโหลด หลายความเร็ว และความผิดปกติหลายชนิดเกิดพร้อมกัน บทความนี้ถอดประสบการณ์จากงานวิจัยล่าสุดด้าน Multimodal Sensor Fusion — การผสานข้อมูลจากหลายเซ็นเซอร์หลายประเภทเข้าสู่โมเดลเดียว — พร้อมตัวเลขเปรียบเทียบว่าการเพิ่มแต่ละ modality ซื้อความแม่นยำเพิ่มได้เท่าไร และโรงงานไทยควรเริ่มจากตรงไหน ทำไม Single-Modality ไม่พอแล้ว: ตัวเลขจากงานวิจัย งานวิจัยปี 2026 ด้าน condition monitoring ลูกปืนกังหันลม (ตีพิมพ์ใน Journal of Electrical Systems ปลายเดือนมกราคม 2026) ได้ทำสิ่งที่โรงงานส่วนใหญ่ยังไม่เคยทำ: การเปรียบเทียบแบบ Ablation Study — ถอด modality ออกทีละตัวเพื่อวัดว่าแต่ละเซ็นเซอร์ "ซื้อ" ความแม่นยำเพิ่มเท่าไร ผลลัพธ์สรุปได้ตามตารางนี้ ชุดข้อมูลที่ใช้เทรนF1-Scoreสิ่งที่ได้เพิ่ม เฉพาะข้อมูล SCADA (โหลด อุณหภูมิ ความเร็ว)84.5%บริบทการทำงาน แต่ไม่เห็นตัวความเสียหาย เฉพาะ Acoustic Emission (คลื่นเสียงความถี่สูง)89.2%เห็นรอยร้าวเริ่มต้นก่อนใคร เฉพาะ Vibration92.8%มาตรฐานเดิมของ PdM Vibration + SCADA94.1%แยกโหลดหนักออกจากความเสียหายได้ Vibration + Acoustic Emission96.3%Synergy เกินผลรวมของแต่ละตัว ทั้ง 4 modality (Vib+AE+Temp+SCADA)98.9%สูงสุด ทนทานต่อทุกสภาวะโหลด จุดที่น่าสนใจที่สุดคือแถว Vibration + AE ที่ได้ 96.3% — สูงกว่าผลรวมเดี่ยวของทั้งสองตัวบวกกันแล้วหารสอง นั่นคือ ความเสริมแรงกัน (Complementarity): Vibration เก่งจับ "การสั่นพ้องเชิงโครงสร้าง" จากความเสียหายที่ลุกลามแล้ว ขณะที่ AE ไวต่อคลื่นความเค้นความถี่สูงที่เกิดตอนรอยร้าว เพิ่งเริ่มก่อตัว — ทำให้ระบบเห็นสัญญาณตั้งแต่ระยะ Incipient Fault ที่ Vibration ยังเงียบ สถาปัตยกรรมที่ใช้: CNN-LSTM Hybrid บน Edge โมเดลในงานวิจัยนี้ไม่ใช่โมเดลมหึมา แต่เป็นสถาปัตยกรรมผสม 1D-CNN + LSTM ที่ออกแบบให้ลง Edge Computing Platform ใน nacelle กังหันลมได้จริง…
Read More
How-to: ประเมินความพร้อม AI โรงงานด้วยกรอบ TARI — เช็คลิสต์ 8 มิติ และแผน 90 วัน

How-to: ประเมินความพร้อม AI โรงงานด้วยกรอบ TARI — เช็คลิสต์ 8 มิติ และแผน 90 วัน

Article
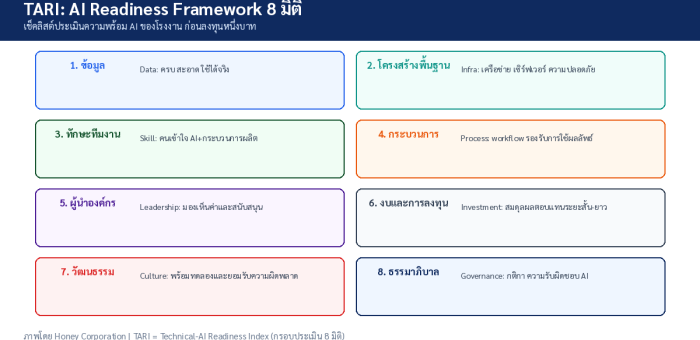
กลางปี 2026 ประเทศไทยมีเครื่องมือใหม่ที่โรงงานควรรู้จัก: Thailand AI Readiness Index (TARI) — ดัชนีวัดความพร้อมด้าน AI ฉบับแรกของประเทศ ผลิตจากความร่วมมือระหว่างหน่วยงานนโยบายด้านอุดมศึกษา วิทยาศาสตร์ วิจัยและนวัตกรรม (MHESI) สภานโยบายการอุดมศึกษา วิทยาศาสตร์ วิจัยและนวัตกรรมแห่งชาติ (NXPO) ร่วมกับภาคเอกชน สาระสำคัญคือ TARI เป็น มาตรฐานกลางระดับชาติ สำหรับประเมินความพร้อม AI อย่างเป็นระบบ ครอบคลุม 3 ระดับ: องค์กร หน่วยงาน (Business Function) และบุคคล — และนี่คือช่วงเวลาที่ดีที่โรงงานไทยควรใช้กรอบนี้จัดระเบียบการเดินทางสู่ AI ของตัวเอง ก่อนที่คู่แข่งจะวัดค่าแล้วไปไกลกว่า ทำไมต้องวัดตอนนี้: รายงานระดับโลกปี 2026 พบว่าองค์กรอุตสาหกรรมกว่า 90% ที่ใช้ AI หน้างานจริงได้ผลลัพธ์วัดได้ แต่เพียง 4% มีกลไกบังคับ Human Oversight ในการตัดสินใจที่ AI สนับสนุน — การวัดความพร้อมจึงไม่ใช่การชะลอตัว แต่คือการป้องกันไม่ให้ AI วิ่งแบบไร้เข็มขัดนิรภัย 8 มิติของ TARI — แปลงเป็น Checklist หน้างานโรงงาน กรอบ TARI ประเมิน 8 มิติ ซึ่งเมื่อแปลงเป็นภาษาโรงงานแล้ว สามารถใช้เป็นแบบสำรวจตัวเองได้ทันที: มิติ TARI คำถามสำรวจสำหรับโรงงาน สัญญาณว่า “ยังไม่พร้อม” 1. กลยุทธ์และภาวะผู้นำ AI มีเป้าหมาย AI ที่ผูกกับตัวเลขธุรกิจหรือไม่ (OEE, Downtime, Yield)? มีแต่คำว่า “ใช้ AI” ในแผน แต่ไม่มี KPI เจ้าของ 2. การจัดการข้อมูล ข้อมูลเครื่องจักรถูกเก็บอัตโนมัติ มีต้นทางชัดเจน และค้นได้หรือไม่? ข้อมูลยังอยู่ในกระดาษ ไฟล์ Excel กระจัดกระจาย หรือฝังใน HMI เก่า 3. เทคโนโลยีและโครงสร้างพื้นฐาน เครื่องจักรหลักเชื่อมต่อข้อมูลได้ (ไม่ใช่แค่เดินเครื่อง)? สายการผลิตสำคัญไม่มีจุดเก็บข้อมูลเลย 4. บุคลากรและทักษะ AI ทีมหน้างานมีคนใช้เครื่องมือวิเคราะห์ข้อมูลได้กี่คน? พึ่ง “คนเดียว” ในบริษัทที่รู้เรื่องข้อมูล 5. ธรรมาภิบาลและการบริหารความเสี่ยง มีกฎว่าใครใช้ AI ตัดสินใจอะไรได้บ้าง และต้องมีคนตรวจกี่ขั้น? ไม่มีใครรู้ว่าหน้างานกำลังใช้ AI หรือ…
Read More
บทวิเคราะห์: หน้างานวิ่งนำ C-suite — Industrial AI Index 2026 เผยช่องว่างควบคุมที่อันตรายกว่าการยอมรับช้า

บทวิเคราะห์: หน้างานวิ่งนำ C-suite — Industrial AI Index 2026 เผยช่องว่างควบคุมที่อันตรายกว่าการยอมรับช้า

Article
กลางเดือนตุลาคม 2026 รายงานสำรวจรายใหม่จากผู้ให้บริการซอฟต์แวร์ Industrial AI รายใหญ่ระดับโลก (เผยแพร่ 13 ตุลาคม 2026) สร้างคำถามที่ไม่สบายใจสำหรับผู้บริหารโรงงานหลายราย: ถ้าทีมหน้างานเป็นฝ่ายขับเคลื่อน AI จริง แล้วผู้บริหารกำลังทำอะไรอยู่? รายงานฉบับนี้สำรวจผู้บริหารอาวุโสกว่า 2,200 คนจาก 14 ประเทศ แล้วพบ "Execution Divide" ชัดเจน — วิศวกร หัวหน้าโรงงาน และผู้รับผิดชอบโลจิสติกส์ คือกลุ่มที่ทำให้ AI เกิดผลเชิงพาณิชย์จริง ขณะที่กรอบ Governance และโครงสร้างการเข้าถึงข้อมูลกลับตามไม่ทัน ตัวเลขจากหน้างาน: ได้ผลจริงและวัดได้ องค์กรกว่า 90% ที่นำ AI อุตสาหกรรมไปใช้งานจริงรายงานผลลัพธ์เชิงประจักษ์ โดยเฉพาะด้านความน่าเชื่อถือของสินทรีย์กร: 93% ปรับปรุงอัตราการทำงาน "ถูกตั้งแต่ครั้งแรก" (First-Time-Right) 90% เพิ่มความพร้อมใช้งานของเครื่องจักร (Asset Availability) 88% ปรับปรุงการส่งมอบตรงตามแผน (On-Time Delivery Adherence) กว่า 50% ของเวลาพนักงานในงานหลักอย่าง Throughput และ Quality Assurance ถูกปลดปล่อยออกมา เวลาที่ได้คืนถูกนำไปใช้ต่อ: 36% ทุ่มให้ความปลอดภัยและการฝึกอบรมบุคลากร, 35% ปรับปรุงประสิทธิภาพเครื่องจักร, 26% เร่ง Continuous Improvement และ 25% ขยายส่วนแบ่งตลาด ห้องควบคุมการผลิต — จุดที่ทีมหน้างานใช้ข้อมูล Operational ตัดสินใจทุกวัน (ภาพ: Wikimedia Commons) ปรากฏการณ์ที่ต้องจับตา: คนหน้างาน "ฝึก AI ให้ทำงานแทน" ก่อนที่ผู้บริหารจะรู้ตัว ข้อมูลที่น่าประหลาดใจที่สุดคือพฤติกรรมของ Frontline ในช่วง 12 เดือนที่ผ่านมา: 43% ฝึกและนำ Agentic Digital Workers (AI Agent ที่ทำงานบางส่วนแทนคนได้) เข้าสู่งานประจำวันจริง 37% อัปสกิลเพื่อนร่วมงานให้ใช้เครื่องมือ AI อุตสาหกรรมในงานประจำวัน 36% ฝึกทีมให้ทำงานร่วมกับ Digital Worker โดยตรง ขณะที่ความพยายามหลักของผู้บริหารช่วงเดียวกันคือ "อัปสกิลตัวเอง" (41%) เพื่อให้เข้าใจ AI — ความสนใจหันเข้าด้านใน มากกว่าเสริมพลังให้หน้างานที่กำลังวิ่งอยู่แล้ว และความมั่นใจของผู้นำ (30%) กลายเป็นอุปสรรคใหญ่ที่สุดของการขยายผล ช่องว่างที่อันตรายกว่า: มั่นใจบนกระดาษ แต่ขาด Controls ที่หน้างาน ปัญหาไม่ใช่การยอมรับ AI…
Read More
Agent-Based Simulation และ Knowledge Graph: เมื่อ Digital Twin เลิกรอคำสั่ง แล้วให้ทุกเครื่องจักรคิดเอง

Agent-Based Simulation และ Knowledge Graph: เมื่อ Digital Twin เลิกรอคำสั่ง แล้วให้ทุกเครื่องจักรคิดเอง

Article
เมื่อ Digital Twin เลิกเป็น "หุ่นยนต์เดินตามคำสั่ง": ทำไม Simulation ยุคใหม่ต้องให้ทุกเครื่องจักร "คิดเอง" ถ้าถามว่า Digital Twin คืออะไร คำตอบส่วนใหญ่คือ "โมเดลจำลองโรงงานที่ซิงก์ข้อมูล Real-Time" คำตอบนั้นถูกต้อง — แต่ไม่เพียงพออีกต่อไปแล้ว ปัญหาของ Twin แบบดั้งเดิมคือมันเป็น โมเดลเดี่ยวที่ต้องรอคนสั่ง: อยากรู้ว่าถ้าเพิ่มความเร็วคอนเวเยอร์ 15% จะเกิดอะไรขึ้น ต้องมีวิศวกรมานั่งตั้งค่า รัน What-If แล้วรอผล แนวโน้มใหม่ที่งานวิจัยระดับโลกกำลังพิสูจน์คือการผสาน Agent-Based Simulation (ABS) เข้ากับ Digital Twin — แทนที่จะสร้างโมเดลใหญ่หนึ่งเดียวที่คำนวณทุกอย่างพร้อมกัน ให้แต่ละองค์ประกอบในโรงงาน (เครื่องจักร, AGV, คนงาน, คลังสินค้า) กลายเป็น "เอเจนต์" ที่มีกฎการตัดสินใจของตัวเอง แล้วปล่อยให้พวกมันโต้ตอบกันเอง เหมือนโรงงานจริงที่ไม่มีใครสั่งการทุกจุด ระบบผลิตที่ซับซ้อน มีพฤติกรรม "อุบัติเหตุ" ที่ไม่มีสมการใดพรรณนาได้ — ภาพ: Wikimedia Commons สิ่งที่สมการเดี่ยวทำไม่ได้: Emergent Behavior จุดขายที่แท้จริงของ Agent-Based Simulation คือการจับ Emergent Behavior — พฤติกรรมที่เกิดขึ้นจากการโต้ตอบของส่วนย่อยจำนวนมาก แต่ไม่สามารถคาดเดาได้จากการดูส่วนย่อยแต่ละชิ้นแยกกัน ตัวอย่างคลาสสิกในโรงงาน: Deadlock ที่คลังสินค้า — AGV 8 คันไม่มีคันไหนผิดกติกา แต่ลำดับการเข้า-ออกของทั้งระบบในวันที่ Order เยอะทำให้ติดกับแก่นกันเอง คอขวดที่เคลื่อนตำแหน่ง — Buffer หน้าเครื่องจักรเครื่องหนึ่งเต็มทุกวัน เมื่อเพิ่มกำลังเครื่องนั้น คอขวดกลับไปโผล่ที่จุดที่ไม่มีใครคาดคิด ผลกระทบลูกโซ่ของ Breakdown — เครื่องหนึ่งหยุด 30 นาที ทำไม WIP ในส่วนอื่นของโรงงานแทบไม่ขยับ แต่บางครั้งหยุดแค่ 10 นาทีกลับสร้างความปั่นป่วนทั้งกะ ปรากฏการณ์เหล่านี้เกิดจาก ความแปรปรวนทางสถิติ (Stochastic Variability) ของเวลาทำงาน เวลารอ และลำดับเหตุการณ์ — สิ่งที่ Discrete-Event Simulation แบบดั้งเดิมจำลองได้ระดับหนึ่ง แต่การเพิ่ม "ตัวตนและกฎการตัดสินใจ" ให้แต่ละเอเจนต์ทำให้โมเดลสะท้อนความจริงได้ลึกกว่า โดยเฉพาะเมื่อมีคนและระบบอัตโนมัติทำงานปนกัน หลักฐานจากงานวิจัย: โมเดล 3 ชั้น + Knowledge Graph งานวิจัยที่ตีพิมพ์ในวารสาร Scientific Reports (2025) ได้สาธิตแนวทางนี้ด้วยสถาปัตยกรรมที่น่าสนใจ: แทนที่จะปล่อยให้เอเจนต์ "คิดเองเลือกอะไรก็ได้" พวกเขาคุมโครงสร้างความรู้ด้วย Knowledge Graph…
Read More