Pump Cavitation ตั้งแต่ฟิสิกส์ฟองไอถึง NPSH Margin: Deep Dive ปัญหาที่กัดใบพัดเงียบๆ

Pump Cavitation ตั้งแต่ฟิสิกส์ฟองไอถึง NPSH Margin: Deep Dive ปัญหาที่กัดใบพัดเงียบๆ

Article
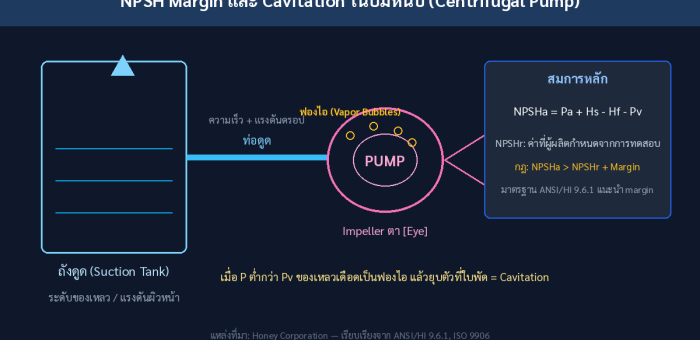
NPSH Margin คือเส้นแบ่งระหว่างปั๊มที่ทำงานเงียบสบาย กับปั๊มที่กำลังกัดใบพัดตัวเองทีละน้อย ปั๊มหนีบ (Centrifugal Pump) คือหัวใจของโรงงานส่วนใหญ่ แต่ปัญหาที่พบบ่อยที่สุดอย่าง Cavitation มักถูกมองข้ามจนกระทั่งใบพัดพัง เสียงดังเหมือน "กรวดในปั๊ม" ที่ช่างบางคนเข้าใจว่าเป็นเรื่องปกติ แท้จริงคือสัญญาณของความเสียหายที่สะสมอยู่แล้ว บทความนี้เจาะลึกตั้งแต่ฟิสิกส์ของฟองไอ การคำนวณ NPSH อย่างถูกต้อง ไปจนถึงการตรวจจับด้วย Condition Monitoring สมัยใหม่ ฟิสิกส์ของฟองไอ: ของเหลวเดือดที่อุณหภูมิห้องได้อย่างไร Cavitation เกิดเมื่อแรงดันท้องถิ่นในปั๊มต่ำกว่าแรงดันไอ (Vapor Pressure) ของของเหลว ณ อุณหภูมิทำงาน น้ำที่ 25 องศาเซลเซียสมีแรงดันไอประมาณ 3.2 kPa ดังนั้นถ้าแรงดันที่ตาใบพัด (Impeller Eye) ต่ำกว่าค่านี้ น้ำจะเดือดกลายเป็นฟองไอทันที ปรากฏการณ์นี้คือ "การเดือดเพราะแรงดันตก" ไม่ใช่ความร้อน และเป็นคำอธิบายที่ตรงกว่าคำว่า "ปั๊มดูดไม่พอ" ที่เข้าใจกันผิดในสนาม จุดที่ทำลายเครื่องจักรไม่ใช่การเกิดฟอง แต่คือ การยุบตัว เมื่อฟองไอไหลเข้าสู่โซนแรงดันสูงด้านส่งของใบพัด ฟองจะยุบตัวภายในไม่กี่ไมโครวินาที เกิด Micro-jet ของเหลวพุ่งชนผิวโลหะด้วยแรงดันท้องถิ่นระดับกิกะปาสกาล (GPa) มากพอจะดึงเนื้อโลหะออกทีละน้อย รอยที่เกิดจึงเป็น "โพรงฟองนม" ขนาดสม่ำเสมอ ต่างจากรอยขีดข่วนจากอนุภาคแข็ง Cavitation สะสมเป็น 3 ระยะ — จากฟองไอเงียบๆ จนถึงใบพัดร้าว NPSH: ตัวเลขที่ต้องเข้าใจก่อนติดเซ็นเซอร์ตัวแรก NPSH Available (NPSHa) คือพลังงานแรงดันที่ระบบท่อจัดให้ ณ ตาใบพัด: NPSHa = (Pa − Pv) / (ρg) + Hs − Hf Pa = แรงดันผิวหน้าของเหลว, Pv = แรงดันไอ, ρ = ความหนาแน่น, g = ความเร่งโน้มถ่วง, Hs = ระดับดูด (บวกเมื่อของเหลวท่วมตาใบพัด), Hf = แรงเสียดทานในท่อดูด NPSH Required (NPSHr) คือค่าที่ผู้ผลิตปั๊มกำหนดจากการทดสอบตาม ISO 9906 โดยทั่วไประบุที่จุด Head ตก 3% (NPSH3) ที่อัตราไหลนั้นๆ กฎเหล็กคือ NPSHa ต้องมากกว่า NPSHr เสมอ แต่ "มากกว่าเท่าไร" คือคำถามที่แยกโรงงานที่ใบพัดอยู่ครบ 10 ปี ออกจากโรงงานที่เปลี่ยนใบพัดทุกปี…
Read More
How-to: เตรียมข้อมูลเครื่องจักรให้พร้อมสำหรับ Industrial AI ใน 6 ขั้นตอน — ก่อน AI ต้องมีข้อมูล

How-to: เตรียมข้อมูลเครื่องจักรให้พร้อมสำหรับ Industrial AI ใน 6 ขั้นตอน — ก่อน AI ต้องมีข้อมูล

Article
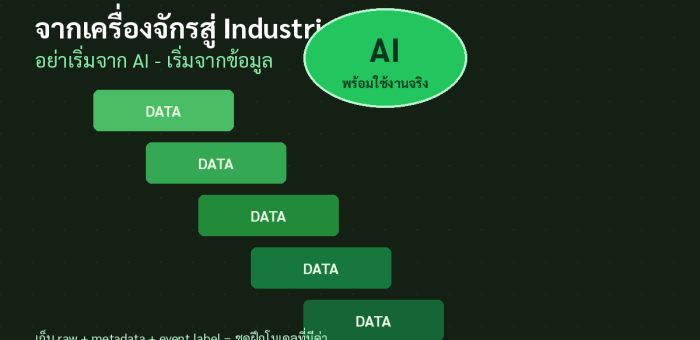
ทำไมโครงการ AI ในโรงงานถึงตายก่อนถึงไลน์ผลิต คำถามที่เราได้ยินบ่อยที่สุดจากผู้บริหารโรงงานช่วงหลังนี้คือ "อยากใช้ AI ในโรงงาน แต่ควรเริ่มจากตรงไหน" — และคำตอบที่หลายคนไม่อยากได้ยินคือ อย่าเริ่มจาก AI เริ่มจากข้อมูล รายงานล่าสุดของ IoT Analytics ระบุว่าตลาด Industrial AI จะเติบโตจาก 43.6 พันล้านดอลลาร์ (2024) สู่ 153.9 พันล้านดอลลาร์ในปี 2030 ที่ CAGR 23% แต่ปัจจุบันการใช้จ่าย AI ในภาคผลิตยังคิดเป็นเพียง 0.1% ของรายได้ สาเหตุใหญ่ไม่ใช่ AI ไม่เก่งพอ แต่คือโรงงานส่วนใหญ่ยังไม่มีข้อมูลที่ "ใช้เพื่อฝึกและใช้งาน AI ได้จริง" งานนำร่อง AI ที่ล้มเหลวมักมีร่องรอยเดียวกัน: ทีมพัฒนาได้รับไฟล์ Excel ที่ส่งออกจาก SCADA ทีละเดือน ข้อมูลขาดหายเป็นช่วงๆ เซ็นเซอร์บางตัวเซ็นสเกลผิด ไม่มีใครรู้ว่าหน่วยเป็นอะไร และไม่มีเหตุการณ์ปัญหาที่ติดแท็กไว้ให้โมเดลเรียนรู้ โมเดลที่ดีที่สุดก็ช่วยไม่ได้เมื่อข้อมูลตั้งต้นเป็นเช่นนั้น — นี่คือเหตุผลที่คู่มือนี้มุ่งเน้นเรื่องเดียว: วางรากฐานข้อมูลให้ถูกต้องก่อน AI ลงมือ เส้นทาง 6 ขั้นตอนจากเครื่องจักรถึง Industrial AI — งาน 70% อยู่ใน 3 ขั้นตอนแรกที่ไม่มีใครเห็น ไม่ใช่ตัวโมเดล (ที่มา: สังเคราะห์โดย Honey Corporation) ขั้นที่ 1–2: คัดเลือก Use Case ที่คุ้มค่า แล้วสำรวจข้อมูลที่มีอยู่จริง ขั้นที่ 1 — เลือก use case จากความเจ็บปวดทางธุรกิจ ไม่ใช่จากเทคโนโลยี: จงนึกถึงปัญหาที่เกิดซ้ำและแพงที่สุด เช่น เครื่องจักรหลักเสียกะทันหัน ของเสียจากกระบวนการอบ หรือการเปลี่ยนได้ช้ากว่าแผน ให้เลือก 1 ปัญหาที่มีเหตุการณ์เกิดขึ้นอย่างน้อยเดือนละ 2–3 ครั้ง เพราะโมเดลต้องการตัวอย่างเหตุการณ์พอสมควร จากนั้นคำนวณค่าใช้จ่ายที่เกิดจริงต่อเหตุการณ์ (ค่าหยุดไลน์ ค่าของเสีย) เพื่อเป็นตัวชี้วัดว่าโครงการจะคุ้มหรือไม่ ขั้นที่ 2 — ทำ Data Audit อย่างซื่อสัตย์: ระบุว่าปัจจุบันมีสัญญาณใดบ้างที่เก็บแล้วจริง เก็บที่ไหน (SCADA, Historian, PLC, กระดาษบันทึก) ความถี่เท่าไร และอยู่ได้นานแค่ไหน ตารางด้านล่างคือเกณฑ์เบื้องต้นที่ใช้ประเมินความพร้อมของแต่ละสัญญาณ: ระดับความพร้อมสภาพข้อมูลจริงสิ่งที่ต้องทำต่อ ระดับ 0 — กระดาษบันทึกยามเขียนมือทุก 2 ชั่วโมง สแกนเก็บเป็น…
Read More
บทวิเคราะห์: Few-Shot Learning กับงานตรวจตำหนิ — เมื่อมีของเสียแค่ 30 ชิ้น ต้องเทรน AI ตรวจคุณภาพอย่างไร

บทวิเคราะห์: Few-Shot Learning กับงานตรวจตำหนิ — เมื่อมีของเสียแค่ 30 ชิ้น ต้องเทรน AI ตรวจคุณภาพอย่างไร

Article
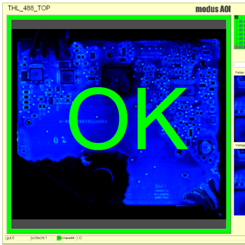
คำถามที่ QA Manager ถามกันทุกโรงงาน: "จะเทรน AI ตรวจตำหนิได้อย่างไร ในเมื่อตัวอย่างของเสียมีแค่ 20-30 ชิ้นจากทั้งปี?" คำถามนี้เคยเป็นปมตายของ AI inspection เพราะ deep learning แบบ supervised ต้องการข้อมูลหลักพันถึงหมื่นภาพต่อ class แต่ปี 2025-2026 สนามวิจัย Few-Shot Learning (FSL) สำหรับงานตรวจตำหนิอุตสาหกรรมเปลี่ยนไปมาก — และตัวเลขที่ตีพิมพ์ล่าสุดบอกว่าอุปสรรค "ข้อมูลน้อย" กำลังถูกทลายทีละชั้น บทวิเคราะห์นี้รวมตัวเลขจากงานวิจัย 5 ชิ้นล่าสุด เพื่อช่วยโรงงานไทยตัดสินใจว่า FSL พร้อมใช้จริงแค่ไหนในปี 2026 และควรเริ่มต้นจากกลยุทธ์ใด ตัวเลขล่าสุดบอกอะไร งานวิจัย (ปี)โจทย์เงื่อนไขผลลัพธ์เด่น TMCNet (2025)Defect segmentation1-shotmIoU 67.8% (FSSD-12), 42.3% (SD-4i) MF-GNN (2025)จำแนกตำหนิเหล็กแผ่น1-shotaccuracy >92% (SEVERSTAL, NEU-DET) RPS-GA (2026)ตรวจตำหนิ PCB10-shotmAP@0.5 จาก 0.086 → 0.299 Meta-YOLO (review 2025)ตำหนิอะลูมิเนียมเย็น30-shotmAP +14.6%, recall 93.6%, 41.9 FPS Attention-FSL (2025)ตำหนิผิวโลหะFew-shotนำทุก baseline ทดสอบ อ่านตารางนี้แบบมีมุม: ที่ 30-shot (รูปของเสีย 30 ใบ) ระบบรัน real-time ได้ 41.9 FPS พร้อม recall 93.6% — นั่นคือระดับที่ใช้หน้างานได้จริง ส่วนที่ 1-shot ผลยังแตกต่างกันตามความยากของ task (classification ทำได้ดีกว่า segmentation ชัดเจน) ภาพจากระบบ Automated Optical Inspection (AOI) — สายพานที่ของเสียหายากมักสะสมภาพ OK นับหมื่น แต่ภาพ defect ไม่ถึง 100 ใบ Few-Shot Learning ออกแบบมาเพื่อสถานการณ์นี้โดยเฉพาะ (ภาพ: Wikimedia Commons) 4 เส้นทางเทคนิคที่งานวิจัยเดินกันจริง 1. Meta-Learning / Prototypical Network แนวคิด: เทรนโมเดลให้ "เก่งการเรียนรู้ไว" โดยฝึกกับหลาย task จำนวนมาก…
Read More
Zero-Shot Anomaly Detection: ตรวจจับตำหนิที่ AI “ไม่เคยเห็นมาก่อน” ด้วย Vision-Language Model

Zero-Shot Anomaly Detection: ตรวจจับตำหนิที่ AI “ไม่เคยเห็นมาก่อน” ด้วย Vision-Language Model

Article
ทำไมโมเดล AI แบบเดิมถึง "เพิ่มรุ่นใหม่ไม่ทัน" โรงงานสมัยนี้เปลี่ยนผลิตภัณฑ์เร็วขึ้นมาก สายการผลิตเดียวอาจสลับ SKU ทุก 2–3 วัน ลูกค้าของัดสีพิเศษ หรือมีอะไหล่ใหม่ที่ไม่เคยมีในชุดข้อมูลเดิม ปัญหาคือระบบตรวจจับตำหนิด้วย AI แบบดั้งเดิม (Supervised Learning) ต้องการภาพตัวอย่างที่ "ติดป้าย" จำนวนหลายพันภาพต่อหนึ่ง Defect กว่าจะเทรนเสร็จ ผลิตจริงเปลี่ยนไปแล้ว งานวิจัยล่าสุดจาก arXiv (LiZAD, กรกฎาคม 2026) ระบุชัดว่า "ในสายการผลิต High-throughput ยุคใหม่ การเก็บและ Label ข้อมูลสำหรับทุก Scenario ใหม่เป็นเรื่องไม่ practical แล้ว" นี่คือช่องว่างที่ Zero-Shot Anomaly Detection (ZSAD) เข้ามาเติม — ตรวจจับตำหนิที่โมเดล "ไม่เคยเห็นมาก่อนเลย" ด้วยการอาศัยความเข้าใจภาษาธรรมชาติที่ฝังอยู่ใน Vision-Language Model สายการผลิตอัตโนมัติยุคใหม่ต้องรองรับการเปลี่ยน SKU ที่เร็วขึ้น ระบบตรวจคุณภาพจึงต้อง "ยืดหยุ่น" ตาม (ภาพ: Wikimedia Commons) Vision-Language Model ทำงานกับงานตรวจตำหนิอย่างไร หัวใจของแนวทางนี้คือการเทียบ "ความหมาย" ระหว่างภาพกับข้อความ แทนที่จะจำตำหนิรูปแบบเดิมๆ ระบบจะสร้าง Prompt เช่น a photo of a normal metal surface และ a photo of a metal surface with scratch แล้ววัดว่าภาพที่กล้องจับมา "ใกล้เคียง" ประโยคไหนมากกว่า ถ้าใกล้ประโยคที่พูดถึงตำหนิมากกว่า ระบบก็แจ้งเตือนทันที โดยไม่ต้องเทรนใหม่แม้แต่ภาพเดียว งานวิจัยสายนี้ส่วนใหญ่อ้างอิงสถาปัตยกรรมแบบ CLIP (Contrastive Language-Image Pre-training) ซึ่งเทรนล่วงหน้าด้วยคู่ภาพ-ข้อความนับร้อยล้านคู่ ทำให้โมเดลเข้าใจความสัมพันธ์ระหว่าง "รอยขีดข่วน" ในเชิงภาษา แล้ว map มาหา pattern ทางภาพได้โดยอัตโนมัติ แนวคิด Object Localization ด้วย AI — ZSAD ต่อยอดด้วยการเทียบความหมายระหว่างภาพกับข้อความแทนการจำ Pattern เดิม (ภาพ: Wikimedia Commons) เทคนิคสำคัญที่งานวิจัยปี 2026 กำลังพัฒนา เทคนิค แนวคิด ประโยชน์ต่อโรงงาน Discrete Prompt Optimization (CoEvoAD, ส.ค.…
Read More
AI Security ในโรงงานอุตสาหกรรม: เมื่อ AI ที่ปกป้องสายการผลิต กลายเป็นเป้าหมายของผู้โจมตี

AI Security ในโรงงานอุตสาหกรรม: เมื่อ AI ที่ปกป้องสายการผลิต กลายเป็นเป้าหมายของผู้โจมตี

Article
เมื่อ AI เข้ามาอยู่ในสายการผลิต ใครจะเป็นคนเฝ้า AI ของคุณ? สองปีที่ผ่านมา โรงงานไทยต่างรีบดึง AI เข้าไปอยู่ในทุกจุดของสายการผลิต ตั้งแต่กล้องตรวจสอบคุณภาพบนสายพาน โมเดลทำนายการเสียหายของเครื่องจักร ไปจนถึงผู้ช่วย AI ที่ช่วยแนะนำการตั้งค่าพารามิเตอร์เครื่องจักร แต่มีคำถามหนึ่งที่หลายองค์กรยังไม่เคยตอบตัวเอง — ถ้า AI ตัวนั้นถูกโจมตี ใครจะรู้ตัว และรู้ได้อย่างไร รายงานดัชนีภัยคุกคามไซเบอร์ระดับโลกปี 2025 ระบุว่าอุตสาหกรรมการผลิตครองสัดส่วนการโจมตีทางไซเบอร์ถึง 17% ของทั้งหมดในปี 2025 เพิ่มขึ้นจาก 9% เมื่อปีก่อน ขณะที่ผลสำรวจผู้ผลิตทั่วโลกช่วงต้นปี 2026 พบว่า 40% ของผู้ผลิตส่วนใหญ่ระบุว่าความมั่นคงปลอดภัยไซเบอร์เป็นอุปสรรคอันดับ 1 ของการนำ AI มาใช้ — พวกเขามองเห็นความเสี่ยง แต่ทางออกที่ถูกต้องไม่ใช่การใช้ AI ให้น้อยลง หากคือการออกแบบระบบ AI ที่ "ปลอดภัยตั้งแต่ต้นทาง" (Security by Design) สายการผลิตอัตโนมัติสมัยใหม่มี AI ฝังอยู่ในทุกจุดตัดสินใจ — ตั้งแต่กล้องตรวจคุณภาพจนถึงการควบคุมเครื่องจักร (ภาพ: Wikimedia Commons, Public Domain) AI ในโรงงานถูกโจมตีได้จากทางไหนบ้าง? เส้นแบ่งระหว่าง "ปัญญาประดิษฐ์" กับ "ช่องโหว่ความปลอดภัย" ในโรงงานบางครั้งบางเกินไป การโจมตี AI ในสภาพแวดล้อมอุตสาหกรรมไม่ได้มากับไฟล์ malware ที่ antivirus สแกนเจอ หากมากับการบิดเบือน "ข้อมูล" และ "กระบวนการตัดสินใจ" ของ AI เอง ซึ่งเป็นมุมที่ทีม IT แบบดั้งเดิมมักมองข้าม เวกเตอร์การโจมตี กลไกการโจมตี ผลกระทบต่อสายการผลิต Adversarial Examples เพิ่มสัญญาณรบกวนขนาดเล็กที่ตามนุษย์มองไม่เห็น ทำให้โมเดล Computer Vision จำแนกชิ้นงานพลาด ชิ้นงานบกพร่องเล็ดลอดถึงลูกค้า หรือชิ้นงานดีถูกทิ้งเป็น scrap ทั้งที่เครื่องจักรปกติดี Model Poisoning แทรกข้อมูลปลอมเข้าชุดข้อมูลเทรน เช่น ป้ายกำกับผิดในระบบติดป้ายอัตโนมัติ จนโมเดลเรียนรู้ว่าความผิดปกติคือเรื่องปกติ โมเดล "เงียบๆ โง่ลง" อัตราการจับ scrap ค่อยๆ ตกลงเป็นเดือนโดยไม่มีใครรู้ตัว Data Evasion ปรับสภาพสัญญาณจากเซ็นเซอร์ เช่น ออฟเซ็ตอุณหภูมิเล็กน้อย ให้พ้นช่วงตรวจจับของโมเดล Anomaly Detection ความผิดพลาดของเครื่องจักรถูก "ทำให้มองไม่เห็น" จนเกิดความเสียหายจริง Prompt Injection ฝังคำสั่งแอบแฝงในเอกสารทางเทคนิค คู่มือ หรือ work…
Read More
TinyML ในโรงงานอุตสาหกรรม: ฝาก AI ลงไมโครคอนโทรลเลอร์ขนาด KB เพื่อตรวจสุขภาพเครื่องจักรแบบ Real-time โดยไม่ต้องพึ่งคลาวด์

TinyML ในโรงงานอุตสาหกรรม: ฝาก AI ลงไมโครคอนโทรลเลอร์ขนาด KB เพื่อตรวจสุขภาพเครื่องจักรแบบ Real-time โดยไม่ต้องพึ่งคลาวด์

Article
หลายโรงงานที่เริ่มใช้ AI ตรวจสอบสถานะเครื่องจักรมักเจอทางตันเดียวกัน คือสถาปัตยกรรมแบบ “ส่งข้อมูลขึ้นคลาวด์แล้วค่อยวิเคราะห์” ทำงานได้ดีในห้องทดลอง แต่เมื่อลงสนามจริงกับเซ็นเซอร์หลายร้อยจุด ปัญหาที่ตามมาคือค่า bandwidth, latency หลายร้อยมิลลิวินาที และความเสี่ยงเมื่ออินเทอร์เน็ตขาดกลางคัน คำตอบที่วงวิศวกร embedded เลือกใช้มากขึ้นเรื่อยๆ ในปี 2026 คือ TinyML — การฝากโมเดล Machine Learning ที่ผ่านการบีบอัดลงไปรันบนไมโครคอนโทรลเลอร์ (MCU) ที่มี RAM เพียงหลักร้อยกิโลไบต์ กินไฟระดับมิลลิวัตต์ และตัดสินใจได้เองที่ขอบเครือข่ายโดยไม่ต้องส่งข้อมูลดิบออกไปไหนเลย TinyML คืออะไร และทำไมโรงงานควรสนใจ TinyML คือสาขาย่อยของ Machine Learning ที่เน้นการ deploy และรันโมเดลบนอุปกรณ์ embedded ที่มีทรัพยากรจำกัด เช่น ไมโครคอนโทรลเลอร์ที่มี RAM เพียง “หลักสิบถึงหลักร้อยกิโลไบต์” flash จำกัด ไม่มี GPU และมักรันบน bare-metal หรือ RTOS เบาๆ ข้อจำกัดพวกนี้บังคับให้ทุกการตัดสินใจทางวิศวกรรมต้องแม่นยำ ตั้งแต่เลือกสถาปัตยกรรมโมเดลไปจนถึงวิธี quantize น้ำหนักโมเดล เหตุผลที่แนวทางนี้โตเร็วในภาคอุตสาหกรรมชัดเจนมาก: การทำ inference บนตัวอุปกรณ์เองช่วยรักษาความเป็นส่วนตัวของข้อมูล (ไม่ต้องส่ง raw data ขึ้นคลาวด์), ยืดอายุแบตเตอรี่ และทำให้ระบบตรวจจับความผิดปกติทำงานต่อได้แม้เน็ตหลุด สำหรับโรงงานที่มีจุดวัดในพื้นที่ห่างไกลหรือสภาพแวดล้อมรุนแรง TinyML จึงเป็นเสมือน “ผู้เชี่ยวชาญที่ประจำอยู่ในเครื่องจักร” 24 ชั่วโมง แผนภาพ: TinyML pipeline — เซ็นเซอร์ส่งสัญญาณเข้า preprocessing (FFT/Filter) แล้วป้อนเข้าโครงข่ายประสาทเทียมขนาดเล็กบน MCU ที่ตัดสินใจส่ง alert เองโดยไม่ผ่านคลาวด์ (ที่มา: Honey Corporation) อาหารสมองของ TinyML: Quantization หัวใจที่ทำให้โมเดล AI ลงไปอยู่ใน MCU ได้คือเทคนิคบีบอัด โมเดล image classification สถาปัตยกรรมยอดนิยมขนาด 50 เลเยอร์ในความละเอียดเต็ม (FP32) มีขนาดราว 100 MB เมื่อแปลงเป็น INT8 ด้วย Post-Training Quantization (PTQ) จะเหลือประมาณ 5 MB และเมื่อปรับให้เหมาะกับงานเฉพาะแบบ TinyML แล้ว ขนาดที่ทำได้จริงคือระดับ 500 KB — เล็กลงราว 200 เท่าจากต้นฉบับ พอที่จะฝากลง flash…
Read More

Case Study: Autonomous Production System จาก Reactive Maintenance สู่ระบบผลิตอัตโนมัติ OEE 79% ใน 13 เดือน

Article
บทความนี้นำเสนอ Case Study การนำ Autonomous Production System ไปใช้ในโรงงานผลิตชิ้นส่วนอุตสาหกรรม โดยวิเคราะห์เส้นทางจากปัญหา การออกแบบระบบ ไปจนถึงผลลัพธ์ที่เกิดขึ้นจริง เป็นแนวทางสำหรับผู้บริหารโรงงานที่กำลังพิจารณาเปลี่ยนจาก Reactive Maintenance สู่ระบบที่เครื่องจักรสามารถปรับตัวเองได้ ปัญหา: เมื่อ "Unplanned Downtime" กลายเป็นความเจ็บปวดประจำวัน โรงงานผลิตชิ้นส่วนโลหะแม่พิมพ์ขนาดกลางแห่งหนึ่ง มีสายการผลิตหลัก 6 สาย ใช้เครื่องจักรกว่า 120 เครื่อง ปัญหาหลักคือ Unplanned Downtime เฉลี่ย 14 ชั่วโมง/สัปดาห์ ส่งผลให้ OEE (Overall Equipment Effectiveness) ต่ำเพียง 58% เทียบกับเป้าหมายอุตสาหกรรมที่ 85% สาเหตุหลักมาจาก: Reactive Maintenance: ซ่อมเฉพาะเมื่อเครื่องเสีย ไม่มีการพยากรณ์ล่วงหน้า Alarm Flood: ระบบ SCADA ส่งการแจ้งเตือนมากกว่า 800 ครั้ง/วัน ช่างไม่สามารถแยกแยะสัญญาณสำคัญได้ Manual Scheduling: เมื่อเครื่องเสีย นักวางแผนต้องใช้เวลา 2-3 ชั่วโมงในการจัดลำดับการผลิตใหม่ โครงสร้างพื้นฐาน Edge Computing และเซิร์ฟเวอร์สำหรับประมวลผลข้อมูลเซ็นเซอร์แบบเรียลไทม์ รากฐานสำคัญของ Autonomous Production System (ภาพ: Wikimedia Commons) การวินิจฉัยและออกแบบระบบ ทีมวิศวกรวิเคราะห์สถาปัตยกรรมที่มีอยู่และออกแบบ Autonomous Production System แบ่งเป็น 3 ระยะ: ระยะ งานหลัก ระยะเวลา ผลลัพธ์ที่คาดหวัง ระยะที่ 1 ติดตั้ง IIoT Sensors + เชื่อม PLC ผ่าน OPC UA + MQTT Broker 3 เดือน Data Visibility: เห็นข้อมูลเครื่องจักรทุกตัวแบบเรียลไทม์ ระยะที่ 2 Deploy Anomaly Detection + Vibration Analysis Model บน Edge Device 4 เดือน Predictive Alerts: เตือนล่วงหน้า 24-72 ชม. ก่อนเครื่องเสีย ระยะที่ 3 Multi-Agent System: Agent บำรุงรักษา +…
Read More

Agentic AI ใน Smart Manufacturing 2026: เมื่อโรงงานเริ่มตัดสินใจเองด้วย Autonomous AI Agent

Article
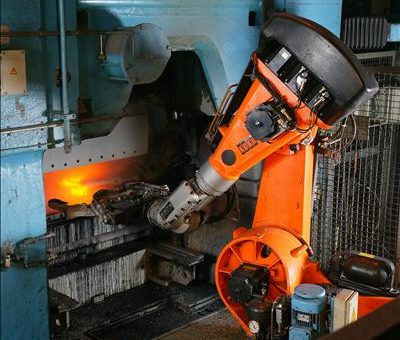
ปี 2026 ถือเป็นจุดเปลี่ยนสำคัญของอุตสาหกรรมการผลิต ข้อมูลจาก Deloitte ระบุว่าการนำ Agentic AI มาใช้ในการผลิตเพิ่มขึ้นถึง 4 เท่าตัวในเวลาเพียงหนึ่งปี จาก 6% สู่ 24% ของผู้ผลิตทั่วโลก ตัวเลขนี้สะท้อนการเปลี่ยนแปลงครั้งใหญ่: โรงงานไม่ได้ใช้ AI แค่วิเคราะห์ข้อมูลอีกต่อไป แต่เริ่มปล่อยให้ระบบ AI ตัดสินใจและดำเนินการเองในกระบวนการผลิตจริง บทความนี้เจาะลึก Agentic AI ในบริบท Smart Manufacturing ตั้งแต่แนวคิด สถาปัตยกรรม กรณีศึกษาผลลัพธ์จริง ไปจนถึงความท้าทายที่ผู้บริหารโรงงานต้องเตรียมรับมือ หุ่นยนต์อุตสาหกรรมในโรงหล่อ — เมื่อ AI Agent เข้ามาประสานงาน หุ่นยนต์เหล่านี้ไม่ได้ทำงานตามโปรแกรมตายตัว แต่ปรับตัวตามสภาพการผลิตแบบเรียลไทม์ (ภาพ: Wikimedia Commons) Agentic AI คืออะไร? แตกต่างจาก AI แบบเดิมอย่างไร? Agentic AI (AI เชิงตัวแทน) คือระบบ AI ที่สามารถ รับรู้ ให้เหตุผล ตัดสินใจ และลงมือทำ ได้อย่างอิสระตามเป้าหมายที่กำหนด โดยไม่ต้องมีมนุษย์สั่งการทีละขั้น แตกต่างจาก AI แบบดั้งเดิมที่ทำหน้าที่ "ตอบคำถาม" หรือ "วิเคราะห์ข้อมูล" เพียงอย่างเดียว คุณสมบัติ AI แบบดั้งเดิม (Reactive) Agentic AI (Autonomous) การตัดสินใจ แนะนำ/วิเคราะห์ แล้วมนุษย์ตัดสินใจ ตัดสินใจและดำเนินการเอง ขอบเขตการทำงาน งานเดี่ยว เช่น ตรวจจับ Defect ประสานหลายระบบ เช่น จัดตารางผลิตและสั่งวัตถุดิบ การเรียนรู้ ต้อง retrain เมื่อข้อมูลเปลี่ยน ปรับตัวต่อเนื่องจาก feedback loop การโต้ตอบ ทางเดียว (Output สู่ Human) สองทาง เรียก API สั่ง PLC แจ้งเตือน ตัวอย่างในโรงงาน Computer Vision ตรวจคุณภาพ Agent จัดการบำรุงรักษาทั้งระบบ 5 Use Case ที่ Agentic AI สร้างผลลัพธ์จริงในโรงงาน จากข้อมูล iFactory AI (กุมภาพันธ์ 2026) ผู้ผลิตชั้นนำเริ่มใช้ Multi-Agent Systems ในพื้นที่ปฏิบัติการหลัก 5…
Read More
Wearable Fatigue Monitoring: วิธีสร้างระบบตรวจจับความเหนื่อยล้าของคนงานแบบเรียลไทม์ด้วยเซ็นเซอร์ชีวภาพและ Machine Learning

Wearable Fatigue Monitoring: วิธีสร้างระบบตรวจจับความเหนื่อยล้าของคนงานแบบเรียลไทม์ด้วยเซ็นเซอร์ชีวภาพและ Machine Learning

Article
ความเหนื่อยล้าของคนงาน (Worker Fatigue) เป็นสาเหตุหลักของอุบัติเหตุในโรงงานประมาณ 13% ของการบาดเจ็บทั้งหมดในสหรัฐอเมริกา ตามข้อมูลของ OSHA คนงานที่ทำงานเกิน 12 ชั่วโมงมีความเสี่ยงต่ออุบัติเหตุสูงขึ้น 37% เมื่อเทียบกับกะปกติ ปัญหาคือ ไม่มี Biomarker หรือตัวชี้วัดสากลที่ยอมรับกันทั่วไปสำหรับการวัดความเหนื่อยล้า — จนกระทั่งงานวิจัยล่าสุดจากมหาวิทยาลัย Northwestern ได้เปิดทางใหม่ บทความนี้จะแนะนำ วิธีการสร้างระบบ Wearable Fatigue Monitoring ตั้งแต่การเลือกเซ็นเซอร์ การวางตำแหน่งบนร่างกาย การเก็บข้อมูล ไปจนถึงการใช้ Machine Learning ทำนายระดับความเหนื่อยล้าแบบเรียลไทม์ อุปกรณ์สวมใส่ในโรงงานสมัยใหม่สามารถติดเซ็นเซอร์ชีวภาพได้หลายจุดเพื่อติดตามสุขภาพคนงาน (ภาพ: Ergosanté, CC BY-SA 4.0) Step 1: เลือกเซ็นเซอร์ชีวภาพ (Biometric Sensors) งานวิจัยของ Northwestern University (ตีพิมพ์ใน Science Advances, 2024) ใช้ระบบเซ็นเซอร์ 6 ตำแหน่งบนลำตัวและแขนเพื่อวัดสัญญาณชีวภาพ 4 ประเภทหลัก: สัญญาณชีวภาพ เซ็นเซอร์ที่ใช้ ตำแหน่งบนร่างกาย บ่งชี้ความเหนื่อยล้า Heart Rate (HR) PPG (Photoplethysmography) ข้อมือ หน้าอก HR สูงขึ้นผิดปกติขณะพัก = ร่างกายกำลังเหนื่อย HRV (Heart Rate Variability) ECG / PPG หน้าอก HRV ลดลง = ระบบประสาท Sympathetic ทำงานหนัก = เครียด/เหนื่อย Skin Temperature Thermistor / IR Sensor แขน ลำตัว อุณหภูมิผิวหนังลดลง = ร่างกายเริ่มอ่อนเพลีย Locomotor Patterns IMU (Accelerometer + Gyroscope) แขนทั้งสองข้าง ลำตัว การเคลื่อนไหวช้าลง ความสม่ำเสมอลดลง = กล้ามเนื้อเหนื่อย Insight สำคัญจากงานวิจัย: การเคลื่อนไหวของ แขนข้างที่ไม่ถนัด (Non-dominant Arm) เป็นตัวบ่งชี้ความเหนื่อยล้าที่ เป็นสากลที่สุด — ทุกคนในการทดลองแสดงรูปแบบการเคลื่อนไหวของแขนข้างไม่ถนัดที่เปลี่ยนไปเมื่อเริ่มเหนื่อย โดยไม่ขึ้นกับปัจจัยส่วนบุคคล Step 2: กำหนดระดับความเหนื่อยล้า (Fatigue Ground Truth) เนื่องจากไม่มี "เกณฑ์มาตรฐาน" สำหรับความเหนื่อยล้า…
Read More
In-Process Monitoring สำหรับ Additive Manufacturing: ระบบตรวจสอบคุณภาพเรียลไทม์ที่กำจัด Defect ทันที

In-Process Monitoring สำหรับ Additive Manufacturing: ระบบตรวจสอบคุณภาพเรียลไทม์ที่กำจัด Defect ทันที

Article
In-Process Monitoring สำหรับ Additive Manufacturing (AM) คือการติดตั้งเซ็นเซอร์และระบบตรวจวัดภายในเครื่องพิมพ์สามมิติเพื่อสังเกตและบันทึกปรากฏการณ์ทางกายภาพที่เกิดขึ้นทุกขณะขณะพิมพ์ ตั้งแต่อุณหภูมิ Melt Pool ขนาดของ HAZ (Heat Affected Zone) ไปจนถึงรูปร่างของแต่ละเลเยอร์ เป้าหมายคือการตรวจจับ Defect ทันทีที่เกิด และปรับพารามิเตอร์การพิมพ์แบบ Closed-Loop เพื่อแก้ไขก่อนที่จะสายเกินไป ทำไม In-Process Monitoring จึงจำเป็นวงจรงาน Machine Learning ในโรงงาน — ตั้งแต่เก็บข้อมูลเซ็นเซอร์จนถึงการใช้โมเดลตัดสินใจบนหน้างาน (ภาพประกอบ: Honey Corporation)วงจรงาน Machine Learning ในโรงงาน — ตั้งแต่เก็บข้อมูลเซ็นเซอร์จนถึงการใช้โมเดลตัดสินใจบนหน้างาน (ภาพประกอบ: Honey Corporation) กระบวนการ Laser Powder Bed Fusion (LPBF) และ Directed Energy Deposition (DED) เกิดปรากฏการณ์ทางฟิสิกส์ที่ซับซ้อนในระดับ Microsecond แสงเลเซอร์หลอมผงโลหะที่อุณหภูมิสูงกว่า 2,500 C เป็น Melt Pool ขนาด 50-200 um ความผันแปรเล็กน้อยใน Laser Power, Scan Speed, หรือ Powder Bed Flatness สามารถสร้าง Defect ได้ทันที: Lack of Fusion: พลังงานไม่พอ – เกิดช่องว่างระหว่าง Track (Porosity 10-100 um) Keyholing: พลังงานสูงเกิน – หลอมลึกเกินไป สร้าง Pore กลมจากไอโลหะที่ติดอยู่ Spatter: อนุภาคโลหะกระเด็นไปปนเปื้อนผงในเลเยอร์ถัดไป Delamination: ความเค้นตกค้าง (Residual Stress) ทำให้เลเยอร์หลุดหรือบิดเบี้ยว Elevation/Deformation: ผิวเลเยอร์ไม่เรียบ – ส่งผลต่อเลเยอร์ถัดไป เซ็นเซอร์และเทคโนโลยีตรวจวัด เซ็นเซอร์ วัดอะไร Sampling Rate ตรวจจับ Defect ตำแหน่ง Coaxial Photodiode Melt Pool Emission Intensity 100 kHz+ Keyholing, Lack of Fusion In-Beam (Coaxial) High-Speed Camera Melt Pool…
Read More