บทวิเคราะห์: Edge หรือ Cloud — ตัวเลขตลาดบอกว่าคำถามนี้ผิดตั้งแต่ต้น (และโรงงานควรถามอะไรแทน)

บทวิเคราะห์: Edge หรือ Cloud — ตัวเลขตลาดบอกว่าคำถามนี้ผิดตั้งแต่ต้น (และโรงงานควรถามอะไรแทน)

Article
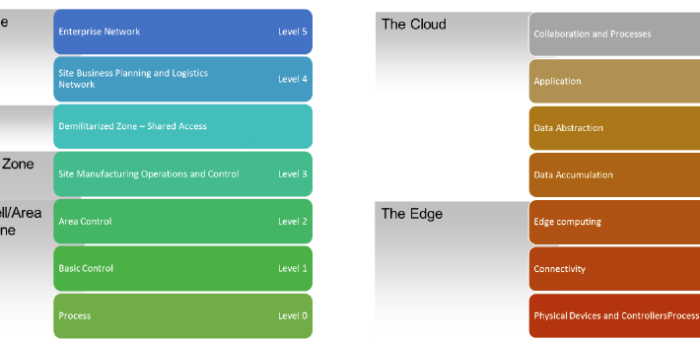
ช่วงสองสามปีที่ผ่านมา วิศวกรโรงงานไทยหลายท่านน่าจะเจอบทสนทนาแบบนี้: "เราควรเอาขึ้นคลาวด์หรือทำ edge ก่อน" คำถามดูเหมือนมีเหตุผล แต่ถ้าดูตัวเลขตลาดล่าสุดแล้ว จะพบว่านี่คือกรอบคิดที่กำลังล้าสมัย เพราะโลกไม่ได้กำลังเลือกระหว่างสองฝั่ง แต่กำลังเติบโต ทั้งสองฝั่งพร้อมกันอย่างก้าวกระโดด ตัวเลขที่ต้องรู้ก่อนตัดสินใจ รายงานล่าสุดของ Grand View Research ระบุว่าตลาด Edge Computing โลกมีมูลค่า 33.4 พันล้านดอลลาร์ในปี 2025 และประมาณการไว้ที่ 46.7 พันล้านดอลลาร์ในปี 2026 ก่อนจะขยายต่อไปถึง 328 พันล้านดอลลาร์ภายในปี 2033 คิดเป็น CAGR 32.1% ตลอดช่วง 2026–2033 — นี่คืออัตราเติบโตที่เร็วกว่าภาพรวมของ smart manufacturing ที่ IoT Analytics ประเมินไว้ที่ CAGR 9.3% (จาก 175 พันล้านดอลลาร์ในปี 2025 สู่ 274 พันล้านดอลลาร์ในปี 2030) ถึงสามเท่าครึ่ง ทำไมถึงเร็วขนาดนั้น? เพราะ edge ไม่ได้แข่งกับคลาวด์ แต่กำลัง เปิดกล่อง use case ใหม่ที่คลาวด์ทำไม่ได้ และเอเชียแปซิฟิกคือภูมิภาคที่โตเร็วที่สุด — Grand View Research ระบุ CAGR ของภูมิภาคเราที่ราว 39% สูงกว่าค่าเฉลี่ยโลก ซึ่งสอดคล้องกับการลงทุน infrastructure ดิจิทัลของไทยในช่วงนี้ Purdue Reference Model เทียบกับ IoT Reference Model — โครงสร้างระดับโรงงานกับระดับคลาวด์กำลังถูกออกแบบให้ทำงานร่วมกัน ไม่ใช่แยกกัน — ภาพ: Wikimedia Commons (CC BY-SA 4.0) คำถามที่ถูกต้อง: Workload นี้ควรอยู่ที่ไหน แทนที่จะถามว่า "เอาขึ้นคลาวด์หรือ edge" ให้ถามว่า "workload นี้มีคุณสมบัติอะไร" แล้วให้คุณสมบัตินั้นตัดสินใจแทน โดยเฉพาะสี่มิติที่ตัดสินได้ชัดเจนที่สุด: มิติการตัดสินใจ ชี้ไปทาง Edge ชี้ไปทาง Cloud Latency ที่ยอมรับได้ ต่ำกว่า ~50 ms เช่น interlock, หยุดเครื่องฉุกเฉิน วินาทีถึงนาที เช่น dashboard, รายงานรายเดือน ปริมาณข้อมูล สูงมากต่อวินาที (vibration 10 kHz, วิดีโอ 30 fps)…
Read More
Fog Computing กลับมาเป็นข่าวอีกครั้ง: ชั้นคำนวณที่โรงงานไทยมองข้ามไป กำลังกลายเป็นหัวใจของ IIoT ยุค Edge AI

Fog Computing กลับมาเป็นข่าวอีกครั้ง: ชั้นคำนวณที่โรงงานไทยมองข้ามไป กำลังกลายเป็นหัวใจของ IIoT ยุค Edge AI

Article
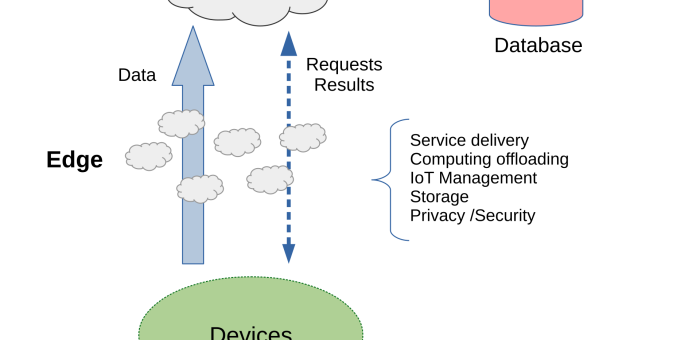
หลายโรงงานในไทยวางแผนธุรกิจดิจิทัลของตัวเองแบบสองขั้ว คือมีอุปกรณ์ IoT และ PLC อยู่ปลายทาง แล้วส่งข้อมูลขึ้นคลาวด์เพื่อประมวลผลทั้งหมด แต่เมื่อปริมาณข้อมูลเพิ่มขึ้นเป็นสิบเท่า และ AI เริ่มถูกใช้ตัดสินใจแบบเรียลไทม์บนพื้นโรงงาน สถาปัตยกรรมแบบสองขั้วนี้ก็เริ่มสะดุด คำตอบที่ถูกที่สุดไม่ใช่การย้ายทุกอย่างกลับมาอยู่ในโรงงาน แต่คือการเพิ่ม ชั้นคำนวณระหว่างกลาง ที่เรียกว่า Fog Computing ซึ่งกำลังกลับมาเป็นที่พูดถึงอีกครั้งในวงการอุตสาหกรรมปี 2026 สถาปัตยกรรมการคำนวณแบบไล่ระดับ ตั้งแต่อุปกรณ์ปลายทาง (Things) ผ่านชั้น Edge/Fog ขึ้นไปถึงคลาวด์ — ภาพ: Wikimedia Commons (CC BY-SA 4.0) ทำไมสองขั้วไม่พออีกต่อไป ลองนึกภาพสายการผลิตที่มีกล้องตรวจคุณภาพ 16 ตัว ส่งภาพความละเอียดสูงกลับคลาวด์เพื่อรันโมเดล Computer Vision ที่ 30 เฟรมต่อวินาที เสียงวิเคราะห์คลื่นเสียงเครื่องจักร และข้อมูล vibration ที่สุ่มที่ 10 kHz — แบนด์วิดท์ที่ต้องใช้ไม่ใช่แค่ "เยอะ" แต่แพงและเปราะ ถ้าเน็ตหลุดแม้เพียง 30 วินาที งานตรวจคุณภาพช่วงนั้นก็หายไปตลอดกาล ในทางกลับกัน การเอาทุกอย่างมาไว้ในเซิร์ฟเวอร์กลางในโรงงานล้มเหลวในอีกแบบ ทีม IT ต้องดูแลฮาร์ดแวร์ ทำ backup อัปเดต patch และขยายระบบทุกครั้งที่เพิ่มสายการผลิต Fog Computing เสนอทางที่สาม — กระจายการคำนวณลงไปในหลายๆ โหนดที่อยู่ใกล้แหล่งข้อมูล แต่ยังจัดการแบบรวมศูนย์ ตามแนวคิดที่ OpenFog Consortium (ซึ่งต่อมาควบรวมเข้ากับ Linux Foundation Edge) เคยสรุปไว้ใน Reference Architecture ว่าต้องมีคุณสมบัติ 8 ด้าน ตั้งแต่ Security, Scalability, Openness, Autonomy, Manageability, Agility, Hierarchical Organization ไปจนถึง Programmability ข้อกำหนดทางเทคนิคที่ต้องรู้ก่อนออกแบบ ประเด็นออกแบบ โจทย์จริงในโรงงาน แนวทาง Fog Latency budget ปิดสวิตช์ฉุกเฉินภายใน 10–50 ms หลังตรวจพบความผิดปกติ ประมวลผลและตัดสินใจที่โหนด Fog ในสายการผลิต ไม่รอ round-trip ไปคลาวด์ แบนด์วิดท์ กล้องตรวจคุณภาพ 16 ตัว ที่ 30 fps กินลิงก์ WAN เกินกว่าที่ลิงก์สำรองจะรับไหว สกัดเฉพาะผลลัพธ์และภาพที่พบ defect ขึ้นคลาวด์ ลดปริมาณข้อมูลขาออกได้ 90%…
Read More
บทวิเคราะห์ Hybrid Cloud ในโรงงานอุตสาหกรรม 2026: งานไหนควรอยู่ On-premise งานไหนควรขึ้นคลาวด์

บทวิเคราะห์ Hybrid Cloud ในโรงงานอุตสาหกรรม 2026: งานไหนควรอยู่ On-premise งานไหนควรขึ้นคลาวด์

Article
คำถามที่ฝ่าย IT ของโรงงานไทยถามกันบ่อยที่สุดในปี 2026 ไม่ใช่ "ควรขึ้นคลาวด์ไหม" อีกต่อไป แต่คือ "งานไหนควรอยู่ที่ไหน" เมื่อระบบ SCADA, MES และ data platform ต้องทำงานร่วมกันทั้งบน on-premise และคลาวด์ คำตอบที่กำลังได้รับความนิยมคือ Hybrid Cloud — สถาปัตยกรรมที่ไม่เลือกข้าง แต่จัดวาง workload ตามลักษณะของงาน บทความนี้วิเคราะห์มุมมองของเราที่ Honey Corporation จากประสบการณ์ทำ System Integration ในภาคอุตสาหกรรมไทย ว่าเส้นแบ่งระหว่าง on-premise กับคลาวด์ควรอยู่ตรงไหนจึงจะได้ประโยชน์สูงสุดโดยไม่สร้างความเสี่ยงใหม่ เซิร์ฟเวอร์ในโรงงาน (on-premise) ยังคงเป็นที่พำนักของระบบ real-time control และข้อมูลดิบ — ขณะที่คลาวด์รับงานวิเคราะห์ระยะยาว (ภาพ: Wikimedia Commons) ทำไม "All-in Cloud" และ "All-in On-premise" ต่างก็ไม่ใช่คำตอบ ฝ่ายที่ผลักดัน all-in cloud มักอ้างเรื่องความยืดหยุ่น ไม่ต้องลงทุน hardware ล่วงหน้า และเข้าถึงบริการ AI ได้ทันที แต่ในบริบทโรงงาน มีสามข้อจำกัดที่ยังแก้ไม่ตก: Latency และ dependency — ระบบควบคุมกระบวนการผลิตต้องทำงานต่อแม้อินเทอร์เน็ตขาด การพึ่งพาคลาวด์ 100% ในงาน critical loop คือความเสี่ยงที่ยอมรับไม่ได้ ปริมาณข้อมูลดิบ — เซ็นเซอร์หลายพันจุดสร้างข้อมูลดิบมหาศาล การเก็บทั้งหมดบนคลาวด์เป็นการใช้ทรัพยากรอย่างสิ้นเปลือง ทั้งยังมีค่าใช้จ่าย egress เมื่อต้องดึงกลับมาวิเคราะห์ ข้อกำหนดด้านข้อมูล — ลูกค้าบางรายหรือกฎหมายบางประเทศกำหนดว่าข้อมูลกระบวนการผลิตบางประเภทห้ามออกนอกประเทศ ในทางกลับกัน all-in on-premise ก็แพ้ในเกมระยะยาว: ทีมงานจำกัด การขยายระบบช้า และการเข้าถึงเครื่องมือ AI/ML สมัยใหม่ที่คลาวด์พัฒนาออกมาตลอดเวลา ทำได้ลำบากกว่ามาก เส้นแบ่งที่เราใช้: วาง workload ตาม 4 คำถาม จากประสบการณ์ติดตั้งระบบให้โรงงานหลายแห่ง เราสรุปกรอบการตัดสินใจ 4 คำถาม ก่อนวาง workload ใดๆ ลงที่ไหน: Workload ความเร็วที่ต้องการ ลักษณะข้อมูล ที่วางที่เหมาะสม Real-time control / interlockมิลลิวินาทีข้อมูลดิบหมุนเร็วOn-premise (PLC/DCS) Line dashboard / Andonวินาทีข้อมูลรวมระดับสายผลิตOn-premise edge server OEE, production reportนาที–ชั่วโมงข้อมูลสรุปรายวัน/รายสัปดาห์Cloud ML…
Read More
How-to: ออกแบบ Edge-to-Cloud Data Pipeline สำหรับโรงงาน IIoT ใน 5 ขั้นตอน — จาก Data Source Inventory ถึงกฎการไหลของข้อมูล

How-to: ออกแบบ Edge-to-Cloud Data Pipeline สำหรับโรงงาน IIoT ใน 5 ขั้นตอน — จาก Data Source Inventory ถึงกฎการไหลของข้อมูล

Article
หลายโรงงานที่เริ่มทำ IIoT ติดอยู่ที่เดิม: เซ็นเซอร์ติดแล้ว ข้อมูลเห็นแล้ว แต่พอจะนำไปใช้จริงกลับพบว่าข้อมูลกระจัดกระจายในหลายระบบ รูปแบบไม่ตรงกัน และ dashboard ที่สวยงามนั้น ดูได้อย่างเดียว ไม่เชื่อมกับการตัดสินใจ รากของปัญหามักไม่ใช่เซ็นเซอร์หรือ AI แต่เป็น สายการไหลของข้อมูล (Data Pipeline) ที่ไม่ถูกออกแบบมาตั้งแต่ต้น บทความนี้เป็นคู่มือแบบทีละขั้น สำหรับวิศวกรที่ต้องการวาง pipeline จากเซ็นเซอร์ในสายการผลิต ผ่าน edge gateway ไปจนถึงคลาวด์อย่างเป็นระบบ — โดยไม่ต้องเป็น data engineer เต็มตัว สายการผลิตสมัยใหม่มีจุดเก็บข้อมูลกระจายอยู่ทั้งสาย — pipeline ที่ดีต้องรวมข้อมูลเหล่านี้ให้เป็นภาพเดียวก่อนส่งขึ้นคลาวด์ (ภาพ: Wikimedia Commons) ทำไมต้องเป็น Edge-to-Cloud (ไม่ใช่ส่งตรงขึ้นคลาวด์) ลองคำนวณง่ายๆ: มิเตอร์พลังงาน 200 จุด ส่งค่าทุก 1 วินาที รวมกว่า 17 ล้านค่าต่อวัน เพียงพอจะทำให้ฐานข้อมูลที่ออกแบบมาไม่ดีบวมในไม่กี่เดือน และการส่งข้อมูลดิบทั้งหมดขึ้นคลาวด์เป็นภาระ bandwidth ที่หลีกเลี่ยงได้ การคาดการณ์ของ Gartner ที่ชี้ว่าตลาด edge computing จะเติบโตจาก 131,000 ล้านดอลลาร์ (2023) สู่ 511,000 ล้านดอลลาร์ (2033) สะท้อนว่าโลกกำลังย้ายการประมวลผลกลับมาใกล้โรงงาน ไม่ใช่เพื่อแทนคลาวด์ แต่เพื่อส่งขึ้นคลาวด์เฉพาะ ข้อมูลที่มีคุณค่า Step 1: สำรวจและจัดทำ Inventory ของแหล่งข้อมูล ก่อนซื้ออุปกรณ์ใด ให้ทำ Data Source Inventory ให้ครบก่อน — ทุก PLC, VFD, มิเตอร์, เซ็นเซอร์ และไฟล์ที่คนงานบันทึกด้วยมือ ตัวอย่างตาราง: แหล่งข้อมูล โปรโตคอล อัตราการเก็บข้อมูล ปลายทางที่เหมาะสม PLC สายประกอบOPC UA100 msEdge สรุปผลก่อนส่ง Cloud VFD / มอเตอร์Modbus TCP1 วินาทีEdge (แจ้งเตือนความผิดปกติ) มิเตอร์พลังงานModbus RTU1 วินาทีEdge (สรุปเป็น profile 15 นาที) เซ็นเซอร์อุณหภูมิ/ความชื้นMQTT30 วินาทีEdge ส่งตรงขึ้น Cloud ตารางนี้จะบอกคุณเองว่าจุดรวมข้อมูล (aggregation point) ควรอยู่ที่ไหน และโปรโตคอลใดต้องการตัวแปลง Step 2: เลือก Edge Gateway ให้เหมาะกับงาน…
Read More
Edge Analytics ในโรงงานอุตสาหกรรม: วิเคราะห์ข้อมูลทันใจที่ตู้คอนโทรล ก่อนส่งขึ้นคลาวด์

Edge Analytics ในโรงงานอุตสาหกรรม: วิเคราะห์ข้อมูลทันใจที่ตู้คอนโทรล ก่อนส่งขึ้นคลาวด์

Article
Edge Analytics คืออะไร — ในโรงงานสมัยใหม่ เซ็นเซอร์และเครื่องจักรหนึ่งแห่งสามารถผลิตข้อมูลได้วันละหลายกิกะไบต์ การส่งข้อมูลดิบทั้งหมดขึ้นคลาวด์ก่อนค่อยประมวลผลไม่ใช่คำตอบอีกต่อไป ทั้งจากค่า bandwidth, latency และความเสี่ยงเมื่ออินเทอร์เน็ตขาดหาย Edge Analytics คือการนำกระบวนการวิเคราะห์ข้อมูล — ตั้งแต่การกรองสัญญาณ คำนวณค่าสถิติ ไปจนถึงโมเดล AI — มาวางไว้ที่ edge of the network ใกล้กับแหล่งกำเนิดข้อมูล ไม่ว่าจะเป็น Edge Gateway ในตู้คอนโทรล คอมพิวเตอร์อุตสาหกรรมข้างสายการผลิต หรือเซิร์ฟเวอร์ในโรงงานเอง ผลลัพธ์คือการตัดสินใจเกิดขึ้นภายใน มิลลิวินาที แทนที่จะต้องรอไป-กลับคลาวด์หลายร้อยมิลลิวินาที ซึ่งเป็นความต่างระหว่าง "หยุดเครื่องทันเวลา" กับ "เสียชิ้นงานทั้งล็อต" แผงควบคุมอัตโนมัติที่เก็บ historical data ของเครื่อง press — จุดที่ Edge Analytics ทำงานจริง ก่อนข้อมูลจะถูกส่งขึ้นคลาวด์ (ภาพ: Wikimedia Commons) ทำไมปี 2026 ต้องพูดถึง Edge Analytics อีกครั้ง ตัวเลขสองชุดอธิบายได้ดีที่สุด รายงานของ IoT Analytics (Industry 4.0 & Smart Manufacturing Market Report 2026–2030) ระบุว่าตลาด Smart Manufacturing ทั่วโลกปี 2025 มีมูลค่า 175,000 ล้านดอลลาร์ และจะเติบโตด้วย CAGR 9.3% ไปแตะ 274,000 ล้านดอลลาร์ในปี 2030 ขณะที่ Gartner คาดการณ์ตลาด edge computing โลกจะขยายจาก 131,000 ล้านดอลลาร์ (2023) สู่ 511,000 ล้านดอลลาร์ภายในปี 2033 — เกือบ 4 เท่าใน 10 ปี แรงขับเคลื่อนที่แท้จริงไม่ใช่ตัวเทคโนโลยีเอง แต่เป็นสามแรงกดดันที่โรงงานไทยกำลังเผชิญ: (1) ปริมาณข้อมูลจาก IIoT sensor ที่เพิ่มขึ้นแบบทวีคูณจนส่งขึ้นคลาวด์ทั้งหมดไม่คุ้ม (2) งานที่ต้องการความเร็วระดับมิลลิวินาที เช่น การตรวจจับความผิดปกติของ vibration signature และ (3) นโยบาย data residency ที่บังคับให้ข้อมูลอ่อนไหวบางประเภทอยู่ในประเทศ สถาปัตยกรรม 3 ชั้นของ Edge Analytics Edge…
Read More
Fog Computing ในโรงงานอุตสาหกรรม: ชั้นคำนวณแบบหลายชั้น (Multi-tier) ที่ต่างจาก Edge Computing อย่างไร

Fog Computing ในโรงงานอุตสาหกรรม: ชั้นคำนวณแบบหลายชั้น (Multi-tier) ที่ต่างจาก Edge Computing อย่างไร

Article
หลายโรงงานที่เริ่มทำ IIoT มักเจอคำถามเดียวกัน คือ "เราควรวิเคราะห์ข้อมูลที่ Edge หรือส่งขึ้น Cloud ดี" คำตอบที่งานวิจัยและการใช้งานจริงชี้ตรงกันคือ ไม่ต้องเลือกอย่างใดอย่างหนึ่ง เพราะระบบ IIoT สมัยใหม่ควรเป็นสถาปัตยกรรมแบบหลายชั้น (Multi-tier) ที่เรียกชั้นกลางระหว่างเครื่องจักรกับคลาวด์ว่า Fog Computing — ชั้นคำนวณที่กระจายอยู่ตามโหนดเกตเวย์และเซิร์ฟเวอร์ระดับโรงงาน ก่อนข้อมูลจะไหลขึ้นสู่คลาวด์จริง บทความนี้เจาะลึกว่า Fog Computing ทำงานอย่างไร ต่างจาก Edge Computing ตรงไหน และโรงงานควรออกแบบชั้น Fog อย่างไรให้คุ้มค่ากับการลงทุน หลักการทำงานของ Fog Computing แนวคิด Fog Computing เกิดจากข้อจำกัดของ Cloud Computing แบบศูนย์กลาง คือ หากส่งข้อมูลดิบจากเซ็นเซอร์ทุกตัวขึ้นคลาวด์ แบนด์วิดธ์และค่า latency จะบานปลายทันทีเมื่อจำนวนอุปกรณ์เพิ่มขึ้นเป็นพันเป็นหมื่นตัว Fog Computing จึงแทรก "ชั้นหมอก" ของทรัพยากรคำนวณลงไประหว่างอุปกรณ์ปลายทางกับคลาวด์ ทำหน้าที่ 3 อย่างหลักคือ รวบรวมและกรองข้อมูล (Aggregation) — รับข้อมูลจากหลาย ๆ Edge Device ในโซนเดียวกัน บีบอัด ลดความถี่ และส่งเฉพาะข้อมูลที่มีค่าขึ้นคลาวด์ ประสานงานระหว่างโหนด (Orchestration) — จัดสรรงานคำนวณให้เหมาะกับทรัพยากรของแต่ละโหนดในโรงงาน ทำหน้าที่เป็นสะพาน (Bridge) — แปลงโปรโตคอลจาก Modbus TCP, OPC UA ให้เป็น MQTT หรือ REST API ก่อนส่งออกสู่ภายนอก สถาปัตยกรรม Fog Computing: ชั้นหมอกของโหนดคำนวณ (Fog Nodes) ทำหน้าที่รวบรวมและกรองข้อมูลจากอุปกรณ์ก่อนส่งขึ้นคลาวด์ (ภาพ: Wikimedia Commons, CC BY 4.0) Fog vs Edge vs Cloud — ตารางเปรียบเทียบ ประเด็น Edge Computing Fog Computing Cloud Computing ตำแหน่งบนหรือใกล้เครื่องจักรโดยตรงโหนดกลางระหว่าง Edge กับ Cloudดาต้าเซ็นเตอร์ภายนอก Latencyต่ำสุด (ระดับมิลลิวินาที)ต่ำ แต่สูงกว่า Edgeสูง (อาจถึงหลายสิบมิลลิวินาที) การประมวลผลข้อมูลเรียลไทม์บนเครื่องรวมกรองข้อมูลหลาย Edge ก่อนส่งต่อการวิเคราะห์เชิงลึกและเก็บถาวร ขนาดระบบระดับเครื่อง/เซลล์เดียวระดับโรงงาน/หลายไลน์ผลิตระดับองค์กร/หลายสาขา กรณีใช้งานPredictive Maintenance, Machine Vision, ควบคุมเรียลไทม์เชื่อมหลายไลน์, จัดการข้อมูลหลายไซต์,…
Read More
Cloud-Native IIoT Platform: สถาปัตยกรรม Microservices และ Service Mesh สำหรับ Smart Factory

Cloud-Native IIoT Platform: สถาปัตยกรรม Microservices และ Service Mesh สำหรับ Smart Factory

Article
Cloud-Native IIoT Platform คืออะไร Cloud-Native IIoT Platform คือสถาปัตยกรรมการออกแบบแพลตฟอร์ม IIoT ที่ใช้หลักการของ Cloud-Native Computing อย่างเต็มรูปแบบ ได้แก่ Microservices, Containerization, Dynamic Orchestration, และ DevOps Automation เพื่อสร้างระบบที่ยืดหยุ่น ขยายตัวได้ และทนทานต่อความล้มเหลว แตกต่างจากแพลตฟอร์มแบบ Monolithic ที่เคยเป็นมาตรฐานในอดีต ซึ่งทุกฟังก์ชันถูกรวมใน codebase เดียว ทำให้การแก้ไขหรืออัปเดตส่วนใดส่วนหนึ่งกระทบระบบทั้งหมด ในบริบทของ Smart Factory แพลตฟอร์ม Cloud-Native ช่วยให้สามารถเพิ่มความสามารถใหม่ ๆ เช่น AI inference, digital twin synchronization, หรือ predictive analytics ได้โดยไม่กระทบระบบที่ทำงานอยู่ ซึ่งเป็นความสามารถที่จำเป็นอย่างยิ่งในยุคที่โรงงานต้องปรับตัวอย่างรวดเร็ว หลักการออกแบบ 6 ด้านของ Cloud-Native IIoT Platform หลักการ คำอธิบาย ประโยชน์ต่อ Smart Factory 1. Microservices แยกฟังก์ชันเป็น service ย่อย ๆ อิสระต่อกัน อัปเดตทีละส่วนโดยไม่กระทบทั้งระบบ 2. Containerization บรรจุแอปพลิเคชันใน container เพื่อความสม่ำเสมอ ทำงานเหมือนกันทุก environment (dev/test/prod) 3. Dynamic Orchestration จัดการ container อัตโนมัติ (scheduling, scaling, healing) ระบบฟื้นตัวเองได้เมื่อ node ล้มเหลว 4. Service Mesh จัดการ communication ระหว่าง microservices load balancing, circuit breaker, mTLS encryption 5. DevOps/CI-CD อัตโนมัติการ build, test, deploy ลดเวลา release จากเดือนเหลือชั่วโมง 6. Observability เก็บ metrics, logs, traces แบบครบถ้วน มองเห็นปัญหาก่อนกระทบการผลิต Microservices Decomposition: การแบ่งแพลตฟอร์ม IIoT ออกเป็น Services การออกแบบ Microservices สำหรับ IIoT Platform ต้องคำนึงถึง…
Read More
Serverless Computing สำหรับ IIoT: FaaS Architecture ที่ขับเคลื่อน Event-Driven Manufacturing

Serverless Computing สำหรับ IIoT: FaaS Architecture ที่ขับเคลื่อน Event-Driven Manufacturing

Article
Serverless Computing คืออะไร และเหตุใดจึงสำคัญสำหรับ IIoT ในโลกของ Industrial IoT (IIoT) ที่เซ็นเซอร์หลายแสนตัวส่งข้อมูลทุก ๆ เสี้ยววินาที สถาปัตยกรรมเซิร์ฟเวอร์แบบดั้งเดิมที่ต้องเปิดทิ้งไว้ตลอดเวลา (always-on) เริ่มกลายเป็นคอขวดทั้งในแง่ต้นทุนและความยืดหยุ่น Serverless Computing หรือ Function-as-a-Service (FaaS) คือพาราดิมที่เปลี่ยนวิธีคิดเรื่องการประมวลผลข้อมูลอุตสาหกรรมอย่างสิ้นเชิง โดยให้คุณเขียนโค้ดเพื่อตอบสนองต่อ "เหตุการณ์" (event) ที่เกิดขึ้นจริง เช่น อุณหภูมิเกินเกณฑ์ มอเตอร์สั่นผิดปกติ หรือสายการผลิตหยุดชะงัก โดยไม่ต้องกังวลเรื่องการจัดการเซิร์ฟเวอร์เลย แนวคิดหลักของ Serverless ในบริบท IIoT คือ Event-Driven Architecture — ระบบจะกระตุ้น (trigger) ฟังก์ชันให้ทำงานก็ต่อเมื่อมี event เกิดขึ้นจริงเท่านั้น ซึ่งสอดคล้องกับพฤติกรรมของข้อมูลอุตสาหกรรมที่ส่วนใหญ่เป็น sporadic (ไม่ต่อเนื่อง) ตัวอย่างเช่น เซ็นเซอร์วัดสั่นสะเทือนอาจส่งข้อมูลทุก ๆ 100 ms แต่สัญญาณเตือนภัยเกิดขึ้นเพียง 2–3 ครั้งต่อวัน การใช้ Serverless ทำให้ทรัพยากรประมวลผลถูกใช้เฉพาะเมื่อจำเป็นจริง ๆ สถาปัตยกรรม Serverless สำหรับ IIoT อย่างละเอียด ส่วนประกอบหลัก 4 ชั้น สถาปัตยกรรม Serverless สำหรับ IIoT ประกอบด้วยชั้นหลัก 4 ชั้นที่ทำงานสัมพันธ์กัน: ชั้น (Layer) หน้าที่ เทคโนโลยี/มาตรฐาน Latency เป้าหมาย 1. Event Source รับข้อมูลจากเซ็นเซอร์/PLC/Edge Gateway MQTT, AMQP, OPC UA Pub/Sub, HTTP Webhook 1–10 ms (Edge) / 50–200 ms (Cloud) 2. Event Router กระจาย event ไปยังฟังก์ชันที่เกี่ยวข้อง Event Bus, Message Queue, Topic-based Routing 5–20 ms 3. Function Execution ประมวลผล logic เช่น anomaly detection, alerting FaaS Runtime (containerized), Edge Function 50–500 ms (ขึ้นกับความซับซ้อน) 4.…
Read More
Hybrid Cloud สำหรับ IIoT: สถาปัตยกรรมผสาน On-Premises และ Public Cloud ที่ตอบโจทย์ทุก Workload

Hybrid Cloud สำหรับ IIoT: สถาปัตยกรรมผสาน On-Premises และ Public Cloud ที่ตอบโจทย์ทุก Workload

Article
ในโลกของ Industrial IoT ที่ข้อมูลและกระบวนการผลิตมีความซับซ้อนมากขึ้นทุกวัน ไม่มีสถาปัตยกรรมคลาวด์รูปแบบใดรูปแบบเดียวที่ตอบโจทย์ทุกความต้องการของโรงงานได้ Hybrid Cloud จึงกลายเป็นแนวทางที่อุตสาหกรรมชั้นนำเลือกใช้ เพราะมันผสานจุดแข็งของทั้ง On-Premises, Private Cloud และ Public Cloud เข้าด้วยกันอย่างยืดหยุ่น โดยให้แต่ละส่วนทำหน้าที่ที่ตัวเองเก่งที่สุด Hybrid Cloud ในบริบทอุตสาหกรรมคืออะไร? Hybrid Cloud Architecture สำหรับ IIoT คือสถาปัตยกรรมที่ผสานระบบคอมพิวเตอร์อย่างน้อย 2 สภาพแวดล้อมเข้าด้วยกัน ได้แก่ (1) ระบบ On-Premises / Private Cloud ที่ตั้งอยู่ภายในโรงงานหรือศูนย์ข้อมูลส่วนตัว และ (2) Public Cloud ที่ให้บริการโดยผู้ให้บริการคลาวด์รายใหญ่ โดยทั้งสองส่วนทำงานร่วมกันผ่านการเชื่อมต่อเครือข่ายที่ปลอดภัยและมี Orchestration ควบคุมการย้าย Workload ระหว่างกันได้ คีย์เวิร์ดสำคัญของ Hybrid Cloud คือ "Workload Portability" — ความสามารถในการย้ายงานประมวลผลไปมาระหว่างสภาพแวดองค์กรกับคลาวด์สาธารณะได้อย่างราบรื่น ตามความเหมาะสมของแต่ละงาน เหตุใดอุตสาหกรรมไม่สามารถใช้ Public Cloud เพียวอย่างเดียว การตัดสินใจเลือกสถาปัตยกรรม Cloud ในอุตสาหกรรมการผลิตไม่ใช่แค่เรื่องของเทคโนโลยี แต่เป็นเรื่องของกฎหมาย ความปลอดภัย และพฤติกรรมของกระบวนการผลิต ดังตารางวิเคราะห์ต่อไปนี้: ปัจจัยพิจารณา On-Premises / Private Public Cloud แนวทาง Hybrid Latency ควบคุมเรียลไทม์ < 5 ms ✅ 50–200 ms ❌ เลือกตามงาน ✅ ข้อมูลละเอียดอ่อน ควบคุมเต็ม ✅ มีความเสี่ยง เก็บใน Private ✅ Scaling ปริมาณงาน จำกัด เกือบไม่จำกัด ✅ Burst to Cloud ✅ การปฏิบัติตามกฎหมาย ง่าย (PDPA/GDPR) ✅ ซับซ้อน เลือกที่เก็บ ✅ AI/ML Training ขนาดใหญ่ ต้องลงทุนสูง พร้อมใช้ ✅ Train on Cloud ✅ หลักการออกแบบ Workload Placement หัวใจของ Hybrid Cloud ที่ประสบความสำเร็จคือการตัดสินใจว่า "งานแบบไหนควรรันที่ไหน" โดยใช้หลักการจำแนกตามลักษณะของ Workload ดังนี้: งานที่ควรอยู่…
Read More
วิเคราะห์ตลาด Industrial IoT: จาก 602 พันล้านЀเป็น 2.43 ล้านล้านดอลลาร์สหรัฐอาเมริกาภายในปี 2035 (CAGR 16.8%)

วิเคราะห์ตลาด Industrial IoT: จาก 602 พันล้านЀเป็น 2.43 ล้านล้านดอลลาร์สหรัฐอาเมริกาภายในปี 2035 (CAGR 16.8%)

Article
รายงานวิจัยอุตสาหกรรมล่าสุดที่ตีพิมพ์ในเดือนมิถุนายน 2026 ระบุตัวเลขที่สะท้อนการเติบโตอย่างก้าวกระโดดของตลาด Industrial IoT (IIoT) ทั่วโลก โดยคาดการณ์ว่ามูลค่าตลาดจะเติบโตจากประมาณ 602.87 พันล้านดอลลาร์สหรัฐในปี 2026 ไปสู่ 2.43 ล้านล้านดอลลาร์สหรัฐภายในปี 2035 ด้วยอัตราการเติบโตเฉลี่ยทบต้นต่อปี (CAGR) 16.8% ตัวเลขนี้สะท้อนการเปลี่ยนแปลงเชิงโครงสร้างครั้งใหญ่ของอุตสาหกรรมการผลิตทั่วโลก ขับเคลื่อนโดยการแปลงดิจิทัล (digital transformation) โครงการ smart manufacturing และการลงทุนในระบบอัตโนมัติอัจฉริยะ 📊 ภาพรวมตลาด IIoT โลก (2025–2035): มูลค่าตลาดปี 2025 อยู่ที่ 514.39 พันล้านดอลลาร์สหรัฐ → ปี 2026 ที่ 602.87 พันล้าน → คาดการณ์ปี 2035 ที่ 2,430.21 พันล้านดอลลาร์สหรัฐ ด้วย CAGR 16.8% ตลอดทั้งทศวรรษ 1. การกระจายตามภูมิภาค (Regional Breakdown) การวิเคราะห์รายภูมิภาคเผยให้เห็นภาพการแข่งขันที่น่าสนใจ: ภูมิภาค ส่วนแบ่งตลาด / อัตราการเติบโต แรงขับเคลื่อนหลัก อเมริกาเหนือ นำตลาดด้วยส่วนแบ่ง ~34% ในปี 2025 การลงทุน R&D สูง โครงสร้างพื้นฐานดิจิทัลพร้อม เอเชียแปซิฟิก เติบโตเร็วที่สุดในช่วงคาดการณ์ นโยบายสนับสนุน smart factory การผลิตยานยนต์และอิเล็กทรอนิกส์ ยุโรป ตลาดที่มั่นคง เน้นมาตรฐาน Industry 4.0 กฎระเบียบ ESG และความยั่งยืน เอเชียแปซิฟิก รวมถึงภูมิภาคอาเซียนที่ประเทศไทยตั้งอยู่ คาดว่าจะเป็นภูมิภาคที่เติบโตเร็วที่สุด ขับเคลื่อนโดยนโยบายสนับสนุน smart manufacturing และการยกระดับอุตสาหกรรมยานยนต์และอิเล็กทรอนิกส์ 2. การวิเคราะห์ตามส่วนประกอบและการใช้งาน (Segment Analysis) ตามส่วนประกอบ (Component) Solution Segment ครองส่วนแบ่งใหญ่ที่สุดในปี 2025 — รวมฮาร์ดแวร์ เซ็นเซอร์ และแพลตฟอร์มซอฟต์แวร์ Services Segment คาดว่าจะเติบโตเร็วที่สุด — สะท้อนความต้องการบริการ system integration การฝึกอบรม และการดูแลระบบ ตามการใช้งานปลายทาง (End-Use) การผลิต (Manufacturing) ครองส่วนแบ่งสูงสุด — เป็นหัวใจของตลาด IIoT โลจิสติกส์และการขนส่ง คาดว่าจะเติบโตเร็วที่สุด — ขับเคลื่อนโดยการติดตามสินค้าแบบ real-time และคลังสินค้าอัตโนมัติ ตามการเชื่อมต่อและการปรับใช้…
Read More