Case Study: Chiller Plant 2,000 RT ลด kW/RT ได้ 22.8% โดยไม่เปลี่ยนเครื่องจักรใหญ่ — เรื่องจริงจากข้อมูล 1 นาที

Case Study: Chiller Plant 2,000 RT ลด kW/RT ได้ 22.8% โดยไม่เปลี่ยนเครื่องจักรใหญ่ — เรื่องจริงจากข้อมูล 1 นาที

Article
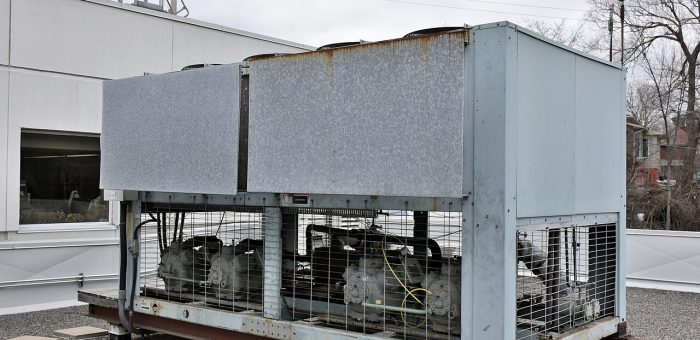
โรงงานผลิตชิ้นส่วนแห่งหนึ่งในนิคมอุตสาหกรรมภาคตะวันออกมี Chiller Plant ขนาด 2,000 ตันเย็น (RT) ให้บริการทั้งระบบปรับอากาศและน้ำเย็นกระบวนการผลิต ทุกคนในทีมซ่อมบำรุงรู้ดีว่า "ค่าไฟห้อง Chillers สูงผิดปกติ" มาหลายปี แต่ไม่มีใครตอบได้ว่าสูงเพราะอะไร เพราะข้อมูลที่มีคือยอด kWh รวมต่อเดือนจากมิเตอร์เดียว และค่าการตั้งค่าที่ "ถูกปรับครั้งสุดท้ายเมื่อคนเก่ายังอยู่" กรณีศึกษานี้ถอดบทเรียนจากโครงการปรับปรุงประสิทธิภาพระบบน้ำเย็นด้วยการติดตั้ง IIoT Monitoring และการวิเคราะห์ข้อมูลแบบ Fault Detection ตั้งแต่วันแรกจนถึงการเปลี่ยนแปลงที่วัดผลได้ — แบบเดียวกับที่โรงงานอื่นต่างประเทศทำและได้ผลยืนยันจากงานวิจัยระดับชาติสหรัฐฯ ปัญหา: เครื่องจักรปกติ แต่ระบบไม่ปกติ สิ่งที่ทีมวิศวกรพบหลังติดตั้งเซ็นเซอร์วัดอุณหภูมิน้ำเข้า/ออกทุกเครื่อง วัดกำลังไฟฟ้าของคอมเพรสเซอร์แยกทีละตัว และดึงค่าจาก BMS มาวิเคราะห์ร่วมกัน คือภาพที่ต่างจากความเชื่อเดิมโดยสิ้นเชิง: เครื่อง Chiller เดิน 3 เครื่องพร้อมกันทั้งวัน ทั้งที่โหลดจริงเฉลี่ยเพียง 58% ของกำลังติดตั้ง — ปัญหา Staging Logic ผิดพลาด อุณหภูมิน้ำเย็นออกถูกตั้งไว้ 6.0°C ทั้งที่กระบวนการผลิตรับ 7.2°C ได้ — ทุก 1°C ที่ลดลงเกินจำเป็น กินพลังงานเพิ่มราว 2-3% Condenser Approach ของเครื่องที่ 2 สูงผิดปกติ (เกิน 3°C) — สัญญาณท่อคอนเดนเซอร์มีตะกอน ปั๊มน้ำเดินที่ความเร็วเต็ม (100%) ตลอดเวลาแม้โหลดต่ำ — ไม่มี VFD ควบคุมตามความต้องการจริง ระบบท่อน้ำเย็นของ Chiller Plant อุตสาหกรรม — จุดวัดอุณหภูมิและความดันทุกจุดคือข้อมูลที่เปลี่ยนวิธีดูแลทั้งระบบ (ภาพ: Wikimedia Commons) โซลูชัน: มองเห็นก่อน แล้วค่อยแก้ หลักการของโครงการคือ "ไม่เดา ไม่ลองผิดลองถูก ใช้ข้อมูลตัดสิน" โดยแบ่งเป็น 3 เส้นทาง: 1. ติดตั้งชั้นข้อมูล (Instrumentation Layer) เพิ่มเซ็นเซอร์อุณหภูมิแม่นยำ ±0.1°C ที่ท่อน้ำเข้า/ออกทุกเครื่อง มิเตอร์วัดกำลังไฟฟ้าทุกตัวขับหลัก (คอมเพรสเซอร์ ปั๊ม พัดลมหอ้นเย็น) และเกตเวย์ IIoT เก็บข้อมูลทุก 1 นาที ส่งขึ้นแพลตฟอร์มวิเคราะห์แบบเรียลไทม์ ตัวชี้วัดหลักที่คำนวณอัตโนมัติคือ kW/RT (กิโลวัตต์ต่อตันเย็น) — ตัวเลขเดียวที่บอกสุขภาพทั้งระบบ 2. วิเคราะห์หาความผิดปกติ (Fault Detection) แพลตฟอร์มเทียบพฤติกรรมจริงกับ Baseline ทางเทคนิค เช่น ความสัมพันธ์ระหว่างโหลด-อุณหภูมิ-กำลังไฟที่ควรเป็นตามหลักอุณหพลศาสตร์ ความผิดปกติที่ตรวจพบถูกจัดคิวตามผลกระทบด้านพลังงาน ไม่ใช่ตามลำดับที่คนเห็นเป็นเรื่องเป็นราวก่อน วิธีนี้เป็นแนวทางเดียวกับ…
Read More
IEC 61724 ปฏิบัติการจริง: ออกแบบระบบ Monitoring โซล่าร์โรงงานให้ค่า Performance Ratio ที่พิสูจน์ได้

IEC 61724 ปฏิบัติการจริง: ออกแบบระบบ Monitoring โซล่าร์โรงงานให้ค่า Performance Ratio ที่พิสูจน์ได้

Article
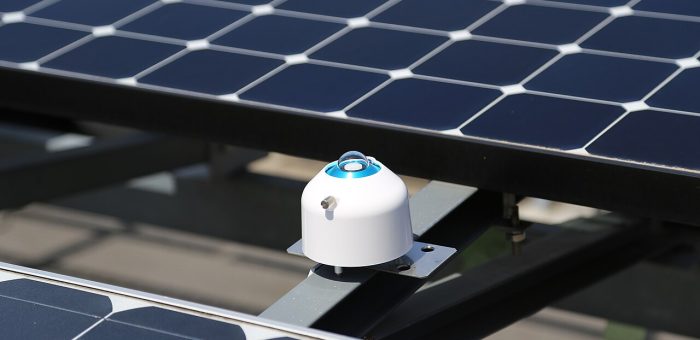
โรงงานจำนวนมากติดตั้งโซล่าร์บนหลังคาด้วยความคาดหวังว่าจะประหยัดค่าไฟ 10-20% แต่พอผ่านไป 2-3 ปี กลับตอบไม่ได้ว่าระบบ "ยังทำงานได้ดีเท่าวันแรกหรือไม่" เพราะข้อมูลที่มีคือตัวเลขผลผลิตรวมจากหน้าจออินเวอร์เตอร์ ซึ่งความผิดพลาดของเครื่องวัดอาจสูงถึง ±3-5% — ไม่พอสำหรับการอ้างสิทธิ์ความเสียหายตามสัญญารับประกันผลผลิต (Performance Guarantee) มาตรฐานสากล IEC 61724 คือคำตอบของปัญหานี้ มันกำหนดว่าจะ "วัดอะไร แม่นยำแค่ไหน ถี่แค่ไหน" เพื่อให้ค่า Performance Ratio (PR) ที่คำนวณออกมาสามารถใช้โต้แย้งทางกฎหมายและการเงินได้ บทความนี้ถอดรหัสมาตรฐานฉบับนี้สำหรับวิศวกรที่ดูแลโซล่าร์ในโรงงานอุตสาหกรรม เซ็นเซอร์วัดรังสีอาทิตย์ (Pyranometer) คือหัวใจของระบบมอนิเตอริ่งตาม IEC 61724 — ความแม่นยำของมันคำนวณเป็นค่า PR ทั้งระบบ (ภาพ: Wikimedia Commons) โครงสร้างมาตรฐาน 3 ส่วน IEC 61724 แบ่งเป็น 3 ส่วน โดยส่วนที่วิศวกรโรงงานต้องรู้จักดีที่สุดคือข้อ 1: IEC 61724-1 — ข้อกำหนดการติดตั้งระบบวัด (Monitoring): เซ็นเซอร์ ความแม่นยำ ความถี่การเก็บข้อมูล IEC 61724-2 — วิธีการประเมินกำลังผลิต (Capacity Evaluation) จากข้อมูลจริง IEC 61724-3 — วิธีการประเมินพลังงาน (Energy Evaluation) เทียบกับค่าอ้างอิง Class A / B / C — เลือกระดับความแม่นยำให้เหมาะกับงาน หัวใจของ IEC 61724-1 คือการจัดระดับระบบวัดเป็น 3 คลาส ตามความแม่นยำของเซ็นเซอร์และความละเอียดข้อมูล: องค์ประกอบ Class A (Bankable) Class B (Operational) Class C (Basic) เซ็นเซอร์วัดรังสี Thermopile Pyranometer มาตรฐาน ISO 9060 Class A (ความคลาดเคลื่อนรายวัน ±1.0-1.5%) Pyranometer ISO 9060 Class B หรือ Reference Cell สอบเทียบแล้ว (±2-3%) Reference Cell ไม่สอบเทียบ หรือค่าจากสถานีอุตุนิยมวิทยา (±5-10%) มิเตอร์พลังงาน IEC 62053 Class 0.2S (±0.2%) IEC 62053…
Read More
บทวิเคราะห์: Digital Twin กับปัญหา Model Drift — เมื่อโมเดล PdM เริ่มเพี้ยน Fleet Learning จะช่วยได้จริงหรือไม่

บทวิเคราะห์: Digital Twin กับปัญหา Model Drift — เมื่อโมเดล PdM เริ่มเพี้ยน Fleet Learning จะช่วยได้จริงหรือไม่

Article
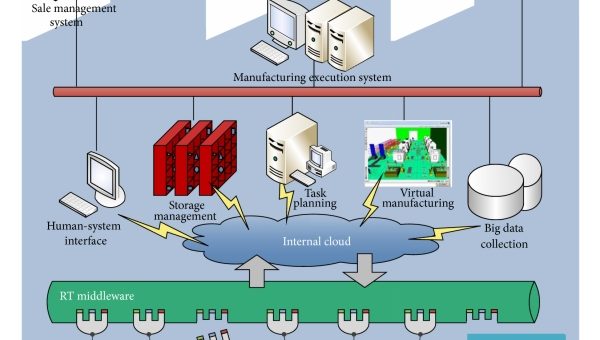
โมเดล AI ทำนายความเสียหายของเครื่องจักร (Predictive Maintenance) ตัวหนึ่งในโรงงานสิ่งทอทำงานได้แม่นยำมากในปีแรก แต่ปีที่สองความแม่นยำเริ่มถดลง เพราะสภาพเครื่องจักรเปลี่ยน โหลดการผลิตเปลี่ยน และพฤติกรรม "ปกติ" ของเครื่องจักรเลื่อนไปจากเดิม นี่คือปัญหา Model Drift ที่ทุกโรงงานต้องเจอ และเป็นคำถามเปิดของวงการว่า Digital Twin จะช่วยแก้ได้จริงหรือไม่ บทวิเคราะห์นี้มองปัญหาจากมุมวิศวกรรม ไม่ใช่มุมการตลาด ปัญหา Model Drift ในโรงงาน: ทำไมโมเดลเก่าเร็วจนน่าใจหาย โมเดล Anomaly Detection ส่วนใหญ่เรียนรู้จากข้อมูลในอดีต แล้วตั้งสมมติฐานว่าอนาคตจะคล้ายอดีต แต่ในโรงงานจริง ไม่มีอะไรนิ่ง: ชิ้นส่วนสึกหรอ, สูตรผลิตเปลี่ยน, ผู้ปฏิบัติงานเปลี่ยนวิธีเดินเครื่อง, อุณหภูมิแวดล้อมตามฤดูกาล หรือแม้แต่การซ่อมบำรุงที่ "ปรับ" พฤติกรรมเครื่องจักรไปโดยสิ้นเชิง ผลคือเกิดการแจ้งเตือนเท็จ (False Alarm) เพิ่มขึ้นเรื่อยๆ จนทีมซ่อมบำรุงเริ่มกด "Dismiss" โดยไม่อ่าน — และวันหนึ่ง Alarm จริงก็ถูกกดไปพร้อมกับพวกเท็จ แนวทางแก้แบบดั้งเดิมคือ การเทรนซ้ำ (Retraining) ด้วยข้อมูลใหม่ แต่คำถามคือใครจะ Label ข้อมูลว่าอะไรคือ "ปกติ" ในสถานการณ์ใหม่ และต้องรอนานแค่ไหนจึงจะมีข้อมูลเพียงพอ เพราะความเสียหายจริงเกิดไม่บ่อยนัก แนวคิดใหม่: Fleet Learning ผ่าน Digital Twin แนวคิดที่กำลังได้รับความสนใจคือการใช้ Digital Twin เป็น "ผู้เรียนรู้ร่วมกัน" ของกลุ่มเครื่องจักรลักษณะเดียวกัน แทนที่จะปล่อยให้แต่ละเครื่องเรียนรู้ลำพัง: สถาปัตยกรรม Smart Factory ยุคใหม่เชื่อมทุกชั้นข้อมูลเข้าด้วยกัน — Fleet Learning เป็นการขยายแนวคิดนี้สู่กลุ่มเครื่องจักรข้ามไซต์ (ภาพ: Wikimedia Commons, CC BY 4.0) หลักการคือ เมื่อเครื่องจักร A ในไซต์ 1 เจอ Failure Mode ใหม่และถูกบันทึกไว้ใน Twin ของมัน ความรู้นั้นสามารถถ่ายทอด (Transfer) ไปยังโมเดลของเครื่องจักร B, C, D ที่อยู่คนละไซต์แต่มีลักษณะเดียวกันได้ทันที เครื่องจักรอื่นๆ จึง "รู้" ล่วงหน้าโดยไม่ต้องเจอเองก่อน นี่คือความต่างสำคัญจากการเทรนโมเดลแบบเก่าที่ต้องรอเครื่องเสียจริงทีละตัวเพื่อสะสมประสบการณ์ วิเคราะห์กลไกทางเทคนิค: Twin ช่วยแก้ Drift ได้อย่างไร กลไก วิธีการทำงาน ข้อดี ข้อจำกัดที่ต้องยอมรับ Simulation Augmentationใช้ Twin จำลองสถานการณ์ที่ยังไม่เคยเกิดจริง สร้างข้อมูล Synthetic สำหรับเทรนโมเดลได้ข้อมูล Failure…
Read More
บทวิเคราะห์: Gartner Hype Cycle for Agentic AI 2026 — องค์กรใช้ AI Agent จริงแค่ 17% และนี่คือสิ่งที่โรงงานต้องรู้ก่อนกระโดดขึ้นรถ

บทวิเคราะห์: Gartner Hype Cycle for Agentic AI 2026 — องค์กรใช้ AI Agent จริงแค่ 17% และนี่คือสิ่งที่โรงงานต้องรู้ก่อนกระโดดขึ้นรถ

Article
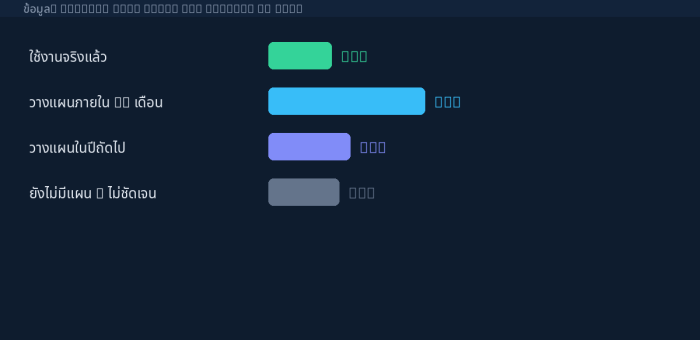
"AI Agent" คือคำที่ถูกพูดมากที่สุดในวงการเทคโนโลยีอุตสาหกรรมปี 2026 ทุกงานสัมมนามีประเด็นนี้ ทุกเวนเดอร์มีแพลตฟอร์มนี้ แต่ตัวเลขจริงจาก Gartner ฉายภาพที่ต่างออกไป: องค์กรที่ใช้ AI Agent ในการทำงานจริงมีเพียง 17% ในขณะที่ 42% วางแผนจะเริ่มภายใน 12 เดือน และอีก 22% มีแผนในปีถัดไป ช่องว่างระหว่าง "ความคาดหวัง" กับ "การใช้งานจริง" นี้แหละคือหัวใจของ Hype Cycle for Agentic AI 2026 ที่ Gartner เผยแพร่ล่าสุด และสำหรับโรงงานไทย นี่คือจังหวะที่ต้องตัดสินใจอย่างมีสติ ไม่ใช่ FOMO ตัวเลขบอกอะไร: 17% ที่เริ่มแล้วทำอะไรอยู่ กลุ่ม 17% ที่ใช้จริงส่วนใหญ่ยังโฟกัสที่ งานอัตโนมัติเฉพาะจุด (Automation เป็นหลัก) ยังไม่ใช่การเปลี่ยนแปลงกระบวนการทั้งองค์กร ซึ่งสอดคล้องกับสิ่งที่เห็นในโรงงานจริง: AI Agent ตัวแรกๆ ที่เวิร์กคือตัวที่ทำงานแคบและชัด เช่น อ่านค่าเซ็นเซอร์แล้วสรุปสรุปสถานะเครื่องจักร จัดลำดับงานซ่อมบำรุง หรือเตรียมรายงานกะกลางคืน 17% ใช้จริง / 42% จะเริ่มใน 12 เดือน / 22% ปีถัดไป — ความต่างขององค์กรจะเกิดในช่วง 12 เดือนข้างหน้า (ข้อมูล: Gartner, แผนภูมิ: Honey Corporation) 3 เทรนด์หลักที่ Gartner ระบุ — แปลเป็นภาษาโรงงาน เทรนด์ Gartner ความหมายต่อโรงงาน 1. AI Agent Adoption — 17% ใช้จริง, 42% ใน 12 เดือนหน้าต่างความได้เปรียบกำลังเปิด ผู้ที่เริ่มก่อนจะสะสมข้อมูลและบทเรียนก่อน แต่เริ่มผิดทางก็เสียเวลาเท่ากัน 2. Semi-Autonomous Deployment — มนุษย์ยังต้องควบคุมอย่ามองหา AI Agent ที่ "ตัดสินใจแทนทั้งหมด" ให้ออกแบบให้ Agent เสนอ + คนอนุมัติจุดวิกฤต เช่น การสั่งหยุดไลน์หรือเปลี่ยนแปลงพารามิเตอร์เครื่องจักร 3. Agent Washing — RPA เดิมแต่งตัวเป็น AI Agentตรวจสอบให้ชัดว่าแพลตฟอร์มที่ซื้อ "คิดและปรับตัว" จริง หรือแค่รันสคริปต์เดิมที่เปลี่ยนชื่อ — ถามดูกรณีที่ Agent…
Read More
Supply Chain Control Tower ยุค Agentic AI: จาก Dashboard เฝ้าดู สู่ศูนย์บัญชาการที่ตัดสินใจแทนคุณในไม่กี่นาที

Supply Chain Control Tower ยุค Agentic AI: จาก Dashboard เฝ้าดู สู่ศูนย์บัญชาการที่ตัดสินใจแทนคุณในไม่กี่นาที

Article
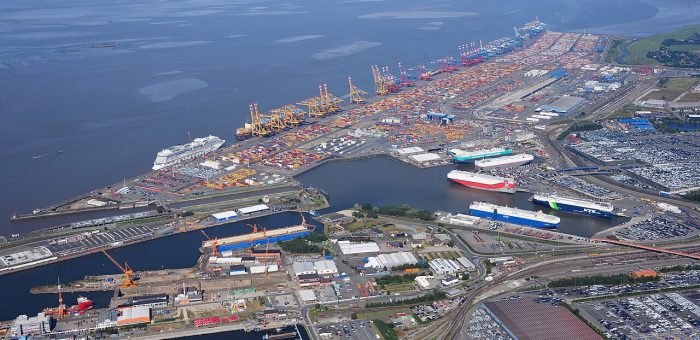
จาก Dashboard บอกเล่าเหตุการณ์ สู่ศูนย์บัญชาการที่ตัดสินใจเอง หลายโรงงานที่ลงทุน "Control Tower" ไปเมื่อ 3-4 ปีก่อน กำลังพบปัญหาเดียวกัน คือระบบสวยงาม ข้อมูลครบ แต่สุดท้ายคนยังต้องนั่งเฝ้าจอ ไล่ดูสถานะรถทุกคัน แล้วโทรไปถามทีมปฏิบัติการเองว่าจะทำอย่างไรต่อ Control Tower รุ่นแรกคือ ชั้นรวบรวมข้อมูล (Data Aggregation Layer) ที่ดึงข้อมูลจาก TMS (ระบบบริหารการขนส่ง) WMS (ระบบบริหารคลังสินค้า) และข้อมูลจากผู้ขนส่งภายนอก มาแสดงบนจอเดียวให้คนตัดสินใจเอง ปี 2026 หน้าที่ของมันกำลังเปลี่ยนไปสู่ AI Control Tower ที่ไม่ใช่แค่รายงานว่าเกิดอะไรขึ้น แต่ประเมินสถานการณ์หลายแบบพร้อมกัน คาดการณ์ผลกระทบ และเสนอหรือลงมือแก้ปัญหาเองภายในไม่กี่นาที แรงผลักดันหลักคือความผันผวนทางภูมิรัฐศาสตร์ การขาดแคลนแรงงาน และต้นทุนที่สูงขึ้น จนองค์กรไม่มีเวลาให้ทีมงานนั่งวิเคราะห์ทุกเหตุการณ์ทีละเคสอีกต่อไป ท่าเรือคอนเทนเนอร์คือจุดที่ความล่าช้าเล็กน้อยถูกขยายเป็นผลกระทบทั้งห่วงโซ่ — AI Control Tower ถูกออกแบบมาเพื่อตัดสินใจ ณ จุดพวกนี้ให้เร็วกว่ามนุษย์ (ภาพ: Wikimedia Commons) ตัวเลขที่อธิบายว่าทำไมทุกคนเร่งตัดสินใจในปี 2026 ข้อมูลจากรายงานอุตสาหกรรมหลายฉบับในปี 2026 ชี้ตรงกันว่า ความไม่แน่นอนทางเศรษฐกิจและภูมิรัฐศาสตร์ เป็นปัจจัยสำคัญที่สุดที่กดดันการตัดสินใจด้าน supply chain ในปีนี้ ขณะที่สัดส่วนองค์กรที่ใช้ AI ในกิจกรรม supply chain เพิ่มจากราว 30% เป็นราว 40% ภายในเวลาเพียงหนึ่งปี — นั่นแปลว่าเกือบครึ่งของคู่แข่งของคุณอาจกำลังให้ AI ช่วยวางแผนสินค้าคงคลังและจัดเส้นทางขนส่งอยู่แล้ว มิติ Control Tower แบบดั้งเดิม AI Control Tower บทบาทหลักรวมข้อมูล แสดงสถานะ (Monitoring)ตัดสินใจและลงมือแก้ปัญหา (Decision + Action) เมื่อรถส่งสินค้าล่าช้าแจ้งเตือนสีแดง รอคนโทรประสานงานระบุเส้นทางทางเลือก จัดสรรสต๊อกระหว่าง DC ใกล้เคียง และจัดลำดับออเดอร์ตาม SLA อัตโนมัติ การตอบสนองชั่วโมงถึงวัน (ผู้เชี่ยวชาญต้องวิเคราะห์)นาที (ระบบประเมินหลายสถานการณ์พร้อมกัน) ข้อมูลที่ใช้TMS + WMS + ผู้ขนส่งเพิ่ม IoT telemetry, สภาพอากาศ, ข่าวภูมิรัฐศาสตร์, ข้อจำกัดท่าเรือแบบ real-time Human-in-the-loopคนตัดสินใจทุกขั้นAI ตัดสินใจชั้นปฏิบัติการ คนกำกับดูแลและยับยั้งได้ คอนเทนเนอร์หลายหมื่นใบในท่าเรือใหญ่ แต่ละใบคือเหตุการณ์ที่ AI Control Tower ต้องติดตามพร้อมกัน — งานที่เกินพิกัดการไล่ด้วยสายตามนุษย์ (ภาพ: Wikimedia Commons) สถาปัตยกรรม 5…
Read More
Soft Sensor (เซ็นเซอร์เสมือน): คำนวณค่าที่วัดไม่ได้จากข้อมูลที่มีอยู่แล้ว — หัวใจที่ถูกลืมของ Digital Twin ระดับกระบวนการ

Soft Sensor (เซ็นเซอร์เสมือน): คำนวณค่าที่วัดไม่ได้จากข้อมูลที่มีอยู่แล้ว — หัวใจที่ถูกลืมของ Digital Twin ระดับกระบวนการ

Article
ในโรงงานกระบวนการผลิต (Process Industry) มีค่าบางอย่างที่วิศวกร "อยากรู้" แต่วัดตรงๆ ไม่ได้ หรือวัดได้แต่ช้าเกินไป ซับซ้อนเกินไป หรือเปลืองเกินไป — ไม่ว่าจะเป็นความเข้มข้นของสารในถังปฏิกิริยา คุณภาพของผลิตภัณฑ์กลางกระบวนการ หรืออัตราการไหลมวลในท่อที่มีสารกัดกร่อน วิธีแก้ดั้งเดิมคือหยิบตัวอย่างส่งแล็บ ซึ่งใช้เวลาเป็นชั่วโมง ทำให้ค่าที่ได้ "สะท้อนอดีต" ไม่ใช่สิ่งที่เกิดขึ้นในถังตอนนี้ Soft Sensor (หรือเรียกอีกชื่อว่า Virtual Sensor / Inferential Sensor) คือคำตอบของปัญหานี้ — มันไม่ใช่ฮาร์ดแวร์ แต่เป็น "เซ็นเซอร์ชิ้นใหม่ที่เกิดจากซอฟต์แวร์" โดยนำค่าจากเซ็นเซอร์จริงหลายสิบถึงหลายร้อยตัวที่มีอยู่แล้วในระบบควบคุม มาประมวลผลร่วมกันเพื่อ "คำนวณ" ค่าที่ต้องการนั้นออกมาแบบเรียลไทม์ โดยไม่ต้องติดตั้งอะไรเพิ่มบนท่อหรือถังเลย Soft Sensor ทำงานอย่างไร — หลักการพื้นฐาน หัวใจของ Soft Sensor อยู่ที่แนวคิดทางทฤษฎีการควบคุมที่เรียกว่า State Observer — ระบบที่ใช้สัญญาณที่วัดได้หลายตัว มาประมาณ "สถานะภายใน" (internal state) ของกระบวนการที่มองไม่เห็น ลองนึกภาพถังปฏิกิริยาเคมี: เราวัดอุณหภูมิ ความดัน อัตราการป้อนวัตถุดิบ และกำลังกวนได้ แต่ความเข้มข้นของผลิตภัณฑ์ในถังต้องรอผลแล็บ Soft Sensor จะเรียนรู้ความสัมพันธ์ระหว่างสัญญาณเหล่านี้กับผลแล็บในอดีต แล้วใช้โมเดลนั้นทำนายความเข้มข้นทุก ๆ วินาที แทนที่จะรอชั่วโมงเดียว แผนภาพหลักการทำงานแบบ Predict–Correct ของ Kalman Filter — อัลกอริทึมตระกูล State Observer คลาสสิกที่ถูกนับเป็น Soft Sensor ยุคแรก (ภาพ: Wikimedia Commons, CC BY-SA 3.0) อัลกอริทึมที่ถูกยกให้เป็นตัวอย่างคลาสสิกของ Soft Sensor คือ Kalman Filter — อัลกอริทึมที่รับชุดการวัดที่มี noise เข้ามาต่อเนื่อง แล้วประมาณค่าตัวแปรที่ไม่รู้ค่าออกมาพร้อมช่วงความไม่แน่นอนของการประมาณ ส่วนการ implement ยุคใหม่นิยมใช้ Neural Network หรือ Fuzzy Computing ซึ่งจับความสัมพันธ์แบบไม่เชิงเส้น (non-linear) ที่ซับซ้อนได้ดีกว่าสมการคณิตศาสตร์แบบดั้งเดิม เปรียบเทียบ Soft Sensor กับเซ็นเซอร์จริงและการวิเคราะห์ในแล็บ ประเด็นเปรียบเทียบ เซ็นเซอร์จริง (Hardware Sensor) การเก็บตัวอย่างส่งแล็บ (Lab Analysis) Soft Sensor (Virtual Sensor) ความถี่ของข้อมูล ต่อเนื่อง (วินาที–มิลลิวินาที) ต่ำมาก (ทุก 2–8…
Read More
บทวิเคราะห์ Hybrid Cloud ในโรงงานอุตสาหกรรม 2026: งานไหนควรอยู่ On-premise งานไหนควรขึ้นคลาวด์

บทวิเคราะห์ Hybrid Cloud ในโรงงานอุตสาหกรรม 2026: งานไหนควรอยู่ On-premise งานไหนควรขึ้นคลาวด์

Article
คำถามที่ฝ่าย IT ของโรงงานไทยถามกันบ่อยที่สุดในปี 2026 ไม่ใช่ "ควรขึ้นคลาวด์ไหม" อีกต่อไป แต่คือ "งานไหนควรอยู่ที่ไหน" เมื่อระบบ SCADA, MES และ data platform ต้องทำงานร่วมกันทั้งบน on-premise และคลาวด์ คำตอบที่กำลังได้รับความนิยมคือ Hybrid Cloud — สถาปัตยกรรมที่ไม่เลือกข้าง แต่จัดวาง workload ตามลักษณะของงาน บทความนี้วิเคราะห์มุมมองของเราที่ Honey Corporation จากประสบการณ์ทำ System Integration ในภาคอุตสาหกรรมไทย ว่าเส้นแบ่งระหว่าง on-premise กับคลาวด์ควรอยู่ตรงไหนจึงจะได้ประโยชน์สูงสุดโดยไม่สร้างความเสี่ยงใหม่ เซิร์ฟเวอร์ในโรงงาน (on-premise) ยังคงเป็นที่พำนักของระบบ real-time control และข้อมูลดิบ — ขณะที่คลาวด์รับงานวิเคราะห์ระยะยาว (ภาพ: Wikimedia Commons) ทำไม "All-in Cloud" และ "All-in On-premise" ต่างก็ไม่ใช่คำตอบ ฝ่ายที่ผลักดัน all-in cloud มักอ้างเรื่องความยืดหยุ่น ไม่ต้องลงทุน hardware ล่วงหน้า และเข้าถึงบริการ AI ได้ทันที แต่ในบริบทโรงงาน มีสามข้อจำกัดที่ยังแก้ไม่ตก: Latency และ dependency — ระบบควบคุมกระบวนการผลิตต้องทำงานต่อแม้อินเทอร์เน็ตขาด การพึ่งพาคลาวด์ 100% ในงาน critical loop คือความเสี่ยงที่ยอมรับไม่ได้ ปริมาณข้อมูลดิบ — เซ็นเซอร์หลายพันจุดสร้างข้อมูลดิบมหาศาล การเก็บทั้งหมดบนคลาวด์เป็นการใช้ทรัพยากรอย่างสิ้นเปลือง ทั้งยังมีค่าใช้จ่าย egress เมื่อต้องดึงกลับมาวิเคราะห์ ข้อกำหนดด้านข้อมูล — ลูกค้าบางรายหรือกฎหมายบางประเทศกำหนดว่าข้อมูลกระบวนการผลิตบางประเภทห้ามออกนอกประเทศ ในทางกลับกัน all-in on-premise ก็แพ้ในเกมระยะยาว: ทีมงานจำกัด การขยายระบบช้า และการเข้าถึงเครื่องมือ AI/ML สมัยใหม่ที่คลาวด์พัฒนาออกมาตลอดเวลา ทำได้ลำบากกว่ามาก เส้นแบ่งที่เราใช้: วาง workload ตาม 4 คำถาม จากประสบการณ์ติดตั้งระบบให้โรงงานหลายแห่ง เราสรุปกรอบการตัดสินใจ 4 คำถาม ก่อนวาง workload ใดๆ ลงที่ไหน: Workload ความเร็วที่ต้องการ ลักษณะข้อมูล ที่วางที่เหมาะสม Real-time control / interlockมิลลิวินาทีข้อมูลดิบหมุนเร็วOn-premise (PLC/DCS) Line dashboard / Andonวินาทีข้อมูลรวมระดับสายผลิตOn-premise edge server OEE, production reportนาที–ชั่วโมงข้อมูลสรุปรายวัน/รายสัปดาห์Cloud ML…
Read More
Edge Analytics ในโรงงานอุตสาหกรรม: วิเคราะห์ข้อมูลทันใจที่ตู้คอนโทรล ก่อนส่งขึ้นคลาวด์

Edge Analytics ในโรงงานอุตสาหกรรม: วิเคราะห์ข้อมูลทันใจที่ตู้คอนโทรล ก่อนส่งขึ้นคลาวด์

Article
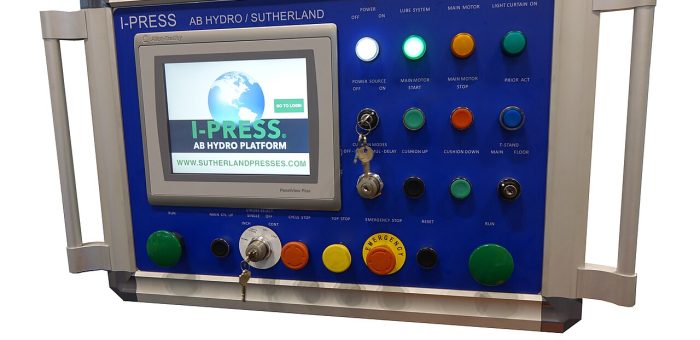
Edge Analytics คืออะไร — ในโรงงานสมัยใหม่ เซ็นเซอร์และเครื่องจักรหนึ่งแห่งสามารถผลิตข้อมูลได้วันละหลายกิกะไบต์ การส่งข้อมูลดิบทั้งหมดขึ้นคลาวด์ก่อนค่อยประมวลผลไม่ใช่คำตอบอีกต่อไป ทั้งจากค่า bandwidth, latency และความเสี่ยงเมื่ออินเทอร์เน็ตขาดหาย Edge Analytics คือการนำกระบวนการวิเคราะห์ข้อมูล — ตั้งแต่การกรองสัญญาณ คำนวณค่าสถิติ ไปจนถึงโมเดล AI — มาวางไว้ที่ edge of the network ใกล้กับแหล่งกำเนิดข้อมูล ไม่ว่าจะเป็น Edge Gateway ในตู้คอนโทรล คอมพิวเตอร์อุตสาหกรรมข้างสายการผลิต หรือเซิร์ฟเวอร์ในโรงงานเอง ผลลัพธ์คือการตัดสินใจเกิดขึ้นภายใน มิลลิวินาที แทนที่จะต้องรอไป-กลับคลาวด์หลายร้อยมิลลิวินาที ซึ่งเป็นความต่างระหว่าง "หยุดเครื่องทันเวลา" กับ "เสียชิ้นงานทั้งล็อต" แผงควบคุมอัตโนมัติที่เก็บ historical data ของเครื่อง press — จุดที่ Edge Analytics ทำงานจริง ก่อนข้อมูลจะถูกส่งขึ้นคลาวด์ (ภาพ: Wikimedia Commons) ทำไมปี 2026 ต้องพูดถึง Edge Analytics อีกครั้ง ตัวเลขสองชุดอธิบายได้ดีที่สุด รายงานของ IoT Analytics (Industry 4.0 & Smart Manufacturing Market Report 2026–2030) ระบุว่าตลาด Smart Manufacturing ทั่วโลกปี 2025 มีมูลค่า 175,000 ล้านดอลลาร์ และจะเติบโตด้วย CAGR 9.3% ไปแตะ 274,000 ล้านดอลลาร์ในปี 2030 ขณะที่ Gartner คาดการณ์ตลาด edge computing โลกจะขยายจาก 131,000 ล้านดอลลาร์ (2023) สู่ 511,000 ล้านดอลลาร์ภายในปี 2033 — เกือบ 4 เท่าใน 10 ปี แรงขับเคลื่อนที่แท้จริงไม่ใช่ตัวเทคโนโลยีเอง แต่เป็นสามแรงกดดันที่โรงงานไทยกำลังเผชิญ: (1) ปริมาณข้อมูลจาก IIoT sensor ที่เพิ่มขึ้นแบบทวีคูณจนส่งขึ้นคลาวด์ทั้งหมดไม่คุ้ม (2) งานที่ต้องการความเร็วระดับมิลลิวินาที เช่น การตรวจจับความผิดปกติของ vibration signature และ (3) นโยบาย data residency ที่บังคับให้ข้อมูลอ่อนไหวบางประเภทอยู่ในประเทศ สถาปัตยกรรม 3 ชั้นของ Edge Analytics Edge…
Read More
Case Study: EnPI ตาม ISO 50006 — เมื่อโรงงานประหยัดไฟ 20% แต่พิสูจน์ไม่ได้ แก้ด้วย Submetering + IIoT

Case Study: EnPI ตาม ISO 50006 — เมื่อโรงงานประหยัดไฟ 20% แต่พิสูจน์ไม่ได้ แก้ด้วย Submetering + IIoT

Article
บทเรียนจากโรงงานที่ "ประหยัดไฟได้ 20% แต่พิสูจน์ไม่ได้" นี่คือเรื่องจริงที่เกิดซ้ำ ๆ ในวงการพลังงานโรงงาน: ทีมวิศวกรลงมือปรับปรุงระบบอากาศอัด ปรับ setpoint ชิลเลอร์ และติดตั้ง VFD ที่ปั๊มหล่อเย็น จนค่าไฟรวมทั้งโรงงานลดลงจริง แต่เมื่อถึงวันประชุมขออนุมัติงบรอบถัดไป ฝ่ายบัญชีถามคำถามเดียวที่ทุกคนตอบไม่ได้ — "ตัวเลขที่ลดลงนั้นมาจากโครงการของพวกคุณ หรือมาจากการที่ยอดสั่งผลิตเดือนนั้นตกลง?" คำถามนี้คือเหตุผลที่มาตรฐาน ISO 50006 มีอยู่ และเป็นสาเหตุที่ทีมงาน Honey Corporation ย้ำเสมอว่า โครงการพลังงานที่ดีต้องเริ่มจาก "ตัวชี้วัดที่ตั้งข้อสงสัยได้" ก่อนติดตั้งอุปกรณ์สักชิ้น มิเตอร์ย่อยหลายตัวตามแนวระบบ — โครงสร้างพื้นฐานของการวัด EnPI ที่สามารถตรวจสอบย้อนกลับได้ (ภาพ: Wikimedia Commons) ปัญหา: Energy Data ที่โกหกตัวเองเงียบ ๆ ตัวชี้วัดพลังงานแบบดิบ (kWh ต่อเดือน) ผสมสัญญาณจริงกับ "noise" เชิงปฏิบัติการเข้าด้วยกัน ตัวอย่างจากคู่มือ ISO 50006 ฉบับปฏิบัติ: สายการผลิตหนึ่งเพิ่ม throughput 20% ขณะที่ kWh รวมคงที่ ผู้จัดการที่ดูตัวเลขดิบจะสรุปว่า "สถานะคงเดิม" แต่เมื่อ normalize ด้วยสมการถดถัยแล้ว ผลคือ ประสิทธิภาพพลังงานดีขึ้นจริง 17% — เรื่องราวที่ตัวเลขดิบลบทิ้งไปทั้งหมด ความแตกต่างระหว่าง "ค่าไฟลด" กับ "ประสิทธิภาพดีขึ้น" คือความแตกต่างระหว่างโครงการที่เล็งระยะสั้น กับโครงการที่ผ่านการตรวจสอบ (audit-proof) วิธีแก้: EnPI ตามกรอบ ISO 50006 ทำงานอย่างไร ISO 50006 (ฉบับปรับปรุงล่าสุด 2023) คือมาตรฐานที่กำหนดวิธีสร้าง EnPI (Energy Performance Indicator) ที่ "ตั้งข้อสงสัยได้และพิสูจน์ได้" ภายในกรอบ ISO 50001 โดยแนวคิดแกนกลางคือ EnPI ที่ไม่มี baseline คืออัตราส่วนที่ไร้ความหมาย องค์ประกอบสำคัญมี 3 ส่วน: Relevant Variables — ปัจจัยนอกเหนือการควบคุมที่กระทบการใช้พลังงานอย่างชอบธรรม เช่น ปริมาณการผลิต (production volume) อุณหภูมิ ambient หรือความชื้นสัมพัทธ์ ระบบอากาศอัด track กับอัตราการผลิต ส่วนชิลเลอร์ track กับ wet-bulb temperature — การเลือกผิดตัวแปร ณ จุดนี้ทำให้ EnPI ทั้งระบบเพี้ยน…
Read More