บทวิเคราะห์: Remaining Useful Life (RUL) — เมื่อคำถามเปลี่ยนจาก ‘พังหรือยัง’ เป็น ‘เหลือกี่สัปดาห์’

บทวิเคราะห์: Remaining Useful Life (RUL) — เมื่อคำถามเปลี่ยนจาก ‘พังหรือยัง’ เป็น ‘เหลือกี่สัปดาห์’

Article
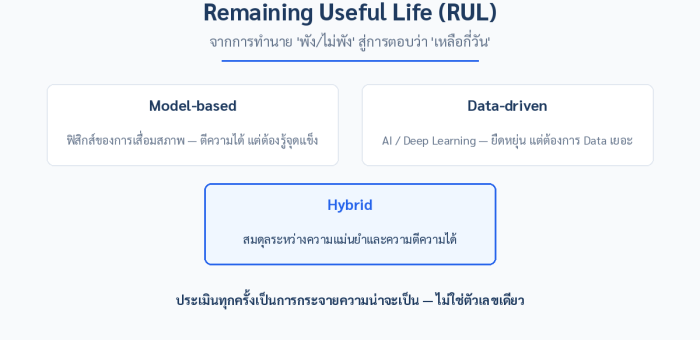
ระบบ Predictive Maintenance ส่วนใหญ่ตอบคำถามได้แค่ "เครื่องนี้กำลังจะพัง" — แต่คำถามที่ Planner และ Production Manager ถามจริงคือ "อีกกี่สัปดาห์จะพัง" เพราะคำตอบนั้นแหละที่ตัดสินได้ว่าจะเลื่อนงานซ่อมไปรวมกับ Shutdown ครั้งถัดไปได้หรือไม่ คำถามนี้คืออาณาเขตของ Remaining Useful Life (RUL) ซึ่งกำลังเปลี่ยนจากงานวิจัยสู่เครื่องมือจริงในโรงงาน RUL ไม่ใช่ตัวเลขเดียว — มันคือการกระจายความน่าจะเป็น ความเข้าใจผิดที่พบมากที่สุดคือคาดหวังให้โมเดลตอบ "เหลืออีก 23 วัน" แบบเด็ดขาด ในความเป็นจริง RUL ที่ถูกต้องคือ ช่วงความเชื่อมั่น เช่น "มีโอกาส 90% ที่จะถึงเกณฑ์เสียหายภายใน 18–26 วัน" เพราะเครื่องจักรสองเครื่องรุ่นเดียวกันภายใต้โหลดต่างกันย่อมเสื่อมสภาพไม่เท่ากัน โมเดลที่ดีจึงต้องรู้จักบอกความไม่แน่นอนของตัวเองด้วย สามเส้นทางของการทำนาย RUL แนวทางหลักการจุดแข็งข้อจำกัด Model-basedสมการฟิสิกส์ของกลไกเสื่อมสภาพ เช่น Paris Law ของรอยแตกตีความได้ ใช้ Data น้อยต้องรู้พารามิเตอร์เครื่องจักรชัดเจน ยืดหยุ่นต่ำ Data-drivenMachine Learning เรียนจากข้อมูลวงจรชีวิตเครื่องจักรจริงแม่นยำ ปรับตัวได้กับระบบซับซ้อนต้องการ Data เสื่อมสภาพจริงจำนวนมาก ตีความยาก Hybridผสมข้อจำกัดทางฟิสิกส์เข้าไปในโมเดล Data-drivenสมดุลความแม่นยำกับการตีความพัฒนาซับซ้อนที่สุด บน P-F Curve — RUL คือการประเมินความกว้างของหน้าต่างทอง ทุกความเสียหายเชิงกลมี ช่วง P-F คือระยะจากจุดที่ตรวจพบได้ครั้งแรก (Potential Failure) ถึงจุดที่พังจริง (Functional Failure) เทคโนโลยีต่าง ๆ เห็นจุด P ไม่พร้อมกัน — Ultrasound มักเห็นก่อนสุด ตามด้วย Oil Analysis แล้วจึง Vibration การทำนาย RUL คือการประมาณว่าจากตำแหน่งปัจจุบันบนเส้นเสื่อมสภาพ ยังเหลือเวลาเท่าไรก่อนแตะเส้น Threshold ซึ่งยิ่งตรวจจับได้เร็ว หน้าต่างการวางแผนก็ยิ่งกว้าง ภาพที่ 1: P-F Curve — ช่วง P-F คือหน้าต่างวางแผนซ่อม และ RUL คือการประมาณเวลาที่เหลือก่อนแตะ Failure Threshold แบบกระจายความน่าจะเป็น (ภาพประกอบเชิงแนวคิด) Deep Learning ไปได้ไกลแค่ไหน — หลักฐานจาก Benchmark จริง ชุดข้อมูล IEEE PHM 2012 Data Challenge (แบริ่งหมุนความเร็วสูงพร้อมข้อมูล Vibration จนถึงวันพังจริง)…
Read More
บทวิเคราะห์: Few-Shot Learning กับงานตรวจตำหนิ — เมื่อมีของเสียแค่ 30 ชิ้น ต้องเทรน AI ตรวจคุณภาพอย่างไร

บทวิเคราะห์: Few-Shot Learning กับงานตรวจตำหนิ — เมื่อมีของเสียแค่ 30 ชิ้น ต้องเทรน AI ตรวจคุณภาพอย่างไร

Article
คำถามที่ QA Manager ถามกันทุกโรงงาน: "จะเทรน AI ตรวจตำหนิได้อย่างไร ในเมื่อตัวอย่างของเสียมีแค่ 20-30 ชิ้นจากทั้งปี?" คำถามนี้เคยเป็นปมตายของ AI inspection เพราะ deep learning แบบ supervised ต้องการข้อมูลหลักพันถึงหมื่นภาพต่อ class แต่ปี 2025-2026 สนามวิจัย Few-Shot Learning (FSL) สำหรับงานตรวจตำหนิอุตสาหกรรมเปลี่ยนไปมาก — และตัวเลขที่ตีพิมพ์ล่าสุดบอกว่าอุปสรรค "ข้อมูลน้อย" กำลังถูกทลายทีละชั้น บทวิเคราะห์นี้รวมตัวเลขจากงานวิจัย 5 ชิ้นล่าสุด เพื่อช่วยโรงงานไทยตัดสินใจว่า FSL พร้อมใช้จริงแค่ไหนในปี 2026 และควรเริ่มต้นจากกลยุทธ์ใด ตัวเลขล่าสุดบอกอะไร งานวิจัย (ปี)โจทย์เงื่อนไขผลลัพธ์เด่น TMCNet (2025)Defect segmentation1-shotmIoU 67.8% (FSSD-12), 42.3% (SD-4i) MF-GNN (2025)จำแนกตำหนิเหล็กแผ่น1-shotaccuracy >92% (SEVERSTAL, NEU-DET) RPS-GA (2026)ตรวจตำหนิ PCB10-shotmAP@0.5 จาก 0.086 → 0.299 Meta-YOLO (review 2025)ตำหนิอะลูมิเนียมเย็น30-shotmAP +14.6%, recall 93.6%, 41.9 FPS Attention-FSL (2025)ตำหนิผิวโลหะFew-shotนำทุก baseline ทดสอบ อ่านตารางนี้แบบมีมุม: ที่ 30-shot (รูปของเสีย 30 ใบ) ระบบรัน real-time ได้ 41.9 FPS พร้อม recall 93.6% — นั่นคือระดับที่ใช้หน้างานได้จริง ส่วนที่ 1-shot ผลยังแตกต่างกันตามความยากของ task (classification ทำได้ดีกว่า segmentation ชัดเจน) ภาพจากระบบ Automated Optical Inspection (AOI) — สายพานที่ของเสียหายากมักสะสมภาพ OK นับหมื่น แต่ภาพ defect ไม่ถึง 100 ใบ Few-Shot Learning ออกแบบมาเพื่อสถานการณ์นี้โดยเฉพาะ (ภาพ: Wikimedia Commons) 4 เส้นทางเทคนิคที่งานวิจัยเดินกันจริง 1. Meta-Learning / Prototypical Network แนวคิด: เทรนโมเดลให้ "เก่งการเรียนรู้ไว" โดยฝึกกับหลาย task จำนวนมาก…
Read More
Multimodal Sensor Fusion: ลดจุดบอดของ Predictive Maintenance ด้วยการผสาน Vibration + Acoustic + Thermal + SCADA

Multimodal Sensor Fusion: ลดจุดบอดของ Predictive Maintenance ด้วยการผสาน Vibration + Acoustic + Thermal + SCADA

Article
หลายโรงงานที่เริ่มทำ Predictive Maintenance (PdM) มักเริ่มจากสิ่งที่ง่ายที่สุด: ติดเซ็นเซอร์วัดการสั่น (Vibration) ที่มอเตอร์หรือลูกปืน แล้วปล่อยให้ AI ทำนายว่าเครื่องจักรจะพังเมื่อไหร่ แนวทางนี้ได้ผลจริง แต่งานวิจัยช่วง 2025-2026 เริ่มชี้ชัดว่า โมเดลที่ฟัง "เสียงเดียว" กำลังถึงเพดานความแม่นยำ โดยเฉพาะเมื่อระบบผลิตมีหลายโหลด หลายความเร็ว และความผิดปกติหลายชนิดเกิดพร้อมกัน บทความนี้ถอดประสบการณ์จากงานวิจัยล่าสุดด้าน Multimodal Sensor Fusion — การผสานข้อมูลจากหลายเซ็นเซอร์หลายประเภทเข้าสู่โมเดลเดียว — พร้อมตัวเลขเปรียบเทียบว่าการเพิ่มแต่ละ modality ซื้อความแม่นยำเพิ่มได้เท่าไร และโรงงานไทยควรเริ่มจากตรงไหน ทำไม Single-Modality ไม่พอแล้ว: ตัวเลขจากงานวิจัย งานวิจัยปี 2026 ด้าน condition monitoring ลูกปืนกังหันลม (ตีพิมพ์ใน Journal of Electrical Systems ปลายเดือนมกราคม 2026) ได้ทำสิ่งที่โรงงานส่วนใหญ่ยังไม่เคยทำ: การเปรียบเทียบแบบ Ablation Study — ถอด modality ออกทีละตัวเพื่อวัดว่าแต่ละเซ็นเซอร์ "ซื้อ" ความแม่นยำเพิ่มเท่าไร ผลลัพธ์สรุปได้ตามตารางนี้ ชุดข้อมูลที่ใช้เทรนF1-Scoreสิ่งที่ได้เพิ่ม เฉพาะข้อมูล SCADA (โหลด อุณหภูมิ ความเร็ว)84.5%บริบทการทำงาน แต่ไม่เห็นตัวความเสียหาย เฉพาะ Acoustic Emission (คลื่นเสียงความถี่สูง)89.2%เห็นรอยร้าวเริ่มต้นก่อนใคร เฉพาะ Vibration92.8%มาตรฐานเดิมของ PdM Vibration + SCADA94.1%แยกโหลดหนักออกจากความเสียหายได้ Vibration + Acoustic Emission96.3%Synergy เกินผลรวมของแต่ละตัว ทั้ง 4 modality (Vib+AE+Temp+SCADA)98.9%สูงสุด ทนทานต่อทุกสภาวะโหลด จุดที่น่าสนใจที่สุดคือแถว Vibration + AE ที่ได้ 96.3% — สูงกว่าผลรวมเดี่ยวของทั้งสองตัวบวกกันแล้วหารสอง นั่นคือ ความเสริมแรงกัน (Complementarity): Vibration เก่งจับ "การสั่นพ้องเชิงโครงสร้าง" จากความเสียหายที่ลุกลามแล้ว ขณะที่ AE ไวต่อคลื่นความเค้นความถี่สูงที่เกิดตอนรอยร้าว เพิ่งเริ่มก่อตัว — ทำให้ระบบเห็นสัญญาณตั้งแต่ระยะ Incipient Fault ที่ Vibration ยังเงียบ สถาปัตยกรรมที่ใช้: CNN-LSTM Hybrid บน Edge โมเดลในงานวิจัยนี้ไม่ใช่โมเดลมหึมา แต่เป็นสถาปัตยกรรมผสม 1D-CNN + LSTM ที่ออกแบบให้ลง Edge Computing Platform ใน nacelle กังหันลมได้จริง…
Read More
Reinforcement Learning ในโรงงาน: เมื่อ AI ไม่ใช่ทำนาย แต่ลงมือควบคุมระบบจริง — จาก Reward Function ถึง Safety Layer

Reinforcement Learning ในโรงงาน: เมื่อ AI ไม่ใช่ทำนาย แต่ลงมือควบคุมระบบจริง — จาก Reward Function ถึง Safety Layer

Article
หลายโรงงานที่เราเจอในประเทศไทยมีปัญหาเดียวกัน — ระบบทำความเย็น ระบบปรับอากาศ หรือชุดหม้อไอน้ำ ถูกตั้งค่าพารามิเตอร์ไว้ตั้งแต่วัน commissioning แล้วก็ไม่เคยถูกปรับอีกเลย ทั้งที่โหลดจริงเปลี่ยนไปตลอดเวลา ทั้งจากฤดูกาล สูตรการผลิต และปริมาณคำสั่งผลิต บทความนี้เราจะเจาะลึกว่า Reinforcement Learning (RL) จะเข้ามา "เรียนรู้" วิธีควบคุมที่ดีที่สุดจากข้อมูลจริงของโรงงานคุณเองได้อย่างไร และทำไมมันถึงไม่ใช่แค่ hype แต่เป็นเทคโนโลยีที่ถูกพิสูจน์แล้วในงานจริงมานานกว่า 8 ปี RL ต่างจาก AI แบบที่โรงงานเคยใช้อย่างไร งาน AI ส่วนใหญ่ในโรงงานตอนนี้คือการ "ทำนาย" — ทำนายว่าแบริ่งจะพังเมื่อไหร่ ทำนายว่าชิ้นงานจะเสียหรือไม่ แต่ RL ไม่ได้ทำนาย RL ทำหน้าที่ ตัดสินใจลงมือทำ โดยตอบคำถามว่า "ถ้าสถานการณ์เป็นแบบนี้ ควรตั้งค่าอะไรเท่าไหร่ถึงจะดีที่สุดในระยะยาว" กลไกหลักของ RL คือการเรียนรู้ผ่านการลองผิดลองถูกภายใต้กรอบที่เรียกว่า Markov Decision Process (MDP) — ตัวควบคุม (agent) สังเกตสถานะปัจจุบัน เช่น อุณหภูมิน้ำเย็น โหลด แรงดัน แล้วเลือก action เช่น ปรับความถี่ปั๊ม เปิด-ปิด chiller จากนั้นระบบให้ reward กลับมา (เช่น พลังงานที่ประหยัดได้ในชั่วโมงนั้น) และวนซ้ำแบบนี้หลายล้านครั้งจนโมเดลเรียนรู้นโยบาย (policy) ที่ดีที่สุด แผนภาพวงจรการเรียนรู้ของ RL: agent สังเกต state → เลือก action → รับ reward → ปรับ policy (ภาพ: Wikimedia Commons, CC) กรณีศึกษาที่เปลี่ยนเกม: ระบบทำความเย็น Data Center ตัวอย่างที่ถูกอ้างถึงมากที่สุดคือโครงการนำร่องปี 2016 ของบริษัทเทคโนโลยีระดับโลกที่นำ Deep RL มาควบคุมระบบทำความเย็นของ data center ของตัวเอง ผลลัพธ์คือพลังงานที่ใช้ในส่วน cooling (PUE ลดลงจาก 1.12 เหลือ 1.10) โดยระบบปรับพารามิเตอร์หลายสิบตัวพร้อมกันที่มนุษย์ทำได้ยาก เพราะตัวแปรทั้งหมด interlock กันหมด ต่อมาปี 2018 มีการต่อยอดให้ระบบส่งคำสั่งควบคุมโดยตรงสู่ระบบจริงทุก 5 นาทีอัตโนมัติ กลายเป็น "operator ที่ไม่มีวันเหนื่อย" ที่คอยหาจุด sweet spot ของระบบตลอด 24 ชั่วโมง ระบบทำความเย็นคือ…
Read More
Remaining Useful Life (RUL): คำถามสุดท้ายของ Predictive Maintenance ที่โมเดลใหญ่ตอบไม่ได้

Remaining Useful Life (RUL): คำถามสุดท้ายของ Predictive Maintenance ที่โมเดลใหญ่ตอบไม่ได้

Article
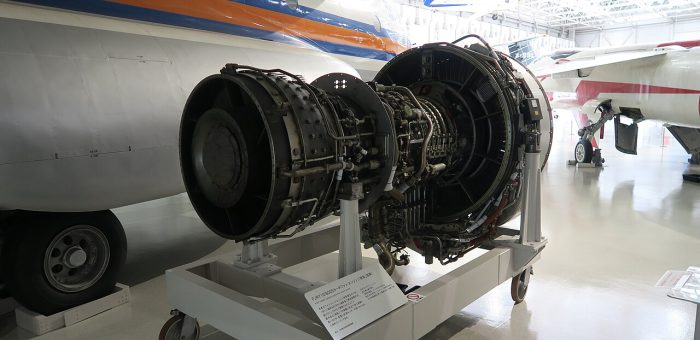
คำถามที่ยากที่สุดของ Predictive Maintenance ไม่ใช่ "เสียหรือยัง" แต่คือ "เหลือเวลาอีกนานเท่าไร" ตลอดหลายปีที่ผ่านมา Predictive Maintenance ในโรงงานส่วนใหญ่หยุดอยู่ที่คำถามแรก: เครื่องจักรตัวนี้ "ผิดปกติหรือไม่" — ซึ่ง Anomaly Detection ตอบได้ค่อนข้างดีแล้ว แต่คำถามที่มีผลต่อการวางแผนจริงๆ คือคำถามที่สอง: "ควรจัดซ่อมเมื่อไร" จัดเร็วเกินไปเสียโอกาสใช้งานชิ้นส่วนเต็มอายุ จัดช้าเกินไปก็กลายเป็น downtime ที่วางแผนไม่ได้ คำตอบของคำถามนี้มีชื่อเฉพาะในวงการวิศวกรรมความน่าเชื่อถือ: Remaining Useful Life (RUL) หรืออายุการใช้งานที่เหลืออยู่ RUL คือหัวใจของสาขา Prognostics and Health Management (PHM) ซึ่งเป็นขั้นสูงสุดของการบำรุงรักษาเชิงพยากรณ์ — ขณะที่ diagnostics บอกว่า "เกิดอะไรขึ้น" prognostics บอกว่า "จะไปต่ออีกนานแค่ไหน" ความต่างนี้คือความต่างระหว่างการรู้ว่าแบริ่งเริ่มมีรอย กับการรู้ว่าแบริ่งนั้นจะทนได้อีก 12 วันหรือ 12 ชั่วโมง ซึ่งนำไปสู่การตัดสินใจที่ต่างกันโดยสิ้นเชิง เครื่องยนต์เทอร์โบแฟน — กลุ่มเครื่องจักรที่งานวิจัย RUL ทำมากที่สุด เพราะความเสียหายระหว่างการใช้งานรุนแรงเกินจะรอให้เกิดขึ้น (ภาพ: Wikimedia Commons) จุดเปลี่ยน 2026: เมื่อ benchmark กลับหน้าไม่เป็นที่คาด เดือนเมษายน 2026 มีงานวิจัยเปรียบเทียบเทคนิค RUL ตีพิมพ์บน arXiv (Goel et al., 2026) ที่ให้ผลลัพธ์ "สะเทือนวงการ" ไม่ใช่เพราะตัวเลขสวย แต่เพราะมันตอกย้ำบทเรียนที่วิศวกรสาย reliability สงสัยกันมานาน งานวิจัยนี้ทดสอบบนชุดข้อมูลมาตรฐาน NASA C-MAPSS turbofan ซึ่งเป็น benchmark ที่ใช้กันทั่วโลกมาเกือบ 20 ปี โดยเปรียบเทียบ 3 ตระกูลวิธีบน subset FD001 และ FD003 ภายใต้ preprocessing เดียวกัน: โมเดล ตระกูล RMSE (FD001) RMSE (FD003) Ridge RegressionClassical (raw features)—— LSTM single-layer (Goel et al. 2026)Deep Learning14.9314.20 Deep LSTM (Zheng et al.)Deep Learning16.1416.18 1D CNNDeep Learning16.9715.68 XGBoostClassical…
Read More
Hand Tracking และ Gesture Recognition ใน Industrial XR: ปลดปล่อยมือคนงานด้วย Natural Interaction

Hand Tracking และ Gesture Recognition ใน Industrial XR: ปลดปล่อยมือคนงานด้วย Natural Interaction

Article
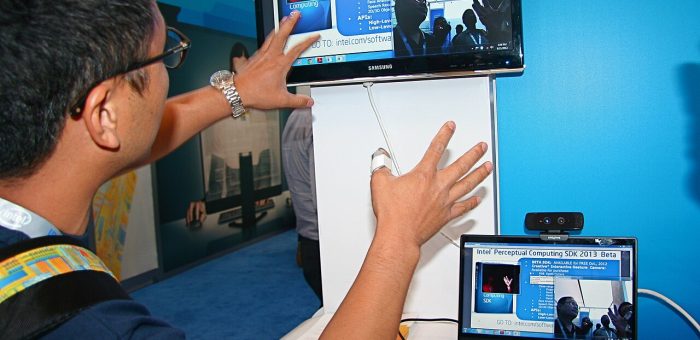
ในสายการผลิตที่มือคนงานต้องถือเครื่องมือหรือสัมผัสชิ้นงานตลอดเวลา การใช้ คอนโทรลเลอร์หรือแท็บเล็ต เพื่อควบคุมระบบ XR จึงเป็นอุปสรรคใหญ่ วันนี้เราจะเจาะลึก Hand Tracking และ Gesture Recognition เทคโนโลยีที่ให้ผู้สวมใส่ Headset โต้ตอบกับสภาพแวดล้อมเสมือนด้วยมือเปล่า (Bare-hand Interaction) ผ่านกลไกที่เรียกว่า Natural User Interface ปัญหา (Problem): เมื่อคอนโทรลเลอร์กลายเป็นภาระ โรงงานประกอบชิ้นส่วนอิเล็กทรอนิกส์แห่งหนึ่งประสบปัญหา: ช่างเทคนิคที่สวม AR Headset เพื่อรับคำแนะนำการประกอบ ต้องสลับมือไปกดคอนโทรลเลอร์เพื่อเลื่อนขั้นตอน หยิบเครื่องมือ และยืนยันผลงาน การสลับมือนี้ทำให้ Cycle Time เพิ่มขึ้นราว 8–12 วินาทีต่อขั้นตอน รวมเป็นหลายนาทีต่อหน่วยผลิต นอกจากนี้คอนโทรลเลอร์ยังสกปรก ชำรุดจากน้ำมันและฝุ่น และทำให้สูญเสียประโยชน์ของการ "ปลดปล่อยมือ" ที่เป็นจุดขายหลักของ AR เอง ภาพประกอบ: Hand Gesture Recognition แบบ Markerless ใช้กล้องตรวจจับท่าทางมือเพื่อสั่งงานระบบโดยไม่ต้องจับอุปกรณ์ — ที่มา: Wikimedia Commons (CC BY 2.0) แนวทางแก้ (Solution): Optical Hand Tracking แบบ Markerless โครงสร้าง Skeletal Model 26 จุด เทคโนโลยี Optical Hand Tracking สมัยใหม่ติดตาม 26 จุดสำคัญ (Keypoints) บนมือแต่ละข้าง ครอบคลุมปลายนิ้ว, ข้อต่อ, ข้อมือ และทิศทางฝ่ามือ โดยโมเดล Machine Learning ประมาณค่าตำแหน่งและทิศทาง (Position, Orientation, Velocity) ของแต่ละจุดที่อัตรา 60–90 เฟรมต่อวินาที จากนั้นจึงจำแนกท่าทาง (Gesture Classification) เช่น Pinch, Grab, Point, Open Palm, หรือ Swipe ตัวเลขประสิทธิภาพเป้าหมายสำหรับงานอุตสาหกรรม: Tracking Latency: ต่ำกว่า 50 มิลลิวินาที (End-to-End) เพื่อให้การตอบสนองรู้สึกเป็นธรรมชาติ Pose Accuracy: ความคลาดเคลื่อนต่ำกว่า 10 มิลลิเมตร ที่ระยะแขน 50 ซม. Gesture Recognition Rate: สูงกว่า 95% ในสภาพแสงปกติ ตำแหน่งมือที่ตรวจได้: ระยะ…
Read More
Knowledge Distillation สำหรับ Industrial AI: เทคนิคบีบอัดโมเดล AI ขนาดใหญ่ให้วิ่งบน Edge Device

Knowledge Distillation สำหรับ Industrial AI: เทคนิคบีบอัดโมเดล AI ขนาดใหญ่ให้วิ่งบน Edge Device

Article
Knowledge Distillation สำหรับ Industrial AI: เทคนิคบีบอัดโมเดล AI ขนาดใหญ่ให้วิ่งบน Edge Device วงจรงาน Machine Learning ในโรงงาน — ตั้งแต่เก็บข้อมูลเซ็นเซอร์จนถึงการใช้โมเดลตัดสินใจบนหน้างาน (ภาพประกอบ: Honey Corporation) วงจรงาน Machine Learning ในโรงงาน — ตั้งแต่เก็บข้อมูลเซ็นเซอร์จนถึงการใช้โมเดลตัดสินใจบนหน้างาน (ภาพประกอบ: Honey Corporation) ในยุคที่โมเดล Deep Learning มีขนาดใหญ่ขึ้นเรื่อยๆ (บางโมเดลมีพารามิเตอร์นับพันล้าน) การ Deploy ลงบน Edge Device ในโรงงานที่มีทรัพยากรจำกัด (RAM 512 MB – 4 GB, CPU พลังต่ำ) จึงเป็นความท้าทายใหญ่ Knowledge Distillation (KD) คือเทคนิคที่แก้ปัญหานี้โดยการ “ถ่ายทอดความรู้” จากโมเดลใหญ่ (Teacher) ไปยังโมเดลเล็ก (Student) โดยรักษาประสิทธิภาพไว้ใกล้เคียงเดิม หลักการพื้นฐานของ Knowledge Distillation KD ได้แรงบันดาลใจจากกระบวนการเรียนการสอนในชีวิตจริง ครูที่มีความรู้ลึกซึ้ง (Teacher Model) สอนนักเรียนที่มีความจำจำกัด (Student Model) ให้เข้าใจเนื้อหาแกนกลางได้โดยไม่ต้องรู้ทุกอย่างแบบครู กระบวนการนี้ทำงานผ่านกลไกที่เรียกว่า Soft Labels ปกติโมเดล Classification จะให้ผลลัพธ์เป็น Hard Label (เช่น “ตำหนิประเภท A = 100%”) แต่ Teacher Model จะให้ผลเป็น Soft Label ที่อยู่ในรูป Probability Distribution (เช่น “ตำหนิ A = 70%, ตำหนิ B = 25%, ปกติ = 5%”) ข้อมูลเหล่านี้เรียกว่า Dark Knowledge — มันเก็บข้อมูลความสัมพันธ์ระหว่างคลาสที่ Hard Label สูญเสียไป สูตรการทำงานของ KD Loss Function ของ Student Model ประกอบด้วย 2 ส่วน: L_total = α × L_hard(y_true, y_student) + (1-α)…
Read More
Industrial Computer Vision: จาก CNN ถึง Vision Transformer สำหรับตรวจสอบคุณภาพการผลิต

Industrial Computer Vision: จาก CNN ถึง Vision Transformer สำหรับตรวจสอบคุณภาพการผลิต

Article
Computer Vision ในงานอุตสาหกรรม: จาก CNN ถึง Vision Transformer สำหรับตรวจสอบคุณภาพการผลิต วงจรงาน Machine Learning ในโรงงาน — ตั้งแต่เก็บข้อมูลเซ็นเซอร์จนถึงการใช้โมเดลตัดสินใจบนหน้างาน (ภาพประกอบ: Honey Corporation) วงจรงาน Machine Learning ในโรงงาน — ตั้งแต่เก็บข้อมูลเซ็นเซอร์จนถึงการใช้โมเดลตัดสินใจบนหน้างาน (ภาพประกอบ: Honey Corporation) ในโรงงานอัตโนมัติยุคใหม่ Computer Vision (CV) ได้กลายเป็นเซ็นเซอร์ที่ทรงพลังที่สุดสำหรับการตรวจสอบคุณภาพ (Quality Inspection) โดยเปลี่ยนกล้องอุตสาหกรรมธรรมดาให้กลายเป็น “ดวงตาอัจฉริยะ” ที่ตรวจจับตำหนิ (defect) ได้แม่นยำกว่าและเร็วกว่ามนุษย์หลายเท่า บทความนี้เจาะลึกสถาปัตยกรรม CV ตั้งแต่ CNN คลาสสิกไปจนถึง Vision Transformer ที่กำลังเป็นที่นิยมในปี 2026 Pipeline การตรวจสอบคุณภาพด้วย CV แบบเต็มรูปแบบ ระบบ Industrial Computer Vision ที่สมบูรณ์ประกอบด้วย 5 ขั้นตอนหลัก: Image Acquisition — ใช้กล้องอุตสาหกรรมความละเอียดสูง (5–25 MP) พร้อมระบบแสงที่เหมาะสม เช่น Bright-Field, Dark-Field, หรือ Backlight Illumination เพื่อเน้นตำหนิให้เด่นชัด Preprocessing — ทำ Image Normalization, Noise Reduction, และ Data Augmentation (Rotation, Flip, Color Jitter) เพื่อเพิ่มความหลากหลายของข้อมูลฝึก Feature Extraction — สกัดคุณลักษณะด้วยโครงข่ายประสาทเทียม เช่น Convolutional Neural Network (CNN) หรือ Vision Transformer (ViT) Inference / Decision — จำแนกประเภทตำหนิ ระบุตำแหน่ง หรือแบ่งส่วนพื้นที่ที่มีปัญหา Post-processing & Action — กรองผลด้วย Non-Maximum Suppression (NMS) ส่งสัญญาณไปยัง PLC หรือ SCADA เพื่อคัดแยกชิ้นงาน สถาปัตยกรรม CNN สำหรับงานอุตสาหกรรม CNN ยังคงเป็นกระดูกสันหลังของระบบ CV ส่วนใหญ่ในโรงงาน เนื่องจากประสิทธิภาพที่พิสูจน์แล้วและความเสถียรในการ Deploy…
Read More
AI Accountability ใน Smart Factory: วิกฤต Governance เมื่อ 70% ขององค์กรสืบย้อนความล้มเหลวของ AI ไม่ได้

AI Accountability ใน Smart Factory: วิกฤต Governance เมื่อ 70% ขององค์กรสืบย้อนความล้มเหลวของ AI ไม่ได้

Article
เมื่อ AI Agent ทำหน้าที่ตั้งแต่อนุมัติการจัดซื้อ จัดตารางผลิต ไปจนถึงกำหนดเส้นทางขนส่ง ใครจะรับผิดชอบเมื่อ AI ตัดสินใจผิด? การศึกษาที่ตีพิมพ์ในเดือนกรกฎาคม 2026 เผยข้อมูลที่น่าตกใจ: 70% ขององค์กรไม่สามารถระบุได้ว่า AI Agent ตัวไหนก่อให้เกิดความล้มเหลวในสภาพแวดล้อมที่มีหลาย Agent ทำงานพร้อมกัน นี่ไม่ใช่ปัญหาทฤษฎี แต่เป็นวิกฤต Governanceที่กำลังเติบโตเร็วกว่าที่โปรแกรม AI ขององค์กรส่วนใหญ่เตรียมพร้อมไว้ โดยเฉพาะในโรงงานอัจฉริยะที่ AI กำลังซึมเข้าสู่ทุกชั้นการตัดสินใจ บริบท: โรงงานยุค Multi-Agentวงจรงาน Machine Learning ในโรงงาน — ตั้งแต่เก็บข้อมูลเซ็นเซอร์จนถึงการใช้โมเดลตัดสินใจบนหน้างาน (ภาพประกอบ: Honey Corporation)วงจรงาน Machine Learning ในโรงงาน — ตั้งแต่เก็บข้อมูลเซ็นเซอร์จนถึงการใช้โมเดลตัดสินใจบนหน้างาน (ภาพประกอบ: Honey Corporation) Smart Factory สมัยใหม่ไม่ได้ใช้ AI เพียงโมเดลเดียว แต่ใช้ระบบ AI หลายตัวทำงานพร้อมกัน (Multi-Agent Environment) — ตัวหนึ่งคาดการณ์ความต้องการวัตถุดิบ อีกตัวจัดตารางเครื่องจักร ตัวถัดไปตรวจสอบคุณภาพด้วย Vision AI และอีกตัวกำหนดเส้นทาง AGV/AMR ในคลังสินค้า แต่ละ Agent ตัดสินใจแบบอัตโนมัติและส่งผลกระทบต่อกัน เจ็ดในสิบองค์กร (70%) ไม่สามารถระบุได้ว่า Agent ตัวใดก่อให้เกิดความล้มเหลว เมื่อระบบ Multi-Agent ทำงานผิดพลาด — จากการศึกษาของผู้ให้บริการแพลตฟอร์ม AI ชั้นนำ ปี 2026 ทำไมสืบย้อนความล้มเหลวของ AI ยาก? ปัญหาหลักคือห่วงโซ่ความรับผิดชอบ (Chain of Accountability) ที่ยากต่อการสืบค้นกลับ เมื่อหุ่นยนต์หยิบชิ้นส่วนผิด คำถามคือ: เป็นความผิดของ Agent วางแผนการผลิตที่ส่งคำสั่งผิด? หรือ Agent นำทางที่เลือกเส้นทางผิด? หรือ Vision AI ที่จำแนกชิ้นส่วนผิด? หรือ Agent จัดซื้อที่สั่งวัตถุดิบผิดขนาด? ในสภาพแวดล้อมแบบดั้งเดิม มนุษย์ตัดสินใจทุกขั้นตอนจึงมี “ลายเซ็น” ชัดเจน แต่เมื่อ AI ตัดสินใจอัตโนมัติด้วยความเร็วที่มนุษย์ตามไม่ทัน บันทึกการตัดสินใจ (Decision Log) มักกระจัดกระจาย ไม่มีมาตรฐานร่วม หรือไม่ถูกบันทึกเลย สาเหตุความล้มเหลวที่ AI ก่อ ผลกระทบต่อโรงงาน ความยากที่จะสืบย้อน ตั้งคำสั่งซื้อผิด (Procurement) สต็อกล้น/ขาดวัตถุดิบ ปานกลาง จัดตารางผลิตผิด (Scheduling) ความล่าช้า…
Read More
Continual Learning สำหรับ Industrial AI: เมื่อโมเดล AI เรียนรู้ไม่หยุดยั้งโดยไม่ลืมความรู้เดิม

Continual Learning สำหรับ Industrial AI: เมื่อโมเดล AI เรียนรู้ไม่หยุดยั้งโดยไม่ลืมความรู้เดิม

Article
Continual Learning คืออะไร? ทำไมโรงงานอัจฉริยะต้องการ AI ที่เรียนรู้ไม่หยุดยั้งวงจรงาน Machine Learning ในโรงงาน — ตั้งแต่เก็บข้อมูลเซ็นเซอร์จนถึงการใช้โมเดลตัดสินใจบนหน้างาน (ภาพประกอบ: Honey Corporation)วงจรงาน Machine Learning ในโรงงาน — ตั้งแต่เก็บข้อมูลเซ็นเซอร์จนถึงการใช้โมเดลตัดสินใจบนหน้างาน (ภาพประกอบ: Honey Corporation) Continual Learning หรือ Lifelong Machine Learning คือความสามารถของโมเดล AI ในการเรียนรู้สิ่งใหม่ ๆ อย่างต่อเนื่องจากข้อมูลที่ไหลเข้ามาใหม่ โดยไม่ลืมความรู้เดิมที่เคยเรียนมาแล้ว ในโรงงานอุตสาหกรรมที่สภาพการผลิตเปลี่ยนแปลงตลอดเวลา เช่น เปลี่ยนชิ้นงานใหม่ เปลี่ยนวัตถุดิบ หรือปรับพารามิเตอร์เครื่องจักร Continual Learning ช่วยให้โมเดล AI สามารถปรับตัวได้โดยไม่ต้องเทรนใหม่ทั้งหมดจากศูนย์ ความท้าทายหลักของ Continual Learning คือปัญหา Catastrophic Forgetting เมื่อโมเดลเรียนรู้ Task ใหม่ น้ำหนักของ Neural Network จะถูกปรับจนเขียนทับความรู้เดิม ทำให้โมเดลลืมวิธีทำงานเดิม สำหรับโรงงานที่หมายถึงโมเดลตรวจสอบคุณภาพชิ้นงานใหม่ได้ดี แต่กลับเสื่อมประสิทธิภาพในการตรวจชิ้นงานเดิม ทำไม Batch Retraining แบบเดิมไม่พอแล้ว วิธีดั้งเดิมในการรักษาประสิทธิภาพโมเดล AI คือการ Retrain ทั้งหมดด้วยข้อมูลเก่าและใหม่รวมกัน (Batch Retraining) แต่วิธีนี้มีข้อจำกัดในโรงงานอุตสาหกรรม: ใช้เวลานาน – การเทรนใหม่ทั้งหมดอาจใช้เวลาหลายชั่วโมงถึงหลายวัน ทำให้โมเดลใช้ข้อมูลล้าหลัง ใช้ทรัพยากรมหาศาล – ต้องเก็บข้อมูลทั้งหมดไว้ ใช้ GPU จำนวนมากในการเทรนซ้ำ ไม่สามารถตอบสนองเร็วพอ – ในโรงงานที่เปลี่ยนชิ้นงานหลายรอบต่อวัน การรอ Retrain ทั้งหมดไม่ใช่ทางเลือก ข้อมูลเก่าอาจไม่เกี่ยวข้อง – การใส่ข้อมูลทั้งหมดอาจทำให้โมเดลสับสนระหว่างบริบทเก่าและใหม่ Key Insight: การเปรียบเทียบง่าย ๆ คือ คนงานเก่งไม่ได้ลืมวิธีประกอบชิ้นงาน A เมื่อเรียนรู้ชิ้นงาน B แต่ AI แบบดั้งเดิมกลับลืม Continual Learning คือเทคโนโลยีที่ทำให้ AI เรียนรู้ได้เหมือนมนุษย์ ปัญหา Catastrophic Forgetting ในเชิงลึก ใน Neural Network ข้อมูลทั้งหมดถูกเข้ารหัสในรูปแบบน้ำหนัก (Weights) ของ Neuron หลายล้านตัว เมื่อเทรนกับ Task ใหม่ Gradient Descent จะปรับน้ำหนักให้เหมาะกับข้อมูลใหม่ โดยไม่สนใจว่าการปรับนั้นจะทำลายความรู้เดิมหรือไม่ ผลที่ได้คือโมเดลทำงานได้ดีกับ Task ล่าสุด…
Read More