บทวิเคราะห์: Data Swamp — เมื่อ Data Lake ของโรงงานไม่มีใครกล้าใช้ และทางออกที่ไม่ใช่การซื้อเครื่องมือเพิ่ม
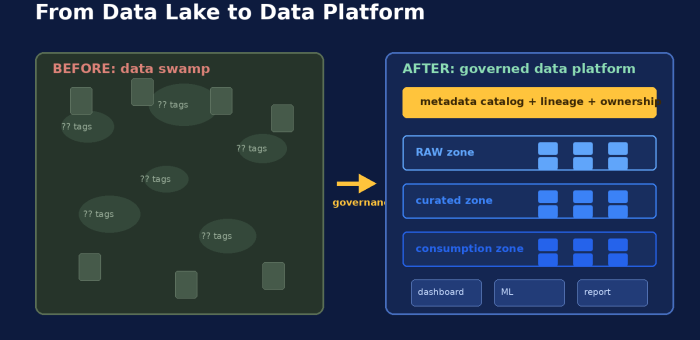
คำสารภาพจากวงการ: โรงงานไม่ได้ขาดข้อมูล — โรงงานจมอยู่ในข้อมูล ตลอดหลายปีที่ผ่านมา วงการอุตสาหกรรมพูดเรื่อง "Data Lake" กันจนเป็นมาตรฐาน คำสัญญาฟังดีเสมอ: ทุกอย่างไหลมารวมที่เดียว ทีมวิเคราะห์เปิดมาใช้ได้ทันที การตัดสินใจยึดตามข้อมูล แต่หลังจากที่ทีม Honey Corporation ได้เข้าไปประเมินแพลตฟอร์มข้อมูลของโรงงานหลายสิบแห่ง เราพบว่าคำถามที่แท้จริงของปี 2026 ไม่ใช่ "เราจะเก็บข้อมูลอย่างไร" อีกต่อไป แต่คือ "ทำไมข้อมูลที่เก็บมาทั้งหมดนี้ ไม่มีใครกล้าใช้" นี่คือบทวิเคราะห์มุมมองของเราต่อปรากฏการณ์ "Data Swamp" — ทะเลข้อมูลที่เน่าเสียเพราะไม่มีใครรู้ว่าข้อมูลแต่ละก้อนมาจากไหน หมายถึงอะไร และเชื่อถือได้แค่ไหน แพลตฟอร์มข้อมูลที่มีชีวิตต้องมีผู้รับผิดชอบชัดเจนรอบตัวมัน — ไม่ใช่แค่ท่อและคลัง (ภาพประกอบ: Honey Corporation) อาการสามข้อที่บอกว่าโรงงานคุณกำลังกลายเป็นหนองน้ำข้อมูล จากประสบการณ์เข้าประเมินงานจริง เราสรุปอาการวินิจฉัยได้ 3 ข้อ: อาการที่ 1: หา tag ไม่เจอ — วิศวกรอยากรู้อุณหภูมิถังหมัก B-7 เมื่อสัปดาห์ก่อน แต่ไม่รู้ว่าในระบบมีชื่อจุดวัดกว่า 40,000 รายการ กระจายอยู่ในเซิร์ฟเวอร์เก็บข้อมูล 4 ตัว จะค้นด้วยคำว่าอะไร ระบบตั้งชื่อโดยผู้รับเหมาเก่าสมัย 8 ปีก่อนด้วยรูปแบบที่ไม่มีเอกสารอธิบาย เวลาที่ใช้หาแค่จุดวัดเดียวกินไปเกือบ 45 นาที ผลคือเขาเลือกที่จะติดเทอร์มอมิเตอร์มือถีบขึ้นไปวัดเอง แล้วบันทึกในสมุด — เทคโนโลยีที่ลงทุนมาทั้งระบบย้อนกลับไปเป็นกระดาษ อาการที่ 2: ตัวเลขเดียว สามคำตอบ — ปริมาณผลิตเมื่อวานบนหน้าจอเฝ้าระวัง ในรายงานสรุปประจำวัน และในไฟล์นำเสนอฝ่ายบริหาร ให้ค่าสามค่าที่ไม่เท่ากัน ต่างกัน 1-3% ทั้งที่มาจากทะเลข้อมูลก้อนเดียวกัน ต้นเหตุมักตื้นๆ นิดเดียว: เขตเวลาที่ใช้ต่างกัน การปัดเศษต่างกัน หรือนิยาม "ชิ้นงานดี" ต่างกันตามคนเขียน query แต่ผลลัพธ์คือความเชื่อมั่นที่ตาย อาการที่ 3: โครงการ AI ตายก่อนเกิด — ทีมข้อมูลวิเคราะห์ว่าปัญหาคุณภาพที่เกิดซ้ำมาเป็นเวลา 6 เดือนน่าจะมาจากอุณหภูมิ แต่ตอนจะหยิบข้อมูลมาสอนโมเดล พบว่าข้อมูลช่วงที่สนใจมีช่องว่างหายไปถึง 8 เดือน จากจุดวัดราว 300 tags เพราะเกตเวย์ของเครื่องจักรตัวหนึ่งถูกปิดการเก็บไปตั้งแต่ครั้งทำโครงการย้ายระบบ และไม่มีใครรู้ตัวเพราะไม่มีการเฝ้าระวังความครบถ้วนของข้อมูล โมเดลที่ดีที่สุดในโลกก็ไม่มีทางเรียนรู้จากข้อมูลที่ไม่มีอยู่ เวลาส่วนใหญ่ของทีมข้อมูลโรงงานหมดไปกับการ "ตามหา" และ "ล้าง" ข้อมูล ไม่ใช่การวิเคราะห์ — แผนภาพเชิงแนวคิดจากการสังเกตงานจริงของทีม Honey Corporation มุมมองของเรา: ปัญหาไม่ได้อยู่ที่เทคโนโลยี — แต่อยู่ที่สิ่งที่ถูกละเลย ถ้าถามว่าอะไรทำให้ทะเลข้อมูลกลายเป็นหนองน้ำ เราจะตอบไม่ใช่เพราะเลือกฐานข้อมูลผิด แต่เพราะสามสิ่งที่ทุกโครงการรู้ว่าสำคัญแต่ไม่มีใครทำ เพราะ "ไม่มีเวลา": Metadata และการตั้งชื่อที่มีความหมาย…