บทวิเคราะห์: ซื้อฮาร์ดแวร์ Edge อย่างไรไม่ให้เสียใจภายหลัง — 5 หมวดที่ต้องประเมินก่อนเซ็น PO

บทวิเคราะห์: ซื้อฮาร์ดแวร์ Edge อย่างไรไม่ให้เสียใจภายหลัง — 5 หมวดที่ต้องประเมินก่อนเซ็น PO

Article
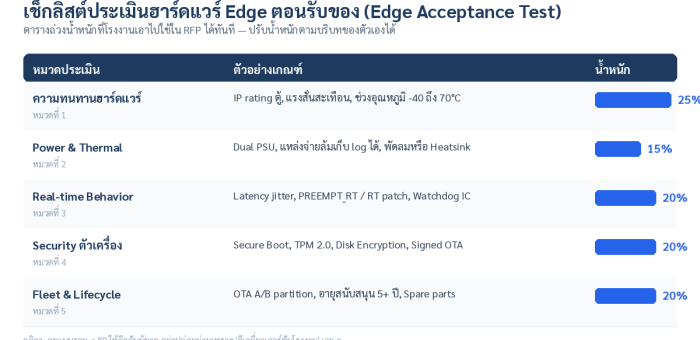
ทุกครั้งที่โรงงานไทยจะเริ่มโปรเจกต์ Edge Computing มีหนึ่งจุดที่แทบทุกแห่งตกหลุมพรางเดียวกัน: ซื้อฮาร์ดแวร์ก่อน คิดสถาปัตยกรรมทีหลัง ผลคือเครื่อง edge ที่ spec เกินความจำเป็นแต่ทนสภาพหน้างานไม่ได้ หรือแย่กว่านั้น — เครื่องที่ "ใช้ได้ในห้อง server" แต่ล้มในตู้คอนโทรลที่อุณหภูมิ 45°C ภายในสามเดือน บทความนี้คือสิ่งที่เราอยากให้ทุกฝ่ายจัดซื้ออ่านก่อนเซ็น PO ทำไม "คอมพิวเตอร์ธรรมดา" ถึงไม่รอดในโรงงาน ตู้คอนโทรลในโรงงานไม่ใช่ห้อง server มันคือสภาพแวดล้อมที่มีทั้งฝุ่น ความชื้น แรงสั่นสะเทือนจากมอเตอร์และคอมเพรสเซอร์ ไฟกระชากจากการสตาร์ทเครื่องจักรหนัก และสัญญาณรบกวน EMI จาก VFD ฮาร์ดแวร์ edge ที่ออกแบบมาสำหรับสภาพนี้ต้องผ่านการรับรองหลายด้านที่คอมพิวเตอร์สำนักงานไม่เคยถูกทดสอบ ไทม์ไลน์เหตุการณ์จริงที่พบบ่อยในอุตสาหกรรม: พัดลมเสีย → thermal throttle → silent failure → ข้อมูล QC ขาดช่วง 43 นาที (ที่มา: Honey Corporation) 5 หมวดที่ต้องประเมินก่อนเซ็นสัญญา 1. ความทนทานฮาร์ดแวร์ (Hardware Durability) เช็คช่วงอุณหภูมิทำงาน (อุตสาหกรรมจริงควรได้ -40 ถึง 70°C ไม่ใช่แค่ 0-50°C), แรงสั่นสะเทือนและแรงกระแทกตามมาตรฐานทดสอบ, การกันน้ำและฝุ่นตามระดับ IP rating ที่เหมาะกับจุดติดตั้ง และ connector แบบ lock ที่ไม่หลุดเมื่อตู้สั่น 2. Power และ Thermal คำถามที่ควรถามผู้ขายเสมอ: "ถ้าไฟดับตอนเครื่องกำลังเขียนข้อมูลลงดิสก์ จะเกิดอะไรขึ้น?" ฮาร์ดแวร์ระดับอุตสาหกรรมควรมี dual power supply, วงจรที่จ่ายไฟต่อให้เพียงพอให้ flush ข้อมูลและเขียน log ก่อนดับ และระบบระบายความร้อนที่ไม่มีพัดลมก็ยังทำงานได้ (fanless heatsink design) หรือมีพัดลมที่เปลี่ยนได้โดยไม่ต้องปิดเครื่อง 3. พฤติกรรม Real-time ถ้า edge ของคุณจะทำงานที่ใกล้ชิดกับลูปควบคุม ค่า latency jitter สำคัญกว่าค่าเฉลี่ย — ระบบปฏิบัติการทั่วไปอาจมี pause ของ scheduler นับสิบมิลลิวินาทีเป็นครั้งคราว ซึ่งไม่เป็นไรกับ dashboard แต่ทำลายงานที่ต้องตอบสนองสม่ำเสมอ ให้ถามหาการรองรับ real-time kernel patch และ watchdog IC ที่รีเซ็ตเครื่องอัตโนมัติเมื่อ software ค้าง 4. Security ระดับตัวเครื่อง…
Read More
How-to: ออกแบบ Edge Data Historian — จาก RAM Buffer ถึง Cloud Lakehouse โดยไม่ทำข้อมูลหาย

How-to: ออกแบบ Edge Data Historian — จาก RAM Buffer ถึง Cloud Lakehouse โดยไม่ทำข้อมูลหาย

Article
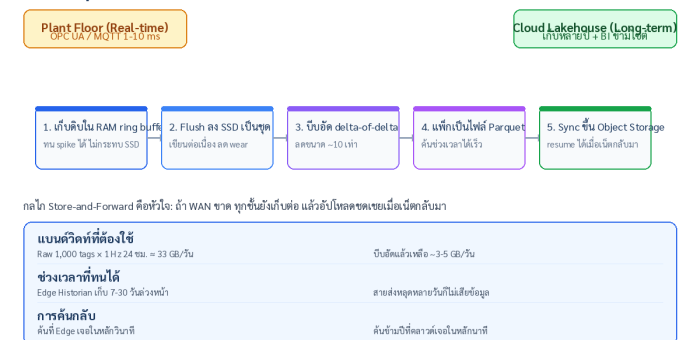
คำถามที่ดูเหมือนง่ายแต่เจ็บจริงของทุกโปรเจกต์ IIoT คือ "ข้อมูลที่เก็บมาทั้งหมดนี้ ตกลงจะเก็บไว้ที่ไหน และเก็บนานแค่ไหน?" — คำตอบที่ผิดนำไปสู่สองปลายทางเดียวกัน: ซื้อ storage ระดับ enterprise เกินจำเป็นจนงบบานปลาย หรือลบข้อมูลเก่าทิ้งแล้วเจอการตรวจสอบย้อนหลังหลังจากนั้นหกเดือน บทความนี้เดินไปทีละขั้นตามเส้นทางของข้อมูลหนึ่งจุดวัด ตั้งแต่หน้างานจนถึงคลาวด์ ขั้นที่ 1: ข้อมูลเกิดที่หน้างาน 1,000 ครั้งต่อวินาที เริ่มจากคณิตศาสตร์ง่าย ๆ: โรงงานขนาดกลางที่มี 1,000 tags × 1 Hz (เช่น อุณหภูมิ ความดัน รอบมอเตอร์) จะผลิตข้อมูลดิบประมาณ 86.4 ล้านจุดต่อวัน ถ้าเก็บเป็น JSON ตรง ๆ ขนาดจะบวมถึง ~33 GB ต่อวัน — นี่คือเหตุผลที่ทุก pipeline จริงจำเป็นต้องมีทั้งการกรองและการบีบอัดตั้งแต่ต้นทาง เส้นทางข้อมูลจาก Plant Floor ถึง Cloud Lakehouse — แต่ละขั้นมีหน้าที่ลดปริมาณและเพิ่มความทนทานต่อการขาดเน็ต (ที่มา: Honey Corporation) ขั้นที่ 2: RAM Ring Buffer — ด่านแรกที่ทุกคนมองข้าม เมื่อข้อมูลไหลเข้า edge gateway จุดแรกที่มันจอดไม่ใช่ดิสก์ แต่เป็น RAM ring buffer เหตุผลคือความเร็ว: การเขียน SSD ทุกครั้งที่ข้อมูลมาถึงจะทำให้ SSD สึกเร็วผิดปกติ (write amplification) และทำให้ระบบรับ spike ของข้อมูลไม่ไหว รูปแบบที่ใช้กันคือเก็บใน RAM ก่อน 30-120 วินาที แล้วค่อย flush เป็นชุด (batch) ลง SSD ขั้นที่ 3: บีบอัดด้วย Delta-of-Delta เทคนิคที่ทำให้ time-series ของโรงงานบีบได้มากกว่าที่คิดคือการเก็บ "ผลต่างของผลต่าง" (delta-of-delta encoding) — เพราะค่าอุณหภูมิส่วนใหญ่ไม่เปลี่ยนระหว่างการ sample สองครั้งติดกัน การเก็บเป็น "เท่ากับครั้งก่อน" ใช้พื้นที่น้อยกว่าเก็บค่าเต็มหลายเท่า ในทางปฏิบัติ pipeline ของโรงงานส่วนใหญ่บีบจาก 33 GB/วัน เหลือ ~3-5 GB/วัน ก่อนส่งขึ้นคลาวด์ ขั้นที่ 4: แพ็กเป็นไฟล์ Parquet แล้ว Sync ขึ้น Object…
Read More
Edge 3 ชั้นสำหรับโรงงาน IIoT: ออกแบบสถาปัตยกรรมตามลำดับชั้นหน่วงเวลา (Latency Hierarchy)

Edge 3 ชั้นสำหรับโรงงาน IIoT: ออกแบบสถาปัตยกรรมตามลำดับชั้นหน่วงเวลา (Latency Hierarchy)

Article
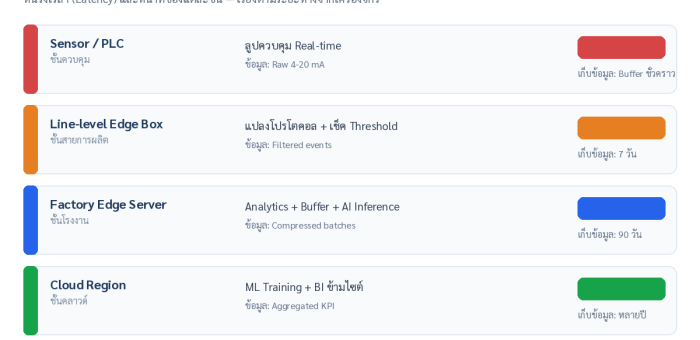
หลายโรงงานที่เริ่มทำ IIoT มักเจอคำถามเดียวกันในวันแรกของโปรเจกต์: "ข้อมูลควรส่งขึ้นคลาวด์ทั้งหมดเลย หรือเก็บไว้ประมวลผลในโรงงานก่อน?" คำตอบที่ถูกต้องในปี 2026 ไม่ใช่อย่างใดอย่างหนึ่ง — แต่คือการออกแบบสถาปัตยกรรมแบบหลายชั้น (Multi-tier) ที่ให้แต่ละงานวิ่งลงมาอยู่ใกล้แหล่งข้อมูลมากที่สุดเท่าที่ความจำเป็นของงานนั้นต้องการ แนวคิดนี้มีชื่อเรียกหลายชื่อ — Edge Continuum, Cloud Continuum หรือ Computing Continuum — แต่แก่นคือเรื่องเดียว: ลำดับชั้นของหน่วงเวลา (Latency Hierarchy) ที่กำหนดว่างานแบบไหนควรจบที่ไหน บันไดหน่วงเวลาแบบมาตราส่วน log — PLC ตอบที่ ~1 ms ส่วนคลาวด์ผ่าน WAN อยู่ที่ ~45 ms พร้อม jitter ที่สูงกว่ามาก (ที่มา: Honey Corporation) ลำดับชั้นหน่วงเวลา: งานไหนควรจบที่ชั้นไหน ลองนึกภาพข้อมูลจากเซ็นเซอร์อุณหภูมิตัวเดียวที่ถูก sample ทุก 100 ms ถ้าโรงงานมี 1,000 tags เท่ากัน จะมีข้อมูลดิบไหลเข้าระบบประมาณ 10,000 จุดต่อวินาที การส่งขึ้นคลาวด์ทั้งหมดไม่ใช่แค่เรื่องค่าแบนด์วิดท์ แต่คือการเพิ่มหน่วงเวลา 30-60 ms ให้กับทุกการตัดสินใจ ทั้งที่บางการตัดสินใจต้องการคำตอบใน 5 ms สถาปัตยกรรม Edge 3 ชั้น — ยิ่งอยู่ใกล้เครื่องจักร หน่วงเวลายิ่งต่ำ แต่ความสามารถเชิงคำนวณและระยะเก็บข้อมูลยิ่งจำกัด (ที่มา: Honey Corporation) ชั้นที่ 1: กล่อง Edge ระดับสายการผลิต (Line-level Edge Box) อุปกรณ์ขนาดเล็กที่ติดตั้งในตู้คอนโทรลของแต่ละสายการผลิต หน้าที่หลักคือการแปลงโปรโตคอล (เช่น Modbus TCP, PROFINET → OPC UA หรือ MQTT), กรองข้อมูลดิบให้เหลือเฉพาะ event ที่มีความหมาย และตรวจ threshold แบบ local หน่วงเวลาอยู่ในระดับ 1-5 ms ซึ่งเพียงพอสำหรับงาน monitoring แบบเรียลไทม์ที่ไม่ใช่ลูปควบคุม ชั้นที่ 2: Edge Server ระดับโรงงาน (Factory Edge Server) เซิร์ฟเวอร์ที่รวบข้อมูลจากทุก line-level box ในโรงงาน ทำหน้าที่หนักกว่า: aggregation, buffering ระยะ 7-90 วัน, และเป็นที่รัน AI…
Read More
บทวิเคราะห์: ตลาด Smart Manufacturing 2025–2030 — เมื่อเงินไหลจากฮาร์ดแวร์ไป AI

บทวิเคราะห์: ตลาด Smart Manufacturing 2025–2030 — เมื่อเงินไหลจากฮาร์ดแวร์ไป AI

Article
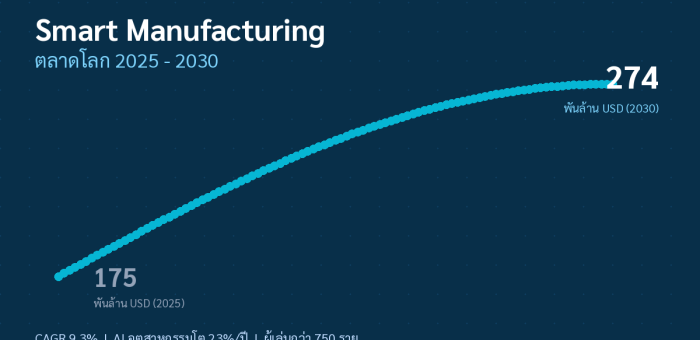
มุมมองจากงานแสดงสินค้า: เมื่อ "ป้าย Smart Factory" ไม่ใช่จุดขายอีกต่อไป ปลายเดือนตุลาคมที่ผ่านมา งาน Smart Manufacturing 2026 ที่กรุงเทพฯ ปิดฉากลงด้วยบรรยากาศที่ต่างจากทุกปีที่ผ่านมา — ทุกบูธพูดเรื่องเดียวกันแต่ต่างคนต่างพูด: AI ที่ลงมือทำงานได้จริงบนพื้นโรงงาน ไม่ใช่ AI ในสไลด์นำเสนอ ปรากฏการณ์นี้สอดคล้องกับข้อมูลตลาดล่าสุดจากรายงาน Industry 4.0 & Smart Manufacturing Market Report 2026–2030 ของ IoT Analytics ที่ระบุว่าตลาดเทคโนโลยีการผลิตอัจฉริยะทั่วโลกในปี 2025 มีมูลค่า 175 พันล้านดอลลาร์สหรัฐ และจะเติบโตเฉลี่ย 9.3% ต่อปี (CAGR) จนแตะ 274 พันล้านดอลลาร์ในปี 2030 โดยมีผู้เล่นในตลาดมากกว่า 750 ราย ตัวเลขนี้บอกอะไรมากกว่าที่เห็น เพราะเบื้องหลังอัตราการเติบโตที่ดู "เฉยๆ" คือการเปลี่ยนองค์ประกอบภายในตลาดอย่างรุนแรง — เงินกำลังไหลจากฮาร์ดแวร์ไปสู่ซอฟต์แวร์และ AI ผู้นำตลาด 10 อันดับแรกต่างเร่งเปลี่ยนตัวเองจากบริษัทขายเครื่องจักร ไปสู่สถาปัตยกรรมที่ขับเคลื่อนด้วยซอฟต์แวร์และผสาน AI (Software-defined, AI-infused architectures) ซึ่งเป็นการปรับตัวครั้งใหญ่ที่สุดของอุตสาหกรรมระบบอัตโนมัติตั้งแต่ยุค PLC ถือกำเนิด ตลาด Smart Manufacturing โลกเติบโตจาก 175 พันล้านดอลลาร์ (2025) สู่ 274 พันล้านดอลลาร์ (2030) ที่ CAGR 9.3% — ค่าเฉลี่ยที่ดูเรียบ แต่ซ่อนการเปลี่ยนโครงสร้างจากฮาร์ดแวร์สู่ซอฟต์แวร์และ AI (ที่มา: IoT Analytics, Industry 4.0 & Smart Manufacturing Market Report 2026–2030) 5 แรงกดดันที่ทำให้โรงงาน "ต้อง" ลงทุน ไม่ใช่ "อยาก" ลงทุน สิ่งที่น่าสนใจจากรายงานคือรายการแรงขับเคลื่อน — ไม่มีข้อไหนเป็นเรื่องเทคโนโลยีเลย ทั้งหมดเป็นแรงกดดันเชิงธุรกิจที่บีบให้ผู้ผลิตต้องลงมือ: ต้นทุนที่สูงขึ้นทุกด้าน: ค่าแรง พลังงาน และวัตถุดิบพุ่งพร้อมกัน เทคโนโลยีจึงกลายเป็นเครื่องมือเพิ่มประสิทธิภาพและลดความสูญเสีย ไม่ใช่ของตกแต่ง ภูมิรัฐศาสตร์และการย้ายฐานผลิต: กระแส Reshoring ผลักการผลิตกลับไปยังพื้นที่ต้นทุนสูง ระบบอัตโนมัติจึงเป็นคำตอบชดเชยแรงงานที่หายไป วิกฤตแรงงานเรื้อรัง: การขาดแคลนแรงงานทักษะและโครงสร้างประชากรที่สูงวัย บังคับให้เทคโนโลยีทำงานร่วมกับคนหรือทดแทนช่องว่าง โครงสร้างพื้นฐานที่พร้อมแล้วจริง: Edge Computing และ Cloud เสถียรพอที่การเชื่อม OT เข้ากับ IT ไม่ใช่โครงการเสี่ยงระเบิดเวลาอีกต่อไป…
Read More
CAN FD: Deep Dive จากเฟรม 8 ไบต์สู่ 64 ไบต์ — เมื่อบัสอายุ 40 ปีกลับมาเป็นทางเลือกของโรงงานยุค IIoT

CAN FD: Deep Dive จากเฟรม 8 ไบต์สู่ 64 ไบต์ — เมื่อบัสอายุ 40 ปีกลับมาเป็นทางเลือกของโรงงานยุค IIoT

Article
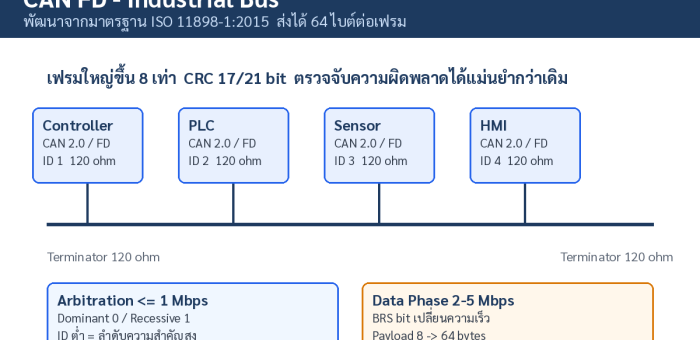
ในโลกที่ทุกคนพูดถึง 5G และ TSN บัสสายคู่อย่าง CAN ที่เกิดขึ้นมากว่า 40 ปีดูเหมือนจะเป็นของเก่า แต่ตัวเลขจากผู้ดูแลมาตรฐานอย่าง CAN in Automation (CiA) บอกเรื่องตรงกันข้าม — มีโหนด CAN ถูกติดตั้งใหม่หลายร้อยล้านตัวทุกปี เพราะมันถูก ทนทาน และพิสูจน์ตัวเองในสภาพแวดล้อมที่รุนแรงที่สุดของโรงงาน สิ่งที่ทำให้มาตรฐานนี้ยังมีชีวิตอยู่ในยุค IIoT คือการอัปเกรดครั้งสำคัญที่ชื่อว่า CAN FD (CAN with Flexible Data-rate) ซึ่งถูกบรรจุเข้ามาตรฐานสากล ISO 11898-1:2015 ปัญหาของ Classical CAN ที่ CAN FD มาแก้ Classical CAN ส่งข้อมูลได้สูงสุดแค่ 8 ไบต์ต่อเฟรม ที่ความเร็วไม่เกิน 1 Mbps ในอดีตที่ข้อมูลคือสถานะเปิด-ปิดของวาล์ว ก็เพียงพอ แต่เมื่อเซ็นเซอร์ยุคใหม่ส่งค่า waveform การสั่น หรือผลวิเคราะห์คุณภาพที่ยาวเป็นร้อยไบต์ ข้อมูลต้องถูกซอยข้ามหลายเฟรม ทำให้ latency สะสมและประสิทธิภาพบัสตกลง CAN FD แก้ด้วยสองจุดหลัก: ขยาย payload เป็น 64 ไบต์ และอนุญาตให้สลับความเร็วกลางเฟรมได้ผ่านบิต BRS — ช่วง arbitrate ใช้ 1 Mbps เพื่อรักษาความยาวสาย แล้วเร่งช่วงข้อมูลขึ้นไปได้ถึง 2–5 Mbps (งานวิจัยจาก CiA ระบุว่าสัดส่วน 1:8 ให้ throughput รวมเพิ่มราว 6 เท่า) โครงสร้างเฟรม Classical CAN เทียบกับ CAN FD — payload ขยายจาก 8 เป็น 64 ไบต์ พร้อมสลับความเร็วช่วงข้อมูลผ่านบิต BRS ตารางเปรียบเทียบแบบย่อ คุณสมบัติClassical CANCAN FD Payload ต่อเฟรมสูงสุด 8 ไบต์สูงสุด 64 ไบต์ ความเร็วช่วงข้อมูลคงที่ 1 Mbps2–5 Mbps (เปลี่ยนกลางเฟรมด้วย BRS) CRC15 bit17/21 bit + Stuff Bit Counter ระยะสายที่ 1 Mbpsราว 40…
Read More
Contextual AR: เมื่อแว่น AR รู้จักชิ้นส่วนเองด้วย AI Object Recognition — Deep Dive จาก SLAM ถึง Latency Budget ต่ำกว่า 20 ms

Contextual AR: เมื่อแว่น AR รู้จักชิ้นส่วนเองด้วย AI Object Recognition — Deep Dive จาก SLAM ถึง Latency Budget ต่ำกว่า 20 ms

Article
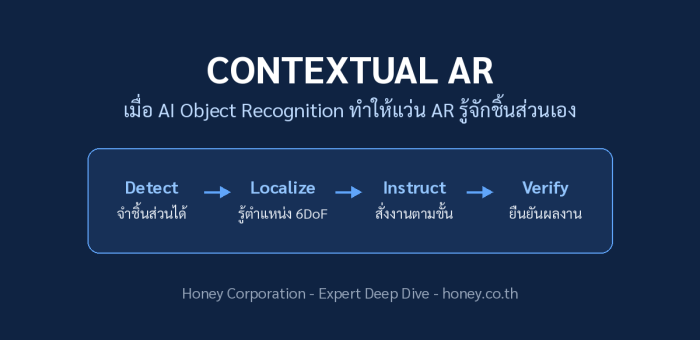
ระบบ AR Work Instructions รุ่นแรกๆ ทำงานได้ดีในห้อง Demo แต่มักล้มเหลวเมื่อลงสนามจริง สาเหตุหลักคือมัน ไม่รู้ว่ากำลังมองอะไร — ระบบต้องพึ่ง marker ที่ติดไว้ล่วงหน้า หรือแผนที่ 3 มิติที่ต้องสแกนไว้ก่อน พอเปลี่ยนไลน์ผลิต ย้ายเครื่องจักร หรือเปลี่ยนรุ่นชิ้นส่วน ทุกอย่างก็พังทันที Contextual AR คือรุ่นถัดไปของเทคโนโลยีนี้: แว่น Smart Glasses อุตสาหกรรมที่ฝังโมเดล AI Object Recognition บนชิป Edge NPU จะ จำชิ้นส่วนได้เอง เพียงชี้กล้องไปที่เครื่องจักร ระบบจะรู้ว่านี่คือปั๊มรุ่นไหน วาล์วตัวไหน แล้วดึงคำสั่งงานที่ถูกต้องจากระบบหลังบ้านมาฉายทับไว้บนจอทันที — โดยไม่ต้องติด marker แม้แต่ชิ้นเดียว หัวใจของระบบ: Pipeline 6 ขั้นตอนที่ต้องจบในเสี้ยววินาที ทุกอย่างเกิดขึ้นบนอุปกรณ์ ไม่ผ่านคลาวด์ เพราะเวลาไป-กลับของเน็ตเพียง 50-100 ms ก็ทำให้ภาพ Overlay 'ลอยหลุด' จากวัตถุจริงเวลาคนงานหันหัวเร็วๆ แล้ว Pipeline ของ Contextual AR ตั้งแต่กล้องจับภาพ 30 fps จนถึงการส่งผลไป CMMS ทุกขั้นต้องจบรวมกันภายใน Motion-to-Photon Latency ต่ำกว่า 20 ms ตัวเลขที่วิศวกรต้องจำคือ Motion-to-Photon Latency ต้องต่ำกว่า 20 ms — คือช่วงเวลาตั้งแต่หัวขยับจนภาพ Overlay เคลื่อนตาม ถ้าเกินกว่านี้สมองจะรู้สึกว่าภาพ 'เหลื่อม' จนใช้งานจริงไม่ได้ แปลว่า AI Inference ต้องกินเวลาไม่เกิน 15 ms เท่านั้น ซึ่งเป็นเหตุผลที่โมเดลตรวจจับวัตถุต้องผ่านการ Quantize เป็น INT8 และรันบน NPU ของอุปกรณ์เสมอ ขั้นตอนLatency BudgetหมายเหตุทางเทคนิคCamera Capture~5-10 msกล้องปล่อยเฟรม 30 fps ขึ้นไปPreprocess~2-3 msResize + Normalize บน GPU ของอุปกรณ์AI Inferenceต่ำกว่า 15 msโมเดล Quantized INT8 บน Edge NPUPose Estimation (6DoF)~2-5 msแปลง Bounding Box เป็นพิกัด 3 มิติRender Overlay~3-5…
Read More
Case Study: รวม 4 เครื่อง HMI/Edge เก่าให้เหลือ Edge Server เครื่องเดียวด้วย Type-1 Hypervisor

Case Study: รวม 4 เครื่อง HMI/Edge เก่าให้เหลือ Edge Server เครื่องเดียวด้วย Type-1 Hypervisor

Article
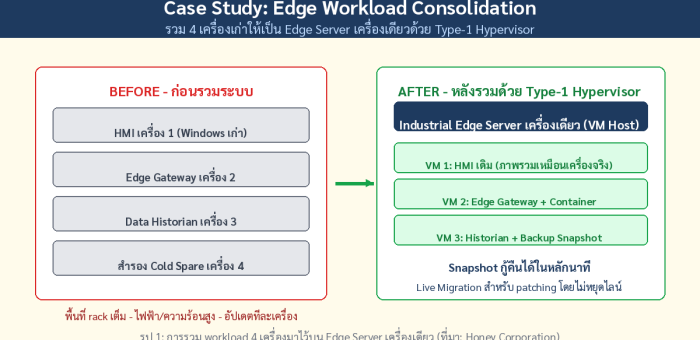
โรงงานประกอบชิ้นส่วนแห่งหนึ่งใน ร.น. มีปัญหาที่หลายโรงงานคุ้นเคย: ตู้คอนโทรลหน้าไลน์ผลิตมีคอมพิวเตอร์ถึง 4 เครื่อง — เครื่อง HMI ที่รัน Windows เวอร์ชันเก่าพร้อมโปรแกรมที่ vendor เดิมไม่มีมา update แล้ว, เครื่อง Edge Gateway เก็บข้อมูลเครื่องจักร, เครื่อง Data Historian และ Cold Spare อีกหนึ่งเครื่อง เครื่องไหนพังก็สลับเครื่อง การอัปเดต security patch ต้องทำทีละเครื่อง และเมื่อ HMI หลักเสียครั้งล่าสุด ทีม IT ใช้เวลากว่า 2 วันเต็มกว่าจะติดตั้งระบบกลับมาเหมือนเดิม บทความนี้เล่าว่าการรวมทั้งหมดมาไว้บน Edge Server เครื่องเดียวด้วย Type-1 Hypervisor เปลี่ยนสถานการณ์นี้อย่างไร รูป 1: การรวม workload จาก 4 เครื่องมาไว้บน Edge Server เครื่องเดียว (ที่มา: Honey Corporation) ปัญหา (Problem) เวลากู้คืนยาว: HMI พัง = ติดตั้ง OS + โปรแกรม + restore config ใหม่ทั้งหมด ใช้เวลา 2-3 วัน ระหว่างนั้น operator ดูค่าหน้าเครื่องไม่ได้ ภาระดูแล 4 เท่า: patch 4 เครื่อง 4 รอบ บางเครื่อง OS เก่าจนหา driver ยาก ทรัพยากรกระจาย: rack หน้าไลน์เต็ม ค่าไฟ ความร้อนสะสม และไม่มีสำรองที่ sync กันจริง ทางแก้ (Solution): Type-1 Hypervisor บน Edge Server เครื่องเดียว หัวใจของทางแก้คือการเลือก Type-1 (bare-metal) Hypervisor คือซอฟต์แวร์เสมือนมิได้รัน "บน" Windows หรือ Linux แต่รันบนฮาร์ดแวร์โดยตรง แล้วจำลองเครื่องเสมือน (VM) หลายเครื่องที่แยกกันสนิท การแบ่ง Type-1 กับ Type-2 (hosted) นี้มีมาตั้งแต่งานวิจัยคลาสสิกของ Goldberg ปี…
Read More
eBPF ที่ Edge ของโรงงาน: Observability และ Security ระดับ Kernel ที่ Agent แบบเดิมทำไม่ได้

eBPF ที่ Edge ของโรงงาน: Observability และ Security ระดับ Kernel ที่ Agent แบบเดิมทำไม่ได้

Article
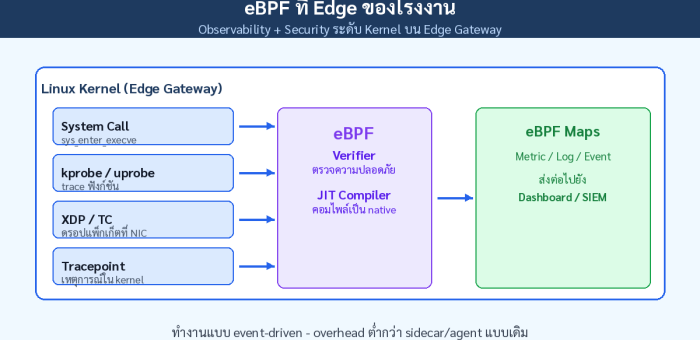
ถ้าคุณดูแล Edge Gateway ที่รัน Linux อยู่หน้าโรงงาน น่าจะคุ้นเคยกับภาพนี้: เครื่องหนึ่งต้องลง agent เก็บ metric อีกตัวเก็บ log อีกตัวเฝ้า security และอีกตัวดักจับ network — แต่ละตัวกิน CPU กันคนละเปอร์เซ็นต์ และต้องอัปเดตแยกกันคนละรอบ คำถามที่วงการ infrastructure เริ่มตอบด้วยเทคโนโลยีเดียวคือ eBPF (extended Berkeley Packet Filter) เทคโนโลย์จาก Linux kernel ที่ให้โปรแกรมขนาดเล็ก "รันอยู่ใน kernel" เพื่อเก็บข้อมูลและบังคับใช้นโยบายความปลอดภัยได้โดยตรง รูป 1: สถาปัตยกรรม eBPF บน Edge Gateway — hook รับเหตุการณ์ ผ่าน verifier และ JIT compiler แล้วส่งข้อมูลผ่าน maps (ที่มา: Honey Corporation) eBPF คืออะไร และทำไมมันปลอดภัยพอให้ใช้ในโรงงาน eBPF พัฒนาต่อจาก Berkeley Packet Filter เดิมที่ทำหน้าที่กรองแพ็กเก็ตเท่านั้น ปัจจุบันเป็นกลไกที่ให้โปรแกรม sandbox ทำงานในบริบท privileged ของ kernel โดยไม่ต้องแก้ source code ของ kernel หรือโหลด kernel module ตัวหลักที่ทำให้เราวางใจได้คือ Verifier ซึ่งตรวจทุกเส้นทางการทำงานของโปรแกรมก่อนรันจริง ว่าไม่มีการเข้าถึงหน่วยความจำนอกเขต ไม่วนลูปไม่รู้จบ และจบการทำงานภายในขีดจำกัดที่กำหนด จากนั้น JIT compiler จะคอมไพล์โปรแกรมให้เป็น machine code ที่ทำงานเร็วเทียบ native การทำงานเป็นแบบ event-driven: โปรแกรม eBPF จะถูกเรียกเมื่อเกิดเหตุการณ์ที่ "hook point" เช่น การเรียก system call, การเข้า-ออกฟังก์ชันใน kernel (kprobe) หรือแม้แต่ฟังก์ชันในแอปพลิเคชันเราเอง (uprobe) และเหตุการณ์ network ระดับ NIC ผ่าน XDP รูป 2: 4 กลุ่ม hook หลักที่ใช้ได้บน Edge Gateway ที่รัน Linux (ที่มา: eBPF.io documentation, Honey…
Read More
Case Study: หุ่นยนต์ 400,000 ตัวที่ “เรียนงานจากช่างฝีมือ” — Embodied Learning, งบปรับปรุงโรงงาน 6,400 ล้านดอลลาร์ต่อปี และสัญญาณ Physical AI จากดีล M&A 675 ล้านดอลลาร์

Case Study: หุ่นยนต์ 400,000 ตัวที่ “เรียนงานจากช่างฝีมือ” — Embodied Learning, งบปรับปรุงโรงงาน 6,400 ล้านดอลลาร์ต่อปี และสัญญาณ Physical AI จากดีล M&A 675 ล้านดอลลาร์

Article
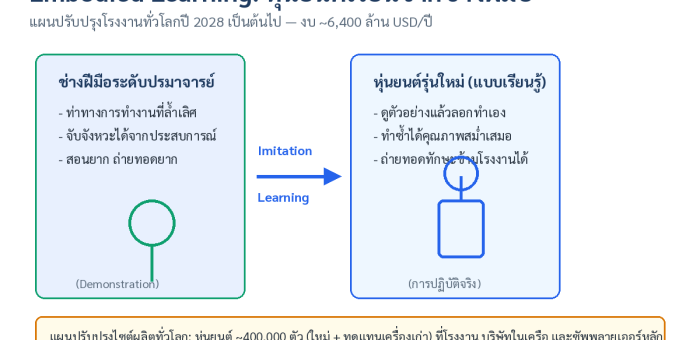
ข่าวใหญ่ปลายไตรมาส 3/2026 จากผู้ผลิตรถยนต์รายใหญ่ที่สุดของญี่ปุ่นให้สัญญาณที่โรงงานทั่วโลกต้องอ่านให้ขาด: ตั้งแต่ปี 2028 บริษัทจะลงทุนประมาณ 6,400 ล้านดอลลาร์ต่อปี ปรับปรุงไซต์ผลิตทั่วโลก พร้อมส่งหุ่นยนต์ราว 400,000 ตัว (ทั้งเครื่องใหม่และทดแทนเครื่องเก่า) ลงโรงงาน บริษัทในเครือ และซัพพลายเออร์หลัก — และหัวใจของแผนนี้ไม่ใช่ความเร็วหุ่นยนต์ แต่คือวิธีที่มัน "เรียนรู้" Embodied Learning: ช่างฝีมือระดับปรมาจารย์สาธิต (Demonstration) → หุ่นยนต์เรียนและลอกแบบท่าทางผ่าน Imitation Learning (ที่มา: เรียบเรียงจากงานนักลงทุน ก.ย. 2026 รายงานโดยสื่อการเงินระดับโลก) Problem: ทักษะปรมาจารย์ที่ถ่ายทอดไม่ได้ ในโรงงานการผลิตทุกแห่ง ทักษะของช่างฝีมืออาวุโสคือ "ทรัพย์สินที่หายไปเมื่อคนเกษียณ" งานประจำ เช่น การประกอบชิ้นส่วนที่ต้องอาศัยจังหวะ แรงบิด และความรู้สึกที่สั่งสมมาหลายสิบปี ถ่ายทอดด้วยเอกสารไม่ได้ หุ่นยนต์อุตสาหกรรมแบบดั้งเดิมจึงทำงานเหล่านี้แทนไม่ได้ เพราะต้องโปรแกรมทุกท่าทางล่วงหน้าแบบตายตัว ขณะที่ปัญหาขาดแรงงานฝีมือของไทยกำลังรุนแรงขึ้นทุกปี Solution: หุ่นยนต์ที่เรียนโดย "ดูตัวอย่าง" ในงานนักลงทุนเมื่อเดือนกันยายน ที่ศูนย์บริหารภูมิภาคยุโรป บริษัทได้สาธิตหุ่นยนต์ตัวใหม่ที่พัฒนาเองภายในองค์กร โดยมีชื่อย่อมาจากแนวคิด "Embodied Learning robot for Enhanced Yield" — หุ่นยนต์ขนาดเล็กกว่าหุ่นยนต์อุตสาหกรรมทั่วไป ที่เรียนรู้งานจากการดูช่างฝีมือทำจริงแล้วลอกแบบ (Imitation Learning) แทนการโปรแกรมทีละท่า แนวทางนี้เปลี่ยนเกมเพราะ: เวลาตั้งค่างานใหม่สั้นลงมาก — สาธิตไม่กี่ครั้ง หุ่นยนต์ก็เริ่มทำงานได้ แทนการโปรแกรมหลายวัน ทักษะถ่ายทอดได้ทั่วทั้งกลุ่มบริษัทและซัพพลายเออร์ — 400,000 ตัวหมายถึงเครือข่ายที่แชร์บทเรียนร่วมกัน ออกแบบมาเพื่ออยู่ร่วมกับคน (Coexist) — ไม่ใช่กรงขังเหล็กแบบหุ่นยนต์ดั้งเดิม สัญญาณยืนยันจากตลาด M&A: Physical AI กำลังถูกซื้อ ไม่กี่สัปดาห์ก่อนหน้า ยักษ์ใหญ่ด้านระบบออโตเมชันและเซ็นเซอร์ของญี่ปุ่นประกาศเข้าซื้อบริษัทผู้ผลิตคอมพิวเตอร์อุตสาหกรรมสัญชาติอเมริกันในราคา 675 ล้านดอลลาร์ (คาดปิดดีลต้นปี 2027) เป้าหมายชัดเจน: หลอมรวมเซ็นเซอร์+ระบบควบคุม+หุ่นยนต์ เข้ากับพลังการประมวลผลหน้างาน เพื่อสร้าง Physical AI — ระบบที่ประมวลผลข้อมูลมหาศาลจากเซ็นเซอร์ได้ทันที "หน้างาน" แบบ Real-time แทนการรอส่งขึ้นคลาวด์ เช่นระบบตรวจคุณภาพอัตโนมัติที่พบชิ้นงานผิดมาตรฐานแล้วสั่งปรับกระบวนการได้ทันทีแบบไร้รอยต่อ (Closed-loop Manufacturing) สถาปัตยกรรม 4 ชั้นของ Physical AI บนสายการผลิต: รับรู้ → คำนวณหน้างาน → ตัดสินใจ → ปรับเครื่องจักรจริง (ที่มา: เรียบเรียงจาก metrology.news) Results และสิ่งที่โรงงานไทยควรทำตอนนี้ สัญญาณจากข่าว ความหมายต่อโรงงานไทย งบปรับปรุงไซต์ผลิต 6,400 ล้านดอลลาร์/ปี เริ่มปี…
Read More
Multimodal Sensor Fusion: ลดจุดบอดของ Predictive Maintenance ด้วยการผสาน Vibration + Acoustic + Thermal + SCADA

Multimodal Sensor Fusion: ลดจุดบอดของ Predictive Maintenance ด้วยการผสาน Vibration + Acoustic + Thermal + SCADA

Article
หลายโรงงานที่เริ่มทำ Predictive Maintenance (PdM) มักเริ่มจากสิ่งที่ง่ายที่สุด: ติดเซ็นเซอร์วัดการสั่น (Vibration) ที่มอเตอร์หรือลูกปืน แล้วปล่อยให้ AI ทำนายว่าเครื่องจักรจะพังเมื่อไหร่ แนวทางนี้ได้ผลจริง แต่งานวิจัยช่วง 2025-2026 เริ่มชี้ชัดว่า โมเดลที่ฟัง "เสียงเดียว" กำลังถึงเพดานความแม่นยำ โดยเฉพาะเมื่อระบบผลิตมีหลายโหลด หลายความเร็ว และความผิดปกติหลายชนิดเกิดพร้อมกัน บทความนี้ถอดประสบการณ์จากงานวิจัยล่าสุดด้าน Multimodal Sensor Fusion — การผสานข้อมูลจากหลายเซ็นเซอร์หลายประเภทเข้าสู่โมเดลเดียว — พร้อมตัวเลขเปรียบเทียบว่าการเพิ่มแต่ละ modality ซื้อความแม่นยำเพิ่มได้เท่าไร และโรงงานไทยควรเริ่มจากตรงไหน ทำไม Single-Modality ไม่พอแล้ว: ตัวเลขจากงานวิจัย งานวิจัยปี 2026 ด้าน condition monitoring ลูกปืนกังหันลม (ตีพิมพ์ใน Journal of Electrical Systems ปลายเดือนมกราคม 2026) ได้ทำสิ่งที่โรงงานส่วนใหญ่ยังไม่เคยทำ: การเปรียบเทียบแบบ Ablation Study — ถอด modality ออกทีละตัวเพื่อวัดว่าแต่ละเซ็นเซอร์ "ซื้อ" ความแม่นยำเพิ่มเท่าไร ผลลัพธ์สรุปได้ตามตารางนี้ ชุดข้อมูลที่ใช้เทรนF1-Scoreสิ่งที่ได้เพิ่ม เฉพาะข้อมูล SCADA (โหลด อุณหภูมิ ความเร็ว)84.5%บริบทการทำงาน แต่ไม่เห็นตัวความเสียหาย เฉพาะ Acoustic Emission (คลื่นเสียงความถี่สูง)89.2%เห็นรอยร้าวเริ่มต้นก่อนใคร เฉพาะ Vibration92.8%มาตรฐานเดิมของ PdM Vibration + SCADA94.1%แยกโหลดหนักออกจากความเสียหายได้ Vibration + Acoustic Emission96.3%Synergy เกินผลรวมของแต่ละตัว ทั้ง 4 modality (Vib+AE+Temp+SCADA)98.9%สูงสุด ทนทานต่อทุกสภาวะโหลด จุดที่น่าสนใจที่สุดคือแถว Vibration + AE ที่ได้ 96.3% — สูงกว่าผลรวมเดี่ยวของทั้งสองตัวบวกกันแล้วหารสอง นั่นคือ ความเสริมแรงกัน (Complementarity): Vibration เก่งจับ "การสั่นพ้องเชิงโครงสร้าง" จากความเสียหายที่ลุกลามแล้ว ขณะที่ AE ไวต่อคลื่นความเค้นความถี่สูงที่เกิดตอนรอยร้าว เพิ่งเริ่มก่อตัว — ทำให้ระบบเห็นสัญญาณตั้งแต่ระยะ Incipient Fault ที่ Vibration ยังเงียบ สถาปัตยกรรมที่ใช้: CNN-LSTM Hybrid บน Edge โมเดลในงานวิจัยนี้ไม่ใช่โมเดลมหึมา แต่เป็นสถาปัตยกรรมผสม 1D-CNN + LSTM ที่ออกแบบให้ลง Edge Computing Platform ใน nacelle กังหันลมได้จริง…
Read More