How-to: เตรียมข้อมูลเครื่องจักรให้พร้อมสำหรับ Industrial AI ใน 6 ขั้นตอน — ก่อน AI ต้องมีข้อมูล

How-to: เตรียมข้อมูลเครื่องจักรให้พร้อมสำหรับ Industrial AI ใน 6 ขั้นตอน — ก่อน AI ต้องมีข้อมูล

Article
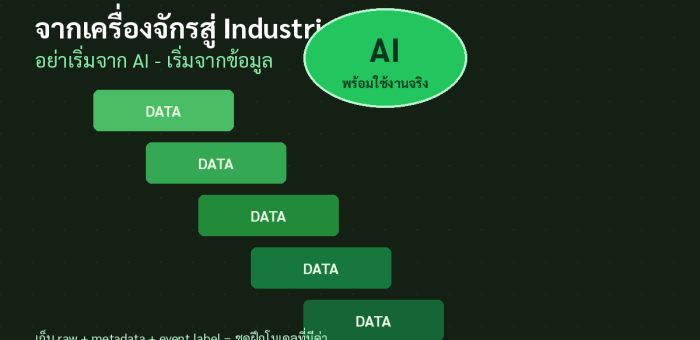
ทำไมโครงการ AI ในโรงงานถึงตายก่อนถึงไลน์ผลิต คำถามที่เราได้ยินบ่อยที่สุดจากผู้บริหารโรงงานช่วงหลังนี้คือ "อยากใช้ AI ในโรงงาน แต่ควรเริ่มจากตรงไหน" — และคำตอบที่หลายคนไม่อยากได้ยินคือ อย่าเริ่มจาก AI เริ่มจากข้อมูล รายงานล่าสุดของ IoT Analytics ระบุว่าตลาด Industrial AI จะเติบโตจาก 43.6 พันล้านดอลลาร์ (2024) สู่ 153.9 พันล้านดอลลาร์ในปี 2030 ที่ CAGR 23% แต่ปัจจุบันการใช้จ่าย AI ในภาคผลิตยังคิดเป็นเพียง 0.1% ของรายได้ สาเหตุใหญ่ไม่ใช่ AI ไม่เก่งพอ แต่คือโรงงานส่วนใหญ่ยังไม่มีข้อมูลที่ "ใช้เพื่อฝึกและใช้งาน AI ได้จริง" งานนำร่อง AI ที่ล้มเหลวมักมีร่องรอยเดียวกัน: ทีมพัฒนาได้รับไฟล์ Excel ที่ส่งออกจาก SCADA ทีละเดือน ข้อมูลขาดหายเป็นช่วงๆ เซ็นเซอร์บางตัวเซ็นสเกลผิด ไม่มีใครรู้ว่าหน่วยเป็นอะไร และไม่มีเหตุการณ์ปัญหาที่ติดแท็กไว้ให้โมเดลเรียนรู้ โมเดลที่ดีที่สุดก็ช่วยไม่ได้เมื่อข้อมูลตั้งต้นเป็นเช่นนั้น — นี่คือเหตุผลที่คู่มือนี้มุ่งเน้นเรื่องเดียว: วางรากฐานข้อมูลให้ถูกต้องก่อน AI ลงมือ เส้นทาง 6 ขั้นตอนจากเครื่องจักรถึง Industrial AI — งาน 70% อยู่ใน 3 ขั้นตอนแรกที่ไม่มีใครเห็น ไม่ใช่ตัวโมเดล (ที่มา: สังเคราะห์โดย Honey Corporation) ขั้นที่ 1–2: คัดเลือก Use Case ที่คุ้มค่า แล้วสำรวจข้อมูลที่มีอยู่จริง ขั้นที่ 1 — เลือก use case จากความเจ็บปวดทางธุรกิจ ไม่ใช่จากเทคโนโลยี: จงนึกถึงปัญหาที่เกิดซ้ำและแพงที่สุด เช่น เครื่องจักรหลักเสียกะทันหัน ของเสียจากกระบวนการอบ หรือการเปลี่ยนได้ช้ากว่าแผน ให้เลือก 1 ปัญหาที่มีเหตุการณ์เกิดขึ้นอย่างน้อยเดือนละ 2–3 ครั้ง เพราะโมเดลต้องการตัวอย่างเหตุการณ์พอสมควร จากนั้นคำนวณค่าใช้จ่ายที่เกิดจริงต่อเหตุการณ์ (ค่าหยุดไลน์ ค่าของเสีย) เพื่อเป็นตัวชี้วัดว่าโครงการจะคุ้มหรือไม่ ขั้นที่ 2 — ทำ Data Audit อย่างซื่อสัตย์: ระบุว่าปัจจุบันมีสัญญาณใดบ้างที่เก็บแล้วจริง เก็บที่ไหน (SCADA, Historian, PLC, กระดาษบันทึก) ความถี่เท่าไร และอยู่ได้นานแค่ไหน ตารางด้านล่างคือเกณฑ์เบื้องต้นที่ใช้ประเมินความพร้อมของแต่ละสัญญาณ: ระดับความพร้อมสภาพข้อมูลจริงสิ่งที่ต้องทำต่อ ระดับ 0 — กระดาษบันทึกยามเขียนมือทุก 2 ชั่วโมง สแกนเก็บเป็น…
Read More
บทวิเคราะห์: ตลาด Smart Manufacturing 2025–2030 — เมื่อเงินไหลจากฮาร์ดแวร์ไป AI

บทวิเคราะห์: ตลาด Smart Manufacturing 2025–2030 — เมื่อเงินไหลจากฮาร์ดแวร์ไป AI

Article
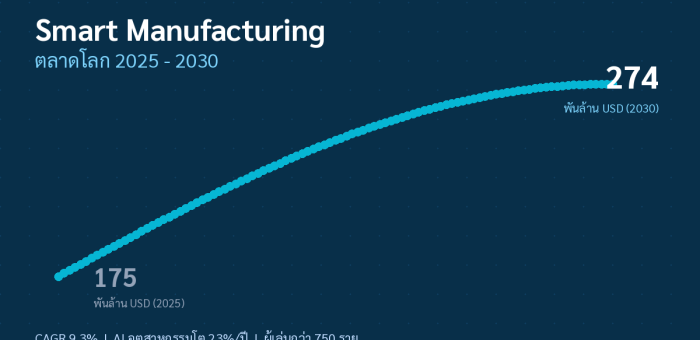
มุมมองจากงานแสดงสินค้า: เมื่อ "ป้าย Smart Factory" ไม่ใช่จุดขายอีกต่อไป ปลายเดือนตุลาคมที่ผ่านมา งาน Smart Manufacturing 2026 ที่กรุงเทพฯ ปิดฉากลงด้วยบรรยากาศที่ต่างจากทุกปีที่ผ่านมา — ทุกบูธพูดเรื่องเดียวกันแต่ต่างคนต่างพูด: AI ที่ลงมือทำงานได้จริงบนพื้นโรงงาน ไม่ใช่ AI ในสไลด์นำเสนอ ปรากฏการณ์นี้สอดคล้องกับข้อมูลตลาดล่าสุดจากรายงาน Industry 4.0 & Smart Manufacturing Market Report 2026–2030 ของ IoT Analytics ที่ระบุว่าตลาดเทคโนโลยีการผลิตอัจฉริยะทั่วโลกในปี 2025 มีมูลค่า 175 พันล้านดอลลาร์สหรัฐ และจะเติบโตเฉลี่ย 9.3% ต่อปี (CAGR) จนแตะ 274 พันล้านดอลลาร์ในปี 2030 โดยมีผู้เล่นในตลาดมากกว่า 750 ราย ตัวเลขนี้บอกอะไรมากกว่าที่เห็น เพราะเบื้องหลังอัตราการเติบโตที่ดู "เฉยๆ" คือการเปลี่ยนองค์ประกอบภายในตลาดอย่างรุนแรง — เงินกำลังไหลจากฮาร์ดแวร์ไปสู่ซอฟต์แวร์และ AI ผู้นำตลาด 10 อันดับแรกต่างเร่งเปลี่ยนตัวเองจากบริษัทขายเครื่องจักร ไปสู่สถาปัตยกรรมที่ขับเคลื่อนด้วยซอฟต์แวร์และผสาน AI (Software-defined, AI-infused architectures) ซึ่งเป็นการปรับตัวครั้งใหญ่ที่สุดของอุตสาหกรรมระบบอัตโนมัติตั้งแต่ยุค PLC ถือกำเนิด ตลาด Smart Manufacturing โลกเติบโตจาก 175 พันล้านดอลลาร์ (2025) สู่ 274 พันล้านดอลลาร์ (2030) ที่ CAGR 9.3% — ค่าเฉลี่ยที่ดูเรียบ แต่ซ่อนการเปลี่ยนโครงสร้างจากฮาร์ดแวร์สู่ซอฟต์แวร์และ AI (ที่มา: IoT Analytics, Industry 4.0 & Smart Manufacturing Market Report 2026–2030) 5 แรงกดดันที่ทำให้โรงงาน "ต้อง" ลงทุน ไม่ใช่ "อยาก" ลงทุน สิ่งที่น่าสนใจจากรายงานคือรายการแรงขับเคลื่อน — ไม่มีข้อไหนเป็นเรื่องเทคโนโลยีเลย ทั้งหมดเป็นแรงกดดันเชิงธุรกิจที่บีบให้ผู้ผลิตต้องลงมือ: ต้นทุนที่สูงขึ้นทุกด้าน: ค่าแรง พลังงาน และวัตถุดิบพุ่งพร้อมกัน เทคโนโลยีจึงกลายเป็นเครื่องมือเพิ่มประสิทธิภาพและลดความสูญเสีย ไม่ใช่ของตกแต่ง ภูมิรัฐศาสตร์และการย้ายฐานผลิต: กระแส Reshoring ผลักการผลิตกลับไปยังพื้นที่ต้นทุนสูง ระบบอัตโนมัติจึงเป็นคำตอบชดเชยแรงงานที่หายไป วิกฤตแรงงานเรื้อรัง: การขาดแคลนแรงงานทักษะและโครงสร้างประชากรที่สูงวัย บังคับให้เทคโนโลยีทำงานร่วมกับคนหรือทดแทนช่องว่าง โครงสร้างพื้นฐานที่พร้อมแล้วจริง: Edge Computing และ Cloud เสถียรพอที่การเชื่อม OT เข้ากับ IT ไม่ใช่โครงการเสี่ยงระเบิดเวลาอีกต่อไป…
Read More
บทวิเคราะห์: Graph Neural Network — เมื่อ AI เริ่มอ่านโรงงานเป็น “โครงข่าย” ไม่ใช่ตารางตัวเลข

บทวิเคราะห์: Graph Neural Network — เมื่อ AI เริ่มอ่านโรงงานเป็น “โครงข่าย” ไม่ใช่ตารางตัวเลข

Article
เมื่อพูดถึง AI ในโรงงาน ภาพที่เข้ามาในหัวส่วนใหญ่คือกล้องตรวจคุณภาพหรือโมเดลทำนายจากข้อมูลชุดหนึ่ง แต่มีคลาสของปัญหาที่โมเดลแบบ "หนึ่งแถวข้อมูล หนึ่งคำทำนาย" จัดการได้ยากโดยธรรมชาติ: ความผิดปกติของกระบวนการผลิตทั้งระบบ ที่เซ็นเซอร์หลายสิบตัวในหน่วยผลิตต่างๆ เชื่อมโยงกันผ่านท่อ วาล์ว และลำดับขั้นของกระบวนการเคมี Graph Neural Network (GNN) คือคำตอบที่งานวิจัยปี 2026 ชี้ชัดแล้วว่าเป็นทิศทางหลักของงาน fault diagnosis ยุคใหม่ — บทวิเคราะห์นี้ถอดประเด็นว่าทำไม และโรงงานไทยควรมองไว้ตั้งแต่ตอนนี้ ข้อมูลโรงงานไม่ใช่ตาราง — มันคือกราฟ ภาพที่ 1: มุมมองเดียวกัน สองแบบ — ตารางแบนราบมองไม่เห็นความสัมพันธ์ กราฟเห็น topology ของทั้งกระบวนการ โมเดล time-series ทั่วไป (LSTM, Transformer) ประมวลผลข้อมูลของแต่ละจุดวัดเป็นอิสระหรือรวมทั้งหมดเป็นเวกเตอร์เดียว แต่ความผิดปกติในโรงงานเคมี/กระบวนการต่อเนื่องมักปรากฏเป็น "รูปแบบเชิงพื้นที่" — อุณหภูมิ reactor เพี้ยนเล็กน้อย ทำให้ pressure ขาลงระบายตามมา แล้วระดับใน stripper สั่นในอีก 15 นาทีถัดมา ความสัมพันธ์แบบนี้ฝังอยู่ใน topology ของ process ซึ่ง GNN เข้าถึงได้โดยตรงผ่านการสร้าง graph จาก P&ID (แผนผังท่อและเครื่องมือวัด) หรือ Pearson correlation ระหว่างตัวแปร หัวใจคือ Message Passing ภาพที่ 2: Message Passing — แต่ละโหนดรับข้อมูลจากเพื่อนบ้าน รวมเป็น representation ใหม่ แล้วทำนายร่วมกัน GNN ทำงานเป็นรอบ (layer) แต่ละรอบ โหนดหนึ่งๆ — ไม่ว่าจะแทนเซ็นเซอร์ อุปกรณ์ หรือหน่วยผลิต — จะรวบรวม feature จากโหนดที่เชื่อมต่อโดยตรง (aggregate ด้วย sum/mean/max) แล้วอัปเดต representation ของตัวเอง ยิ่งหลาย layer ข้อมูลยิ่งเดินทางไกลขึ้นในกราฟ โหนดปั๊มจึง "รับรู้" สภาพของ reactor ที่อยู่ห่างออกไปสองขั้นโดยไม่ต้องอาศัย feature engineering แบบ manual ผลที่ตามมามีสองด้านที่สำคัญกับโรงงาน: แม่นขึ้น เพราะ fault ที่เกิดจริงมักส่งผลต่อเพื่อนบ้านหลายตัวพร้อมกัน โมเดลที่เห็นความสัมพันธ์นี้จะแยก "fault จริง" ออกจาก "เซ็นเซอร์ตัวเดียวเพี้ยน" ได้ และ ตีความได้…
Read More
How-to: Transfer Learning ข้ามเครื่องจักร — เริ่ม Predictive Maintenance ด้วย Fault จริงแค่ 20-50 ตัวอย่าง

How-to: Transfer Learning ข้ามเครื่องจักร — เริ่ม Predictive Maintenance ด้วย Fault จริงแค่ 20-50 ตัวอย่าง

Article
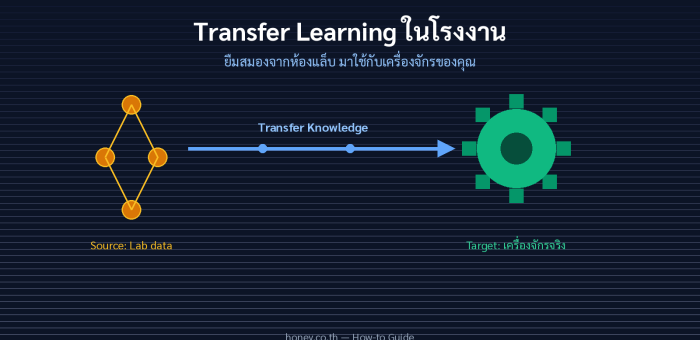
คำถามที่ทีมวิศวกรของเราเจอบ่อยที่สุดจากโรงงานที่อยากเริ่ม Predictive Maintenance คือ "โมเดลเราต้องการข้อมูล fault ของเครื่องจักรตัวนี้กี่ตัวอย่าง กว่าจะใช้งานได้จริง?" คำตอบตรงๆ คือหลายพันตัวอย่าง — จำนวนที่โรงงานส่วนใหญ่ไม่มีทางรอให้เกิดขึ้นเองโดยไม่เจอ breakdown ก่อน Transfer Learning คือทางออกที่ถูกที่สุดและงานวิจัยล่าสุดยืนยันแล้วว่า ยืมความรู้จากข้อมูลสาธารณะมาใช้กับเครื่องจักรจริงได้ ด้วยตัวอย่างเพียง 20-50 ตัวอย่าง หลักการ: Source Domain → Target Domain ภาพที่ 1: แนวคิด Transfer Learning ข้ามเครื่องจักร — freeze ชั้นพื้นฐาน เทรนเฉพาะชั้นท้ายด้วยข้อมูลจริงจำนวนน้อย แนวคิดคือการแยกโมเดลเป็นสองส่วน: ชั้น feature extractor (คอนโวลิวชัน) ที่เรียนรู้ลักษณะพื้นฐานของสัญญาณแรงสั่น — harmonic ของ BPFO/BPFI, รูปแบบ modulation เมื่อแบริ่งเสียหาย ซึ่งเหมือนกันข้ามเครื่องจักรไม่ว่าจะเป็นปั๊มหรือมอเตอร์ กับ ชั้น classifier ปลายทางที่จำเพาะกับเครื่องจักรแต่ละตัว เราจึง pre-train ทั้งหมดบนชุดข้อมูลสาธารณะ แล้ว freeze ชั้นแรกไว้ ปรับแต่งเฉพาะชั้นท้าย งานวิจัยใน Scientific Reports (2025) พิสูจน์แนวทางนี้บนงานจริง: ทีมวิจัยสร้าง Siamese-WDCNN จากชุดข้อมูล CWRU แล้วโอนย้ายไปยัง hydrodynamic transmission testbed กำลังสูง — อุปกรณ์ที่มีโครงสร้างและลักษณะสัญญาณต่างจากแบริ่งทดสอบในแล็บอย่างมาก ผลคือ FSL+TL ทำได้ 85.30% บนสภาวะผสม และเมื่อเติม attention mechanism ขึ้นเป็น 88.75% เทียบกับ WDCNN เดี่ยวๆ ที่ตกไปอยู่ระดับ 70% ต้นๆ 5 ขั้นตอนนำไปใช้จริงในโรงงาน ภาพที่ 2: กระบวนการ 5 ขั้นตอน — ขั้นที่ 4 (ตรวจ negative transfer) คือขั้นที่มักถูกข้ามและทำให้โครงการล้ม ขั้นที่ 1: เก็บสัญญาณ baseline ให้ถูกวิธี ก่อนคุยเรื่อง AI ต้องมีข้อมูลที่เปรียบเทียบได้ก่อน ติดเซ็นเซอร์แรงสั่น 3 แกนที่จุดวัดตามมาตรฐาน ISO 20816 (ผิวแบน สะอาด ใกล้ bearing load zone) พร้อมไมโครโฟนหรือ acoustic sensor…
Read More
Synthetic Data บำลุยข้อมูลตำหนิขาดแคลน: สร้างภาพ Defect ด้วย Diffusion Model เพื่อเทรน AI ตรวจคุณภาพ

Synthetic Data บำลุยข้อมูลตำหนิขาดแคลน: สร้างภาพ Defect ด้วย Diffusion Model เพื่อเทรน AI ตรวจคุณภาพ

Article
โจทย์คลาสสิกของ AI ตรวจคุณภาพในโรงงานคือ "ของเสียไม่พอเทรน" — ระบบที่ผลิตชิ้นงานถูกต้อง 99.5% จะมีตำหนิให้เก็บภาพเพียง 5 ภาพต่อพันชิ้น และเมื่อรวบรวมได้เป็นร้อยภาพ ก็มักเป็นตำหนิประเภทเดียวกันซ้ำๆ โมเดล deep learning ที่ต้องการภาพหลายพันใบจึง overfit กับความหลากหลายที่แทบไม่มีอยู่จริง บทความนี้ดำน้ำลึกสู่แนวทางที่งานวิจัยปี 2026 ยืนยันแล้วว่าได้ผลจริง: สร้างภาพตำหนิสังเคราะห์ด้วย Diffusion Model แล้วมาเสริมชุดข้อมูลฝึก ทำไม GAN ยุคก่อนยังไม่พอ Generative Adversarial Network (GAN) เคยเป็นคำตอบมาตรฐานของปัญหานี้มานานกว่าห้าปี แต่งานวิจัยที่ตีพิมพ์ใน Multimedia Tools and Applications (2026) สรุปข้อจำกัดที่โรงงานเจอตรงๆ สามข้อ: ปัญหา mode collapse ที่ทำให้ภาพที่สร้างซ้ำซากจำเจ ความละเอียดเท็กซ์เจอร์ความถี่สูงที่ไม่พอสำหรับงานตรวจสอบอุตสาหกรรม และความขัดแย้งพื้นฐานที่สุด — GAN ต้องการข้อมูลปริมาณมากอยู่ด่วนในการเทรนให้เสถียร ซึ่งขัดกับสถานการณ์ low-shot ตั้งแต่ต้น Diffusion Model เปลี่ยนกระบวนทัศน์จากการต่อสู้สองโครงข่าย มาเป็นการ ถอด noise ทีละขั้น (iterative denoising) ที่ optimize ด้วย objective แบบ likelihood ที่เสถียรกว่า ผลคือควบคุมโครงสร้างตำหนิและความหลากหลายได้ดีกว่าอย่างมีนัยสำคัญ — งานเปรียบเทียบโดยตรงในโครงการ CINNABAR 2 ของ DLR MRO Institute (เยอรมนี) พบว่า Diffusion Model ให้คะแนน LPIPS ดีกว่าและยก performance ของตัวตรวจจับขึ้น 12% เมื่อเทียบกับ GAN บนงานตรวจคราบบนผิวเครื่องบิน Pipeline ที่งานวิจัยยืนยันแล้ว ภาพที่ 1: Pipeline การสร้างภาพตำหนิสังเคราะห์ด้วย Latent Diffusion Model — เริ่มจากภาพจริงเพียง 3-5 ใบต่อชนิดตำหนิ แนวทางที่ทรงพลังที่สุดในปัจจุบันคือการ fine-tune Latent Diffusion Model (LDM) ที่ pre-train มาแล้วด้วยเทคนิค DreamBooth + LoRA — ฝัง concept ของตำหนิชนิดใหม่ลงโมเดลด้วยภาพอ้างอิงเพียงไม่กี่ใบ โดยปรับเฉพาะ cross-attention layers เพื่อลดภาระคำนวณ จากนั้นใช้ Differential Diffusion แปะตำหนิที่เรียนรู้ได้ลงบนภาพพื้นผิวปกติ โดยไม่เกิดรอยต่อ (boundary…
Read More
Case Study: หุ่นยนต์ 400,000 ตัวที่ “เรียนงานจากช่างฝีมือ” — Embodied Learning, งบปรับปรุงโรงงาน 6,400 ล้านดอลลาร์ต่อปี และสัญญาณ Physical AI จากดีล M&A 675 ล้านดอลลาร์

Case Study: หุ่นยนต์ 400,000 ตัวที่ “เรียนงานจากช่างฝีมือ” — Embodied Learning, งบปรับปรุงโรงงาน 6,400 ล้านดอลลาร์ต่อปี และสัญญาณ Physical AI จากดีล M&A 675 ล้านดอลลาร์

Article
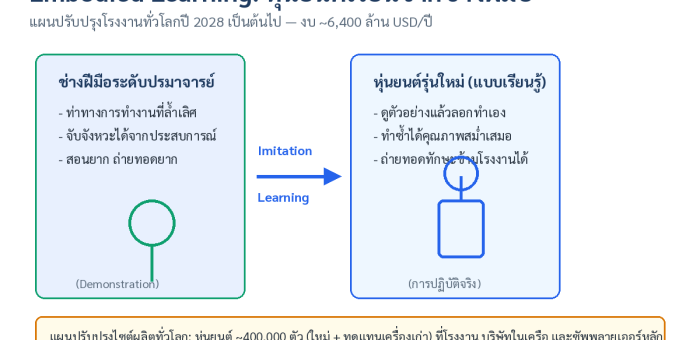
ข่าวใหญ่ปลายไตรมาส 3/2026 จากผู้ผลิตรถยนต์รายใหญ่ที่สุดของญี่ปุ่นให้สัญญาณที่โรงงานทั่วโลกต้องอ่านให้ขาด: ตั้งแต่ปี 2028 บริษัทจะลงทุนประมาณ 6,400 ล้านดอลลาร์ต่อปี ปรับปรุงไซต์ผลิตทั่วโลก พร้อมส่งหุ่นยนต์ราว 400,000 ตัว (ทั้งเครื่องใหม่และทดแทนเครื่องเก่า) ลงโรงงาน บริษัทในเครือ และซัพพลายเออร์หลัก — และหัวใจของแผนนี้ไม่ใช่ความเร็วหุ่นยนต์ แต่คือวิธีที่มัน "เรียนรู้" Embodied Learning: ช่างฝีมือระดับปรมาจารย์สาธิต (Demonstration) → หุ่นยนต์เรียนและลอกแบบท่าทางผ่าน Imitation Learning (ที่มา: เรียบเรียงจากงานนักลงทุน ก.ย. 2026 รายงานโดยสื่อการเงินระดับโลก) Problem: ทักษะปรมาจารย์ที่ถ่ายทอดไม่ได้ ในโรงงานการผลิตทุกแห่ง ทักษะของช่างฝีมืออาวุโสคือ "ทรัพย์สินที่หายไปเมื่อคนเกษียณ" งานประจำ เช่น การประกอบชิ้นส่วนที่ต้องอาศัยจังหวะ แรงบิด และความรู้สึกที่สั่งสมมาหลายสิบปี ถ่ายทอดด้วยเอกสารไม่ได้ หุ่นยนต์อุตสาหกรรมแบบดั้งเดิมจึงทำงานเหล่านี้แทนไม่ได้ เพราะต้องโปรแกรมทุกท่าทางล่วงหน้าแบบตายตัว ขณะที่ปัญหาขาดแรงงานฝีมือของไทยกำลังรุนแรงขึ้นทุกปี Solution: หุ่นยนต์ที่เรียนโดย "ดูตัวอย่าง" ในงานนักลงทุนเมื่อเดือนกันยายน ที่ศูนย์บริหารภูมิภาคยุโรป บริษัทได้สาธิตหุ่นยนต์ตัวใหม่ที่พัฒนาเองภายในองค์กร โดยมีชื่อย่อมาจากแนวคิด "Embodied Learning robot for Enhanced Yield" — หุ่นยนต์ขนาดเล็กกว่าหุ่นยนต์อุตสาหกรรมทั่วไป ที่เรียนรู้งานจากการดูช่างฝีมือทำจริงแล้วลอกแบบ (Imitation Learning) แทนการโปรแกรมทีละท่า แนวทางนี้เปลี่ยนเกมเพราะ: เวลาตั้งค่างานใหม่สั้นลงมาก — สาธิตไม่กี่ครั้ง หุ่นยนต์ก็เริ่มทำงานได้ แทนการโปรแกรมหลายวัน ทักษะถ่ายทอดได้ทั่วทั้งกลุ่มบริษัทและซัพพลายเออร์ — 400,000 ตัวหมายถึงเครือข่ายที่แชร์บทเรียนร่วมกัน ออกแบบมาเพื่ออยู่ร่วมกับคน (Coexist) — ไม่ใช่กรงขังเหล็กแบบหุ่นยนต์ดั้งเดิม สัญญาณยืนยันจากตลาด M&A: Physical AI กำลังถูกซื้อ ไม่กี่สัปดาห์ก่อนหน้า ยักษ์ใหญ่ด้านระบบออโตเมชันและเซ็นเซอร์ของญี่ปุ่นประกาศเข้าซื้อบริษัทผู้ผลิตคอมพิวเตอร์อุตสาหกรรมสัญชาติอเมริกันในราคา 675 ล้านดอลลาร์ (คาดปิดดีลต้นปี 2027) เป้าหมายชัดเจน: หลอมรวมเซ็นเซอร์+ระบบควบคุม+หุ่นยนต์ เข้ากับพลังการประมวลผลหน้างาน เพื่อสร้าง Physical AI — ระบบที่ประมวลผลข้อมูลมหาศาลจากเซ็นเซอร์ได้ทันที "หน้างาน" แบบ Real-time แทนการรอส่งขึ้นคลาวด์ เช่นระบบตรวจคุณภาพอัตโนมัติที่พบชิ้นงานผิดมาตรฐานแล้วสั่งปรับกระบวนการได้ทันทีแบบไร้รอยต่อ (Closed-loop Manufacturing) สถาปัตยกรรม 4 ชั้นของ Physical AI บนสายการผลิต: รับรู้ → คำนวณหน้างาน → ตัดสินใจ → ปรับเครื่องจักรจริง (ที่มา: เรียบเรียงจาก metrology.news) Results และสิ่งที่โรงงานไทยควรทำตอนนี้ สัญญาณจากข่าว ความหมายต่อโรงงานไทย งบปรับปรุงไซต์ผลิต 6,400 ล้านดอลลาร์/ปี เริ่มปี…
Read More
6 เทรนด์การผลิตปี 2026 จาก Forbes: AI Agents โต 4 เท่า และ Smart Materials แตะ 133,000 ล้านดอลลาร์ — โรงงานไทยควรเริ่มจากตรงไหน

6 เทรนด์การผลิตปี 2026 จาก Forbes: AI Agents โต 4 เท่า และ Smart Materials แตะ 133,000 ล้านดอลลาร์ — โรงงานไทยควรเริ่มจากตรงไหน

Article
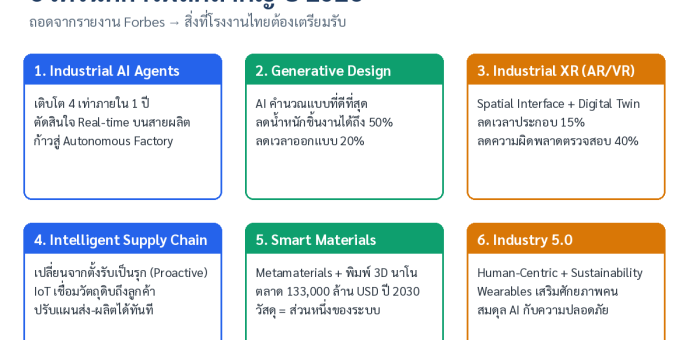
ต้นปี 2026 รายงานเทรนด์การผลิตจากสำนักข่ายการเงินระดับโลก (Forbes) ได้สรุป 6 แรงขับเคลื่อนสำคัญของโรงงานทั่วโลกไว้อย่างชัดเจน จุดร่วมของทั้ง 6 ข้อไม่ใช่ "AI ทำอะไรได้อีกบ้าง" แต่คือการทำให้ คนและเครื่องจักรทำงานร่วมกันได้จริงในทางปฏิบัติ — ซึ่งเป็นคำถามเดียวกันที่โรงงานไทยกำลังเผชิญในยุคต้นทุนและการแข่งขันที่เข้มข้นขึ้นทุกไตรมาส ภาพรวม 6 เทรนด์การผลิตสำคัญปี 2026 พร้อมตัวเลขสำคัญจากรายงาน Forbes (ถอดความโดย ManuTalkThai) ตารางสรุป: 6 เทรนด์ ตัวเลข และระดับความพร้อมที่โรงงานไทยควรประเมิน เทรนด์ ตัวเลขสำคัญจากรายงาน สิ่งที่โรงงานไทยต้องมีก่อน 1. Industrial AI Agentsการใช้งานโต ~4 เท่าภายใน 1 ปีข้อมูลหน้างานที่เข้าถึงได้แบบ Real-time (เชื่อมต่อเครื่องจักรก่อน) 2. Generative Designลดน้ำหนักชิ้นงานได้ถึง 50% และลดเวลาออกแบบ 20%คลังแบบ 3 มิติ + เงื่อนไขวัสดุ/กระบวนการผลิตที่ถูก digitalize 3. Industrial XR (AR/VR)ลดเวลาประกอบ 15% และลดความผิดพลาดการตรวจสอบ 40% ในอุตสาหกรรมการบินDigital Work Instructions + Digital Twin ระดับสินทรัพย์ 4. Intelligent Supply Chainเปลี่ยนจากตั้งรับเป็นรุก (Proactive)การมองเห็นข้อมูล End-to-End ผ่าน IoT และ Track & Trace 5. Smart Materialsตลาดโตถึง ~133,000 ล้านดอลลาร์ในปี 2030ความเข้าใจกระบวนการผลิตสมรรถนะสูง เช่น การพิมพ์ 3 มิติ 6. Industry 5.0Human-Centric + Sustainability เป็นแกนกลยุทธ์การออกแบบงานที่ให้เทคโนโลยีเสริมคน ไม่ใช่แทนที่ เจาะ 2 เทรนด์ที่กระทบโรงงานไทยเร็วที่สุด Industrial AI Agents — จาก Dashboard สู่ผู้ลงมือ จุดเปลี่ยนของปี 2026 คือ AI เปลี่ยนบทบาทจาก "ผู้ช่วยวิเคราะห์" เป็น "เอเจนต์" ที่ลงมือทำงานได้เอง ตั้งแต่วางแผนการผลิต สั่งซื้อวัตถุดิบ ไปจนถึงแก้คอขวดบนสายการผลิตโดยแทบไม่ต้องรอคำสั่งมนุษย์ รายงานคาดการณ์ว่าการใช้ระบบเอเจนต์ในโรงงานจะเติบโตถึง 4 เท่าภายในหนึ่งปี มุ่งสู่เป้าหมาย Autonomous Smart Factory อย่างไรก็ตาม เอเจนต์จะทำงานได้ ต้องอาศัย "เชื้อเพลิง" คือข้อมูลหน้างานที่ถูกเก็บอย่างเป็นระบบ…
Read More
บทวิเคราะห์: หน้างานวิ่งนำ C-suite — Industrial AI Index 2026 เผยช่องว่างควบคุมที่อันตรายกว่าการยอมรับช้า

บทวิเคราะห์: หน้างานวิ่งนำ C-suite — Industrial AI Index 2026 เผยช่องว่างควบคุมที่อันตรายกว่าการยอมรับช้า

Article
กลางเดือนตุลาคม 2026 รายงานสำรวจรายใหม่จากผู้ให้บริการซอฟต์แวร์ Industrial AI รายใหญ่ระดับโลก (เผยแพร่ 13 ตุลาคม 2026) สร้างคำถามที่ไม่สบายใจสำหรับผู้บริหารโรงงานหลายราย: ถ้าทีมหน้างานเป็นฝ่ายขับเคลื่อน AI จริง แล้วผู้บริหารกำลังทำอะไรอยู่? รายงานฉบับนี้สำรวจผู้บริหารอาวุโสกว่า 2,200 คนจาก 14 ประเทศ แล้วพบ "Execution Divide" ชัดเจน — วิศวกร หัวหน้าโรงงาน และผู้รับผิดชอบโลจิสติกส์ คือกลุ่มที่ทำให้ AI เกิดผลเชิงพาณิชย์จริง ขณะที่กรอบ Governance และโครงสร้างการเข้าถึงข้อมูลกลับตามไม่ทัน ตัวเลขจากหน้างาน: ได้ผลจริงและวัดได้ องค์กรกว่า 90% ที่นำ AI อุตสาหกรรมไปใช้งานจริงรายงานผลลัพธ์เชิงประจักษ์ โดยเฉพาะด้านความน่าเชื่อถือของสินทรีย์กร: 93% ปรับปรุงอัตราการทำงาน "ถูกตั้งแต่ครั้งแรก" (First-Time-Right) 90% เพิ่มความพร้อมใช้งานของเครื่องจักร (Asset Availability) 88% ปรับปรุงการส่งมอบตรงตามแผน (On-Time Delivery Adherence) กว่า 50% ของเวลาพนักงานในงานหลักอย่าง Throughput และ Quality Assurance ถูกปลดปล่อยออกมา เวลาที่ได้คืนถูกนำไปใช้ต่อ: 36% ทุ่มให้ความปลอดภัยและการฝึกอบรมบุคลากร, 35% ปรับปรุงประสิทธิภาพเครื่องจักร, 26% เร่ง Continuous Improvement และ 25% ขยายส่วนแบ่งตลาด ห้องควบคุมการผลิต — จุดที่ทีมหน้างานใช้ข้อมูล Operational ตัดสินใจทุกวัน (ภาพ: Wikimedia Commons) ปรากฏการณ์ที่ต้องจับตา: คนหน้างาน "ฝึก AI ให้ทำงานแทน" ก่อนที่ผู้บริหารจะรู้ตัว ข้อมูลที่น่าประหลาดใจที่สุดคือพฤติกรรมของ Frontline ในช่วง 12 เดือนที่ผ่านมา: 43% ฝึกและนำ Agentic Digital Workers (AI Agent ที่ทำงานบางส่วนแทนคนได้) เข้าสู่งานประจำวันจริง 37% อัปสกิลเพื่อนร่วมงานให้ใช้เครื่องมือ AI อุตสาหกรรมในงานประจำวัน 36% ฝึกทีมให้ทำงานร่วมกับ Digital Worker โดยตรง ขณะที่ความพยายามหลักของผู้บริหารช่วงเดียวกันคือ "อัปสกิลตัวเอง" (41%) เพื่อให้เข้าใจ AI — ความสนใจหันเข้าด้านใน มากกว่าเสริมพลังให้หน้างานที่กำลังวิ่งอยู่แล้ว และความมั่นใจของผู้นำ (30%) กลายเป็นอุปสรรคใหญ่ที่สุดของการขยายผล ช่องว่างที่อันตรายกว่า: มั่นใจบนกระดาษ แต่ขาด Controls ที่หน้างาน ปัญหาไม่ใช่การยอมรับ AI…
Read More
บทวิเคราะห์: Gartner Hype Cycle for Agentic AI 2026 — องค์กรใช้ AI Agent จริงแค่ 17% และนี่คือสิ่งที่โรงงานต้องรู้ก่อนกระโดดขึ้นรถ

บทวิเคราะห์: Gartner Hype Cycle for Agentic AI 2026 — องค์กรใช้ AI Agent จริงแค่ 17% และนี่คือสิ่งที่โรงงานต้องรู้ก่อนกระโดดขึ้นรถ

Article
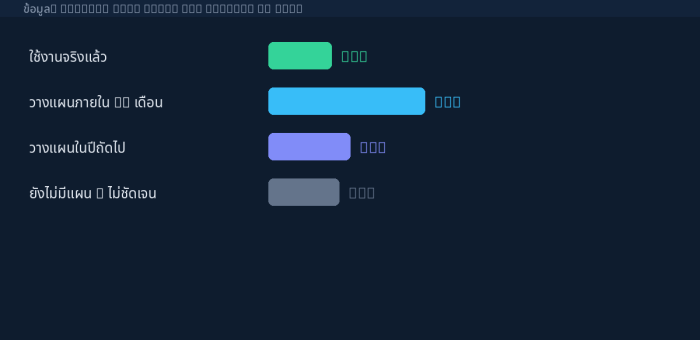
“AI Agent” คือคำที่ถูกพูดมากที่สุดในวงการเทคโนโลยีอุตสาหกรรมปี 2026 ทุกงานสัมมนามีประเด็นนี้ ทุกเวนเดอร์มีแพลตฟอร์มนี้ แต่ตัวเลขจริงจาก Gartner ฉายภาพที่ต่างออกไป: องค์กรที่ใช้ AI Agent ในการทำงานจริงมีเพียง 17% ในขณะที่ 42% วางแผนจะเริ่มภายใน 12 เดือน และอีก 22% มีแผนในปีถัดไป ช่องว่างระหว่าง “ความคาดหวัง” กับ “การใช้งานจริง” นี้แหละคือหัวใจของ Hype Cycle for Agentic AI 2026 ที่ Gartner เผยแพร่ล่าสุด และสำหรับโรงงานไทย นี่คือจังหวะที่ต้องตัดสินใจอย่างมีสติ ไม่ใช่ FOMO ตัวเลขบอกอะไร: 17% ที่เริ่มแล้วทำอะไรอยู่ กลุ่ม 17% ที่ใช้จริงส่วนใหญ่ยังโฟกัสที่ งานอัตโนมัติเฉพาะจุด (Automation เป็นหลัก) ยังไม่ใช่การเปลี่ยนแปลงกระบวนการทั้งองค์กร ซึ่งสอดคล้องกับสิ่งที่เห็นในโรงงานจริง: AI Agent ตัวแรกๆ ที่เวิร์กคือตัวที่ทำงานแคบและชัด เช่น อ่านค่าเซ็นเซอร์แล้วสรุปสรุปสถานะเครื่องจักร จัดลำดับงานซ่อมบำรุง หรือเตรียมรายงานกะกลางคืน 17% ใช้จริง / 42% จะเริ่มใน 12 เดือน / 22% ปีถัดไป — ความต่างขององค์กรจะเกิดในช่วง 12 เดือนข้างหน้า (ข้อมูล: Gartner, แผนภูมิ: Honey Corporation) 3 เทรนด์หลักที่ Gartner ระบุ — แปลเป็นภาษาโรงงาน เทรนด์ Gartner ความหมายต่อโรงงาน 1. AI Agent Adoption — 17% ใช้จริง, 42% ใน 12 เดือน หน้าต่างความได้เปรียบกำลังเปิด ผู้ที่เริ่มก่อนจะสะสมข้อมูลและบทเรียนก่อน แต่เริ่มผิดทางก็เสียเวลาเท่ากัน 2. Semi-Autonomous Deployment — มนุษย์ยังต้องควบคุม อย่ามองหา AI Agent ที่ “ตัดสินใจแทนทั้งหมด” ให้ออกแบบให้ Agent เสนอ + คนอนุมัติจุดวิกฤต เช่น การสั่งหยุดไลน์หรือเปลี่ยนแปลงพารามิเตอร์เครื่องจักร 3. Agent Washing — RPA เดิมแต่งตัวเป็น AI Agent ตรวจสอบให้ชัดว่าแพลตฟอร์มที่ซื้อ “คิดและปรับตัว” จริง หรือแค่รันสคริปต์เดิมที่เปลี่ยนชื่อ…
Read More
Zero-Shot Anomaly Detection: ตรวจจับตำหนิที่ AI “ไม่เคยเห็นมาก่อน” ด้วย Vision-Language Model

Zero-Shot Anomaly Detection: ตรวจจับตำหนิที่ AI “ไม่เคยเห็นมาก่อน” ด้วย Vision-Language Model

Article
ทำไมโมเดล AI แบบเดิมถึง "เพิ่มรุ่นใหม่ไม่ทัน" โรงงานสมัยนี้เปลี่ยนผลิตภัณฑ์เร็วขึ้นมาก สายการผลิตเดียวอาจสลับ SKU ทุก 2–3 วัน ลูกค้าของัดสีพิเศษ หรือมีอะไหล่ใหม่ที่ไม่เคยมีในชุดข้อมูลเดิม ปัญหาคือระบบตรวจจับตำหนิด้วย AI แบบดั้งเดิม (Supervised Learning) ต้องการภาพตัวอย่างที่ "ติดป้าย" จำนวนหลายพันภาพต่อหนึ่ง Defect กว่าจะเทรนเสร็จ ผลิตจริงเปลี่ยนไปแล้ว งานวิจัยล่าสุดจาก arXiv (LiZAD, กรกฎาคม 2026) ระบุชัดว่า "ในสายการผลิต High-throughput ยุคใหม่ การเก็บและ Label ข้อมูลสำหรับทุก Scenario ใหม่เป็นเรื่องไม่ practical แล้ว" นี่คือช่องว่างที่ Zero-Shot Anomaly Detection (ZSAD) เข้ามาเติม — ตรวจจับตำหนิที่โมเดล "ไม่เคยเห็นมาก่อนเลย" ด้วยการอาศัยความเข้าใจภาษาธรรมชาติที่ฝังอยู่ใน Vision-Language Model สายการผลิตอัตโนมัติยุคใหม่ต้องรองรับการเปลี่ยน SKU ที่เร็วขึ้น ระบบตรวจคุณภาพจึงต้อง "ยืดหยุ่น" ตาม (ภาพ: Wikimedia Commons) Vision-Language Model ทำงานกับงานตรวจตำหนิอย่างไร หัวใจของแนวทางนี้คือการเทียบ "ความหมาย" ระหว่างภาพกับข้อความ แทนที่จะจำตำหนิรูปแบบเดิมๆ ระบบจะสร้าง Prompt เช่น a photo of a normal metal surface และ a photo of a metal surface with scratch แล้ววัดว่าภาพที่กล้องจับมา "ใกล้เคียง" ประโยคไหนมากกว่า ถ้าใกล้ประโยคที่พูดถึงตำหนิมากกว่า ระบบก็แจ้งเตือนทันที โดยไม่ต้องเทรนใหม่แม้แต่ภาพเดียว งานวิจัยสายนี้ส่วนใหญ่อ้างอิงสถาปัตยกรรมแบบ CLIP (Contrastive Language-Image Pre-training) ซึ่งเทรนล่วงหน้าด้วยคู่ภาพ-ข้อความนับร้อยล้านคู่ ทำให้โมเดลเข้าใจความสัมพันธ์ระหว่าง "รอยขีดข่วน" ในเชิงภาษา แล้ว map มาหา pattern ทางภาพได้โดยอัตโนมัติ แนวคิด Object Localization ด้วย AI — ZSAD ต่อยอดด้วยการเทียบความหมายระหว่างภาพกับข้อความแทนการจำ Pattern เดิม (ภาพ: Wikimedia Commons) เทคนิคสำคัญที่งานวิจัยปี 2026 กำลังพัฒนา เทคนิค แนวคิด ประโยชน์ต่อโรงงาน Discrete Prompt Optimization (CoEvoAD, ส.ค.…
Read More