Case Study: Chiller Plant 2,000 RT ลด kW/RT ได้ 22.8% โดยไม่เปลี่ยนเครื่องจักรใหญ่ — เรื่องจริงจากข้อมูล 1 นาที

Case Study: Chiller Plant 2,000 RT ลด kW/RT ได้ 22.8% โดยไม่เปลี่ยนเครื่องจักรใหญ่ — เรื่องจริงจากข้อมูล 1 นาที

Article
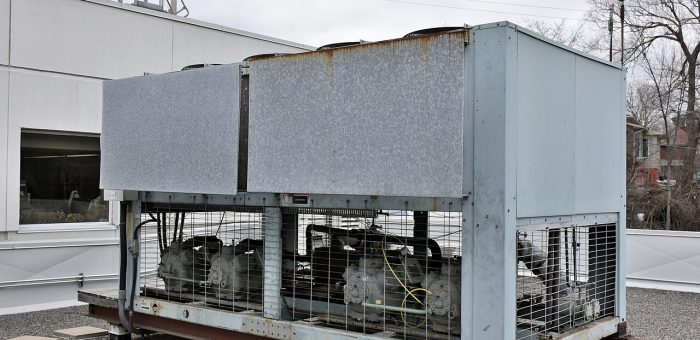
โรงงานผลิตชิ้นส่วนแห่งหนึ่งในนิคมอุตสาหกรรมภาคตะวันออกมี Chiller Plant ขนาด 2,000 ตันเย็น (RT) ให้บริการทั้งระบบปรับอากาศและน้ำเย็นกระบวนการผลิต ทุกคนในทีมซ่อมบำรุงรู้ดีว่า "ค่าไฟห้อง Chillers สูงผิดปกติ" มาหลายปี แต่ไม่มีใครตอบได้ว่าสูงเพราะอะไร เพราะข้อมูลที่มีคือยอด kWh รวมต่อเดือนจากมิเตอร์เดียว และค่าการตั้งค่าที่ "ถูกปรับครั้งสุดท้ายเมื่อคนเก่ายังอยู่" กรณีศึกษานี้ถอดบทเรียนจากโครงการปรับปรุงประสิทธิภาพระบบน้ำเย็นด้วยการติดตั้ง IIoT Monitoring และการวิเคราะห์ข้อมูลแบบ Fault Detection ตั้งแต่วันแรกจนถึงการเปลี่ยนแปลงที่วัดผลได้ — แบบเดียวกับที่โรงงานอื่นต่างประเทศทำและได้ผลยืนยันจากงานวิจัยระดับชาติสหรัฐฯ ปัญหา: เครื่องจักรปกติ แต่ระบบไม่ปกติ สิ่งที่ทีมวิศวกรพบหลังติดตั้งเซ็นเซอร์วัดอุณหภูมิน้ำเข้า/ออกทุกเครื่อง วัดกำลังไฟฟ้าของคอมเพรสเซอร์แยกทีละตัว และดึงค่าจาก BMS มาวิเคราะห์ร่วมกัน คือภาพที่ต่างจากความเชื่อเดิมโดยสิ้นเชิง: เครื่อง Chiller เดิน 3 เครื่องพร้อมกันทั้งวัน ทั้งที่โหลดจริงเฉลี่ยเพียง 58% ของกำลังติดตั้ง — ปัญหา Staging Logic ผิดพลาด อุณหภูมิน้ำเย็นออกถูกตั้งไว้ 6.0°C ทั้งที่กระบวนการผลิตรับ 7.2°C ได้ — ทุก 1°C ที่ลดลงเกินจำเป็น กินพลังงานเพิ่มราว 2-3% Condenser Approach ของเครื่องที่ 2 สูงผิดปกติ (เกิน 3°C) — สัญญาณท่อคอนเดนเซอร์มีตะกอน ปั๊มน้ำเดินที่ความเร็วเต็ม (100%) ตลอดเวลาแม้โหลดต่ำ — ไม่มี VFD ควบคุมตามความต้องการจริง ระบบท่อน้ำเย็นของ Chiller Plant อุตสาหกรรม — จุดวัดอุณหภูมิและความดันทุกจุดคือข้อมูลที่เปลี่ยนวิธีดูแลทั้งระบบ (ภาพ: Wikimedia Commons) โซลูชัน: มองเห็นก่อน แล้วค่อยแก้ หลักการของโครงการคือ "ไม่เดา ไม่ลองผิดลองถูก ใช้ข้อมูลตัดสิน" โดยแบ่งเป็น 3 เส้นทาง: 1. ติดตั้งชั้นข้อมูล (Instrumentation Layer) เพิ่มเซ็นเซอร์อุณหภูมิแม่นยำ ±0.1°C ที่ท่อน้ำเข้า/ออกทุกเครื่อง มิเตอร์วัดกำลังไฟฟ้าทุกตัวขับหลัก (คอมเพรสเซอร์ ปั๊ม พัดลมหอ้นเย็น) และเกตเวย์ IIoT เก็บข้อมูลทุก 1 นาที ส่งขึ้นแพลตฟอร์มวิเคราะห์แบบเรียลไทม์ ตัวชี้วัดหลักที่คำนวณอัตโนมัติคือ kW/RT (กิโลวัตต์ต่อตันเย็น) — ตัวเลขเดียวที่บอกสุขภาพทั้งระบบ 2. วิเคราะห์หาความผิดปกติ (Fault Detection) แพลตฟอร์มเทียบพฤติกรรมจริงกับ Baseline ทางเทคนิค เช่น ความสัมพันธ์ระหว่างโหลด-อุณหภูมิ-กำลังไฟที่ควรเป็นตามหลักอุณหพลศาสตร์ ความผิดปกติที่ตรวจพบถูกจัดคิวตามผลกระทบด้านพลังงาน ไม่ใช่ตามลำดับที่คนเห็นเป็นเรื่องเป็นราวก่อน วิธีนี้เป็นแนวทางเดียวกับ…
Read More
IEC 61724 ปฏิบัติการจริง: ออกแบบระบบ Monitoring โซล่าร์โรงงานให้ค่า Performance Ratio ที่พิสูจน์ได้

IEC 61724 ปฏิบัติการจริง: ออกแบบระบบ Monitoring โซล่าร์โรงงานให้ค่า Performance Ratio ที่พิสูจน์ได้

Article
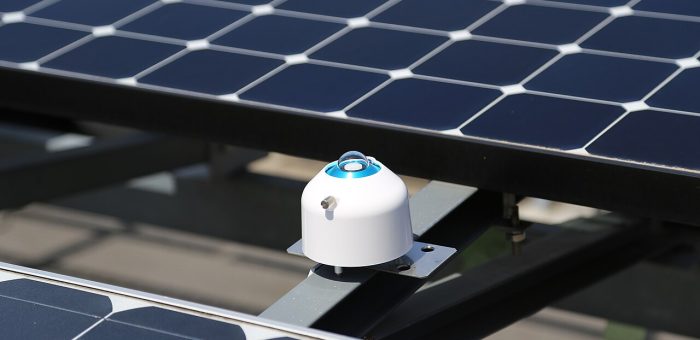
โรงงานจำนวนมากติดตั้งโซล่าร์บนหลังคาด้วยความคาดหวังว่าจะประหยัดค่าไฟ 10-20% แต่พอผ่านไป 2-3 ปี กลับตอบไม่ได้ว่าระบบ "ยังทำงานได้ดีเท่าวันแรกหรือไม่" เพราะข้อมูลที่มีคือตัวเลขผลผลิตรวมจากหน้าจออินเวอร์เตอร์ ซึ่งความผิดพลาดของเครื่องวัดอาจสูงถึง ±3-5% — ไม่พอสำหรับการอ้างสิทธิ์ความเสียหายตามสัญญารับประกันผลผลิต (Performance Guarantee) มาตรฐานสากล IEC 61724 คือคำตอบของปัญหานี้ มันกำหนดว่าจะ "วัดอะไร แม่นยำแค่ไหน ถี่แค่ไหน" เพื่อให้ค่า Performance Ratio (PR) ที่คำนวณออกมาสามารถใช้โต้แย้งทางกฎหมายและการเงินได้ บทความนี้ถอดรหัสมาตรฐานฉบับนี้สำหรับวิศวกรที่ดูแลโซล่าร์ในโรงงานอุตสาหกรรม เซ็นเซอร์วัดรังสีอาทิตย์ (Pyranometer) คือหัวใจของระบบมอนิเตอริ่งตาม IEC 61724 — ความแม่นยำของมันคำนวณเป็นค่า PR ทั้งระบบ (ภาพ: Wikimedia Commons) โครงสร้างมาตรฐาน 3 ส่วน IEC 61724 แบ่งเป็น 3 ส่วน โดยส่วนที่วิศวกรโรงงานต้องรู้จักดีที่สุดคือข้อ 1: IEC 61724-1 — ข้อกำหนดการติดตั้งระบบวัด (Monitoring): เซ็นเซอร์ ความแม่นยำ ความถี่การเก็บข้อมูล IEC 61724-2 — วิธีการประเมินกำลังผลิต (Capacity Evaluation) จากข้อมูลจริง IEC 61724-3 — วิธีการประเมินพลังงาน (Energy Evaluation) เทียบกับค่าอ้างอิง Class A / B / C — เลือกระดับความแม่นยำให้เหมาะกับงาน หัวใจของ IEC 61724-1 คือการจัดระดับระบบวัดเป็น 3 คลาส ตามความแม่นยำของเซ็นเซอร์และความละเอียดข้อมูล: องค์ประกอบ Class A (Bankable) Class B (Operational) Class C (Basic) เซ็นเซอร์วัดรังสี Thermopile Pyranometer มาตรฐาน ISO 9060 Class A (ความคลาดเคลื่อนรายวัน ±1.0-1.5%) Pyranometer ISO 9060 Class B หรือ Reference Cell สอบเทียบแล้ว (±2-3%) Reference Cell ไม่สอบเทียบ หรือค่าจากสถานีอุตุนิยมวิทยา (±5-10%) มิเตอร์พลังงาน IEC 62053 Class 0.2S (±0.2%) IEC 62053…
Read More
บทวิเคราะห์: Digital Twin กับปัญหา Model Drift — เมื่อโมเดล PdM เริ่มเพี้ยน Fleet Learning จะช่วยได้จริงหรือไม่

บทวิเคราะห์: Digital Twin กับปัญหา Model Drift — เมื่อโมเดล PdM เริ่มเพี้ยน Fleet Learning จะช่วยได้จริงหรือไม่

Article
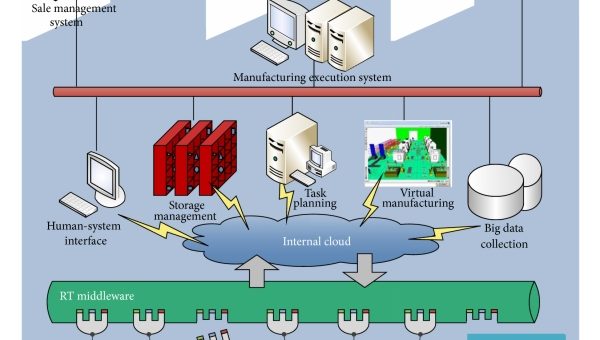
โมเดล AI ทำนายความเสียหายของเครื่องจักร (Predictive Maintenance) ตัวหนึ่งในโรงงานสิ่งทอทำงานได้แม่นยำมากในปีแรก แต่ปีที่สองความแม่นยำเริ่มถดลง เพราะสภาพเครื่องจักรเปลี่ยน โหลดการผลิตเปลี่ยน และพฤติกรรม "ปกติ" ของเครื่องจักรเลื่อนไปจากเดิม นี่คือปัญหา Model Drift ที่ทุกโรงงานต้องเจอ และเป็นคำถามเปิดของวงการว่า Digital Twin จะช่วยแก้ได้จริงหรือไม่ บทวิเคราะห์นี้มองปัญหาจากมุมวิศวกรรม ไม่ใช่มุมการตลาด ปัญหา Model Drift ในโรงงาน: ทำไมโมเดลเก่าเร็วจนน่าใจหาย โมเดล Anomaly Detection ส่วนใหญ่เรียนรู้จากข้อมูลในอดีต แล้วตั้งสมมติฐานว่าอนาคตจะคล้ายอดีต แต่ในโรงงานจริง ไม่มีอะไรนิ่ง: ชิ้นส่วนสึกหรอ, สูตรผลิตเปลี่ยน, ผู้ปฏิบัติงานเปลี่ยนวิธีเดินเครื่อง, อุณหภูมิแวดล้อมตามฤดูกาล หรือแม้แต่การซ่อมบำรุงที่ "ปรับ" พฤติกรรมเครื่องจักรไปโดยสิ้นเชิง ผลคือเกิดการแจ้งเตือนเท็จ (False Alarm) เพิ่มขึ้นเรื่อยๆ จนทีมซ่อมบำรุงเริ่มกด "Dismiss" โดยไม่อ่าน — และวันหนึ่ง Alarm จริงก็ถูกกดไปพร้อมกับพวกเท็จ แนวทางแก้แบบดั้งเดิมคือ การเทรนซ้ำ (Retraining) ด้วยข้อมูลใหม่ แต่คำถามคือใครจะ Label ข้อมูลว่าอะไรคือ "ปกติ" ในสถานการณ์ใหม่ และต้องรอนานแค่ไหนจึงจะมีข้อมูลเพียงพอ เพราะความเสียหายจริงเกิดไม่บ่อยนัก แนวคิดใหม่: Fleet Learning ผ่าน Digital Twin แนวคิดที่กำลังได้รับความสนใจคือการใช้ Digital Twin เป็น "ผู้เรียนรู้ร่วมกัน" ของกลุ่มเครื่องจักรลักษณะเดียวกัน แทนที่จะปล่อยให้แต่ละเครื่องเรียนรู้ลำพัง: สถาปัตยกรรม Smart Factory ยุคใหม่เชื่อมทุกชั้นข้อมูลเข้าด้วยกัน — Fleet Learning เป็นการขยายแนวคิดนี้สู่กลุ่มเครื่องจักรข้ามไซต์ (ภาพ: Wikimedia Commons, CC BY 4.0) หลักการคือ เมื่อเครื่องจักร A ในไซต์ 1 เจอ Failure Mode ใหม่และถูกบันทึกไว้ใน Twin ของมัน ความรู้นั้นสามารถถ่ายทอด (Transfer) ไปยังโมเดลของเครื่องจักร B, C, D ที่อยู่คนละไซต์แต่มีลักษณะเดียวกันได้ทันที เครื่องจักรอื่นๆ จึง "รู้" ล่วงหน้าโดยไม่ต้องเจอเองก่อน นี่คือความต่างสำคัญจากการเทรนโมเดลแบบเก่าที่ต้องรอเครื่องเสียจริงทีละตัวเพื่อสะสมประสบการณ์ วิเคราะห์กลไกทางเทคนิค: Twin ช่วยแก้ Drift ได้อย่างไร กลไก วิธีการทำงาน ข้อดี ข้อจำกัดที่ต้องยอมรับ Simulation Augmentationใช้ Twin จำลองสถานการณ์ที่ยังไม่เคยเกิดจริง สร้างข้อมูล Synthetic สำหรับเทรนโมเดลได้ข้อมูล Failure…
Read More
บทวิเคราะห์ Cloud Continuum: เลิกถามว่า ‘Edge หรือ Cloud’ แล้วเริ่มกำหนดนโยบายวาง Workload แบบต่อเนื่อง

บทวิเคราะห์ Cloud Continuum: เลิกถามว่า ‘Edge หรือ Cloud’ แล้วเริ่มกำหนดนโยบายวาง Workload แบบต่อเนื่อง

Article
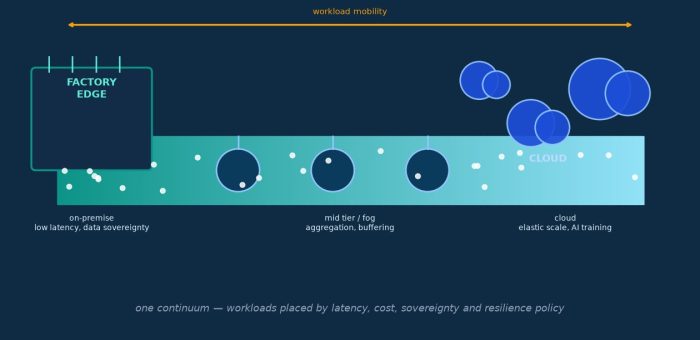
คำถามเก่าที่ยังไม่มีคำตอบสมบูรณ์: "งานนี้ควรอยู่ Edge หรือ Cloud" ตลอดหลายปีที่ผ่านมา การตัดสินใจว่า "งานไหนควรประมวลผลที่ไหน" เป็นคำถามที่ได้คำตอบแบบ binary: ถ้าต้องการเร็วให้อยู่ Edge, ถ้าต้องการ scale ให้อยู่ Cloud แต่เมื่อโรงงานหนึ่งมีทั้ง Edge Computer หลายสิบเครื่อง, on-premise server และบัญชี cloud ผู้ให้บริการหลายราย คำถามไม่ได้เป็นสองทางเลือกอีกต่อไป และเกิดปัญหาใหม่: ภาระการดูแลระบบที่กระจัดกระจาย (distributed sprawl) และ Silo ของข้อมูลที่ย้ายระหว่างกันไม่ได้ แนวคิดที่ตอบโจทย์นี้ในช่วงหลายปีที่ผ่านมาคือ Cloud Continuum — มองทรัพยากรคอมพิวติ้งทั้งหมดขององค์กรเป็น "ช่วงสเปกตรัมต่อเนื่อง" จาก on-premise edge ถึง public cloud ที่เชื่อมถึงกันด้วยเครือข่ายซอฟต์แวร์ (SDN) และ 5G แทนที่จะเป็นกล่องแยกส่วน งาน (workload) สามารถถูกวาง (place) และย้าย (migrate) ตามนโยบาย เช่น latency, อธิปไตยของข้อมูล (sovereignty) และความทนทาน ภาพประกอบ: การวาง workload บน continuum — แกนนอนคือเพดาน latency ที่งานยอมรับได้ (log scale) แกนตั้งคือประโยชน์จาก elasticity งานขวาบน (ฝึกโมเดล AI) ได้ประโยชน์จากคลาวด์มากที่สุด ส่วนงานซ้ายล่าง (motion control) ต้องอยู่ edge เสมอ จาก "เลือกที่" สู่ "กำหนดนโยบาย": วิธีคิดแบบ Continuum จุดเปลี่ยนสำคัญของมุมมองแบบ continuum คือการเปลี่ยนจากคำถาม "งานนี้ควรอยู่ที่ไหน" เป็น "นโยบายอะไรกำหนดว่างานนี้ควรอยู่ที่ไหน" ตัวอย่างเช่น: นโยบาย คำถามที่นโยบายตอบ ผลลัพธ์ต่อการวางงาน Latency ceiling งานยอมรับ delay เกิน X ms ได้หรือไม่? > 100 ms → ขึ้นคลาวด์ได้; < 10 ms → ต้องอยู่ edge/fog Data gravity ข้อมูลเกิดใหม่เร็วแค่ไหน และผู้บริโภคอยู่ไหน? ข้อมูล 1 kHz ต้องกรองที่ edge ก่อนส่งต่อ…
Read More
How-to: วางระบบ Zero-Touch Provisioning (ZTP) สำหรับ Edge Gateway นับพันเครื่อง — จาก Voucher ถึงการเปลี่ยนอุปกรณ์เสียกลางดึก

How-to: วางระบบ Zero-Touch Provisioning (ZTP) สำหรับ Edge Gateway นับพันเครื่อง — จาก Voucher ถึงการเปลี่ยนอุปกรณ์เสียกลางดึก

Article
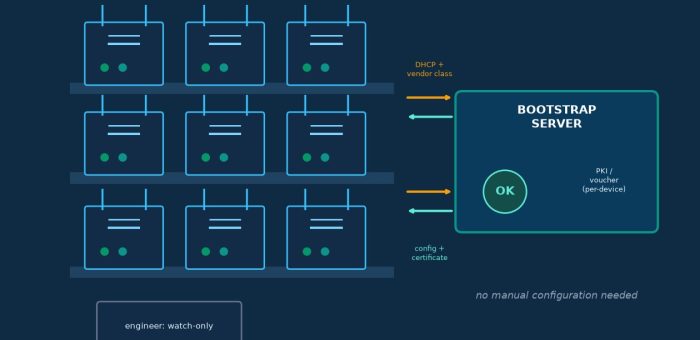
ปัญหาเดิมที่ทุกโครงการ IIoT ขนาดใหญ่เจอ: Onboarding อุปกรณ์ 500 เครื่องด้วยมือ ลองนึกภาพโครงการวาง Edge Gateway 200 เครื่องต่อโรงงาน 5 ไซต์ ช่างแต่ละคนต้องทำเหมือนกันหมด: เสียบสาย console เข้าอุปกรณ์ใหม่ ตั้งค่า IP ผ่าน terminal, แฟลชเฟิร์มแวร์เวอร์ชันที่ถูกต้อง, คัดลอกไฟล์ config ที่ต่างกันเล็กน้อยในแต่ละไซต์, สร้าง certificate สำหรับอุปกรณ์นั้น แล้วทดสอบว่าเชื่อมต่อได้จริง ครบวงจรประมาณ 30–60 นาทีต่อเครื่อง — คูณ 1,000 เครื่อง เท่ากับ คนงานหลายร้อยชั่วโมงของงานที่ทำซ้ำจนชำนาญความผิดพลาด และปัญหาไม่ได้จบที่การติดตั้งครั้งแรก: เมื่อพนักงานคนเดิมลาออก ไฟล์ config ที่ "อยู่ในเครื่องเท่านั้น" กลายเป็นหลักฐานลับที่ไม่มีใครรู้ การเปลี่ยนอุปกรณ์เสียกลางดึกต้องรอผู้เชี่ยวชาญเฉพาะทาง และการตรวจสอบว่าทั้ง 1,000 เครื่องยังใช้ config ตรงตามมาตรฐาน (Configuration Drift) แทบเป็นไปไม่ได้ คำตอบของปัญหานี้คือ Zero-Touch Provisioning (ZTP) — แนวทางที่อุปกรณ์ใหม่จากโรงงานผู้ผลิตสามารถ "ตื่นมาแล้วหาทางเข้าระบบเองได้" โดยช่างเพียงเสียบไฟและสาย LAN หลักการทำงาน: อุปกรณ์ต้องพิสูจน์ตัวเองก่อนรับ Config แนวคิดของ ZTP ถูกกำหนดเป็นมาตรฐานเปิด เช่น SZTP (RFC 8572) ซึ่งอธิบายกระบวนการ Bootstrap ที่ปลอดภัย หลักการสำคัญคือ อุปกรณ์ที่ยังไม่มี config ต้องไม่สามารถรับ config จากใครก็ได้ที่อ้างว่าเป็นเซิร์ฟเวอร์ และเซิร์ฟเวอร์ก็ต้องมั่นใจว่าอุปกรณ์ที่ขอ config เป็นของคุณจริง ไม่ใช่อุปกรณ์ปลอมที่ถูกแทรกเข้ามา ภาพประกอบ: ลำดับ Bootstrap แบบ Zero-Touch ตามแนว RFC — อุปกรณ์ขอ config ผ่าน DHCP option, พิสูจน์ความเป็นเจ้าของด้วย voucher, รับเฟิร์มแวร์และ config ผ่านช่องทางเข้ารหัส แล้วเข้าร่วม fleet โดยอัตโนมัติ ขั้นตอนสำคัญคือ Voucher — เอกสารดิจิทัลที่ผู้ผลิตอุปกรณ์ลงนามฝากไว้กับผู้ซื้อ (เจ้าของล็อตการผลิต) เมื่ออุปกรณ์ขอ config จาก registrar มันจะพิสูจน์ตัวผ่าน voucher นี้ และทั้งสองฝ่ายตรวจสอบกันและกันผ่าน PKI แบบรายเครื่อง (per-device certificate) ที่ถูกฝังตั้งแต่กระบวนการผลิต How-to: วางระบบ ZTP ในโรงงาน…
Read More
PREEMPT_RT ใน Linux Kernel 6.12: เมื่อ Edge Computer ของโรงงานกลายเป็น Real-Time Machine อย่างสมบูรณ์

PREEMPT_RT ใน Linux Kernel 6.12: เมื่อ Edge Computer ของโรงงานกลายเป็น Real-Time Machine อย่างสมบูรณ์

Article
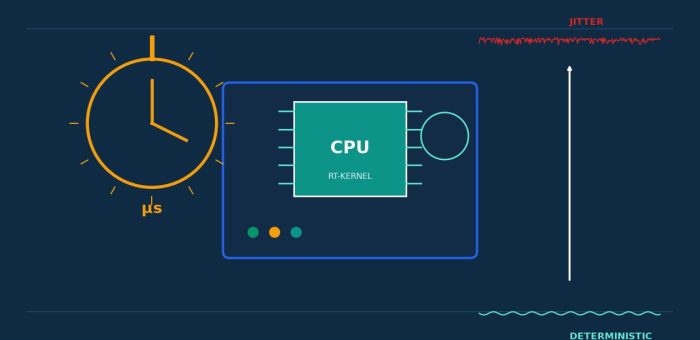
ทำไมโรงงานปี 2026 ยังต้องกังวลเรื่อง "ความหน่วงแบบสุ่ม" บน Edge Computer เมื่อคุณย้ายงานควบคุม การวิเคราะห์ หรือการตรวจจับความผิดปกติ จาก PLC/DCS ลงมาที่ Edge Computer ที่ใช้ระบบปฏิบัติการ Linux ทั่วไป สิ่งหนึ่งที่มักถูกมองข้ามคือ Scheduling Latency แบบสุ่ม (Jitter) — ความหน่วงระหว่าง "เหตุการณ์เกิดขึ้น" กับ "โปรแกรมได้รับโอกาสประมวลผล" ซึ่งบน Linux มาตรฐานอาจแกว่งจากไมโครวินาทีหลักร้อย ไปจนถึง หลายสิบมิลลิวินาที เมื่อระบบพร้อมกันรับภาระงานอื่น เช่น การเข้ารหัส TLS, การบีบอัดไฟล์ log, หรือการอัปเดตฐานข้อมูล local สำหรับ Dashboard หรือ Report ค่า Jitter ระดับนี้ไม่ใช่ปัญหา แต่ถ้างานนั้นคือ การปิด Interlock ภายใน 2 มิลลิวินาที, การสุ่มตัวอย่างแรงสั่นสะเทือน 1,000 ครั้ง/วินาทีแบบ sync กับมุม shaft, หรือการควบคุม Motion แบบ Soft Motion — Latency ที่แกว่ง 30 มิลลิวินาทีโดยไม่ทราบล่วงหน้า อาจหมายถึงชิ้นงานเสีย หรือแย่กว่านั้นคือความเสียหายต่อเครื่องจักร คำตอบที่วงการ Automation ใช้กันมาหลายสิบปีคือ RTOS (Real-Time Operating System) เฉพาะทางบน MCU แต่ปัญหาเปลี่ยนไปเมื่อ Edge AI, Protocol Gateway และ Container เข้ามาอยู่ในตู้คอนโทรลเดียวกัน — คุณต้องการทั้ง Ecosystem ของ Linux (Driver, Library, Toolchain) และ Determinism ของ RTOS ในเครื่องเดียว PREEMPT_RT ใน Linux Kernel 6.12: จุดจบของการติดตั้ง Patch เอง เหตุการณ์สำคัญที่เปลี่ยนเกมในช่วงปลายปี 2024 คือการประกาศรวมแพตช์ PREEMPT_RT เข้าสู่ Linux Kernel 6.12 (หลังพัฒนาต่อเนื่องกว่า 20 ปี) ทำให้ Kernel หลักสามารถเปิดโหมด Fully Preemptible ได้อย่างสมบูรณ์ และ 6.12 ยังเป็น…
Read More
Wi-Fi HaLow (IEEE 802.11ah): Wi-Fi Sub-GHz ระยะกิโลเมตรสำหรับ IIoT — เมื่อ LoRaWAN ช้าเกิน แต่ Wi-Fi ปกติถึงไม่หมด

Wi-Fi HaLow (IEEE 802.11ah): Wi-Fi Sub-GHz ระยะกิโลเมตรสำหรับ IIoT — เมื่อ LoRaWAN ช้าเกิน แต่ Wi-Fi ปกติถึงไม่หมด

Article
Wi-Fi ของโรงงานที่ทะลุไปไกลกว่าที่คิด ทุกครั้งที่ทีมงาน Honey Corporation เข้าไปสำรวจหน้างานลูกค้าอุตสาหกรรม เรามักพบว่าปัญหาอันดับหนึ่งของการวางระบบเซ็นเซอร์ไร้สายไม่ใช่ตัวเซ็นเซอร์ แต่คือ การเชื่อมต่อ — โรงงานหนึ่งแห่งอาจมีท่อส่งวัสดุยาวเหยียดหลายกิโลเมตร คลังวัตถุดิบกลางแจ้ง หรือโรงเรือนเพาะปลูกที่อยู่นอกรัศมี Wi-Fi ปกติ ในขณะที่ LPWAN อย่าง LoRaWAN ตอบโจทย์ระยะไกลได้ดี แต่แลกมากับความเร็วหลัก kbps และ topology ที่ต้องมี gateway แปลงโปรโตคอล มาตรฐาน Wi-Fi HaLow (IEEE 802.11ah) คือคำตอบที่อยู่ตรงกลาง — วิศวกรหลายคนยังไม่คุ้นเคย เพราะมันถูกออกแบบมาเพื่อ IoT โดยเฉพาะตั้งแต่ต้น ไม่ใช่ Wi-Fi ที่ถูกดัดแปลงให้ประหยัดพลังงานในภายหลัง ภาพประกอบ: HaLow AP เดียวดูแลเซ็นเซอร์หลายพันโหนดในรัศมีระดับกิโลเมตรผ่านคลื่น Sub-GHz — ภาพโดยทีมงาน Honey Corporation เจาะลึกเทคนิค: ทำไม Sub-GHz + แบนด์วิดท์แคบถึงไกลกว่า หัวใจของ HaLow อยู่ที่การใช้ย่านความถี่ Sub-GHz (902–928 MHz ในสหรัฐ / 920–923 MHz ในไทย) แทนย่าน 2.4 GHz หรือ 5 GHz ของ Wi-Fi ปกติ ผลลัพธ์ที่ได้คือ: Path Loss ต่ำกว่า — คลื่นความถี่ต่ำเสื่อมสภาพน้อยกว่า และทะลุโครงสร้างโลหะของอาคารอุตสาหกรรมได้ดีกว่า แบนด์วิดท์ช่องแคบ (1/2/4/8/16 MHz) — ความหนาแน่นของพลังงานต่อ Hz สูง ทำให้รับส่งได้ในสภาพสัญญาณอ่อน (low SNR) ที่ Wi-Fi ปกติทำไม่ได้ Tone Spacing แคบของ OFDM — ออกแบบให้ประหยัดพลังงานและทนสัญญาณรบกวน ซึ่งเป็นสภาพแวดล้อมปกติของสนามจริง Relay และ Sector Antenna — ขยายระยะเป็นหลายเท่าได้โดยไม่ต้องเปลี่ยนมาตรฐาน ตัวเลขอ้างอิงจากผู้ผลิตชิพรายใหญ่: HaLow SoC รุ่นใหม่ทำความเร็วสูงสุดได้ ~43 Mbps ส่วน AP เชิงพาณิชย์บางรุ่นอ้างระยะ 1–3 กิโลเมตร และรองรับ 1,000+ โหนดต่อ AP — เป็นจุดสมดุลที่ LoRaWAN ให้จำนวนโหนดได้ใกล้เคียง แต่ความเร็วต่ำกว่าหลายเท่าตัว คุณสมบัติ Wi-Fi…
Read More
Case Study: Store-and-Forward กู้ข้อมูลหายช่วงเน็ตหลุด — เมื่อ Edge Gateway ของโรงงานอาหารต้องเก็บข้อมูล HACCP ให้ครบ

Case Study: Store-and-Forward กู้ข้อมูลหายช่วงเน็ตหลุด — เมื่อ Edge Gateway ของโรงงานอาหารต้องเก็บข้อมูล HACCP ให้ครบ

Article
สถานการณ์: เมื่ออินเทอร์เน็ตโรงงานหลุดทุกเดือน ข้อมูลหายทุกครั้ง โรงงานแปรรูปอาหารแห่งหนึ่งในภาคกลางติดตั้งระบบเฝ้าระวังอุณหภูมิตู้แช่ด้วย IIoT Gateway ส่งข้อมูลขึ้นคลาวด์ทุก 30 วินาที เพื่อใช้ตรวจสอบย้อนหลังตามข้อกำหนด HACCP ปัญหาเกิดขึ้นเมื่อลิงก์อินเทอร์เน็ตของโรงงาน (ทั้ง fiber หลักและ 4G backup) ล่มพร้อมกันในช่วงพายุฤดูฝน เป็นเวลาราว 4 ชั่วโมง ข้อมูลช่วงนั้นหายไปทั้งหมด และทีมคุณภาพต้องเขียนรายงานอธิบายช่องว่างข้อมูลให้ผู้ตรวจสอบฟังทุกครั้ง ช่องว่างข้อมูลระหว่าง edge กับคลาวด์คือจุดที่พบปัญหาบ่อยที่สุดของระบบ IIoT (ภาพ: Honey Corporation) วินิจฉัยต้นตอ: สถาปัตยกรรมสมมติว่าเครือข่ายไม่มีวันล่ม การวิเคราะห์พบว่า gateway เดิมออกแบบแบบ "fire-and-forget" คืออ่านค่าเซ็นเซอร์แล้วส่งขึ้นคลาวด์ทันที หากส่งไม่สำเร็จก็ปล่อยข้อมูลนั้นหายไป ไม่มีการเก็บสำรองใดๆ บนตัวเครื่อง สถาปัตยกรรมลักษณะนี้ยอมรับได้กับ dashboard ดูสภาพแวดล้อมทั่วไป แต่ไม่เกิดผลกับงานที่ต้องมีหลักฐานข้อมูลต่อเนื่องตามกฎระเบียบ ทางแก้: Store-and-Forward บน Edge Gateway หลักการคือข้อมูลต้อง "เขียนลงดิสก์สำเร็จก่อน" แล้วจึงส่ง หากส่งไม่ได้ให้เก็บต่อในคิวจนกว่าเครือข่ายกลับมา ส่วนประกอบสำคัญมี 4 อย่าง Local persistent queue เก็บข้อมูลเป็นไฟล์บนดิสก์ gateway (เช่น embedded database หรือ log-structured storage) แยกจาก RAM เพื่อรอดจากไฟฟ้าดับ Send-then-acknowledge ข้อมูลถูกลบออกจากคิวเมื่อ server ปลายทางตอบรับสำเร็จเท่านั้น ไม่ใช่แค่ส่งออกไปแล้ว Circular buffer policy กำหนดขนาดคิวสูงสุดและนโยบายเมื่อเต็ม เช่น เขียนทับข้อมูลเก่าที่สุด หรือหยุดรับและเปิด alarm Timestamp ที่ต้นทาง ประทับเวลา ณ จุดอ่านค่าเซ็นเซอร์ ไม่ใช่เวลาที่ส่งสำเร็จ เพื่อให้ข้อมูลย้อนหลังยังถูกต้อง MQTT QoS 1 ร่วมกับ persistent session ช่วยให้ broker และ client จัดการข้อความค้างส่งได้อย่างเป็นระบบ (ภาพ: Honey Corporation) ในทางโปรโตคอล การเลือกใช้ MQTT ระดับ QoS 1 ร่วมกับ persistent session และการตั้งค่า message expiry interval ช่วยให้ broker ทำหน้าที่คล้ายกันในระดับหนึ่ง แต่สำหรับ outage ยาวหลายชั่วโมง การมีคิวบนดิสก์ของ gateway เองยังจำเป็น เพราะไม่ต้องพึ่ง TCP connection ที่ต้องเชื่อมต่อใหม่ทั้งหมด…
Read More
WebAssembly (Wasm) ที่ Edge ของโรงงาน: บทวิเคราะห์ Container Alternative ที่ Cold Start ต่ำกว่า 1 ms

WebAssembly (Wasm) ที่ Edge ของโรงงาน: บทวิเคราะห์ Container Alternative ที่ Cold Start ต่ำกว่า 1 ms

Article
ทำไมโรงงานปี 2026 ถึงพูดถึง Wasm ที่ Edge หลายทีมที่ดูแลระบบ IIoT คุ้นเคยกับการ deploy โค้ดลง Edge Gateway ด้วยสองทางเลือกคลาสสิก คือคอมไพล์โปรแกรมลง OS ตรงๆ หรือห่อด้วย Linux Container แต่ทั้งสองวิธีมีข้อจำกัดที่เจ็บปวดเมื่อเครื่อข่าย Edge โตขึ้น โค้ดที่คอมไพล์ตรงๆ ย้ายระหว่างสถาปัตยกรรม CPU ไม่ได้ ส่วน Container กินทรัพยากรเริ่มต้นค่อนข้างมากและมีพื้นที่โจมตี (attack surface) กว้าง WebAssembly หรือ Wasm คือ binary format มาตรฐานเปิดที่แก้ปัญหาเหล่านี้ได้พร้อมกัน ตัวเลขจาก State of WebAssembly Survey ปี 2026 ชี้ว่าผู้ใช้งานจริงใน production ขึ้นไปถึง 67% เพิ่มจาก 47% ในปี 2024 และเป็นครั้งแรกที่การใช้งานฝั่ง server-side แซงการใช้ในเบราว์เซอร์ โดย 52% ของ deployment ใช้งานในสภาพแวดล้อมที่ไม่ใช่เบราว์เซอร์ Edge Gateway คือจุดที่เหมาะที่สุดในการรัน Wasm module เพราะเป็นชั้นที่ต้องการทั้งความปลอดภัยและการจัดการโค้ดหลากหลายสถาปัตยกรรม CPU (ภาพ: Honey Corporation) Wasm แตกต่างจาก Container ตรงไหน หัวใจของ Wasm คือ sandbox ระดับสถาปัตยกรรมที่ออกแบบมาตั้งแต่แรก โมดูล Wasm แต่ละตัวทำงานแยกจากกันโดยสิ้นเชิง และไม่สามารถเข้าถึงไฟล์ เครือข่าย หรือ hardware ใดๆ ได้เลยจนกว่า host จะมอบสิทธิ์ (capability) ให้อย่างชัดเจน ลักษณะเช่นนี้ต่างจาก Container ที่ process ภายในแชร์ kernel ของ host และเคยมีช่องโหว่ container escape หลายครั้งในอดีต มิติเปรียบเทียบ Linux Container Wasm Module Cold Start500 ms ถึง 2 วินาทีต่ำกว่า 1 ms Memory ขั้นต่ำ100 MB ขึ้นไป1–10 MB ความสามารถพอร์ตตาบิลิตี้ผูกกับ OS และ CPU archbinary…
Read More
บทวิเคราะห์: Wearable Gas Detection และ Lone Worker Protection — เทคโนโลยีสวมใส่ที่พาคนกลับบ้านอย่างปลอดภัย

บทวิเคราะห์: Wearable Gas Detection และ Lone Worker Protection — เทคโนโลยีสวมใส่ที่พาคนกลับบ้านอย่างปลอดภัย

Article
ในบรรดาเทคโนโลยีสวมใส่ (Wearables) ทั้งหมดที่เข้ามาในโรงงาน มีอยู่กลุ่มหนึ่งที่มีสถานะพิเศษ: มันไม่ได้มาเพื่อเพิ่มผลิตภาพ แต่มาเพื่อ พาคนกลับบ้านอย่างปลอดภัย — กลุ่มนั้นคือเครื่องตรวจวัดก๊าซแบบสวมใส่ (Wearable Gas Detection) และระบบคุ้มครองพนักงานที่ทำงานโดดเดี่ยว (Lone Worker Protection) บทความนี้เป็นบทวิเคราะห์มุมมองของผู้ติดตั้งระบบ — ทำไมเราเชื่อว่าสองเทคโนโลยีนี้จะกลายเป็น "มาตรฐานขั้นต่ำ" ของโรงงานไทยในอีกไม่กี่ปีข้างหน้า เงื่อนไขที่ต้องครบก่อน และกับดักที่เราเห็นจากหน้างานจริง ชุดอุปกรณ์ป้องกันสำหรับงานในที่ว่างแคบ (Confined Space) — ที่ซึ่งบรรยากาศอาจเปลี่ยนเป็นอันตรายถึงชีวิตได้ภายในนาที (ภาพ: Wikimedia Commons, CC BY 2.0) ทำไมเรื่องนี้ดึงดันกว่าที่คิด อุบัติเหตุจากบรรยากาศอันตรายมีลักษณะเฉพาะที่ทำให้มัน "ซ่อนตัว" จากการบริหารความเป็นธรรมดา: ก๊าซไม่มีสี ไม่มีกลิ่นบางชนิด — CO, H₂S ในระดับอันตรายอาจไม่มีสัญญาณเตือนธรรมชาติใด ๆ คนงานหมดสติก่อนรู้ตัวว่ามีอะไรผิดปกติ หน้าที่ว่างแคบเปลี่ยนสภาพเร็ว — บรรยากาศในถัง ท่อ หรือบ่อ อาจปลอดภัยตอนเปิดงาน แต่เปลี่ยนภายใน 10 นาทีจากกิจกรรมเช่นการขูดลอก การเชื่อม หรือแม้แต่การหมักของเศษอินทรีย์ Lone worker ไม่มีใครเห็น — พนักงานที่ทำงานกะคนเดียวที่สถานีปั๊ม โรงไฟฟ้าย่อย หรือห้องเครื่องชั้นล่าง ถ้าหมดสติจากก๊าซหรือสะดุดล้ม การค้นพบมักเกิดหลังผ่านไปหลายชั่วโมง — หน้าต่างทองของการช่วยชีวิตคือนาทีแรก ๆ ไม่ใช่ชั่วโมงแรก ๆ สามข้อนี้รวมกันทำให้ปัญหาไม่สามารถแก้ด้วย "การอบรม" เพียงอย่างเดียวได้ เพราะมันคือปัญหาของข้อมูลที่ไม่มีอยู่ ณ จุดที่ต้องตัดสินใจ เทคโนโลยีที่เปลี่ยนเกม เครื่องตรวจวัดก๊าซแบบสวมใส่รุ่นใหม่แตกต่างจากเครื่องตรวจวัดแบบถือคลาสสิกด้วย 3 จุด: ตัวเครื่องเล็กพอจะติดปกติ — ขนาดระดับติดเข็มขัดหรือแขนเสื้อ น้ำหนักไม่กี่ร้อยกรัม ทำให้สวมทั้งกะได้โดยไม่รบกวนการทำงาน จุดนี้สำคัญมาก เพราะเครื่องตรวจวัดที่ถูกฝากไว้ที่โต๊ะคือเครื่องที่ไม่ทำงาน เซ็นเซอร์ 4 ก๊าซมาตรฐาน — โดยทั่วไปครอบคลุม O₂ (ขาด/เกิน), ก๊าซระเหยได้ติดไฟ (LEL), CO และ H₂S ด้วยเซ็นเซอร์แบบ electrochemical, catalytic bead หรือ infrared แล้วแต่ชนิดก๊าซ อายุสองปีขึ้นไปต่อเซ็นเซอร์ เชื่อมต่อขึ้นคลาวด์ได้ — ผ่าน Wi-Fi, LTE-M/NB-IoT หรือ Bluetooth ผ่านโทรศัพท์ ทำให้ค่าวัดไหลไปถึงแดชบอร์ดความปลอดภัยแบบเรียลไทม์ พร้อมการแจ้งเตือนตามลำดับ (local alarm ที่ตัวเครื่อง → หัวหน้างาน → ศูนย์กลาง) สำหรับ lone worker ระบบสมัยใหม่จะเพิ่มชั้น "ตรวจจับคนหมดสติ"…
Read More