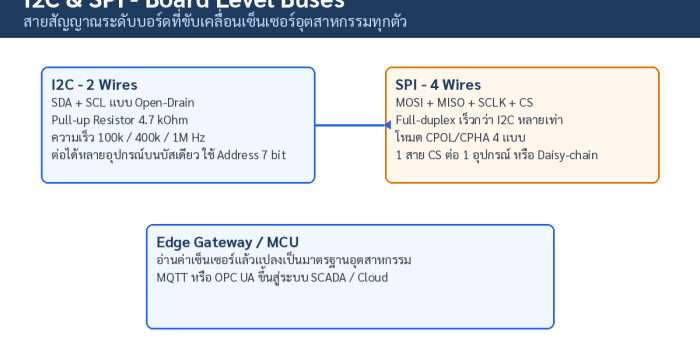
How-to: เชื่อมเซ็นเซอร์ I2C/SPI เข้าสู่ระบบ IIoT ใน 6 ขั้นตอน — จาก Pull-up Resistor ถึง MQTT บน Edge Gateway

How-to: เชื่อมเซ็นเซอร์ I2C/SPI เข้าสู่ระบบ IIoT ใน 6 ขั้นตอน — จาก Pull-up Resistor ถึง MQTT บน Edge Gateway

Article
ก่อนข้อมูลเซ็นเซอร์ตัวเดียวจะไปถึงหน้าจอ SCADA หรือ Dashboard บนคลาวด์ได้ มันต้องเดินทางผ่านสองบัสเล็กๆ ที่วิศวกรอิเล็กทรอนิกส์ทุกคนรู้จัก — I2C และ SPI ทั้งคู่เกิดในยุค 80s แต่ยังเป็นปากทางของเซ็นเซอร์อุตสาหกรรมส่วนใหญ่ที่ขายในท้องตลาดทุกวันนี้ บทความนี้สรุปวิธีเชื่อมสองบัสนี้เข้าสู่ระบบ IIoT อย่างเป็นขั้นตอน พร้อมกับดักที่เจอบ่อยในโรงงานจริง เข้าใจสองบัสให้ชัดก่อนออกแบบ I2C ใช้สายแค่ 2 เส้น (SDA, SCL) แบบ open-drain ต้องมีตัวต้านทาน pull-up เสมอ ระบุอุปกรณ์ด้วย address 7 หรือ 10 bit จึงต่อหลายเซ็นเซอร์บนบัสเดียวได้ แลกมาด้วยความเร็วที่ต่ำกว่า SPI และข้อจำกัดเรื่องความจุบัสรวมประมาณ 400 pF ซึ่งแปลว่าสายควรสั้นกว่า 1 เมตร ฝั่ง SPI ใช้ 4 เส้น (MOSI, MISO, SCLK, CS) สื่อสารแบบ full-duplex เร็วได้หลักสิบ MHz แต่ต้องมีสาย CS แยกทุกอุปกรณ์ ทำให้จำนวนขาโตตามจำนวนเซ็นเซอร์ ตารางเทียบ I2C กับ SPI แบบที่วิศวกรใช้ตัดสินใจก่อนลงมือออกแบบบอร์ด 6 ขั้นตอนจากบอร์ดต้นแบบสู่ระบบจริง เลือกเซ็นเซอร์และบัสให้ตรงงาน — ถ้าต้องการอ่านค่าถี่สูงเช่น ความสั่น 100 kHz ของ I2C อาจไม่พอ ให้ใช้ SPI หรือเซ็นเซอร์ที่มี ADC ในตัวแล้วส่งค่าสำเร็จรูป ออกแบบวงจรให้ถูกหลัก — คำนวณค่า pull-up ของ I2C จากความเร็วและความจุบัส (ยิ่งเร็วยิ่งต้องลดค่าตัวต้านทาน) จัดเส้นสัญญาณให้สั้นและห่างจากแหล่งสัญญาณรบกวนเช่นสายมอเตอร์ ทดสอบ signal integrity ก่อนขยายระบบ — ใช้ oscilloscope ดู rise time ของ SDA/SCL และ noise margin ปัญหาที่เจอบ่อยคือ pull-up อ่อนเกินไปทำให้ waveform ไม่ถึง threshold ในเวลาที่กำหนด ต่อระยะไกลอย่างถูกวิธี — เมื่อเซ็นเซอร์อยู่ไกลกว่าที่บัสบอร์ดรับได้ อย่ายืดสาย I2C ตรงๆ ให้ใช้ตัวแปลงระดับบัสเป็นลิงก์ทนทานก่อน เช่น differential transceiver หรือย้ายฝั่ง controller ไปอยู่ใกล้เซ็นเซอร์แล้วส่งข้อมูลดิจิทัลแทน เขียนไดรเวอร์ตาม register map…
Read More
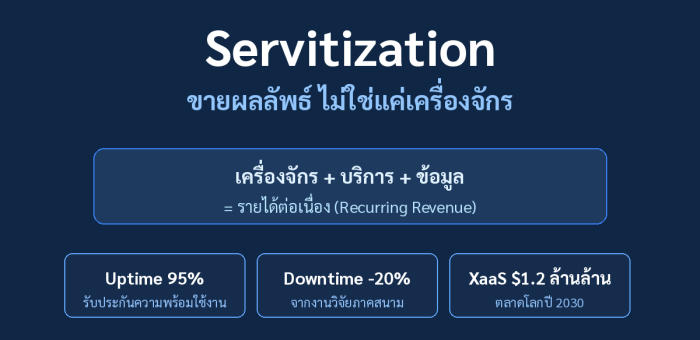
Servitization: Deep Dive จากขายเครื่องจักรสู่ขายชั่วโมงการผลิต — เมื่อ Uptime 95% กลายเป็นสินค้า

Servitization: Deep Dive จากขายเครื่องจักรสู่ขายชั่วโมงการผลิต — เมื่อ Uptime 95% กลายเป็นสินค้า

Article
"ลูกค้าไม่ได้อยากซื้อเครื่องเจาะ 1/4 นิ้ว แต่เขาอยากได้รูเจาะ 1/4 นิ้ว" — ประโยคคลาสสิกของศาสตร์การตลาดที่ Theodore Levitt แห่ง Harvard Business School เคยสรุปไว้ กำลังกลายเป็นความจริงของธุรกิจการผลิตทั่วโลกในชื่อ Servitization — การเปลี่ยนจาก "ขายของ" ไปเป็น "ขายผลลัพธ์" ไม่ว่าจะเป็นชั่วโมงการทำงานของเครื่องจักร ปริมาณก๊าซที่อัดได้ หรืออุณหภูมิที่ควบคุมคงที่ตลอด 24 ชั่วโมง แนวคิดนี้ไม่ใช่เรื่องใหม่ ผู้ผลิตเครื่องยนต์การบินรายใหญ่ของยุโรปเริ่มเสนอสัญญาแบบจ่ายตามชั่วโมงบิน (Power-by-the-Hour) มาตั้งแต่ทศวรรษ 1960 แต่สิ่งที่เปลี่ยนไปในยุค IIoT คือ ต้นทุนของการรู้ได้ทันทีว่าเครื่องจักรของลูกค้ากำลังทำงานอย่างไรลดลงจนทำให้สัญญาแบบ Outcome-based มีความเป็นไปได้เชิงพาณิชย์ งานวิจัยตลาดของ Spherical Insights & Consulting คาดว่าตลาด Everything-as-a-Service (XaaS) ทั่วโลกจะแตะระดับ 1.2 ล้านล้านดอลลาร์ภายในปี 2030 เส้นทาง 4 ขั้นของ Servitization Copperberg สถาบันวิจัยด้าน field service สรุปการเดินทางของผู้ผลิตสู่ servitization ไว้เป็น 4 ขั้น ซึ่งแต่ละขั้น "ย้ายความเสี่ยง" จากลูกค้ามาที่ผู้ผลิตมากขึ้นเรื่อยๆ — และต้องแลกด้วยข้อมูล ความไว้ใจ และความแม่นยำด้านปฏิบัติการที่สูงขึ้นตามไปด้วย เส้นทาง 4 ขั้นจากการขายเครื่องจักรสู่สัญญา Outcome-based (ที่มา: สังเคราะห์จาก Copperberg Field Service Research) ขั้นรูปแบบรายได้สิ่งที่ผู้ผลิตต้องมีความเสี่ยงของผู้ผลิต ขายเครื่องจักร + ค่าช่างรายชั่วโมงกระจุกตัว ณ วันขาย (One-off)ศักยภาพการผลิตและเครือข่ายตัวแทนต่ำ แต่รายได้แกว่งตามวัฏจักรเศรษฐกิจ สัญญาบริการ (Service Contract)ประจำ (Recurring) คาดการณ์ได้ระบบบริหารสัญญา อะไหล่ และตาราง PMปานกลาง — ตั้งราคาสัญญาผิด = ขาดทุนเงิน Performance-based Contractผูกกับ KPI เช่น Uptime 95%เซ็นเซอร์ IIoT + แพลตฟอร์มข้อมูล + Predictive Maintenanceสูง — พลาดเป้ามีค่าปรับตามสัญญา Outcome-based Contractจ่ายตามผลลัพธ์ เช่น ชั่วโมงการผลิต จำนวนชิ้นงานข้อมูลปลายทางครบวงจร + การบูรณาการกับ MES/ERP ของลูกค้าสูงสุด — ผู้ผลิตกลายเป็นผู้รับผิดชอบผลการผลิตจริง ตัวเลขที่ทำให้ผู้ผลิตกล้าเดินตามเส้นทางนี้ งานวิจัยภาคสนามที่ Copperberg รวบรวมไว้ให้ภาพชัดเจนสองกรณี กรณีแรกคือผู้ผลิตเครื่องจักรอุตสาหกรรมรายใหญ่ที่เปลี่ยนจากการซ่อมแบบมีปัญหาแล้วค่อยมา…
Read More
How-to: สร้าง Asset-Level Digital Twin ของเครื่องจักรเดี่ยวใน 6 ขั้นตอน — จาก P&ID สู่โมเดลที่ทำนายได้

How-to: สร้าง Asset-Level Digital Twin ของเครื่องจักรเดี่ยวใน 6 ขั้นตอน — จาก P&ID สู่โมเดลที่ทำนายได้

Article
หลายโรงงานอยากมี Digital Twin แต่เริ่มไม่ถูก — พยายามจำลอง "ทั้งโรงงาน" ตั้งแต่วันแรก แล้วโครงการก็จบก่อนเริ่ม ความจริงคือ Digital Twin ที่สร้างคุณค่าได้จริงส่วนใหญ่เริ่มจากหน่วยที่เล็กที่สุดที่มีความหมายทางธุรกิจ: เครื่องจักรเดี่ยว (Asset-Level Digital Twin) — ปั๊มไฮโดรลิก คอมเพรสเซอร์ ตู้อบ หรือหุ่นยนต์เชื่อม ที่เมื่อหยุดแล้วสายการผลิตหยุดตาม บทความนี้คือคู่มือทีละขั้นตอนสำหรับวิศวกรและผู้จัดการโรงงาน ที่จะพาคุณสร้าง asset twin ตัวแรกให้สำเร็จภายใน 3-6 เดือน โดยไม่ต้องซื้ออะไรเกินจำเป็น ขั้นที่ 1: เลือก Asset ที่ "เจ็บที่สุด" — ไม่ใช่ที่ทันสมัยที่สุด เกณฑ์การเลือกควรใช้ criticality ไม่ใช่ความใหม่ของเครื่องจักร ใช้ผล FMEA (Failure Mode and Effects Analysis) หรือประวัติการเสียจริง 12 เดือนหลังสุด ถาม 3 คำถาม: (1) เครื่องนี้หยุดแล้วกระทบการผลิตมากแค่ไหน (2) อะไหล่หายากแค่ไหน (3) มี sensor ติดอยู่แล้วกี่จุด — เครื่องที่คะแนนสูงสุดคือตัวเริ่มที่ถูกต้อง ขั้นที่ 2: เก็บ "ข้อมูลฐาน" ให้ครบก่อนเขียนโค้ดแม้บรรทัดเดียว Asset twin ที่ดีต้องการข้อมูล 4 ชั้น ซึ่งมักกระจายอยู่ในหลายแผนก: ชั้นข้อมูล ตัวอย่าง แหล่งที่มา Geometryแบบ 3D CAD, P&ID, ผังการเดินสายแผนกวิศวกรรม, ผู้ผลิตเครื่อง Behaviorสมการ dynamics, กราฟประสิทธิภาพ, ค่าคงที่ตัวเครื่องDatasheet, คู่มือเครื่อง, ผลทดสอบ acceptance Telemetryค่า vibration, อุณหภูมิ, กระแสมอเตอร์, แรงดันPLC/SCADA ผ่าน OPC UA หรือ MQTT Knowledgeประวัติซ่อม, บันทึกช่าง, คู่มือ PMCMMS, logbook หน้างาน ภาพที่ 1: Asset-Level Digital Twin ประกอบด้วยข้อมูล 4 ชั้น — Geometry, Behavior, Telemetry และ Knowledge (ที่มา: Honey Corporation) ขั้นที่ 3: เชื่อมข้อมูลจริงเข้าโมเดล — อย่าคัดลอกมาเก็บใน…
Read More
บทวิเคราะห์: WebSocket แก่แล้วจริงหรือ — Head-of-Line Blocking, WebTransport บน QUIC และอนาคต Dashboard แบบ Real-Time ของโรงงาน

บทวิเคราะห์: WebSocket แก่แล้วจริงหรือ — Head-of-Line Blocking, WebTransport บน QUIC และอนาคต Dashboard แบบ Real-Time ของโรงงาน

Article
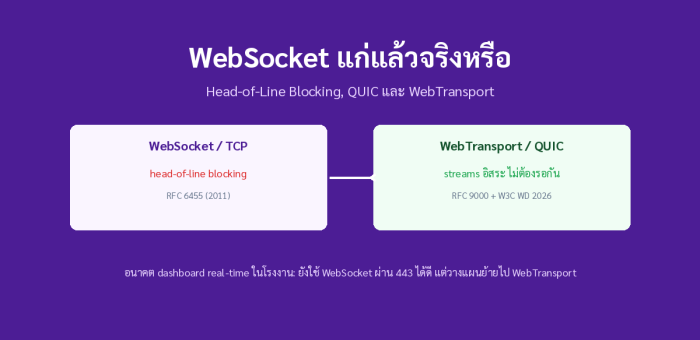
เกือบทุก dashboard แบบ real-time ในโรงงานที่คุณเคยเห็น — Andon board, OEE monitor, energy wall — ส่วนใหญ่ใช้เทคโนโลยีเดียวกันใต้ฝาครอบ: WebSocket โปรโตคอลจากปี 2011 (RFC 6455) ที่เปิดช่องทางสองทางถาวรบน TCP ทำให้เซิร์ฟเวอร์ push ข้อมูลหา browser ได้โดยไม่ต้อง polling คำถามคือ ในปี 2026 ที่ HTTP/3 และ QUIC (RFC 9000) กลายเป็นมาตรฐาน และ W3C เพิ่งประกาศ WebTransport Working Draft ใหม่ล่าสุดเมื่อมีนาคม 2026 — เราควรยังวางแผนสถาปัตยกรรม real-time บน WebSocket อยู่ไหม ปัญหาเก่าที่ยังอยู่: Head-of-Line Blocking จุดอ่อนของ WebSocket ไม่ได้อยู่ที่ตัวโปรโตคอลเอง แต่อยู่ที่ฐานรากคือ TCP ซึ่งรับประกันการส่งถึงตามลำดับ (in-order delivery) เมื่อ packet หนึ่งสูญหาย ทุก byte ที่มาถึงแล้วหลังจากนั้นต้องรอ retransmission แม้ข้อมูลเหล่านั้นจะเป็นคนละ message ก็ตาม — นี่คือ head-of-line blocking ใน dashboard ที่มีทั้งกราฟ trend ชุดใหญ่และ alarm วิกฤตที่ห้ามดองเลย การที่ alarm ติดค้างอยู่หลังกราฟที่กำลัง retransmit คือความเสี่ยงจริงของระบบ monitoring เมื่อ P3 สูญหาย: บน TCP ข้อมูลหลังจากนั้นต้องรอ แต่บน QUIC แต่ละ stream ไหลต่ออย่างอิสระ QUIC แก้ปัญหานี้ที่ราก: stream ที่แยกกันบน connection เดียวมีการรับประกันการส่งถึงแบบอิสระ ข้อมูลของ stream 2 ไม่ต้องรอ stream 1 ที่กำลังส่งใหม่ WebTransport ตาม Working Draft ของ W3C (มีนาคม 2026) ยกระดับความสามารถนี้ขึ้นสู่ browser API: รองรับหลาย stream, unidirectional stream, datagram แบบ…
Read More
Case Study: โรงงานที่ข้อมูล Production Order หายระหว่างทาง — เมื่อ AMQP 1.0 รับหน้าที่ Backbone ที่ MQTT ตอบไม่ได้

Case Study: โรงงานที่ข้อมูล Production Order หายระหว่างทาง — เมื่อ AMQP 1.0 รับหน้าที่ Backbone ที่ MQTT ตอบไม่ได้

Article
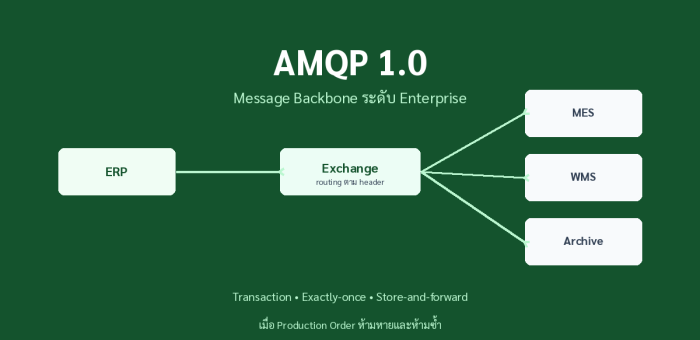
ปัญหาเริ่มจากสิ่งเล็กๆ: Production Order จาก ERP ถึง MES ค้างอยู่สถานะ “กำลังส่ง” เป็นครั้งที่สามในเดือน ทีม IT ตรวจ log พบว่า REST call ระหว่างระบบ timeout ช่วง 03:00 ตาม batch backup — ไม่มี retry ที่เชื่อถือได้ ไม่มีการันตีว่าข้อมูลถึงครบหรือไม่ และเมื่อลองส่งซ้ำ บางครั้ง order ถูกสร้างสองรายการ นี่คือจุดที่หลายโรงงานเริ่มมองหา message backbone ระดับ enterprise แทนการเขียน point-to-point interface เพิ่มเรื่อยๆ ทำไม MQTT อย่างเดียวไม่พอ MQTT เป็นโปรโตคอลที่เหมาะกับงาน telemetry อย่างยิ่ง: header เล็ก 2 ไบต์, QoS 0–2, retained message และ last will สำหรับอุปกรณ์จำนวนมาก แต่เมื่องานคือ เอกสารธุรกิจ (production order, work order, genealogy, invoice) สิ่งที่ต้องการไม่ใช่แค่ “ส่งถึง” แต่คือ: Transaction — จัดกลุ่มหลายข้อความให้สำเร็จหรือล้มพร้อมกัน Exactly-once delivery — ไม่มี duplicate, ไม่มีหาย Store-and-forward — ปลายทางล่ม ข้อความรอได้เป็นวันโดยไม่สูญ Rich routing — แยกปลายทางตาม header/topic/content แบบหลายชั้น AMQP แยกการ routing (Exchange) ออกจากการเก็บ (Queue) — ต่างจาก MQTT ที่ผูกกับ topic tree เดียว สถาปัตยกรรมที่เลือก: MQTT ที่ขอบเครือข่าย, AMQP ที่แกนหลัก ตามข้อมูลจำเพาะ OASIS AMQP 1.0 (มาตรฐาน ISO/IEC 19464) AMQP คือ wire-level binary protocol บน TCP ที่แยกการทำงานเป็น connection → session → link หลายชั้น…
Read More
Case Study: เมื่อน็อตหลุดหนึ่งตัวกลายเป็นงานเคลมทั้งล็อต — เส้นทางจากไขควงธรรมดาสู่ Smart Bolting ที่ย้อนกลับได้ทุกครั้ง

Case Study: เมื่อน็อตหลุดหนึ่งตัวกลายเป็นงานเคลมทั้งล็อต — เส้นทางจากไขควงธรรมดาสู่ Smart Bolting ที่ย้อนกลับได้ทุกครั้ง

Article
โรงงานประกอบชิ้นส่วนแห่งหนึ่งใน 304 Industrial Park ประสบปัญหาคลาสสิกที่หลายโรงงานคุ้นเคย — งานเคลมจากลูกค้าเรื่องน็อตหลุด ทั้งที่กระบวนการประกอบผ่านการตรวจสอบมาแล้ว เมื่อสืบสาเหตุ ทีมคุณภาพพบว่าไม่สามารถระบุได้ว่าน็อตตัวไหนถูกไขด้วยแรงบิดเท่าไร โดยใคร และเมื่อไร เพราะบันทึกที่มีคือเพียงเครื่องหมายบนหัวน็อตที่แสดงว่า "ผ่านการไขแล้ว" เท่านั้น กรณีนี้คือจุดเริ่มต้นของโครงการ Smart Bolting ที่เชื่อมไขควงอัจฉริยะ ระบบ AR และฐานข้อมูล Traceability เข้าด้วยกัน บทความนี้เล่าเส้นทางทั้งหมด ตั้งแต่วิเคราะห์ปัญหา ออกแบบโซลูชัน ไปจนถึงผลลัพธ์ที่วัดได้จริงหลังการใช้งาน ปัญหา: ความมั่นใจที่ไม่มีข้อมูลรองรับ การไขน็อตด้วยไขควงแบบ Clutch แบบดั้งเดิมมีข้อจำกัดสามชั้นที่ซ้อนกัน: ความแม่นยำของเครื่องมือ — ไขควง Clutch ทั่วไปมีค่าคลาดเคลื่อน ±6–10% จากค่าตั้ง และค่าคลาดเคลื่อนนี้ขยายตัวขึ้นเมื่อสภาพหัวไขควงสึกหรอ ไม่มีการบันทึกผลรายครั้ง — ระบบบันทึกแบบเดิมจดเฉพาะผลรวมของกะ ไม่ใช่รายน็อต ทำให้การเคลมย้อนกลับเป็นไปไม่ได้ พึ่งพาวินัยคน 100% — ลำดับการไข จำนวนรอบ และการตรวจซ้ำ อยู่ในความรับผิดชอบของ Operator แต่ละคน เมื่อมีงานเร่งหรือพนักงานใหม่ ความเสี่ยงจึงเพิ่มขึ้น เมื่อลูกค้าเริ่มเรียกเอกสารยืนยันกระบวนการ (PPAP Level 3) ที่ต้องการหลักฐานการควบคุมแรงบิดรายจุด โรงงานจึงตระหนักว่าระบบเดิมไม่เพียงพออีกต่อไป โซลูชัน: สามชั้นที่ทำงานร่วมกัน ภาพที่ 1: โครงสร้างระบบ Smart Bolting — ค่าแรงบิดไหลจากเครื่องมือสู่ฐานข้อมูล และวนกลับมาเป็นสถานะ OK/NG ที่หน้างานทันที (ที่มา: Honey Corporation) ชั้นที่ 1 — เครื่องมือวัดอัจฉริยะ เปลี่ยนไขควง Clutch เป็น Digital Torque Wrench ที่ส่งค่าแรงบิดและมุมการไขแบบ Real-time ผ่านการเชื่อมต่อไร้สาย ค่าคลาดเคลื่อนลดลงเหลือระดับ ±2% และที่สำคัญกว่านั้น — ทุกครั้งของการไขถูกบันทึกพร้อม Timestamp และรหัสเครื่องมือ การสอบเทียบ (Calibration) ตามมาตรฐาน ISO 6789 กำหนดให้ทำตามรอบ และระบบเตือนอัตโนมัติเมื่อใกล้ครบกำหนด ป้องกันการใช้เครื่องมือที่หมดอายุการสอบเทียบ ชั้นที่ 2 — ซอฟต์แวร์ควบคุมลำดับงาน ค่าจากเครื่องมือถูกส่งผ่าน Edge Gateway ด้วยโปรโตคอล MQTT เข้าสู่ฐานข้อมูล Traceability ที่ผูกกับหมายเลขซีเรียลของชิ้นงาน ระบบเทียบผลกับหน้าต่างค่าที่ยอมรับได้ (เช่น ±5% จากค่าเป้าหมาย) แล้วส่งสถานะกลับไปที่หน้างานภายในไม่กี่ร้อยมิลลิวินาที ภาพที่ 2: ลำดับ Error-Proofing — ระบบไม่เพียงแจ้งเตือน แต่บล็อกขั้นตอนถัดไปเมื่อพบ…
Read More
How-to: สร้าง Line-level Digital Twin ใน 6 ขั้นตอน — จาก Data Pipeline ตาม ISA-95 สู่ What-if Simulation ที่ใช้ตัดสินใจจริง

How-to: สร้าง Line-level Digital Twin ใน 6 ขั้นตอน — จาก Data Pipeline ตาม ISA-95 สู่ What-if Simulation ที่ใช้ตัดสินใจจริง

Article
คำถามที่เราได้ยินบ่อยที่สุดในปี 2026: "โรงงานเรามีเครื่องจักรอยู่แล้ว เซ็นเซอร์ติดบ้างแล้ว จะเริ่ม Digital Twin จากตรงไหนดี" — คำตอบจากรายงานแนวโน้มอุตสาหกรรมปี 2026 หลายสำนักชี้ไปทางเดียวกัน: อย่าเริ่มจากเครื่องจักรเดี่ยว ให้เริ่มจากไลน์ผลิต (Production Line) ทั้งเส้น เพราะนั่นคือระดับที่ความล้มเหลวของ Digital Twin ส่วนใหญ่เกิดขึ้น และเป็นระดับที่ให้ผลตอบแทนชัดที่สุด บทวิเคราะห์จากสื่ออุตสาหกรรมการผลิตไทย (Manage & Manufacturing Thailand, ก.พ. 2026) สรุปภาพรวมไว้ว่า Digital Twin กำลังก้าวพ้นช่วงทดลอง (Pilot Phase) สู่การใช้งานจริงในระดับองค์กร โดยเฉพาะการผสานกับ CMMS (ระบบจัดการซ่อมบำรุง), ERP, Edge Computing และเครือข่าย 5G เพื่อลด Downtime และเพิ่มประสิทธิภาพสายการผลิตอย่างเป็นรูปธรรม ไลน์ผลิตจริงคือ "วัตถุดิบ" ของ Line-level Digital Twin — โมเดลที่ดีต้องสะท้อนทั้งจังหวะเครื่องจักร คอขวด และพฤติกรรมคนงาน (ที่มา: Tjeerd Wiersma, CC BY 2.0) ทำไมต้อง Line-level ไม่ใช่ Asset-level Digital Twin ระดับเครื่องจักรเดี่ยว (Asset Twin) เหมาะกับงานวิเคราะห์การสั่นสะเทือนหรืออายุการใช้งานแบริ่ง แต่คำถามที่แท้จริงของผู้จัดการโรงงานอยู่ในระดับที่สูงขึ้น: ถ้าเพิ่มกำลังผลิต 15% จะเกิดอะไรขึ้นกับคอขวด? ถ้าเปลี่ยนสูตรวัตถุดิบ จุดไหนของไลน์จะรับไม่ได้? คำถามเหล่านี้ตอบไม่ได้ด้วยการดูเครื่องจักรเดี่ยว — ต้องจำลอง ปฏิสัมพันธ์ระหว่างเครื่องจักรทุกตัวในไลน์รวมถึง Buffer และรอบเปลี่ยน Batch มิติ Asset Twin (เครื่องจักรเดี่ยว) Line-level Twin (ทั้งไลน์ผลิต) คำถามหลักที่ตอบได้ เครื่องนี้กำลังจะพังไหม? ควรเปลี่ยนอะไหล่เมื่อไร? เพิ่มกำลังผลิตแล้วคอขวดย้ายไปอยู่ตรงไหน? ไลน์รับสูตรใหม่ได้ไหม? ข้อมูลที่ต้องมี Vibration, Temperature, Motor Current ของเครื่องเป้าหมาย ข้อมูลทุกสถานี + อัตราการไหลชิ้นงาน + เวลา Changeover + OEE รายสถานี ผู้ใช้หลัก ทีมซ่อมบำรุง (Maintenance) ผู้จัดการผลิต + Process Engineer + ฝ่ายวางแผน ตัวอย่างการใช้งานเด่น คาดการณ์ความเสียหายแบริ่งล่วงหน้า 2-4 สัปดาห์ ทดสอบ What-if ก่อนเพิ่มกำลังผลิต /…
Read More
ตลาด SCADA โต CAGR 10% ถึงปี 2032: อ่านตัวเลข MarketsandMarkets ให้ขาด และสิ่งที่โรงงานไทยต้องทำตอนนี้

ตลาด SCADA โต CAGR 10% ถึงปี 2032: อ่านตัวเลข MarketsandMarkets ให้ขาด และสิ่งที่โรงงานไทยต้องทำตอนนี้

Article
ตลาด SCADA ทั่วโลกกำลังเข้าสู่ช่วงเร่งตัว — รายงานฉบับล่าสุดจาก MarketsandMarkets (ตีพิมพ์กันยายน 2026) คาดการณ์ว่ามูลค่าตลาดระบบควบคุมและเฝ้าระวังแบบรวมศูนย์จะเติบโตจาก 13.94 พันล้านดอลลาร์สหรัฐในปี 2026 สู่ 24.69 พันล้านดอลลาร์ในปี 2032 ด้วยอัตราเติบโตเฉลี่ยต่อปี (CAGR) 10.0% ตัวเลขนี้ไม่ได้แค่บอกว่า "มีคนซื้อ SCADA มากขึ้น" แต่สะท้อนการเปลี่ยนแปลงเชิงโครงสร้างว่าระบบ SCADA กำลังถูกมองใหม่จาก "ห้องควบคุมของฝ่ายวิศวกรรม" ไปเป็น "แพลตฟอร์มข้อมูลกลางของทั้งองค์กร" ทีมงาน Honey Corporation ติดตั้งระบบ SCADA และระบบเฝ้าระวังในโรงงานอุตสาหกรรมมากว่าหลายโครงการ และสิ่งที่เราเห็นชัดในรอบ 2-3 ปีคือ ลูกค้าไม่ได้ถามแค่ "จอภาพเก็บค่าจาก PLC ได้กี่จุด" อีกต่อไป แต่ถามว่า "ข้อมูลจาก SCADA จะเชื่อมไปยังระบบ MES, ERP และ Dashboard ผู้บริหารได้อย่างไร" — คำถามที่เปลี่ยนไปนี้แหละคือแรงขับเคลื่อนตัวจริงของตลาด 10.0% ที่รายงานบอก อ่านตัวเลขให้ขาด: SCADA 10.0% หมายความว่าอย่างไร เราลองแยกแยะว่า CAGR 10.0% ในช่วง 2026-2032 มาจากไหน โดยเทียบกับรายงานย่อยที่เกี่ยวข้องจากสำนักเดียวกัน: ตลาด ปีฐาน → ปีเป้า ขนาดตลาด CAGR สิ่งที่บอกเรา SCADA โดยรวม 2026 → 2032 USD 13.94B → 24.69B 10.0% โครงสร้างพื้นฐาน + ซอฟต์แวร์โตพร้อมกันทั้งไลน์ SCADA in BIM (อาคาร) → 2032 USD 16.60B 21.5% อาคารอัจฉริยะ + Digital Twin ดันส่วนผสม BIM Power SCADA (ไฟฟ้า) → 2028 USD 2.9B 7.1% กลุ่มพลังงานเติบโตสม่ำเสมอ ไม่ใช่ตัวขับหลัก ที่มา: MarketsandMarkets, SCADA Market Global Forecast to 2032 (ก.ย. 2026); Power SCADA Market (2024); SCADA in Building Information…
Read More
How-to: MR Maintenance — คู่มือ 6 ขั้นตอนพาทีมซ่อมบำรุงเข้าสู่ยุค Mixed Reality + Digital Twin

How-to: MR Maintenance — คู่มือ 6 ขั้นตอนพาทีมซ่อมบำรุงเข้าสู่ยุค Mixed Reality + Digital Twin

Article
คุณเคยลองนึกภาพช่างที่เพิ่งทำงานได้สามเดือน กำลังยืนหน้าปั๊มไฮดรอลิกขนาดใหญ่ที่มีอาการสั่นผิดปกติ โดยไม่มีคู่มือ ไม่มีผู้เชี่ยวชาญ และไม่รู้ด้วยซ้ำว่าภายในตัวปั๊มมีชิ้นส่วนอะไรซ่อนอยู่บ้างหรือไม่? นี่คือสถานการณ์จริงในโรงงานส่วนใหญ่วันนี้ และเป็นสถานการณ์ที่ Mixed Reality (MR) Maintenance ถูกออกแบบมาแก้ ต่างจาก AR ทั่วไปที่แค่ “วางข้อความทับภาพจริง” MR ทำงานลึกกว่านั้น — มันสร้าง โมเดลสามมิติของชิ้นส่วนภายในเครื่องจักรที่ซ้อนทับกับตัวเครื่องจริง ราวกับมองทะลุ (X-Ray View) พร้อมดึงข้อมูล IoT แบบเรียลไทม์มาแสดงข้างชิ้นส่วนแต่ละชิ้น บทความนี้เป็นคู่มือ How-to แบบทีละขั้น สำหรับวิศวกรและผู้จัดการซ่อมบำรุงที่อยากพาทีมเข้าสู่ยุค MR อย่างเป็นระบบ ทำความเข้าใจก่อน: MR ต่างจาก AR ตรงไหน หลายคนใช้คำ AR/MR สลับกัน แต่ในเชิงเทคนิคมีเส้นแบ่งที่สำคัญ: AR Overlay ธรรมดาคือข้อมูลสองมิติที่ “ลอย” อยู่บนจอ ไม่รับรู้เรขาคณิตของสิ่งรอบตัว ส่วน MR ต้องมี Spatial Understanding — ระบบต้องสร้างแผนที่ความลึก (Depth Map) ของห้อง รู้ว่าพื้นอยู่ตรงไหน เครื่องจักรห่างกันกี่เมตร และตรึงโมเดลสามมิติให้ติดกับวัตถุจริงแม้ผู้สวมจะเดินรอบ รายงาน Technology Vision ของ Nokia อธิบายว่าความสามารถนี้คือหัวใจของ Spatial Computing ยุคใหม่ที่กำลังหลอมรวม Digital Twin เข้ากับงานหน้างานจริง งานวิจัยทางวิชาการ เช่น บทความจากวารสาร Applied Ergonomics และงานสำรวจ Light: Advanced Manufacturing (2025) พบว่างานบำรุงรักษาคือ use case ที่มีงานวิจัยรองรับหนาแน่นที่สุดของ HMD-based AR/MR ในภาคอุตสาหกรรม ด้วยเหตุผลง่ายๆ: มันเป็นงานที่ มือทั้งสองข้างต้องทำงาน สายตาต้องอยู่กับเครื่องจักร และความรู้อยู่ที่ไหนสักแห่งที่ไม่ใช่หน้างาน — สามข้อจำกัดที่จอแท็บเล็ตแก้ไม่ได้พร้อมกัน แผนภาพที่ 1: วงจรงาน MR Maintenance 6 ขั้นตอน — จากเปิด Work Order ด้วยการสแกน ถึงการปิดงานเข้าสู่ CMMS (ที่มา: Honey Corporation) How-to: 6 ขั้นตอนสู่ MR Maintenance ที่ใช้งานได้จริง ขั้นที่ 1 — เลือกเครื่องจักรนำร่องด้วยเกณฑ์ 3 ข้อ อย่าเริ่มกับเครื่องจักรที่ “ง่ายที่สุด” แต่เริ่มกับเครื่องที่ผ่านเกณฑ์นี้: (1)…
Read More
Case Study: Store-and-Forward กู้ข้อมูลหายช่วงเน็ตหลุด — เมื่อ Edge Gateway ของโรงงานอาหารต้องเก็บข้อมูล HACCP ให้ครบ

Case Study: Store-and-Forward กู้ข้อมูลหายช่วงเน็ตหลุด — เมื่อ Edge Gateway ของโรงงานอาหารต้องเก็บข้อมูล HACCP ให้ครบ

Article
สถานการณ์: เมื่ออินเทอร์เน็ตโรงงานหลุดทุกเดือน ข้อมูลหายทุกครั้ง โรงงานแปรรูปอาหารแห่งหนึ่งในภาคกลางติดตั้งระบบเฝ้าระวังอุณหภูมิตู้แช่ด้วย IIoT Gateway ส่งข้อมูลขึ้นคลาวด์ทุก 30 วินาที เพื่อใช้ตรวจสอบย้อนหลังตามข้อกำหนด HACCP ปัญหาเกิดขึ้นเมื่อลิงก์อินเทอร์เน็ตของโรงงาน (ทั้ง fiber หลักและ 4G backup) ล่มพร้อมกันในช่วงพายุฤดูฝน เป็นเวลาราว 4 ชั่วโมง ข้อมูลช่วงนั้นหายไปทั้งหมด และทีมคุณภาพต้องเขียนรายงานอธิบายช่องว่างข้อมูลให้ผู้ตรวจสอบฟังทุกครั้ง ช่องว่างข้อมูลระหว่าง edge กับคลาวด์คือจุดที่พบปัญหาบ่อยที่สุดของระบบ IIoT (ภาพ: Honey Corporation) วินิจฉัยต้นตอ: สถาปัตยกรรมสมมติว่าเครือข่ายไม่มีวันล่ม การวิเคราะห์พบว่า gateway เดิมออกแบบแบบ "fire-and-forget" คืออ่านค่าเซ็นเซอร์แล้วส่งขึ้นคลาวด์ทันที หากส่งไม่สำเร็จก็ปล่อยข้อมูลนั้นหายไป ไม่มีการเก็บสำรองใดๆ บนตัวเครื่อง สถาปัตยกรรมลักษณะนี้ยอมรับได้กับ dashboard ดูสภาพแวดล้อมทั่วไป แต่ไม่เกิดผลกับงานที่ต้องมีหลักฐานข้อมูลต่อเนื่องตามกฎระเบียบ ทางแก้: Store-and-Forward บน Edge Gateway หลักการคือข้อมูลต้อง "เขียนลงดิสก์สำเร็จก่อน" แล้วจึงส่ง หากส่งไม่ได้ให้เก็บต่อในคิวจนกว่าเครือข่ายกลับมา ส่วนประกอบสำคัญมี 4 อย่าง Local persistent queue เก็บข้อมูลเป็นไฟล์บนดิสก์ gateway (เช่น embedded database หรือ log-structured storage) แยกจาก RAM เพื่อรอดจากไฟฟ้าดับ Send-then-acknowledge ข้อมูลถูกลบออกจากคิวเมื่อ server ปลายทางตอบรับสำเร็จเท่านั้น ไม่ใช่แค่ส่งออกไปแล้ว Circular buffer policy กำหนดขนาดคิวสูงสุดและนโยบายเมื่อเต็ม เช่น เขียนทับข้อมูลเก่าที่สุด หรือหยุดรับและเปิด alarm Timestamp ที่ต้นทาง ประทับเวลา ณ จุดอ่านค่าเซ็นเซอร์ ไม่ใช่เวลาที่ส่งสำเร็จ เพื่อให้ข้อมูลย้อนหลังยังถูกต้อง MQTT QoS 1 ร่วมกับ persistent session ช่วยให้ broker และ client จัดการข้อความค้างส่งได้อย่างเป็นระบบ (ภาพ: Honey Corporation) ในทางโปรโตคอล การเลือกใช้ MQTT ระดับ QoS 1 ร่วมกับ persistent session และการตั้งค่า message expiry interval ช่วยให้ broker ทำหน้าที่คล้ายกันในระดับหนึ่ง แต่สำหรับ outage ยาวหลายชั่วโมง การมีคิวบนดิสก์ของ gateway เองยังจำเป็น เพราะไม่ต้องพึ่ง TCP connection ที่ต้องเชื่อมต่อใหม่ทั้งหมด…
Read More