How-to: สร้าง Line-level Digital Twin ใน 6 ขั้นตอน — จาก Data Pipeline ตาม ISA-95 สู่ What-if Simulation ที่ใช้ตัดสินใจจริง

How-to: สร้าง Line-level Digital Twin ใน 6 ขั้นตอน — จาก Data Pipeline ตาม ISA-95 สู่ What-if Simulation ที่ใช้ตัดสินใจจริง

Article
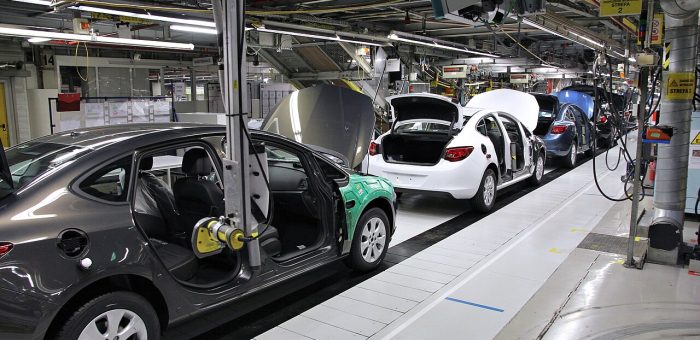
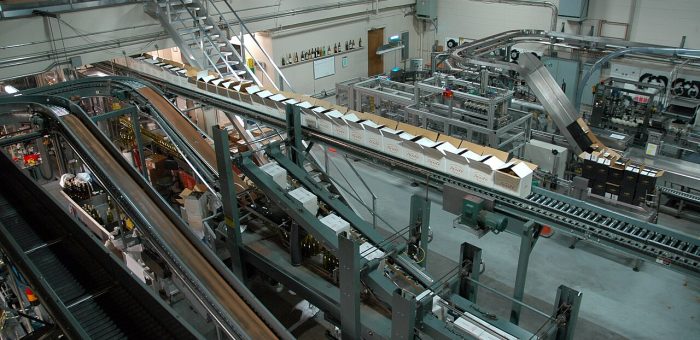
คำถามที่เราได้ยินบ่อยที่สุดในปี 2026: "โรงงานเรามีเครื่องจักรอยู่แล้ว เซ็นเซอร์ติดบ้างแล้ว จะเริ่ม Digital Twin จากตรงไหนดี" — คำตอบจากรายงานแนวโน้มอุตสาหกรรมปี 2026 หลายสำนักชี้ไปทางเดียวกัน: อย่าเริ่มจากเครื่องจักรเดี่ยว ให้เริ่มจากไลน์ผลิต (Production Line) ทั้งเส้น เพราะนั่นคือระดับที่ความล้มเหลวของ Digital Twin ส่วนใหญ่เกิดขึ้น และเป็นระดับที่ให้ผลตอบแทนชัดที่สุด บทวิเคราะห์จากสื่ออุตสาหกรรมการผลิตไทย (Manage & Manufacturing Thailand, ก.พ. 2026) สรุปภาพรวมไว้ว่า Digital Twin กำลังก้าวพ้นช่วงทดลอง (Pilot Phase) สู่การใช้งานจริงในระดับองค์กร โดยเฉพาะการผสานกับ CMMS (ระบบจัดการซ่อมบำรุง), ERP, Edge Computing และเครือข่าย 5G เพื่อลด Downtime และเพิ่มประสิทธิภาพสายการผลิตอย่างเป็นรูปธรรม ไลน์ผลิตจริงคือ "วัตถุดิบ" ของ Line-level Digital Twin — โมเดลที่ดีต้องสะท้อนทั้งจังหวะเครื่องจักร คอขวด และพฤติกรรมคนงาน (ที่มา: Tjeerd Wiersma, CC BY 2.0) ทำไมต้อง Line-level ไม่ใช่ Asset-level Digital Twin ระดับเครื่องจักรเดี่ยว (Asset Twin) เหมาะกับงานวิเคราะห์การสั่นสะเทือนหรืออายุการใช้งานแบริ่ง แต่คำถามที่แท้จริงของผู้จัดการโรงงานอยู่ในระดับที่สูงขึ้น: ถ้าเพิ่มกำลังผลิต 15% จะเกิดอะไรขึ้นกับคอขวด? ถ้าเปลี่ยนสูตรวัตถุดิบ จุดไหนของไลน์จะรับไม่ได้? คำถามเหล่านี้ตอบไม่ได้ด้วยการดูเครื่องจักรเดี่ยว — ต้องจำลอง ปฏิสัมพันธ์ระหว่างเครื่องจักรทุกตัวในไลน์รวมถึง Buffer และรอบเปลี่ยน Batch มิติ Asset Twin (เครื่องจักรเดี่ยว) Line-level Twin (ทั้งไลน์ผลิต) คำถามหลักที่ตอบได้ เครื่องนี้กำลังจะพังไหม? ควรเปลี่ยนอะไหล่เมื่อไร? เพิ่มกำลังผลิตแล้วคอขวดย้ายไปอยู่ตรงไหน? ไลน์รับสูตรใหม่ได้ไหม? ข้อมูลที่ต้องมี Vibration, Temperature, Motor Current ของเครื่องเป้าหมาย ข้อมูลทุกสถานี + อัตราการไหลชิ้นงาน + เวลา Changeover + OEE รายสถานี ผู้ใช้หลัก ทีมซ่อมบำรุง (Maintenance) ผู้จัดการผลิต + Process Engineer + ฝ่ายวางแผน ตัวอย่างการใช้งานเด่น คาดการณ์ความเสียหายแบริ่งล่วงหน้า 2-4 สัปดาห์ ทดสอบ What-if ก่อนเพิ่มกำลังผลิต /…
Read More
ตลาด SCADA โต CAGR 10% ถึงปี 2032: อ่านตัวเลข MarketsandMarkets ให้ขาด และสิ่งที่โรงงานไทยต้องทำตอนนี้

ตลาด SCADA โต CAGR 10% ถึงปี 2032: อ่านตัวเลข MarketsandMarkets ให้ขาด และสิ่งที่โรงงานไทยต้องทำตอนนี้

Article
ตลาด SCADA ทั่วโลกกำลังเข้าสู่ช่วงเร่งตัว — รายงานฉบับล่าสุดจาก MarketsandMarkets (ตีพิมพ์กันยายน 2026) คาดการณ์ว่ามูลค่าตลาดระบบควบคุมและเฝ้าระวังแบบรวมศูนย์จะเติบโตจาก 13.94 พันล้านดอลลาร์สหรัฐในปี 2026 สู่ 24.69 พันล้านดอลลาร์ในปี 2032 ด้วยอัตราเติบโตเฉลี่ยต่อปี (CAGR) 10.0% ตัวเลขนี้ไม่ได้แค่บอกว่า "มีคนซื้อ SCADA มากขึ้น" แต่สะท้อนการเปลี่ยนแปลงเชิงโครงสร้างว่าระบบ SCADA กำลังถูกมองใหม่จาก "ห้องควบคุมของฝ่ายวิศวกรรม" ไปเป็น "แพลตฟอร์มข้อมูลกลางของทั้งองค์กร" ทีมงาน Honey Corporation ติดตั้งระบบ SCADA และระบบเฝ้าระวังในโรงงานอุตสาหกรรมมากว่าหลายโครงการ และสิ่งที่เราเห็นชัดในรอบ 2-3 ปีคือ ลูกค้าไม่ได้ถามแค่ "จอภาพเก็บค่าจาก PLC ได้กี่จุด" อีกต่อไป แต่ถามว่า "ข้อมูลจาก SCADA จะเชื่อมไปยังระบบ MES, ERP และ Dashboard ผู้บริหารได้อย่างไร" — คำถามที่เปลี่ยนไปนี้แหละคือแรงขับเคลื่อนตัวจริงของตลาด 10.0% ที่รายงานบอก อ่านตัวเลขให้ขาด: SCADA 10.0% หมายความว่าอย่างไร เราลองแยกแยะว่า CAGR 10.0% ในช่วง 2026-2032 มาจากไหน โดยเทียบกับรายงานย่อยที่เกี่ยวข้องจากสำนักเดียวกัน: ตลาด ปีฐาน → ปีเป้า ขนาดตลาด CAGR สิ่งที่บอกเรา SCADA โดยรวม 2026 → 2032 USD 13.94B → 24.69B 10.0% โครงสร้างพื้นฐาน + ซอฟต์แวร์โตพร้อมกันทั้งไลน์ SCADA in BIM (อาคาร) → 2032 USD 16.60B 21.5% อาคารอัจฉริยะ + Digital Twin ดันส่วนผสม BIM Power SCADA (ไฟฟ้า) → 2028 USD 2.9B 7.1% กลุ่มพลังงานเติบโตสม่ำเสมอ ไม่ใช่ตัวขับหลัก ที่มา: MarketsandMarkets, SCADA Market Global Forecast to 2032 (ก.ย. 2026); Power SCADA Market (2024); SCADA in Building Information…
Read More
บทวิเคราะห์: Gartner Hype Cycle for Agentic AI 2026 — องค์กรใช้ AI Agent จริงแค่ 17% และนี่คือสิ่งที่โรงงานต้องรู้ก่อนกระโดดขึ้นรถ

บทวิเคราะห์: Gartner Hype Cycle for Agentic AI 2026 — องค์กรใช้ AI Agent จริงแค่ 17% และนี่คือสิ่งที่โรงงานต้องรู้ก่อนกระโดดขึ้นรถ

Article
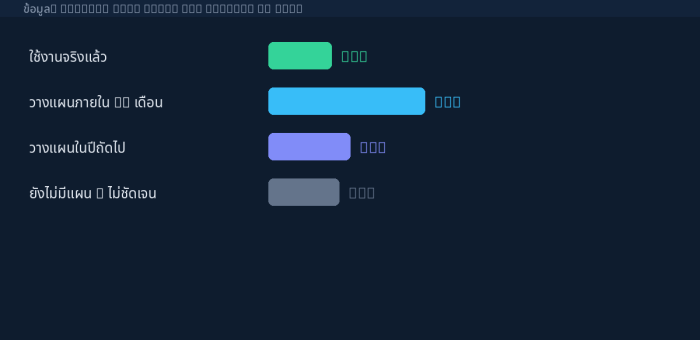
"AI Agent" คือคำที่ถูกพูดมากที่สุดในวงการเทคโนโลยีอุตสาหกรรมปี 2026 ทุกงานสัมมนามีประเด็นนี้ ทุกเวนเดอร์มีแพลตฟอร์มนี้ แต่ตัวเลขจริงจาก Gartner ฉายภาพที่ต่างออกไป: องค์กรที่ใช้ AI Agent ในการทำงานจริงมีเพียง 17% ในขณะที่ 42% วางแผนจะเริ่มภายใน 12 เดือน และอีก 22% มีแผนในปีถัดไป ช่องว่างระหว่าง "ความคาดหวัง" กับ "การใช้งานจริง" นี้แหละคือหัวใจของ Hype Cycle for Agentic AI 2026 ที่ Gartner เผยแพร่ล่าสุด และสำหรับโรงงานไทย นี่คือจังหวะที่ต้องตัดสินใจอย่างมีสติ ไม่ใช่ FOMO ตัวเลขบอกอะไร: 17% ที่เริ่มแล้วทำอะไรอยู่ กลุ่ม 17% ที่ใช้จริงส่วนใหญ่ยังโฟกัสที่ งานอัตโนมัติเฉพาะจุด (Automation เป็นหลัก) ยังไม่ใช่การเปลี่ยนแปลงกระบวนการทั้งองค์กร ซึ่งสอดคล้องกับสิ่งที่เห็นในโรงงานจริง: AI Agent ตัวแรกๆ ที่เวิร์กคือตัวที่ทำงานแคบและชัด เช่น อ่านค่าเซ็นเซอร์แล้วสรุปสรุปสถานะเครื่องจักร จัดลำดับงานซ่อมบำรุง หรือเตรียมรายงานกะกลางคืน 17% ใช้จริง / 42% จะเริ่มใน 12 เดือน / 22% ปีถัดไป — ความต่างขององค์กรจะเกิดในช่วง 12 เดือนข้างหน้า (ข้อมูล: Gartner, แผนภูมิ: Honey Corporation) 3 เทรนด์หลักที่ Gartner ระบุ — แปลเป็นภาษาโรงงาน เทรนด์ Gartner ความหมายต่อโรงงาน 1. AI Agent Adoption — 17% ใช้จริง, 42% ใน 12 เดือนหน้าต่างความได้เปรียบกำลังเปิด ผู้ที่เริ่มก่อนจะสะสมข้อมูลและบทเรียนก่อน แต่เริ่มผิดทางก็เสียเวลาเท่ากัน 2. Semi-Autonomous Deployment — มนุษย์ยังต้องควบคุมอย่ามองหา AI Agent ที่ "ตัดสินใจแทนทั้งหมด" ให้ออกแบบให้ Agent เสนอ + คนอนุมัติจุดวิกฤต เช่น การสั่งหยุดไลน์หรือเปลี่ยนแปลงพารามิเตอร์เครื่องจักร 3. Agent Washing — RPA เดิมแต่งตัวเป็น AI Agentตรวจสอบให้ชัดว่าแพลตฟอร์มที่ซื้อ "คิดและปรับตัว" จริง หรือแค่รันสคริปต์เดิมที่เปลี่ยนชื่อ — ถามดูกรณีที่ Agent…
Read More
How-to: ออกแบบ Edge-to-Cloud Data Pipeline สำหรับโรงงาน IIoT ใน 5 ขั้นตอน — จาก Data Source Inventory ถึงกฎการไหลของข้อมูล

How-to: ออกแบบ Edge-to-Cloud Data Pipeline สำหรับโรงงาน IIoT ใน 5 ขั้นตอน — จาก Data Source Inventory ถึงกฎการไหลของข้อมูล

Article
หลายโรงงานที่เริ่มทำ IIoT ติดอยู่ที่เดิม: เซ็นเซอร์ติดแล้ว ข้อมูลเห็นแล้ว แต่พอจะนำไปใช้จริงกลับพบว่าข้อมูลกระจัดกระจายในหลายระบบ รูปแบบไม่ตรงกัน และ dashboard ที่สวยงามนั้น ดูได้อย่างเดียว ไม่เชื่อมกับการตัดสินใจ รากของปัญหามักไม่ใช่เซ็นเซอร์หรือ AI แต่เป็น สายการไหลของข้อมูล (Data Pipeline) ที่ไม่ถูกออกแบบมาตั้งแต่ต้น บทความนี้เป็นคู่มือแบบทีละขั้น สำหรับวิศวกรที่ต้องการวาง pipeline จากเซ็นเซอร์ในสายการผลิต ผ่าน edge gateway ไปจนถึงคลาวด์อย่างเป็นระบบ — โดยไม่ต้องเป็น data engineer เต็มตัว สายการผลิตสมัยใหม่มีจุดเก็บข้อมูลกระจายอยู่ทั้งสาย — pipeline ที่ดีต้องรวมข้อมูลเหล่านี้ให้เป็นภาพเดียวก่อนส่งขึ้นคลาวด์ (ภาพ: Wikimedia Commons) ทำไมต้องเป็น Edge-to-Cloud (ไม่ใช่ส่งตรงขึ้นคลาวด์) ลองคำนวณง่ายๆ: มิเตอร์พลังงาน 200 จุด ส่งค่าทุก 1 วินาที รวมกว่า 17 ล้านค่าต่อวัน เพียงพอจะทำให้ฐานข้อมูลที่ออกแบบมาไม่ดีบวมในไม่กี่เดือน และการส่งข้อมูลดิบทั้งหมดขึ้นคลาวด์เป็นภาระ bandwidth ที่หลีกเลี่ยงได้ การคาดการณ์ของ Gartner ที่ชี้ว่าตลาด edge computing จะเติบโตจาก 131,000 ล้านดอลลาร์ (2023) สู่ 511,000 ล้านดอลลาร์ (2033) สะท้อนว่าโลกกำลังย้ายการประมวลผลกลับมาใกล้โรงงาน ไม่ใช่เพื่อแทนคลาวด์ แต่เพื่อส่งขึ้นคลาวด์เฉพาะ ข้อมูลที่มีคุณค่า Step 1: สำรวจและจัดทำ Inventory ของแหล่งข้อมูล ก่อนซื้ออุปกรณ์ใด ให้ทำ Data Source Inventory ให้ครบก่อน — ทุก PLC, VFD, มิเตอร์, เซ็นเซอร์ และไฟล์ที่คนงานบันทึกด้วยมือ ตัวอย่างตาราง: แหล่งข้อมูล โปรโตคอล อัตราการเก็บข้อมูล ปลายทางที่เหมาะสม PLC สายประกอบOPC UA100 msEdge สรุปผลก่อนส่ง Cloud VFD / มอเตอร์Modbus TCP1 วินาทีEdge (แจ้งเตือนความผิดปกติ) มิเตอร์พลังงานModbus RTU1 วินาทีEdge (สรุปเป็น profile 15 นาที) เซ็นเซอร์อุณหภูมิ/ความชื้นMQTT30 วินาทีEdge ส่งตรงขึ้น Cloud ตารางนี้จะบอกคุณเองว่าจุดรวมข้อมูล (aggregation point) ควรอยู่ที่ไหน และโปรโตคอลใดต้องการตัวแปลง Step 2: เลือก Edge Gateway ให้เหมาะกับงาน…
Read More
Asset Administration Shell (AAS): บัตรประจำตัวดิจิทัลมาตรฐาน IEC 63278 ของทุกสินทรัพย์ในโรงงาน

Asset Administration Shell (AAS): บัตรประจำตัวดิจิทัลมาตรฐาน IEC 63278 ของทุกสินทรัพย์ในโรงงาน

Article
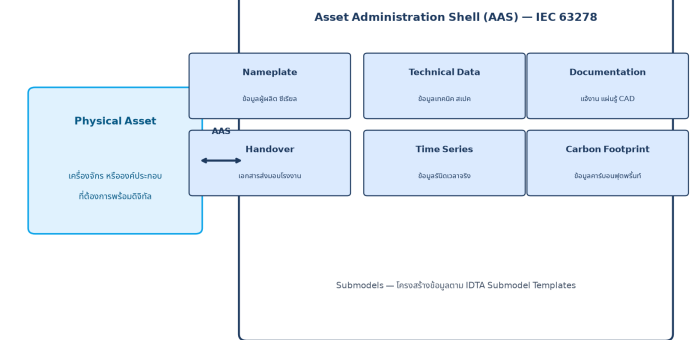
ถ้าถามว่าอะไรคือคอขวดที่แท้จริงของ Digital Twin ในปี 2026 คำตอบไม่ใช่การสร้างโมเดลสามมิติสวยงาม แต่คือการทำให้ข้อมูลของเครื่องจักรจากผู้ผลิตหลายสิบราย เข้าใจกันได้โดยไม่ต้องแปลเป็นภาษากลางทีละคู่ โจทย์นี้คือที่มาของ Asset Administration Shell หรือ AAS มาตรฐานที่ถูกขนานนามว่า "บัตรประจำตัวดิจิทัลมาตรฐานของทุกสินทรัพย์" ในขบวนการ Industrie 4.0 ของยุโรป AAS ถูกพัฒนาต่อยอดเป็นมาตรฐานสากล IEC 63278 ดูแลโดย Industrial Digital Twin Association (IDTA) ซึ่งมีสมาชิกรวมทั้งผู้ผลิตเครื่องจักรอุตสาหกรรมและผู้ให้บริการซอฟต์แวร์รายใหญ่ทั่วโลก แนวคิดหลักเรียบง่าย: ทุกสินทรัพย์ ไม่ว่าเครื่องจักร เซ็นเซอร์ ซอฟต์แวร์ หรือทั้งโรงงาน ควรมี "เปลือก" (Shell) ดิจิทัลที่อธิบายตัวเองด้วยโครงสร้างเดียวกัน ทำให้ระบบใดก็ตามอ่านความสามารถและข้อมูลของสินทรัพย์นั้นได้ทันที โดยไม่ต้องรู้จักผู้ผลิตเป็นการส่วนตัว โครงสร้าง AAS: สินทรัพย์จริงหนึ่งชิ้นมี Submodels มาตรฐานหลายด้าน — ภาพวาดโดยทีม Honey Corporation Submodels: หัวใจของความเข้ากันได้ ความแข็งแรงของ AAS อยู่ที่ระบบ Submodels ที่แบ่งข้อมูลของสินทรัพย์ออกเป็นมุมมองเฉพาะด้าน แต่ละ Submodel มีเทมเพลตมาตรฐานที่ IDTA เผยแพร่และดูแล ตัวอย่างเช่น Nameplate เก็บข้อมูลผู้ผลิตและหมายเลขซีเรียล, Technical Data เก็บสเปกการทำงาน, Documentation เก็บคู่มือและแบบ CAD, Handover Documentation เก็บเอกสารส่งมอบโรงงาน, Time Series Data เก็บค่าเซ็นเซอร์ย้อนหลัง และ Carbon Footprint เก็บข้อมูลคาร์บอนที่สำคัญขึ้นเรื่อยๆ ตามกระแส ESG การที่โครงสร้างพวกนี้เป็นมาตรฐานเปิดหมายความว่า ระบบ CMMS, MES, หรือแพลตฟอร์ม Digital Twin จากค่ายใดก็อ่านข้อมูลได้เหมือนกัน การเปลี่ยนผู้ให้บริการซอฟต์แวร์จึงไม่ได้แปลว่าต้องเสียข้อมูลไปทั้งกอง นี่คือสิ่งที่ต่างจาก data sheet แบบ PDF ที่มนุษย์อ่านอย่างเดียว เพราะ AAS ออกแบบมาเพื่อให้เครื่องอ่านเครื่องโดยตรง รองรับทั้งรูปแบบ JSON, XML, RDF และไฟล์แพ็กเกจ AASX ที่รวมไบนารีประกอบ เทคโนโลยีเดิมที่คุ้นเคย ยังใช้ได้ทั้งหมด จุดที่ทำให้ AAS ลงมือทำได้จริงคือมันไม่ได้มาแทนที่โปรโตคอลที่โรงงานใช้อยู่ แต่ทำงานร่วมกับ OPC UA ผ่าน companion specification, MQTT สำหรับข้อมูลเซ็นเซอร์แบบเบา และ REST API ตามสเปก OpenAPI สำหรับระบบคลาวด์…
Read More
Hybrid Twin: เมื่อ Physics-based Model จับมือ Machine Learning เพื่อโมเดลที่แม่นและทนทานกว่า

Hybrid Twin: เมื่อ Physics-based Model จับมือ Machine Learning เพื่อโมเดลที่แม่นและทนทานกว่า

Article
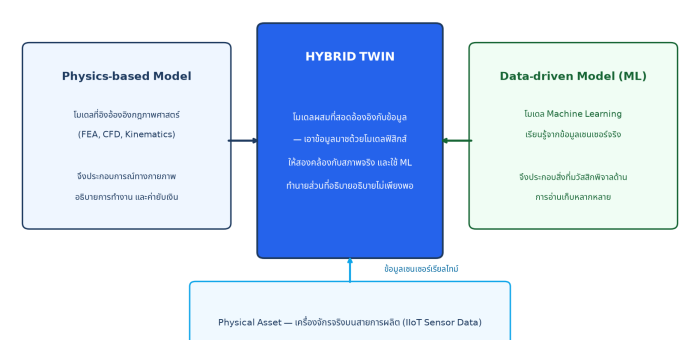
ในโครงการทำ Predictive Twin หลายโครงการที่เราเห็นล้มเหลว มีจุดตายตรงกันคือเลือกใช้ Machine Learning เพียงอย่างเดียว โมเดลทำนายแม่นยำในช่วงทดสอบ แต่พอเครื่องจักรเปลี่ยนสภาวะทำงาน ความแม่นยำก็ไถลลงจนใช้งานจริงไม่ได้ ในทางกลับกัน โมเดลฟิสิกส์ที่แม่นยำสุดๆ ก็มีข้อจำกัดเรื่องเวลาคำนวณและต้นทุนการสร้าง คำตอบที่งานวิจัยอุตสาหกรรมหันไปใช้กันมากขึ้นคือ Hybrid Twin — การผสานจุดแข็งของสองโลกเข้าไว้ในโมเดลเดียว ปัญหา: ทำไมโมเดลชนิดเดียวไม่พอ ลองนึกภาพการทำนายอุณหภูมิแบริ่งของมอเตอร์ไฟฟ้าขนาดใหญ่ วิธีฟิสิกส์ (Physics-based) คือสร้างโมเดลความร้อนและการสั่นสะเทือนจากสมการถ่ายเทความร้อนและพลศาสตร์ วิธีนี้เชื่อถือได้สูงเมื่ออยู่ในเงื่อนไขที่โมเดลออกแบบมา วิศวกรอธิบายได้ว่าทำไมค่าทำนายเป็นเช่นนั้น แต่การสร้างโมเดล FEA หรือ CFD ที่ละเอียดขึ้น มัคช์กับเครื่องจักรจริง ต้องใช้เวลาคำนวณนานและทรัพยากรจำนวนมาก ที่สำคัญข้อผิดพลาดเล็กๆ ในค่าสัมประสิทธิ์ เช่น สัมประสิทธิ์การนำความร้อนของวัสดุ สะสมกันเป็นความคลาดเคลื่อนของผลลัพธ์ ส่วนวิธีข้อมูล (Data-driven) อย่าง Deep Learning เรียนรู้จากข้อมูลเซ็นเซอร์จริงหลายหมื่นจุด ทำนายได้เร็วและแม่นในสภาวะที่เคยเห็น แต่โมเดลไม่เข้าใจกลไกเบื้องหลัง เมื่อเจอสภาวะใหม่ที่ไม่เคยมีในชุดข้อมูลฝึก เช่น เปลี่ยนวัตถุดิบ เปลี่ยนอัตราการผลิต หรือแว่วเสียงแปลกประหลาด โมเดลก็เดาผิดได้อย่างมั่นใจ งานวิจัยที่ตีพิมพ์ในวารสาร Procedia CIRP ปี 2022 เรียกปัญหานี้ว่าช่องว่างระหว่างสองกระบวนทัศน์ และเสนอว่าการผสานกันคือทางออกที่ยั่งยืนกว่า การจำลองทางฟิสิกส์อย่าง crash-test simulation แม่นยำแต่ต้องแลกกับเวลาคำนวณ — ที่มา: Wikimedia Commons (CC BY-SA) แนวทางแก้: โครงสร้างของ Hybrid Twin หลักคิดของ Hybrid Twin มีสามชั้นต่อกัน ชั้นแรกคือโมเดลฟิสิกส์แบบลดทอน (Reduced-order Model) ที่ย่อส่วนจากโมเดล FEA/CFD เต็มรูปแบบให้คำนวณได้เร็วขึ้นหลายเท่าตัว โดยยอมรับความคลาดเคลื่อนเล็กน้อย ชั้นที่สองคือโมเดลแทรกแซง (Correction Model) ที่เป็น Machine Learning หน้าที่เดียวคือเรียนรู้ "ส่วนต่าง" ระหว่างค่าทำนายของโมเดลฟิสิกส์กับค่าจริงจากเซ็นเซอร์ และชั้นที่สามคือวงจรสอบเทียบอัตโนมัติที่อัปเดตโมเดลแทรกแซงอย่างต่อเนื่องเมื่อข้อมูลใหม่ไหลเข้ามา โครงสร้าง Hybrid Twin: โมเดลฟิสิกส์ให้ความเข้าใจกลไก ML ชดเชยส่วนต่างจากข้อมูลจริง — ภาพวาดโดยทีม Honey Corporation ผลลัพธ์ที่ได้คือระบบที่ทำนายเร็วเท่า Machine Learning แต่ยังคงความน่าเชื่อถือนอกเงื่อนไขที่เคยเห็น เพราะเมื่อสภาวะเปลี่ยน โมเดลฟิสิกส์ยังจับพฤติกรรมหลักได้ ส่วน ML แค่ปรับค่าชดเชย แนวทางนี้ถูกนำไปใช้จริงในงานวิจัยระดับสากล เช่น โครงการ Horizon Europe ที่ใช้แนวคิด hybrid modeling ผสาน Digital Twin กับการผลิตจริง และงานวิจัยในวารสาร Journal of Engineering…
Read More
ISO 23247: มาตรฐาน Digital Twin Framework ที่ทำให้โรงงานพูดภาษาเดียวกัน

ISO 23247: มาตรฐาน Digital Twin Framework ที่ทำให้โรงงานพูดภาษาเดียวกัน

Article
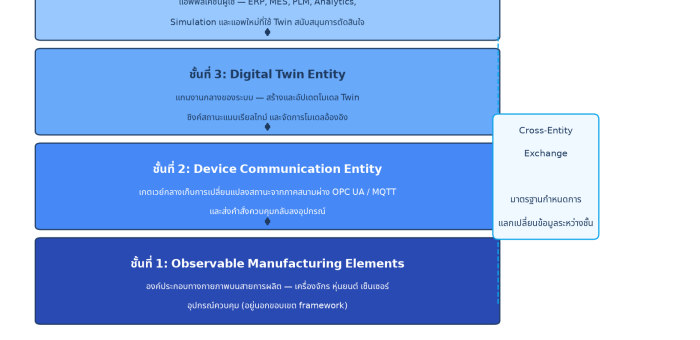
หลายโรงงานที่เริ่มต้นทำ Digital Twin มักเจอปัญหาเดียวกัน คือระบบที่ได้มา "ติด" กับผู้ให้บริการรายใดรายหนึ่งเต็มที่ ขยายไปเครื่องจักรตระกูลอื่นไม่ได้ เชื่อมกับระบบเดิมอย่าง MES หรือ ERP ต้องเขียน adapter ใหม่ทุกครั้ง สาเหตุลึกๆ ไม่ใช่เทคโนโลยี แต่เป็นการที่ยังไม่มี "ภาษากลาง" ในการจัดโครงสร้างดิจิทัลทวินร่วมกัน ซึ่งเป็นช่องว่างที่มาตรฐาน ISO 23247 ถูกออกแบบมาเติมให้ครบ ชุดมาตรฐาน ISO 23247 ชื่ออย่างเป็นทางการว่า "Automation systems and integration — Digital twin framework for manufacturing" เผยแพร่ครั้งแรกในปี 2021 ครอบคลุมตั้งแต่แนวคิดภาพรวม สถาปัตยกรรมอ้างอิง การแทนค่าข้อมูล ไปจนถึงการแลกเปลี่ยนข้อมูลระหว่างเอนทิตี้ จุดเด่นที่ทำให้มันต่างจากเอกสารแนวคิดทั่วไปคือ มาตรฐานนี้ไม่ได้บอกแค่ว่า Digital Twin คืออะไร แต่กำหนดโครงสร้างอ้างอิงที่แบ่งระบบออกเป็นชั้นทำงานชัดเจน พร้อมชื่อเรียก ขอบเขต และหน้าที่ของแต่ละส่วน ทำให้ทีมงานจากคนละองค์กรนั่งโต๊ะเดียวกันแล้วเข้าใจกันได้ทันที รากฐานมาจากสถาปัตยกรรม IoT ระดับสากล สิ่งที่น่าสนใจสำหรับผู้ที่ทำงานด้าน IIoT คือ ISO 23247 ไม่ได้คิดโครงสร้างขึ้นมาใหม่จากศูนย์ แต่ยืมพื้นฐานจากสถาปัตยกรรมอ้างอิง IoT อย่าง ISO/IEC 30141 แล้วปรับแต่ง functional entities ให้เหมาะกับบริบทการผลิต หมายความว่าถ้าโรงงานของคุณมีระบบเก็บข้อมูลเครื่องจักรผ่าน OPC UA หรือ MQTT อยู่แล้ว คุณมีวัตถุดิบชั้นที่สองของมาตรฐานนี้พร้อมใช้แล้วโดยไม่ต้องเริ่มใหม่ แนวคิดพื้นฐาน: ความต่างระหว่าง Digital Model (ไม่มีการไหลของข้อมูลอัตโนมัติ), Digital Shadow (ไหลทางเดียว) และ Digital Twin (ไหลสองทาง) — ที่มา: Wikimedia Commons (สาธารณะ) สถาปัตยกรรมอ้างอิง 4 ชั้น ที่หัวใจของ ISO 23247 แกนกลางของมาตรฐานคือการแบ่งระบบ Digital Twin เพื่อการผลิตออกเป็น 4 ชั้น โดยแต่ละชั้นเป็น "Entity" ที่มีหน้าที่และความรับผิดชอบของตัวเอง และการสื่อสารข้ามชั้น (Cross-Entity Exchange) ถูกกำหนดไว้อย่างเป็นทางการ สถาปัตยกรรมอ้างอิง 4 ชั้นตาม ISO 23247 — ภาพวาดโดยทีม Honey Corporation ชั้นที่ 1: Observable Manufacturing Elements คือทุกสิ่งบนสายการผลิตที่ต้องการจะสร้างแฝดดิจิทัล…
Read More

PLC (Programmable Logic Controller): สมองกลของระบบอัตโนมัติที่วิ่ง Scan Cycle ทุก 1 มิลลิวินาที — วิเคราะห์สถาปัตยกรรมและภาษา IEC 61131-3

Article
ในโรงงานอุตสาหกรรมแทบทุกแห่ง มีอุปกรณ์อิเล็กทรอนิกส์ตัวหนึ่งที่ทำงานเงียบๆ ภายในตู้ควบคุม 24 ชั่วโมงต่อวัน 365 วันต่อปี โดยไม่มีวันหยุด — PLC (Programmable Logic Controller) หรือ "คอนโทรลเลอร์เชิงตรรกะที่โปรแกรมได้" อุปกรณ์นี้คือสมองกลของระบบอัตโนมัติที่คอยรับข้อมูลจากเซ็นเซอร์ ประมวลผลตามโปรแกรมที่วิศวกรเขียนไว้ แล้วสั่งงานอุปกรณ์ประกอบการ (actuator) เช่น วาล์ว มอเตอร์ และคอนเทคเตอร์ ให้ทำงานตามลำดับที่กำหนด บทความนี้เจาะลึกการทำงานของ PLC ตั้งแต่สถาปัตยกรรมฮาร์ดแวร์ กระบวนการ Scan Cycle ภาษาโปรแกรมตามมาตรฐาน IEC 61131-3 ไปจนถึงเทรนด์ล่าสุดในปี 2026 ที่ PLC กำลังกลายเป็น Edge Computing Node ที่เชื่อมโยงกับระบบ Cloud และ AI ได้อย่างไร ประวัติศาสตร์: จาก Relay Logic สู่ Microprocessor ก่อนที่ PLC จะถูกประดิษฐ์ขึ้น in ปี 1968 ระบบควบคุมอัตโนมัติทั้งหมดพึ่งพา Relay Logic — วงจรที่ใช้รีเลย์ไฟฟ้าหลายร้อยตัวเดินสายต่อกันบนแผงวงจรขนาดใหญ่ เมื่อต้องการเปลี่ยนลำดับการทำงาน วิศวกรต้องเดินสายไฟใหม่ทั้งหมด ใช้เวลาหลายวันถึงหลายสัปดาห์ Dick Morley วิศวกรชาวอเมริกัน ได้พัฒนา PLC ตัวแรกชื่อ Modicon 084 สำหรับ General Motors เพื่อแก้ปัญหานี้ ความก้าวล้ำคือการแยก "ฮาร์ดแวร์" ออกจาก "โลจิก" — เปลี่ยนการเดินสายใหม่เป็นการแก้โค้ดซอฟต์แวร์ จากจุดนั้น PLC ก็กลายเป็นหัวใจของระบบอัตโนมัติในโรงงานทั่วโลก ตู้ควบคุมอุตสาหกรรม (Control Cabinet) ที่บรรจุ PLC CPU, โมดูล I/O และอุปกรณ์ควบคุม — บางครั้งประกอบด้วยระบบ Redundancy เพื่อความน่าเชื่อถือสูงสุด สถาปัตยกรรมภายในของ PLC PLC ประกอบด้วยส่วนหลัก 4 ส่วนที่ทำงานประสานกัน: ส่วนประกอบ หน้าที่ คุณสมบัติเด่น CPU / Processor ประมวลผลโปรแกรมควบคุม คำนวณโลจิก และจัดการการสื่อสาร ความเร็วระดับไมโครวินาที, บางรุ่นรองรับ 64-bit dual-core Input Modules รับสัญญาณจากเซ็นเซอร์ (ดิจิทัล 24VDC หรืออะนาล็อก 4-20mA) Optical isolation ป้องกันกระแสไฟเกิน, รองรับ…
Read More
OPC UA: มาตรฐานกลางสำหรับการแลกเปลี่ยนข้อมูลอุตสาหกรรมที่ทำลายกำแพง Vendor Lock-in ในยุค Industry 4.0

OPC UA: มาตรฐานกลางสำหรับการแลกเปลี่ยนข้อมูลอุตสาหกรรมที่ทำลายกำแพง Vendor Lock-in ในยุค Industry 4.0

Article
OPC UA เชื่อมข้อมูลระหว่างอุปกรณ์และระบบต่างผู้ผลิตในโรงงานอัตโนมัติ (ภาพประกอบ) OPC UA: มาตรฐานกลางที่ทำลายกำแพง Vendor Lock-in ในโรงงานอัตโนมัติ OPC UA (Open Platform Communications Unified Architecture) คือมาตรฐานเปิดสำหรับการแลกเปลี่ยนข้อมูลในระบบอัตโนมัติอุตสาหกรรม ที่พัฒนาโดย OPC Foundation เพื่อแก้ปัญหาใหญ่ที่สุดของวงการอุตสาหกรรม นั่นคือ Vendor Lock-in — การที่อุปกรณ์จากผู้ผลิตแต่ละรายใช้โปรโตคอลสื่อสารเฉพาะ ทำให้ไม่สามารถเชื่อมต่อกันได้ ในช่วงปลายปี 2025 OPC Foundation ได้ประกาศมาตรฐานใหม่ OPC UA FX (Field eXchange) ที่ออกแบบมาเพื่อการสื่อสารระดับ Field Device โดยตรง โดยไม่ต้องผ่าน Server ตัวกลาง ถือเป็นก้าวสำคัญที่จะเปลี่ยนโครงสร้างการสื่อสารในโรงงานจากแบบ Hierarchical (แบบเดิม) เป็น Peer-to-Peer ในอนาคตอันใกล้ สถาปัตยกรรม OPC UA: สองโหมดการทำงาน OPC UA รองรับการสื่อสารสองรูปแบบหลัก: 1. Client/Server Model (แบบดั้งเดิม) อุปกรณ์ Client ส่ง Request ไปยัง Server เพื่ออ่าน/เขียนข้อมูล ใช้ TCP เป็น transport โดย Session หนึ่งสามารถสร้าง Subscription สำหรับรับข้อมูลแบบ Monitored Item ได้ — เมื่อค่าเปลี่ยน Server จะส่ง Notification กลับมาอัตโนมัติ 2. PubSub Model (เพิ่มใน OPC UA Part 14) เหมือนกับ MQTT — Publisher ส่งข้อมูลไปยัง Message Broker หรือ Multicast ไปยัง Subscriber ที่สนใจ โดยไม่ต้องสร้าง Session ตรง เหมาะกับการส่งข้อมูล Telemetry จำนวนมากในเวลาเดียวกัน คุณสมบัติ Client/Server PubSub การเชื่อมต่อ Session-based (TCP) Connectionless (UDP/Multicast) Latency ~10-50 ms ~1-10 ms Scalability หลักร้อย-Security หลักหมื่น กรณีใช้งาน…
Read More
Digital Thread: สายดิจิทัลที่เชื่อมข้อมูลผลิตภัณฑ์ตลอดวงจรชีวิต จากแบบร่างสู่การส่งมอบ

Digital Thread: สายดิจิทัลที่เชื่อมข้อมูลผลิตภัณฑ์ตลอดวงจรชีวิต จากแบบร่างสู่การส่งมอบ

Article
หาก Digital Twin คือ "ภาพสะท้อน" ของสินทรัพย์หรือกระบวนการในเวลาหนึ่ง Digital Thread ก็คือ "เส้นเวลา" ที่เชื่อมข้อมูลของผลิตภัณฑ์ตั้งแต่ต้นน้ำจนถึงปลายน้ำ — ตั้งแต่การออกแบบใน CAD, การวางแผนการผลิตใน ERP, การควบคุมสายการผลิตใน SCADA ไปจนถึงการบำรุงรักษาและการรีไซเคิล เส้นดิจิทัลนี้คือกระดูกสันหลังของอุตสาหกรรม 4.0 ที่ผู้ผลิตชั้นนำทั่วโลกกำลังลงทุนสร้างขึ้นอย่างจริงจัง ภาพประกอบ: การพัฒนาผลิตภัณฑ์ในยุคดิจิทัลต้องเชื่อมโยงข้อมูลระหว่างทีมออกแบบ วิศวกรรม และการผลิต (ที่มา: Unsplash) Digital Thread คืออะไร? และทำไมจึงสำคัญกว่าที่คิด Digital Thread คือกระแสข้อมูลที่ไหลผ่านระบบต่างๆ อย่างต่อเนื่องตลอดวงจรชีวิตของผลิตภัณฑ์ (Product Lifecycle) โดยรักษาความสัมพันธ์และการสืบย้อนกลับ (Traceability) ของข้อมูลไว้ได้ แนวคิดนี้มีรากฐานจาก Model-Based Systems Engineering (MBSE) ซึ่งมองว่าผลิตภัณฑ์ทุกชิ้นควรมี "โมเดลแม่" (Authoritative Source) ที่ทุกระบบอ้างอิงกลับไป ความแตกต่างสำคัญระหว่าง Digital Twin และ Digital Thread คือ มิติของเวลา Digital Twin สะท้อนสถานะปัจจุบันของสินทรัพย์หนึ่งในขณะนี้ ส่วน Digital Thread เก็บประวัติและความสัมพันธ์ของข้อมูลทั้งหมดตั้งแต่กำเนิดจนสิ้นสุดอายุการใช้งาน กล่าวอีกนัยหนึ่ง Digital Twin คือภาพถ่าย ส่วน Digital Thread คือภาพยนตร์ที่บันทึกเรื่องราวทั้งหมด จุดเชื่อม 5 ด่านของวงจรผลิตภัณฑ์ Digital Thread เชื่อมระบบข้อมูล 5 ด่านหลักที่ในอดีตทำงานแยกขาดจากกัน ทำให้เกิด "เกาะข้อมูล" (Data Silo) ที่ทำให้ไม่สามารถสืบย้อนได้ว่าการตัดสินใจในด่านหนึ่งส่งผลต่ออีกด่านอย่างไร: ด่าน (Phase) ระบบหลัก ประเภทข้อมูล 1. As-Designed (ออกแบบ) PLM / CAD / CAE โมเดล 3 มิติ, BOM (Bill of Materials), สเปกวัสดุ 2. As-Planned (วางแผน) ERP / APS แผนการผลิต, ใบสั่งผลิต, การจัดซื้อวัตถุดิบ 3. As-Built (ผลิตจริง) MES / SCADA พารามิเตอร์เครื่องจักร, หมายเลขชุดผลิต, ผล QC 4. As-Maintained (ดูแลรักษา) CMMS…
Read More