บทวิเคราะห์: Uncertainty Quantification — ทำไม Digital Twin ที่ดีต้องบอกว่า “ตัวเลขนี้เชื่อได้แค่ไหน”

บทวิเคราะห์: Uncertainty Quantification — ทำไม Digital Twin ที่ดีต้องบอกว่า “ตัวเลขนี้เชื่อได้แค่ไหน”

Article
เมื่อดิจิทัลทวินบอกว่า "อุณหภูมิจะเป็น 78°C ใน 30 นาที" — คุณควรเชื่อแค่ไหน? ค่าทำนายที่แม่นยำดูเหมือนของดี แต่ในโลกอุตสาหกรรม ตัวเลขเดียวที่ไม่บอกความมั่นใจคือข้อมูลครึ่งๆ กลางๆ ลองนึกภาพสองระบบ: ระบบ A ทำนายอุณหภูมิ 78°C, ระบบ B ทำนาย 78°C ± 6°C พร้อมช่วงความเชื่อมั่น 95% — ทั้งคู่ให้ตัวเลขกลางเดียวกัน แต่การนำไปใช้ตัดสินใจหยุดสายการผลิตหรือไม่ต่างกันคนละเรื่อง นี่คือเหตุผลที่ Uncertainty Quantification (UQ) กำลังกลายเป็นเกณฑ์ใหม่ของดิจิทัลทวินระดับมืออาชีพ ผลลัพธ์การจำลองเชิงตัวเลข ( finite element simulation) — เมื่อพารามิเตอร์ตั้งต้นไม่แน่นอน ผลลัพธ์ที่ได้ก็เป็นการกระจาย ไม่ใช่ค่าเดียว (ที่มา: Wikimedia Commons, CC BY-SA 3.0) ทำไมตัวเลขเดียวจึงไม่พออีกต่อไป รายงานฉบับสำคัญ Foundational Research Gaps and Future Directions for Digital Twins ของ National Academies of Sciences, Engineering, and Medicine (สหรัฐฯ, 2024) ระบุชัดเจนว่า uncertainty quantification ต้องเป็นส่วนหนึ่งของการออกแบบดิจิทัลทวินตั้งแต่ต้น ไม่ใช่ของตกแต่งท้ายโครงการ เพราะความไม่แน่นอนในระบบ twin มีหลายชั้นมากกว่าที่คิด: ชนิดความไม่แน่นอน ต้นกำเนิด ตัวอย่างในโรงงาน Aleatoric ความสุ่มตามธรรมชาติของกระบวนการ ความแปรปรวนของวัตถุดิบแต่ละล็อต, ความผันแปรของอุณหภูมิแวดล้อม Epistemic ความรู้ที่ยังไม่ครบถ้วน สัมประสิทธิ์สึกหรอที่ยังวัดไม่ได้, พฤติกรรมเครื่องจักรที่ยังไม่เคยเจอในข้อมูล Model การทำให้เป็นโมเดล (assumptions, สมการอย่างง่าย) สมการถ่ายเทความร้อนที่ตัดรายละเอียดมุมตายของหม้อต้มออก Numerical ข้อจำกัดของการคำนวณ ขนาด mesh ที่หยาบเกินไปเพื่อให้คำนวณทันเวลาจริง Data / Sensor ความคลาดเคลื่อนของการวัด เซ็นเซอร์อุณหภูมิความแม่นยำ ±0.5°C, ค่า drift หลังใช้งาน, สัญญาณรบกวน ประเด็นสำคัญที่มักถูกมองข้าม: สองชนิดแรกต้องจัดการคนละวิธี Aleatoric เป็นธรรมชาติของกระบวนการ ลดไม่ได้แต่บรรยายได้ด้วยการกระจายความน่าจะเป็น ส่วน Epistemic ลดได้ด้วยการเก็บข้อมูลเพิ่มหรือทดลองเพิ่ม — การแยกแยะให้ออกว่า error ที่เห็นมาจากไหน จึงกำหนดว่าควรลงทุนซื้อเซ็นเซอร์แม่นขึ้น (แก้ data) หรือปรับโมเดล (แก้ model) หรือทั้งคู่ เครื่องมือหลักของ UQ ในงานอุตสาหกรรม…
Read More
บทวิเคราะห์: Anti-Surge Control — ทำไม Recycle Valve ตัวเดียวที่เปิดไม่ทันใน 200 มิลลิวินาที ชี้ขาดชะตากรรมของคอมเพรสเซอร์

บทวิเคราะห์: Anti-Surge Control — ทำไม Recycle Valve ตัวเดียวที่เปิดไม่ทันใน 200 มิลลิวินาที ชี้ขาดชะตากรรมของคอมเพรสเซอร์

Article
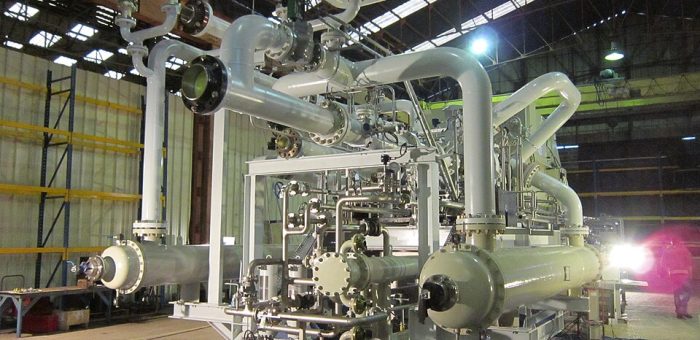
ในบรรดา Loop ควบคุมทั้งหมดในโรงงานโปรเซส มี Loop หนึ่งที่ไม่มีสิทธิ์ล้มเหลว — Anti-Surge Control ของ Centrifugal Compressor เพราะเมื่อเกิด Surge ขึ้นแล้ว แรงสั่นสะเทือนที่กระทบ Impeller, Thrust Bearing และ Dry Gas Seal จะทำลายเครื่องจักรภายในเวลาเพียงไม่กี่วินาที ผลที่ตามมาคือการเปลี่ยน Rotor ทั้งชุดและเวลาหยุดผลิตที่ยาวนานต่อทุกเหตุการณ์ บทวิเคราะห์นี้ถอดรหัสว่า Surge เกิดขึ้นได้อย่างไร และเพราะเหตุใดหัวใจของการป้องกันจึงอยู่ที่วาล์วตัวเดียวที่ต้องเปิดทันภายในระดับร้อยมิลลิวินาที Centrifugal Compressor ติดตั้งบน Skid พร้อมระบบประกอบ — หน้างานจริงในอุตสาหกรรมโปรเซส (ภาพ: Wikimedia Commons) Surge คืออะไร: วินาทีที่แรงดันไหลย้อนกลับ Centrifugal Compressor เสถียรเฉพาะเมื่อ Flow สูงกว่าค่าต่ำสุดของแต่ละความเร็วรอบและอัตราส่วนความดัน เมื่อ Flow ตกต่ำกว่าจุดนั้น (Surge Point) เครื่องจะไม่สามารถรักษา Differential Pressure ไว้ได้ แก๊สแรงดันสูงด้าน Discharge จะไหลย้อนกลับผ่านเครื่อง ความดันคายตัว เครื่องจักรสร้าง Flow ใหม่ชั่วขณะ แล้ววงจรก็ซ้ำไปซ้ำมา — นี่คือ Surge โดยในเครื่องขนาดเล็กวงรอบการไหลย้อนเกิดที่ความถี่ราว 10–20 Hz สร้างแรงกระชากซ้ำๆ บนชิ้นส่วนหมุนทั้งหมด ความน่ากลัวของ Surge อยู่ที่ความเร็วในการทำลาย: เหตุการณ์เพียง 1–2 วินาทีก็เพียงพอจะทำให้ใบพัดเกิด Fatigue Cracking จากการสั่นพ้อง Thrust Bearing รับแรงเพลามหาศาลระหว่างการไหลย้อน และ Dry Gas Seal เสียหายจากการกลับด้านของ Differential Pressure หลายเหตุการณ์ที่รายงานต่อกันมาจบด้วยการเปลี่ยน Rotor ทั้งชุด Surge Control Line: เส้นเบี่ยง 10–15% ที่ซ่อนความหมายไว้ Anti-Surge Controller คำนวณจุดทำงานของเครื่องแบบ Real-time (มักพล็อตเป็น Head vs Flow หรือ Pressure Ratio vs Reduced Flow) แล้วเทียบกับ Surge Limit Line ที่เก็บไว้ในตัวควบคุม ทางปฏิบัติจะวาง Surge Control Line แบบเว้นระยะ Flow Margin ประมาณ 10–15%…
Read More
Case Study: Physical AI ในโรงงานจริง — เมื่อ Georgia Tech ช่วยผู้ผลิตอะไหล่รถยนต์ลด Scrap Rate 50% ใน 45 วัน

Case Study: Physical AI ในโรงงานจริง — เมื่อ Georgia Tech ช่วยผู้ผลิตอะไหล่รถยนต์ลด Scrap Rate 50% ใน 45 วัน

Article
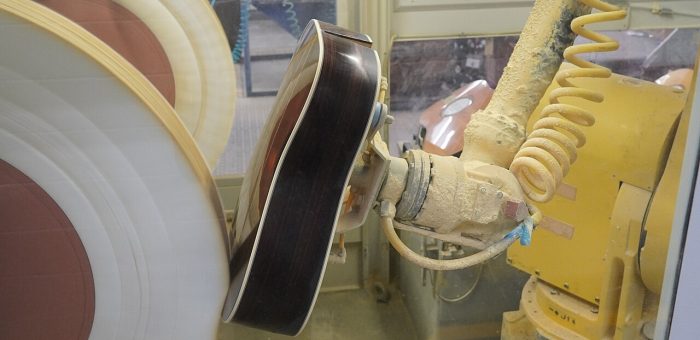
ตลาด PCB ของสหรัฐฯ เหลือเพียง 4% ของโลก และการพึ่งพาการแปรรูปหายากธาตุจากต่างประเทศเพิ่มความเสี่ยงเชิงกลยุทธ์ — นี่คือที่มาของสิ่งที่ Georgia Tech Manufacturing Institute (GTMI) เปิดตัวในปี 2026: สิ่งอำนวยความสะดวกนำร่อง Advanced Manufacturing Pilot Facility (AMPF) สถานที่ใช้ร่วมกันแห่งแรกในมหาวิทยาลัยวิจัยของสหรัฐฯ ที่ "ทำจริง" ในสิ่งที่หน่วยงานรัฐเพิ่งเริ่มให้ทุนวิจัย ผลลัพธ์ที่โดดเด่นที่สุด: อัตราเศษวัสดุเสีย (scrap rate) ของผู้ผลิตอะไหล่รถยนต์รายใหญ่ถูกลดลงครึ่งหนึ่งภายใน 45 วัน แขนกลอุตสาหกรรมทำงานจริงบนไลน์ผลิต — Physical AI ทำให้เครื่องจักรตัดสินใจปรับตัวเองได้ระดับเครื่อง (ภาพ: Henrysz / Wikimedia Commons, CC BY 4.0) ปัญหา: ข้อมูลมีเต็มคลัง แต่ไม่มีใครวิเคราะห์ทันเวลา IAC Group ผู้ผลิตชิ้นส่วนภายในรถยนต์ที่มีโรงงานกระจายทั่วสหรัฐฯ เม็กซิโก และอื่นๆ ประสบปัญหาคลาสสิกของยุค IIoT: "มีข้อมูลการผลิตมหาศาลอยู่แล้ว แต่วิเคราะห์เองไม่ทันการผลิต" — ประธานเจ้าหน้าที่ฝ่ายปฏิบัติการ Tom Boney เล่าว่าบริษัทแข่งขันทุกวันกับโรงงานในภูมิภาคต้นทุนต่ำ และต้องการความช่วยเหลือด้านสมองและพลังคำนวณที่องค์กรสร้างเองไม่ได้ โครงการแรกเลือกกระบวนการผลิตสารยึดติด (adhesive manufacturing) ที่ซับซ้อน ณ โรงงานในเมืองแวนซ์ รัฐแอละแบมา ซึ่งมีข้อมูลการผลิตเก็บมาแล้วมากมาย แต่ขาดทั้งพลังคำนวณและโมเดล AI ที่จะใช้ข้อมูลนั้นแบบเรียลไทม์ วิธีทำ: Physical AI + Mobile Robot ลงพื้นโรงงานจริง ทีมนักวิจัยและนักศึกษาระดับดุษฎีบัณฑิตของ Georgia Tech เชื่อมระบบของสถาบันตรงเข้ากับเครื่องจักรในโรงงาน และทำงานเคียงข้างพนักงานหน้าเครื่อง หัวใจของ AMPF คือการตีพิมพ์ Physical AI สู่สภาพแวดล้อมการผลิตจริง: เรียนรู้เครื่องจักรจากสัญญาณหลากหลาย — ระบบ AI วิเคราะห์สัญญาณออปติคอล ความร้อน เสียง และกระบวนการผลิตนับพันชุดต่อเนื่อง เพื่อหาแพทเทิร์น ปรับปรุงสมรรถนะ และตรวจจับความผิดปกติ เหตุผลที่ต้องทำแบบเรียลไทม์ — การพิมพ์ชิ้นส่วนจากผงโลหะพิเศษราคาสูงยิ่ง หรือซูเปอร์อัลลอยตัวใหม่ที่พัฒนาขึ้นเอง ความล้มเหลวของกระบวนการไม่ใช่ทางเลือกที่ยอมรับได้ คนกำหนดการทดลอง คนแปลผล — ในห้องปฏิบัติการ R&D โปรแกรมเครื่องจักรครั้งเดียวแล้วเปลี่ยนนับล้านครั้ง AI และหุ่นยนต์เคลื่อนที่จัดตารางผลิตและขนย้ายวัสดุอัตโนมัติ ขณะที่มนุษย์คือผู้ออกแบบการทดลองและแปลผล การสาธิต Smart Manufacturing — เชื่อมการค้นพบวัสดุ กระบวนการผลิต และการตรวจสอบคุณภาพไว้ในพื้นที่เดียว (ภาพ: Science and Technology Facilities…
Read More
Remaining Useful Life (RUL): คำถามสุดท้ายของ Predictive Maintenance ที่โมเดลใหญ่ตอบไม่ได้

Remaining Useful Life (RUL): คำถามสุดท้ายของ Predictive Maintenance ที่โมเดลใหญ่ตอบไม่ได้

Article
คำถามที่ยากที่สุดของ Predictive Maintenance ไม่ใช่ "เสียหรือยัง" แต่คือ "เหลือเวลาอีกนานเท่าไร" ตลอดหลายปีที่ผ่านมา Predictive Maintenance ในโรงงานส่วนใหญ่หยุดอยู่ที่คำถามแรก: เครื่องจักรตัวนี้ "ผิดปกติหรือไม่" — ซึ่ง Anomaly Detection ตอบได้ค่อนข้างดีแล้ว แต่คำถามที่มีผลต่อการวางแผนจริงๆ คือคำถามที่สอง: "ควรจัดซ่อมเมื่อไร" จัดเร็วเกินไปเสียโอกาสใช้งานชิ้นส่วนเต็มอายุ จัดช้าเกินไปก็กลายเป็น downtime ที่วางแผนไม่ได้ คำตอบของคำถามนี้มีชื่อเฉพาะในวงการวิศวกรรมความน่าเชื่อถือ: Remaining Useful Life (RUL) หรืออายุการใช้งานที่เหลืออยู่ RUL คือหัวใจของสาขา Prognostics and Health Management (PHM) ซึ่งเป็นขั้นสูงสุดของการบำรุงรักษาเชิงพยากรณ์ — ขณะที่ diagnostics บอกว่า "เกิดอะไรขึ้น" prognostics บอกว่า "จะไปต่ออีกนานแค่ไหน" ความต่างนี้คือความต่างระหว่างการรู้ว่าแบริ่งเริ่มมีรอย กับการรู้ว่าแบริ่งนั้นจะทนได้อีก 12 วันหรือ 12 ชั่วโมง ซึ่งนำไปสู่การตัดสินใจที่ต่างกันโดยสิ้นเชิง เครื่องยนต์เทอร์โบแฟน — กลุ่มเครื่องจักรที่งานวิจัย RUL ทำมากที่สุด เพราะความเสียหายระหว่างการใช้งานรุนแรงเกินจะรอให้เกิดขึ้น (ภาพ: Wikimedia Commons) จุดเปลี่ยน 2026: เมื่อ benchmark กลับหน้าไม่เป็นที่คาด เดือนเมษายน 2026 มีงานวิจัยเปรียบเทียบเทคนิค RUL ตีพิมพ์บน arXiv (Goel et al., 2026) ที่ให้ผลลัพธ์ "สะเทือนวงการ" ไม่ใช่เพราะตัวเลขสวย แต่เพราะมันตอกย้ำบทเรียนที่วิศวกรสาย reliability สงสัยกันมานาน งานวิจัยนี้ทดสอบบนชุดข้อมูลมาตรฐาน NASA C-MAPSS turbofan ซึ่งเป็น benchmark ที่ใช้กันทั่วโลกมาเกือบ 20 ปี โดยเปรียบเทียบ 3 ตระกูลวิธีบน subset FD001 และ FD003 ภายใต้ preprocessing เดียวกัน: โมเดล ตระกูล RMSE (FD001) RMSE (FD003) Ridge RegressionClassical (raw features)—— LSTM single-layer (Goel et al. 2026)Deep Learning14.9314.20 Deep LSTM (Zheng et al.)Deep Learning16.1416.18 1D CNNDeep Learning16.9715.68 XGBoostClassical…
Read More

วิเคราะห์ตลาด IIoT 2025-2034: จาก 864 พันล้านสู่ 5.55 ล้านล้านดอลลาร์ — โอกาสและความท้าทายสำหรับโรงงานไทย

Article
ตลาด Internet of Things (IoT) ทั่วโลกมีมูลค่า 864 พันล้านดอลลาร์สหรัฐในปี 2025 และคาดการณ์ว่าจะเติบโตเป็น 5.55 ล้านล้านดอลลาร์สหรัฐภายในปี 2034 (ข้อมูล Fortune Business Insights) นี่คือการเติบโตกว่า 6 เท่าตัวในเวลาเพียง 9 ปี แต่ตัวเลขรวมนี้ซ่อนเรื่องราวที่ซับซ้อนกว่านั้น — โดยเฉพาะส่วน Industrial IoT (IIoT) ที่กำลังขับเคลื่อนการเปลี่ยนแปลงครั้งใหญ่ในอุตสาหกรรมการผลิต บทความนี้วิเคราะห์แนวโน้มตลาด IIoT และการลงทุนใน Smart Factory ปี 2025-2026 พร้อมมุมมองเชิงปฏิบัติสำหรับผู้บริหารโรงงานในประเทศไทย ศูนย์ข้อมูลที่ขับเคลื่อน IIoT Platform และ Cloud Analytics โครงสร้างพื้นฐานสำคัญที่รองรับการเติบโตของตลาด IoT แบบทวีคูณ (ภาพ: Wikimedia Commons) ภาพรวมตลาด: IIoT คือส่วนที่เติบโตเร็วที่สุด จากข้อมูล Mordor Intelligence ตลาด IIoT โดยเฉพาะมีมูลค่า 142.4 พันล้านดอลลาร์สหรัฐในปี 2025 และคาดการณ์ว่าจะสูงถึง 191.4 พันล้านดอลลาร์สหรัฐภายในปี 2031 ในขณะที่ข้อมูลจาก Statista ระบุว่า IIoT คิดเป็น 24.3% ของรายได้ตลาด IoT ทั้งหมดในปี 2023 และสัดส่วนนี้กำลังขยายตัวอย่างต่อเนื่อง สิ่งที่น่าสนใจคือ การลงทุนด้าน IoT ในภาคอุตสาหกรรมสูงกว่าภาคอื่นๆ ข้อมูลจาก N-iX ระบุว่าอุตสาหกรรมการผลิตเป็นผู้นำในการพัฒนา IoT โดยมีการลงทุนที่สูงกว่าภาคอื่นๆ อย่างชัดเจน 6 เทรนด์หลักที่ขับเคลื่อนการลงทุนในปี 2026 เทรนด์ ความสำคัญสำหรับโรงงาน ระดับการนำไปใช้ 1. IT/OT Convergence เชื่อมระบบเทคโนโลยีสารสนเทศกับระบบควบคุมการผลิต ทำลาย Silos ข้อมูล กำลังเติบโต 2. Open Standards OPC UA, MQTT Sparkplug ลด Vendor Lock-in และค่าใช้จ่ายการเชื่อมต่อ เป็นมาตรฐาน 3. Digital Twin + AAS สร้างแบบจำลองเสมือนของเครื่องจักรและกระบวนการเพื่อจำลองสถานการณ์ เริ่มแพร่หลาย 4. Industrial Agentic AI ระบบ AI ที่ตัดสินใจและดำเนินการเองในกระบวนการผลิต เกิดใหม่/เติบโตเร็ว 5. Private 5G…
Read More

Case Study: Autonomous Production System จาก Reactive Maintenance สู่ระบบผลิตอัตโนมัติ OEE 79% ใน 13 เดือน

Article
บทความนี้นำเสนอ Case Study การนำ Autonomous Production System ไปใช้ในโรงงานผลิตชิ้นส่วนอุตสาหกรรม โดยวิเคราะห์เส้นทางจากปัญหา การออกแบบระบบ ไปจนถึงผลลัพธ์ที่เกิดขึ้นจริง เป็นแนวทางสำหรับผู้บริหารโรงงานที่กำลังพิจารณาเปลี่ยนจาก Reactive Maintenance สู่ระบบที่เครื่องจักรสามารถปรับตัวเองได้ ปัญหา: เมื่อ "Unplanned Downtime" กลายเป็นความเจ็บปวดประจำวัน โรงงานผลิตชิ้นส่วนโลหะแม่พิมพ์ขนาดกลางแห่งหนึ่ง มีสายการผลิตหลัก 6 สาย ใช้เครื่องจักรกว่า 120 เครื่อง ปัญหาหลักคือ Unplanned Downtime เฉลี่ย 14 ชั่วโมง/สัปดาห์ ส่งผลให้ OEE (Overall Equipment Effectiveness) ต่ำเพียง 58% เทียบกับเป้าหมายอุตสาหกรรมที่ 85% สาเหตุหลักมาจาก: Reactive Maintenance: ซ่อมเฉพาะเมื่อเครื่องเสีย ไม่มีการพยากรณ์ล่วงหน้า Alarm Flood: ระบบ SCADA ส่งการแจ้งเตือนมากกว่า 800 ครั้ง/วัน ช่างไม่สามารถแยกแยะสัญญาณสำคัญได้ Manual Scheduling: เมื่อเครื่องเสีย นักวางแผนต้องใช้เวลา 2-3 ชั่วโมงในการจัดลำดับการผลิตใหม่ โครงสร้างพื้นฐาน Edge Computing และเซิร์ฟเวอร์สำหรับประมวลผลข้อมูลเซ็นเซอร์แบบเรียลไทม์ รากฐานสำคัญของ Autonomous Production System (ภาพ: Wikimedia Commons) การวินิจฉัยและออกแบบระบบ ทีมวิศวกรวิเคราะห์สถาปัตยกรรมที่มีอยู่และออกแบบ Autonomous Production System แบ่งเป็น 3 ระยะ: ระยะ งานหลัก ระยะเวลา ผลลัพธ์ที่คาดหวัง ระยะที่ 1 ติดตั้ง IIoT Sensors + เชื่อม PLC ผ่าน OPC UA + MQTT Broker 3 เดือน Data Visibility: เห็นข้อมูลเครื่องจักรทุกตัวแบบเรียลไทม์ ระยะที่ 2 Deploy Anomaly Detection + Vibration Analysis Model บน Edge Device 4 เดือน Predictive Alerts: เตือนล่วงหน้า 24-72 ชม. ก่อนเครื่องเสีย ระยะที่ 3 Multi-Agent System: Agent บำรุงรักษา +…
Read More
Partial Discharge Monitoring: สัญญาณเตือนภัยล่วงหน้าจากฉนวนสินทรัพย์ไฟฟ้ากำลัง

Partial Discharge Monitoring: สัญญาณเตือนภัยล่วงหน้าจากฉนวนสินทรัพย์ไฟฟ้ากำลัง

Article
หม้อแปลงกำลัง หน้าสวิตช์เกียร์ หรือสายเคเบิลแรงสูง ไม่ได้ล้มเหลวกะทันหัน — มันเริ่มตายตั้งแต่วันที่ฉนวนเริ่มมี Partial Discharge (PD) คืนแรก เทคโนโลยี PD Monitoring คือประกาศณีย์แห่งการ "ได้ยินเสียงฟ้าผ่าเล็กๆ" ก่อนที่มันจะกลายเป็นไฟไหม้เครื่องหม้อแปลง — บทความนี้วิเคราะห์ว่าทำไมการเฝ้าระวัง PD แบบต่อเนื่องจึงกลายเป็นมาตรฐานใหม่ของสินทรัพย์ไฟฟ้ากำลังในยุค IIoT หม้อแปลงไฟฟ้ากำลังในสถานีไฟฟ้าย่อย — สินทรัพย์ที่ Partial Discharge เป็นสาเหตุหลักของการเสื่อมสภาพฉนวนและไฟไหม้ (ภาพ: Flickr, CC BY 2.0) Partial Discharge คืออะไร? Partial Discharge (PD) คือการคายประจุไฟฟ้าเฉพาะส่วนที่เกิดขึ้นในหรือบนผิวของระบบฉนวนแรงดันสูง โดยที่การคายประจุนั้น ไม่ได้เชื่อมต่อ (bridge) ระหว่างตัวนำทั้งสองขั้วอย่างสมบูรณ์ แม้จะเป็น "บางส่วน" แต่พลังงานของมันสร้างความเสียหายสะสม — กัดกร่อนฉนวนจากภายใน จนวันหนึ่งฉนวนทะลุทะลวง (breakdown) กลายเป็นไฟอาร์คเต็มตัว PD แบ่งเป็นสามประเภทตามตำแหน่งที่เกิด: Internal/Void Discharge: เกิดในโพรงอากาศ (void) ภายในฉนวนของแข็ง — อันตรายที่สุดเพราะมองไม่เห็นและกัดกร่อนจากข้างใน Surface Discharge: เกิดบนผิวฉนวน มักตามมลพิษ/ความชื้น — พบบนปลายสายเคเบิลและบุชชิง Corona Discharge: เกิดในอากาศรอบตัวนำที่มีสนามไฟฟ้าสูง (รอยบนผิว ปลายแหลม) สัญญาณทิ้งร่องรอย: PD "เผยตัว" ผ่าน 4 รูปแบบพลังงาน ทุกครั้งที่ PD เกิด มันปล่อยพลังงานออกมาพร้อมกัน 4 รูปแบบ — และนี่คือเหตุผลที่เรามี 4 เทคนิคการตรวจจับ ที่แต่ละแบบ "ฟัง" พลังงานคนละชนิดกัน: เทคนิคตรวจจับ สิ่งที่วัด ช่วงความถี่ จุดเด่น Electrical (IEC 60270) ประจุ apparent (pC) ผ่าน coupling capacitor / HFCT ต่ำ-กลาง (เคฮertz) วัดปริมาณได้ตรง ใช้เป็นอ้างอิง calibrate UHF คลื่นแม่เหล็กไฟฟ้าที่ PD แผ่ออก 300 MHz – 3 GHz ความไวสูง ทนต่อสัญญาณรบกวน ดีใน GIS Acoustic Emission คลื่นเสียงเหนือความถี่ยินจาก PD 40 – 300…
Read More
Acoustic Emission Monitoring: ดักฟังคลื่นเงียบจากวัสดุเพื่อพยากรณ์ความเสียหายก่อนเกิด

Acoustic Emission Monitoring: ดักฟังคลื่นเงียบจากวัสดุเพื่อพยากรณ์ความเสียหายก่อนเกิด

Article
เมื่อวัสดุเครื่องจักรเริ่มแตกร้าว ก่อนที่ตาเราจะเห็น หรือก่อนที่เซ็นเซอร์สั่นสะเทือนจะตรวจจับได้ วัสดุนั้นกำลัง "เคยชิน" คลื่นความเค้น (stress wave) ความถี่สูงออกมาเบาๆ เทคนิคที่ดักฟังคลื่นเงียบนี้คือ Acoustic Emission (AE) Monitoring — หนึ่งในเทคโนโลยี Non-Destructive Testing (NDT) ที่ทรงพลังที่สุดของวงการ Predictive Maintenance Acoustic Emission คืออะไร? Acoustic Emission (AE) คือปรากฏการณ์ที่วัสดุปล่อยคลื่นยืดหยุ่นชั่วขณะ (transient elastic wave) ออกมาเมื่อเกิดการเปลี่ยนแปลงโครงสร้างภายใน เช่น การเกิดรอยร้าว (crack initiation/propagation) การหลุดร่อง (delamination) การเสียรูปแบบพลาสติก (plastic deformation) หรือการรั่วของก๊าซ/ของเหลว คลื่นเหล่านี้มีความถี่อยู่ในย่าน 100 kHz ถึง 1 MHz (สูงกว่าเสียงที่หูมนุษย์ได้ยิน) และถูกตรวจจับด้วย เซ็นเซอร์เพียโซอิเล็กทริก (piezoelectric sensor) ที่แปลงคลื่นแรงดันเป็นสัญญาณไฟฟ้า เซ็นเซอร์เพียโซอิเล็กทริกแบบที่ใช้ในงาน Acoustic Emission Monitoring — แกนกลางคือวัสดุเซรามิกที่แปลงคลื่นความเค้นเป็นสัญญาณไฟฟ้า (ภาพ: Wikimedia Commons, CC BY-SA 4.0) สิ่งที่ทำให้ AE แตกต่างจากเทคนิค NDT อื่นอย่าง Ultrasonic Testing คือการที่ AE เป็นระบบ "Passive" — ไม่ปล่อยพลังงานเข้าไปกระตุ้น แต่ ดักฟัง สิ่งที่วัสดุปล่อยออกมาเอง นั่นหมายความว่า AE บอกได้ว่ารอยร้าวนั้น "กำลังเติบโตอยู่จริง" หรือไม่ ซึ่งเป็นข้อมูลสำคัญที่ตรวจการณ์แบบ snapshot มอบไม่ได้ พารามิเตอร์สำคัญที่วิศวกรต้องอ่านออก สัญญาณ AE แต่ละ "Hit" จะถูกสกัดเป็นพารามิเตอร์หลายตัวที่สะท้อนลักษณะของแหล่งกำเนิด: พารามิเตอร์ ความหมาย สื่อถึงอะไร Amplitude (dB) ค่าสูงสุดของสัญญาณ (มักวัด 40–100 dB) ความรุนแรงของเหตุการณ์ — ค่าสูงมักชี้การแตกร้าวรุนแรง Energy พื้นที่ใต้รูปคลื่น (μV²·s) พลังงานรวม — เกี่ยวข้องกับขนาดความเสียหาย Counts จำนวนครั้งที่สัญญาณข้าม threshold ความซับซ้อนของคลื่น — รอยร้าวมักให้ counts สูง Duration / Rise Time ระยะเวลาของสัญญาณ / เวลาขึ้นสู่…
Read More
Private 5G + AI Case Study: โรงงานอัจฉริยะที่ใช้เครือข่าย 5G เฉพาะกิจควบคุม AGV 223 คันและดิจิทัลทวินแบบเรียลไทม์

Private 5G + AI Case Study: โรงงานอัจฉริยะที่ใช้เครือข่าย 5G เฉพาะกิจควบคุม AGV 223 คันและดิจิทัลทวินแบบเรียลไทม์

Article
บทนำ: โรงงานอัจฉริยะที่ขับเคลื่อนด้วย Private 5G ในเดือนกรกฎาคม 2026 สื่อระดับชาติของจีนรายงานเกี่ยวกับ โรงงานผลิตเซลล์แสงอาทิตย์ (Photovoltaic Cell) แห่งหนึ่งในเมืองจินหัว มณฑลเจ้อเจียง ที่กลายเป็นเคสศึกษา (Case Study) ที่โดดเด่นของการประยุกต์ใช้ Private 5G Network ร่วมกับปัญญาประดิษฐ์ (AI) และดิจิทัลทวิน (Digital Twin) ในโรงงานอุตสาหกรรมขนาดใหญ่ โรงงานแห่งนี้ใช้เครือข่าย 5G เฉพาะกิจครอบคลุมพื้นที่ขนาดมหึมา 580 เมตร × 100 เมตร เชื่อมต่ออุปกรณ์มากกว่า 800 ชิ้น รวมถึง AGV (Automated Guided Vehicle) จำนวน 223 คัน ที่วิ่งได้อิสระโดยไม่ต้องใช้แถบแม่เหล็กหรือ QR Code ใดๆ บนพื้น ผลลัพธ์ที่น่าทึ่งคือ อัตราการใช้กำลังการผลิต (Capacity Utilization Rate) สูงถึง 97% ซึ่งเป็นอัตราสูงสุดในอุตสาหกรรมเซลล์แสงอาทิตย์ของประเทศ โดยโรงงานสามารถผลิตเซลล์แสงอาทิตย์ได้วันละ 3.7 ล้านชิ้นจากกำลังการผลิตตามแบบ 3.78 ล้านชิ้นต่อวัน และที่สำคัญคือ ไม่เคยเกิดการหยุดชะงักของเครือข่ายแม้แต่ครั้งเดียว ตั้งแต้วันเริ่มเปิดการผลิต สถาปัตยกรรม Private 5G ในโรงงาน การใช้ Private 5G ในโรงงานอุตสาหกรรมแตกต่างจากเครือข่าย 5G สาธารณะอย่างมาก เพราะโรงงานต้องการ: คุณสมบัติ 5G สาธารณะ Private 5G (ในโรงงาน) Latency 10-30 ms 1-10 ms (URLLC) ความน่าเชื่อถือ 99.9% 99.999% (5-Nines) Device Density 10,000/km² 1,000,000/km² (mMTC) Security Shared Infrastructure Dedicated Core, Network Slicing Data Sovereignty ผ่านผู้ให้บริการ ภายในโรงงาน (On-Premises) AGV Navigation แบบ 5G Visual Navigation สิ่งที่ทำให้เคสศึกษานี้โดดเด่นคือ AGV 223 คันทั้งหมด ไม่ใช้แถบแม่เหล็ก (Magnetic Strip) หรือ QR Code บนพื้นแบบดั้งเดิม แต่อาศัย 5G Visual Navigation…
Read More
Condition-Based Monitoring (CBM): บำรุงรักษาตามสภาพจริงด้วย IIoT Sensor

Condition-Based Monitoring (CBM): บำรุงรักษาตามสภาพจริงด้วย IIoT Sensor

Article
Condition-Based Monitoring (CBM) หรือการตรวจสอบตามสภาพ เป็นกลยุทธ์การบำรุงรักษาที่เปลี่ยนจากการซ่อมตามกำหนดเวลา (Time-Based/Preventive) มาเป็นการตัดสินใจซ่อมบำรุง ตามสภาพจริงของเครื่องจักร โดยใช้ข้อมูลจาก Sensor ที่ติดตั้งอยู่กับ Asset อย่างต่อเนื่อง ตามนิยามจากมาตรฐาน ISO 17359 (Condition Monitoring and Diagnostics of Machines) ซึ่งเป็นกรอบมาตรฐานสากลสำหรับการวางระบบ Condition Monitoring ในอุตสาหกรรม CBM คืออะไร? แตกต่างจาก Preventive Maintenance อย่างไร? สมมติว่าเรามีปั๊มน้ำ 1 เครื่อง แนวทาง Preventive Maintenance (PM) จะกำหนดให้เปลี่ยน Bearing ทุก 10,000 ชั่วโมงการทำงาน ไม่ว่า Bearing จะยังอยู่ในสภาพดีหรือไม่ แต่ CBM จะติด Vibration Sensor ที่ปั๊ม และตัดสินใจเปลี่ยนเฉพาะเมื่อสัญญาณสั่นสะเทือนเข้าสู่ Warning Zone หรือ Alert Threshold เท่านั้น ผลที่ได้คือลดการเปลี่ยนอะไหล่ก่อนกำหนด (Premature Replacement) และหลีกเลี่ยงการทำงานจนเสียกะทันหัน (Run-to-Failure) เปรียบเทียบกลยุทธ์การบำรุงรักษา กลยุทธ์ พื้นฐานการตัดสินใจ จุดแข็ง จุดอ่อน Reactive (Run-to-Failure) ซ่อมเมื่อเสีย ไม่ต้องลงทุนตั้งต้น Downtime สูง ค่าเสียหายมหาศาล Preventive (Time-Based) ตามปฏิทิน/ชั่วโมงทำงาน วางแผนง่าย คาดเดาได้ Over-Maintenance เปลี่ยนของที่ยังดีอยู่ Condition-Based (CBM) ตามสภาพจริงจาก Sensor ลด Downtime และต้นทุนอะไหล่ ต้องลงทุน Sensor และ Analytics Predictive (AI-driven) พยากรณ์ล่วงหน้าด้วย ML เตือนล่วงหน้านานที่สุด ต้องการ Data Science และข้อมูลประวัติ ประเภทของ Sensor ที่ใช้ใน CBM CBM อาศัยข้อมูลจาก Sensor หลายประเภท ขึ้นอยู่กับชนิดของเครื่องจักรและ Failure Mode ที่ต้องการตรวจจับ Accelerometer (Vibration Sensor): วัดความสั่นสะเทือนในหน่วย mm/s หรือ g ตามมาตรฐาน ISO 10816 (Vibration severity) และ ISO…
Read More