Hardware-in-the-Loop (HIL): ทดสอบ PLC ของจริงบนโรงงานเสมือน ก่อนถึงวันเดินเครื่องจริง

Hardware-in-the-Loop (HIL): ทดสอบ PLC ของจริงบนโรงงานเสมือน ก่อนถึงวันเดินเครื่องจริง

Article
ทำไมสายการผลิตใหม่ถึงพังตอนเดินเครื่องครั้งแรก — ทั้งที่ PLC ผ่านการทดสอบมาแล้ว? คำถามนี้เราได้ยินจากหัวหน้าโรงงานหลายท่าน ทุกครั้งที่มีการติดตั้งสายการผลิตใหม่หรือทำ Major Upgrade ระบบควบคุม ทีม Automation ทดสอบ PLC Logic บน Desktop Simulation จนผ่านทุก Case แต่พอถึงวันเดินจริง ปัญหาก็ยังมาถึง: Sensor ที่ต่อสลับขั้ว, Noise บนสาย Analog, ค่า Scaling ผิด, หรือ Interlock ที่ทำงานตอนที่ไม่ควรทำงาน สาเหตุอยู่ที่ "ช่องว่าง" ระหว่างโลกจำลองกับโลกจริง Desktop Simulation ทดสอบแค่ Logic ภายในตัว PLC เท่านั้น แต่ไม่ได้ทดสอบ ตัวฮาร์ดแวร์จริงร่วมกับ พฤติกรรมจริงของเครื่องจักรพร้อมกัน วิธีแก้ที่อุตสาหกรรมยุโรปและอเมริกาใช้มานานกว่า 20 ปีคือ Hardware-in-the-Loop (HIL) Simulation — และตอนนี้กำลังกลายเป็นมาตรฐานใหม่ของการทำ Virtual Commissioning ในโรงงานเอเชียด้วยเช่นกัน HIL คืออะไร: เอาของจริงมาต่อกับโรงงานเสมือน หัวใจของ HIL นั้นเรียบง่าย: เอา ตัวควบคุมจริง (PLC, VFD, Motion Controller) มาวางบนโต๊ะทดสอบ แล้วต่อเข้ากับ Real-Time Simulator ที่รันโมเดลคณิตศาสตร์ของเครื่องจักรและกระบวนการผลิตทั้งสาย ตัว Simulator จะปลอมตัวเป็น "โรงงานเสมือน" ที่ส่งสัญญาณ Sensor กลับมาที่ PLC ผ่านทาง I/O จริง ทั้ง Analog 4–20 mA, Digital 24VDC, และโปรโตคอล Industrial Ethernet ตัวควบคุมจริง (PLC) คือองค์ประกอบ "Hardware" ใน Hardware-in-the-Loop — ภาพ: Wikimedia Commons สิ่งที่เกิดขึ้นคือ Closed Loop ที่สมบูรณ์: PLC สั่งปิดวาล์ว → Simulator คำนวณการไหลและแรงดันตาม Physics แล้วส่งค่า Sensor ใหม่กลับมา → PLC เห็นค่าเปลี่ยนแล้วตัดสินใจต่อ ทุกอย่างเกิดขึ้นแบบ Real-Time ในหน่วยมิลลิวินาที เหมือนเครื่องจักรจริงนั่นอยู่ตรงหน้า สถาปัตยกรรม 3 ส่วนของระบบ HIL องค์ประกอบ หน้าที่…
Read More
บทวิเคราะห์: Edge หรือ Cloud — ตัวเลขตลาดบอกว่าคำถามนี้ผิดตั้งแต่ต้น (และโรงงานควรถามอะไรแทน)

บทวิเคราะห์: Edge หรือ Cloud — ตัวเลขตลาดบอกว่าคำถามนี้ผิดตั้งแต่ต้น (และโรงงานควรถามอะไรแทน)

Article
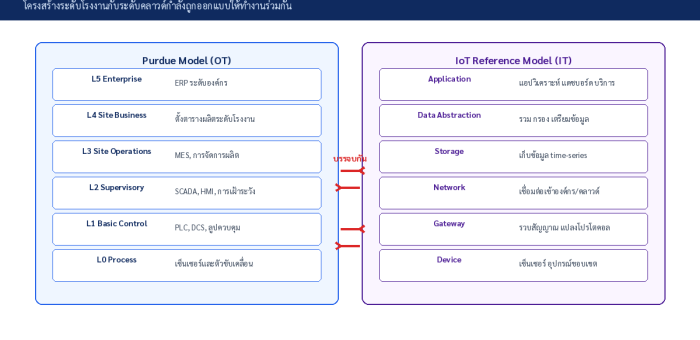
ช่วงสองสามปีที่ผ่านมา วิศวกรโรงงานไทยหลายท่านน่าจะเจอบทสนทนาแบบนี้: “เราควรเอาขึ้นคลาวด์หรือทำ edge ก่อน” คำถามดูเหมือนมีเหตุผล แต่ถ้าดูตัวเลขตลาดล่าสุดแล้ว จะพบว่านี่คือกรอบคิดที่กำลังล้าสมัย เพราะโลกไม่ได้กำลังเลือกระหว่างสองฝั่ง แต่กำลังเติบโต ทั้งสองฝั่งพร้อมกันอย่างก้าวกระโดด ตัวเลขที่ต้องรู้ก่อนตัดสินใจ รายงานล่าสุดของ Grand View Research ระบุว่าตลาด Edge Computing โลกมีมูลค่า 33.4 พันล้านดอลลาร์ในปี 2025 และประมาณการไว้ที่ 46.7 พันล้านดอลลาร์ในปี 2026 ก่อนจะขยายต่อไปถึง 328 พันล้านดอลลาร์ภายในปี 2033 คิดเป็น CAGR 32.1% ตลอดช่วง 2026–2033 — นี่คืออัตราเติบโตที่เร็วกว่าภาพรวมของ smart manufacturing ที่ IoT Analytics ประเมินไว้ที่ CAGR 9.3% (จาก 175 พันล้านดอลลาร์ในปี 2025 สู่ 274 พันล้านดอลลาร์ในปี 2030) ถึงสามเท่าครึ่ง ทำไมถึงเร็วขนาดนั้น? เพราะ edge ไม่ได้แข่งกับคลาวด์ แต่กำลัง เปิดกล่อง use case ใหม่ที่คลาวด์ทำไม่ได้ และเอเชียแปซิฟิกคือภูมิภาคที่โตเร็วที่สุด — Grand View Research ระบุ CAGR ของภูมิภาคเราที่ราว 39% สูงกว่าค่าเฉลี่ยโลก ซึ่งสอดคล้องกับการลงทุน infrastructure ดิจิทัลของไทยในช่วงนี้ Purdue Reference Model เทียบกับ IoT Reference Model — โครงสร้างระดับโรงงานกับระดับคลาวด์กำลังถูกออกแบบให้ทำงานร่วมกัน ไม่ใช่แยกกัน — ภาพ: Wikimedia Commons (CC BY-SA 4.0) คำถามที่ถูกต้อง: Workload นี้ควรอยู่ที่ไหน แทนที่จะถามว่า “เอาขึ้นคลาวด์หรือ edge” ให้ถามว่า “workload นี้มีคุณสมบัติอะไร” แล้วให้คุณสมบัตินั้นตัดสินใจแทน โดยเฉพาะสี่มิติที่ตัดสินได้ชัดเจนที่สุด: มิติการตัดสินใจ ชี้ไปทาง Edge ชี้ไปทาง Cloud Latency ที่ยอมรับได้ ต่ำกว่า ~50 ms เช่น interlock, หยุดเครื่องฉุกเฉิน วินาทีถึงนาที เช่น dashboard, รายงานรายเดือน ปริมาณข้อมูล สูงมากต่อวินาที (vibration 10 kHz, วิดีโอ 30 fps)…
Read More
Case Study: โรงงานอาหาร ‘เสียเครื่อง Edge ตอนตี 2’ — บทเรียนจากการย้าย Orchestration ลงสู่ระดับสายการผลิตด้วย Kubernetes แบบ Lightweight

Case Study: โรงงานอาหาร ‘เสียเครื่อง Edge ตอนตี 2’ — บทเรียนจากการย้าย Orchestration ลงสู่ระดับสายการผลิตด้วย Kubernetes แบบ Lightweight

Article
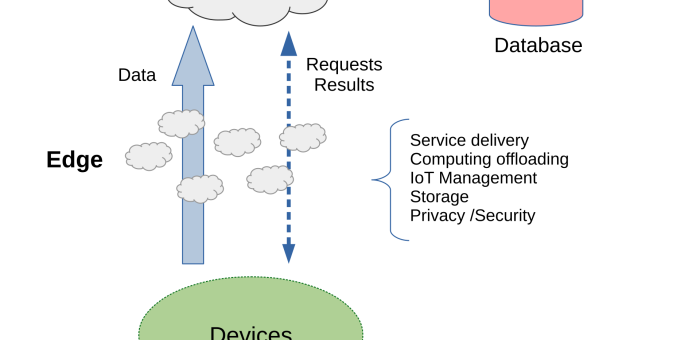
เรื่องนี้เล่าถึงโรงงานอาหารแห่งหนึ่งในนิคมอุตสาหกรรมภาคตะวันออก ที่เดิมใช้เกตเวย์ IoT แบบ standalone จำนวน 24 ตัวกระจายอยู่ทุกสายการผลิต แต่ละตัวเก็บค่าอุณหภูมิห้องเย็น ความชื้น และสถานะเครื่องจักร แล้วส่งขึ้นคลาวด์ผ่าน MQTT ทุกอย่างทำงานได้ดี… จนกระทั่งคืนหนึ่งที่เกตเวย์ตัวหนึ่งหยุดทำงานเพราะการ์ดหน่วยความจำเสีย และไม่มีใครรู้ตัวจนกระทั่งเช้าวันรุ่งขึ้น ข้อมูลห้องเย็นหายไป 7 ชั่วโมงเต็ม ซึ่งในธุรกิจอาหารแปลว่าต้องเขียนรายงานเหตุการณ์ deviation ยาวเหยียด และต้องประเมินความเสี่ยงต่อสินค้าที่เก็บในช่วงเวลานั้น ปัญหา: ความล้มเหลวแบบเงียบ (Silent Failure) การตรวจสอบย้อนหลังพบว่าปัญหาไม่ได้อยู่ที่ตัวเกตเวย์ แต่อยู่ที่สถาปัตยกรรม ระบบเดิมไม่มีกลไกใดตรวจจับว่าเกตเวย์ “ยังมีชีวิต” หรือไม่ และเมื่อเกตเวย์หนึ่งตัวตาย ก็ไม่มีตัวไหนรับหน้าที่แทน ทีมวิศวกรรมจึงเสนอแนวคิดที่ตอนนั้นดูเกินจำเป็นสำหรับโรงงานอาหาร นั่นคือการนำ container orchestration แบบ Kubernetes รุ่นเบา ลงมาวางที่ระดับสายการผลิต — ไม่ใช่เพื่อความสวยงามทางเทคนิค แต่เพื่อให้ได้สามอย่าง: self-healing, declarative configuration และ rollback ที่ทำได้ในไม่กี่วินาที การวางโหนด Edge หลายชั้นให้ครอบคลุมทุกสายการผลิต คือฐานของ orchestration แบบกระจาย — ภาพ: Wikimedia Commons (CC BY-SA 4.0) ทางออก: Single-node Cluster ที่ทุกสายการผลิต แนวทางที่เลือกไม่ใช่คลัสเตอร์กลางขนาดใหญ่ แต่เป็น คลัสเตอร์เล็กๆ อยู่กับสายการผลิต แต่ละสายมี industrial computer ตั้งแต่ 2 โหนดขึ้นไป รัน Kubernetes distribution แบบ lightweight ที่ตัดส่วนประกอบที่ไม่จำเป็นออก ตัว workload หลักมีสามชนิด: Collector — อ่านค่าจาก PLC ผ่าน OPC UA และเซ็นเซอร์ผ่าน Modbus TCP เขียนลง local time-series storage Rule engine — ประเมินเงื่อนไข alarm เช่น อุณหภูมิห้องเย็นเกิน -18°C นานเกิน 10 นาที แล้วส่งแจ้งเตือนผ่านหลายช่องทาง Forwarder — ส่งข้อมูลแบบ batch ขึ้นคลาวด์ พร้อม store-and-forward เมื่อลิงก์หลุด จุดเปลี่ยนที่สำคัญคือการตั้งค่า liveness/readiness probe ให้กับทุก workload — collector ที่ค้างไม่อ่านค่า PLC…
Read More
Fog Computing กลับมาเป็นข่าวอีกครั้ง: ชั้นคำนวณที่โรงงานไทยมองข้ามไป กำลังกลายเป็นหัวใจของ IIoT ยุค Edge AI

Fog Computing กลับมาเป็นข่าวอีกครั้ง: ชั้นคำนวณที่โรงงานไทยมองข้ามไป กำลังกลายเป็นหัวใจของ IIoT ยุค Edge AI

Article
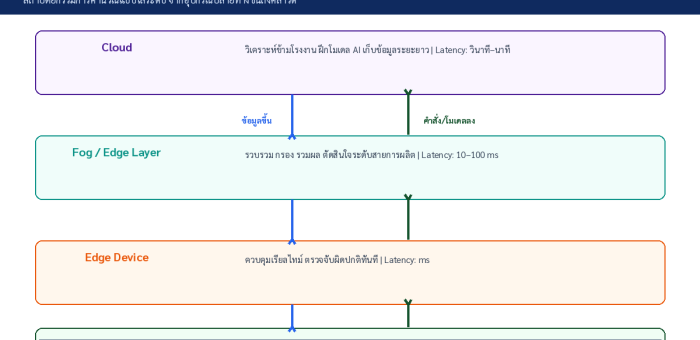
หลายโรงงานในไทยวางแผนธุรกิจดิจิทัลของตัวเองแบบสองขั้ว คือมีอุปกรณ์ IoT และ PLC อยู่ปลายทาง แล้วส่งข้อมูลขึ้นคลาวด์เพื่อประมวลผลทั้งหมด แต่เมื่อปริมาณข้อมูลเพิ่มขึ้นเป็นสิบเท่า และ AI เริ่มถูกใช้ตัดสินใจแบบเรียลไทม์บนพื้นโรงงาน สถาปัตยกรรมแบบสองขั้วนี้ก็เริ่มสะดุด คำตอบที่ถูกที่สุดไม่ใช่การย้ายทุกอย่างกลับมาอยู่ในโรงงาน แต่คือการเพิ่ม ชั้นคำนวณระหว่างกลาง ที่เรียกว่า Fog Computing ซึ่งกำลังกลับมาเป็นที่พูดถึงอีกครั้งในวงการอุตสาหกรรมปี 2026 สถาปัตยกรรมการคำนวณแบบไล่ระดับ ตั้งแต่อุปกรณ์ปลายทาง (Things) ผ่านชั้น Edge/Fog ขึ้นไปถึงคลาวด์ — ภาพ: Wikimedia Commons (CC BY-SA 4.0) ทำไมสองขั้วไม่พออีกต่อไป ลองนึกภาพสายการผลิตที่มีกล้องตรวจคุณภาพ 16 ตัว ส่งภาพความละเอียดสูงกลับคลาวด์เพื่อรันโมเดล Computer Vision ที่ 30 เฟรมต่อวินาที เสียงวิเคราะห์คลื่นเสียงเครื่องจักร และข้อมูล vibration ที่สุ่มที่ 10 kHz — แบนด์วิดท์ที่ต้องใช้ไม่ใช่แค่ “เยอะ” แต่แพงและเปราะ ถ้าเน็ตหลุดแม้เพียง 30 วินาที งานตรวจคุณภาพช่วงนั้นก็หายไปตลอดกาล ในทางกลับกัน การเอาทุกอย่างมาไว้ในเซิร์ฟเวอร์กลางในโรงงานล้มเหลวในอีกแบบ ทีม IT ต้องดูแลฮาร์ดแวร์ ทำ backup อัปเดต patch และขยายระบบทุกครั้งที่เพิ่มสายการผลิต Fog Computing เสนอทางที่สาม — กระจายการคำนวณลงไปในหลายๆ โหนดที่อยู่ใกล้แหล่งข้อมูล แต่ยังจัดการแบบรวมศูนย์ ตามแนวคิดที่ OpenFog Consortium (ซึ่งต่อมาควบรวมเข้ากับ Linux Foundation Edge) เคยสรุปไว้ใน Reference Architecture ว่าต้องมีคุณสมบัติ 8 ด้าน ตั้งแต่ Security, Scalability, Openness, Autonomy, Manageability, Agility, Hierarchical Organization ไปจนถึง Programmability ข้อกำหนดทางเทคนิคที่ต้องรู้ก่อนออกแบบ ประเด็นออกแบบ โจทย์จริงในโรงงาน แนวทาง Fog Latency budget ปิดสวิตช์ฉุกเฉินภายใน 10–50 ms หลังตรวจพบความผิดปกติ ประมวลผลและตัดสินใจที่โหนด Fog ในสายการผลิต ไม่รอ round-trip ไปคลาวด์ แบนด์วิดท์ กล้องตรวจคุณภาพ 16 ตัว ที่ 30 fps กินลิงก์ WAN เกินกว่าที่ลิงก์สำรองจะรับไหว สกัดเฉพาะผลลัพธ์และภาพที่พบ defect ขึ้นคลาวด์ ลดปริมาณข้อมูลขาออกได้ 90%…
Read More
บทวิเคราะห์ Over-Optimization Trap: ทำไมระบบที่ Efficient ที่สุดคือระบบที่เปราะบางที่สุด — บทเรียน Resilience ยุค Industry 5.0

บทวิเคราะห์ Over-Optimization Trap: ทำไมระบบที่ Efficient ที่สุดคือระบบที่เปราะบางที่สุด — บทเรียน Resilience ยุค Industry 5.0

Article
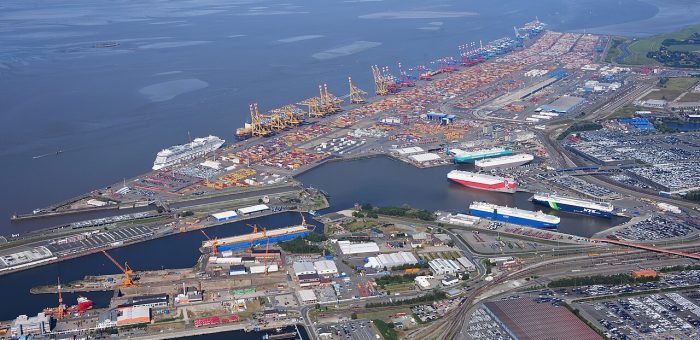
ยี่สิบปีที่แล้ว คำว่า "Lean" และ "Just-in-Time" คือคำตอบสุดท้ายของวงการผลิต — ตัดสต๊อกให้เหลือน้อยที่สุด ตัด Waste ให้หมด บีบ Supplier ให้ส่งของถี่ขึ้นเรื่อยๆ แล้ว COVID-19 ก็มาถึง ตามด้วยสงครามการค้า ความขัดแย้งภูมิรัฐศาสตร์ และวิกฤตพลังงาน โลกของปี 2026 ค้นพบความจริงข้อหนึ่ง: ระบบที่ Optimize สูงสุดคือระบบที่เปราะบางสูงสุด นี่คือบทวิเคราะห์ปรากฏการณ์ที่เราเรียกว่า "กับดักการ Optimize เกินพอดี" (Over-Optimization Trap) — และเหตุใด Industry 5.0 จึงยกเรื่อง Resilience ขึ้นเป็นเสาหลักเทียบเท่าประสิทธิภาพ ท่าเรือคอนเทนเนอร์คือภาพจำของ Global Value Chains — ระบบที่มีประสิทธิภาพสูงที่สุดในประวัติศาสตร์ และก็เปราะบางที่สุดเมื่อโลกหยุดหมุน (ภาพ: Wikimedia Commons, Public Domain) กับดักทำงานอย่างไร — 3 กลไกที่มองไม่เห็นในตาราง Excel 1. Efficiency กับ Resilience คือ Trade-off ที่ซ่อนอยู่ ทุกครั้งที่เราตัดสต๊อก Buffer ลง รวม Supplier จาก 5 รายเหลือ 1 ราย (เพื่อราคาดีกว่า) หรือรวมโรงงานจาก 3 แห่งเหลือ 1 แห่ง (เพื่อ Economies of Scale) — เรากำลังแลก "ความเปราะบาง" ซื้อ "ประสิทธิภาพ" โดยที่ตัวเลขในงบการเงินแสดงเฉพาะครึ่งหลัง เอกสารวิเคราะห์ของสภาอุตสาหกรรมแห่งประเทศไทย (FTPI) ปี 2026 ชี้ตรงว่าแนวทาง Just-in-Time ที่เน้นประสิทธิภาพสูงสุดของ Industry 4.0 กลายเป็น "ความเปราะบางเมื่อเผชิญเหตุการณ์ไม่ปกติ" — วิกฤตด้านสาธารณสุข เศรษฐกิจ ภูมิรัฐศาสตร์ และการหยุดชะงักของห่วงโซ่อุปทาน 2. Rebound Effect — เทคโนโลยีประหยัดทรัพยากรที่ทำให้ใช้ทรัพยาศเพิ่ม เอกสารเดียวกันอธิบายปรากฏการณ์ที่ถูกมองข้าม: เมื่อเทคโนโลยีทำให้ต้นทุนการผลิตลดลง ความต้องการก็เพิ่มขึ้นจน "หักล้างประสิทธิภาพที่ทำไว้" — โรงงานที่ประหยัดพลังงานต่อหน่วยได้ 20% อาจผลิตเพิ่ม 30% สุทธิคือใช้พลังงานมากขึ้น นี่คือเหตุผลที่เป้าหมาย Sustainability ของ Industry 5.0 ต้องมาพร้อมระบบวัดผลจริง (Carbon Accounting, Energy Submetering…
Read More
Case Study: Active Learning ในงานตรวจจับตำหนิ — เมื่อโมเดลเลือกเองว่าภาพไหน “คุ้มค่า” ที่จะให้คนติดป้าย

Case Study: Active Learning ในงานตรวจจับตำหนิ — เมื่อโมเดลเลือกเองว่าภาพไหน “คุ้มค่า” ที่จะให้คนติดป้าย

Article
ปัญหา: ข้อมูลติดป้ายไม่พอ แต่สายการผลิตไม่หยุดรอ โรงงานประกอบอิเล็กทรอนิกส์แห่งหนึ่งเริ่มโครงการ AI ตรวจจับตำหนิบน PCB ด้วยความหวังสูง หกเดือนต่อมาโครงการยังติดอยู่ที่จุดเดิม — ไม่ใช่เพราะโมเดลไม่ดี แต่เพราะ คนติดป้ายภาพไม่ทันสายพาน กล้องถ่ายได้วันละหลายหมื่นภาพ แต่ผู้เชี่ยวชาญ QC มีเวลาตรวจและ Label ได้เพียงเสี้ยวเปอร์เซ็นต์ของจำนวนนั้น ภาพส่วนใหญ่ที่เก็บมาจึงไร้ค่าในเชิงการเทรน เพราะเป็นภาพชิ้นงานปกติที่ซ้ำๆ กัน นี่คือปัญหาคลาสสิกที่งานวิจัยสาย Active Learning พยายามแก้ และล่าสุด (กันยายน 2026) มีกรอบการทำงานใหม่ชื่อ FuDU (Fuzzy Dual-dimensional Uncertainty) ที่นำเสนอแนวทาง Streaming Active Learning สำหรับงานตรวจจับตำหนิแบบ Real-time โดยเฉพาะ การตรวจสอบด้วยสายตา (Visual Inspection) ต้องใช้ผู้เชี่ยวชาญ — ทรัพยากรที่หายากและแพงที่สุดในโครงการ AI Quality (ภาพ: Wikimedia Commons) แนวคิดแนวทางแก้: ให้ AI เลือกภาพที่ "คุ้มค่าที่สุด" ให้คนติดป้าย Active Learning พลิกตรรกะจากเดิม แทนที่จะให้คน Label ทุกภาพตามลำดับ ระบบจะประเมินว่าภาพไหน "มีข้อมูลที่โมเดลยังไม่รู้" มากที่สุด แล้วส่งเฉพาะภาพเหล่านั้นให้ผู้เชี่ยวชาญ ผลลัพธ์คือปริมาณงาน Label ลดลงหลายเท่า แต่คุณภาพโมเดลกลับดีขึ้นเร็วกว่า เพราะทุกภาพที่ Label คือภาพที่สอนอะไรใหม่ๆ แก่โมเดลจริงๆ Framework FuDU ทำงานบนสตรีมภาพจากสายการผลิตด้วยการวัดความไม่แน่นอน (Uncertainty) ถึง 2 มิติ: PGUQ (Prototype-based Global Uncertainty) — ประเมินความไม่แน่นอนที่ระดับภาพ โดยเทียบภาพใหม่กับกลุ่ม Feature ต้นแบบของ "ชิ้นงานปกติ" และ "ชิ้นงานมีตำหนิ" ที่ระบบสะสมไว้ DeUE (Dual-entropy Defect Uncertainty Evaluator) — วัดความไม่แน่นอนที่ระดับ Bounding Box ของตำหนิแต่ละจุด ด้วย Entropy 2 รูปแบบ จากนั้นใช้ Fuzzy Inference หลอมค่า Uncertainty ทั้งสองมิติเข้าด้วยกัน (โดยมองว่าความผิดพลาดเป็น Systematic Error) เพื่อตัดสินว่าภาพไหนสมควรถูกส่งไปให้มนุษย์ Label ในลักษณะการตัดสินใจแบบ Fuzzy ที่ไม่เด็ดขาดแบบ Threshold ค่าเดียว สายการผลิตความเร็วสูงอย่างสิ่งทอและอิเล็กทรอนิกส์ ผลิตภาพมหาศาลต่อวัน — การเลือกภาพ…
Read More
Zero-Shot Anomaly Detection: ตรวจจับตำหนิที่ AI “ไม่เคยเห็นมาก่อน” ด้วย Vision-Language Model

Zero-Shot Anomaly Detection: ตรวจจับตำหนิที่ AI “ไม่เคยเห็นมาก่อน” ด้วย Vision-Language Model

Article
ทำไมโมเดล AI แบบเดิมถึง "เพิ่มรุ่นใหม่ไม่ทัน" โรงงานสมัยนี้เปลี่ยนผลิตภัณฑ์เร็วขึ้นมาก สายการผลิตเดียวอาจสลับ SKU ทุก 2–3 วัน ลูกค้าของัดสีพิเศษ หรือมีอะไหล่ใหม่ที่ไม่เคยมีในชุดข้อมูลเดิม ปัญหาคือระบบตรวจจับตำหนิด้วย AI แบบดั้งเดิม (Supervised Learning) ต้องการภาพตัวอย่างที่ "ติดป้าย" จำนวนหลายพันภาพต่อหนึ่ง Defect กว่าจะเทรนเสร็จ ผลิตจริงเปลี่ยนไปแล้ว งานวิจัยล่าสุดจาก arXiv (LiZAD, กรกฎาคม 2026) ระบุชัดว่า "ในสายการผลิต High-throughput ยุคใหม่ การเก็บและ Label ข้อมูลสำหรับทุก Scenario ใหม่เป็นเรื่องไม่ practical แล้ว" นี่คือช่องว่างที่ Zero-Shot Anomaly Detection (ZSAD) เข้ามาเติม — ตรวจจับตำหนิที่โมเดล "ไม่เคยเห็นมาก่อนเลย" ด้วยการอาศัยความเข้าใจภาษาธรรมชาติที่ฝังอยู่ใน Vision-Language Model สายการผลิตอัตโนมัติยุคใหม่ต้องรองรับการเปลี่ยน SKU ที่เร็วขึ้น ระบบตรวจคุณภาพจึงต้อง "ยืดหยุ่น" ตาม (ภาพ: Wikimedia Commons) Vision-Language Model ทำงานกับงานตรวจตำหนิอย่างไร หัวใจของแนวทางนี้คือการเทียบ "ความหมาย" ระหว่างภาพกับข้อความ แทนที่จะจำตำหนิรูปแบบเดิมๆ ระบบจะสร้าง Prompt เช่น a photo of a normal metal surface และ a photo of a metal surface with scratch แล้ววัดว่าภาพที่กล้องจับมา "ใกล้เคียง" ประโยคไหนมากกว่า ถ้าใกล้ประโยคที่พูดถึงตำหนิมากกว่า ระบบก็แจ้งเตือนทันที โดยไม่ต้องเทรนใหม่แม้แต่ภาพเดียว งานวิจัยสายนี้ส่วนใหญ่อ้างอิงสถาปัตยกรรมแบบ CLIP (Contrastive Language-Image Pre-training) ซึ่งเทรนล่วงหน้าด้วยคู่ภาพ-ข้อความนับร้อยล้านคู่ ทำให้โมเดลเข้าใจความสัมพันธ์ระหว่าง "รอยขีดข่วน" ในเชิงภาษา แล้ว map มาหา pattern ทางภาพได้โดยอัตโนมัติ แนวคิด Object Localization ด้วย AI — ZSAD ต่อยอดด้วยการเทียบความหมายระหว่างภาพกับข้อความแทนการจำ Pattern เดิม (ภาพ: Wikimedia Commons) เทคนิคสำคัญที่งานวิจัยปี 2026 กำลังพัฒนา เทคนิค แนวคิด ประโยชน์ต่อโรงงาน Discrete Prompt Optimization (CoEvoAD, ส.ค.…
Read More
บทวิเคราะห์ MRP vs PRP vs HSR: วิธีเลือก Network Redundancy ให้โรงงานให้คุ้มค่า ก่อนที่สายแลนจะขาดกลางดึก

บทวิเคราะห์ MRP vs PRP vs HSR: วิธีเลือก Network Redundancy ให้โรงงานให้คุ้มค่า ก่อนที่สายแลนจะขาดกลางดึก

Article
คำถามที่ควรถามก่อนเครือข่ายโรงงานล่ม ทุกครั้งที่เราเข้าไปประเมินระบบเครือข่ายในโรงงานอุตสาหกรรม คำถามแรกที่เราถามเสมอคือ "ถ้าสาย LAN เส้นนี้ขาดตอนกลางดึก ระบบจะกลับมาใช้ได้ในกี่วินาที และใครจะเป็นคนรู้ก่อน" คำตอบที่ได้กลับมามักเป็นเงียบ หรือไม่ก็ "คงต้องรอช่างมาดูตอนเช้า" ซึ่งแปลว่าโรงงานนั้นยังพึ่ง Spanning Tree Protocol แบบดั้งเดิม ที่ใช้เวลากู้คืนเป็นสิบวินาทีถึงหลักนาที — นานเกินกว่าที่สายการผลิตที่วิ่ง 24 ชั่วโมงจะยอมรับได้ ในโลกของ OT ที่ downtime ของเครือข่ายเท่ากับ downtime ของการผลิต วงการอุตสาหกรรมจึงพัฒนามาตรฐานความซ้ำซ้อนของเครือข่ายขึ้นมาเป็นชุด ภายใต้ IEC 62439 ซึ่งครอบคลุมทั้ง MRP (ส่วนที่ 2), PRP และ HSR (ส่วนที่ 3) บทความนี้วิเคราะห์ว่าแต่ละตัวเหมาะกับโรงงานแบบไหน และจุดไหนที่คุ้มค่าที่จะลงทุน โทโพโลยีวงแหวน (Ring) — รากฐานของ MRP ที่เปลี่ยนเส้นทางสำรองให้พร้อมใช้เสมอ (ที่มา: Wikimedia Commons) ทำไม RSTP ไม่พอแล้วสำหรับสายการผลิต Rapid Spanning Tree Protocol (RSTP) เป็นมาตรฐานเปิดที่หาได้ในสวิตช์แทบทุกตัว แต่เวลากู้คืนของมันอยู่ในระดับ หลักวินาทีถึงหลักสิบวินาที ซึ่งสำหรับเครือข่ายสำนักงานถือว่ารับได้ แต่สำหรับสายการผลิตที่ Controller ต้องคุยกับ Drive ทุก 10–100 มิลลิวินาที ช่วงเวลาขนาดนั้นเท่ากับคำสั่งควบคุมหายไปหลายรอบ สินค้าเสียหาย และอาจถึงขั้นต้องหยุดเครื่อง มาตรฐาน IEC 62439 ถูกออกแบบมาเพื่อลดเวลานี้ให้เหลือระดับที่สายการผลิตอยู่รอดได้: MRP การันตี recovery ในระดับ 10–200 มิลลิวินาที (ขึ้นกับขนาดวงแหวนและคลาสอุปกรณ์) ส่วน PRP และ HSR ให้ "zero recovery time" เพราะเฟรมถูกส่งซ้ำสองทางพร้อมกันตั้งแต่ต้น ไม่มีช่วงเปลี่ยนผ่านให้ข้อมูลหายเลย แคร็กสวิตช์ในโรงงาน — ทุกพอร์ตและทุกเส้นสายคือจุดล้มเหลวที่ต้องออกแบบรองรับล่วงหน้า (ที่มา: Wikimedia Commons) ตารางวิเคราะห์: MRP vs PRP vs HSR เลือกอย่างไรให้คุ้ม ประเด็น MRP (IEC 62439-2) PRP (IEC 62439-3) HSR (IEC 62439-3) โทโพโลยี วงแหวนเดียว สองเครือข่ายขนานแยกกัน วงแหวนเดี่ยว เฟรมวิ่งสองทิศ เวลากู้คืน 10–200 ms (ตามคลาส) 0 ms (seamless)…
Read More
Wearable Ring Scanner: เทคโนโลยีสแกนบาร์โค้ดบนนิ้วที่คืน ‘มือว่าง’ ให้พนักงานคลังสินค้า — Deep Dive จาก Sensor ถึง WMS

Wearable Ring Scanner: เทคโนโลยีสแกนบาร์โค้ดบนนิ้วที่คืน ‘มือว่าง’ ให้พนักงานคลังสินค้า — Deep Dive จาก Sensor ถึง WMS

Article
ในโลกของคลังสินค้าและศูนย์กระจายสินค้า หนึ่งในความฝันที่เก่าแก่ที่สุดคือ "มือที่ว่าง" — พนักงานหยิบสินค้า (Picker) ที่ดีต้องหยิบ สแกน ตรวจ และวางสินค้าได้ในครั้งเดียวโดยไม่ต้องวางของลงเพื่อหยิบเครื่องสแกนมือถือ แต่เครื่องสแกนแบบถือ (Handheld Scanner) แบบเดิมบังคับให้ทำตรงกันข้าม: หยิบของ วางของ หยิบปืนสแกน สแกน วางปืน แล้วหยิบของขึ้นมาใหม่ วงจรซ้ำนี้เกิดขึ้น 800–1,200 ครั้งต่อกะ และเป็นต้นตอของทั้งเวลาที่สูญเปล่าและการบาดเจ็บสะสมที่ข้อมือ บทความนี้พาไปดูให้ลึกถึงเทคโนโลยีที่แก้ปัญหานี้ตรงจุด — Wearable Ring Scanner อุปกรณ์สแกนบาร์โค้ดขนาดเล็กที่สวมบนนิ้ว ตั้งแต่หลักการทำงาน เทคโนโลยีเซ็นเซอร์ สถาปัตยกรรมการเชื่อมต่อ ไปจนถึงตัวเลขผลลัพธ์ที่คลังสินค้าจริงเก็บได้ และเงื่อนไขที่ทำให้โครงการลักษณะนี้สำเร็จหรือล้มเหลว รถเข็นหยิบสินค้า (Picking Trolley) พร้อมอุปกรณ์ประจำรถ — ทุกการหยิบสินค้าหนึ่งชิ้นคือรอบการสแกนหนึ่งครั้ง คูณหลายพันครั้งต่อกะ (ภาพ: Wikimedia Commons, CC BY-SA 4.0) ปัญหาที่มาพร้อมปืนสแกนแบบถือ งาน order picking คือหัวใจของทุกศูนย์กระจายสินค้า แต่ก็เป็นงานที่มีต้นทุนแฝงสูงมากเมื่อวัดจากเวลาและร่างกายของคน ปัญหาหลักของการใช้ handheld scanner มี 3 ข้อ: Double Handling — ต้องวางสินค้าเพื่อหยิบเครื่องสแกน แล้วหยิบสินค้าขึ้นมาใหม่ เพิ่มเวลาต่อรอบการหยิบ 3–5 วินาที คูณด้วย 1,000 picks ต่อกะ เท่ากับเวลาที่หายไปเกือบชั่วโมงต่อคนต่อวัน การบาดเจ็บสะสม (RSI) — ท่าทางการหยิบ-วางเครื่องสแกนซ้ำ ๆ หลายพันครั้งต่อวัน คือสาเหตุของ repetitive strain injury ที่ข้อมือ นิ้ว และไหล่ ซึ่งการประเมิน ergonomics แบบเดิมมักจับไม่ได้ เพราะเกิดจาก micro-motion ขนาดเล็กที่ทำซ้ำต่อเนื่อง Error จากความล่าช้า — เมื่อมือไม่ว่าง พนักงานต้องจำรหัสสินค้าไว้แล้วสแกนทีหลัง ช่วงท้ายกะที่ความสนใจลดลงคือช่วงที่ mispick ระดับ 0.8–1.5% เกิดขึ้นบ่อยที่สุด เมื่อรวมกัน ปัญหาเหล่านี้ไม่ได้แค่ทำให้ช้าลง แต่ทำให้ ข้อมูลที่ป้อนเข้าระบบ WMS (Warehouse Management System) ล่าช้าและผิดพลาด ซึ่งส่งผลต่อความแม่นยำของทรัพยากรข้อมูลสต็อกทั้งคลัง Ring Scanner ทำงานอย่างไร Ring Scanner คือเครื่องสแกนขนาดเล็กที่สวมบนนิ้วด้วยสายรัดปรับขนาดได้ น้ำหนักเพียงประมาณ 35–60 กรัม ปล่อยให้นิ้วที่เหลือและฝ่ามือเป็นอิสระเต็มที่ หัวสแกนมี 2 เทคโนโลยีหลัก: Imager แบบ 2D — ใช้เซ็นเซอร์…
Read More
TSN (Time-Sensitive Networking): ชุดมาตรฐาน IEEE 802.1 ที่ปฏิวัติ Ethernet ให้กลายเป็นเครือข่ายเรียลไทม์สำหรับโรงงานอัตโนมัติ

TSN (Time-Sensitive Networking): ชุดมาตรฐาน IEEE 802.1 ที่ปฏิวัติ Ethernet ให้กลายเป็นเครือข่ายเรียลไทม์สำหรับโรงงานอัตโนมัติ

Article
TSN เปลี่ยน Ethernet มาตรฐานให้รองรับการสื่อสารแบบ Real-Time แบบกำหนดเวลา (ภาพประกอบ) TSN: มาตรฐาน IEEE 802.1 ที่ปฏิวัติ Ethernet ให้กลายเป็นเครือข่าย Real-Time สำหรับโรงงานอัตโนมัติ TSN (Time-Sensitive Networking) คือชุดมาตรฐานภายใต้ IEEE 802.1 ที่เพิ่มความสามารถด้าน Real-Time Deterministic Communication ให้กับ Ethernet มาตรฐาน ทำให้สามารถส่งข้อมูลที่ "ต้องถึงในเวลาที่กำหนดเท่านั้น" (deterministic latency) ได้อย่างแม่นยำในระดับไมโครวินาที ก่อนหน้า TSN ระบบอัตโนมัติที่ต้องการ Real-Time จำเป็นต้องใช้ Fieldbus หรือ Industrial Ethernet แบบ proprietary ซึ่งไม่สามารถทำงานร่วมกับเครือข่าย IT มาตรฐานได้ TSN มาแก้ปัญหานี้โดยให้ทั้ง IT และ OT ทำงานบน Ethernet เดียวกันได้ โดยที่ Real-Time traffic ยังคง latency ต่ำและ deterministic สถาปัตยกรรมหลักของ TSN: Time Synchronization + Scheduling TSN อาศัยพื้นฐานสำคัญสองอย่างที่ทำงานร่วมกัน: 1. Time Synchronization (IEEE 802.1AS) อุปกรณ์ทุกตัวในเครือข่ายต้องมีนาฬิกาที่ ตรงกันในระดับ sub-microsecond (±1 ไมโครวินาที) โดยใช้ gPTP (generalized Precision Time Protocol) ที่สืบทอดเวลาจาก Grandmaster Clock ไปยังทุก node ผ่านกระบวนการ clock synchronization แบบต่อเนื่อง ⚡ ความแม่นยำ: gPTP ใน TSN สามารถ sync เวลาแม่นยำถึง ±100 นาโนวินาทีในเครือข่าย LAN ซึ่งเทียบเท่ากับมาตรฐาน PTP (IEEE 1588) แต่ทำงานที่ Layer 2 โดยตรง 2. Time-Aware Scheduling (IEEE 802.1Qbv) เมื่อทุกอุปกรณ์มีเวลาตรงกัน ก็สามารถกำหนด TGATE (Time Gate) เพื่อสร้าง "ช่องเวลา" (Time Slot) สำหรับส่งข้อมูล…
Read More