
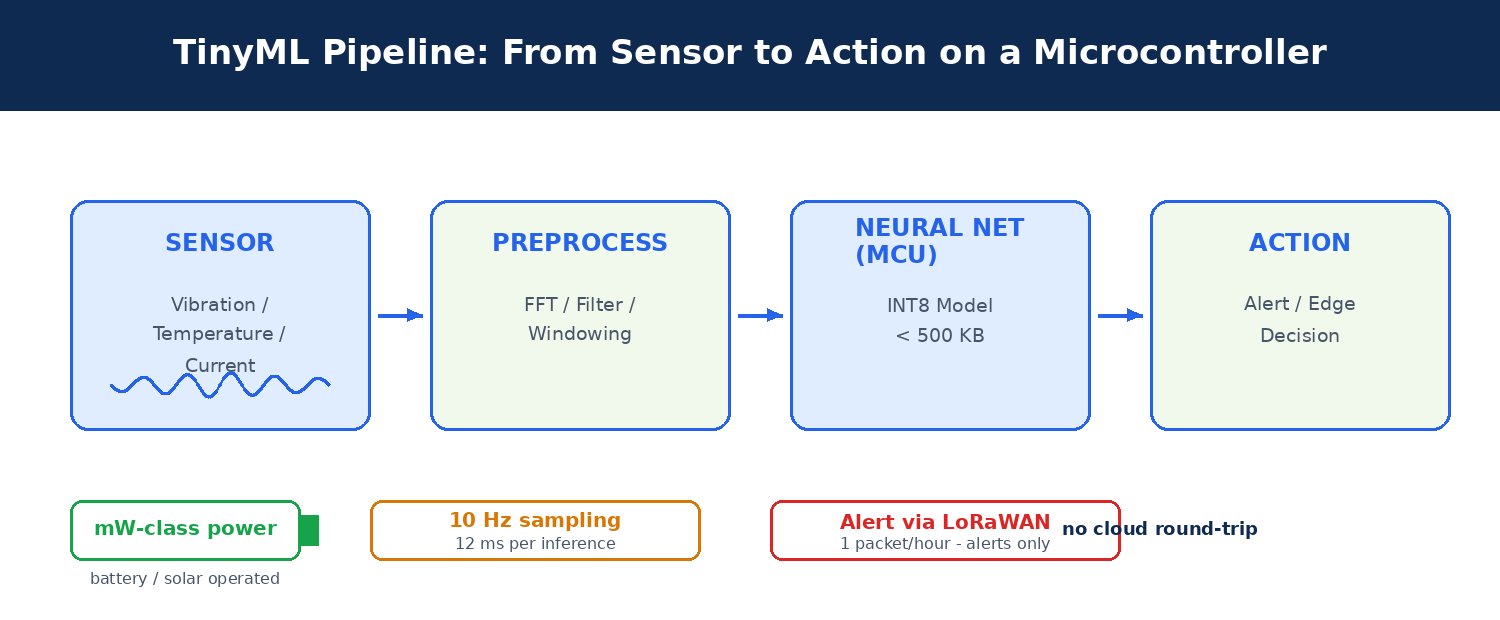
หลายโรงงานที่เริ่มใช้ AI ตรวจสอบสถานะเครื่องจักรมักเจอทางตันเดียวกัน คือสถาปัตยกรรมแบบ “ส่งข้อมูลขึ้นคลาวด์แล้วค่อยวิเคราะห์” ทำงานได้ดีในห้องทดลอง แต่เมื่อลงสนามจริงกับเซ็นเซอร์หลายร้อยจุด ปัญหาที่ตามมาคือค่า bandwidth, latency หลายร้อยมิลลิวินาที และความเสี่ยงเมื่ออินเทอร์เน็ตขาดกลางคัน คำตอบที่วงวิศวกร embedded เลือกใช้มากขึ้นเรื่อยๆ ในปี 2026 คือ TinyML — การฝากโมเดล Machine Learning ที่ผ่านการบีบอัดลงไปรันบนไมโครคอนโทรลเลอร์ (MCU) ที่มี RAM เพียงหลักร้อยกิโลไบต์ กินไฟระดับมิลลิวัตต์ และตัดสินใจได้เองที่ขอบเครือข่ายโดยไม่ต้องส่งข้อมูลดิบออกไปไหนเลย
TinyML คืออะไร และทำไมโรงงานควรสนใจ
TinyML คือสาขาย่อยของ Machine Learning ที่เน้นการ deploy และรันโมเดลบนอุปกรณ์ embedded ที่มีทรัพยากรจำกัด เช่น ไมโครคอนโทรลเลอร์ที่มี RAM เพียง “หลักสิบถึงหลักร้อยกิโลไบต์” flash จำกัด ไม่มี GPU และมักรันบน bare-metal หรือ RTOS เบาๆ ข้อจำกัดพวกนี้บังคับให้ทุกการตัดสินใจทางวิศวกรรมต้องแม่นยำ ตั้งแต่เลือกสถาปัตยกรรมโมเดลไปจนถึงวิธี quantize น้ำหนักโมเดล
เหตุผลที่แนวทางนี้โตเร็วในภาคอุตสาหกรรมชัดเจนมาก: การทำ inference บนตัวอุปกรณ์เองช่วยรักษาความเป็นส่วนตัวของข้อมูล (ไม่ต้องส่ง raw data ขึ้นคลาวด์), ยืดอายุแบตเตอรี่ และทำให้ระบบตรวจจับความผิดปกติทำงานต่อได้แม้เน็ตหลุด สำหรับโรงงานที่มีจุดวัดในพื้นที่ห่างไกลหรือสภาพแวดล้อมรุนแรง TinyML จึงเป็นเสมือน “ผู้เชี่ยวชาญที่ประจำอยู่ในเครื่องจักร” 24 ชั่วโมง
อาหารสมองของ TinyML: Quantization
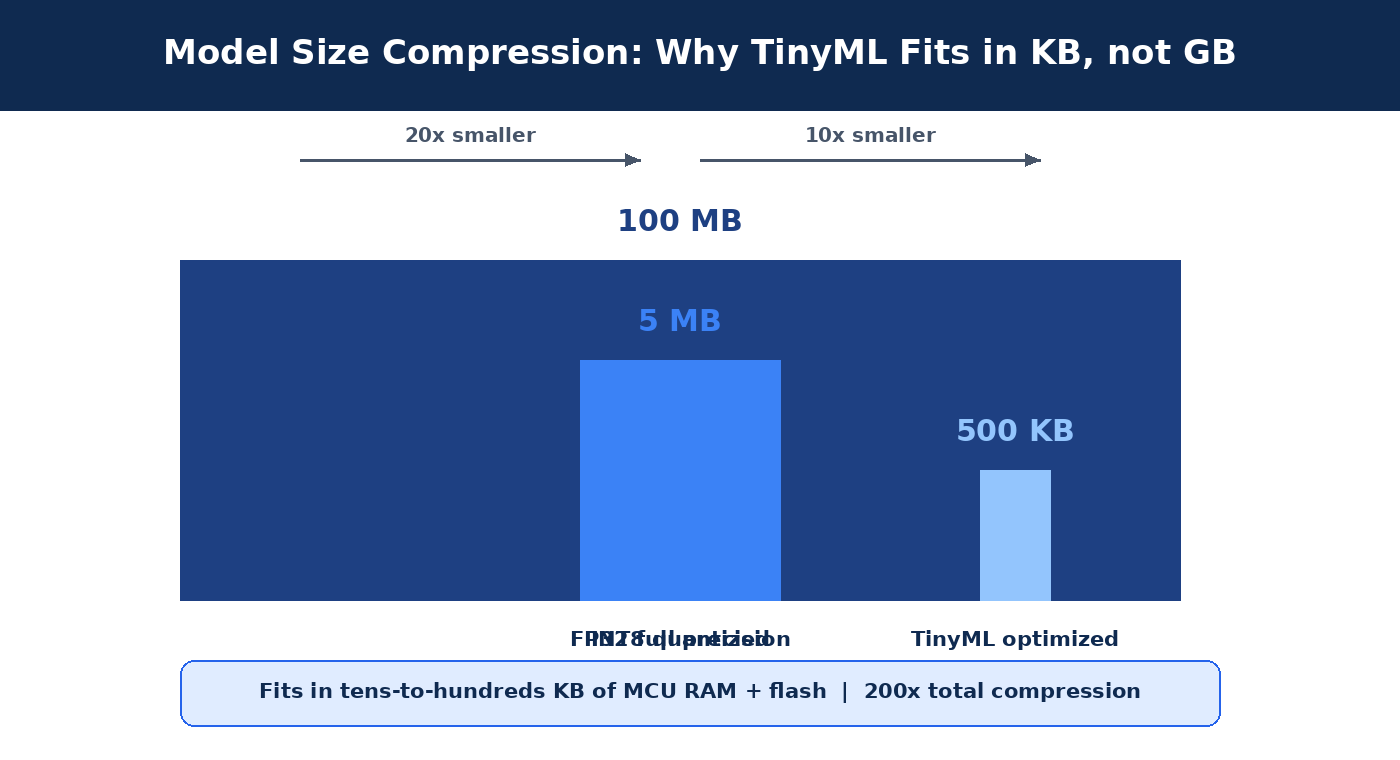
หัวใจที่ทำให้โมเดล AI ลงไปอยู่ใน MCU ได้คือเทคนิคบีบอัด โมเดล image classification สถาปัตยกรรมยอดนิยมขนาด 50 เลเยอร์ในความละเอียดเต็ม (FP32) มีขนาดราว 100 MB เมื่อแปลงเป็น INT8 ด้วย Post-Training Quantization (PTQ) จะเหลือประมาณ 5 MB และเมื่อปรับให้เหมาะกับงานเฉพาะแบบ TinyML แล้ว ขนาดที่ทำได้จริงคือระดับ 500 KB — เล็กลงราว 200 เท่าจากต้นฉบับ พอที่จะฝากลง flash ของ MCU ทั่วไปได้สบาย
เทคนิคหลักที่ใช้ในปี 2026 แบ่งเป็น 3 ระดับ:
- Post-Training Quantization (PTQ) — แปลงน้ำหนัก FP32 เป็น INT8 หลังเทรนเสร็จ เร็ว ใช้แรงน้อย และเสีย accuracy น้อยมาก เหมาะกับงานส่วนใหญ่
- Quantization-Aware Training (QAT) — จำลองการคำนวณ INT8 ระหว่างเทรน ได้ accuracy ดีที่สุดแต่ต้องเทรนใหม่ เหมาะกับงานที่ต้องการความแม่นระดับสูง
- Microscaling (MX) — ฟอร์แมต 4-bit/6-bit ยุคใหม่ที่ให้ประสิทธิภาพต่อพื้นที่ดีกว่า INT8 บนสถาปัตยกรรมรุ่นล่าสุด
ตารางเปรียบเทียบ: Cloud AI vs Edge AI vs TinyML
| มิติ | Cloud AI | Edge AI (Gateway/IPC) | TinyML (MCU) |
|---|---|---|---|
| Latency | 100–500 ms+ (อิงเน็ต) | 10–50 ms | 1–15 ms ในตัวชิป |
| พลังงาน | สูง (datacenter + ระบบส่งข้อมูล) | หลักวัตต์ | หลักมิลลิวัตต์ (mW) |
| Bandwidth | สูงมาก (ส่ง raw data ตลอด) | ปานกลาง | เกือบเป็นศูนย์ (ส่งเฉพาะ alert) |
| ความเป็นส่วนตัวข้อมูล | ต่ำ (ข้อมูลออกนอกไซต์) | ปานกลาง | สูงสุด (raw data ไม่ออกจากอุปกรณ์) |
| ทำงานตอนเน็ตล่ม | ไม่ได้ | ได้ (บางฟังก์ชัน) | ได้เต็มรูปแบบ |
| ขนาดโมเดล | ไม่จำกัด (GB–TB) | MB หลักสิบ–ร้อย | KB หลักสิบ–ร้อย |
| เหมาะกับ | โมเดลใหญ่, วิเคราะห์ข้ามโรงงาน | วิเคราะห์รวมหลายสายการผลิต | เฝ้าระวังต่อเครื่อง ณ จุดวัด |
เกณฑ์เลือกชิปและรันไทม์
ในปี 2026 ตลาด MCU สำหรับ Edge AI แยกเป็น 3 กลุ่มใหญ่ กลุ่มแรกคือ MCU พื้นฐานพร้อม software acceleration — ไลบรารีระดับ operator อย่าง CMSIS-NN ใช้ประโยชน์จาก SIMD และ cache-aware memory access ทำให้โมเดลเล็กๆ รันได้ดีโดยไม่ต้องมีฮาร์ดแวร์ AI เฉพาะทาง กลุ่มที่สองคือ MCU หัวก้าวหน้าที่มี NPU (Neural Processing Unit) ในตัวสำหรับงาน vision และ ML หนักกว่าปกติ และกลุ่มที่สามคือ crossover MCU ที่ผสม core สมรรถนะสูงกับ DSP และ ML acceleration เบลอเส้นระหว่าง MCU กับ application processor
ด้านรันไทม์ยอดนิยมคือ runtime ระดับ microcontroller ของชุดเครื่องมือ ML ยกกำลังสองที่สามารถพอร์ตได้กว้างและต่อยอดด้วยแพ็กเกจ operator ที่ใช้ประโยชน์จากคำสั่ง DSP เฉพาะของแต่ละแพลตฟอร์ม นอกจากนี้ยังมี runtime ข้ามแพลตฟอร์มแบบโอเพนสแตนดาร์ดที่แข็งแกร่งขึ้นเรื่อยๆ และเฟรมเวิร์กเฉพาะของแต่ละค่ายซิลิคอนที่ต่อยอดจาก SDK เดิม — จุดแลกเปลี่ยนคือความสะดวกใน ecosystem นั้นๆ กับความยืดหยุ่นในการย้ายข้ามแพลตฟอร์ม
Case Study จริง: 500 มอเตอร์อุตสาหกรรม กับ 12 มิลลิวินาทีต่อการตรวจหนึ่งครั้ง
ตัวอย่าง deployment จริงในปี 2026 ที่น่าอ้างอิงคือระบบเฝ้าระวังมอเตอร์อุตสาหกรรม 500 ตัว โดยแต่ละจุดวัดใช้ MCU พร้อม RAM เสริม 8 MB และโมเดล anomaly detection ที่รัน inference ทุก 100 ms (sample 10 Hz) ผลลัพธ์ที่วัดได้จริง:
- พลังงานเฉลี่ย 12 mW ต่อจุดวัด ทำให้ขับเคลื่อนด้วยแผงโซลาร์เซลล์ได้โดยไม่ต้องเดินสายไฟ
- Latency 12 ms ต่อการ inference หนึ่งครั้ง — เร็วกว่าการรอ round-trip ขึ้นคลาวด์หลายสิบเท่า
- Accuracy 94% ในการทำนาย bearing failure ล่วงหน้า 24 ชั่วโมงก่อนเกิด
- ส่งข้อมูลผ่าน LoRaWAN เพียงแพ็กเก็ตต่อชั่วโมง — ส่งเฉพาะ alert เมื่อ anomaly score เกิน 0.85 ไม่ใช่สตรีมข้อมูลดิบ
แปลเป็นภาษาธุรกิจง่ายๆ: ถ้าระบบเดิมต้องสตรีม waveform จาก 500 จุดวัดขึ้นคลาวด์ตลอดเวลา TinyML ช่วยลดปริมาณข้อมูลที่ต้องส่งออกจากโรงงานลงเหลือไม่ถึง 0.1% โดยไม่เสียความสามารถในการเฝ้าระวัง เพราะการ “เฝ้า” เกิดขึ้นในชิป ส่วนเครือข่ายมีหน้าที่แค่รายงานเหตุการณ์สำคัญเท่านั้น
ทีมงาน Honey Corporation มีประสบการณ์ติดตั้งระบบ IIoT monitoring ในโรงงานอุตสาหกรรมหลายแห่ง ทั้งงานเฝ้าระวังตู้แช่ Freezer และระบบเก็บข้อมูลเครื่องจักรแบบ real-time เราเห็นความท้าทายของการขยายระบบจาก pilot 10 จุดวัดไปสู่ production 500+ จุดวัดด้วยตัวเอง — bandwidth และความน่าเชื่อถือของเครือข่ายคือคอขวดจริง และแนวทาง on-device inference แบบ TinyML คือหนึ่งในเครื่องมือที่เราใช้ออกแบบสถาปัตยกรรมให้ลูกค้าให้ scale ได้จริง
Key Takeaways
- TinyML คือ ML บน MCU — RAM หลักสิบถึงหลักร้อย KB, พลังงานระดับ mW, inference ในตัวอุปกรณ์โดยไม่พึ่งคลาวด์
- Quantization คือกุญแจ — PTQ ลดโมเดลระดับ 100 MB เหลือ 5 MB, TinyML-optimized เหลือ 500 KB (เล็กลง ~200 เท่า)
- ตัวเลขจริงจาก deployment 2026: 12 mW ต่อจุดวัด, 12 ms ต่อ inference, ทำนาย bearing failure ได้ 94% ล่วงหน้า 24 ชม.
- เหมาะที่สุดกับงาน per-asset monitoring — vibration, temperature, current signature ของแต่ละเครื่องจักร ณ จุดวัด
- เลือกชิปตามงาน: MCU พื้นฐาน + CMSIS-NN เพียงพอสำหรับโมเดลเล็ก, MCU พร้อม NPU สำหรับ vision, crossover MCU สำหรับงานหลักล้านคำสั่งหนัก
- ออกแบบเครือข่ายใหม่: ส่งเฉพาะ alert (เช่น 1 แพ็กเก็ต/ชม. ผ่าน LoRaWAN) แทนการสตรีม raw data — ลด bandwidth ได้มากกว่า 99%
- ระวังจุดแลกเปลี่ยน: vendor framework สะดวกแต่ lock-in, runtime พอร์ตได้แต่ต้องเสียเวลา optimize เอง — ชั่งน้ำหนักตามทีมและอายุโครงการ
Honey Corporation พร้อมให้คำปรึกษา
ทีมงานของเรามีความเชี่ยวชาญด้านระบบ IIoT Monitoring และ Edge AI พร้อมออกแบบและติดตั้งระบบเฝ้าระวังเครื่องจักรแบบ TinyML ให้เหมาะกับธุรกิจของคุณ ตั้งแต่เลือกฮาร์ดแวร์ ออกแบบโมเดล ไปจนถึงเชื่อมต่อกับระบบ SCADA และ Dashboard ที่มีอยู่เดิม
📞 โทร: 09-23242995 | อีเมล: support@honey.co.th
เว็บไซต์: www.honey.co.th