ระบบ Predictive Maintenance ส่วนใหญ่ตอบคำถามได้แค่ “เครื่องนี้กำลังจะพัง” — แต่คำถามที่ Planner และ Production Manager ถามจริงคือ “อีกกี่สัปดาห์จะพัง” เพราะคำตอบนั้นแหละที่ตัดสินได้ว่าจะเลื่อนงานซ่อมไปรวมกับ Shutdown ครั้งถัดไปได้หรือไม่ คำถามนี้คืออาณาเขตของ Remaining Useful Life (RUL) ซึ่งกำลังเปลี่ยนจากงานวิจัยสู่เครื่องมือจริงในโรงงาน
RUL ไม่ใช่ตัวเลขเดียว — มันคือการกระจายความน่าจะเป็น
ความเข้าใจผิดที่พบมากที่สุดคือคาดหวังให้โมเดลตอบ “เหลืออีก 23 วัน” แบบเด็ดขาด ในความเป็นจริง RUL ที่ถูกต้องคือ ช่วงความเชื่อมั่น เช่น “มีโอกาส 90% ที่จะถึงเกณฑ์เสียหายภายใน 18–26 วัน” เพราะเครื่องจักรสองเครื่องรุ่นเดียวกันภายใต้โหลดต่างกันย่อมเสื่อมสภาพไม่เท่ากัน โมเดลที่ดีจึงต้องรู้จักบอกความไม่แน่นอนของตัวเองด้วย
สามเส้นทางของการทำนาย RUL
| แนวทาง | หลักการ | จุดแข็ง | ข้อจำกัด |
|---|---|---|---|
| Model-based | สมการฟิสิกส์ของกลไกเสื่อมสภาพ เช่น Paris Law ของรอยแตก | ตีความได้ ใช้ Data น้อย | ต้องรู้พารามิเตอร์เครื่องจักรชัดเจน ยืดหยุ่นต่ำ |
| Data-driven | Machine Learning เรียนจากข้อมูลวงจรชีวิตเครื่องจักรจริง | แม่นยำ ปรับตัวได้กับระบบซับซ้อน | ต้องการ Data เสื่อมสภาพจริงจำนวนมาก ตีความยาก |
| Hybrid | ผสมข้อจำกัดทางฟิสิกส์เข้าไปในโมเดล Data-driven | สมดุลความแม่นยำกับการตีความ | พัฒนาซับซ้อนที่สุด |
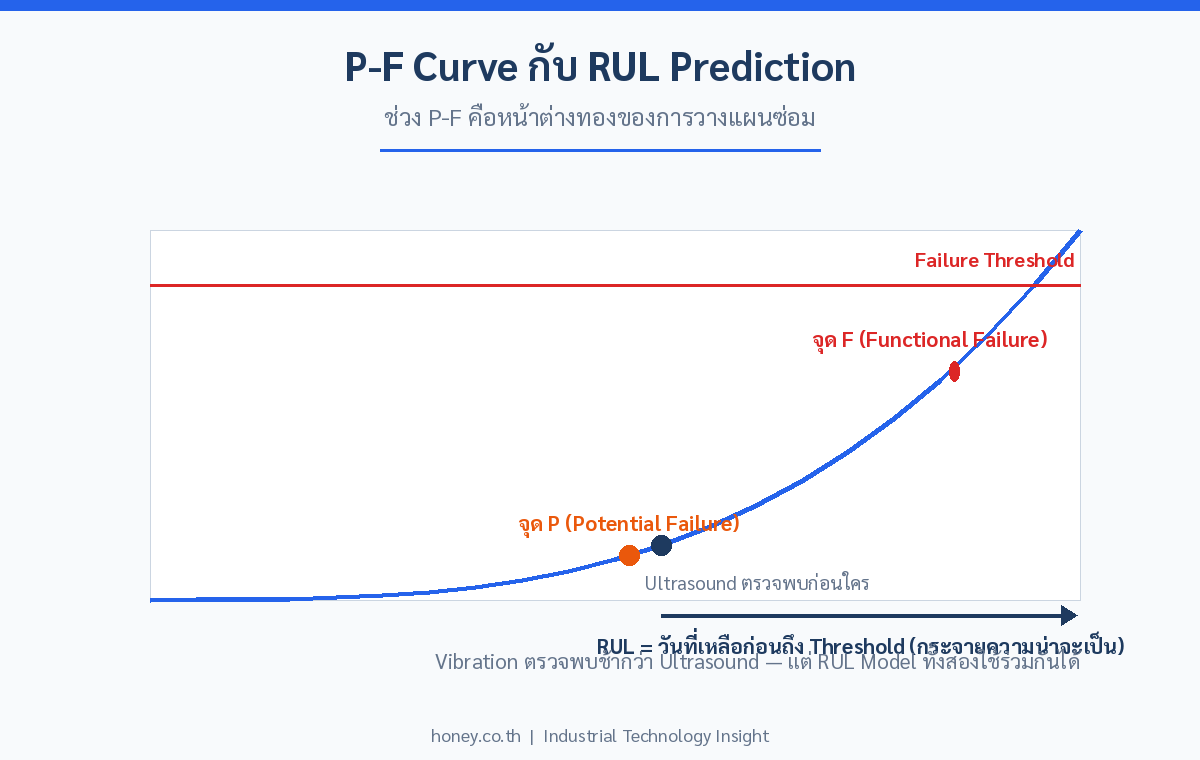
บน P-F Curve — RUL คือการประเมินความกว้างของหน้าต่างทอง
ทุกความเสียหายเชิงกลมี ช่วง P-F คือระยะจากจุดที่ตรวจพบได้ครั้งแรก (Potential Failure) ถึงจุดที่พังจริง (Functional Failure) เทคโนโลยีต่าง ๆ เห็นจุด P ไม่พร้อมกัน — Ultrasound มักเห็นก่อนสุด ตามด้วย Oil Analysis แล้วจึง Vibration การทำนาย RUL คือการประมาณว่าจากตำแหน่งปัจจุบันบนเส้นเสื่อมสภาพ ยังเหลือเวลาเท่าไรก่อนแตะเส้น Threshold ซึ่งยิ่งตรวจจับได้เร็ว หน้าต่างการวางแผนก็ยิ่งกว้าง
Deep Learning ไปได้ไกลแค่ไหน — หลักฐานจาก Benchmark จริง
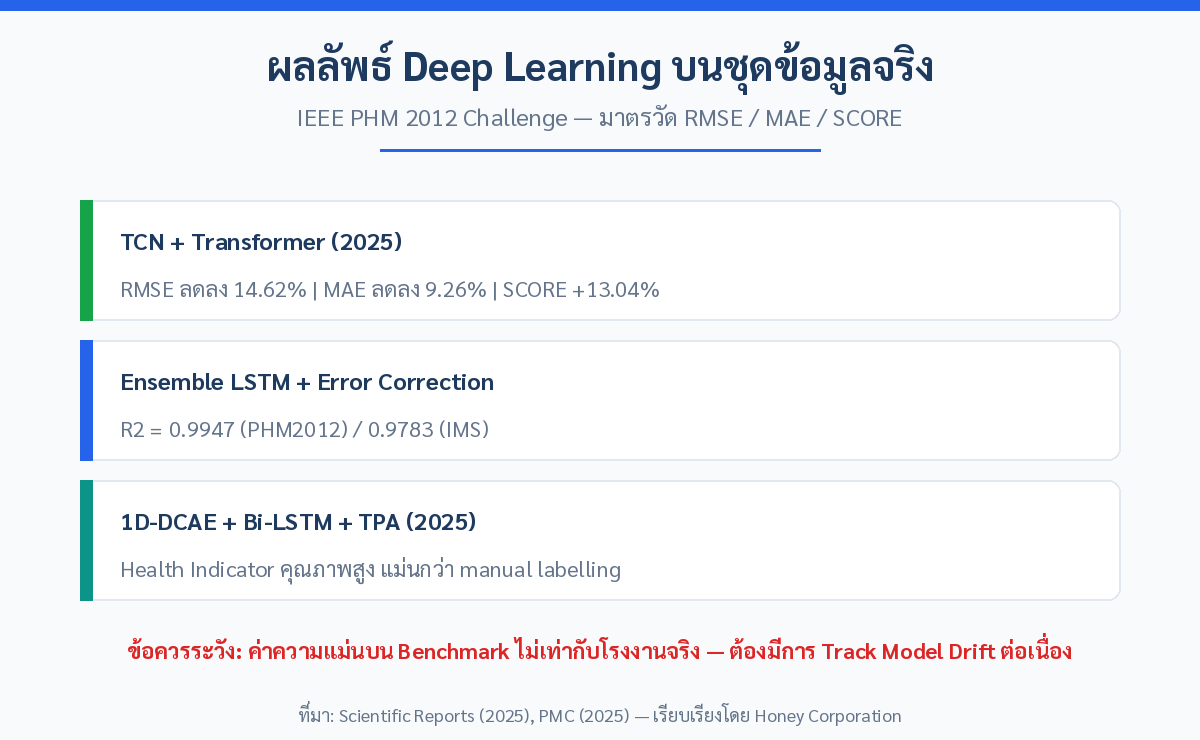
ชุดข้อมูล IEEE PHM 2012 Data Challenge (แบริ่งหมุนความเร็วสูงพร้อมข้อมูล Vibration จนถึงวันพังจริง) กลายเป็นสนามทดสอบมาตรฐานของวงการ ผลงานวิจัยล่าสุดปี 2025 น่าสนใจหลายชิ้น: โมเดลผสาน TCN + Transformer ลด RMSE ลง 14.62% และ MAE ลง 9.26% เทียบกับวิธีเดิม ขณะที่ Ensemble ของ LSTM และ GRU พร้อมกลไก Error Correction ทำ R² ได้ถึง 0.9947 บน PHM2012 และแนวทาง Autoencoder + Bi-LSTM + Temporal Attention แสดงให้เห็นว่าการสร้าง Health Indicator คุณภาพสูงก่อนเข้าโมเดลทำนาย สำคัญกว่าตัวโมเดลเอง
มุมมองของ Honey Corporation — เริ่มจาก Data ก่อนโมเดลเสมอ
จากประสบการณ์ลงมือติดตั้งระบบ IIoT Monitoring ในโรงงานจริง เราเห็นโครงการ RUL ล้มเหลวจากสาเหตุเดียวกันซ้ำ ๆ: เริ่มจากซื้อโมเดล ทั้งที่ Infrastructure ข้อมูลยังไม่พร้อม ความจริงคือก่อนจะมี RUL ต้องมีสามอย่าง — (1) ข้อมูล Sensor ต่อเนื่องมีคุณภาพพร้อม Time-stamp ที่เชื่อถือได้ (2) ประวัติการเสียหายและการซ่อมของเครื่องจักรนั้นจริง ๆ และ (3) Health Indicator ที่ทีมวิศวกรเชื่อถือ ตรงนี้คือจุดที่ประสบการณ์ System Integration ของทีม Honey Corporation เข้ามาช่วยได้ — เราออกแบบ Data Pipeline จาก Sensor ถึง Platform ให้พร้อมสำหรับงาน Advanced Analytics ตั้งแต่วันแรก ไม่ใช่มาเติมทีหลัง
อีกหนึ่งบทเรียนสำคัญ: ค่าความแม่นบน Benchmark ไม่เคยเท่ากับโรงงานจริง โหลด เศษวัสดุ อุณหภูมิ และการเปลี่ยนผู้ปฏิบัติงาน ล้วนทำให้โมเดลเก่าค่อย ๆ เพี้ยน (Model Drift) ระบบ RUL ที่ใช้ได้จริงต้องมีกระบวนการเฝ้าความเพี้ยนและ Retrain ต่อเนื่อง ไม่ใช่ติดตั้งครั้งเดียวจบ
Key Takeaways
- RUL ตอบคำถามที่ Planner ถามจริง — “เหลือกี่วัน” ไม่ใช่แค่ “จะพังหรือไม่”
- คำตอบที่ถูกต้องของ RUL คือการกระจายความน่าจะเป็นพร้อมช่วงความเชื่อมั่น ไม่ใช่ตัวเลขเดียว
- สามแนวทาง Model-based / Data-driven / Hybrid มี Trade-off ระหว่างความแม่นกับการตีความได้
- Benchmark จริงปี 2025: TCN+Transformer ลด RMSE 14.62%, Ensemble LSTM+GRU ทำ R² 0.9947 บน PHM2012
- Health Indicator คุณภาพสูงสำคัญกว่าสถาปัตยกรรมโมเดล — เริ่มจาก Data ที่เชื่อถือได้
- ช่วง P-F ยิ่งกว้าง (ตรวจจับเร็ว) โอกาสเลื่อนงานซ่อมไปรวม Shutdown ยิ่งเยอะ — Ultrasound + Oil Analysis ช่วยขยายหน้าต่างนี้
- อย่าลืม Model Drift — โมเดลที่ไม่ถูกเฝ้าระวังจะเพี้ยนเงียบ ๆ จนความเชื่อมั่นหายไปทั้งระบบ
Honey Corporation พร้อมให้คำปรึกษา
ทีมงานของเรามีความเชี่ยวชาญด้านระบบ IIoT Monitoring และ Data Infrastructure สำหรับ Predictive Analytics พร้อมออกแบบและติดตั้งระบบให้เหมาะกับธุรกิจของคุณ
📞 โทร: 09-23242995 | อีเมล: support@honey.co.th
เว็บไซต์: www.honey.co.th