How-to: ตั้งศูนย์เพลาด้วยเลเซอร์ 6 ขั้นตอน — กำจัด Misalignment ต้นตอแบริ่งพังซ้ำๆ ที่เปลี่ยนกี่ครั้งก็ไม่หาย

How-to: ตั้งศูนย์เพลาด้วยเลเซอร์ 6 ขั้นตอน — กำจัด Misalignment ต้นตอแบริ่งพังซ้ำๆ ที่เปลี่ยนกี่ครั้งก็ไม่หาย

Article
ในโลกของการบำรุงรักษาเชิงคาดการณ์ ทุกคนพูดถึงเซ็นเซอร์ AI และโมเดลทำนาย แต่มีต้นตอความเสียหายราคาแพงชนิดหนึ่งที่แก้ได้ด้วยเครื่องมือกล้องเลเซอร์ชิ้นเดียวภายในครึ่งวัน: ความคลาดเคลื่อนของศูนย์เพลา (Shaft Misalignment) สถิติสากลด้าน reliability ชี้ตรงกันมาหลายทศวรรษว่า ความคลาดเคลื่อนของศูนย์เพลาคือสาเหตุอันดับต้นของการเสียหายของแบริ่ง ซีล และคู่มือเพลา โดยเฉพาะเครื่องจักรหมุนที่เดินความเร็วสูง บทความนี้เป็นคู่มือแบบ How-to จาก Honey Corporation — อธิบายชนิดของ misalignment, ค่า tolerance ที่ยอมรับได้ตามความเร็วรอบ, และขั้นตอนตั้งศูนย์ด้วยเลเซอร์ 6 ขั้น ที่ทีมช่างของโรงงานทำตามได้จริงตั้งแต่ครั้งแรก คู่มือเพลา (Coupling) เชื่อมมอเตอร์กับชิ้นงาน — จุดเดียวที่ความคลาดเคลื่อนเพียงไม่กี่สิบไมโครเมตรจะถูกขยายเป็นแรงกระแทกนับล้านครั้งต่อชั่วโมง (ภาพ: Wikimedia Commons) Parallel vs Angular: เข้าใจศัตรู 2 แบบก่อนลงมือ Misalignment มี 2 แบบพื้นฐานที่มักเกิดร่วมกัน: Parallel (Offset) Misalignment — ศูนย์เพลาสองข้างขนานกันแต่ไม่อยู่แนวเดียวกัน เหมือนเส้นรถไฟสองสายที่เยื้องกัน ทำให้ coupling หมุนโค้งตลอดรอบ สร้างแรงสั่นความถี่สูงเป็น 2 เท่าของรอบเครื่อง (2×RPM) Angular (Gap) Misalignment — ศูนย์เพลาทำมุมต่อกัน เหมือนบันไดสองขั้นที่ลาดไม่เท่ากัน ทำให้ coupling บิดไป-กลับทุกรอบหมุน สร้างแรง axial vibration ที่ความถี่ 1×RPM และ 2×RPM ผสมกัน ในสนามจริงเกือบทุกกรณีคือแบบผสม — มีทั้ง offset และ angular ซ่อนอยู่ในหลายระนาบ ซึ่งเป็นเหตุผลที่การตั้งศูนย์ด้วยสายเทปหรือน้ำมันตรวจสอบขั้นพื้นฐานไม่เพียงพออีกต่อไปสำหรับเครื่องจักรสมัยใหม่ ตาราง Tolerance: ตัวเลขที่ต้องจำก่อนเปิดกล่องเครื่องมือ หลักการสำคัญ: ยิ่งเครื่องหมุนเร็ว ยิ่งต้องแม่น — ความคลาดเคลื่อนที่โรงงานจำนวนมากใช้กันจนชินคือค่าที่เขียนตามอกเขามาโดยไม่ได้คิด ตารางอ้างอิงที่ใช้กันทั่วไปในวงการตั้งศูนย์เลเซอร์ (ตามแนวทางมาตรฐานสากล เช่น แนวค่าที่ใช้กันในอุตสาหกรรมตามความเร็วรอบเครื่องจักร) มีหน้าตาแบบนี้: ความเร็วเครื่อง (RPM) Offset ที่ยอมรับ (mm) Angularity ที่ยอมรับ (mm/100mm) ผลกระทบถ้าเกิน 6000.200.20แบริ่งอายุสั้นลงเล็กน้อย เสียงดังขึ้น 1,8000.100.10แบริ่งร้อน น้ำมันรั่วที่ซีล เสียง 2×RPM ชัด 3,6000.050.05แบริ่งพังก่อนอายุมาก คู่มือเพลาสึก พลังงานสูญเปล่า แบริ่งความเร็วสูง / กังหัน0.02–0.030.02ความเสียหายรวดเร็ว อาจพังภายในหลักสิบชั่วโมง หมายเหตุ: ค่าข้างต้นเป็นค่าอ้างอิงทั่วไป — ผู้ผลิต coupling แต่ละรายและผู้ผลิตเครื่องจักรอาจกำหนดค่าเฉพาะที่เข้มงวดกว่านี้ ให้ยึดตามเอกสารของอุปกรณ์จริงเสมอ How-to:…
Read More
บทวิเคราะห์: Digital Twin กับปัญหา Model Drift — เมื่อโมเดล PdM เริ่มเพี้ยน Fleet Learning จะช่วยได้จริงหรือไม่

บทวิเคราะห์: Digital Twin กับปัญหา Model Drift — เมื่อโมเดล PdM เริ่มเพี้ยน Fleet Learning จะช่วยได้จริงหรือไม่

Article
โมเดล AI ทำนายความเสียหายของเครื่องจักร (Predictive Maintenance) ตัวหนึ่งในโรงงานสิ่งทอทำงานได้แม่นยำมากในปีแรก แต่ปีที่สองความแม่นยำเริ่มถดลง เพราะสภาพเครื่องจักรเปลี่ยน โหลดการผลิตเปลี่ยน และพฤติกรรม "ปกติ" ของเครื่องจักรเลื่อนไปจากเดิม นี่คือปัญหา Model Drift ที่ทุกโรงงานต้องเจอ และเป็นคำถามเปิดของวงการว่า Digital Twin จะช่วยแก้ได้จริงหรือไม่ บทวิเคราะห์นี้มองปัญหาจากมุมวิศวกรรม ไม่ใช่มุมการตลาด ปัญหา Model Drift ในโรงงาน: ทำไมโมเดลเก่าเร็วจนน่าใจหาย โมเดล Anomaly Detection ส่วนใหญ่เรียนรู้จากข้อมูลในอดีต แล้วตั้งสมมติฐานว่าอนาคตจะคล้ายอดีต แต่ในโรงงานจริง ไม่มีอะไรนิ่ง: ชิ้นส่วนสึกหรอ, สูตรผลิตเปลี่ยน, ผู้ปฏิบัติงานเปลี่ยนวิธีเดินเครื่อง, อุณหภูมิแวดล้อมตามฤดูกาล หรือแม้แต่การซ่อมบำรุงที่ "ปรับ" พฤติกรรมเครื่องจักรไปโดยสิ้นเชิง ผลคือเกิดการแจ้งเตือนเท็จ (False Alarm) เพิ่มขึ้นเรื่อยๆ จนทีมซ่อมบำรุงเริ่มกด "Dismiss" โดยไม่อ่าน — และวันหนึ่ง Alarm จริงก็ถูกกดไปพร้อมกับพวกเท็จ แนวทางแก้แบบดั้งเดิมคือ การเทรนซ้ำ (Retraining) ด้วยข้อมูลใหม่ แต่คำถามคือใครจะ Label ข้อมูลว่าอะไรคือ "ปกติ" ในสถานการณ์ใหม่ และต้องรอนานแค่ไหนจึงจะมีข้อมูลเพียงพอ เพราะความเสียหายจริงเกิดไม่บ่อยนัก แนวคิดใหม่: Fleet Learning ผ่าน Digital Twin แนวคิดที่กำลังได้รับความสนใจคือการใช้ Digital Twin เป็น "ผู้เรียนรู้ร่วมกัน" ของกลุ่มเครื่องจักรลักษณะเดียวกัน แทนที่จะปล่อยให้แต่ละเครื่องเรียนรู้ลำพัง: สถาปัตยกรรม Smart Factory ยุคใหม่เชื่อมทุกชั้นข้อมูลเข้าด้วยกัน — Fleet Learning เป็นการขยายแนวคิดนี้สู่กลุ่มเครื่องจักรข้ามไซต์ (ภาพ: Wikimedia Commons, CC BY 4.0) หลักการคือ เมื่อเครื่องจักร A ในไซต์ 1 เจอ Failure Mode ใหม่และถูกบันทึกไว้ใน Twin ของมัน ความรู้นั้นสามารถถ่ายทอด (Transfer) ไปยังโมเดลของเครื่องจักร B, C, D ที่อยู่คนละไซต์แต่มีลักษณะเดียวกันได้ทันที เครื่องจักรอื่นๆ จึง "รู้" ล่วงหน้าโดยไม่ต้องเจอเองก่อน นี่คือความต่างสำคัญจากการเทรนโมเดลแบบเก่าที่ต้องรอเครื่องเสียจริงทีละตัวเพื่อสะสมประสบการณ์ วิเคราะห์กลไกทางเทคนิค: Twin ช่วยแก้ Drift ได้อย่างไร กลไก วิธีการทำงาน ข้อดี ข้อจำกัดที่ต้องยอมรับ Simulation Augmentationใช้ Twin จำลองสถานการณ์ที่ยังไม่เคยเกิดจริง สร้างข้อมูล Synthetic สำหรับเทรนโมเดลได้ข้อมูล Failure…
Read More
How-to: สร้าง Digital Twin ของระบบควบคุมเครื่องจักรเก่า — ถอด Logic สู่ Behavioral Twin ใน 6 ขั้นตอน

How-to: สร้าง Digital Twin ของระบบควบคุมเครื่องจักรเก่า — ถอด Logic สู่ Behavioral Twin ใน 6 ขั้นตอน

Article
โรงงานที่มีเครื่องจักรอายุ 10–20 ปีกำลังเจอปัญหาเดียวกัน: ระบบควบคุมเก่า อะไหล่หายาก และไม่มีใครกล้าแตะ Logic ที่เขียนไว้สมัยคนละยุค — เพราะแก้แล้วไลน์อาจหยุดทั้งวัน บทความนี้คือคู่มือทีละขั้น การสร้าง Digital Twin ของระบบควบคุมเครื่องจักรเก่า เพื่อทดสอบทุกอย่างในโลกเสมือนก่อนแตะโลกจริง แม้เครื่องจักรตัวนั้นจะอายุ 15 ปีแล้วก็ตาม ทำไมต้องเป็น Twin ของ "ระบบควบคุม" ไม่ใช่แค่หน้าตาเครื่องจักร Digital Twin ของเครื่องจักรเก่ามี 2 ระดับ ระดับแรกคือ 3D Model ที่สวยงามเหมาะกับการนำเสนอ ระดับที่สองคือ Behavioral Twin ที่จำลองพฤติกรรมการควบคุมจริง: Logic การทำงาน, Sequence การเริ่มเครื่อง, Interlock, และการตอบสนองต่อคำสั่ง ระดับที่สองนี่แหละที่มีคุณค่าทางวิศวกรรม เพราะมันทำให้คุณทดลองแก้ Logic, ทดสอบ Patch ใหม่ และฝึกคน โดยไม่เสี่ยงหยุดไลน์ผลิตจริง ระบบ SCADA เก่าของโรงงานจำนวนมากยังใช้งานอยู่ แต่ Logic ที่ซ่อนอยู่ด้านหลังคือความเสี่ยงเมื่อผู้พัฒนาดั้งเดิมไม่อยู่แล้ว — Twin ช่วยถอดรหัสนี้ได้ (ภาพ: Wikimedia Commons, CC0) ภาพรวมก่อนเริ่ม: สิ่งที่ต้องมี ขั้นตอน สิ่งที่ได้ ระยะเวลาอ้างอิง* 1. ตรวจจับ Logic เดิมคลัง Logic ที่ถอดออกมาได้ครบ1–2 สัปดาห์ 2. สร้าง Behavioral Modelโมเดลจำลองพฤติกรรมเครื่องจักร2–4 สัปดาห์ 3. เชื่อมข้อมูลจริง (Soft Sensor)ข้อมูลสถานะเครื่องจักรเก่าแบบเรียลไทม์1–3 สัปดาห์ 4. Validate ด้วยข้อมูลจริงค่าความคลาดเคลื่อนของโมเดลที่ยอมรับได้ต่อเนื่อง 5. ทดลองแก้ Logic บน TwinPatch ที่ทดสอบแล้วว่าปลอดภัยตามโจทย์ 6. Deploy + ฝึกทีมทีมใหม่ที่เข้าใจเครื่องจักรเก่าต่อเนื่อง *ระยะเวลาขึ้นกับความซับซ้อนของเครื่องจักรและความสมบูรณ์ของเอกสารเดิม ขั้นที่ 1: ถอด Logic เดิมออกจากเครื่องจักร (Logic Extraction) เริ่มจากดึงโปรแกรมควบคุม (Ladder Diagram, Function Block) ออกจาก PLC เดิมให้ได้มากที่สุด ปัญหาคือหลายโรงงานสูญเสีย Source Code ต้นฉบับ เหลือแค่ไฟล์ Compile แล้ว หรือระบบเก่าจน Software สำหรับเปิดไม่รองรับ OS ปัจจุบัน แนวทางที่ใช้ได้จริง: Reverse Engineering…
Read More
Electrical Digital Twin: จำลองระบบไฟฟ้าทั้งโรงงานเพื่อวางแผนพลังงานยุคโซล่าร์+BESS อย่างเป็นระบบ

Electrical Digital Twin: จำลองระบบไฟฟ้าทั้งโรงงานเพื่อวางแผนพลังงานยุคโซล่าร์+BESS อย่างเป็นระบบ

Article
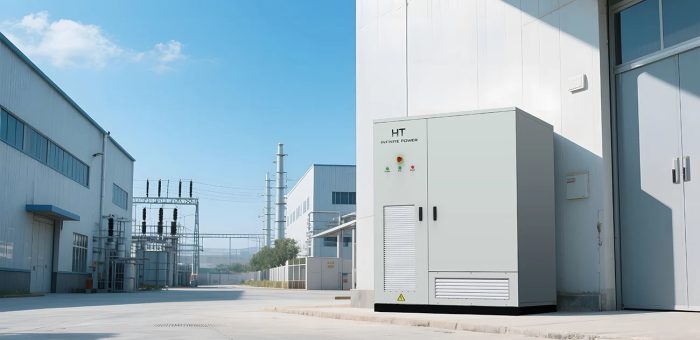
เมื่อพูดถึง Digital Twin ในโรงงาน คนส่วนใหญ่นึกถึงการจำลองเครื่องจักรหรือสายการผลิต แต่มีระบบหนึ่งที่ถูกมองข้ามบ่อยที่สุด ทั้งที่กินงบลงทุนมหาศาลและกำหนดต้นทุนต่อหน่วยผลิตของโรงงานโดยตรง นั่นคือ ระบบไฟฟ้าและพลังงานทั้งโครงข่าย — หม้อแปลง, Switchgear, Solar Rooftop, ระบบกักเก็บพลังงานแบตเตอรี่ (BESS), ระบบปรับอากาศ, และมอเตอร์นับพันตัวที่กระจายอยู่ทั้งโรงงาน วันนี้โรงงานไทยจำนวนมากติดตั้งโซล่าร์บนหลังคาและพิจารณาลงทุน BESS เพื่อลดค่าไฟช่วง Peak แต่การตัดสินใจเหล่านี้ส่วนใหญ่ยังอาศัยสูตรคำนวณแบบ Static จาก Excel ที่คำนวณครั้งเดียวตอนทำ ROI — คำนวณก่อนติดตั้ง แล้วไม่มีใครกลับมาเช็คอีกเลยว่าระบบจริงทำงานตรงกับที่คำนวณไว้หรือไม่ ตู้ระบบกักเก็บพลังงานแบตเตอรี่ (BESS) แบบระบายความร้อนด้วยอากาศสำหรับงานอุตสาหกรรม — หนึ่งในอสังหาริมทรัพย์พลังงานที่ Digital Twin ช่วยวางแผนการชาร์จ/คายประจุได้แม่นที่สุด (ภาพ: Wikimedia Commons, CC0) Electrical Digital Twin คืออะไร ต่างจาก Energy Dashboard อย่างไร หลายองค์กรมี Dashboard แสดงค่าไฟ ค่า Maximum Demand แล้ว และคิดว่านั่นคือ "การจัดการพลังงาน" แต่จริงๆ แล้วนั่นคือการ เฝ้าดูย้อนหลัง — เห็นว่าเมื่อวานค่าไฟเท่าไร แล้วก็จบ Electrical Digital Twin คือโมเดลจำลองทางไฟฟ้าของทั้งโรงงานที่สะท้อนสถานะ แบบเรียลไทม์ และสามารถ จำลองอนาคต ได้ ประกอบด้วย 3 ชั้น: ชั้นข้อมูล (Data Layer) — Power Meter, Power Quality Analyzer, และ Sensor ตามจุดสำคัญ ส่งข้อมูลแรงดัน กระแส กำลังไฟฟ้า ตัวประกอบกำลัง (Power Factor) และ Harmonics ผ่านโปรโตคอล Modbus TCP หรือ OPC UA ขึ้น Edge Gateway แบบต่อเนื่อง ชั้นโมเดล (Model Layer) — โมเดลวงจรไฟฟ้าแบบ One-Line Diagram ที่มีพารามิเตอร์จริงของหม้อแปลง สายไฟ และโหลด บางจุดผสม Physics-based Model (สมการวงจร) กับ Data-driven Model (ML) แบบ Hybrid Twin ชั้นจำลองสถานการณ์ (Simulation…
Read More
บทวิเคราะห์ Cloud Continuum: เลิกถามว่า ‘Edge หรือ Cloud’ แล้วเริ่มกำหนดนโยบายวาง Workload แบบต่อเนื่อง

บทวิเคราะห์ Cloud Continuum: เลิกถามว่า ‘Edge หรือ Cloud’ แล้วเริ่มกำหนดนโยบายวาง Workload แบบต่อเนื่อง

Article
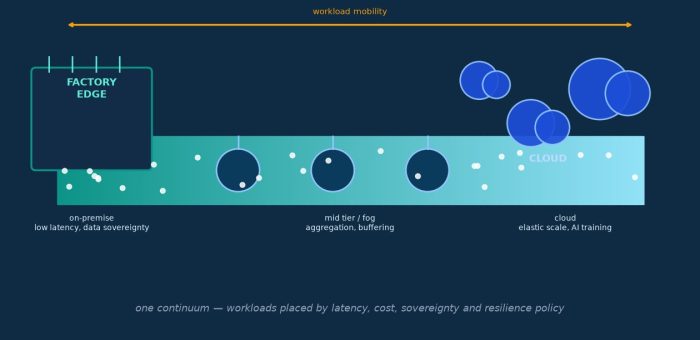
คำถามเก่าที่ยังไม่มีคำตอบสมบูรณ์: "งานนี้ควรอยู่ Edge หรือ Cloud" ตลอดหลายปีที่ผ่านมา การตัดสินใจว่า "งานไหนควรประมวลผลที่ไหน" เป็นคำถามที่ได้คำตอบแบบ binary: ถ้าต้องการเร็วให้อยู่ Edge, ถ้าต้องการ scale ให้อยู่ Cloud แต่เมื่อโรงงานหนึ่งมีทั้ง Edge Computer หลายสิบเครื่อง, on-premise server และบัญชี cloud ผู้ให้บริการหลายราย คำถามไม่ได้เป็นสองทางเลือกอีกต่อไป และเกิดปัญหาใหม่: ภาระการดูแลระบบที่กระจัดกระจาย (distributed sprawl) และ Silo ของข้อมูลที่ย้ายระหว่างกันไม่ได้ แนวคิดที่ตอบโจทย์นี้ในช่วงหลายปีที่ผ่านมาคือ Cloud Continuum — มองทรัพยากรคอมพิวติ้งทั้งหมดขององค์กรเป็น "ช่วงสเปกตรัมต่อเนื่อง" จาก on-premise edge ถึง public cloud ที่เชื่อมถึงกันด้วยเครือข่ายซอฟต์แวร์ (SDN) และ 5G แทนที่จะเป็นกล่องแยกส่วน งาน (workload) สามารถถูกวาง (place) และย้าย (migrate) ตามนโยบาย เช่น latency, อธิปไตยของข้อมูล (sovereignty) และความทนทาน ภาพประกอบ: การวาง workload บน continuum — แกนนอนคือเพดาน latency ที่งานยอมรับได้ (log scale) แกนตั้งคือประโยชน์จาก elasticity งานขวาบน (ฝึกโมเดล AI) ได้ประโยชน์จากคลาวด์มากที่สุด ส่วนงานซ้ายล่าง (motion control) ต้องอยู่ edge เสมอ จาก "เลือกที่" สู่ "กำหนดนโยบาย": วิธีคิดแบบ Continuum จุดเปลี่ยนสำคัญของมุมมองแบบ continuum คือการเปลี่ยนจากคำถาม "งานนี้ควรอยู่ที่ไหน" เป็น "นโยบายอะไรกำหนดว่างานนี้ควรอยู่ที่ไหน" ตัวอย่างเช่น: นโยบาย คำถามที่นโยบายตอบ ผลลัพธ์ต่อการวางงาน Latency ceiling งานยอมรับ delay เกิน X ms ได้หรือไม่? > 100 ms → ขึ้นคลาวด์ได้; < 10 ms → ต้องอยู่ edge/fog Data gravity ข้อมูลเกิดใหม่เร็วแค่ไหน และผู้บริโภคอยู่ไหน? ข้อมูล 1 kHz ต้องกรองที่ edge ก่อนส่งต่อ…
Read More
PREEMPT_RT ใน Linux Kernel 6.12: เมื่อ Edge Computer ของโรงงานกลายเป็น Real-Time Machine อย่างสมบูรณ์

PREEMPT_RT ใน Linux Kernel 6.12: เมื่อ Edge Computer ของโรงงานกลายเป็น Real-Time Machine อย่างสมบูรณ์

Article
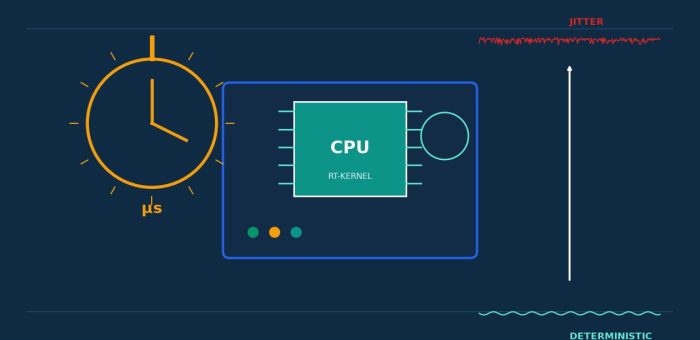
ทำไมโรงงานปี 2026 ยังต้องกังวลเรื่อง "ความหน่วงแบบสุ่ม" บน Edge Computer เมื่อคุณย้ายงานควบคุม การวิเคราะห์ หรือการตรวจจับความผิดปกติ จาก PLC/DCS ลงมาที่ Edge Computer ที่ใช้ระบบปฏิบัติการ Linux ทั่วไป สิ่งหนึ่งที่มักถูกมองข้ามคือ Scheduling Latency แบบสุ่ม (Jitter) — ความหน่วงระหว่าง "เหตุการณ์เกิดขึ้น" กับ "โปรแกรมได้รับโอกาสประมวลผล" ซึ่งบน Linux มาตรฐานอาจแกว่งจากไมโครวินาทีหลักร้อย ไปจนถึง หลายสิบมิลลิวินาที เมื่อระบบพร้อมกันรับภาระงานอื่น เช่น การเข้ารหัส TLS, การบีบอัดไฟล์ log, หรือการอัปเดตฐานข้อมูล local สำหรับ Dashboard หรือ Report ค่า Jitter ระดับนี้ไม่ใช่ปัญหา แต่ถ้างานนั้นคือ การปิด Interlock ภายใน 2 มิลลิวินาที, การสุ่มตัวอย่างแรงสั่นสะเทือน 1,000 ครั้ง/วินาทีแบบ sync กับมุม shaft, หรือการควบคุม Motion แบบ Soft Motion — Latency ที่แกว่ง 30 มิลลิวินาทีโดยไม่ทราบล่วงหน้า อาจหมายถึงชิ้นงานเสีย หรือแย่กว่านั้นคือความเสียหายต่อเครื่องจักร คำตอบที่วงการ Automation ใช้กันมาหลายสิบปีคือ RTOS (Real-Time Operating System) เฉพาะทางบน MCU แต่ปัญหาเปลี่ยนไปเมื่อ Edge AI, Protocol Gateway และ Container เข้ามาอยู่ในตู้คอนโทรลเดียวกัน — คุณต้องการทั้ง Ecosystem ของ Linux (Driver, Library, Toolchain) และ Determinism ของ RTOS ในเครื่องเดียว PREEMPT_RT ใน Linux Kernel 6.12: จุดจบของการติดตั้ง Patch เอง เหตุการณ์สำคัญที่เปลี่ยนเกมในช่วงปลายปี 2024 คือการประกาศรวมแพตช์ PREEMPT_RT เข้าสู่ Linux Kernel 6.12 (หลังพัฒนาต่อเนื่องกว่า 20 ปี) ทำให้ Kernel หลักสามารถเปิดโหมด Fully Preemptible ได้อย่างสมบูรณ์ และ 6.12 ยังเป็น…
Read More
How-to: วางระบบ Zero-Touch Provisioning (ZTP) สำหรับ Edge Gateway นับพันเครื่อง — จาก Voucher ถึงการเปลี่ยนอุปกรณ์เสียกลางดึก

How-to: วางระบบ Zero-Touch Provisioning (ZTP) สำหรับ Edge Gateway นับพันเครื่อง — จาก Voucher ถึงการเปลี่ยนอุปกรณ์เสียกลางดึก

Article
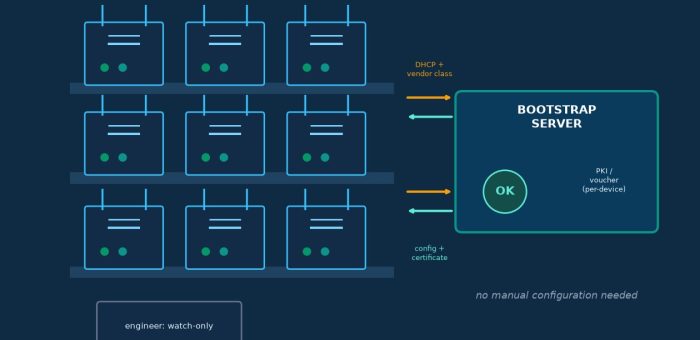
ปัญหาเดิมที่ทุกโครงการ IIoT ขนาดใหญ่เจอ: Onboarding อุปกรณ์ 500 เครื่องด้วยมือ ลองนึกภาพโครงการวาง Edge Gateway 200 เครื่องต่อโรงงาน 5 ไซต์ ช่างแต่ละคนต้องทำเหมือนกันหมด: เสียบสาย console เข้าอุปกรณ์ใหม่ ตั้งค่า IP ผ่าน terminal, แฟลชเฟิร์มแวร์เวอร์ชันที่ถูกต้อง, คัดลอกไฟล์ config ที่ต่างกันเล็กน้อยในแต่ละไซต์, สร้าง certificate สำหรับอุปกรณ์นั้น แล้วทดสอบว่าเชื่อมต่อได้จริง ครบวงจรประมาณ 30–60 นาทีต่อเครื่อง — คูณ 1,000 เครื่อง เท่ากับ คนงานหลายร้อยชั่วโมงของงานที่ทำซ้ำจนชำนาญความผิดพลาด และปัญหาไม่ได้จบที่การติดตั้งครั้งแรก: เมื่อพนักงานคนเดิมลาออก ไฟล์ config ที่ "อยู่ในเครื่องเท่านั้น" กลายเป็นหลักฐานลับที่ไม่มีใครรู้ การเปลี่ยนอุปกรณ์เสียกลางดึกต้องรอผู้เชี่ยวชาญเฉพาะทาง และการตรวจสอบว่าทั้ง 1,000 เครื่องยังใช้ config ตรงตามมาตรฐาน (Configuration Drift) แทบเป็นไปไม่ได้ คำตอบของปัญหานี้คือ Zero-Touch Provisioning (ZTP) — แนวทางที่อุปกรณ์ใหม่จากโรงงานผู้ผลิตสามารถ "ตื่นมาแล้วหาทางเข้าระบบเองได้" โดยช่างเพียงเสียบไฟและสาย LAN หลักการทำงาน: อุปกรณ์ต้องพิสูจน์ตัวเองก่อนรับ Config แนวคิดของ ZTP ถูกกำหนดเป็นมาตรฐานเปิด เช่น SZTP (RFC 8572) ซึ่งอธิบายกระบวนการ Bootstrap ที่ปลอดภัย หลักการสำคัญคือ อุปกรณ์ที่ยังไม่มี config ต้องไม่สามารถรับ config จากใครก็ได้ที่อ้างว่าเป็นเซิร์ฟเวอร์ และเซิร์ฟเวอร์ก็ต้องมั่นใจว่าอุปกรณ์ที่ขอ config เป็นของคุณจริง ไม่ใช่อุปกรณ์ปลอมที่ถูกแทรกเข้ามา ภาพประกอบ: ลำดับ Bootstrap แบบ Zero-Touch ตามแนว RFC — อุปกรณ์ขอ config ผ่าน DHCP option, พิสูจน์ความเป็นเจ้าของด้วย voucher, รับเฟิร์มแวร์และ config ผ่านช่องทางเข้ารหัส แล้วเข้าร่วม fleet โดยอัตโนมัติ ขั้นตอนสำคัญคือ Voucher — เอกสารดิจิทัลที่ผู้ผลิตอุปกรณ์ลงนามฝากไว้กับผู้ซื้อ (เจ้าของล็อตการผลิต) เมื่ออุปกรณ์ขอ config จาก registrar มันจะพิสูจน์ตัวผ่าน voucher นี้ และทั้งสองฝ่ายตรวจสอบกันและกันผ่าน PKI แบบรายเครื่อง (per-device certificate) ที่ถูกฝังตั้งแต่กระบวนการผลิต How-to: วางระบบ ZTP ในโรงงาน…
Read More
Humanoid Robot แบบ RaaS: คู่มือตัดสินใจ Rent vs Buy จาก 3 Use Case จริงปี 2026 — เมื่อผู้ผลิตชิ้นส่วนรายใหญ่ตั้งเป้า 2,000 ตัวภายในปี 2032

Humanoid Robot แบบ RaaS: คู่มือตัดสินใจ Rent vs Buy จาก 3 Use Case จริงปี 2026 — เมื่อผู้ผลิตชิ้นส่วนรายใหญ่ตั้งเป้า 2,000 ตัวภายในปี 2032

Article
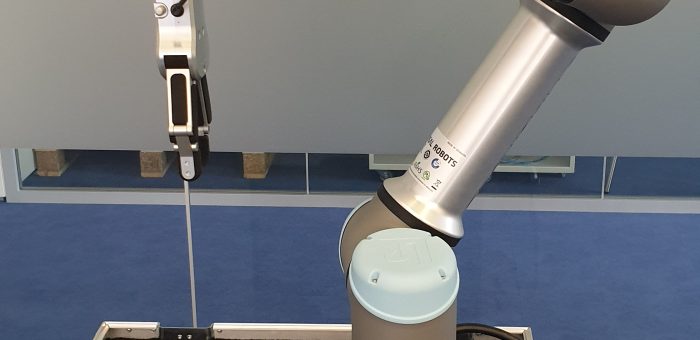
ปี 2026 หุ่นยนต์ฮิวแมนนอยด์ข้ามจากหน้าข่าวสู่สายการผลิตจริงแล้ว ตัวเลขล่าสุดที่น่าสนใจที่สุดคือแผนของผู้ผลิตชิ้นส่วนยานยนต์แถวหน้าของโลกรายหนึ่ง ที่จะติดตั้งหุ่นยนต์รูปแบบมนุษย์ 1,000–2,000 ตัวในโรงงานทั่วโลกภายในปี 2032 เริ่มที่โรงงานในเยอรมนีปลายปีนี้ ในรูปแบบ Robot-as-a-Service (RaaS) แต่ประเด็นของบทความนี้ไม่ใช่ "หุ่นยนต์เก่งแค่ไหน" แต่คือ คำถามที่ผู้จัดการโรงงานทุกคนต้องตอบก่อนเซ็นสัญญา: RaaS หรือซื้อขาด? เพราะเทคโนโลยีที่เปลี่ยนเร็วที่สุดในรอบสิบปี ความผิดพลาดในการเลือกรูปแบบการได้มาสามารถกินกำไรทั้งปีได้ 3 Use Case จริงที่กำหนดสนามแห่งใหม่ ก่อนตัดสินใจ เรามาดูว่าปี 2026 หุ่นยนต์ฮิวแมนนอยด์ทำอะไรได้จริงใน 3 กรณีอ้างอิงจากภาคการผลิต: Use Case รายละเอียดงาน ตัวเลขสำคัญ งานโหลดชิ้นงานงานเชื่อม (สหรัฐฯ)ทำงานร่วมกับสายการประกอบยานยนต์กว่า 11 เดือน, 5 วัน/สัปดาห์, กะละ 10 ชั่วโมง, ร่วมประกอบรถยนต์ 30,000+ คัน, โหลดโลหะ 90,000+ ชิ้นสำหรับฟิกเจอร์งานเชื่อมความแม่นยำการหยิบจับ >99% งานโลจิสติกส์และซัพพลายเชน (แคนาดา)ผู้ผลิตรถยนต์รายใหญ่ขยายการใช้งานสู่งานขนส่งภายในและซัพพลายเชนครบวงจรขยายจากงานทดลองสู่การผลิตจริง แผนปรับใช้ทั่วโลก (เยอรมนี)ผู้ผลิตชิ้นส่วนยานยนต์เริ่มต้นที่โรงงานในเยอรมนีปลายปี 2026 ผ่านรูปแบบ RaaSเป้า 1,000–2,000 ตัวภายในปี 2032 หุ่นยนต์รูปแบบมนุษย์ต้องทำงานร่วมกับคนและเครื่องจักรเดิมในพื้นที่เดียวกัน — ความปลอดภัยและการผสานระบบคือโจทย์ใหญ่กว่าความเก่งของตัวหุ่น (ภาพ: Wikimedia Commons, CC BY-SA 4.0) ทำไม RaaS กลายเป็นคำตอบของปี 2026 เมื่อเทคโนโลยีเปลี่ยนเร็ว การเป็นเจ้าของคือการแบกความเสี่ยงความล้าสมัยเอง RaaS เปลี่ยนหุ่นยนต์จากสินทรัพย์ที่ต้องเกษียณเป็นบริการที่อัปเกรดตามสัญญา ผู้ผลิตชิ้นส่วนรายใหญ่ที่ประกาศแผน 2,000 ตัวเลือก RaaS ไม่ใช่เพราะไม่มีเงิน แต่เพราะ ในช่วงที่ฮาร์ดแวร์และโมเดล AI อัปเกรดทุก 6–12 เดือน การล็อกตัวเองกับรุ่นใดรุ่นหนึ่งคือความเสี่ยง กรอบตัดสินใจ Rent vs Buy — งานที่ยังเปลี่ยนแปลงเร็วเหมาะกับ RaaS งานที่ล็อกแล้วเหมาะกับการซื้อขาด (แผนภาพ: Honey Corporation) Checklist 8 ข้อ ก่อนเซ็นสัญญา RaaS หุ่นยนต์ฮิวแมนนอยด์ เคสงานต้อง "เป็นรูปเป็นร่าง" ก่อน — เริ่มจากงานซ้ำที่วัดผลได้ เช่น การโหลดชิ้นงาน การยกสินค้าขึ้นแท่นวาง ก่อนคิดงานผสานทักษะ ถามเรื่อง Uptime ในสัญญา — บริการที่ดีต้องมี SLA ระบุเวลาทำงานจริงต่อสัปดาห์ ไม่ใช่แค่สเปกกระดาษ อ้างอิงมาตรฐานจาก use case จริง: 5 วัน ×…
Read More
บทวิเคราะห์: Gartner Hype Cycle for Agentic AI 2026 — องค์กรใช้ AI Agent จริงแค่ 17% และนี่คือสิ่งที่โรงงานต้องรู้ก่อนกระโดดขึ้นรถ

บทวิเคราะห์: Gartner Hype Cycle for Agentic AI 2026 — องค์กรใช้ AI Agent จริงแค่ 17% และนี่คือสิ่งที่โรงงานต้องรู้ก่อนกระโดดขึ้นรถ

Article
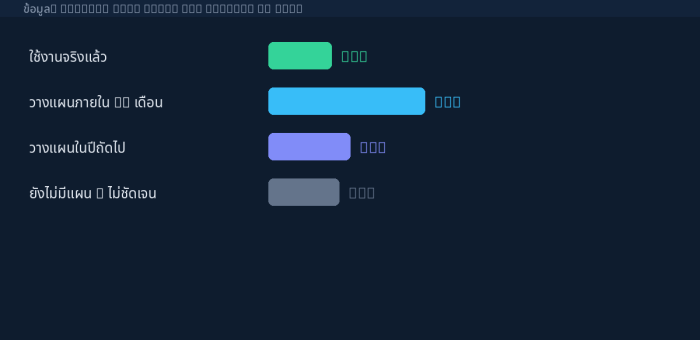
“AI Agent” คือคำที่ถูกพูดมากที่สุดในวงการเทคโนโลยีอุตสาหกรรมปี 2026 ทุกงานสัมมนามีประเด็นนี้ ทุกเวนเดอร์มีแพลตฟอร์มนี้ แต่ตัวเลขจริงจาก Gartner ฉายภาพที่ต่างออกไป: องค์กรที่ใช้ AI Agent ในการทำงานจริงมีเพียง 17% ในขณะที่ 42% วางแผนจะเริ่มภายใน 12 เดือน และอีก 22% มีแผนในปีถัดไป ช่องว่างระหว่าง “ความคาดหวัง” กับ “การใช้งานจริง” นี้แหละคือหัวใจของ Hype Cycle for Agentic AI 2026 ที่ Gartner เผยแพร่ล่าสุด และสำหรับโรงงานไทย นี่คือจังหวะที่ต้องตัดสินใจอย่างมีสติ ไม่ใช่ FOMO ตัวเลขบอกอะไร: 17% ที่เริ่มแล้วทำอะไรอยู่ กลุ่ม 17% ที่ใช้จริงส่วนใหญ่ยังโฟกัสที่ งานอัตโนมัติเฉพาะจุด (Automation เป็นหลัก) ยังไม่ใช่การเปลี่ยนแปลงกระบวนการทั้งองค์กร ซึ่งสอดคล้องกับสิ่งที่เห็นในโรงงานจริง: AI Agent ตัวแรกๆ ที่เวิร์กคือตัวที่ทำงานแคบและชัด เช่น อ่านค่าเซ็นเซอร์แล้วสรุปสรุปสถานะเครื่องจักร จัดลำดับงานซ่อมบำรุง หรือเตรียมรายงานกะกลางคืน 17% ใช้จริง / 42% จะเริ่มใน 12 เดือน / 22% ปีถัดไป — ความต่างขององค์กรจะเกิดในช่วง 12 เดือนข้างหน้า (ข้อมูล: Gartner, แผนภูมิ: Honey Corporation) 3 เทรนด์หลักที่ Gartner ระบุ — แปลเป็นภาษาโรงงาน เทรนด์ Gartner ความหมายต่อโรงงาน 1. AI Agent Adoption — 17% ใช้จริง, 42% ใน 12 เดือน หน้าต่างความได้เปรียบกำลังเปิด ผู้ที่เริ่มก่อนจะสะสมข้อมูลและบทเรียนก่อน แต่เริ่มผิดทางก็เสียเวลาเท่ากัน 2. Semi-Autonomous Deployment — มนุษย์ยังต้องควบคุม อย่ามองหา AI Agent ที่ “ตัดสินใจแทนทั้งหมด” ให้ออกแบบให้ Agent เสนอ + คนอนุมัติจุดวิกฤต เช่น การสั่งหยุดไลน์หรือเปลี่ยนแปลงพารามิเตอร์เครื่องจักร 3. Agent Washing — RPA เดิมแต่งตัวเป็น AI Agent ตรวจสอบให้ชัดว่าแพลตฟอร์มที่ซื้อ “คิดและปรับตัว” จริง หรือแค่รันสคริปต์เดิมที่เปลี่ยนชื่อ…
Read More
Case Study: โรงงานประภาคารแห่งแรกนอกจีนในอุตสาหกรรมเครื่องใช้ไฟฟ้าของไทย — ถอดสูตร 5G + AI + ESG จาก 208,000 ตร.ม. ในศรีราชา

Case Study: โรงงานประภาคารแห่งแรกนอกจีนในอุตสาหกรรมเครื่องใช้ไฟฟ้าของไทย — ถอดสูตร 5G + AI + ESG จาก 208,000 ตร.ม. ในศรีราชา

Article
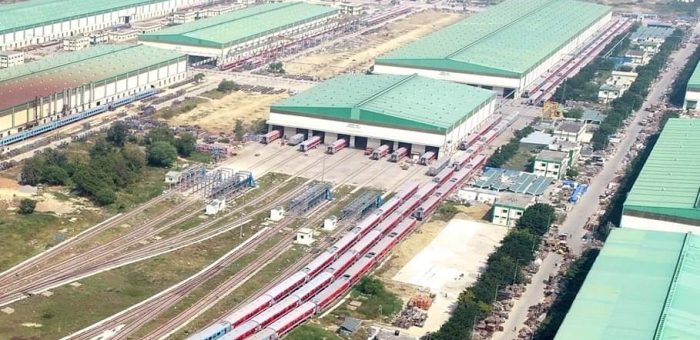
ตุลาคม 2026 ที่ผ่านมา สภาอุตสาหกรรมโลก (World Economic Forum) ประกาศสถานะ "โรงงานประภาคาร" (Lighthouse Factory) ให้กับโรงงานผลิตเครื่องปรับอากาศแห่งหนึ่งในนิคมอุตสาหกรรมปิ่นทอง จังหวัดชลบุรี นี่คือครั้งแรกของอุตสาหกรรมเครื่องใช้ไฟฟ้าที่โรงงานตั้งอยู่นอกประเทศจีนได้รับการรับรองระดับนี้ และเป็นหมุดหมายสำคัญของภาคการผลิตไทยบนแผนที่โลก กรณีนี้น่าสนใจไม่ใช่แค่เกียรติยศ แต่เพราะมันพิสูจน์ว่าโรงงานขนาดใหญ่ในไทยสามารถทำผลลัพธ์ที่วัดได้จริงจากเทคโนโลยีที่พูดถึงกันมานาน — แล้วตัวเลขที่ออกมาคืออะไร และโรงงานไทยทั่วไปเรียนอะไรได้บ้าง วันนี้เราจะเจาะทีละชั้น ขนาดของสนาม: เคสนี้ใหญ่แค่ไหน โรงงานแห่งนี้ตั้งอยู่บนพื้นที่ 208,000 ตารางเมตร (ราว 130 สนามฟุตบอล) ในเขตพัฒนาพิเศษภาคตะวันออก (EEC) ด้วยงบลงทุนระดับ 5,000 ล้านบาท และกำหนดเป้ากำลังผลิตเครื่องปรับอากาศภายในบ้านถึง 6 ล้านเครื่องภายในปี 2569 — สายการผลิตเครื่องปรับอากาศใหญ่ที่สุดในไทยและอาเซียนของกลุ่มบริษัทแม่ โรงงานยุคใหม่ระดับ "ประภาคาร" ถูกออกแบบให้ข้อมูลไหลได้ทั้งเส้น — จากซัพพลายเออร์ยันคลังสินค้า (ภาพประกอบ: Wikimedia Commons, CC BY-SA 4.0) Problem: ปัญหาที่โรงงานระดับนี้ต้องแก้ การผลิตเครื่องปรับอากาศล้านเครื่องต่อปี คือการจัดการความซับซ้อนมหาศาล: หลายพัน SKU, ชิ้นส่วนจากหลายร้อยซัพพลายเออร์, ความต้องการตามฤดูกาลที่พีคสูงมากในหน้าร้อน และแรงกดดันด้านต้นทุนพลังงานที่สูงขึ้นทุกปี ปัญหาคลาสสิกของโรงงานสายการประกอบขนาดใหญ่คือ: ข้อมูลติดอยู่ในเกาะ — แต่ละสายการผลิตมีข้อมูลของตัวเอง แต่รวมกลางไม่ได้แบบเรียลไทม์ การตรวจสอบคุณภาพตามหลัง — พบของเสียตอนท้ายไลน์ ทั้งที่สัญญาณเตือนมีอยู่ก่อนแล้ว AGV/รถลำเลียงจำนวนมาก ต้องการเครือข่ายที่เสถียรและมีดีเลย์ต่ำสม่ำเสมอ ซึ่ง Wi-Fi แบบเดิมตามไม่ทัน Solution: 5G เครือข่ายเดียว เป็นกระดูกสันหลังของทุกกระบวนการ หัวใจของโรงงานแห่งนี้คือการเป็นโรงงานแรกในอาเซียนที่ประยุกต์ เครือข่าย 5G เข้ากับการผลิตอัจฉริยะอย่างเต็มรูปแบบ จนได้รับรางวัล Best Mobile Technology Breakthrough in Asia จาก Asia Mobile Awards ปี 2567 สิ่งที่ 5G ปลดล็อกได้จริงในโรงงานคือ: Use Case ทำไมต้อง 5G ผลลัพธ์ที่วัดได้ ตรวจสอบคุณภาพด้วย AI Visionส่งภาพความละเอียดสูงจากกล้องหลายสิบตัวขึ้นประมวลผลแบบเรียลไทม์ตรวจจับข้อบกพร่องแบบเรียลไทม์ ลดของเสียได้ 20% ควบคุม AGV และการขนส่งภายในโรงงานดีเลย์ต่ำและเสถียร ทำให้การหลบหลีกและจัดคิวอัจฉริยะปลอดภัยการขนส่งภายในรองรับกำลังผลิต 6 ล้านเครื่อง/ปี สนับสนุนงานที่มีความเสี่ยงสูงระบบเตือนและควบคุมตอบสนองทันที ลดการสัมผัสจุดเสี่ยงของคนงานความปลอดภัยของบุคลากรเพิ่มขึ้น ตัวเลขผลลัพธ์ ESG จากการรับรอง Lighthouse: พลังงาน −40.2%, ของเสีย −20%, น้ำ −23.5% (แผนภูมิ: Honey Corporation) Results:…
Read More