Case Study: AR-Guided Changeover ตามหลัก SMED — ลดเวลาเปลี่ยนรุ่นสายการผลิตจาก 52 เหลือ 19 นาที

Case Study: AR-Guided Changeover ตามหลัก SMED — ลดเวลาเปลี่ยนรุ่นสายการผลิตจาก 52 เหลือ 19 นาที

Article
ที่มาของ Case Study: โรงงานประกอบเครื่องใช้ไฟฟ้าขนาดกลาง บทความนี้เป็น Case Study สังเคราะห์จากสถานการณ์ที่พบบ่อยในโรงงานประกอบภายนอกหลายแห่ง ซึ่งผู้เขียนสังเคราะห์จากแนวปฏิบัติมาตรฐานอุตสาหกรรมเพื่อการเรียนรู้ โรงงานประกอบเครื่องใช้ไฟฟ้าขนาดกลางแห่งหนึ่งผลิตชิ้นงานหลากหลายรุ่นบนสายการผลิตเดียวกัน ทุกครั้งที่เปลี่ยนรุ่น ทีม setup ต้องเปลี่ยน jig ปรับตำแหน่ง feeder และอัปโหลดโปรแกรมใหม่เข้าเครื่องจักร เวลา changeover เฉลี่ยอยู่ที่ 45-60 นาทีต่อครั้ง และเนื่องจากเปลี่ยนรุ่นถี่วันละ 3-4 ครั้ง เวลาที่หายไปจึงเทียบเท่ากับการสูญเสียกำลังผลิตหลายชั่วโมงต่อสัปดาห์ ปัญหาใหญ่ที่สุดไม่ใช่เวลาเฉลี่ย แต่คือ ความแปรปรวน (variance) การเปลี่ยนรุ่นครั้งเดียวกันโดยทีมต่างกันใช้เวลาต่างกันได้ถึง 40% เพราะพึ่งคู่มือกระดาษและความจำของช่างที่มีประสบการณ์ต่างกัน ผลคือการวางแผน production plan ต้องกัน buffer เวลาเผื่อไว้เสมอ Smart Glasses แสดงขั้นตอน setup ทีละขั้นตอนบนจอที่อยู่ในสายตา พร้อมเรียกวิดีโอสาธิตเมื่อจำเป็น (ภาพ: Wikimedia Commons) ขั้นตอนที่ 1: วิเคราะห์งานเปลี่ยนแม่พิมพ์ด้วยหลัก SMED ทีมปรับปรุงเริ่มจากวิดีโอการเปลี่ยนรุ่นจริง 12 ครั้ง แล้วแยกขั้นตอนเป็น Internal Setup (ต้องหยุดเครื่อง) กับ External Setup (ทำได้ขณะเครื่องยังเดิน) ตามหลัก SMED (Single-Minute Exchange of Die) ที่เผยแพร่โดยวิศวกรอุตสาหกรรมชาวญี่ปุ่น Shigeo Shingo เป้าหมายของ SMED ไม่ใช่การเปลี่ยนแบบใน 1 นาที แต่คือ "single-digit minute" คือต่ำกว่า 10 นาที โดยเป้าหมายขั้นสูงสุดคือ OTED (One-Touch Exchange of Die) ที่ต่ำกว่า 100 วินาที ผลการวิเคราะห์พบว่าขั้นตอน internal ที่กินเวลามากที่สุดคือ (1) ค้นหาอะไหล่และเครื่องมือที่กระจายอยู่หลายจุด (2) การไล่สายไฟและท่อลมที่ต้องถอด-ต่อใหม่ทุกครั้ง (3) การตรวจสอบคู่มือกระดาษที่เวอร์ชันไม่ตรงกัน และ (4) การทดลอง run ซ้ำหลายรอบเพราะพารามิเตอร์ตั้งไม่ตรงในครั้งแรก ขั้นตอน internal ที่กินเวลา % ของเวลา changeover สาเหตุราก แนวทางแก้ด้วย AR ค้นหาเครื่องมือ/อะไหล่15%จุดเก็บไม่มาตรฐาน ไม่มี kit ล่วงหน้าAR ชี้ตำแหน่งจุดเก็บ + checklist บนจอ ถอด-ต่อสายไฟ/ท่อลม30%ไม่มี quick-release connectorAR overlay แสดงลำดับถอดสาย +…
Read More
VR Ergonomic Risk Assessment: วิเคราะห์ท่าทางการทำงานด้วย REBA/RULA และ Digital Human Modeling

VR Ergonomic Risk Assessment: วิเคราะห์ท่าทางการทำงานด้วย REBA/RULA และ Digital Human Modeling

Article
ทำไม Ergonomics กลายเป็นงานวิศวกรรมที่ "วัดผลได้" ในยุคดิจิทัล ด้าน Ergonomics หรือ Human Factors Engineering เคยถูกมองเป็นเรื่อง "นามธรรม" ของโรงงานมานาน วิศวกรส่วนใหญ่รู้ว่าท่าทางการทำงานที่ผิดธรรมชาติคือต้นเหตุของการบาดเจ็บสะสม แต่การจะพิสูจน์ให้ฝ่ายบริหารเห็นตัวเลขที่ชัดเจนกลับทำได้ยาก นับตั้งแต่เครื่องมือประเมินเชิงสังเกตการณ์ (Observational Tools) อย่าง REBA (Rapid Entire Body Assessment) ที่เผยแพร่โดย Dr. Sue Hignett และ Dr. Lynn McAtamney ในวารสาร Applied Ergonomics เมื่อปี 1998 และ RULA (Rapid Upper Limb Assessment) ของ Dr. Lynn McAtamney และ Prof. E. Nigel Corlett ปี 1993 ปัญหานี้เริ่มมีทางออก เพราะเครื่องมือทั้งสองเปลี่ยน "ท่าทาง" ให้กลายเป็น "คะแนนความเสี่ยง" ที่บริหารจัดการได้ ปัญหาเดิมของวิธีสังเกตการณ์คือการนั่งจับอิริยาบถจากวิดีโอแล้วให้คะแนนทีละเฟรม ซึ่งใช้เวลามหาศาลและขึ้นกับวิจารณญาณของผู้ประเมิน VR ทำให้เรื่องนี้เปลี่ยนไป ชุดหูฟัง XR สมัยใหม่บันทึกตำแหน่งหัวและคอนโทรลเลอร์ด้วยระบบ Inside-out Tracking ที่ความถี่ 72-120 Hz ร่วมกับ Inertial Measurement Unit (IMU) ในตัวอุปกรณ์ ทำให้ได้ข้อมูลมุมข้อต่อที่ต่อเนื่องตลอดการทำงาน ไม่ใช่แค่ภาพนิ่ง 3-5 ภาพต่อรอบการประเมินแบบเดิม ชุด Motion Capture สำหรับบันทึกการเคลื่อนไหว ต้นทางของข้อมูลมุมข้อต่อที่ป้อนเข้าสู่การคำนวณ REBA/RULA อัตโนมัติ (ภาพ: Wikimedia Commons) จากท่าทางสู่ตัวเลข: กลไกการให้คะแนนของ REBA และ RULA เพื่อให้เห็นภาพว่า VR เปลี่ยนการประเมินให้เร็วขึ้นอย่างไร เราต้องเข้าใจกลไกใต้ปีกเครื่องมือสองตัวนี้ก่อน REBA จะแบ่งร่างกายเป็น 2 กลุ่ม กลุ่ม A ประกอบด้วย ลำตัว คอ และขา ส่วนกลุ่ม B คือ ต้นแขน ปลายแขน และข้อมือ แต่ละส่วนถูกให้คะแนนตามมุมที่วัดได้ เช่น ลำตัวเอนมากกว่า 60 องศาได้คะแนนมากกว่าการเอนเพียง 20 องศา จากนั้นนำมารวมกับตัวคูณเพิ่ม (Coupling Score) และน้ำหนักที่ยก ก่อนออกมาเป็นคะแนนรวม…
Read More
บทวิเคราะห์: Uncertainty Quantification — ทำไม Digital Twin ที่ดีต้องบอกว่า “ตัวเลขนี้เชื่อได้แค่ไหน”

บทวิเคราะห์: Uncertainty Quantification — ทำไม Digital Twin ที่ดีต้องบอกว่า “ตัวเลขนี้เชื่อได้แค่ไหน”

Article
เมื่อดิจิทัลทวินบอกว่า "อุณหภูมิจะเป็น 78°C ใน 30 นาที" — คุณควรเชื่อแค่ไหน? ค่าทำนายที่แม่นยำดูเหมือนของดี แต่ในโลกอุตสาหกรรม ตัวเลขเดียวที่ไม่บอกความมั่นใจคือข้อมูลครึ่งๆ กลางๆ ลองนึกภาพสองระบบ: ระบบ A ทำนายอุณหภูมิ 78°C, ระบบ B ทำนาย 78°C ± 6°C พร้อมช่วงความเชื่อมั่น 95% — ทั้งคู่ให้ตัวเลขกลางเดียวกัน แต่การนำไปใช้ตัดสินใจหยุดสายการผลิตหรือไม่ต่างกันคนละเรื่อง นี่คือเหตุผลที่ Uncertainty Quantification (UQ) กำลังกลายเป็นเกณฑ์ใหม่ของดิจิทัลทวินระดับมืออาชีพ ผลลัพธ์การจำลองเชิงตัวเลข ( finite element simulation) — เมื่อพารามิเตอร์ตั้งต้นไม่แน่นอน ผลลัพธ์ที่ได้ก็เป็นการกระจาย ไม่ใช่ค่าเดียว (ที่มา: Wikimedia Commons, CC BY-SA 3.0) ทำไมตัวเลขเดียวจึงไม่พออีกต่อไป รายงานฉบับสำคัญ Foundational Research Gaps and Future Directions for Digital Twins ของ National Academies of Sciences, Engineering, and Medicine (สหรัฐฯ, 2024) ระบุชัดเจนว่า uncertainty quantification ต้องเป็นส่วนหนึ่งของการออกแบบดิจิทัลทวินตั้งแต่ต้น ไม่ใช่ของตกแต่งท้ายโครงการ เพราะความไม่แน่นอนในระบบ twin มีหลายชั้นมากกว่าที่คิด: ชนิดความไม่แน่นอน ต้นกำเนิด ตัวอย่างในโรงงาน Aleatoric ความสุ่มตามธรรมชาติของกระบวนการ ความแปรปรวนของวัตถุดิบแต่ละล็อต, ความผันแปรของอุณหภูมิแวดล้อม Epistemic ความรู้ที่ยังไม่ครบถ้วน สัมประสิทธิ์สึกหรอที่ยังวัดไม่ได้, พฤติกรรมเครื่องจักรที่ยังไม่เคยเจอในข้อมูล Model การทำให้เป็นโมเดล (assumptions, สมการอย่างง่าย) สมการถ่ายเทความร้อนที่ตัดรายละเอียดมุมตายของหม้อต้มออก Numerical ข้อจำกัดของการคำนวณ ขนาด mesh ที่หยาบเกินไปเพื่อให้คำนวณทันเวลาจริง Data / Sensor ความคลาดเคลื่อนของการวัด เซ็นเซอร์อุณหภูมิความแม่นยำ ±0.5°C, ค่า drift หลังใช้งาน, สัญญาณรบกวน ประเด็นสำคัญที่มักถูกมองข้าม: สองชนิดแรกต้องจัดการคนละวิธี Aleatoric เป็นธรรมชาติของกระบวนการ ลดไม่ได้แต่บรรยายได้ด้วยการกระจายความน่าจะเป็น ส่วน Epistemic ลดได้ด้วยการเก็บข้อมูลเพิ่มหรือทดลองเพิ่ม — การแยกแยะให้ออกว่า error ที่เห็นมาจากไหน จึงกำหนดว่าควรลงทุนซื้อเซ็นเซอร์แม่นขึ้น (แก้ data) หรือปรับโมเดล (แก้ model) หรือทั้งคู่ เครื่องมือหลักของ UQ ในงานอุตสาหกรรม…
Read More
Case Study: Twin Decay — เมื่อ Digital Twin คลาดเคลื่อนเงียบๆ จนคนหยุดเชื่อ และวิธีฟื้นความเชื่อมั่นด้วย VVUQ

Case Study: Twin Decay — เมื่อ Digital Twin คลาดเคลื่อนเงียบๆ จนคนหยุดเชื่อ และวิธีฟื้นความเชื่อมั่นด้วย VVUQ

Article
Case Study: ดิจิทัลทวินที่ "เงียบๆ คลาดเคลื่อน" — บทเรียนจากโครงการจำลองระบบทำความเย็น โครงการดิจิทัลทวินจำนวนมากไม่ได้ตายด้วยการพังเด่นตัว แต่ตายอย่างเงียบๆ — ระบบยังเดินอยู่ dashboard ยังสวย ค่าทำนายยังออกมา แต่ไม่มีใครเชื่อมันอีกแล้ว เพราะตัวเลขคลาดเคลื่อนจากความจริงมากขึ้นเรื่อยๆ จนทีมผลิตกลับไปใช้สมุดบันทึกและประสบการณ์ กรณีศึกษาสมมติข้างนี้รวบรวมจากรูปแบบความล้มเหลวที่พบบ่อยในโครงการจำลองระบบอุตสาหกรรม เพื่อเป็นแผนที่ป้องกันสำหรับทีมที่กำลังจะเริ่ม ห้องควบคุม SCADA — จุดที่ทีมผลิตใช้ตัดสินใจทุกวัน ถ้าค่าทำนายของดิจิทัลทวินเริ่มเบี่ยงจากค่าจริง ความเชื่อมั่นจะหายไปเร็วกว่าที่คิด (ที่มา: Wikimedia Commons, CC BY-SA 4.0) สถานการณ์: โครงการที่เริ่มด้วยดี โรงงานผลิตอาหารแห่งหนึ่งลงทุนสร้างดิจิทัลทวินของระบบทำความเย็น (chiller plant) ที่หล่อเย็นถังหมัก โดยเชื่อมข้อมูลอุณหภูมิ ความดัน และอัตราการไหลจาก SCADA มาป้อนโมเดลทางกายภาพ (physics-based model) ที่จำลองสมการถ่ายเทความร้อน เป้าหมายคือทำนายอุณหภูมิน้ำเย็นที่ตัวถังล่วงหน้า 30 นาที เพื่อปรับตารางเดินเครื่องคอมเพรสเซอร์ให้เหมาะกับช่วงโหลดสูง ช่วง 3 เดือนแรกเป็นเรื่องราวความสำเร็จ: ค่าทำนายตรงกับเซ็นเซอร์จริง คลาดเคลื่อนเฉลี่ยไม่ถึง 0.5°C ทีมงานตื่นเต้นกับ dashboard ที่มองเห็นอนาคตล่วงหน้า แล้วความเชื่อมั่นก็เริ่มถดถอยโดยไม่มีใครทันรู้ตัว อาการ: ความเบี่ยงเบนที่โตขึ้นทีละน้อย หลังเดินระบบ 6 เดือน ค่าทำนายเริ่มเบี่ยงจากค่าจริงเป็น 1.2°C เฉลี่ย และบางช่วงโหลดสูงพุ่งถึง 2.5°C ซึ่งทีมยังอธิบายไม่ได้ว่า "โมเดลผิด" หรือ "เครื่องจักรเปลี่ยน" ปัญหานี้คือสิ่งที่วงวิชาการเรียกว่า twin decay — สภาวะที่โมเดลเสื่อมสภาพเรื่อยๆ เมื่อระบบกายภาพเปลี่ยนไปจากวันที่โมเดลถูกสร้างและพิสูจน์ สาเหตุที่สืบค้นได้จากบันทึกโครงการ ฟิล์มตะกอนในหม้อต้ม (fouling) เปลี่ยนสัมประสิทธิ์ถ่ายเทความร้อน — โมเดลใช้ค่าสัมประสิทธิ์จากข้อมูลตอน commissioning แต่หลอดความร้อนสะสมตะกอนขึ้นเรื่อยๆ ทำให้พฤติกรรมจริงเบี่ยงจากสมการเดิม เซ็นเซอร์ 2 ตัวถูกสอบเทียบใหม่ (recalibration) — ค่าที่เข้าโมเดลเปลี่ยนกระโดด แต่ไม่มีใครบันทึกว่า "input ของโมเดลเปลี่ยนนิยาม" ทำให้การเทียบกับข้อมูลเก่าเสีย โหลดโรงงานเปลี่ยนตามผลิตภัณฑ์ใหม่ — สูตรใหม่ที่หนืดกว่าทำให้ภาระความร้อนที่ถังหมักต่างจากช่วงที่ใช้เทรนและ validate โมเดล (data distribution shift) ไม่มีกระบวนการ revalidation ตามรอบ — ทีมตั้งสมมติฐานว่า "โมเดลถูกแล้วตลอดไป" จึงไม่มีตัวชี้วัดความสดของโมเดล และไม่มีใครรู้ตัวว่าความเชื่อมั่นกำลังไหลออก แนวคิด Control Chart ที่วิศวกรคุ้นเคยนำมาใช้กับ "ความเสื่อมของโมเดล" ได้ — ติดตาม error ระหว่างค่าทำนายกับค่าจริงเหมือนติดตามคุณภาพกระบวนการ แล้วตั้ง control limit ให้แจ้งเตือนเมื่อโมเดลเริ่มเบี่ยง (ที่มา: Wikimedia…
Read More
Knowledge Graph กับ Digital Twin: เมื่อกราฟความรู้ทำให้ดิจิทัลทวินเข้าใจโรงงานของคุณจริงๆ

Knowledge Graph กับ Digital Twin: เมื่อกราฟความรู้ทำให้ดิจิทัลทวินเข้าใจโรงงานของคุณจริงๆ

Article
ทำไมโรงงานจึง "มีข้อมูลมหาศาล แต่ตอบคำถามง่ายๆ ไม่ได้" คำถามที่ดูเหมือนง่ายอย่าง "เครื่องอัดกระแทกเนื้อ (hydraulic press) หมายเลข 7 ที่สาย 2 ใช้ VFD รุ่นไหน ติดตั้งเมื่อไร และเชื่อมกับ HMI ตัวไหน" มักต้องข้ามไปถาม 3 แผนก รอคำตอบ 2 วัน เพราะข้อมูลชิ้นนี้กระจายอยู่ใน Excel ของฝ่ายวิศวกรรม, ไฟล์ PDF แผนภาพ P&ID, ฐานข้อมูล SCADA และใบสั่งซื้อในระบบ ERP — ทุกระบบเก็บ "ข้อเท็จจริง" ไว้คนละที่ แต่ไม่มีระบบใดเก็บ "ความสัมพันธ์" ระหว่างข้อเท็จจริงเหล่านั้นเลย Digital Twin ยุคแรกแก้ปัญหาการ "เห็น" เครื่องจักรผ่านโมเดลสามมิติและข้อมูลเรียลไทม์ได้แล้ว แต่ความท้าทายระยะถัดไปคือการทำให้ดิจิทัลทวิน เข้าใจบริบท (context) ว่าอุปกรณ์แต่ละตัวเป็นใคร อยู่ที่ไหน ติดต่อกับใคร และมีความหมายอย่างไรต่อกระบวนการผลิต — นี่คือจุดที่ Knowledge Graph (กราฟความรู้) เข้ามาเป็นชั้นความหมายที่ขาดหายไป ตัวอย่างโครงสร้าง Knowledge Graph: เอนทิตี (วงกลม) เชื่อมกันด้วยความสัมพันธ์ที่มีความหมายชัดเจน (เส้น) — หลักการเดียวกับที่ใช้จัดระเบียบข้อมูลสินทรัพย์ในโรงงาน (ที่มา: Wikimedia Commons, CC0) Knowledge Graph คืออะไร และต่างจากฐานข้อมูลเดิมอย่างไร ฐานข้อมูลแบบตาราง (relational) ออกแบบมาเพื่อเก็บ "ข้อเท็จจริง" ที่โครงสร้างคงที่ เช่น รายการเครื่องจักร รายการใบสั่งซื้อ ส่วน Knowledge Graph ออกแบบมาเพื่อเก็บ "ความสัมพันธ์" เป็นชุดของ triple สามส่วน: หัวเรื่อง → ความสัมพันธ์ → วัตถุ เช่น Motor-M-201 → isPartOf → Line-2, Motor-M-201 → hasSensor → VIB-014, VIB-014 → measures → VibrationVelocity โครงสร้างพื้นฐานของ RDF triple (subject–predicate–object) ที่ Knowledge Graph ใช้เก็บความสัมพันธ์ระหว่างสินทรัพย์ในโรงงาน (ที่มา: Wikimedia Commons, CC BY-SA 4.0) เมื่อทุกข้อเท็จจริงเชื่อมกันเป็นสายโซ่ของความสัมพันธ์…
Read More
บทวิเคราะห์ Hybrid Cloud ในโรงงานอุตสาหกรรม 2026: งานไหนควรอยู่ On-premise งานไหนควรขึ้นคลาวด์

บทวิเคราะห์ Hybrid Cloud ในโรงงานอุตสาหกรรม 2026: งานไหนควรอยู่ On-premise งานไหนควรขึ้นคลาวด์

Article
คำถามที่ฝ่าย IT ของโรงงานไทยถามกันบ่อยที่สุดในปี 2026 ไม่ใช่ "ควรขึ้นคลาวด์ไหม" อีกต่อไป แต่คือ "งานไหนควรอยู่ที่ไหน" เมื่อระบบ SCADA, MES และ data platform ต้องทำงานร่วมกันทั้งบน on-premise และคลาวด์ คำตอบที่กำลังได้รับความนิยมคือ Hybrid Cloud — สถาปัตยกรรมที่ไม่เลือกข้าง แต่จัดวาง workload ตามลักษณะของงาน บทความนี้วิเคราะห์มุมมองของเราที่ Honey Corporation จากประสบการณ์ทำ System Integration ในภาคอุตสาหกรรมไทย ว่าเส้นแบ่งระหว่าง on-premise กับคลาวด์ควรอยู่ตรงไหนจึงจะได้ประโยชน์สูงสุดโดยไม่สร้างความเสี่ยงใหม่ เซิร์ฟเวอร์ในโรงงาน (on-premise) ยังคงเป็นที่พำนักของระบบ real-time control และข้อมูลดิบ — ขณะที่คลาวด์รับงานวิเคราะห์ระยะยาว (ภาพ: Wikimedia Commons) ทำไม "All-in Cloud" และ "All-in On-premise" ต่างก็ไม่ใช่คำตอบ ฝ่ายที่ผลักดัน all-in cloud มักอ้างเรื่องความยืดหยุ่น ไม่ต้องลงทุน hardware ล่วงหน้า และเข้าถึงบริการ AI ได้ทันที แต่ในบริบทโรงงาน มีสามข้อจำกัดที่ยังแก้ไม่ตก: Latency และ dependency — ระบบควบคุมกระบวนการผลิตต้องทำงานต่อแม้อินเทอร์เน็ตขาด การพึ่งพาคลาวด์ 100% ในงาน critical loop คือความเสี่ยงที่ยอมรับไม่ได้ ปริมาณข้อมูลดิบ — เซ็นเซอร์หลายพันจุดสร้างข้อมูลดิบมหาศาล การเก็บทั้งหมดบนคลาวด์เป็นการใช้ทรัพยากรอย่างสิ้นเปลือง ทั้งยังมีค่าใช้จ่าย egress เมื่อต้องดึงกลับมาวิเคราะห์ ข้อกำหนดด้านข้อมูล — ลูกค้าบางรายหรือกฎหมายบางประเทศกำหนดว่าข้อมูลกระบวนการผลิตบางประเภทห้ามออกนอกประเทศ ในทางกลับกัน all-in on-premise ก็แพ้ในเกมระยะยาว: ทีมงานจำกัด การขยายระบบช้า และการเข้าถึงเครื่องมือ AI/ML สมัยใหม่ที่คลาวด์พัฒนาออกมาตลอดเวลา ทำได้ลำบากกว่ามาก เส้นแบ่งที่เราใช้: วาง workload ตาม 4 คำถาม จากประสบการณ์ติดตั้งระบบให้โรงงานหลายแห่ง เราสรุปกรอบการตัดสินใจ 4 คำถาม ก่อนวาง workload ใดๆ ลงที่ไหน: Workload ความเร็วที่ต้องการ ลักษณะข้อมูล ที่วางที่เหมาะสม Real-time control / interlockมิลลิวินาทีข้อมูลดิบหมุนเร็วOn-premise (PLC/DCS) Line dashboard / Andonวินาทีข้อมูลรวมระดับสายผลิตOn-premise edge server OEE, production reportนาที–ชั่วโมงข้อมูลสรุปรายวัน/รายสัปดาห์Cloud ML…
Read More
How-to: ออกแบบ Edge-to-Cloud Data Pipeline สำหรับโรงงาน IIoT ใน 5 ขั้นตอน — จาก Data Source Inventory ถึงกฎการไหลของข้อมูล

How-to: ออกแบบ Edge-to-Cloud Data Pipeline สำหรับโรงงาน IIoT ใน 5 ขั้นตอน — จาก Data Source Inventory ถึงกฎการไหลของข้อมูล

Article
หลายโรงงานที่เริ่มทำ IIoT ติดอยู่ที่เดิม: เซ็นเซอร์ติดแล้ว ข้อมูลเห็นแล้ว แต่พอจะนำไปใช้จริงกลับพบว่าข้อมูลกระจัดกระจายในหลายระบบ รูปแบบไม่ตรงกัน และ dashboard ที่สวยงามนั้น ดูได้อย่างเดียว ไม่เชื่อมกับการตัดสินใจ รากของปัญหามักไม่ใช่เซ็นเซอร์หรือ AI แต่เป็น สายการไหลของข้อมูล (Data Pipeline) ที่ไม่ถูกออกแบบมาตั้งแต่ต้น บทความนี้เป็นคู่มือแบบทีละขั้น สำหรับวิศวกรที่ต้องการวาง pipeline จากเซ็นเซอร์ในสายการผลิต ผ่าน edge gateway ไปจนถึงคลาวด์อย่างเป็นระบบ — โดยไม่ต้องเป็น data engineer เต็มตัว สายการผลิตสมัยใหม่มีจุดเก็บข้อมูลกระจายอยู่ทั้งสาย — pipeline ที่ดีต้องรวมข้อมูลเหล่านี้ให้เป็นภาพเดียวก่อนส่งขึ้นคลาวด์ (ภาพ: Wikimedia Commons) ทำไมต้องเป็น Edge-to-Cloud (ไม่ใช่ส่งตรงขึ้นคลาวด์) ลองคำนวณง่ายๆ: มิเตอร์พลังงาน 200 จุด ส่งค่าทุก 1 วินาที รวมกว่า 17 ล้านค่าต่อวัน เพียงพอจะทำให้ฐานข้อมูลที่ออกแบบมาไม่ดีบวมในไม่กี่เดือน และการส่งข้อมูลดิบทั้งหมดขึ้นคลาวด์เป็นภาระ bandwidth ที่หลีกเลี่ยงได้ การคาดการณ์ของ Gartner ที่ชี้ว่าตลาด edge computing จะเติบโตจาก 131,000 ล้านดอลลาร์ (2023) สู่ 511,000 ล้านดอลลาร์ (2033) สะท้อนว่าโลกกำลังย้ายการประมวลผลกลับมาใกล้โรงงาน ไม่ใช่เพื่อแทนคลาวด์ แต่เพื่อส่งขึ้นคลาวด์เฉพาะ ข้อมูลที่มีคุณค่า Step 1: สำรวจและจัดทำ Inventory ของแหล่งข้อมูล ก่อนซื้ออุปกรณ์ใด ให้ทำ Data Source Inventory ให้ครบก่อน — ทุก PLC, VFD, มิเตอร์, เซ็นเซอร์ และไฟล์ที่คนงานบันทึกด้วยมือ ตัวอย่างตาราง: แหล่งข้อมูล โปรโตคอล อัตราการเก็บข้อมูล ปลายทางที่เหมาะสม PLC สายประกอบOPC UA100 msEdge สรุปผลก่อนส่ง Cloud VFD / มอเตอร์Modbus TCP1 วินาทีEdge (แจ้งเตือนความผิดปกติ) มิเตอร์พลังงานModbus RTU1 วินาทีEdge (สรุปเป็น profile 15 นาที) เซ็นเซอร์อุณหภูมิ/ความชื้นMQTT30 วินาทีEdge ส่งตรงขึ้น Cloud ตารางนี้จะบอกคุณเองว่าจุดรวมข้อมูล (aggregation point) ควรอยู่ที่ไหน และโปรโตคอลใดต้องการตัวแปลง Step 2: เลือก Edge Gateway ให้เหมาะกับงาน…
Read More
Edge Analytics ในโรงงานอุตสาหกรรม: วิเคราะห์ข้อมูลทันใจที่ตู้คอนโทรล ก่อนส่งขึ้นคลาวด์

Edge Analytics ในโรงงานอุตสาหกรรม: วิเคราะห์ข้อมูลทันใจที่ตู้คอนโทรล ก่อนส่งขึ้นคลาวด์

Article
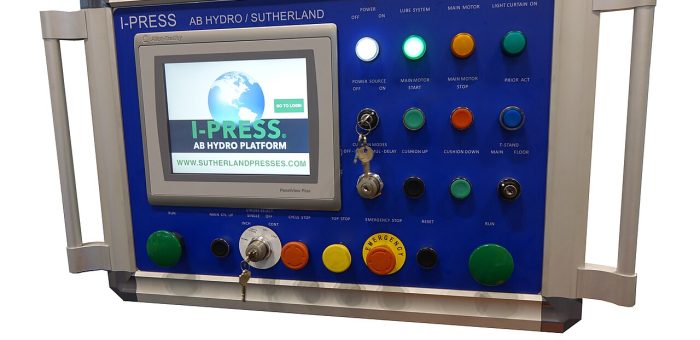
Edge Analytics คืออะไร — ในโรงงานสมัยใหม่ เซ็นเซอร์และเครื่องจักรหนึ่งแห่งสามารถผลิตข้อมูลได้วันละหลายกิกะไบต์ การส่งข้อมูลดิบทั้งหมดขึ้นคลาวด์ก่อนค่อยประมวลผลไม่ใช่คำตอบอีกต่อไป ทั้งจากค่า bandwidth, latency และความเสี่ยงเมื่ออินเทอร์เน็ตขาดหาย Edge Analytics คือการนำกระบวนการวิเคราะห์ข้อมูล — ตั้งแต่การกรองสัญญาณ คำนวณค่าสถิติ ไปจนถึงโมเดล AI — มาวางไว้ที่ edge of the network ใกล้กับแหล่งกำเนิดข้อมูล ไม่ว่าจะเป็น Edge Gateway ในตู้คอนโทรล คอมพิวเตอร์อุตสาหกรรมข้างสายการผลิต หรือเซิร์ฟเวอร์ในโรงงานเอง ผลลัพธ์คือการตัดสินใจเกิดขึ้นภายใน มิลลิวินาที แทนที่จะต้องรอไป-กลับคลาวด์หลายร้อยมิลลิวินาที ซึ่งเป็นความต่างระหว่าง "หยุดเครื่องทันเวลา" กับ "เสียชิ้นงานทั้งล็อต" แผงควบคุมอัตโนมัติที่เก็บ historical data ของเครื่อง press — จุดที่ Edge Analytics ทำงานจริง ก่อนข้อมูลจะถูกส่งขึ้นคลาวด์ (ภาพ: Wikimedia Commons) ทำไมปี 2026 ต้องพูดถึง Edge Analytics อีกครั้ง ตัวเลขสองชุดอธิบายได้ดีที่สุด รายงานของ IoT Analytics (Industry 4.0 & Smart Manufacturing Market Report 2026–2030) ระบุว่าตลาด Smart Manufacturing ทั่วโลกปี 2025 มีมูลค่า 175,000 ล้านดอลลาร์ และจะเติบโตด้วย CAGR 9.3% ไปแตะ 274,000 ล้านดอลลาร์ในปี 2030 ขณะที่ Gartner คาดการณ์ตลาด edge computing โลกจะขยายจาก 131,000 ล้านดอลลาร์ (2023) สู่ 511,000 ล้านดอลลาร์ภายในปี 2033 — เกือบ 4 เท่าใน 10 ปี แรงขับเคลื่อนที่แท้จริงไม่ใช่ตัวเทคโนโลยีเอง แต่เป็นสามแรงกดดันที่โรงงานไทยกำลังเผชิญ: (1) ปริมาณข้อมูลจาก IIoT sensor ที่เพิ่มขึ้นแบบทวีคูณจนส่งขึ้นคลาวด์ทั้งหมดไม่คุ้ม (2) งานที่ต้องการความเร็วระดับมิลลิวินาที เช่น การตรวจจับความผิดปกติของ vibration signature และ (3) นโยบาย data residency ที่บังคับให้ข้อมูลอ่อนไหวบางประเภทอยู่ในประเทศ สถาปัตยกรรม 3 ชั้นของ Edge Analytics Edge…
Read More
Case Study: อุปกรณ์ OT ติดอินเทอร์เน็ตโดยไม่รู้ตัว — จาก Flat Network สู่การแบ่งโซนตาม IEC 62443 ใน 4 ขั้นตอน

Case Study: อุปกรณ์ OT ติดอินเทอร์เน็ตโดยไม่รู้ตัว — จาก Flat Network สู่การแบ่งโซนตาม IEC 62443 ใน 4 ขั้นตอน

Article
สัปดาห์นี้เราเจอโจทย์คลาสสิกที่สุดจากโรงงานแปรรูปอาหารแห่งหนึ่ง: ระบบทำงานปกติทุกอย่าง แต่เมื่อทีมไอทีสแกนเครือข่ายเพื่อเตรียมขออนุมัติงบ IoT เพิ่ม กลับพบว่ามีอุปกรณ์ OT ที่ "ติดอินเทอร์เน็ตตรงๆ" โดยที่ไม่มีใครในโรงงานรู้ตัวมาก่อน กรณีแบบนี้ไม่ใช่เรื่องแปลก และตัวเลขล่าสุดยืนยันว่ามันระดับ "ระบาด" ไปแล้วทั่วโลก สถานการณ์: ตัวเลขที่ทำให้ทุกโรงงานต้องหยุดอ่าน งานวิจัยด้าน OT Security ล่าสุดที่วิเคราะห์ตัวอย่างจากอุปกรณ์ไฟร์วอลล์ OT กว่า 60,000 เครื่องทั่วโลก และตัวอย่างซอฟต์แวร์ 16 ล้านชิ้น พบว่าจำนวน อุปกรณ์ OT ที่เปิดใช้งานและมองเห็นได้จากอินเทอร์เน็ต เพิ่มขึ้น 332% เทียบกับช่วงสำรวจก่อนหน้า ขณะเดียวกันในภาคองค์กรทั่วไป ยังมีเครือข่ายที่ใช้สถาปัตยกรรมแบบแบน (flat network) อยู่ราว 77.7% และมีสัดส่วนการเชื่อมต่อ IoT ที่ถูกประเมินว่า "ความเสี่ยงสูง" ถึง 48.2% — เมื่อคูณสามตัวเลขนี้เข้าด้วยกันกับจำนวนอุปกรณ์เชื่อมต่อ 21.1 พันล้านเครื่อง จะได้ภาพคร่าวๆ ว่ามีการเชื่อมต่อระดับหลายพันล้านรายการที่ทำงานอยู่ในเครือข่ายที่ "แออัดและเปิดโล่ง" เกินไป ห้องควบคุมการผลิตคือหัวใจของระบบ OT — แต่ทุกแผงควบคุมที่ต่อเข้าเครือข่ายเดียวกับออฟฟิศโดยไม่มีการแบ่งโซน คือประตูเปิดที่ผู้โจมตีมองหา (ภาพ: Wikimedia Commons, CC BY 2.0) ปัญหา (Problem): ทำไมมันเกิดขึ้นได้ เครือข่ายแบน (Flat Network) — อุปกรณ์ทุกชนิดอยู่ใน VLAN เดียวกัน เมื่อเครื่องพิมพ์ออฟฟิศโดนเจาะ ผู้โจมตีเห็นชื่อ PLC และ HMI ใน scan ถัดไปทันที การเข้าถึงระยะไกลแบบทางลัด — ผู้รับเหมาหรือทีมซ่อมเปิด port forwarding บนเราเตอร์เพื่อ remote เข้าเครื่องจักรจากภายนอก แล้วลืมปิด กลายเป็นอุปกรณ์ OT ที่มองเห็นจากอินเทอร์เน็ต มองไม่เห็น = บริหารไม่ได้ — โรงงานส่วนใหญ่ไม่มีบัญชีสินทรัพย์ IT/OT ที่เป็นหนึ่งเดียว จึงไม่รู้ด้วยซ้ำว่ามีอุปกรณ์แปลกปลอมหลุดเข้ามาในเครือข่ายเมื่อไหร่ ทางแก้ (Solution): แบ่งโซนตาม IEC 62443 ทีละขั้น เราแนะนำแนวทางเดียวกับที่ใช้ในงานประเมินจริง คือแบ่งเครือข่ายเป็น โซน (Zone) และท่อร่วม (Conduit) ตามแนวคิดของมาตรฐานสากล IEC 62443 โดยเริ่มจาก 4 ขั้นตอนที่ทำได้จริงในโรงงานที่ยังผลิตอยู่: ทำ Asset Inventory ด้วย Passive Monitoring — ติดอุปกรณ์ดักฟังทราฟฟิก (ไม่ต้องหยุดการผลิต)…
Read More
บทวิเคราะห์ WRC 2026: เมื่อหุ่นยนต์ถูกถามว่า “ทำงานจริงได้หรือยัง” — สัญญาณจากปักกิ่งที่โรงงานไทยต้องอ่าน

บทวิเคราะห์ WRC 2026: เมื่อหุ่นยนต์ถูกถามว่า “ทำงานจริงได้หรือยัง” — สัญญาณจากปักกิ่งที่โรงงานไทยต้องอ่าน

Article
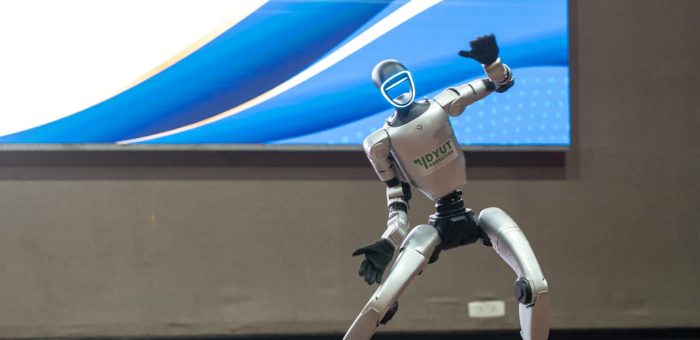
กลางเดือนสิงหาคมที่ผ่านมา งาน World Robot Conference (WRC) 2026 ที่ปักกิ่งปิดฉากลงด้วยภาพที่ต่างจากปีก่อนๆ อย่างชัดเจน — ไม่ใช่การแข่งกันอวดว่าโมเดลฉลาดแค่ไหน แต่เป็นการถูกถามคำถามตรงๆ ว่า "หุ่นยนต์ตัวนี้ทำงานจริงได้หรือยัง" และคำถามนั้น เป็นคำถามเดียวกันที่ผู้จัดการโรงงานในไทยถามทุกวัน ตัวเลขจากงานบอกอะไร ปีนี้ WRC มีผู้เข้าร่วมแสดงสินค้ามากกว่า 300 ราย เพิ่มขึ้นราว 40% จากปีก่อน พร้อมหุ่นยนต์บนเวทีราว 3,000 ตัว ในพื้นที่ 52,000 ตารางเมตร ขยายเป็น 4 ฮอลล์ แต่สิ่งที่น่าสนใจกว่าขนาดงานคือองค์ประกอบของคนในงาน: มี รัฐวิสาหกิจ (SOE) 49 แห่ง เดินทางมาร่วมกัน พร้อมส่งมอบ 12 สถานการณ์วิศวกรรมจริง ตั้งแต่งานโครงข่ายไฟฟ้า อวกาศ เหมืองแร่ ไปจนถึงงานโลหกรรม เพื่อหาโซลูชันหุ่นยนต์ที่ใช้งานได้จริง — ผู้ซื้อมาหาผู้ขายด้วยโจทย์จริง ไม่ใช่แค่มาชมเทคโนโลยี จาก VLA สู่ World Model — วิวัฒนาการที่โรงงานควรเข้าใจ กระแสเทคนิคที่เปลี่ยนไปจากปีก่อนคือ ปี 2025 คนพูดถึง Vision-Language-Action (VLA) model กันทั้งงาน แต่ปีนี้ผู้แสดงสินค้าหันมาพูดถึงการผสาน World Model เข้ากับ VLA แทน — งานวิจัยที่เผยแพร่บน arXiv ช่วงก่อนหน้านี้ก็ไปในทิศทางเดียวกัน โดยนำเสนอวิธี pre-train ที่ทำให้ policy เดียวทำงานข้ามรูปแบบหุ่นยนต์ที่ต่างกันได้ เหตุผลทางเทคนิคง่ายกว่าที่คิด: VLA เพียวๆ มองเห็นฉาก ตีความคำสั่ง แล้วสั่งการเคลื่อนไหวได้ แต่มันไม่ได้ "คาดเดา" ว่าสิ่งแวดล้อมจะเปลี่ยนไปอย่างไรหลังการกระทำนั้น เมื่องานยาวขึ้น ความผิดพลาดจึงสะสม และประสิทธิภาพตกทันทีที่เจอสถานการณ์ไม่คุ้นเคย — ซึ่งเป็นเรื่องปกติมากในสายการผลิตจริง ที่ตำแหน่งชิ้นงานคลาดเคลื่อนหรือของหลุดมือจาก pallet ได้ตลอดเวลา มุมเปรียบเทียบVLA เพียวๆVLA + World Model การมองสถานการณ์รับรู้ฉากปัจจุบันแบบ snapshotคาดการณ์การเปลี่ยนแปลงของสภาพแวดล้อม งานยาว (Long-horizon)error สะสม ประสิทธิภาพตกเสถียรกว่า เพราะคาดผลลัพธ์ก่อนลงมือ สถานที่ไม่คุ้นเคยต้องเทรนใหม่เมื่อ layout เปลี่ยน generalize ได้ดีกว่า ปรับตัวเร็วกว่า ความเร็วอนุมานเร็วกว่า (pipeline สั้น)ช้ากว่า แต่บางสถาปัตยกรรมลดช่องว่างได้ (มีรายงานเร็วขึ้น 2.71 เท่าจาก autoregressive แบบเดิม) การหยิบจับวัตถุด้วยมือหุ่นยนต์ในสภาพแวดล้อมจริง — งานที่ง่ายสำหรับคนแต่ยากที่สุดสำหรับโมเดล เพราะต้องคาดการณ์แรง…
Read More