Anomaly Detection สำหรับ Industrial AI: เทคโนโลยีตรวจจับความผิดปกติที่ทำงานได้ก่อนเกิดความเสียหาย

Anomaly Detection สำหรับ Industrial AI: เทคโนโลยีตรวจจับความผิดปกติที่ทำงานได้ก่อนเกิดความเสียหาย

Article
Anomaly Detection คืออะไร? และทำไมโรงงานอัจฉริยะถึงจำเป็นต้องมีวงจรงาน Machine Learning ในโรงงาน — ตั้งแต่เก็บข้อมูลเซ็นเซอร์จนถึงการใช้โมเดลตัดสินใจบนหน้างาน (ภาพประกอบ: Honey Corporation)วงจรงาน Machine Learning ในโรงงาน — ตั้งแต่เก็บข้อมูลเซ็นเซอร์จนถึงการใช้โมเดลตัดสินใจบนหน้างาน (ภาพประกอบ: Honey Corporation) Anomaly Detection หรือการตรวจจับความผิดปกติ คือเทคโนโลยี AI ที่เรียนรู้รูปแบบการทำงานปกติของเครื่องจักรและกระบวนการผลิตจากข้อมูลเชิงเวลา (Time-Series Data) แล้วแจ้งเตือนเมื่อพบพฤติกรรมที่แตกต่างจากเบสไลน์ โดยไม่ต้องรอให้เกิดความเสียหายก่อน ในโลกของ IIoT ที่เซ็นเซอร์หลายพันตัวส่งข้อมูลทุกวินาที Anomaly Detection คือ “ระบบภูมิคุ้มกัน” ที่ทำงานอัตโนมัติตลอด 24 ชั่วโมง ต่างจากระบบแจ้งเตือนแบบดั้งเดิมที่ตั้ง Threshold ตายตัว (เช่น “อุณหภูมิเกิน 80°C ให้แจ้งเตือน”) ระบบ Anomaly Detection ด้วย AI สามารถเข้าใจบริบทได้ เช่น อุณหภูมิ 75°C อาจปกติในช่วง Startup แต่ผิดปกติในช่วง Steady State ทำให้ลด False Alarm ได้อย่างมีนัยสำคัญ ประเภทของ Anomaly ในโรงงานอุตสาหกรรม ในแวดวง Industrial AI เราแบ่งความผิดปกติออกเป็น 3 ประเภทหลัก: Point Anomaly — จุดข้อมูลเดี่ยวที่แตกต่างจากค่าปกติอย่างชัดเจน เช่น ความสั่นสะเทือนกระโดดจาก 2 mm/s เป็น 15 mm/s ทันที มักบ่งชี้การชน หรือของแปลกปลอมเข้าระบบ Contextual Anomaly — ค่าที่ผิดปกติเฉพาะในบริบทหนึ่ง เช่น อุณหภูมิมอเตอร์ 70°C เป็นเรื่องปกติในช่วงโหลดสูง แต่ผิดปกติเมื่อมอเตอร์ Idle ระบบ AI ต้องเข้าใจบริบทการทำงาน Collective Anomaly — ลำดับข้อมูลที่ร่วมกันบ่งชี้ความผิดปกติ แม้ค่าแต่ละตัวยังอยู่ในช่วงปกติ เช่น อุณหภูมิค่อย ๆ สูงขึ้น 0.5°C ต่อวันนาน 2 สัปดาห์ — อาการคลาสสิกของ Bearing Deterioration 💡 Key Insight: Collective Anomaly เป็นประเภทที่อันตรายที่สุด เพราะระบบแบบดั้งเดิมมักตรวจไม่พบ การเสื่อมสภาพช้า ๆ ของเครื่องจักรสร้างความเสียหายสะสมนับล้านบาทก่อนที่ Threshold Alarm…
Read More
Complex Event Processing (CEP): เครื่องมือวิเคราะห์เหตุการณ์เรียลไทม์ที่ตรวจจับรูปแบบความผิดปกติก่อนเกิดความเสียหายในโรงงาน

Complex Event Processing (CEP): เครื่องมือวิเคราะห์เหตุการณ์เรียลไทม์ที่ตรวจจับรูปแบบความผิดปกติก่อนเกิดความเสียหายในโรงงาน

Article
Complex Event Processing (CEP) คือเทคโนโลยีที่วิเคราะห์กระแสเหตุการณ์ (Event Stream) ที่ไหลเข้ามาอย่างต่อเนื่อง แล้วตรวจจับ “รูปแบบ” (Pattern) ที่บ่งชี้ถึงสถานการณ์สำคัญ เช่น ความผิดปกติ ภัยคุกคาม หรือโอกาสทางธุรกิจ ภายในเวลาไม่กี่มิลลิวินาที — เร็วกว่าการวิเคราะห์แบบ Batch แบบดั้งเดิมนับพันเท่า ในโรงงานอัจฉริยะ เซ็นเซอร์หลายพันตัวส่งข้อมูลเข้ามาทุกวินาที ไม่ว่าจะเป็นอุณหภูมิ ความดัน ความสั่นสะเทือน หรืออัตราการไหล เหตุการณ์ (Event) เดี่ยวๆ แต่ละตัวอาจดูปกติ แต่เมื่อนำมาประกอบกันในช่วงเวลาใกล้เคียง อาจเปิดเผยภาพที่บ่งชี้ความเสียหายที่กำลังจะเกิดขึ้น Complex Event Processing คือเครื่องมือที่ทำหน้าที่ “เชื่อมจุด” เหล่านี้เข้าด้วยกันแบบเรียลไทม์ CEP ทำงานอย่างไร?โปรโตคอลสื่อสารในระบบ IIoT — แต่ละชั้นของระบบสื่อสารในโรงงานใช้มาตรฐานต่างกันตามหน้าที่ (ภาพประกอบ: Honey Corporation)โปรโตคอลสื่อสารในระบบ IIoT — แต่ละชั้นของระบบสื่อสารในโรงงานใช้มาตรฐานต่างกันตามหน้าที่ (ภาพประกอบ: Honey Corporation) CEP Engine ทำงานด้วยแนวคิด Event-Driven Architecture แทนที่จะรอข้อมูลสะสมแล้วค่อยประมวลผล (Batch Processing) ระบบจะประมวลผลทุกเหตุการณ์ทันทีที่เข้ามา โดยรักษาเหตุการณ์ไว้ใน Sliding Window ซึ่งคือช่วงเวลาเลื่อนไปเรื่อยๆ เช่น “30 วินาทีล่าสุด” หรือ “100 เหตุการณ์ล่าสุด” แล้วตรวจสอบว่ามีรูปแบบที่ตรงเงื่อนไขหรือไม่ ขั้นตอนหลักมี 4 ข้อ: Ingestion — รับเหตุการณ์จากเซ็นเซอร์ผ่าน Message Broker (เช่น MQTT, AMQP) ด้วยอัตราหลายหมื่นถึงหลายแสนเหตุการณ์ต่อวินาที Pattern Matching — เปรียบเทียบเหตุการณ์ใน Window กับกฎ (Rule) ที่กำหนดไว้ เช่น “อุณหภูมิเกิน 90°C ติดต่อกันเกิน 5 ครั้ง ภายใน 10 วินาที” Complex Event Generation — เมื่อพบรูปแบบ สร้าง “Complex Event” ใหม่ที่สรุปสถานการณ์ เช่น “Overheating Alert ที่เตาอบเบอร์ 3” Action — ส่งสัญญาณเตือน, สั่งงดการผลิต, หรือ trigger ระบบควบคุมอัตโนมัติ ประเภทของ Pattern ที่ CEP ตรวจจับได้ Temporal Pattern…
Read More
Self-Supervised Learning สำหรับ Industrial AI: เรียนรู้จากข้อมูลไร้ป้ายในโรงงาน

Self-Supervised Learning สำหรับ Industrial AI: เรียนรู้จากข้อมูลไร้ป้ายในโรงงาน

Article
โรงงานอุตสาหกรรมทุกแห่งผลิตข้อมูลมหาศาลทุกวินาที — เซ็นเซอร์สั่นสะเทือน กล้องตรวจสอบคุณภาพ เครื่องวัดอุณหภูมิและแรงดัน — แต่ข้อมูลเหล่านี้ กว่า 95% เป็นข้อมูลปกติที่ไม่มีป้ายกำกับ (unlabeled data) การจะนำข้อมูลเหล่านี้ไปฝึกโมเดลตรวจจับตำหนิแบบมีผู้สอน (supervised) ต้องเสียเวลาและบุคลากรผู้เชี่ยวชาญในการระบุตำหนิทีละภาพ ซึ่งช้าและมีค่าใช้จ่ายสูง Self-Supervised Learning (SSL) คือวิธีที่ทำให้ AI เรียนรู้รูปแบบที่ซ่อนอยู่จากข้อมูลไร้ป้ายเหล่านี้ได้ด้วยตัวมันเอง Self-Supervised Learning คืออะไร?วงจรงาน Machine Learning ในโรงงาน — ตั้งแต่เก็บข้อมูลเซ็นเซอร์จนถึงการใช้โมเดลตัดสินใจบนหน้างาน (ภาพประกอบ: Honey Corporation)วงจรงาน Machine Learning ในโรงงาน — ตั้งแต่เก็บข้อมูลเซ็นเซอร์จนถึงการใช้โมเดลตัดสินใจบนหน้างาน (ภาพประกอบ: Honey Corporation) SSL เป็นเทคนิคที่สร้าง “สัญญาณการเรียนรู้” ขึ้นมาจากโครงสร้างของข้อมูลเอง โดยไม่ต้องมีมนุษย์มาติดป้ายกำกับ ระบบจะตั้ง ภารกิจหลอก (pretext task) ให้โมเดลทำนายส่วนหนึ่งของข้อมูลจากส่วนอื่น เช่น ทายทิศทางการหมุนของภาพ หรือเติมส่วนที่ถูกปิดไว้ (masked) จากการทำภารกิจเหล่านี้ โมเดลเรียนรู้ การแทนคุณลักษณะ (representation) ที่สามารถนำไปใช้ต่อกับงานจริงได้ โดยใช้ข้อมูลที่มีป้ายนิดเดียวในขั้นปรับแต่งสุดท้าย (fine-tuning) 🧠 เหตุผลสำคัญ: ผลงานวิจัยพบว่าโมเดลที่ผ่านการฝึกแบบ self-supervised สามารถบรรลุประสิทธิภาพใกล้เคียงหรือบางครั้งสูงกว่า supervised learning ในงานตรวจจับความผิดปกติ ในขณะที่ใช้ข้อมูลที่มีป้ายน้อยลงมาก วิธีการหลักของ SSL ในงานอุตสาหกรรม Contrastive Learning: สอนโมเดจับคู่ข้อมูลที่ “คล้ายกัน” (เช่น ภาพผลิตภัณฑ์ปกติสองมุม) ให้อยู่ใกล้กันในเวกเตอร์สเปซ และดันข้อมูลที่ “ต่างกัน” ให้ออกห่าง เป็นวิธียอดนิยมในการสร้างโมเดลพื้นฐานที่แยกแยะตำหนิได้ Masked Modeling: ปิดบางส่วนของสัญญาณเซ็นเซอร์หรือภาพแล้วให้โมเดลเติมให้ถูกต้อง เหมาะกับข้อมูลอนุกรมเวลา (time-series) จากเครื่องจักร Synthetic Anomaly: ฉีดตำหนิสังเคราะห์ลงในภาพปกติเพื่อสร้างข้อมูลฝึก เนื่องจากตำหนิจริงในโรงงานมีน้อยมาก เทคนิคนี้ช่วยให้ตรวจจับตำหนิได้โดยไม่ต้องรอสะสมตัวอย่างตำหนิจริง Predictive / Reconstruction: ให้โมเดลเรียนรู้สร้างภาพซ้ำจากข้อมูลปกติ เมื่อเจอข้อมูลผิดปกติโมเดลจะ “สร้างได้ไม่ดี” ส่งสัญญาณว่าพบความผิดปกติ เปรียบเทียบกระบวนทัศน์การเรียนรู้ มิติเปรียบเทียบ Supervised Unsupervised Self-Supervised ต้องมีป้ายกำกับ? ✅ มาก ❌ ไม่มี ป้ายน้อย (final step) ใช้ประโยชน์จากข้อมูลไร้ป้าย ❌ ✅ ✅ ดีมาก ตรวจจับตำหนิประเภทใหม่ ❌ (ต้องเคยเห็น) ปานกลาง ✅ ได้ดี คุณภาพ representation ดี…
Read More
Time-Series Foundation Models: รุ่นใหม่ของ AI พยากรณ์อนุกรมเวลาที่ไม่ต้อง Train ใหม่ทุกครั้ง

Time-Series Foundation Models: รุ่นใหม่ของ AI พยากรณ์อนุกรมเวลาที่ไม่ต้อง Train ใหม่ทุกครั้ง

Article
ในโลกของ AI เปลี่ยนไปอย่างสิ้นเชิงเมื่อ Large Language Models อย่าง GPT เริ่มนำแนวคิด “Foundation Model” มาสู่ข้อมูลอนุกรมเวลา (Time-Series Data) ที่เป็นหัวใจของอุตสาหกรรม ตอนนี้ Time-Series Foundation Models กำลังปฏิวัติการพยากรณ์ในโรงงานอัจฉริยะ โดยไม่ต้อง Train โมเดลใหม่ทุกครั้ง Time-Series Foundation Models คืออะไร?วงจรงาน Machine Learning ในโรงงาน — ตั้งแต่เก็บข้อมูลเซ็นเซอร์จนถึงการใช้โมเดลตัดสินใจบนหน้างาน (ภาพประกอบ: Honey Corporation)วงจรงาน Machine Learning ในโรงงาน — ตั้งแต่เก็บข้อมูลเซ็นเซอร์จนถึงการใช้โมเดลตัดสินใจบนหน้างาน (ภาพประกอบ: Honey Corporation) Time-Series Foundation Models (TSFM) เป็นโมเดล AI ขนาดใหญ่ที่ถูก Pre-Train บนข้อมูลอนุกรมเวลาหลายพันล้านจุด (Billions of Time-Series Data Points) จากหลากหลายโดเมน เช่น การเงิน สภาพอากาศ การใช้พลังงาน การจราจร และอุตสาหกรรม แตกต่างจากโมเดลพยากรณ์แบบดั้งเดิมที่ต้อง Train เฉพาะสำหรับแต่ละงาน TSFM สามารถ Zero-Shot Forecasting ได้ทันทีบนข้อมูลใหม่ที่ไม่เคยเห็นมาก่อน 🚀 จุดเปลี่ยน: TSFM ทำให้การสร้างโมเดลพยากรณ์ที่เคยใช้เวลาหลายสัปดาห์ ลดลงเหลือเพียง ไม่กี่นาที เพราะสามารถพยากรณ์ได้ทันทีโดยไม่ต้องฝึกใหม่ (Zero-Shot) หรือฝึกเสริมเพียงเล็กน้อย (Few-Shot Fine-Tuning) ปัญหาของ Time-Series ML แบบดั้งเดิม ในโรงงานอุตสาหกรรม การสร้างโมเดลพยากรณ์อนุกรมเวลาแบบดั้งเดิม เช่น ARIMA, LSTM, หรือ Prophet มักประสบปัญหา: ต้อง Train ใหม่ทุก Task: ทุกเครื่องจักร ทุกสายการผลิต ทุกตัวแปร ต้องสร้างโมเดลแยกกัน ไม่มีการแบ่งปันความรู้ ต้องการข้อมูลประวัติยาวนาน: โมเดลส่วนใหญ่ต้องการข้อมูลอย่างน้อย 3-12 เดือนจึงจะพยากรณ์ได้แม่นยำ ไม่สามารถ Generalize: โมเดลที่ Train สำหรับเครื่องจักร A ไม่สามารถนำไปใช้กับเครื่องจักร B ได้ Cold Start Problem: เครื่องจักรใหม่ที่เพิ่งติดตั้งเซ็นเซอร์ไม่มีข้อมูลเพียงพอให้ Train โมเดล Multivariate Complexity: การพยากรณ์หลายตัวแปรพร้อมกันต้องการสถาปัตยกรรมซับซ้อนและเวลาฝึกนาน สถาปัตยกรรมหลักของ TSFM TSFM ส่วนใหญ่ดัดแปลงสถาปัตยกรรมจาก…
Read More
Transfer Learning สำหรับ Industrial AI: ย้ายความรู้โมเดลระหว่างสายการผลิต

Transfer Learning สำหรับ Industrial AI: ย้ายความรู้โมเดลระหว่างสายการผลิต

Article
Transfer Learning ในอุตสาหกรรม: ย้ายความรู้ AI ระหว่างสายการผลิตเพื่อลดเวลา Deploy วงจรงาน Machine Learning ในโรงงาน — ตั้งแต่เก็บข้อมูลเซ็นเซอร์จนถึงการใช้โมเดลตัดสินใจบนหน้างาน (ภาพประกอบ: Honey Corporation) วงจรงาน Machine Learning ในโรงงาน — ตั้งแต่เก็บข้อมูลเซ็นเซอร์จนถึงการใช้โมเดลตัดสินใจบนหน้างาน (ภาพประกอบ: Honey Corporation) หนึ่งในอุปสรรคใหญ่ที่สุดของการนำ AI ไปใช้ในโรงงานอุตสาหกรรมคือ ปัญหา Data Scarcity การฝึกโมเดล Machine Learning สำหรับ Predictive Maintenance หรือ Quality Inspection บนเครื่องจักรตัวใหม่ต้องการข้อมูล Failure จำนวนมาก (มัก 10,000+ samples) แต่ในความเป็นจริง เครื่องจักรใหม่ไม่เคยเสียมาก่อน จึงไม่มีข้อมูล Failure ให้ฝึกโมเดล Transfer Learning คือเทคนิคที่แก้ปัญหานี้โดย “ย้ายความรู้” จากโมเดลที่ฝึกบนเครื่องจักรหรือสายการผลิตหนึ่ง ไปใช้กับอีกที่หนึ่งที่มีข้อมูลน้อยกว่า หลักการ Transfer Learning แบบเข้าใจง่าย ลองนึกภาพช่างซ่อมเครื่องจักรที่เคยทำงานกับเครื่อง CNC มา 20 ปี เมื่อย้ายไปดูแลเครื่อง CNC รุ่นใหม่ ช่างคนนั้นไม่ได้เริ่มจากศูนย์ เขาใช้ ความรู้เดิม เรื่องการสั่นสะเทือน อุณหภูมิ และเสียงเครื่องจักรมาประยุกต์ใช้กับเครื่องรุ่นใหม่ได้ทันที Transfer Learning ทำงานในลักษณะเดียวกัน — โมเดล AI ที่เรียนรู้จากสายการผลิต A (Source Domain) สามารถถ่ายทอดความรู้ไปยังสายการผลิต B (Target Domain) ที่มีข้อมูลน้อยกว่า โครงสร้างการ Transfer ความรู้ ใน Deep Learning โมเดลประกอบด้วยหลาย Layer ซึ่งสามารถแบ่งออกเป็น 2 ส่วน: Feature Extractor (Layer ต้น) — เรียนรู้รูปแบบพื้นฐาน เช่น Edge ในภาพ, Frequency Pattern ในสัญญาณเสียง หรือ Trend ใน Time-Series — ส่วนนี้ สามารถย้ายได้ เพราะเป็นความรู้ที่ใช้ร่วมกันข้าม Domain Classifier/Regressor (Layer ปลาย) — เฉพาะเจาะจงกับ Domain นั้นๆ —…
Read More
Graph Neural Networks (GNN) สำหรับ Predictive Maintenance: เมื่อ AI เข้าใจความสัมพันธ์ระหว่างเครื่องจักร

Graph Neural Networks (GNN) สำหรับ Predictive Maintenance: เมื่อ AI เข้าใจความสัมพันธ์ระหว่างเครื่องจักร

Article
Graph Neural Networks (GNN): เมื่อ AI เข้าใจความสัมพันธ์ระหว่างเครื่องจักรในโรงงาน วงจรงาน Machine Learning ในโรงงาน — ตั้งแต่เก็บข้อมูลเซ็นเซอร์จนถึงการใช้โมเดลตัดสินใจบนหน้างาน (ภาพประกอบ: Honey Corporation) วงจรงาน Machine Learning ในโรงงาน — ตั้งแต่เก็บข้อมูลเซ็นเซอร์จนถึงการใช้โมเดลตัดสินใจบนหน้างาน (ภาพประกอบ: Honey Corporation) ในโรงงานอุตสาหกรรมสมัยใหม่ เครื่องจักรหลายสิบหรือหลายร้อยตัวทำงานเชื่อมโยงกันเป็นสายการผลิต เมื่อเครื่องหนึ่งเริ่มทำงานผิดปกติ มักส่งผลกระทบไปยังเครื่องอื่นๆ ที่เชื่อมโยงด้วยกระบวนการผลิตเดียวกัน ปัญหาคือ AI แบบดั้งเดิม เช่น Random Forest หรือ LSTM มักวิเคราะห์เครื่องจักรแต่ละตัวแบบ แยกส่วน (Isolated) โดยไม่คำนึงถึงความสัมพันธ์ระหว่างเครื่อง ทำให้ไม่สามารถคาดการณ์ Cascading Failure หรือการล้มท cascading ของสายการผลิตได้ Graph Neural Network (GNN) คือสถาปัตยกรรม Deep Learning ที่ออกแบบมาเพื่อประมวลผลข้อมูลที่มีโครงสร้างเป็นกราฟ (Graph) — โดยมองเครื่องจักรแต่ละตัวเป็น Node และความสัมพันธ์ทางกายภาพ/กระบวนการผลิตเป็น Edge เทคโนโลยีนี้กำลังเปลี่ยนวิธีที่โรงงานทำ Predictive Maintenance อย่าง根本的 โครงสร้างกราฟในโรงงานอุตสาหกรรม การสร้างกราฟสำหรับ GNN ในโรงงานเริ่มจากการกำหนด Node และ Edge ดังนี้: Node (จุด) = เครื่องจักร เช่น มอเตอร์ ปั๊ม คอมเพรสเซอร์ คอนเวย์เบล์ หรือ Heat Exchanger — แต่ละ Node มี Feature Vector ที่ประกอบด้วยข้อมูลเซ็นเซอร์ เช่น อุณหภูมิ (°C), การสั่นสะเทือน (mm/s), กระแสไฟฟ้า (A), และความดัน (bar) Edge (เส้นเชื่อม) = ความสัมพันธ์ระหว่างเครื่องจักร เช่น การไหลของวัตถุดิบ สายพลังงานร่วมกัน หรือการควบคุมแบบ Cascade Control — Edge สามารถมีน้ำหนัก (Edge Weight) แสดงความแรงของความสัมพันธ์ได้ กลไก Message Passing ของ GNN หัวใจของ GNN คือกระบวนการ Message Passing — ในแต่ละรอบการเรียนรู้…
Read More
Synthetic Data Generation สำหรับ Industrial AI: แก้ปัญหา Data Scarcity ด้วย GAN และ Diffusion Models

Synthetic Data Generation สำหรับ Industrial AI: แก้ปัญหา Data Scarcity ด้วย GAN และ Diffusion Models

Article
ปัญหาใหญ่ที่สุดของการนำ AI ไปใช้ในโรงงานอุตสาหกรรมไม่ใช่ algorithm หรือ hardware — แต่คือ ข้อมูล ในโรงงานส่วนใหญ่ ข้อมูล normal operation มีมหาศาล แต่ข้อมูล defect, failure, หรือ edge case มีน้อยเสียจน train model ไม่ได้ ตัวอย่างเช่น สายผลิตที่ reject rate เพียง 0.5% จะมีภาพ defect เพียง 50 ภาพต่อการผลิต 10,000 ชิ้น — ไม่พอ train deep learning model ที่ต้องการข้อมูลนับหมื่นภาพ Synthetic Data Generation คือวิธีแก้ที่กำลังเปลี่ยน paradigm ของ Industrial AI Synthetic Data คืออะไร?วงจรงาน Machine Learning ในโรงงาน — ตั้งแต่เก็บข้อมูลเซ็นเซอร์จนถึงการใช้โมเดลตัดสินใจบนหน้างาน (ภาพประกอบ: Honey Corporation)วงจรงาน Machine Learning ในโรงงาน — ตั้งแต่เก็บข้อมูลเซ็นเซอร์จนถึงการใช้โมเดลตัดสินใจบนหน้างาน (ภาพประกอบ: Honey Corporation) Synthetic Data คือข้อมูลที่สร้างขึ้นโดยอัตโนมัติด้วยโมเดล AI หรือ simulation โดยมีคุณสมบัติทางสถิติใกล้เคียงข้อมูลจริง แต่ไม่ได้มาจากการวัดในโลกจริง ในบริบทอุตสาหกรรม Synthetic Data มี 3 ประเภทหลัก: Image-based — ภาพ defect, ภาพ product variant, ภาพ scene ที่ไม่เคยเกิดใน production Time-series-based — sensor signal ของ failure pattern, degradation curve, anomalous behavior Tabular-based — ข้อมูล process parameter ที่จำลองสถานการณ์ edge case 3 เทคโนโลยีหลักในการสร้าง Synthetic Data 1. GAN (Generative Adversarial Network) GAN ประกอบด้วย neural network 2 ตัวที่แข่งขันกัน:…
Read More
Acoustic AI และ Sound-Based Anomaly Detection: เมื่อเสียงเครื่องจักรเผยความผิดปกติก่อนเกิด Breakdown

Acoustic AI และ Sound-Based Anomaly Detection: เมื่อเสียงเครื่องจักรเผยความผิดปกติก่อนเกิด Breakdown

Article
ในโรงงานอุตสาหกรรมส่วนใหญ่ เสียงที่เครื่องจักรส่งออกมามักถูกมองว่าเป็นเพียง “มลพิษทางเสียง” ที่ต้องควบคุม แต่ในมุมมองของวิศวกร Reliability และ Data Scientist เสียงเหล่านั้นคือ สัญญาณข้อมูลที่ทรงคุณค่า เพราะทุก component ที่หมุน กระแทก หรือสั่นสะเทือน จะปล่อยพลังงานเสียงที่มีลายเซ็นเฉพาะตัว (acoustic signature) เมื่อ component เริ่มเสื่อมสภาพ ลายเซ็นเสียงจะเปลี่ยนแปลงก่อนที่ค่า vibration หรือ temperature จะเกิน threshold — บางครั้งเร็วกว่า 2-4 สัปดาห์ ทำไมเสียงจึงบอกสุขภาพเครื่องจักรได้?โปรโตคอลสื่อสารในระบบ IIoT — แต่ละชั้นของระบบสื่อสารในโรงงานใช้มาตรฐานต่างกันตามหน้าที่ (ภาพประกอบ: Honey Corporation)โปรโตคอลสื่อสารในระบบ IIoT — แต่ละชั้นของระบบสื่อสารในโรงงานใช้มาตรฐานต่างกันตามหน้าที่ (ภาพประกอบ: Honey Corporation) เสียงคือคลื่นความดันในอากาศที่เกิดจากการสั่นสะเทือนของวัสดุ ในระบบเครื่องจักรอุตสาหกรรม แหล่งกำเนิดเสียงหลักประกอบด้วย: Mechanical contact — ฟันเฟืองกระแทกกัน ลูกปืนหมุนในร่อง ซึ่งสร้าง frequency components เฉพาะที่สัมพันธ์กับความเร็วรอบ (RPM) Fluid flow — การไหลผ่าน valve, pump impeller, หรือ leakage สร้าง broadband noise และ tonal peaks Electromagnetic — coil switching ในมอเตอร์สร้างเสียงความถี่สูงที่เชื่อมโยงกับสภาพ winding Friction & wear — การสึกหรอของผิวสัมผัสเพิ่ม high-frequency content ที่สายตาและเซ็นเซอร์ทั่วไปมองไม่เห็น การวิเคราะห์เสียงจึงเป็นเหมือนการ “ตรวจคลื่นหัวใจ” ให้เครื่องจักร — สามารถตรวจจับความผิดปกติในระดับ nanometer-scale wear ได้ก่อนที่จะกลายเป็น failure ที่มองเห็น สถาปัตยกรรม Acoustic AI System แบบ End-to-End ระบบ Sound-Based Anomaly Detection ที่ทำงานในสภาพแวดล้อมโรงงานจริงประกอบด้วย 5 ชั้นหลัก: 1. Signal Acquisition Layer เซ็นเซอร์ที่ใช้เก็บเสียงมีหลายประเภท แต่ละประเภทเหมาะกับสถานการณ์ต่างกัน: MEMS Microphone — ราคาถูก ขนาดเล็ก ตอบสนอง 20 Hz – 20 kHz เหมาะกับการกระจายไปทั่วโรงงาน Contact Piezoelectric…
Read More
OT Network Traffic Analysis และ Deep Packet Inspection: ตรวจจับพฤติกรรมผิดปกติในเครือข่ายอุตสาหกรรม

OT Network Traffic Analysis และ Deep Packet Inspection: ตรวจจับพฤติกรรมผิดปกติในเครือข่ายอุตสาหกรรม

Article
OT Network Traffic Analysis และ Deep Packet Inspection: ตรวจจับพฤติกรรมผิดปกติในเครือข่ายอุตสาหกรรม Defense in Depth ตามแนวทาง IEC 62443 — ความปลอดภัยระบบ OT ต้องออกแบบเป็นชั้นๆ ตั้งแต่การแบ่งโซนเครือข่ายถึงแผนตอบสนองเหตุการณ์ (ภาพประกอบ: Honey Corporation) Defense in Depth ตามแนวทาง IEC 62443 — ความปลอดภัยระบบ OT ต้องออกแบบเป็นชั้นๆ ตั้งแต่การแบ่งโซนเครือข่ายถึงแผนตอบสนองเหตุการณ์ (ภาพประกอบ: Honey Corporation) ในโรงงานอุตสาหกรรมสมัยใหม่ เครือข่าย OT (Operational Technology) เป็นเส้นเลือดใหญ่ที่เชื่อมต่อ PLC, HMI, SCADA Server, RTU และอุปกรณ์อัจฉริยะนับร้อยเข้าด้วยกัน การตรวจสอบ Traffic ที่ไหลผ่านเครือข่ายเหล่านี้จึงเป็นหัวใจของการเฝ้าระวังภัยไซเบอร์ Deep Packet Inspection (DPI) สำหรับ OT ไม่ได้ตรวจแค่ IP Address หรือ Port Number แต่วิเคราะห์เจาะลึกถึงระดับ Industrial Protocol Payload เพื่อตรวจจับพฤติกรรมผิดปกติที่อาจบ่งบอกถึงการบุกรุก DPI ใน OT ต่างจาก IT อย่างไร? ในโลก IT มักตรวจสอบ HTTP, DNS, TLS แต่ใน OT เครือข่ายใช้ Industrial Protocol ที่มีโครงสร้างแตกต่างอย่างสิ้นเชิง: Modbus TCP (Port 502) โปรโตคอลแบบ Request/Response ที่ไม่มี Authentication ใดๆ ทั้งสิ้น ทำให้ง่ายต่อการ Spoof คำสั่ง Read/Write Register DNP3 (Port 20000) ใช้ในสาธารณูปโภคและพลังงาน มี Secure Authentication version แต่หลายโรงงานยังใช้แบบไม่เข้ารหัส S7comm (Port 102) โปรโตคอลสำหรับ S7 PLC ที่มีช่องโหว่หลายจุดในเวอร์ชันเก่า EtherNet/IP (Port 44818) ใช้ CIP (Common Industrial Protocol) ที่มี Mechanism ซับซ้อน OPC…
Read More
TinyML สำหรับอุปกรณ์ IoT: เมื่อ Machine Learning วิ่งบนไมโครคอนโทรลเลอร์ขนาดเพียงหลายสิบ KB

TinyML สำหรับอุปกรณ์ IoT: เมื่อ Machine Learning วิ่งบนไมโครคอนโทรลเลอร์ขนาดเพียงหลายสิบ KB

Article
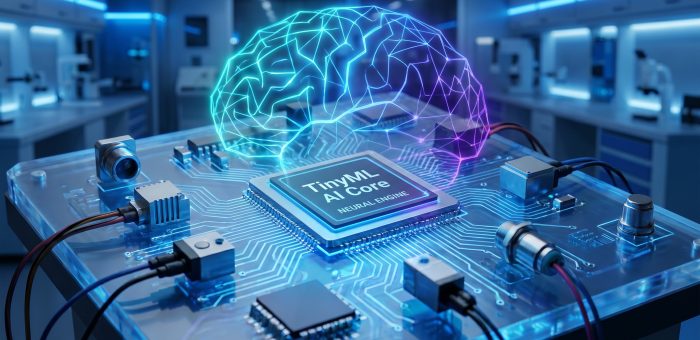
TinyML คืออะไร? เมื่อ AI ลงไปอยู่บนไมโครคอนโทรลเลอร์วงจรงาน Machine Learning ในโรงงาน — ตั้งแต่เก็บข้อมูลเซ็นเซอร์จนถึงการใช้โมเดลตัดสินใจบนหน้างาน (ภาพประกอบ: Honey Corporation)วงจรงาน Machine Learning ในโรงงาน — ตั้งแต่เก็บข้อมูลเซ็นเซอร์จนถึงการใช้โมเดลตัดสินใจบนหน้างาน (ภาพประกอบ: Honey Corporation) TinyML หรือ Tiny Machine Learning คือการนำโมเดล Machine Learning มาทำงานบนไมโครคอนโทรลเลอร์ขนาดเล็ก (Microcontroller Unit หรือ MCU) ที่มี RAM เพียง 32-512 KB และ Flash Memory ไม่เกิน 2 MB ต่างจาก AI แบบดั้งเดิมที่ต้องพึ่ง Cloud Server ด้วยกำลังประมวลผลหลาย TFLOPS TinyML ทำให้อุปกรณ์ IoT ราคาประหยัดสามารถ “คิดเองได้” โดยไม่ต้องเชื่อมต่อ Internet ในบริบทของโรงงานอุตสาหกรรม TinyML เปิดโอกาสให้ Sensor Node แต่ละจุดสามารถวิเคราะห์ข้อมูลได้แบบ Real-time ที่ตำแหน่งที่ตั้งจริง (Edge Inference) ลด Latency จากหลายร้อยมิลลิวินาที (ส่งขึ้น Cloud แล้วรอผล) เหลือเพียง 1-10 มิลลิวินาที ซึ่งเป็นความแตกต่างที่สำคัญต่อการตัดสินใจเชิงควบคุม สถาปัตยกรรม TinyML สำหรับ Industrial IoT ระบบ TinyML แบ่งเป็น 3 ชั้นหลัก: ชั้นฝึกอบรม (Training Phase): ฝึกโมเดลบน Cloud หรือเวิร์กสเตชันด้วย Dataset ขนาดใหญ่ ใช้เทคนิค Quantization และ Pruning ลดขนาดโมเดลให้พอดีกับ MCU ชั้นแปลงโมเดล (Model Optimization): ใช้ ML Framework สำหรับ Microcontrollers (เช่น TFLM, MCUNet) แปลงโมเดลจาก float32 เป็น int8 ลดขนาดลง 4 เท่าโดย Accuracy ลดลงไม่เกิน 2-3% ชั้นอนุมาน (Inference on Device): รันโมเดลบน MCU…
Read More