Synthetic Data Generation สำหรับ Industrial AI: แก้ปัญหา Data Scarcity ด้วย GAN และ Diffusion Models
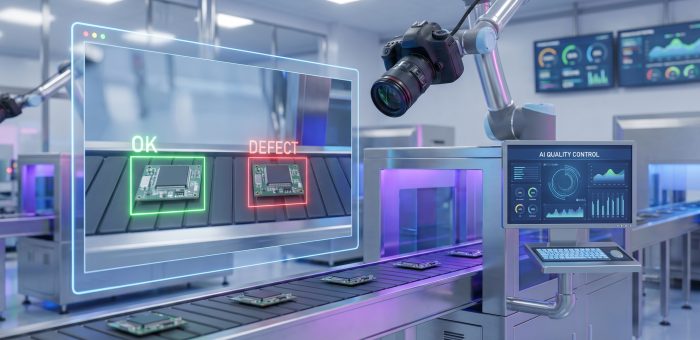
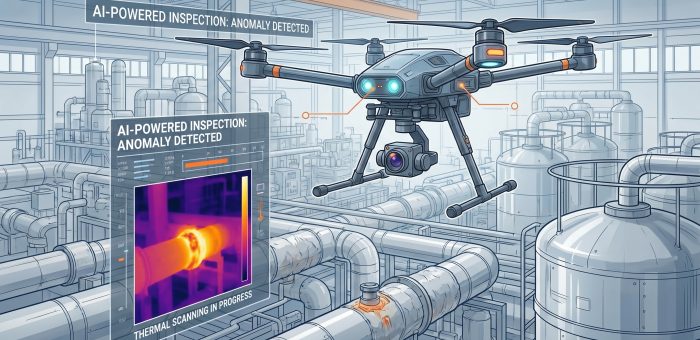
ปัญหาใหญ่ที่สุดของการนำ AI ไปใช้ในโรงงานอุตสาหกรรมไม่ใช่ algorithm หรือ hardware — แต่คือ ข้อมูล ในโรงงานส่วนใหญ่ ข้อมูล normal operation มีมหาศาล แต่ข้อมูล defect, failure, หรือ edge case มีน้อยเสียจน train model ไม่ได้ ตัวอย่างเช่น สายผลิตที่ reject rate เพียง 0.5% จะมีภาพ defect เพียง 50 ภาพต่อการผลิต 10,000 ชิ้น — ไม่พอ train deep learning model ที่ต้องการข้อมูลนับหมื่นภาพ Synthetic Data Generation คือวิธีแก้ที่กำลังเปลี่ยน paradigm ของ Industrial AI Synthetic Data คืออะไร?วงจรงาน Machine Learning ในโรงงาน — ตั้งแต่เก็บข้อมูลเซ็นเซอร์จนถึงการใช้โมเดลตัดสินใจบนหน้างาน (ภาพประกอบ: Honey Corporation)วงจรงาน Machine Learning ในโรงงาน — ตั้งแต่เก็บข้อมูลเซ็นเซอร์จนถึงการใช้โมเดลตัดสินใจบนหน้างาน (ภาพประกอบ: Honey Corporation) Synthetic Data คือข้อมูลที่สร้างขึ้นโดยอัตโนมัติด้วยโมเดล AI หรือ simulation โดยมีคุณสมบัติทางสถิติใกล้เคียงข้อมูลจริง แต่ไม่ได้มาจากการวัดในโลกจริง ในบริบทอุตสาหกรรม Synthetic Data มี 3 ประเภทหลัก: Image-based — ภาพ defect, ภาพ product variant, ภาพ scene ที่ไม่เคยเกิดใน production Time-series-based — sensor signal ของ failure pattern, degradation curve, anomalous behavior Tabular-based — ข้อมูล process parameter ที่จำลองสถานการณ์ edge case 3 เทคโนโลยีหลักในการสร้าง Synthetic Data 1. GAN (Generative Adversarial Network) GAN ประกอบด้วย neural network 2 ตัวที่แข่งขันกัน:…