NILM (Non-Intrusive Load Monitoring): อ่านทะลุโหลดไฟฟ้าทั้งโรงงานจากมิเตอร์ตัวเดียวด้วย AI

NILM (Non-Intrusive Load Monitoring): อ่านทะลุโหลดไฟฟ้าทั้งโรงงานจากมิเตอร์ตัวเดียวด้วย AI

Article
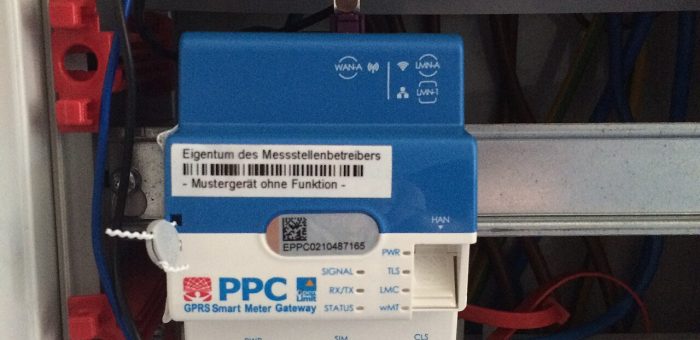
โรงงานของคุณมีมิเตอร์ไฟฟ้ากี่ตัว? คำถามนี้กำลังเปลี่ยนคำตอบด้วย AI คำถามฟังดูง่าย แต่แทบทุกโรงงานในไทยตอบเหมือนกัน — มิเตอร์หลักจากการไฟฟ้าหนึ่งตัว แล้วก็จบ เวลาใบแจ้งค่าไฟขึ้นเลข ฝ่ายวิศวกรรมก็นั่งเทียนหาสาเหตุกันแบบเดา ๆ ว่าเดือนนี้เครื่องจักรตัวไหนกินไฟมากขึ้น คอมเพรสเซอร์? ชิลเลอร์? หรือเตาอบที่ช่วงนี้รันเวลาเพิ่ม? คำตอบที่แท้จริงมักถูกฝังอยู่ในรูปคลื่นของข้อมูลที่เราไม่เคยแยกแยะ NILM (Non-Intrusive Load Monitoring) หรือ Energy Disaggregation คือเทคโนโลยีที่ตอบคำถามนี้โดยไม่ต้องติดมิเตอร์ย่อยทุกเครื่องจักร หลักการคือ อ่านสัญญาณกำลังไฟฟ้ารวมจากจุดเดียว แล้วใช้อัลกอริทึม "แยกสลาย" กลับเป็นโหลดย่อยของแต่ละอุปกรณ์ — เหมือนฟังเพลงประสานเสียงแล้วบอกได้ว่าตอนนี้ใครกำลังร้องเสียงดังเกินใคร Smart Meter Gateway — ประตูข้อมูลพลังงานระดับอุปกรณ์ที่ NILM ใช้เป็นแหล่งสัญญาณ (ภาพ: Wikimedia Commons) ต้นกำเนิดจากงานวิจัยปี 1992 ที่กลับมาฮอตในยุค IIoT แนวคิด NILM เริ่มจากงานวิจัยคลาสสิกของ George Hart แห่ง MIT ในปี 1992 ซึ่งพิสูจน์ว่า "ลายเซ็นไฟฟ้า" (load signature) ของอุปกรณ์แต่ละชนิด — รูปแบบการเปลี่ยนขึ้น-ลงของกำลังจริง (kW) และกำลังปฏิกิริยา (kVAR) ตอนเปิด-ปิด — นั้นแตกต่างกันเพียงพอที่จะใช้ระบุตัวอุปกรณ์ได้ มอเตอร์อินดักชันมี surge สูงตอนสตาร์ท ส่วนเตาความร้อนมีรูปคลื่นแบนราบเป็นขั้นบันได งานวิจัยทบทวนวรรณกรรมชั้นนำ (Kaselimi และคณะ, 2022) แบ่งวิวัฒนาการของ NILM เป็น 3 ยุค: ยุคแรก คือการคิดคณิตศาสตร์พื้นฐานด้วย combinatorial optimization และ factorial hidden Markov model (FHMM), ยุคกลาง คือการทดลอง deep learning อย่าง sequence-to-sequence และ CNN ที่แม่นยำขึ้นบนชุดข้อมูลสาธารณะ และ ยุคปัจจุบัน ที่งานวิจัยหันมาเน้นความ "น่าเชื่อถือได้จริง" (trustworthiness) — ความสามารถถ่ายโอนโมเดลข้ามสถานที่ (transferability) และความซับซ้อนที่ต้องลดลงเพื่อให้รันได้จริงในสภาพแวดล้อมโรงงาน หลักการทำงาน: จากสัญญาณเดียวสู่ N โหลด pipework ของ NILM มี 4 ขั้นตอนหลัก: เก็บสัญญาณ — อ่านค่ากำลังรวมจากมิเตอร์อัจฉริยะหรือ power quality analyzer ที่จุดจ่ายหลัก ความถี่ตั้งแต่ 1 ครั้ง/วินาที (1 Hz)…
Read More
บทวิเคราะห์: Prescriptive Maintenance (RxM) — เมื่อระบบบำรุงรักษาไม่ใช่แค่ทำนาย แต่บอกว่าควรทำอะไร

บทวิเคราะห์: Prescriptive Maintenance (RxM) — เมื่อระบบบำรุงรักษาไม่ใช่แค่ทำนาย แต่บอกว่าควรทำอะไร

Article
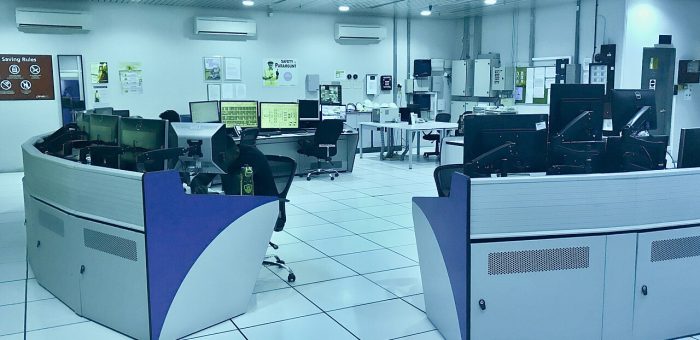
ทุกสายการผลิตเคยเจอคำถามนี้: ระบบแจ้งเตือนว่า "สัญญาณสั่นสะเทือนผิดปกติ" แล้วต่อไปล่ะ? ใครต้องไปดู ต้องซ่อมตอนไหน ถ้ารอก่อนจะเสียผลผลิตเท่าไร ถ้าหยุดเครื่องตอนนี้จะกระทบออร์เดอร์คือไหน — Prescriptive Maintenance (RxM) คือคำตอบที่อุตสาหกรรมกำลังเปลี่ยนไปหาในปี 2026 โดยมีรายงานจาก Hannover Messe ปีนี้ระบุว่า "Predictive Maintenance กำลังกลายเป็น Prescriptive" เป็นหนึ่งใน 12 เทรนด์หลักของปี ห้องควบคุมกลาง — จุดที่การแจ้งเตือนจาก predictive system ต้องถูกแปลงเป็นการตัดสินใจ ซึ่งยังเป็นงานของมนุษย์เต็มตัว (ภาพ: Z22 / Wikimedia Commons, CC BY-SA 4.0) ปัญหาของ Predictive: บอกว่า "จะเกิดอะไร" แต่ไม่บอกว่า "ควรทำอะไร" Predictive Maintenance ที่แข็งแรงแล้วหลายโรงงานยังคงเจอระยะสุดท้ายที่ติดอยู่ที่คน: โมเดลทำนายเก่ง แต่การแปลง prediction ให้เป็นการตัดสินใจยังต้องพึ่งประสบการณ์วิศวกร วิศวกรต้องชั่งน้ำหนักสภาพเครื่องจักรกับตารางผลิต อะไหล่พร้อมหรือไม่ และความสำคัญของสินทรัพย์แต่ละตัว ช่องว่างนี้คือสิ่งที่ RxM มาปิด — จากงานวิเคราะห์เชิงลึกของผู้ให้บริการ CMMS ระดับโลก: "ช่องว่างระหว่างสองกลยุทธ์นี้ไม่ใช่เซ็นเซอร์เพิ่มหรือ dashboard ที่สวยขึ้น แต่คือทีมของคุณได้รับข้อมูลที่ยังต้องตีความ หรือได้รับการตัดสินใจที่ปฏิบัติได้ทันที" RxM ทำงานอย่างไร: 3 ชั้นโครงสร้าง เพื่อให้คำแนะนำที่ "ตัดสินใจแทนได้" ระบบ RxM ต้องมี 3 ชั้นทำงานร่วมกัน ตามการวิเคราะห์ของผู้ให้บริการ CMMS ชั้นนำ: Condition Monitoring หลายโหมดต่อเนื่อง — เก็บสัญญาณ vibration, ultrasound, temperature และ magnetic field ด้วยความละเอียดพอจะเห็น failure signature ระยะต้นทั่วทั้ง fleet เครื่องจักร Automated Diagnostics — ระบุ failure mode เฉพาะเจาะจง ไม่ใช่แค่ "มีบางอย่างเปลี่ยน" การรู้ว่า vibration เพิ่มคือข้อมูล แต่การรู้ว่าแพทเทิร์นนั้นตรงกับ stage-two inner race bearing defect คือจุดเริ่มของการตัดสินใจ Prescription Layer — นำการวินิจฉัยไปชั่งน้ำหนักกับตัวแปรเชิงปฏิบัติการ (ตารางผลิต อะไหล่ในคลัง ความสำคัญของสินทรัพย์ แรงงาน ต้นทุนพลังงาน) แล้วส่งคืนเป็นคำแนะนำเฉพาะพร้อมผลลัพธ์ที่คาดหวัง หลายระบบใช้ digital…
Read More
Remaining Useful Life (RUL): คำถามสุดท้ายของ Predictive Maintenance ที่โมเดลใหญ่ตอบไม่ได้

Remaining Useful Life (RUL): คำถามสุดท้ายของ Predictive Maintenance ที่โมเดลใหญ่ตอบไม่ได้

Article
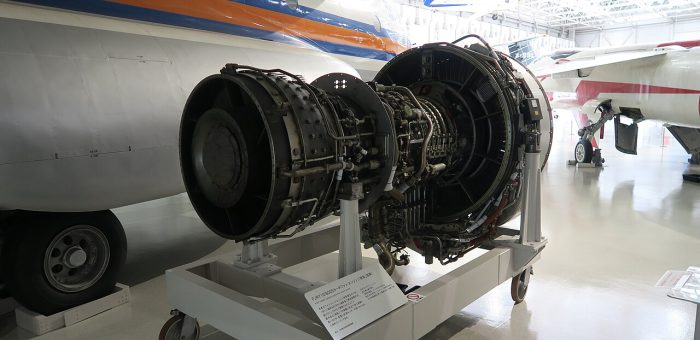
คำถามที่ยากที่สุดของ Predictive Maintenance ไม่ใช่ "เสียหรือยัง" แต่คือ "เหลือเวลาอีกนานเท่าไร" ตลอดหลายปีที่ผ่านมา Predictive Maintenance ในโรงงานส่วนใหญ่หยุดอยู่ที่คำถามแรก: เครื่องจักรตัวนี้ "ผิดปกติหรือไม่" — ซึ่ง Anomaly Detection ตอบได้ค่อนข้างดีแล้ว แต่คำถามที่มีผลต่อการวางแผนจริงๆ คือคำถามที่สอง: "ควรจัดซ่อมเมื่อไร" จัดเร็วเกินไปเสียโอกาสใช้งานชิ้นส่วนเต็มอายุ จัดช้าเกินไปก็กลายเป็น downtime ที่วางแผนไม่ได้ คำตอบของคำถามนี้มีชื่อเฉพาะในวงการวิศวกรรมความน่าเชื่อถือ: Remaining Useful Life (RUL) หรืออายุการใช้งานที่เหลืออยู่ RUL คือหัวใจของสาขา Prognostics and Health Management (PHM) ซึ่งเป็นขั้นสูงสุดของการบำรุงรักษาเชิงพยากรณ์ — ขณะที่ diagnostics บอกว่า "เกิดอะไรขึ้น" prognostics บอกว่า "จะไปต่ออีกนานแค่ไหน" ความต่างนี้คือความต่างระหว่างการรู้ว่าแบริ่งเริ่มมีรอย กับการรู้ว่าแบริ่งนั้นจะทนได้อีก 12 วันหรือ 12 ชั่วโมง ซึ่งนำไปสู่การตัดสินใจที่ต่างกันโดยสิ้นเชิง เครื่องยนต์เทอร์โบแฟน — กลุ่มเครื่องจักรที่งานวิจัย RUL ทำมากที่สุด เพราะความเสียหายระหว่างการใช้งานรุนแรงเกินจะรอให้เกิดขึ้น (ภาพ: Wikimedia Commons) จุดเปลี่ยน 2026: เมื่อ benchmark กลับหน้าไม่เป็นที่คาด เดือนเมษายน 2026 มีงานวิจัยเปรียบเทียบเทคนิค RUL ตีพิมพ์บน arXiv (Goel et al., 2026) ที่ให้ผลลัพธ์ "สะเทือนวงการ" ไม่ใช่เพราะตัวเลขสวย แต่เพราะมันตอกย้ำบทเรียนที่วิศวกรสาย reliability สงสัยกันมานาน งานวิจัยนี้ทดสอบบนชุดข้อมูลมาตรฐาน NASA C-MAPSS turbofan ซึ่งเป็น benchmark ที่ใช้กันทั่วโลกมาเกือบ 20 ปี โดยเปรียบเทียบ 3 ตระกูลวิธีบน subset FD001 และ FD003 ภายใต้ preprocessing เดียวกัน: โมเดล ตระกูล RMSE (FD001) RMSE (FD003) Ridge RegressionClassical (raw features)—— LSTM single-layer (Goel et al. 2026)Deep Learning14.9314.20 Deep LSTM (Zheng et al.)Deep Learning16.1416.18 1D CNNDeep Learning16.9715.68 XGBoostClassical…
Read More
Case Study: เมื่อ Work Order เกิดเอง — เชื่อม IIoT Sensor เข้า CMMS เปลี่ยนซ่อมบำรุงแบบไหน

Case Study: เมื่อ Work Order เกิดเอง — เชื่อม IIoT Sensor เข้า CMMS เปลี่ยนซ่อมบำรุงแบบไหน

Article
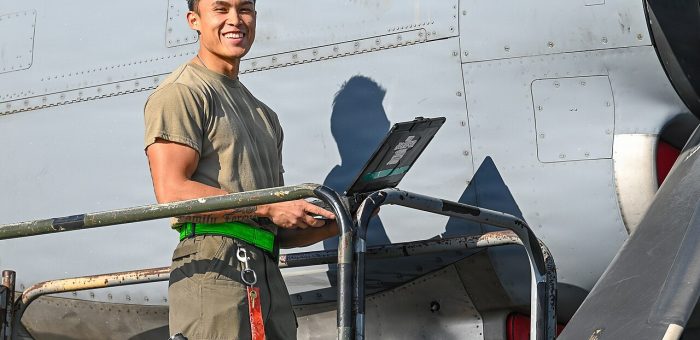
ปัญหา: เมื่อ Work Order เกิดช้ากว่าความเสียหาย ลองนึกภาพโรงงานผลิตชิ้นส่วนแห่งหนึ่งที่มีเครื่องจักรหลักกว่า 120 เครื่อง ทีมซ่อมบำรุง 12 คน และระบบบันทึกงานซ่อม ( CMMS ) ที่ใช้มานานกว่าสิบปี ทุกอย่างดูเรียบร้อยบนกระดาษ — แต่ในความจริง กระบวนการซ่อมบำรุงยังคง "รอ" สามสิ่ง: รอช่างเดินตรวจ, รอคนกรอกใบสั่งงาน และรอผู้จัดการอนุมัติ ผลคือเหตุการณ์เสียหายเล็กๆ กลายเป็น downtime ใหญ่เพราะมาถึงหูทีมซ่อมช้าเกินไป ช่างเทคนิคกับเอกสารงานซ่อมหน้าเครื่องจักร — ขั้นตอน "กรอกใบสั่งงาน" ที่ดูเล็กน้อยคือคอขวดที่แท้จริงของการซ่อมบำรุงสมัยใหม่ (ภาพ: Wikimedia Commons / U.S. Air Force, public domain) สิ่งที่เกิดขึ้นที่โรงงานแห่งนี้สะท้อนภาพอุตสาหกรรมกว้างๆ ตามข้อมูลจากการวิเคราะห์ของผู้ให้บริการแพลตฟอร์ม IIoT ปี 2025: การบริหารซ่อมบำรุงแบบดั้งเดิมที่พึ่งการตรวจด้วยตนเอง การซ่อมเมื่อเสีย และตารางซ่อมตามปฏิทิน นำไปสู่ downtime ที่หลีกเลี่ยงได้และต้นทุนสูงเกินจำเป็น ขณะที่การซ่อมบำรุงเชิงพยากรณ์ ( Predictive Maintenance ) ที่ขับเคลื่อนด้วย IoT ช่วยลดต้นทุนซ่อมบำรุงได้ถึง 30% และขจัดการเสียหายกระจาย ( breakdown ) ได้ 70-75% ทางออก: ต่อเซ็นเซอร์เข้ากับ CMMS ให้ Work Order "เกิดเอง" หัวใจของการแก้ปัญหาไม่ใช่การซื้อเซ็นเซอร์เพิ่ม แต่คือการ เชื่อมช่องว่างระหว่างโลกของข้อมูลกับโลกของการปฏิบัติงาน สถาปัตยกรรมที่ใช้แก้ปัญหามี 5 ขั้นตอน ซึ่งล้วนทำงานอัตโนมัติตั้งแต่ขั้นที่ 1 ถึง 4: เซ็นเซอร์เก็บข้อมูล — เซ็นเซอร์ไร้สาย ( vibration, temperature, pressure, humidity ) ตรวจวัดสภาพเครื่องจักรต่อเนื่อง ส่งข้อมูลขึ้นแพลตฟอร์ม — ค่าที่วัดได้ส่งตรงสู่ระบบ CMMS แบบ real-time ผ่านเกตเวย์ IIoT แจ้งเตือนและสร้าง Work Order อัตโนมัติ — เมื่อค่าใดๆ เกินเกณฑ์ที่กำหนด ระบบสร้างใบสั่งงานทันทีโดยไม่ต้องมีคนกรอก ทีมซ่อมรับมือ — ช่างได้รับแจ้งเตือนแบบ real-time ลดเวลาตอบสนองลงอย่างมีนัยสำคัญ ข้อมูลสะสมเป็นฐานของ AI — ข้อมูลย้อนหลังถูก Machine Learning วิเคราะห์หาแนวโน้ม กลายเป็น Predictive Maintenance ที่แท้จริง เซ็นเซอร์วัดการสั่นสะเทือนไร้สายที่ติดตั้งกับเครื่องจักร —…
Read More
Hybrid Twin: เมื่อ Physics-based Model จับมือ Machine Learning เพื่อโมเดลที่แม่นและทนทานกว่า

Hybrid Twin: เมื่อ Physics-based Model จับมือ Machine Learning เพื่อโมเดลที่แม่นและทนทานกว่า

Article
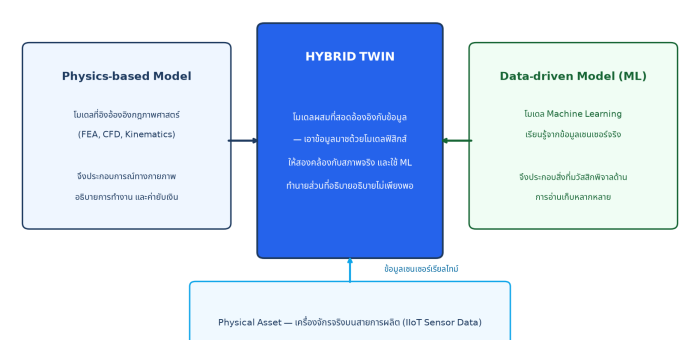
ในโครงการทำ Predictive Twin หลายโครงการที่เราเห็นล้มเหลว มีจุดตายตรงกันคือเลือกใช้ Machine Learning เพียงอย่างเดียว โมเดลทำนายแม่นยำในช่วงทดสอบ แต่พอเครื่องจักรเปลี่ยนสภาวะทำงาน ความแม่นยำก็ไถลลงจนใช้งานจริงไม่ได้ ในทางกลับกัน โมเดลฟิสิกส์ที่แม่นยำสุดๆ ก็มีข้อจำกัดเรื่องเวลาคำนวณและต้นทุนการสร้าง คำตอบที่งานวิจัยอุตสาหกรรมหันไปใช้กันมากขึ้นคือ Hybrid Twin — การผสานจุดแข็งของสองโลกเข้าไว้ในโมเดลเดียว ปัญหา: ทำไมโมเดลชนิดเดียวไม่พอ ลองนึกภาพการทำนายอุณหภูมิแบริ่งของมอเตอร์ไฟฟ้าขนาดใหญ่ วิธีฟิสิกส์ (Physics-based) คือสร้างโมเดลความร้อนและการสั่นสะเทือนจากสมการถ่ายเทความร้อนและพลศาสตร์ วิธีนี้เชื่อถือได้สูงเมื่ออยู่ในเงื่อนไขที่โมเดลออกแบบมา วิศวกรอธิบายได้ว่าทำไมค่าทำนายเป็นเช่นนั้น แต่การสร้างโมเดล FEA หรือ CFD ที่ละเอียดขึ้น มัคช์กับเครื่องจักรจริง ต้องใช้เวลาคำนวณนานและทรัพยากรจำนวนมาก ที่สำคัญข้อผิดพลาดเล็กๆ ในค่าสัมประสิทธิ์ เช่น สัมประสิทธิ์การนำความร้อนของวัสดุ สะสมกันเป็นความคลาดเคลื่อนของผลลัพธ์ ส่วนวิธีข้อมูล (Data-driven) อย่าง Deep Learning เรียนรู้จากข้อมูลเซ็นเซอร์จริงหลายหมื่นจุด ทำนายได้เร็วและแม่นในสภาวะที่เคยเห็น แต่โมเดลไม่เข้าใจกลไกเบื้องหลัง เมื่อเจอสภาวะใหม่ที่ไม่เคยมีในชุดข้อมูลฝึก เช่น เปลี่ยนวัตถุดิบ เปลี่ยนอัตราการผลิต หรือแว่วเสียงแปลกประหลาด โมเดลก็เดาผิดได้อย่างมั่นใจ งานวิจัยที่ตีพิมพ์ในวารสาร Procedia CIRP ปี 2022 เรียกปัญหานี้ว่าช่องว่างระหว่างสองกระบวนทัศน์ และเสนอว่าการผสานกันคือทางออกที่ยั่งยืนกว่า การจำลองทางฟิสิกส์อย่าง crash-test simulation แม่นยำแต่ต้องแลกกับเวลาคำนวณ — ที่มา: Wikimedia Commons (CC BY-SA) แนวทางแก้: โครงสร้างของ Hybrid Twin หลักคิดของ Hybrid Twin มีสามชั้นต่อกัน ชั้นแรกคือโมเดลฟิสิกส์แบบลดทอน (Reduced-order Model) ที่ย่อส่วนจากโมเดล FEA/CFD เต็มรูปแบบให้คำนวณได้เร็วขึ้นหลายเท่าตัว โดยยอมรับความคลาดเคลื่อนเล็กน้อย ชั้นที่สองคือโมเดลแทรกแซง (Correction Model) ที่เป็น Machine Learning หน้าที่เดียวคือเรียนรู้ "ส่วนต่าง" ระหว่างค่าทำนายของโมเดลฟิสิกส์กับค่าจริงจากเซ็นเซอร์ และชั้นที่สามคือวงจรสอบเทียบอัตโนมัติที่อัปเดตโมเดลแทรกแซงอย่างต่อเนื่องเมื่อข้อมูลใหม่ไหลเข้ามา โครงสร้าง Hybrid Twin: โมเดลฟิสิกส์ให้ความเข้าใจกลไก ML ชดเชยส่วนต่างจากข้อมูลจริง — ภาพวาดโดยทีม Honey Corporation ผลลัพธ์ที่ได้คือระบบที่ทำนายเร็วเท่า Machine Learning แต่ยังคงความน่าเชื่อถือนอกเงื่อนไขที่เคยเห็น เพราะเมื่อสภาวะเปลี่ยน โมเดลฟิสิกส์ยังจับพฤติกรรมหลักได้ ส่วน ML แค่ปรับค่าชดเชย แนวทางนี้ถูกนำไปใช้จริงในงานวิจัยระดับสากล เช่น โครงการ Horizon Europe ที่ใช้แนวคิด hybrid modeling ผสาน Digital Twin กับการผลิตจริง และงานวิจัยในวารสาร Journal of Engineering…
Read More

วิเคราะห์ตลาด IIoT 2025-2034: จาก 864 พันล้านสู่ 5.55 ล้านล้านดอลลาร์ — โอกาสและความท้าทายสำหรับโรงงานไทย

Article
ตลาด Internet of Things (IoT) ทั่วโลกมีมูลค่า 864 พันล้านดอลลาร์สหรัฐในปี 2025 และคาดการณ์ว่าจะเติบโตเป็น 5.55 ล้านล้านดอลลาร์สหรัฐภายในปี 2034 (ข้อมูล Fortune Business Insights) นี่คือการเติบโตกว่า 6 เท่าตัวในเวลาเพียง 9 ปี แต่ตัวเลขรวมนี้ซ่อนเรื่องราวที่ซับซ้อนกว่านั้น — โดยเฉพาะส่วน Industrial IoT (IIoT) ที่กำลังขับเคลื่อนการเปลี่ยนแปลงครั้งใหญ่ในอุตสาหกรรมการผลิต บทความนี้วิเคราะห์แนวโน้มตลาด IIoT และการลงทุนใน Smart Factory ปี 2025-2026 พร้อมมุมมองเชิงปฏิบัติสำหรับผู้บริหารโรงงานในประเทศไทย ศูนย์ข้อมูลที่ขับเคลื่อน IIoT Platform และ Cloud Analytics โครงสร้างพื้นฐานสำคัญที่รองรับการเติบโตของตลาด IoT แบบทวีคูณ (ภาพ: Wikimedia Commons) ภาพรวมตลาด: IIoT คือส่วนที่เติบโตเร็วที่สุด จากข้อมูล Mordor Intelligence ตลาด IIoT โดยเฉพาะมีมูลค่า 142.4 พันล้านดอลลาร์สหรัฐในปี 2025 และคาดการณ์ว่าจะสูงถึง 191.4 พันล้านดอลลาร์สหรัฐภายในปี 2031 ในขณะที่ข้อมูลจาก Statista ระบุว่า IIoT คิดเป็น 24.3% ของรายได้ตลาด IoT ทั้งหมดในปี 2023 และสัดส่วนนี้กำลังขยายตัวอย่างต่อเนื่อง สิ่งที่น่าสนใจคือ การลงทุนด้าน IoT ในภาคอุตสาหกรรมสูงกว่าภาคอื่นๆ ข้อมูลจาก N-iX ระบุว่าอุตสาหกรรมการผลิตเป็นผู้นำในการพัฒนา IoT โดยมีการลงทุนที่สูงกว่าภาคอื่นๆ อย่างชัดเจน 6 เทรนด์หลักที่ขับเคลื่อนการลงทุนในปี 2026 เทรนด์ ความสำคัญสำหรับโรงงาน ระดับการนำไปใช้ 1. IT/OT Convergence เชื่อมระบบเทคโนโลยีสารสนเทศกับระบบควบคุมการผลิต ทำลาย Silos ข้อมูล กำลังเติบโต 2. Open Standards OPC UA, MQTT Sparkplug ลด Vendor Lock-in และค่าใช้จ่ายการเชื่อมต่อ เป็นมาตรฐาน 3. Digital Twin + AAS สร้างแบบจำลองเสมือนของเครื่องจักรและกระบวนการเพื่อจำลองสถานการณ์ เริ่มแพร่หลาย 4. Industrial Agentic AI ระบบ AI ที่ตัดสินใจและดำเนินการเองในกระบวนการผลิต เกิดใหม่/เติบโตเร็ว 5. Private 5G…
Read More
Master Data Management (MDM) สำหรับ Smart Factory: สร้าง Single Source of Truth ในยุค IIoT และข้อมูลขนาดใหญ่

Master Data Management (MDM) สำหรับ Smart Factory: สร้าง Single Source of Truth ในยุค IIoT และข้อมูลขนาดใหญ่

Article
Master Data Management (MDM) คืออะไร? รากฐานข้อมูลที่ Smart Factory จำเป็นต้องมี ในโรงงานอุตสาหกรรมที่มีระบบหลายชั้น — ERP, MES, SCADA, WMS, QMS — ปัญหาที่คอยหลอกหลอนผู้จัดการโรงงานมาตลอดคือ "ข้อมูลไม่ตรงกัน" ระบบ ERP บอกว่ามีวัตถุดิบ A คงคลัง 5,000 กก. แต่ระบบ WMS บอกว่าเหลือ 4,800 กก. ระบบ MES ก็มีรหัสวัตถุดิบของตัวเองที่เรียกต่างจาก ERP ผลคือความสับสน การตัดสินใจผิดพลาด และการสูญเสียเวลาในการ Reconcile ข้อมูลด้วยมือ Master Data Management (MDM) คือวิธีการและเทคโนโลยีที่แก้ปัญหานี้โดยสร้าง "แหล่งข้อมูลหลัก" (Single Source of Truth) สำหรับข้อมูลอ้างอิง (Reference Data) ที่ใช้ร่วมกันระหว่างระบบ เช่น ข้อมูลสินค้า, วัตถุดิบ, ลูกค้า, ผู้ผลิต, และเครื่องจักร โดยทุกระบบจะอ้างอิงและซิงค์ข้อมูลจาก MDM เท่านั้น ข้อมูล 3 ประเภทในโรงงาน: Transaction, Master และ Reference ก่อนจะเข้าใจ MDM ต้องแยกแยะข้อมูลในโรงงานออกเป็น 3 ประเภทให้ชัดเจน: ประเภทข้อมูล ลักษณะ ตัวอย่าง ความถี่การเปลี่ยนแปลง Transactional Data ข้อมูลธุรกรรม มี Timestamp Production Order, Sales Order สูงมาก (หลายพันรายการ/วัน) Master Data ข้อมูลหลักของ Entity Material Master, Customer Master ต่ำ (เพิ่ม/แก้เป็นครั้งคราว) Reference Data ข้อมูลอ้างอิง/มาตรฐาน หน่วยวัด (kg, mm), รหัสประเทศ แทบไม่เปลี่ยน MDM เน้นจัดการ Master Data เป็นหลัก เพราะนี่คือข้อมูลที่ทุกระบบต้องใช้ และเมื่อไม่ตรงกันจะสร้างปัญหาลูกโซ่ที่กระทบทั้งสายการผลิต Master Data ในโรงงานอุตสาหกรรมมีอะไรบ้าง? ในบริบทอุตสาหกรรมการผลิต Master Data ที่สำคัญประกอบด้วย: Material Master: ข้อมูลวัตถุดิบและสินค้าสำเร็จ — รหัส, ชื่อ, หน่วยนับ, ความหนาแน่น,…
Read More
MES (Manufacturing Execution System) — ระบบปฏิบัติการระดับโรงงานที่เปลี่ยนข้อมูลการผลิตให้กลายเป็นภูมิปัญญา

MES (Manufacturing Execution System) — ระบบปฏิบัติการระดับโรงงานที่เปลี่ยนข้อมูลการผลิตให้กลายเป็นภูมิปัญญา

Article
MES คืออะไร? ระบบจัดการการผลิตที่เชื่อมต่อระหว่างฝ่ายชั้นโรงงานกับสำนักงานใหญ่ Manufacturing Execution System หรือ MES คือระบบปฏิบัติการที่ทำหน้าที่เป็น "สมองกลกลาง" ของโรงงานอุตสาหกรรม โดยนิยามตามมาตรฐาน ISA-95 ระบบนี้อยู่ใน Level 3 ของพีรามิดการทำงานอัตโนมัติ (Automation Pyramid) ซึ่งอยู่เหนือ SCADA และ PLC แต่อยู่ใต้ระบบ ERP ที่ระดับองค์กร หน้าที่หลักของ MES คือการรับคำสั่งผลิตจากระบบวางแผน แล้วแปลเป็นคำสั่งปฏิบัติการที่ระดับเครื่องจักร พร้อมรวบรวมข้อมูลการผลิตจริงส่งกลับขึ้นไปวิเคราะห์ ในโรงงานที่ยังไม่มี MES ปัญหาที่พบบ่อยที่สุดคือ "ช่องว่างข้อมูล" (Data Gap) ระหว่างฝ่ายวางแผนกับฝ่ายผลิตจริง ทีมวางแผนอาจสั่งผลิตสินค้า 10,000 ชิ้น แต่ฝ่ายผลิตพบว่าเครื่องจักรบางเครื่องล่ม หรือวัตถุดิบไม่พอ ส่งผลให้กำหนดส่งมอบคลาดเคลื่อน เมื่อมี MES เข้ามาเชื่อมช่องว่างนี้ ข้อมูลจะไหลผ่านได้ทั้งสองทิศทางแบบเรียลไทม์ ฟังก์ชันหลัก 11 ประการตามมาตรฐาน ISA-95 มาตรฐาน ISA-95 (Part 3) กำหนดฟังก์ชันหลักของ MES ไว้อย่างชัดเจน โดยครอบคลุมกระบวนการผลิตตั้งแต่ต้นน้ำถึงปลายน้ำ: ฟังก์ชัน (ISA-95) หน้าที่ ตัวอย่างในโรงงาน Operations Definition นิยามสูตรการผลิต (Recipe/BOM) กำหนดขั้นตอน 10 สเต็ปสำหรับชิ้นส่วน A Operations Scheduling จัดตารางการผลิต จองเครื่องจักร #3 เวลา 09:00–14:00 Operations Dispatching ส่งคำสั่งผลิตไปยังเครื่องจักร ส่ง Work Order ไปยัง HMI ของสายการผลิต Operations Execution ควบคุมและติดตามการทำงานจริง ตรวจสอบว่าแต่ละสเต็ปผ่านเรียบร้อย Data Collection เก็บข้อมูลผลิตจริง อุณหภูมิ แรงดัน จำนวนชิ้นดี/เสีย Quality Management จัดการคุณภาพตามข้อกำหนด SPC บันทึกค่าวัดทุก 5 นาทีเข้าแผนภูมิควบคุม Maintenance Mgmt จัดการบำรุงรักษาเครื่องจักร สั่งหยุดเครื่องเมื่อ Run-Hour เกินกำหนด Inventory Mgmt ติดตามวัตถุดิบและ Work-in-Process แจ้งเตือนเมื่อวัตถุดิบเหลือต่ำกว่าจุดสั่งซื้อ OEE: ตัวชี้วัดที่ MES คำนวณได้อัตโนมัติ One of the most powerful capabilities of MES is real-time…
Read More
Edge Analytics: การวิเคราะห์ข้อมูลแบบเรียลไทม์ที่ขอบเครือข่ายลด Latency เหลือ 1–10 ms

Edge Analytics: การวิเคราะห์ข้อมูลแบบเรียลไทม์ที่ขอบเครือข่ายลด Latency เหลือ 1–10 ms

Article
ในยุคที่โรงงานอุตสาหกรรมหนึ่งแห่งสามารถผลิตข้อมูลได้มากกว่า 1 เทราไบต์ต่อวัน จากเซ็นเซอร์นับหมื่นตัว การส่งข้อมูลทั้งหมดขึ้น Cloud เพื่อประมวลผลไม่ใช่คำตอบอีกต่อไป Edge Analytics คือแนวทางที่ย้ายกระบวนการวิเคราะห์ข้อมูลออกจากศูนย์กลาง Cloud มาไว้ใกล้กับแหล่งกำเนิดข้อมูล ณ จุดที่ข้อมูลถูกสร้างขึ้น ไม่ว่าจะเป็น Edge Gateway, Industrial PC หรือแม้กระทั่งภายในเซ็นเซอร์อัจฉริยะเอง Edge Analytics คืออะไร? Edge Analytics คือการประมวลผลและวิเคราะห์ข้อมูลแบบ Real-time ณ ตำแหน่งขอบเครือข่าย (Network Edge) แทนที่จะส่งข้อมูลดิบทั้งหมดไปประมวลผลที่ Cloud ระยะไกล เป้าหมายหลักคือลด Latency ลดปริมาณ Bandwidth ที่ต้องส่งผ่านเครือข่าย และเพิ่มความเป็นอิสระจากการเชื่อมต่อ Internet สถาปัตยกรรม Edge Analytics ทำงานอยู่บนหลักการ "Process where data is born" — ประมวลผลในที่ที่ข้อมูลเกิด โดยทำหน้าที่กรอง (Filter), รวบยอด (Aggregate), ตรวจจับความผิดปกติ (Anomaly Detection) และตัดสินใจในระดับ Local ก่อนที่จะส่งเฉพาะข้อมูลสำคัญหรือ Insight ที่ผ่านการกลั่นกรองแล้วขึ้นสู่ Cloud เพื่อเก็บเป็น Historical Record หรือใช้ฝึกโมเดล AI เพิ่มเติม เหตุใดการส่งข้อมูลทั้งหมดขึ้น Cloud จึงไม่ตอบโจทย์อุตสาหกรรม การปฏิเสธแนวคิด "Cloud-First" ในบริบทอุตสาหกรรมเกิดจากข้อจำกัดทางกายภาพและเศรษฐกิจที่ชัดเจน ดังตารางเปรียบเทียบต่อไปนี้: เกณฑ์เปรียบเทียบ Cloud Analytics (ดั้งเดิม) Edge Analytics Latency การตอบสนอง 100–500 ms (Round-trip) 1–10 ms (Local processing) Bandwidth ที่ใช้ สูง (ส่ง Raw Data ทั้งหมด) ต่ำกว่า 90% (ส่งเฉพาะ Insight) การทำงาน Offline ไม่ได้ (ต้องเชื่อมต่อ Internet) ทำได้ (ทำงานต่อได้เมื่อเน็ตดับ) ความเป็นส่วนตัวของข้อมูล ข้อมูลออกจากไซต์ ข้อมูลอยู่ในโรงงาน (Data Sovereignty) ต้นทุนการส่งข้อมูล Egress Fee สะสมตามปริมาณ ลดลงอย่างมีนัยสำคัญ สถาปัตยกรรม 3 ชั้นของ Edge Analytics ชั้นที่ 1: Edge Device…
Read More
FactoryOps: เลเยอร์ปฏิบัติการที่หายไปใน Smart Factory — เติมช่องว่างการมองเห็นที่ PLC/SCADA/MES ทำไม่ได้

FactoryOps: เลเยอร์ปฏิบัติการที่หายไปใน Smart Factory — เติมช่องว่างการมองเห็นที่ PLC/SCADA/MES ทำไม่ได้

Article
โรงงานแห่งหนึ่งอาจมีหุ่นยนต์ คอนโทรลเลอร์ และซอฟต์แวร์ควบคุมครบทุกสายการผลิต แต่กลับไม่สามารถบอกได้แบบเรียลไทม์ว่าเครื่องจักรเครื่องไหนหยุดทำงานเมื่อไหร่ และเสียผลผลิตไปเท่าไหร่ในกะล่าสุด นี่คือ "ช่องว่างการมองเห็น" (Visibility Gap) ที่กำลังคุกคามกำไรของโรงงานอัตโนมัติทั่วโลกในปี 2026 FactoryOps คือหมวดซอฟต์แวร์ปฏิบัติการที่กำลังผุดขึ้นมาเพื่อเติมช่องว่างนี้โดยเฉพาะ ทำงานคู่ขนานกับ PLC, SCADA และ MES ที่มีอยู่แล้ว โดยไม่ต้องเปลี่ยนหรือโปรแกรมใหม่ และไม่จำกัดอายุหรือยี่ห้อของเครื่องจักร Stack ที่โรงงานส่วนใหญ่มีอยู่แล้ว ระบบอัตโนมัติอุตสาหกรรมในปัจจุบันเป็นการสะสมชั้นเทคโนโลยีมาตลอดหลายทศวรรษ แต่ละชั้นแก้ปัญหาจริงของยุคนั้น แต่ไม่มีชั้นไหนออกแบบมาเพื่อให้ "มุมมองเดียวแบบสด" (Single Live View) ของทุกเครื่องจักรพร้อมกัน ชั้นเทคโนโลยี หน้าที่หลัก มาตรฐาน จุดบอด PLC ควบคุมเครื่องจักรแบบเรียลไทม์ IEC 61131-3 มีเฉพาะ Control Data ไม่บอกบริบทการผลิต SCADA / HMI มุมมองควบคุมระดับสาย/ไซต์ ISA-101 ไม่เชื่อมโยงกับต้นทุนและกำไร MES ติดตามคำสั่งผลิตและ WIP ISA-95 ข้อมูลอ้างอิง Order ไม่ใช่เครื่องจักรเครื่องเดียว IIoT Cloud วิเคราะห์ข้อมูลบนคลาวด์ MQTT / OPC UA Delay นาทีถึงชั่วโมง ไม่ตอบทันเหตุการณ์ ทำไมข้อมูลยังแยกกันอยู่ทั้งที่มีระบบครบ? รายงาน State of Smart Manufacturing พบว่า มากกว่า 50% ของโรงงานยังพึ่งสเปรดชีตหรือบันทึกด้วยมือ สำหรับข้อมูลการผลิต การหยุดทำงาน และของเสีย แม้ในโรงงานที่มีระบบอัตโนมัติระดับสูงแล้วก็ตาม สาเหตุเป็นปัญหาโครงสร้าง: PLC ผลิต Control Data, SCADA ผลิต Supervisory Data, ส่วน MES ผลิต Order Data — แต่สามกระแสนี้อยู่คนละระบบ ไม่แชร์ timestamp หรือนิยาม "เหตุการณ์การผลิต" ร่วมกัน "ระบบอัตโนมัติสั่งการให้เครื่องจักรทำงาน แต่มันไม่ได้ให้ 'แหล่งความจริงเดียว' ข้ามโรงงานโดยอัตโนมัติ นั่นเป็นเลเยอร์คนละชั้น" ผลคือสิ่งที่ทีมปฏิบัติการเรียกว่า "สงครามข้อมูลวันจันทร์เช้า" (Monday Morning Data Fight) — บันทึกกะ รายงาน MES และความจำของหัวหน้ากะให้เรื่องเล่าที่ขัดแย้งกัน การตัดสินใจจึงอิงตัวเลขล้าหรือเถียงกันไม่รู้จบ และต้นทุนจริงของ Downtime ยังซ่อนอยู่จนกว่าจะปรากฏเป็นกำไรที่ลดลง FactoryOps เติมอะไร และอยู่ตรงไหนของ Stack แพลตฟอร์ม FactoryOps วางตัวระหว่างชั้นพื้นโรงงานกับ ERP แทนที่จะไปแทน…
Read More