Humanoid Robot แบบ RaaS: คู่มือตัดสินใจ Rent vs Buy จาก 3 Use Case จริงปี 2026 — เมื่อผู้ผลิตชิ้นส่วนรายใหญ่ตั้งเป้า 2,000 ตัวภายในปี 2032

Humanoid Robot แบบ RaaS: คู่มือตัดสินใจ Rent vs Buy จาก 3 Use Case จริงปี 2026 — เมื่อผู้ผลิตชิ้นส่วนรายใหญ่ตั้งเป้า 2,000 ตัวภายในปี 2032

Article
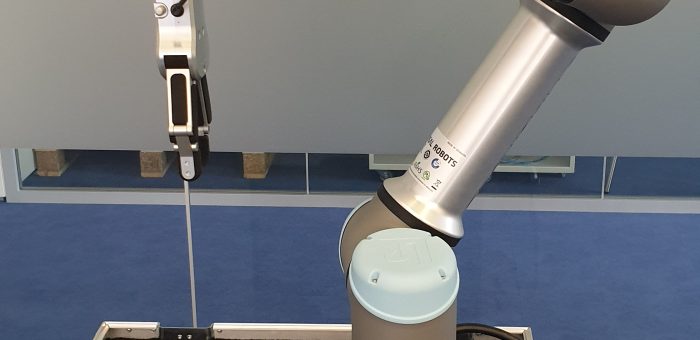
ปี 2026 หุ่นยนต์ฮิวแมนนอยด์ข้ามจากหน้าข่าวสู่สายการผลิตจริงแล้ว ตัวเลขล่าสุดที่น่าสนใจที่สุดคือแผนของผู้ผลิตชิ้นส่วนยานยนต์แถวหน้าของโลกรายหนึ่ง ที่จะติดตั้งหุ่นยนต์รูปแบบมนุษย์ 1,000–2,000 ตัวในโรงงานทั่วโลกภายในปี 2032 เริ่มที่โรงงานในเยอรมนีปลายปีนี้ ในรูปแบบ Robot-as-a-Service (RaaS) แต่ประเด็นของบทความนี้ไม่ใช่ "หุ่นยนต์เก่งแค่ไหน" แต่คือ คำถามที่ผู้จัดการโรงงานทุกคนต้องตอบก่อนเซ็นสัญญา: RaaS หรือซื้อขาด? เพราะเทคโนโลยีที่เปลี่ยนเร็วที่สุดในรอบสิบปี ความผิดพลาดในการเลือกรูปแบบการได้มาสามารถกินกำไรทั้งปีได้ 3 Use Case จริงที่กำหนดสนามแห่งใหม่ ก่อนตัดสินใจ เรามาดูว่าปี 2026 หุ่นยนต์ฮิวแมนนอยด์ทำอะไรได้จริงใน 3 กรณีอ้างอิงจากภาคการผลิต: Use Case รายละเอียดงาน ตัวเลขสำคัญ งานโหลดชิ้นงานงานเชื่อม (สหรัฐฯ)ทำงานร่วมกับสายการประกอบยานยนต์กว่า 11 เดือน, 5 วัน/สัปดาห์, กะละ 10 ชั่วโมง, ร่วมประกอบรถยนต์ 30,000+ คัน, โหลดโลหะ 90,000+ ชิ้นสำหรับฟิกเจอร์งานเชื่อมความแม่นยำการหยิบจับ >99% งานโลจิสติกส์และซัพพลายเชน (แคนาดา)ผู้ผลิตรถยนต์รายใหญ่ขยายการใช้งานสู่งานขนส่งภายในและซัพพลายเชนครบวงจรขยายจากงานทดลองสู่การผลิตจริง แผนปรับใช้ทั่วโลก (เยอรมนี)ผู้ผลิตชิ้นส่วนยานยนต์เริ่มต้นที่โรงงานในเยอรมนีปลายปี 2026 ผ่านรูปแบบ RaaSเป้า 1,000–2,000 ตัวภายในปี 2032 หุ่นยนต์รูปแบบมนุษย์ต้องทำงานร่วมกับคนและเครื่องจักรเดิมในพื้นที่เดียวกัน — ความปลอดภัยและการผสานระบบคือโจทย์ใหญ่กว่าความเก่งของตัวหุ่น (ภาพ: Wikimedia Commons, CC BY-SA 4.0) ทำไม RaaS กลายเป็นคำตอบของปี 2026 เมื่อเทคโนโลยีเปลี่ยนเร็ว การเป็นเจ้าของคือการแบกความเสี่ยงความล้าสมัยเอง RaaS เปลี่ยนหุ่นยนต์จากสินทรัพย์ที่ต้องเกษียณเป็นบริการที่อัปเกรดตามสัญญา ผู้ผลิตชิ้นส่วนรายใหญ่ที่ประกาศแผน 2,000 ตัวเลือก RaaS ไม่ใช่เพราะไม่มีเงิน แต่เพราะ ในช่วงที่ฮาร์ดแวร์และโมเดล AI อัปเกรดทุก 6–12 เดือน การล็อกตัวเองกับรุ่นใดรุ่นหนึ่งคือความเสี่ยง กรอบตัดสินใจ Rent vs Buy — งานที่ยังเปลี่ยนแปลงเร็วเหมาะกับ RaaS งานที่ล็อกแล้วเหมาะกับการซื้อขาด (แผนภาพ: Honey Corporation) Checklist 8 ข้อ ก่อนเซ็นสัญญา RaaS หุ่นยนต์ฮิวแมนนอยด์ เคสงานต้อง "เป็นรูปเป็นร่าง" ก่อน — เริ่มจากงานซ้ำที่วัดผลได้ เช่น การโหลดชิ้นงาน การยกสินค้าขึ้นแท่นวาง ก่อนคิดงานผสานทักษะ ถามเรื่อง Uptime ในสัญญา — บริการที่ดีต้องมี SLA ระบุเวลาทำงานจริงต่อสัปดาห์ ไม่ใช่แค่สเปกกระดาษ อ้างอิงมาตรฐานจาก use case จริง: 5 วัน ×…
Read More
บทวิเคราะห์: Gartner Hype Cycle for Agentic AI 2026 — องค์กรใช้ AI Agent จริงแค่ 17% และนี่คือสิ่งที่โรงงานต้องรู้ก่อนกระโดดขึ้นรถ

บทวิเคราะห์: Gartner Hype Cycle for Agentic AI 2026 — องค์กรใช้ AI Agent จริงแค่ 17% และนี่คือสิ่งที่โรงงานต้องรู้ก่อนกระโดดขึ้นรถ

Article
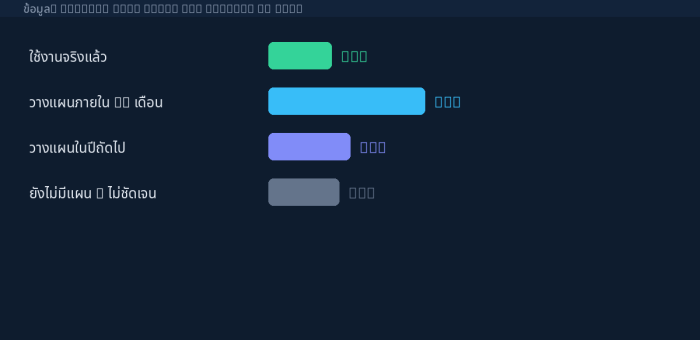
“AI Agent” คือคำที่ถูกพูดมากที่สุดในวงการเทคโนโลยีอุตสาหกรรมปี 2026 ทุกงานสัมมนามีประเด็นนี้ ทุกเวนเดอร์มีแพลตฟอร์มนี้ แต่ตัวเลขจริงจาก Gartner ฉายภาพที่ต่างออกไป: องค์กรที่ใช้ AI Agent ในการทำงานจริงมีเพียง 17% ในขณะที่ 42% วางแผนจะเริ่มภายใน 12 เดือน และอีก 22% มีแผนในปีถัดไป ช่องว่างระหว่าง “ความคาดหวัง” กับ “การใช้งานจริง” นี้แหละคือหัวใจของ Hype Cycle for Agentic AI 2026 ที่ Gartner เผยแพร่ล่าสุด และสำหรับโรงงานไทย นี่คือจังหวะที่ต้องตัดสินใจอย่างมีสติ ไม่ใช่ FOMO ตัวเลขบอกอะไร: 17% ที่เริ่มแล้วทำอะไรอยู่ กลุ่ม 17% ที่ใช้จริงส่วนใหญ่ยังโฟกัสที่ งานอัตโนมัติเฉพาะจุด (Automation เป็นหลัก) ยังไม่ใช่การเปลี่ยนแปลงกระบวนการทั้งองค์กร ซึ่งสอดคล้องกับสิ่งที่เห็นในโรงงานจริง: AI Agent ตัวแรกๆ ที่เวิร์กคือตัวที่ทำงานแคบและชัด เช่น อ่านค่าเซ็นเซอร์แล้วสรุปสรุปสถานะเครื่องจักร จัดลำดับงานซ่อมบำรุง หรือเตรียมรายงานกะกลางคืน 17% ใช้จริง / 42% จะเริ่มใน 12 เดือน / 22% ปีถัดไป — ความต่างขององค์กรจะเกิดในช่วง 12 เดือนข้างหน้า (ข้อมูล: Gartner, แผนภูมิ: Honey Corporation) 3 เทรนด์หลักที่ Gartner ระบุ — แปลเป็นภาษาโรงงาน เทรนด์ Gartner ความหมายต่อโรงงาน 1. AI Agent Adoption — 17% ใช้จริง, 42% ใน 12 เดือน หน้าต่างความได้เปรียบกำลังเปิด ผู้ที่เริ่มก่อนจะสะสมข้อมูลและบทเรียนก่อน แต่เริ่มผิดทางก็เสียเวลาเท่ากัน 2. Semi-Autonomous Deployment — มนุษย์ยังต้องควบคุม อย่ามองหา AI Agent ที่ “ตัดสินใจแทนทั้งหมด” ให้ออกแบบให้ Agent เสนอ + คนอนุมัติจุดวิกฤต เช่น การสั่งหยุดไลน์หรือเปลี่ยนแปลงพารามิเตอร์เครื่องจักร 3. Agent Washing — RPA เดิมแต่งตัวเป็น AI Agent ตรวจสอบให้ชัดว่าแพลตฟอร์มที่ซื้อ “คิดและปรับตัว” จริง หรือแค่รันสคริปต์เดิมที่เปลี่ยนชื่อ…
Read More
บทวิเคราะห์ Over-Optimization Trap: ทำไมระบบที่ Efficient ที่สุดคือระบบที่เปราะบางที่สุด — บทเรียน Resilience ยุค Industry 5.0

บทวิเคราะห์ Over-Optimization Trap: ทำไมระบบที่ Efficient ที่สุดคือระบบที่เปราะบางที่สุด — บทเรียน Resilience ยุค Industry 5.0

Article
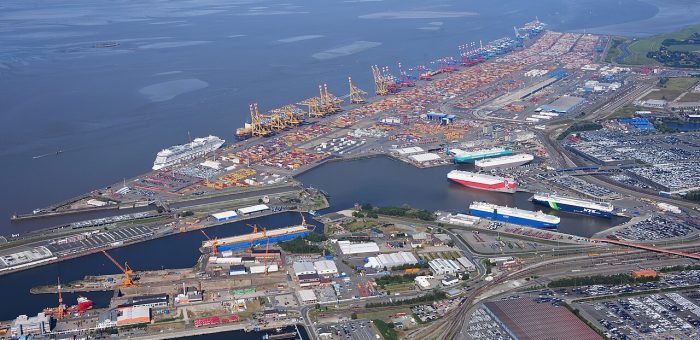
ยี่สิบปีที่แล้ว คำว่า "Lean" และ "Just-in-Time" คือคำตอบสุดท้ายของวงการผลิต — ตัดสต๊อกให้เหลือน้อยที่สุด ตัด Waste ให้หมด บีบ Supplier ให้ส่งของถี่ขึ้นเรื่อยๆ แล้ว COVID-19 ก็มาถึง ตามด้วยสงครามการค้า ความขัดแย้งภูมิรัฐศาสตร์ และวิกฤตพลังงาน โลกของปี 2026 ค้นพบความจริงข้อหนึ่ง: ระบบที่ Optimize สูงสุดคือระบบที่เปราะบางสูงสุด นี่คือบทวิเคราะห์ปรากฏการณ์ที่เราเรียกว่า "กับดักการ Optimize เกินพอดี" (Over-Optimization Trap) — และเหตุใด Industry 5.0 จึงยกเรื่อง Resilience ขึ้นเป็นเสาหลักเทียบเท่าประสิทธิภาพ ท่าเรือคอนเทนเนอร์คือภาพจำของ Global Value Chains — ระบบที่มีประสิทธิภาพสูงที่สุดในประวัติศาสตร์ และก็เปราะบางที่สุดเมื่อโลกหยุดหมุน (ภาพ: Wikimedia Commons, Public Domain) กับดักทำงานอย่างไร — 3 กลไกที่มองไม่เห็นในตาราง Excel 1. Efficiency กับ Resilience คือ Trade-off ที่ซ่อนอยู่ ทุกครั้งที่เราตัดสต๊อก Buffer ลง รวม Supplier จาก 5 รายเหลือ 1 ราย (เพื่อราคาดีกว่า) หรือรวมโรงงานจาก 3 แห่งเหลือ 1 แห่ง (เพื่อ Economies of Scale) — เรากำลังแลก "ความเปราะบาง" ซื้อ "ประสิทธิภาพ" โดยที่ตัวเลขในงบการเงินแสดงเฉพาะครึ่งหลัง เอกสารวิเคราะห์ของสภาอุตสาหกรรมแห่งประเทศไทย (FTPI) ปี 2026 ชี้ตรงว่าแนวทาง Just-in-Time ที่เน้นประสิทธิภาพสูงสุดของ Industry 4.0 กลายเป็น "ความเปราะบางเมื่อเผชิญเหตุการณ์ไม่ปกติ" — วิกฤตด้านสาธารณสุข เศรษฐกิจ ภูมิรัฐศาสตร์ และการหยุดชะงักของห่วงโซ่อุปทาน 2. Rebound Effect — เทคโนโลยีประหยัดทรัพยากรที่ทำให้ใช้ทรัพยาศเพิ่ม เอกสารเดียวกันอธิบายปรากฏการณ์ที่ถูกมองข้าม: เมื่อเทคโนโลยีทำให้ต้นทุนการผลิตลดลง ความต้องการก็เพิ่มขึ้นจน "หักล้างประสิทธิภาพที่ทำไว้" — โรงงานที่ประหยัดพลังงานต่อหน่วยได้ 20% อาจผลิตเพิ่ม 30% สุทธิคือใช้พลังงานมากขึ้น นี่คือเหตุผลที่เป้าหมาย Sustainability ของ Industry 5.0 ต้องมาพร้อมระบบวัดผลจริง (Carbon Accounting, Energy Submetering…
Read More
Case Study: ออกแบบงานใหม่แบบ Human-Centric — เมื่อปัญหา ‘ขาดคน’ ของโรงงานคือปัญหา ‘งานถูกออกแบบไม่ดี’

Case Study: ออกแบบงานใหม่แบบ Human-Centric — เมื่อปัญหา ‘ขาดคน’ ของโรงงานคือปัญหา ‘งานถูกออกแบบไม่ดี’

Article
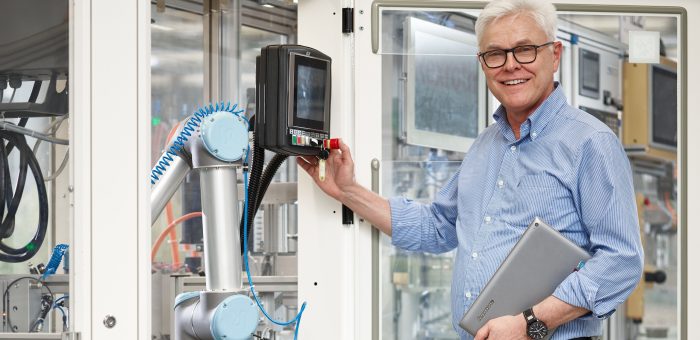
โรงงานประกอบชิ้นส่วนอิเล็กทรอนิกส์แห่งหนึ่งในภาคตะวันออกของไทยกำลังเผชิญปัญหาคลาสสิกของปี 2026: คนงานใหม่ลาออกเร็ว ตำแหน่งว่างหาคนทดแทนยาก และ Productivity ของไลน์ผลิตไม่ขยับแม้ลงทุนเครื่องจักรอัตโนมัติเพิ่มแล้ว บทความนี้ถอดบทเรียนกรณีศึกษาการออกแบบงานใหม่แบบ Human-Centric — แนวทางหลักของ Industry 5.0 — ที่ใช้ได้จริงกับบริบทโรงงานไทย Problem: เมื่อ Automation แก้ปัญหา "ขาดคน" ไม่ได้ทั้งหมด สถานการณ์ตั้งต้นของโรงงานตัวอย่าง (ข้อมูลจากการรวบรวมงานวิจัยและกรณีศึกษาอุตสาหกรรม ปี 2023–2026): อัตราลาออกของพนักงานสายการผลิตสูง — ข้อมูล U.S. Bureau of Labor Statistics อ้างอิงในงานวิจัยภาคอุตสาหกรรม ระบุอัตรา Turnover ภาคการผลิตสหรัฐฯ ปี 2023 แตะระดับ 37% ต่อปี และภูมิภาคเอเชียตะวันออกเฉียงใต้เผชิญแรงกดดันในทิศทางเดียวกันจากภาวะแรงงานสูงวัยและการย้ายข้ามอุตสาหกรรม งานที่มอบหมายคนใหม่คืองานซ้ำ ๆ ความยากสูง อธิบายด้วยปากเปล่าแบบ Shadowing — คนใหม่ใช้เวลาเข้าใจงานนาน ผิดพลาดบ่อยในช่วง 3 เดือนแรก การลงทุน Cobot เพิ่มใน 2 สถานี ช่วยลดภาระงานหนักได้จริง แต่ Bottleneck ย้ายไปอยู่ที่ "ขั้นตอนที่ต้องใช้วิจารณญาณ" ที่ระบบอัตโนมัติทำแทนไม่ได้ งานวิจัย Human-Robot Collaboration: หุ่นยนต์รับน้ำหนักและความแม่นยำ มนุษย์รับการตัดสินใจ — แบ่งบทบาทตามจุดแข็งของแต่ละฝ่าย (ภาพ: Luka Peternel / Wikimedia Commons, CC BY-SA 4.0) Solution: ออกแบบงานรอบ "คน" ใน 4 ขั้นตอน ขั้นที่ 1 — ทำ Task Inventory แยกงานตามลักษณะ ทีมวิศวกรรมและ HR ร่วมกันแยกงานทุกขั้นตอนในไลน์ผลิตออกเป็น 3 กลุ่ม: (1) งานซ้ำ อันตราย หนัก (2) งานที่ต้องใช้วิจารณญาณ/ประสบการณ์ และ (3) งานที่คนกับเครื่องทำร่วมกันได้ ผลที่ได้ทำให้เห็นว่าการมอบหมายงานเดิมผิดที่: คนเก่งถูกผูกกับงานซ้ำ ๆ ที่เครื่องจักรควรทำแทน ขณะที่คนใหม่กลับถูกโยนงานที่ต้องใช้วิจารณญาณโดยไม่มีระบบช่วย ขั้นที่ 2 — จัดสรรงานใหม่แบบ Human-Technology Collaboration งานกลุ่ม (1) โอนให้ Cobot และระบบขนส่งอัตโนมัติ งานกลุ่ม (2) ออกแบบให้มี Digital Work Instructions รองรับ…
Read More
Industry 5.0 คืออะไร: ถอดรหัส 3 เสาหลัก Human-Centric, Sustainability, Resilience และเส้นทางเปลี่ยนผ่านสำหรับโรงงานไทย

Industry 5.0 คืออะไร: ถอดรหัส 3 เสาหลัก Human-Centric, Sustainability, Resilience และเส้นทางเปลี่ยนผ่านสำหรับโรงงานไทย

Article
ในช่วงสิบปีที่ผ่านมา คำว่า Industry 4.0 กลายเป็นคำโฆษณาชวนเชื่อ (Buzzword) ที่โรงงานทั่วโลกใช้เรียกการลงทุนเทคโนโลยีดิจิทัล ตั้งแต่ IoT Platform, Big Data ไปจนถึง AI แต่ปลายปี 2026 นี้ กระแสนโยบายเริ่มเปลี่ยน สหภาพยุโรปผลักดันกรอบแนวคิด Industry 5.0 อย่างจริงจัง โดยไม่ได้หมายถึง "เทคโนโลยีเจเนอเรชันใหม่" แต่คือการเปลี่ยนกระบวนทัศน์ (Paradigm Shift) จากระบบ Techno-economic ไปสู่ Socio-technical System — เทคโนโลยีเป็นเพียงเครื่องมือ ไม่ใช่ปลายทาง บทความนี้ถอดรหัส Industry 5.0 ให้วิศวกรและผู้บริหารโรงงานไทยเข้าใจอย่างเป็นระบบ พร้อมตัวเลขจริงที่อ้างอิงจากเอกสารวิจัยของสภาอุตสาหกรรมแห่งประเทศไทย (FTPI) ปี 2026 และรายงานระดับโลก Industry 4.0 ติดขัดตรงไหน — 4 ข้อจำกัดที่โลกยอมรับแล้ว ก่อนจะเข้าใจ Industry 5.0 ต้องเข้าใจว่าทำไมโลกถึงต้องการ "อุตสาหกรรม 5.0" ตัวเลขชี้ว่า Industry 4.0 ประสบความสำเร็จด้านประสิทธิภาพ แต่สร้างผลข้างเคียง 4 ข้อที่ยังแก้ไม่ตก: เน้นผลกำไรมากกว่าสังคม — การตัดสินใจลงทุนถูกขับเคลื่อนด้วย ROI และการลดต้นทุน จนแรงงานถูกมองเป็น "ต้นทุนที่ต้องควบคุม" มากกว่าทรัพยากรที่ต้องพัฒนา ความเสี่ยงแทนที่แรงงาน — รายงาน Future of Jobs Report ของ World Economic Forum ระบุว่าภายในปี 2027 จะมีตำแหน่งงานหายไปราว 83 ล้านตำแหน่ง ขณะที่เกิดงานใหม่เพียง 69 ล้านตำแหน่ง เกิด Net Job Loss ประมาณ 14 ล้านตำแหน่งทั่วโลก และแรงงาน 400–800 ล้านคนอาจต้องเปลี่ยนอาชีพภายในปี 2030 ใช้ทรัพยากรเข้มข้นเกินไป — เกิดปรากฏการณ์ Rebound Effect: เทคโนโลยีที่ประหยัดต้นทุนกลับกระตุ้นการผลิตมากขึ้นจนหักล้างประสิทธิภาพที่ทำไว้ รวมถึง AI, Data Center และ Cloud Computing ที่ใช้พลังงานสูง ความเปราะบางของห่วงโซ่อุปทาน — ระบบ Just-in-Time ที่ผองชื่อเรื่องประสิทธิภาพ กลายเป็นจุดอ่อนเมื่อเจอ COVID-19 ความขัดแย้งภูมิรัฐศาสตร์ และการหยุดชะงักของ Global Value Chains Cobot คือสัญลักษณ์ของ Human-Technology…
Read More
How-to: รับมือ TH-AI Passport ยุคพนักงานใช้ AI ทุกคน — วาง AI Policy โรงงาน 5 ขั้นตอน

How-to: รับมือ TH-AI Passport ยุคพนักงานใช้ AI ทุกคน — วาง AI Policy โรงงาน 5 ขั้นตอน

Article
ปลายเดือนสิงหาคม 2026 ประเทศไทยเปิดตัว TH-AI Passport โครงการระดับชาติที่ให้ประชาชนเข้าถึงโมเดล AI ชั้นนำได้ และภายในเดือนแรกมีผู้ใช้แล้ว 500,000 ราย (ที่มา: Thai PBS World, 3 ก.ย. 2026) ขณะที่หน่วยงานภาครัฐเปิดเผยเป้าหมายผลักดันอัตราการใช้ AI ของคนไทยให้ถึง อย่างน้อย 20% ภายในปีหน้า สำหรับคนทำโรงงาน ข่าวนี้ไม่ใช่แค่นโยบายรัฐที่อ่านผ่าน — มันคือสัญญาณว่า พนักงานของคุณจะเริ่มใช้ AI ในงานจริงเร็วกว่าที่ระบบและกฎเกณฑ์ของโรงงานจะพร้อมรับ คำถามจึงไม่ใช่ว่าควรอนุญาตหรือไม่ แต่คือจะเปลี่ยนพนักงานที่ใช้ AI ให้เป็นความได้เปรียบได้อย่างไร บริบท: ทำไมรัฐต้องผลักดันเป้าหมาย 20% เหตุผลมาจากตัวเลขในรายงาน Global AI Adoption in 2025 — อัตราการใช้ AI ของไทยอยู่ที่เพียง 10.7% ต่ำกว่าค่าเฉลี่ยโลก 16.3% และติดอันดับ 89 ของโลก ขณะที่เวียดนามอยู่ที่ 23.5% (อันดับ 38) มาเลเซีย 19.7% ฟิลิปปินส์ 18.3% และสิงคโปร์สูงถึง 60.9% (อันดับ 2 ของโลก) ภาพประกอบ: เมื่อการเข้าถึง AI กลายเป็นโครงสร้างพื้นฐานสาธารณะใหม่ โรงงานไทยต้องปรับตัวรับพนักงานยุคใหม่ที่ใช้ AI เป็นประจำ (ที่มา: Unsplash) เป้าหมาย 20% จึงหมายถึงการเพิ่มเกือบเท่าตัวจากระดับปัจจุบัน และ TH-AI Passport คือเครื่องมือหลักเพื่อไปให้ถึงเป้าหมาย โดยลดอุปสรรคด้านการเข้าถึงเทคโนโลยี ซึ่งรายงานฉบับเดียวกันระบุว่าเป็นหนึ่งในสามช่องว่างหลักของไทย (อีกสองคือทักษะ และการนำไปใช้จริงในภาคเศรษฐกิจ) ตาราง: โอกาสและความเสี่ยงเมื่อพนักงานโรงงานใช้ AI สาธารณะ มิติงาน โอกาส ความเสี่ยง การผลิตช่วยเรียบเรียง work instruction สรุป log เครื่องจักร และแปลคู่มือเทคนิคคำแนะนำที่ผิดโดยไม่มีใครตรวจ นำไปสู่การตัดสินใจผิดหน้างาน คุณภาพร่างรายงาน 8D รายงาน CAPA และสรุปผล auditผลลัพธ์ที่ดูน่าเชื่อถือแต่ผิด (hallucination) ปนเข้าเอกสารคุณภาพ ซ่อมบำรุงวิเคราะห์แนวโน้มการเสียของเครื่องจักร และช่วย troubleshooting ขั้นต้นข้อมูลที่ควรเป็นความลับถูกส่งเข้าโมเดลสาธารณะ (data leakage) ความปลอดภัยสร้างแบบประเมิน JSA และร่าง permit-to-worknetwork diagram หรือ IP ภายในองค์กรถูกวางเข้าโมเดลภายนอก ฝึกอบรมสร้างสื่ออบรมสั้นตามสถานการณ์หน้างานจริงเนื้อหาต้องผ่านการตรวจทานของผู้เชี่ยวชาญก่อนนำไปใช้จริง ที่มา: วิเคราะห์โดย Honey Corporation จากกรณีการใช้งานจริงในโรงงานอุตสาหกรรม…
Read More
บทวิเคราะห์: ไทยอันดับ 89 ของโลกด้าน AI Adoption (10.7%) — สัญญาณเตือนที่โรงงานไทยต้องอ่านให้ขาด

บทวิเคราะห์: ไทยอันดับ 89 ของโลกด้าน AI Adoption (10.7%) — สัญญาณเตือนที่โรงงานไทยต้องอ่านให้ขาด

Article
รายงาน "Global AI Adoption in 2025: A Widening Digital Divide" ที่ถูกรายงานโดย The Nation Thailand เมื่อปลายเดือนพฤษภาคม 2026 ชี้ตัวเลขที่หลายคนในวงการอุตสาหกรรมไทยควรหยุดอ่านสักครู่ — อัตราการใช้ AI ของคนไทยอยู่ที่เพียง 10.7% ของประชากรทั้งหมด ต่ำกว่าค่าเฉลี่ยโลกที่ 16.3% และส่งผลให้ไทยติดอันดับ 89 ของโลก ในครึ่งหลังของปี 2025 ตัวเลขนี้ไม่ใช่แค่สถิติ แต่คือ "สัญญาณเตือน" สำหรับภาคการผลิตของไทย เมื่อเพื่อนบ้านใน ASEAN กำลังวิ่งไปข้างหน้าเร็วกว่าที่คิด ตารางเปรียบเทียบ: ไทยอยู่ตรงไหนในสนาม AI ของภูมิภาค? ประเทศ อัตราการใช้ AI อันดับโลก เทียบกับไทย (10.7%) สิงคโปร์60.9%2สูงกว่าไทยเกือบ 6 เท่า เวียดนาม23.5%38สูงกว่าไทย 2.2 เท่า มาเลเซีย19.7%–สูงกว่าไทย 1.8 เท่า ฟิลิปปินส์18.3%–สูงกว่าไทย 1.7 เท่า อินโดนีเซีย12.7%–สูงกว่าไทยเล็กน้อย ไทย10.7%89— ที่มา: รายงาน "Global AI Adoption in 2025: A Widening Digital Divide" รายงานโดย The Nation Thailand (พ.ค. 2026) ภาพประกอบ: ช่องว่างการใช้ AI ในภูมิภาค ASEAN — เมื่อข้อมูลกลายเป็นเส้นทางแข่งขันใหม่ของภาคการผลิต ทำไมตัวเลข 10.7% ถึงสำคัญกับโรงงานไทยมากกว่าที่คิด หลายฝ่ายอามแย้งว่า "AI adoption" ที่รายงานวัดจากประชากรทั้งหมด ไม่ได้วัดที่ระดับองค์กร แต่ประเด็นสำคัญอยู่ที่ว่า คนที่จะใช้ AI ในโรงงาน ก็มาจากกลุ่มประชากรนี้แหละ เมื่อฐานคนใช้ AI ทั้งประเทศเล็ก ย่อมหมายความว่า: พนักงานสายเทคนิคที่คุ้นเคย AI หายากขึ้น — โรงงานที่ต้องการเริ่มใช้ machine learning ตรวจสอบคุณภาพ หรือ predictive maintenance จะพบว่า talent pool ในตลาดแคบกว่าที่คาด ช่องว่างระหว่างพูดถึงกับใช้จริงกว้างขึ้น — รายงานระบุชัดว่า ขณะที่ AI ถูกพูดถึงมากขึ้นทั่วประเทศ การใช้งานจริงของประชาชนยังจำกัด เกือบ 90% ของคนไทยยังไม่ใช้ AI หรือไม่มีโอกาสเข้าถึง —…
Read More
Spatial Computing ในโรงงานอุตสาหกรรม: เมื่อ Industrial Metaverse โตกว่า Consumer สองเท่า — บทวิเคราะห์สำหรับโรงงานไทย

Spatial Computing ในโรงงานอุตสาหกรรม: เมื่อ Industrial Metaverse โตกว่า Consumer สองเท่า — บทวิเคราะห์สำหรับโรงงานไทย

Article
ปี 2023 คำว่า “Metaverse” เคยถูกล้อเลียนจนกลายเป็นมีม แต่สองปีถัดมา แนวคิดนั้นแยกร่างเป็นสิ่งที่จับต้องได้มากขึ้น — Spatial Computing — และในครั้งนี้ โรงงานอุตสาหกรรมคือลูกค้ากลุ่มแรกที่จริงจังที่สุด รายงาน Tech Trends ของ Deloitte ประเมินว่ารายได้จาก Industrial Metaverse จะแตะราว 100 พันล้านดอลลาร์ภายในปี 2030 แซงหน้าทั้ง Consumer (50 พันล้าน) และ Enterprise ทั่วไป (30 พันล้าน) ส่วนตลาด Spatial Computing โดยรวมบางประมาณการให้สูงถึง 600 พันล้านดอลลาร์ภายในปี 2032 ตัวเลขเหล่านี้ไม่ใช่แค่การคาดเดาของนักวิเคราะห์ — สำรวจของ Deloitte ร่วมกับ Manufacturing Leadership Council พบว่า 92% ของผู้บริหารฝ่ายการผลิตทั่วโลกทดลองหรือใช้งาน immersive use case อย่างน้อยหนึ่งงาน โดยเฉลี่ยแล้วองค์กรหนึ่งทำมากกว่าหก use cases และคาดหวังการปรับปรุงด้านยอดขาย ผลิตภาพ และคุณภาพราว 12-14% ในอนาคตอันใกล้ คำถามจึงไม่ใช่ “ควรลองไหม” แต่คือ “ควรเริ่มจากตรงไหนและเตรียมรับอะไรบ้าง” Spatial Computing คืออะไร: นิยามที่วิศวกรเข้าใจ รายงาน Technology Vision ของผู้ให้บริการเครือข่ายรายใหญ่นิยาม Spatial Computing ว่าเป็นกระบวนทัศน์ใหม่ของปฏิสัมพันธ์ระหว่างมนุษย์กับคอมพิวเตอร์ ที่ “นำสถานที่และวัตถุทางกายภาพเข้ามาในแอปพลิเคชัน แล้วซ้อนทับข้อมูลดิจิทัลลงบนสิ่งเหล่านั้น” ต่างจาก GUI ดั้งเดิมที่บังคับให้เราเลือกว่าจะดูโลกจริงหรือจอคอมพิวเตอร์ Spatial Computing ลบเส้นแบ่งนั้นด้วยการทำให้ข้อมูลดิจิทัล มีตำแหน่งในอวกาศจริง — ลูกศรชี้ไปที่วาล์วตัวนั้นจริงๆ ค่าอุณหภูมิลอยอยู่ข้างปั๊มตัวนั้นจริงๆ และคนสองคนที่ยืนคนละทวีปมองเห็น Annotation เดียวกันบนเครื่องจักรเครื่องเดียวกัน สิ่งที่ทำให้มันทำงานได้คือชั้นเทคโนโลยีห้าชั้นที่รายงานเทคโนโลยีฉบับดังกล่าวเรียกว่า Spatial Computing Technology Stack: แผนภาพที่ 1: Spatial Computing Technology Stack — 5 องค์ประกอบที่ยึดเกาะข้อมูลดิจิทัลเข้ากับโลกกายภาพ (ที่มา: Honey Corporation, อ้างอิงกรอบคิดจากรายงาน Technology Vision ระดับโลก) Spatial User Interfaces: จาก Smart Glasses น้ำหนักเบาไปถึง MR Headset เต็มรูปแบบ รองรับการควบคุมด้วยท่าทาง เสียง และ Eye…
Read More
Reality Capture สำหรับ Digital Twin: จาก LiDAR และ Point Cloud สู่โมเดลโรงงานที่ตรงความจริง (Scan-to-Twin)

Reality Capture สำหรับ Digital Twin: จาก LiDAR และ Point Cloud สู่โมเดลโรงงานที่ตรงความจริง (Scan-to-Twin)

Article
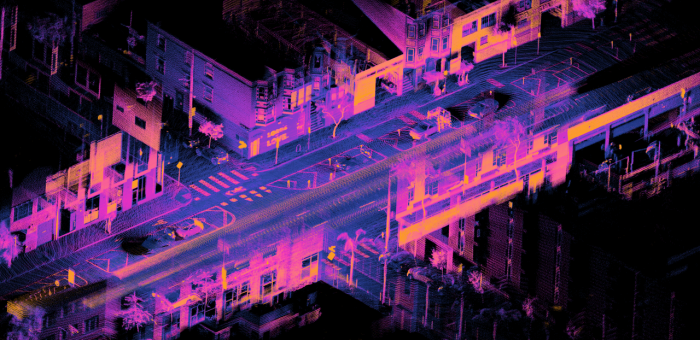
คำถามที่ทีมวิศวกรรมได้ยินบ่อยที่สุดเมื่อเริ่มโครงการ Digital Twin ของโรงงานเก่าคือ "แผ่น CAD ที่มีอยู่ ใช้ได้เลยไหม?" คำตอบในทางปฏิบัติแทบทุกครั้งคือ — ไม่ได้ หรือไม่แม่นพอ โรงงานที่อายุ 10-20 ปีผ่านการปรับปรุงเปลี่ยนแปลงมานับสิบรอบ ทั้งย้ายเครื่องจักร เพิ่มท่อ เปลี่ยนเลย์เอาต์ แต่แฟ้ม CAD ยังค้างอยู่ที่ฉบับวันเปิดโรงงาน ผลคือ "โมเดลที่สวยแต่โกหก" Reality Capture คือกระบวนการจับข้อมูลโลกจริงมาเป็นโมเดลดิจิทัล — ด้วยการสแกนด้วยเลเซอร์ (LiDAR) หรือการถ่ายภาพหลายมุมเพื่อคำนวณเป็นโมเดลสามมิติ (Photogrammetry) ผลลัพธ์ที่ได้เรียกว่า Point Cloud ซึ่งจะกลายเป็นรากฐานที่แท้จริงของ Digital Twin ที่สะท้อนโรงงาน "ตามที่มันเป็น" (as-built) ไม่ใช่ "ตามที่แบบบอก" กระบวนการทั้งหมดนี้เรียกอีกชื่อหนึ่งว่า Scan-to-Twin ทำความรู้จักเครื่องมือก่อน: LiDAR ทำงานอย่างไร LiDAR (Light Detection and Ranging) ทำงานโดยยิงลำแสงเลเซอร์ไปยังวัตถุแล้ววัดเวลาที่แสงสะท้อนกลับมายังตัวรับ จากนั้นคำนวณระยะทางจากความเร็วแสง เมื่อยิงซ้ำนับล้านครั้งต่อวินาทีพร้อมหมุนสแกนไปทั่วพื้นที่ เครื่องจะได้จุดพิกัดสามมิติจำนวนมหาศาลที่ประกอบกันเป็น "เมฆจุด" ของสภาพแวดล้อมจริง รายละเอียดนั้นสูงมากจนสามารถนำไปใช้วัดขนาดจริงได้ หัวสแกน LiDAR แบบหมุน — ยิงลำเลเซอร์นับล้านครั้งต่อวินาทีแล้ววัดเวลาที่แสงสะท้อนกลับ เพื่อระบุพิกัดสามมิติของทุกจุดในพื้นที่ (ภาพ: Wikimedia Commons, CC BY 2.0) How-to: 6 ขั้นตอนจากโรงงานจริงสู่ Digital Twin ขั้นที่ 1 — สำรวจหน้างานและวางแผนตำแหน่งสแกน (Scan Plan) เดินสำรวจพื้นที่ก่อนเสมอ ระบุอุปสรรคแสง (แสงจ้าจากประตูโรงงาน พื้นสะท้อนแสง ผิวโลหะมันวาว) แล้วกำหนดจุดตั้งกล้องให้ทุกมุมมีความซ้อนทับกันอย่างน้อย 30% ระหว่างสแกนแต่ละจุด หากใช้แบบ Handheld SLAM Scanner จะยืดหยุ่นกว่าสำหรับพื้นที่แคบ เช่น ช่องท่อใต้ผิวดินหรือบริเวณท่อร้อย ขั้นที่ 2 — ลงสแกนในหน้างาน สแกนแต่ละจุดใช้เวลาไม่กี่นาที โรงงานขนาดกลางอาจต้องลงสแกนหลายสิบถึงหลายร้อยจุด สิ่งสำคัญคือควบคุมคนเดินผ่านให้น้อยที่สุดระหว่างสแกน เพราะ "คน" จะกลายเป็น noise ใน point cloud ด้วยเหตุผลเดียวกัน ควรสื่อสารกับฝ่ายผลิตล่วงหน้าเพื่อจองช่วงเวลา เช่น วันหยุดปฏิบัติการหรือช่วงเปลี่ยนกะ ขั้นที่ 3 — รวมจุดสแกน (Registration) ไฟล์สแกนแต่ละจุดคือ "ภาพตัด" ของพื้นที่ ต้องนำมาเชื่อมกันเป็นแผนที่เดียว กระบวนการนี้เรียกว่า Point Set Registration โดยอัลกอริทึมที่ใช้แพร่หลายคือ ICP…
Read More
บทวิเคราะห์ GitOps สำหรับ Edge Fleet ของโรงงานหลายไซต์: จัดการ Configuration Drift ตามหลักการ OpenGitOps 4 ข้อ

บทวิเคราะห์ GitOps สำหรับ Edge Fleet ของโรงงานหลายไซต์: จัดการ Configuration Drift ตามหลักการ OpenGitOps 4 ข้อ

Article
คำถามที่ทุกโรงงานหลายไซต์เจอ: เซิร์ฟเวอร์ Edge 30 เครื่อง เหมือนกันจริงหรือไม่ เมื่อระบบ IIoT ขยายจาก pilot หนึ่งไซต์ไปสู่หลายโรงงาน คำถามที่ตามมาเสมอคือ เราจะมั่นใจได้อย่างไรว่าเซิร์ฟเวอร์ Edge ทุกเครื่องทั่วประเทศรันโค้ดเวอร์ชันเดียวกัน ใช้ค่า config เดียวกัน และติดตั้ง security patch ระดับเดียวกัน ประสบการณ์เดิมของหลายองค์กรคือการ ssh เข้าไปแก้ทีละเครื่อง ซึ่งใช้ได้กับ 3 เครื่อง แต่ไม่ใช่กับ 30 หรือ 300 เครื่อง คำตอบจากโลก software ที่กำลังไหลเข้าสู่โลกโรงงานคือ GitOps ซึ่ง OpenGitOps Working Group แห่ง CNCF ให้นิยามผ่านหลักการ 4 ข้อเวอร์ชัน 1.0.0 ได้แก่ Declarative (สถานะที่ต้องการต้องอธิบายแบบประกาศผล), Versioned and Immutable (เก็บประวัติทุกการเปลี่ยนแปลงแบบย้อนหลังได้), Pulled Automatically (agent ดึงสถานะจาก source เองโดยอัตโนมัติ) และ Continuously Reconciled (agent เฝ้าเทียบสถานะจริงกับที่ต้องการตลอดเวลา แล้วแก้กลับเมื่อพบความคลาดเคลื่อน) GitOps มักถูก implement คู่กับ lightweight Kubernetes บน edge node ของโรงงาน (ภาพ: Honey Corporation) Configuration Drift คือศัตรูที่แท้จริง ปัญหาไม่ใช่การติดตั้งครั้งแรก แต่คือ drift ที่สะสมทีละนิด เวอร์ชันโค้ดต่างกันหนึ่ง release, config ที่วิศวกรแก้ชั่วคราวตอนดึกเพื่อดับไฟปัญหา production แล้วลืมกลับมาเก็บ, patch ที่ติดตั้งบางเครื่องแต่ไม่ติดบางเครื่อง เมื่อเวลาผ่านไปหกเดือน ไม่มีใครกล้ายืนยันว่าทุกเครื่องเหมือนกันจริง และนี่คือจุดกำเนิดของปัญหา "ในเครื่องทดสอบทำงานได้ แต่ใน production ไม่ได้" รวมถึงช่องโหว่ความปลอดภัยที่ค้างอยู่ในเครื่องที่ถูกลืม วิเคราะห์: โมเดล Pull ทำงานกับ Edge ได้ดีอย่างไร จุดเปลี่ยนสำคัญที่ทำให้ GitOps เข้ากันได้กับสภาพแวดล้อมโรงงานคือโมเดล pull-based แทนที่เซิร์ฟเวอร์กลางจะ push การเปลี่ยนแปลงออกไปหา edge (ซึ่งต้องเปิดพอร์ตเข้าแต่ละเครื่องและรู้หมายเลข IP ทุกเครื่อง) ฝั่ง edge เป็นผู้ initiate connection ออกไปดึง desired state จาก Git repository…
Read More