บทวิเคราะห์: ทำไม 70% ของโครงการ Digital Transformation โรงงานล้มเหลว — 4 สาเหตุจาก McKinsey และทางออกแบบโรงงานไทย

บทวิเคราะห์: ทำไม 70% ของโครงการ Digital Transformation โรงงานล้มเหลว — 4 สาเหตุจาก McKinsey และทางออกแบบโรงงานไทย

Article
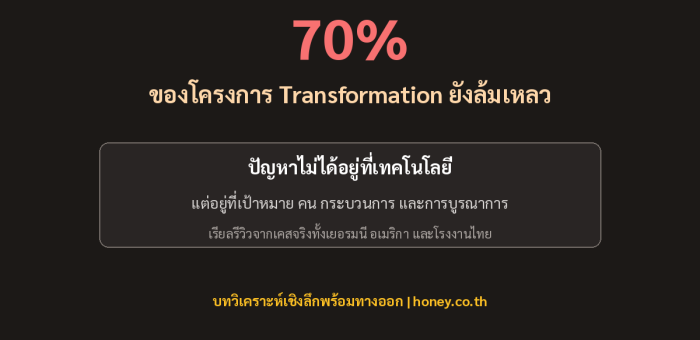
คำถามที่ผู้บริหารโรงงานไทยถามกันบ่อยที่สุดในปี 2026 ไม่ใช่ "จะทำ Digital Transformation อย่างไร" แต่คือ "ทำอย่างไรจะไม่กลายเป็นอีกเคสที่ล้มเหลว" — เพราะตัวเลขที่ McKinsey & Company เผยแพร่ต่อกันอย่างกว้างขวางคือ 70% ของโครงการ Transformation ยังคงต้องเผชิญความท้าทายจนไม่บรรลุเป้าหมายที่ตั้งไว้ และความล้มเหลวพวกนี้ไม่ได้จำกัดอยู่ที่บริษัทเล็ก บทวิเคราะห์นี้รวบรวมเคสจริงจากทั้งต่างประเทศและบริบทโรงงานไทย เพื่อชี้ว่ารากของปัญหาแทบไม่เคยอยู่ที่เทคโนโลยีเลย เคสต่างประเทศ: แบรนด์ใหญ่ก็พังได้ ถ้าแผนไม่เข้มแข็ง ผู้ผลิตลูกอมรายใหญ่ของเยอรมนี — การบูรณาการระบบ ERP ที่ทั่วทั้งองค์กรพร้อมกันนำไปสู่ปัญหาการส่งมอบและการมองเห็นสินค้าคงคลัง จนยอดขายในช่วงเปลี่ยนผ่านลดลงถึง 25% แบรนด์อุปกรณ์กีฬาระดับโลก — การอัปเกรดระบบวางแผนทรัพยากรที่ผิดพลาดทำให้คาดการณ์สินค้าเพี้ยน สต็อกสินค้าผิดปกติ และมูลค่าหุ้นดิ่งลงราว 20% ผู้ผลิตรถยนต์สัญชาติอเมริกัน — ความทะเยอทะยานเรื่องการกลายเป็นบริษัทเทคโนโลยีที่กว้างเกินกว่ากำลังการบูรณาการจริง จบลงด้วยการยกเลิกแผนการลงทุนมูลค่ามหาศาล สามเคสนี้ต่างกันในรายละเอียด แต่เหมือนกันที่จุดตาย: ความซับซ้อนของการบูรณาการถูกประเมินต่ำเกินไป และ "คน" ที่ต้องใช้ระบบไม่ได้เดินทางไปพร้อมกับระบบ — สอดคล้องกับข้อมูล McKinsey ที่ระบุว่าการสูญเสียคุณค่ามากที่สุด 35% เกิดในช่วงบูรณาการ มากกว่าช่วงตั้งเป้า (22%) และช่วงวางแผน (23%) รวมกันแล้วยังแพ้ เคสไทย: วัฒนธรรม "ช็อปเทคโนโลยี" ที่ต้องเปลี่ยน 4 สาเหตุหลักที่ทำให้การทำ Digital Transformation ของโรงงานไทยล้มเหลว (ที่มา: การวิเคราะห์จากงานวิจัย McKinsey & Company) การวิเคราะห์บริบทไทยที่ตีพิมพ์ในสื่ออุตสาหกรรมการผลิตชี้ประเด็นที่คนในวงการคุ้นเคยดี — ผู้ประกอบการจำนวนมากเลือกซื้อเทคโนโลยี "ตามงานแสดงสินค้า" สนใจอันไหนก็คุย ก็ซื้อ โดยยังไม่ได้วิเคราะห์ว่าโรงงานตัวเองต้องการอะไรจริง ซึ่งสะท้อนสาเหตุอันดับหนึ่งของ McKinsey: การตั้งเป้าและคาดหวังที่ไม่อยู่บนพื้นฐานความเป็นจริง ทั้งการตั้งเป้าต่ำเกินไปจนไม่คุ้มลงทุน หรือสูงเกินกว่าข้อมูลภายในจะสนับสนุนได้ ที่น่าสนใจคือฝั่งตรงข้าม — เมื่อโครงการตั้งต้นจากข้อมูล ผลลัพธ์ต่างอย่างสิ้นเชิง ที่ปรึกษาด้าน Digital Transformation ในไทยเล่าเคสโรงงานที่นำ Digital Twin มาสร้างแบบจำลองกระบวนการผลิตก่อนปรับไลน์จริง ผลคือ ความผิดพลาดจาก Human Error ลดลงราว 40% และ Lead Time ลดลงราว 15% — ตัวเลขชุดนี้ไม่ได้มาจากเทคโนโลยีล้ำ แต่มาจากการ "เห็นก่อนทำ" บนฐานข้อมูลที่โปร่งใส เส้นทางออกจากวงจรล้มเหลว: จากการช็อปเทคโนโลยี สู่ยุทธศาสตร์ที่ตั้งอยู่บนข้อมูลของโรงงานตัวเอง มุมมองของ Honey Corporation จากประสบการณ์ทำงานกับโรงงานอุตสาหกรรมในไทย เราเชื่อว่าปัญหา "ช็อปก่อนคิด" ไม่ใช่ความผิดของผู้ประกอบการ — เพราะสิ่งที่ขาดหายไปคือ ข้อมูลพื้นฐานที่ทำให้ตัดสินใจได้ว่าควรเริ่มจากจุดไหน โรงงานที่ยังไม่มีข้อมูลการหยุดเครื่องแบบเป็นระบบ ย่อมประเมินผลตอบแทนของโครงการใดๆ ไม่ได้ ดังนั้นก้าวแรกที่ถูกที่สุดและเสี่ยงน้อยที่สุดมักไม่ใช่ระบบใหญ่ แต่คือการติดตั้งจุดวัดข้อมูลพื้นฐาน…
Read More
บทวิเคราะห์: 1.9 ล้านตำแหน่งที่ไม่มีคนสมัคร — เมื่อ XR Reskilling กลายเป็นกลยุทธ์การผลิต ไม่ใช่งานของ HR

บทวิเคราะห์: 1.9 ล้านตำแหน่งที่ไม่มีคนสมัคร — เมื่อ XR Reskilling กลายเป็นกลยุทธ์การผลิต ไม่ใช่งานของ HR

Article
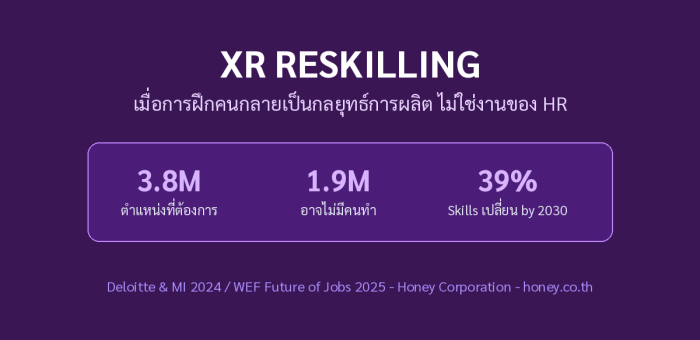
ตัวเลขที่ผู้บริหารโรงงานควรอ่านสักครั้ง: งานวิจัยล่าสุดของ Deloitte ร่วมกับ The Manufacturing Institute (ปี 2024) ประมาณการว่าอุตสาหกรรมการผลิตสหรัฐฯ ต้องการแรงงานใหม่ถึง 3.8 ล้านตำแหน่ง ระหว่างปี 2024-2033 และราวครึ่งหนึ่ง — 1.9 ล้านตำแหน่ง — อาจไม่มีคนสมัคร เลย หากปัญหา Skills Gap และ Applicant Gap ยังไม่ถูกแก้ ช่องว่างแรงงานภาคการผลิตสหรัฐฯ ปี 2024-2033 จาก Deloitte & The Manufacturing Institute 2024 เชื่อมกับตัวเลข 39% ของ Core Skills ที่จะเปลี่ยนภายในปี 2030 จาก WEF ประเด็นสำคัญคืองานวิจัยชิ้นนี้ชี้ว่าปัญหาไม่ได้มีแค่ 'ทักษะไม่ตรง' แต่มี ช่องว่างของจำนวนผู้สมัครเองด้วย (Applicant Gap) — คือไม่มีคนเข้ามาสมัครให้เรียนรู้ทักษะตั้งแต่แรก สาเหตุหลัก: ทักษะที่ต้องการเปลี่ยนเร็วเพราะเทคโนโลยีใหม่ และช่างเทคนิคอาวุโสกำลังเกษียณพร้อมกันเป็นระลอก เกณฑ์นี้ไม่ได้จำกัดอยู่ที่อเมริกา — โรงงานไทยที่กำลังเดินหน้าสู่ Smart Factory เจอแรงกดดันแบบเดียวกัน ในสังคมที่เข้าสู่สังคมสูงวัยเร็วที่สุดในภูมิภาค ขณะที่ WEF Future of Jobs Report 2025 (สำรวจนายจ้างกว่า 1,000 แห่งใน 55 ประเทศ) คาดการณ์ว่า 39% ของ Core Skills จะเปลี่ยนไปภายในปี 2030 ข้อสรุปจึงชัดเจน: การ Reskilling ไม่ใช่โครงการพิเศษปีละครั้ง แต่คือความสามารถหลักของโรงงาน เฉกเช่นเดียวกับความสามารถในการผลิต ทำไมเครื่องมือฝึกอบรมแบบเดิมตามไม่ทัน มิติห้องเรียนสดE-LearningXR (AR/VR/MR)เวลาถึงความชำนาญช้า (ต้องรอตาราง ผู้สอน)ปานกลาง แต่ถ่ายทอดทักษะมือไม่ได้เร็ว — ฝึกมือได้ซ้ำๆ ไม่จำกัดรอบสถานการณ์อันตรายจำลองได้จำกัด มีความเสี่ยงดูวิดีโอเท่านั้นฝึกได้โดยไม่เสี่ยงตัวจริงการส่งต่อความรู้ช่างอาวุโสขึ้นกับตัวบุคคล เก็บไว้ไม่ได้บันทึกเป็นคลิปได้ แต่ไม่มี Interactiveแปลงเป็นสถานการณ์ฝึกที่ใช้ซ้ำได้ทุกรุ่นการวัดผลสอบข้อเขียน ประเมินกลางๆCompletion Rate เท่านั้นทุก Action เป็นข้อมูล (xAPI) วัดได้จริง เศรษฐศาสตร์ของ XR Reskilling — เลิกคิดว่าแพง จุดคุ้มทุน VR Training จากโมเดลต้นทุนของ PwC: 375 คนเทียบห้องเรียนสด, 1,950 คนเทียบ E-Learning และถูกกว่า 52% ที่ 3,000…
Read More
บทวิเคราะห์: Carbon Digital Twin — เมื่อ CBAM ปี 2026 บังคับให้โรงงานไทยรู้ตัวเลข Emission จริงของทุกชิ้นส่วน

บทวิเคราะห์: Carbon Digital Twin — เมื่อ CBAM ปี 2026 บังคับให้โรงงานไทยรู้ตัวเลข Emission จริงของทุกชิ้นส่วน

Article
ตั้งแต่ 1 มกราคม 2026 มาตรการ CBAM (Carbon Border Adjustment Mechanism) ของสหภาพยุโรปเข้าสู่ช่วง Definitive Period — ผู้นำเข้าสินค้ากลุ่มเหล็ก อะลูมิเนียม ซีเมนต์ ปุ๋ย ไฮโดรเจน และไฟฟ้าใน EU ต้องรายงาน embedded emissions (คาร์บอนที่ฝังอยู่ในสินค้า) และซื้อ CBAM certificate ตามปริมาณคาร์บอนของสินค้าที่นำเข้าทุกปี (ที่มา: กรมศุลกากรไทย, PIER) สำหรับผู้ส่งออกไทย ข้อความนี้แปลเป็นภาษาธุรกิจได้ง่ายๆ: ลูกค้าใน EU จะถามหาตัวเลข emission ระดับสินค้า (product-level) จากโรงงานคุณ — และถ้าคุณตอบไม่ได้ เขาจะใช้ default value ของ EU ซึ่งตั้งอย่างอนุรักษ์นิยม มักสูงกว่าค่าจริงของโรงงานที่บริหารพลังงานดี แปลว่าคุณจ่ายคาร์บอนแพงกว่าที่ควรจ่าย โดยไม่มีสิทธิ์แก้ตัว ทำไม "คาร์บอน" กลายเป็นโจทย์วิศวกรรม ไม่ใช่แค่งานเอกสาร ตัวเลข embedded emissions ที่ EU ต้องการไม่ใช่ค่าเฉลี่ยขององค์กร แต่คือ คาร์บอนต่อหน่วยผลิตภัณฑ์ ที่คำนวณจาก mass balance และ energy balance ของกระบวนการผลิตจริง — พลังงานไฟฟ้าที่ใช้, เชื้อเพลิงที่เผา, วัตถุดิบที่ซื้อเข้า (precursor) ทั้งหมดต้องถูกตรึงกับตัวเลข production จริง นี่คืองานที่ spreadsheet รายเดือนทำได้ยาก เพราะข้อมูลกระจัดกระจายใน metering, SCADA, MES และใบสั่งซื้อ จุดนี้เองที่ทำให้ Digital Twin เชิงคาร์บอน (Carbon Twin) กลายเป็นคำตอบที่ผู้ส่งออกทั่วโลกหันมาพูดถึงกันมากขึ้นในปี 2026 Carbon Twin ทำงานอย่างไร หลักการคือสร้างแบบจำลองที่ผูก กระแสวัสดุ (mass flow) เข้ากับ กระแสพลังงาน (energy flow) ของโรงงานแบบ real-time แล้วคำนวณคาร์บอนตาม emission factor ที่ตรวจสอบย้อนกลับได้: ภาพที่ 1: สถาปัตยกรรม Carbon Twin — ข้อมูล meter, SCADA และ MES ไหลเข้าโมเดล mass-energy balance เพื่อคำนวณ emission ระดับสินค้าและออกรายงาน CBAM/ESG…
Read More
How-to: สร้าง Asset-Level Digital Twin ของเครื่องจักรเดี่ยวใน 6 ขั้นตอน — จาก P&ID สู่โมเดลที่ทำนายได้

How-to: สร้าง Asset-Level Digital Twin ของเครื่องจักรเดี่ยวใน 6 ขั้นตอน — จาก P&ID สู่โมเดลที่ทำนายได้

Article
หลายโรงงานอยากมี Digital Twin แต่เริ่มไม่ถูก — พยายามจำลอง "ทั้งโรงงาน" ตั้งแต่วันแรก แล้วโครงการก็จบก่อนเริ่ม ความจริงคือ Digital Twin ที่สร้างคุณค่าได้จริงส่วนใหญ่เริ่มจากหน่วยที่เล็กที่สุดที่มีความหมายทางธุรกิจ: เครื่องจักรเดี่ยว (Asset-Level Digital Twin) — ปั๊มไฮโดรลิก คอมเพรสเซอร์ ตู้อบ หรือหุ่นยนต์เชื่อม ที่เมื่อหยุดแล้วสายการผลิตหยุดตาม บทความนี้คือคู่มือทีละขั้นตอนสำหรับวิศวกรและผู้จัดการโรงงาน ที่จะพาคุณสร้าง asset twin ตัวแรกให้สำเร็จภายใน 3-6 เดือน โดยไม่ต้องซื้ออะไรเกินจำเป็น ขั้นที่ 1: เลือก Asset ที่ "เจ็บที่สุด" — ไม่ใช่ที่ทันสมัยที่สุด เกณฑ์การเลือกควรใช้ criticality ไม่ใช่ความใหม่ของเครื่องจักร ใช้ผล FMEA (Failure Mode and Effects Analysis) หรือประวัติการเสียจริง 12 เดือนหลังสุด ถาม 3 คำถาม: (1) เครื่องนี้หยุดแล้วกระทบการผลิตมากแค่ไหน (2) อะไหล่หายากแค่ไหน (3) มี sensor ติดอยู่แล้วกี่จุด — เครื่องที่คะแนนสูงสุดคือตัวเริ่มที่ถูกต้อง ขั้นที่ 2: เก็บ "ข้อมูลฐาน" ให้ครบก่อนเขียนโค้ดแม้บรรทัดเดียว Asset twin ที่ดีต้องการข้อมูล 4 ชั้น ซึ่งมักกระจายอยู่ในหลายแผนก: ชั้นข้อมูล ตัวอย่าง แหล่งที่มา Geometryแบบ 3D CAD, P&ID, ผังการเดินสายแผนกวิศวกรรม, ผู้ผลิตเครื่อง Behaviorสมการ dynamics, กราฟประสิทธิภาพ, ค่าคงที่ตัวเครื่องDatasheet, คู่มือเครื่อง, ผลทดสอบ acceptance Telemetryค่า vibration, อุณหภูมิ, กระแสมอเตอร์, แรงดันPLC/SCADA ผ่าน OPC UA หรือ MQTT Knowledgeประวัติซ่อม, บันทึกช่าง, คู่มือ PMCMMS, logbook หน้างาน ภาพที่ 1: Asset-Level Digital Twin ประกอบด้วยข้อมูล 4 ชั้น — Geometry, Behavior, Telemetry และ Knowledge (ที่มา: Honey Corporation) ขั้นที่ 3: เชื่อมข้อมูลจริงเข้าโมเดล — อย่าคัดลอกมาเก็บใน…
Read More
Virtual Commissioning ด้วย Digital Twin: ทดสอบทั้งไลน์ผลิตในโลกเสมือนก่อนสั่งไฟเครื่องจริง

Virtual Commissioning ด้วย Digital Twin: ทดสอบทั้งไลน์ผลิตในโลกเสมือนก่อนสั่งไฟเครื่องจริง

Article
ในโครงการอัตโนมัติทั่วไป ช่วง Commissioning หรือการติดตั้งและทดสอบระบบก่อนส่งมอบ มักกินเวลาถึง 20-30% ของ timeline ทั้งโครงการ และเป็นช่วงที่ปัญหาทุกประเภทพร้อมโผล่พร้อมกัน — logic PLC ผิด, I/O map ไม่ตรง, ทางกลไกชนกัน, สัญญาณ sensor กลับด้าน ทั้งที่เครื่องจักรจริงหยุดรออยู่และทีม production กดดันให้เร็วขึ้นทุกวัน Virtual Commissioning (VC) คือแนวทางที่ย้ายการทดสอบทั้งหมดนั้นไปทำใน "โลกเสมือน" ก่อน — ด้วยการเชื่อม Digital Twin ของเครื่องจักรและสายการผลิต (ทั้งแบบจำลองเชิงกลไก 3D และ physics-based simulation) เข้ากับ โปรแกรมควบคุมจริง (PLC/DCS code) แล้วรันสถานการณ์ทดสอบทั้งหมดก่อนที่อุปกรณ์ชิ้นแรกจะถูกขนถึงหน้างาน หลักการสำคัญ: ยิ่งเจอ error เร็ว ต้นทุนยิ่งถูก แนวคิด "Cost of Change" ในวิศวกรรมระบบอ้างกันมานานว่า ต้นทุนการแก้ไขข้อผิดพลาดเพิ่มขึ้นราว 10 เท่าทุกครั้งที่ข้ามหนึ่งขั้นของโครงการ — แก้ logic ผิดตอนเขียนโปรแกรมอาจใช้เวลาไม่กี่ชั่วโมง แต่ error ตัวเดียวกันที่หลุดไปถึงช่วง commissioning ต้องหยุดเครื่อง รอวิศวกร แก้ code ทดสอบใหม่ และอาจทำให้กำหนดส่งมอบเลื่อนเป็นสัปดาห์ VC ทำงานบนหลักการนี้โดยตรง: ดันการทดสอบให้เกิด "ซ้าย" ของ timeline ให้มากที่สุด ภาพที่ 1: Workflow ของ Virtual Commissioning — สร้างโมเดลเสมือน เชื่อม PLC จริง ทดสอบใน simulation แล้วจึงลง hardware จริง (ที่มา: Honey Corporation) ระดับความสมบูรณ์ของการทดสอบ: จาก MIL ถึง HIL VC ไม่ใช่ all-or-nothing อุตสาหกรรมแบ่งระดับการทดสอบเป็นขั้นบันได โดยแต่ละขั้นให้ความสมจริงและความเชื่อมั่นต่างกัน: ระดับ สิ่งที่ถูกทดสอบ ความสมจริง เหมาะกับ MIL (Model-in-the-Loop)Logic ควบคุมในรูปแบบโมเดล ทดสอบกับ plant modelต่ำ-กลางเช็ค concept และ algorithm ตั้งแต่เฟส design SIL (Software-in-the-Loop)PLC code จริง (soft PLC) รันบน…
Read More
6 เทรนด์การผลิตปี 2026 จาก Forbes: AI Agents โต 4 เท่า และ Smart Materials แตะ 133,000 ล้านดอลลาร์ — โรงงานไทยควรเริ่มจากตรงไหน

6 เทรนด์การผลิตปี 2026 จาก Forbes: AI Agents โต 4 เท่า และ Smart Materials แตะ 133,000 ล้านดอลลาร์ — โรงงานไทยควรเริ่มจากตรงไหน

Article
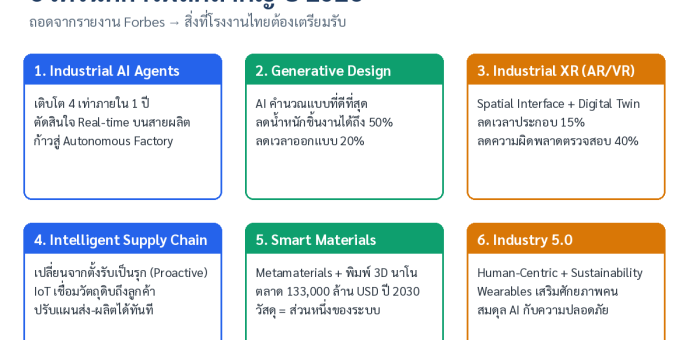
ต้นปี 2026 รายงานเทรนด์การผลิตจากสำนักข่ายการเงินระดับโลก (Forbes) ได้สรุป 6 แรงขับเคลื่อนสำคัญของโรงงานทั่วโลกไว้อย่างชัดเจน จุดร่วมของทั้ง 6 ข้อไม่ใช่ "AI ทำอะไรได้อีกบ้าง" แต่คือการทำให้ คนและเครื่องจักรทำงานร่วมกันได้จริงในทางปฏิบัติ — ซึ่งเป็นคำถามเดียวกันที่โรงงานไทยกำลังเผชิญในยุคต้นทุนและการแข่งขันที่เข้มข้นขึ้นทุกไตรมาส ภาพรวม 6 เทรนด์การผลิตสำคัญปี 2026 พร้อมตัวเลขสำคัญจากรายงาน Forbes (ถอดความโดย ManuTalkThai) ตารางสรุป: 6 เทรนด์ ตัวเลข และระดับความพร้อมที่โรงงานไทยควรประเมิน เทรนด์ ตัวเลขสำคัญจากรายงาน สิ่งที่โรงงานไทยต้องมีก่อน 1. Industrial AI Agentsการใช้งานโต ~4 เท่าภายใน 1 ปีข้อมูลหน้างานที่เข้าถึงได้แบบ Real-time (เชื่อมต่อเครื่องจักรก่อน) 2. Generative Designลดน้ำหนักชิ้นงานได้ถึง 50% และลดเวลาออกแบบ 20%คลังแบบ 3 มิติ + เงื่อนไขวัสดุ/กระบวนการผลิตที่ถูก digitalize 3. Industrial XR (AR/VR)ลดเวลาประกอบ 15% และลดความผิดพลาดการตรวจสอบ 40% ในอุตสาหกรรมการบินDigital Work Instructions + Digital Twin ระดับสินทรัพย์ 4. Intelligent Supply Chainเปลี่ยนจากตั้งรับเป็นรุก (Proactive)การมองเห็นข้อมูล End-to-End ผ่าน IoT และ Track & Trace 5. Smart Materialsตลาดโตถึง ~133,000 ล้านดอลลาร์ในปี 2030ความเข้าใจกระบวนการผลิตสมรรถนะสูง เช่น การพิมพ์ 3 มิติ 6. Industry 5.0Human-Centric + Sustainability เป็นแกนกลยุทธ์การออกแบบงานที่ให้เทคโนโลยีเสริมคน ไม่ใช่แทนที่ เจาะ 2 เทรนด์ที่กระทบโรงงานไทยเร็วที่สุด Industrial AI Agents — จาก Dashboard สู่ผู้ลงมือ จุดเปลี่ยนของปี 2026 คือ AI เปลี่ยนบทบาทจาก "ผู้ช่วยวิเคราะห์" เป็น "เอเจนต์" ที่ลงมือทำงานได้เอง ตั้งแต่วางแผนการผลิต สั่งซื้อวัตถุดิบ ไปจนถึงแก้คอขวดบนสายการผลิตโดยแทบไม่ต้องรอคำสั่งมนุษย์ รายงานคาดการณ์ว่าการใช้ระบบเอเจนต์ในโรงงานจะเติบโตถึง 4 เท่าภายในหนึ่งปี มุ่งสู่เป้าหมาย Autonomous Smart Factory อย่างไรก็ตาม เอเจนต์จะทำงานได้ ต้องอาศัย "เชื้อเพลิง" คือข้อมูลหน้างานที่ถูกเก็บอย่างเป็นระบบ…
Read More
Spatial Anchoring และ Persistent AR: ทำไมคำสั่งงาน AR ที่ ‘ลอย’ ไม่ยังตรงที่เดิม คือปัญหาที่แก้ได้ด้วยวิศวกรรม ไม่ใช่เวทมนตร์

Spatial Anchoring และ Persistent AR: ทำไมคำสั่งงาน AR ที่ ‘ลอย’ ไม่ยังตรงที่เดิม คือปัญหาที่แก้ได้ด้วยวิศวกรรม ไม่ใช่เวทมนตร์

Article
ทีมวิศวกรหลายทีมที่ทดลองใช้ AR ในโรงงานเจอปัญหาเดียวกันเกือบทุกครั้ง — Demo วันแรกเป็นไปได้ด้วยดี แว่น AR ชี้ให้เห็นคำอธิบายใต้ฝาครอบเกียร์ลดความเร็วพอดีตำแหน่ง แต่พอช่างเทคนิคกลับมาทำงานจริงในสัปดาห์ถัดมา ข้อความเดิมกลับลอยเหนือพื้นโรงงาน หรือไปเกาะอยู่กับราวกันสั่นข้างเคียง ปัญหานี้ไม่ใช่ความล้มเหลวของ AR แต่เป็นการออกแบบระบบ Spatial Anchoring ที่ยังไม่ครบ บทความนี้เจาะลึกกลไกการตรึงตำแหน่งเสมือนให้ติดกับโลกกายภาพอย่างถาวร ตั้งแต่หลักการทางคณิตศาสตร์ ไปจนถึงแนวปฏิบัติที่ทีมงาน Honey Corporation ใช้เวลาติดตั้งระบบ AR คู่กับ Digital Twin ในโรงงานจริง ปัญหาเบื้องหลังคำว่า "คำสั่งงานลอยไม่ตรงที่" อุปกรณ์ AR ทุกเครื่องต้องตอบคำถามเดียวกันตลอดเวลา: ตำแหน่งและมุมมองของฉันเทียบกับโลกจริงตอนนี้คืออะไร คำถามนี้ตอบด้วยกระบวนการ Tracking ซึ่งมีข้อจำกัดทางกายภาพสามข้อ Drift เชิงสะสม — การประมาณการเคลื่อนที่จากเซ็นเซอร์ IMU (Inertial Measurement Unit) มีค่าคลาดเคลื่อนเล็กน้อยทุกวินาที หลังเดิน 10 นาทีในโรงงาน ความคลาดเคลื่อนสะสมอาจถึงหลายสิบเซนติเมตร การสูญเสีย Tracking — เมื่อคนงานเดินผ่านมุมอับสัญญาณหรือห้องที่ผนังเรียบไม่มีจุดอ้างอิง ระบบจะ "หลง" ชั่วคราว และเมื่อกลับมาจับได้ใหม่ ตำแหน่งเดิมอาจเพี้ยน สภาพแสงที่เปลี่ยน — โรงงานกลางวันกับกลางคืน หรือฝุ่นในอากาศ ทำให้จุดอ้างอิงภาพ (Feature Points) ที่กล้องมองเห็นต่างกันโดยสิ้นเชิง ภาพที่ 1: แนวทางการปัก Anchor หลักสามแบบ — แต่ละแบบมีพิสัยความแม่นยำและเงื่อนไขการใช้งานต่างกัน (ที่มา: Honey Corporation) สามแนวทางหลักในการปัก Anchor การเลือกเทคนิค Anchoring คือการชั่งน้ำหนักระหว่างความแม่นยำ ความทนทานต่อการเปลี่ยนแปลงสภาพแวดล้อม และต้นทุนการเตรียมหน้างาน ตารางนี้สรุปข้อตกลงหลักของแต่ละแนวทาง เทคนิค ความแม่นยำทั่วไป ต้องเตรียมอะไร ทน Layout เปลี่ยน เหมาะกับงาน Marker-basedประมาณ ±2–5 มม.ติดป้ายลายเฉพาะบนเครื่องจักรต่ำ (ย้ายป้าย = ต้องทำใหม่)จุดเช็คเฉพาะ เครื่องเดิมซ้ำๆ Markerless SLAMประมาณ ±1–3 ซม.สแกนพื้นที่ครั้งแรก (Depth Camera)ปานกลางพื้นที่กว้าง เดินสำรวจอิสระ Cloud Anchorขึ้นกับผู้ให้บริการ (ซม.ระดับ)เครือข่าย + การเชื่อมต่อบริการปานกลาง–สูงทีมหลายคนแชร์พิกัดร่วม Marker-based: แม่นที่สุด แต่เปราะที่สุด ป้ายลายเฉพาะ (Fiducial Marker) คือ "บัตรประชาชน" ของเครื่องจักรในโลก AR กล้องจับมุมและขนาดของป้าย แล้วคำนวณตำแหน่ง 6 องศาอิสระ (6-DoF) ได้ทันทีโดยไม่ต้องพึ่งพื้นที่รอบข้าง จุดอ่อนคือความเปราะ —…
Read More
Hardware-in-the-Loop (HIL): ทดสอบ PLC ของจริงบนโรงงานเสมือน ก่อนถึงวันเดินเครื่องจริง

Hardware-in-the-Loop (HIL): ทดสอบ PLC ของจริงบนโรงงานเสมือน ก่อนถึงวันเดินเครื่องจริง

Article
ทำไมสายการผลิตใหม่ถึงพังตอนเดินเครื่องครั้งแรก — ทั้งที่ PLC ผ่านการทดสอบมาแล้ว? คำถามนี้เราได้ยินจากหัวหน้าโรงงานหลายท่าน ทุกครั้งที่มีการติดตั้งสายการผลิตใหม่หรือทำ Major Upgrade ระบบควบคุม ทีม Automation ทดสอบ PLC Logic บน Desktop Simulation จนผ่านทุก Case แต่พอถึงวันเดินจริง ปัญหาก็ยังมาถึง: Sensor ที่ต่อสลับขั้ว, Noise บนสาย Analog, ค่า Scaling ผิด, หรือ Interlock ที่ทำงานตอนที่ไม่ควรทำงาน สาเหตุอยู่ที่ "ช่องว่าง" ระหว่างโลกจำลองกับโลกจริง Desktop Simulation ทดสอบแค่ Logic ภายในตัว PLC เท่านั้น แต่ไม่ได้ทดสอบ ตัวฮาร์ดแวร์จริงร่วมกับ พฤติกรรมจริงของเครื่องจักรพร้อมกัน วิธีแก้ที่อุตสาหกรรมยุโรปและอเมริกาใช้มานานกว่า 20 ปีคือ Hardware-in-the-Loop (HIL) Simulation — และตอนนี้กำลังกลายเป็นมาตรฐานใหม่ของการทำ Virtual Commissioning ในโรงงานเอเชียด้วยเช่นกัน HIL คืออะไร: เอาของจริงมาต่อกับโรงงานเสมือน หัวใจของ HIL นั้นเรียบง่าย: เอา ตัวควบคุมจริง (PLC, VFD, Motion Controller) มาวางบนโต๊ะทดสอบ แล้วต่อเข้ากับ Real-Time Simulator ที่รันโมเดลคณิตศาสตร์ของเครื่องจักรและกระบวนการผลิตทั้งสาย ตัว Simulator จะปลอมตัวเป็น "โรงงานเสมือน" ที่ส่งสัญญาณ Sensor กลับมาที่ PLC ผ่านทาง I/O จริง ทั้ง Analog 4–20 mA, Digital 24VDC, และโปรโตคอล Industrial Ethernet ตัวควบคุมจริง (PLC) คือองค์ประกอบ "Hardware" ใน Hardware-in-the-Loop — ภาพ: Wikimedia Commons สิ่งที่เกิดขึ้นคือ Closed Loop ที่สมบูรณ์: PLC สั่งปิดวาล์ว → Simulator คำนวณการไหลและแรงดันตาม Physics แล้วส่งค่า Sensor ใหม่กลับมา → PLC เห็นค่าเปลี่ยนแล้วตัดสินใจต่อ ทุกอย่างเกิดขึ้นแบบ Real-Time ในหน่วยมิลลิวินาที เหมือนเครื่องจักรจริงนั่นอยู่ตรงหน้า สถาปัตยกรรม 3 ส่วนของระบบ HIL องค์ประกอบ หน้าที่…
Read More
Case Study: โรงงานปุ๋ยทีม Operator ใหม่ทั้งหมด ทำไม Startup ครั้งแรกถึงราบรื่น — ด้วย Operator Training Simulator

Case Study: โรงงานปุ๋ยทีม Operator ใหม่ทั้งหมด ทำไม Startup ครั้งแรกถึงราบรื่น — ด้วย Operator Training Simulator

Article
Case Study: โรงงานปุ๋ยแห่งใหม่ พนักงานเฉลี่ยอายุงาน 2 ปี — แล้ว Startup ครั้งแรกทำไมถึงสวยกว่าโรงงานเก่า? โรงงานปุ๋ยแห่งหนึ่งในเอเชียตะวันออกเฉียงใต้เพิ่งเริ่มเดินเครื่องจริงเมื่อไม่นานมานี้ สิ่งที่น่าสนใจคือทีม Operator ของพวกเขาเป็นทีม "หน้าใหม่" เกือบทั้งหมด — ประสบการณ์เฉลี่ยต่ำกว่าโรงงานทั่วไปอย่างเห็นได้ชัด เพราะโรงงานเพิ่งก่อตั้งและไม่มีทีมสืบทอดประสบการณ์จากรุ่นพี่ แต่ผลการเดินเครื่องครั้งแรกกลับราบรื่นกว่าที่คาด ความลับไม่ใช่เรื่องบุคลากรโชคดี แต่คือการตัดสินใจของฝ่ายบริหารที่ลงทุนกับสิ่งที่หลายโรงงานมองข้าม: Operator Training Simulator (OTS) หรือระบบจำลองโรงงานเพื่อการฝึกอบรม — ซึ่งเป็นอีกหน้าหนึ่งของ Digital Twin ที่คนมักลืม อุตสาหกรรม Process เช่น ปิโตรเคมีและปุ๋ยเคมี คือกลุ่มแรกๆ ที่ยอมรับ OTS — ภาพ: Wikimedia Commons โจทย์: เมื่อความรู้ของคนหายไปพร้อมกับคนรุ่นเก่า สถิติที่อุตสาหกรรมกระบวนการผลิต (Process Industry) ยอมรับกันคือ อุบัติเหตุราว 90–95% ของโรงงานมนุษย์เป็นสาเหตุ (ข้อมูลจากผู้ให้บริการ OTS ระดับโลกที่ติดตั้งไปแล้วมากกว่า 200 ระบบ) ปัจจัยทางมนุษย์ไม่ได้หมายถึงแค่ความประมาท แต่รวมถึงขาดประสบการณ์เผชิญสถานการณ์ผิดปกติ ไม่เคยเห็น Process Runaway ด้วยตาตัวเอง และไม่รู้ว่า Alarm ตัวไหน "ปกติ" ตัวไหน "ฉุกเฉิน" โรงงานใหม่ต้องเผชิญปัญหาซ้ำสอง: ไม่มีรุ่นพี่ถ่ายทอดประสบการณ์ และไม่มีข้อมูล Upset จริงจากเครื่องจักรของตัวเองให้เรียนรู้ การฝึกแบบ On-the-Job บนโรงงานที่เพิ่งเดินเครื่องจึงเป็นการเสี่ยงสองตลบ — ทั้งเสี่ยงต่อคนและเสี่ยงต่อเครื่องจักรมูลค่าหลายร้อยล้าน ทางแก้: โรงงานเสมือนที่ผิดพลาดได้ 100 ครั้งโดยไม่มีใครบาดเจ็บ OTS ที่ดีไม่ใช่แค่หน้าจอจำลอง HMI แต่ประกอบด้วย 3 ส่วนที่ต้องทำงานร่วมกัน: Dynamic Process Model — โมเดล Thermodynamic และ Fluid Flow จาก First Principles ที่ตอบสนองเหมือนโรงงานจริง เมื่อ Operator เปิดวาล์วเพิ่ม ค่าน้ำหนักก้อนเปลี่ยน อุณหภูมิขึ้น แรงดันตาม ด้วย Lag และ Cascade Effect เหมือนของจริง (โมเดลระดับสูงในตลาดทำได้ใกล้เคียงข้อมูลจริงภายใน ±2%) DCS/SIS Emulation — หน้าจอและ Logic เหมือนระบบควบคุมที่ใช้จริง ทำให้กล้ามเนื้อความจำ (Muscle Memory) ของ Operator ทำงานเหมือนนั่งอยู่หน้า Console จริง…
Read More
Agent-Based Simulation และ Knowledge Graph: เมื่อ Digital Twin เลิกรอคำสั่ง แล้วให้ทุกเครื่องจักรคิดเอง

Agent-Based Simulation และ Knowledge Graph: เมื่อ Digital Twin เลิกรอคำสั่ง แล้วให้ทุกเครื่องจักรคิดเอง

Article
เมื่อ Digital Twin เลิกเป็น "หุ่นยนต์เดินตามคำสั่ง": ทำไม Simulation ยุคใหม่ต้องให้ทุกเครื่องจักร "คิดเอง" ถ้าถามว่า Digital Twin คืออะไร คำตอบส่วนใหญ่คือ "โมเดลจำลองโรงงานที่ซิงก์ข้อมูล Real-Time" คำตอบนั้นถูกต้อง — แต่ไม่เพียงพออีกต่อไปแล้ว ปัญหาของ Twin แบบดั้งเดิมคือมันเป็น โมเดลเดี่ยวที่ต้องรอคนสั่ง: อยากรู้ว่าถ้าเพิ่มความเร็วคอนเวเยอร์ 15% จะเกิดอะไรขึ้น ต้องมีวิศวกรมานั่งตั้งค่า รัน What-If แล้วรอผล แนวโน้มใหม่ที่งานวิจัยระดับโลกกำลังพิสูจน์คือการผสาน Agent-Based Simulation (ABS) เข้ากับ Digital Twin — แทนที่จะสร้างโมเดลใหญ่หนึ่งเดียวที่คำนวณทุกอย่างพร้อมกัน ให้แต่ละองค์ประกอบในโรงงาน (เครื่องจักร, AGV, คนงาน, คลังสินค้า) กลายเป็น "เอเจนต์" ที่มีกฎการตัดสินใจของตัวเอง แล้วปล่อยให้พวกมันโต้ตอบกันเอง เหมือนโรงงานจริงที่ไม่มีใครสั่งการทุกจุด ระบบผลิตที่ซับซ้อน มีพฤติกรรม "อุบัติเหตุ" ที่ไม่มีสมการใดพรรณนาได้ — ภาพ: Wikimedia Commons สิ่งที่สมการเดี่ยวทำไม่ได้: Emergent Behavior จุดขายที่แท้จริงของ Agent-Based Simulation คือการจับ Emergent Behavior — พฤติกรรมที่เกิดขึ้นจากการโต้ตอบของส่วนย่อยจำนวนมาก แต่ไม่สามารถคาดเดาได้จากการดูส่วนย่อยแต่ละชิ้นแยกกัน ตัวอย่างคลาสสิกในโรงงาน: Deadlock ที่คลังสินค้า — AGV 8 คันไม่มีคันไหนผิดกติกา แต่ลำดับการเข้า-ออกของทั้งระบบในวันที่ Order เยอะทำให้ติดกับแก่นกันเอง คอขวดที่เคลื่อนตำแหน่ง — Buffer หน้าเครื่องจักรเครื่องหนึ่งเต็มทุกวัน เมื่อเพิ่มกำลังเครื่องนั้น คอขวดกลับไปโผล่ที่จุดที่ไม่มีใครคาดคิด ผลกระทบลูกโซ่ของ Breakdown — เครื่องหนึ่งหยุด 30 นาที ทำไม WIP ในส่วนอื่นของโรงงานแทบไม่ขยับ แต่บางครั้งหยุดแค่ 10 นาทีกลับสร้างความปั่นป่วนทั้งกะ ปรากฏการณ์เหล่านี้เกิดจาก ความแปรปรวนทางสถิติ (Stochastic Variability) ของเวลาทำงาน เวลารอ และลำดับเหตุการณ์ — สิ่งที่ Discrete-Event Simulation แบบดั้งเดิมจำลองได้ระดับหนึ่ง แต่การเพิ่ม "ตัวตนและกฎการตัดสินใจ" ให้แต่ละเอเจนต์ทำให้โมเดลสะท้อนความจริงได้ลึกกว่า โดยเฉพาะเมื่อมีคนและระบบอัตโนมัติทำงานปนกัน หลักฐานจากงานวิจัย: โมเดล 3 ชั้น + Knowledge Graph งานวิจัยที่ตีพิมพ์ในวารสาร Scientific Reports (2025) ได้สาธิตแนวทางนี้ด้วยสถาปัตยกรรมที่น่าสนใจ: แทนที่จะปล่อยให้เอเจนต์ "คิดเองเลือกอะไรก็ได้" พวกเขาคุมโครงสร้างความรู้ด้วย Knowledge Graph…
Read More