How-to: สร้าง Line-level Digital Twin ใน 6 ขั้นตอน — จาก Data Pipeline ตาม ISA-95 สู่ What-if Simulation ที่ใช้ตัดสินใจจริง

How-to: สร้าง Line-level Digital Twin ใน 6 ขั้นตอน — จาก Data Pipeline ตาม ISA-95 สู่ What-if Simulation ที่ใช้ตัดสินใจจริง

Article
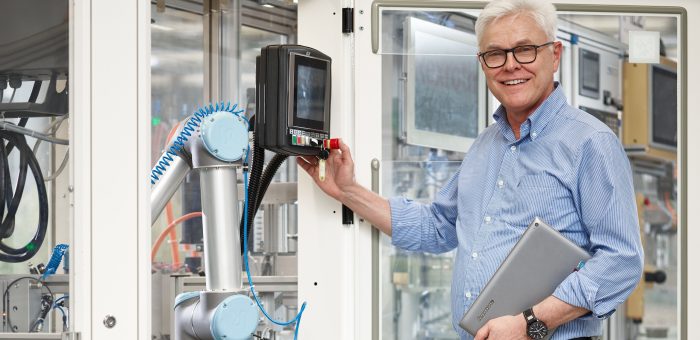
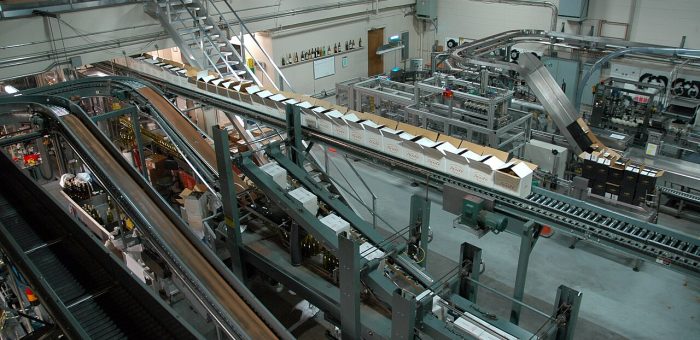
คำถามที่เราได้ยินบ่อยที่สุดในปี 2026: "โรงงานเรามีเครื่องจักรอยู่แล้ว เซ็นเซอร์ติดบ้างแล้ว จะเริ่ม Digital Twin จากตรงไหนดี" — คำตอบจากรายงานแนวโน้มอุตสาหกรรมปี 2026 หลายสำนักชี้ไปทางเดียวกัน: อย่าเริ่มจากเครื่องจักรเดี่ยว ให้เริ่มจากไลน์ผลิต (Production Line) ทั้งเส้น เพราะนั่นคือระดับที่ความล้มเหลวของ Digital Twin ส่วนใหญ่เกิดขึ้น และเป็นระดับที่ให้ผลตอบแทนชัดที่สุด บทวิเคราะห์จากสื่ออุตสาหกรรมการผลิตไทย (Manage & Manufacturing Thailand, ก.พ. 2026) สรุปภาพรวมไว้ว่า Digital Twin กำลังก้าวพ้นช่วงทดลอง (Pilot Phase) สู่การใช้งานจริงในระดับองค์กร โดยเฉพาะการผสานกับ CMMS (ระบบจัดการซ่อมบำรุง), ERP, Edge Computing และเครือข่าย 5G เพื่อลด Downtime และเพิ่มประสิทธิภาพสายการผลิตอย่างเป็นรูปธรรม ไลน์ผลิตจริงคือ "วัตถุดิบ" ของ Line-level Digital Twin — โมเดลที่ดีต้องสะท้อนทั้งจังหวะเครื่องจักร คอขวด และพฤติกรรมคนงาน (ที่มา: Tjeerd Wiersma, CC BY 2.0) ทำไมต้อง Line-level ไม่ใช่ Asset-level Digital Twin ระดับเครื่องจักรเดี่ยว (Asset Twin) เหมาะกับงานวิเคราะห์การสั่นสะเทือนหรืออายุการใช้งานแบริ่ง แต่คำถามที่แท้จริงของผู้จัดการโรงงานอยู่ในระดับที่สูงขึ้น: ถ้าเพิ่มกำลังผลิต 15% จะเกิดอะไรขึ้นกับคอขวด? ถ้าเปลี่ยนสูตรวัตถุดิบ จุดไหนของไลน์จะรับไม่ได้? คำถามเหล่านี้ตอบไม่ได้ด้วยการดูเครื่องจักรเดี่ยว — ต้องจำลอง ปฏิสัมพันธ์ระหว่างเครื่องจักรทุกตัวในไลน์รวมถึง Buffer และรอบเปลี่ยน Batch มิติ Asset Twin (เครื่องจักรเดี่ยว) Line-level Twin (ทั้งไลน์ผลิต) คำถามหลักที่ตอบได้ เครื่องนี้กำลังจะพังไหม? ควรเปลี่ยนอะไหล่เมื่อไร? เพิ่มกำลังผลิตแล้วคอขวดย้ายไปอยู่ตรงไหน? ไลน์รับสูตรใหม่ได้ไหม? ข้อมูลที่ต้องมี Vibration, Temperature, Motor Current ของเครื่องเป้าหมาย ข้อมูลทุกสถานี + อัตราการไหลชิ้นงาน + เวลา Changeover + OEE รายสถานี ผู้ใช้หลัก ทีมซ่อมบำรุง (Maintenance) ผู้จัดการผลิต + Process Engineer + ฝ่ายวางแผน ตัวอย่างการใช้งานเด่น คาดการณ์ความเสียหายแบริ่งล่วงหน้า 2-4 สัปดาห์ ทดสอบ What-if ก่อนเพิ่มกำลังผลิต /…
Read More
บทวิเคราะห์: Digital Twin กับปัญหา Model Drift — เมื่อโมเดล PdM เริ่มเพี้ยน Fleet Learning จะช่วยได้จริงหรือไม่

บทวิเคราะห์: Digital Twin กับปัญหา Model Drift — เมื่อโมเดล PdM เริ่มเพี้ยน Fleet Learning จะช่วยได้จริงหรือไม่

Article
โมเดล AI ทำนายความเสียหายของเครื่องจักร (Predictive Maintenance) ตัวหนึ่งในโรงงานสิ่งทอทำงานได้แม่นยำมากในปีแรก แต่ปีที่สองความแม่นยำเริ่มถดลง เพราะสภาพเครื่องจักรเปลี่ยน โหลดการผลิตเปลี่ยน และพฤติกรรม "ปกติ" ของเครื่องจักรเลื่อนไปจากเดิม นี่คือปัญหา Model Drift ที่ทุกโรงงานต้องเจอ และเป็นคำถามเปิดของวงการว่า Digital Twin จะช่วยแก้ได้จริงหรือไม่ บทวิเคราะห์นี้มองปัญหาจากมุมวิศวกรรม ไม่ใช่มุมการตลาด ปัญหา Model Drift ในโรงงาน: ทำไมโมเดลเก่าเร็วจนน่าใจหาย โมเดล Anomaly Detection ส่วนใหญ่เรียนรู้จากข้อมูลในอดีต แล้วตั้งสมมติฐานว่าอนาคตจะคล้ายอดีต แต่ในโรงงานจริง ไม่มีอะไรนิ่ง: ชิ้นส่วนสึกหรอ, สูตรผลิตเปลี่ยน, ผู้ปฏิบัติงานเปลี่ยนวิธีเดินเครื่อง, อุณหภูมิแวดล้อมตามฤดูกาล หรือแม้แต่การซ่อมบำรุงที่ "ปรับ" พฤติกรรมเครื่องจักรไปโดยสิ้นเชิง ผลคือเกิดการแจ้งเตือนเท็จ (False Alarm) เพิ่มขึ้นเรื่อยๆ จนทีมซ่อมบำรุงเริ่มกด "Dismiss" โดยไม่อ่าน — และวันหนึ่ง Alarm จริงก็ถูกกดไปพร้อมกับพวกเท็จ แนวทางแก้แบบดั้งเดิมคือ การเทรนซ้ำ (Retraining) ด้วยข้อมูลใหม่ แต่คำถามคือใครจะ Label ข้อมูลว่าอะไรคือ "ปกติ" ในสถานการณ์ใหม่ และต้องรอนานแค่ไหนจึงจะมีข้อมูลเพียงพอ เพราะความเสียหายจริงเกิดไม่บ่อยนัก แนวคิดใหม่: Fleet Learning ผ่าน Digital Twin แนวคิดที่กำลังได้รับความสนใจคือการใช้ Digital Twin เป็น "ผู้เรียนรู้ร่วมกัน" ของกลุ่มเครื่องจักรลักษณะเดียวกัน แทนที่จะปล่อยให้แต่ละเครื่องเรียนรู้ลำพัง: สถาปัตยกรรม Smart Factory ยุคใหม่เชื่อมทุกชั้นข้อมูลเข้าด้วยกัน — Fleet Learning เป็นการขยายแนวคิดนี้สู่กลุ่มเครื่องจักรข้ามไซต์ (ภาพ: Wikimedia Commons, CC BY 4.0) หลักการคือ เมื่อเครื่องจักร A ในไซต์ 1 เจอ Failure Mode ใหม่และถูกบันทึกไว้ใน Twin ของมัน ความรู้นั้นสามารถถ่ายทอด (Transfer) ไปยังโมเดลของเครื่องจักร B, C, D ที่อยู่คนละไซต์แต่มีลักษณะเดียวกันได้ทันที เครื่องจักรอื่นๆ จึง "รู้" ล่วงหน้าโดยไม่ต้องเจอเองก่อน นี่คือความต่างสำคัญจากการเทรนโมเดลแบบเก่าที่ต้องรอเครื่องเสียจริงทีละตัวเพื่อสะสมประสบการณ์ วิเคราะห์กลไกทางเทคนิค: Twin ช่วยแก้ Drift ได้อย่างไร กลไก วิธีการทำงาน ข้อดี ข้อจำกัดที่ต้องยอมรับ Simulation Augmentationใช้ Twin จำลองสถานการณ์ที่ยังไม่เคยเกิดจริง สร้างข้อมูล Synthetic สำหรับเทรนโมเดลได้ข้อมูล Failure…
Read More
How-to: สร้าง Digital Twin ของระบบควบคุมเครื่องจักรเก่า — ถอด Logic สู่ Behavioral Twin ใน 6 ขั้นตอน

How-to: สร้าง Digital Twin ของระบบควบคุมเครื่องจักรเก่า — ถอด Logic สู่ Behavioral Twin ใน 6 ขั้นตอน

Article
โรงงานที่มีเครื่องจักรอายุ 10–20 ปีกำลังเจอปัญหาเดียวกัน: ระบบควบคุมเก่า อะไหล่หายาก และไม่มีใครกล้าแตะ Logic ที่เขียนไว้สมัยคนละยุค — เพราะแก้แล้วไลน์อาจหยุดทั้งวัน บทความนี้คือคู่มือทีละขั้น การสร้าง Digital Twin ของระบบควบคุมเครื่องจักรเก่า เพื่อทดสอบทุกอย่างในโลกเสมือนก่อนแตะโลกจริง แม้เครื่องจักรตัวนั้นจะอายุ 15 ปีแล้วก็ตาม ทำไมต้องเป็น Twin ของ "ระบบควบคุม" ไม่ใช่แค่หน้าตาเครื่องจักร Digital Twin ของเครื่องจักรเก่ามี 2 ระดับ ระดับแรกคือ 3D Model ที่สวยงามเหมาะกับการนำเสนอ ระดับที่สองคือ Behavioral Twin ที่จำลองพฤติกรรมการควบคุมจริง: Logic การทำงาน, Sequence การเริ่มเครื่อง, Interlock, และการตอบสนองต่อคำสั่ง ระดับที่สองนี่แหละที่มีคุณค่าทางวิศวกรรม เพราะมันทำให้คุณทดลองแก้ Logic, ทดสอบ Patch ใหม่ และฝึกคน โดยไม่เสี่ยงหยุดไลน์ผลิตจริง ระบบ SCADA เก่าของโรงงานจำนวนมากยังใช้งานอยู่ แต่ Logic ที่ซ่อนอยู่ด้านหลังคือความเสี่ยงเมื่อผู้พัฒนาดั้งเดิมไม่อยู่แล้ว — Twin ช่วยถอดรหัสนี้ได้ (ภาพ: Wikimedia Commons, CC0) ภาพรวมก่อนเริ่ม: สิ่งที่ต้องมี ขั้นตอน สิ่งที่ได้ ระยะเวลาอ้างอิง* 1. ตรวจจับ Logic เดิมคลัง Logic ที่ถอดออกมาได้ครบ1–2 สัปดาห์ 2. สร้าง Behavioral Modelโมเดลจำลองพฤติกรรมเครื่องจักร2–4 สัปดาห์ 3. เชื่อมข้อมูลจริง (Soft Sensor)ข้อมูลสถานะเครื่องจักรเก่าแบบเรียลไทม์1–3 สัปดาห์ 4. Validate ด้วยข้อมูลจริงค่าความคลาดเคลื่อนของโมเดลที่ยอมรับได้ต่อเนื่อง 5. ทดลองแก้ Logic บน TwinPatch ที่ทดสอบแล้วว่าปลอดภัยตามโจทย์ 6. Deploy + ฝึกทีมทีมใหม่ที่เข้าใจเครื่องจักรเก่าต่อเนื่อง *ระยะเวลาขึ้นกับความซับซ้อนของเครื่องจักรและความสมบูรณ์ของเอกสารเดิม ขั้นที่ 1: ถอด Logic เดิมออกจากเครื่องจักร (Logic Extraction) เริ่มจากดึงโปรแกรมควบคุม (Ladder Diagram, Function Block) ออกจาก PLC เดิมให้ได้มากที่สุด ปัญหาคือหลายโรงงานสูญเสีย Source Code ต้นฉบับ เหลือแค่ไฟล์ Compile แล้ว หรือระบบเก่าจน Software สำหรับเปิดไม่รองรับ OS ปัจจุบัน แนวทางที่ใช้ได้จริง: Reverse Engineering…
Read More
Electrical Digital Twin: จำลองระบบไฟฟ้าทั้งโรงงานเพื่อวางแผนพลังงานยุคโซล่าร์+BESS อย่างเป็นระบบ

Electrical Digital Twin: จำลองระบบไฟฟ้าทั้งโรงงานเพื่อวางแผนพลังงานยุคโซล่าร์+BESS อย่างเป็นระบบ

Article
เมื่อพูดถึง Digital Twin ในโรงงาน คนส่วนใหญ่นึกถึงการจำลองเครื่องจักรหรือสายการผลิต แต่มีระบบหนึ่งที่ถูกมองข้ามบ่อยที่สุด ทั้งที่กินงบลงทุนมหาศาลและกำหนดต้นทุนต่อหน่วยผลิตของโรงงานโดยตรง นั่นคือ ระบบไฟฟ้าและพลังงานทั้งโครงข่าย — หม้อแปลง, Switchgear, Solar Rooftop, ระบบกักเก็บพลังงานแบตเตอรี่ (BESS), ระบบปรับอากาศ, และมอเตอร์นับพันตัวที่กระจายอยู่ทั้งโรงงาน วันนี้โรงงานไทยจำนวนมากติดตั้งโซล่าร์บนหลังคาและพิจารณาลงทุน BESS เพื่อลดค่าไฟช่วง Peak แต่การตัดสินใจเหล่านี้ส่วนใหญ่ยังอาศัยสูตรคำนวณแบบ Static จาก Excel ที่คำนวณครั้งเดียวตอนทำ ROI — คำนวณก่อนติดตั้ง แล้วไม่มีใครกลับมาเช็คอีกเลยว่าระบบจริงทำงานตรงกับที่คำนวณไว้หรือไม่ ตู้ระบบกักเก็บพลังงานแบตเตอรี่ (BESS) แบบระบายความร้อนด้วยอากาศสำหรับงานอุตสาหกรรม — หนึ่งในอสังหาริมทรัพย์พลังงานที่ Digital Twin ช่วยวางแผนการชาร์จ/คายประจุได้แม่นที่สุด (ภาพ: Wikimedia Commons, CC0) Electrical Digital Twin คืออะไร ต่างจาก Energy Dashboard อย่างไร หลายองค์กรมี Dashboard แสดงค่าไฟ ค่า Maximum Demand แล้ว และคิดว่านั่นคือ "การจัดการพลังงาน" แต่จริงๆ แล้วนั่นคือการ เฝ้าดูย้อนหลัง — เห็นว่าเมื่อวานค่าไฟเท่าไร แล้วก็จบ Electrical Digital Twin คือโมเดลจำลองทางไฟฟ้าของทั้งโรงงานที่สะท้อนสถานะ แบบเรียลไทม์ และสามารถ จำลองอนาคต ได้ ประกอบด้วย 3 ชั้น: ชั้นข้อมูล (Data Layer) — Power Meter, Power Quality Analyzer, และ Sensor ตามจุดสำคัญ ส่งข้อมูลแรงดัน กระแส กำลังไฟฟ้า ตัวประกอบกำลัง (Power Factor) และ Harmonics ผ่านโปรโตคอล Modbus TCP หรือ OPC UA ขึ้น Edge Gateway แบบต่อเนื่อง ชั้นโมเดล (Model Layer) — โมเดลวงจรไฟฟ้าแบบ One-Line Diagram ที่มีพารามิเตอร์จริงของหม้อแปลง สายไฟ และโหลด บางจุดผสม Physics-based Model (สมการวงจร) กับ Data-driven Model (ML) แบบ Hybrid Twin ชั้นจำลองสถานการณ์ (Simulation…
Read More
Reinforcement Learning ในโรงงาน: เมื่อ AI ไม่ใช่ทำนาย แต่ลงมือควบคุมระบบจริง — จาก Reward Function ถึง Safety Layer

Reinforcement Learning ในโรงงาน: เมื่อ AI ไม่ใช่ทำนาย แต่ลงมือควบคุมระบบจริง — จาก Reward Function ถึง Safety Layer

Article
หลายโรงงานที่เราเจอในประเทศไทยมีปัญหาเดียวกัน — ระบบทำความเย็น ระบบปรับอากาศ หรือชุดหม้อไอน้ำ ถูกตั้งค่าพารามิเตอร์ไว้ตั้งแต่วัน commissioning แล้วก็ไม่เคยถูกปรับอีกเลย ทั้งที่โหลดจริงเปลี่ยนไปตลอดเวลา ทั้งจากฤดูกาล สูตรการผลิต และปริมาณคำสั่งผลิต บทความนี้เราจะเจาะลึกว่า Reinforcement Learning (RL) จะเข้ามา "เรียนรู้" วิธีควบคุมที่ดีที่สุดจากข้อมูลจริงของโรงงานคุณเองได้อย่างไร และทำไมมันถึงไม่ใช่แค่ hype แต่เป็นเทคโนโลยีที่ถูกพิสูจน์แล้วในงานจริงมานานกว่า 8 ปี RL ต่างจาก AI แบบที่โรงงานเคยใช้อย่างไร งาน AI ส่วนใหญ่ในโรงงานตอนนี้คือการ "ทำนาย" — ทำนายว่าแบริ่งจะพังเมื่อไหร่ ทำนายว่าชิ้นงานจะเสียหรือไม่ แต่ RL ไม่ได้ทำนาย RL ทำหน้าที่ ตัดสินใจลงมือทำ โดยตอบคำถามว่า "ถ้าสถานการณ์เป็นแบบนี้ ควรตั้งค่าอะไรเท่าไหร่ถึงจะดีที่สุดในระยะยาว" กลไกหลักของ RL คือการเรียนรู้ผ่านการลองผิดลองถูกภายใต้กรอบที่เรียกว่า Markov Decision Process (MDP) — ตัวควบคุม (agent) สังเกตสถานะปัจจุบัน เช่น อุณหภูมิน้ำเย็น โหลด แรงดัน แล้วเลือก action เช่น ปรับความถี่ปั๊ม เปิด-ปิด chiller จากนั้นระบบให้ reward กลับมา (เช่น พลังงานที่ประหยัดได้ในชั่วโมงนั้น) และวนซ้ำแบบนี้หลายล้านครั้งจนโมเดลเรียนรู้นโยบาย (policy) ที่ดีที่สุด แผนภาพวงจรการเรียนรู้ของ RL: agent สังเกต state → เลือก action → รับ reward → ปรับ policy (ภาพ: Wikimedia Commons, CC) กรณีศึกษาที่เปลี่ยนเกม: ระบบทำความเย็น Data Center ตัวอย่างที่ถูกอ้างถึงมากที่สุดคือโครงการนำร่องปี 2016 ของบริษัทเทคโนโลยีระดับโลกที่นำ Deep RL มาควบคุมระบบทำความเย็นของ data center ของตัวเอง ผลลัพธ์คือพลังงานที่ใช้ในส่วน cooling (PUE ลดลงจาก 1.12 เหลือ 1.10) โดยระบบปรับพารามิเตอร์หลายสิบตัวพร้อมกันที่มนุษย์ทำได้ยาก เพราะตัวแปรทั้งหมด interlock กันหมด ต่อมาปี 2018 มีการต่อยอดให้ระบบส่งคำสั่งควบคุมโดยตรงสู่ระบบจริงทุก 5 นาทีอัตโนมัติ กลายเป็น "operator ที่ไม่มีวันเหนื่อย" ที่คอยหาจุด sweet spot ของระบบตลอด 24 ชั่วโมง ระบบทำความเย็นคือ…
Read More
บทวิเคราะห์ Over-Optimization Trap: ทำไมระบบที่ Efficient ที่สุดคือระบบที่เปราะบางที่สุด — บทเรียน Resilience ยุค Industry 5.0

บทวิเคราะห์ Over-Optimization Trap: ทำไมระบบที่ Efficient ที่สุดคือระบบที่เปราะบางที่สุด — บทเรียน Resilience ยุค Industry 5.0

Article
ยี่สิบปีที่แล้ว คำว่า "Lean" และ "Just-in-Time" คือคำตอบสุดท้ายของวงการผลิต — ตัดสต๊อกให้เหลือน้อยที่สุด ตัด Waste ให้หมด บีบ Supplier ให้ส่งของถี่ขึ้นเรื่อยๆ แล้ว COVID-19 ก็มาถึง ตามด้วยสงครามการค้า ความขัดแย้งภูมิรัฐศาสตร์ และวิกฤตพลังงาน โลกของปี 2026 ค้นพบความจริงข้อหนึ่ง: ระบบที่ Optimize สูงสุดคือระบบที่เปราะบางสูงสุด นี่คือบทวิเคราะห์ปรากฏการณ์ที่เราเรียกว่า "กับดักการ Optimize เกินพอดี" (Over-Optimization Trap) — และเหตุใด Industry 5.0 จึงยกเรื่อง Resilience ขึ้นเป็นเสาหลักเทียบเท่าประสิทธิภาพ ท่าเรือคอนเทนเนอร์คือภาพจำของ Global Value Chains — ระบบที่มีประสิทธิภาพสูงที่สุดในประวัติศาสตร์ และก็เปราะบางที่สุดเมื่อโลกหยุดหมุน (ภาพ: Wikimedia Commons, Public Domain) กับดักทำงานอย่างไร — 3 กลไกที่มองไม่เห็นในตาราง Excel 1. Efficiency กับ Resilience คือ Trade-off ที่ซ่อนอยู่ ทุกครั้งที่เราตัดสต๊อก Buffer ลง รวม Supplier จาก 5 รายเหลือ 1 ราย (เพื่อราคาดีกว่า) หรือรวมโรงงานจาก 3 แห่งเหลือ 1 แห่ง (เพื่อ Economies of Scale) — เรากำลังแลก "ความเปราะบาง" ซื้อ "ประสิทธิภาพ" โดยที่ตัวเลขในงบการเงินแสดงเฉพาะครึ่งหลัง เอกสารวิเคราะห์ของสภาอุตสาหกรรมแห่งประเทศไทย (FTPI) ปี 2026 ชี้ตรงว่าแนวทาง Just-in-Time ที่เน้นประสิทธิภาพสูงสุดของ Industry 4.0 กลายเป็น "ความเปราะบางเมื่อเผชิญเหตุการณ์ไม่ปกติ" — วิกฤตด้านสาธารณสุข เศรษฐกิจ ภูมิรัฐศาสตร์ และการหยุดชะงักของห่วงโซ่อุปทาน 2. Rebound Effect — เทคโนโลยีประหยัดทรัพยากรที่ทำให้ใช้ทรัพยาศเพิ่ม เอกสารเดียวกันอธิบายปรากฏการณ์ที่ถูกมองข้าม: เมื่อเทคโนโลยีทำให้ต้นทุนการผลิตลดลง ความต้องการก็เพิ่มขึ้นจน "หักล้างประสิทธิภาพที่ทำไว้" — โรงงานที่ประหยัดพลังงานต่อหน่วยได้ 20% อาจผลิตเพิ่ม 30% สุทธิคือใช้พลังงานมากขึ้น นี่คือเหตุผลที่เป้าหมาย Sustainability ของ Industry 5.0 ต้องมาพร้อมระบบวัดผลจริง (Carbon Accounting, Energy Submetering…
Read More
Industry 5.0 คืออะไร: ถอดรหัส 3 เสาหลัก Human-Centric, Sustainability, Resilience และเส้นทางเปลี่ยนผ่านสำหรับโรงงานไทย

Industry 5.0 คืออะไร: ถอดรหัส 3 เสาหลัก Human-Centric, Sustainability, Resilience และเส้นทางเปลี่ยนผ่านสำหรับโรงงานไทย

Article
ในช่วงสิบปีที่ผ่านมา คำว่า Industry 4.0 กลายเป็นคำโฆษณาชวนเชื่อ (Buzzword) ที่โรงงานทั่วโลกใช้เรียกการลงทุนเทคโนโลยีดิจิทัล ตั้งแต่ IoT Platform, Big Data ไปจนถึง AI แต่ปลายปี 2026 นี้ กระแสนโยบายเริ่มเปลี่ยน สหภาพยุโรปผลักดันกรอบแนวคิด Industry 5.0 อย่างจริงจัง โดยไม่ได้หมายถึง "เทคโนโลยีเจเนอเรชันใหม่" แต่คือการเปลี่ยนกระบวนทัศน์ (Paradigm Shift) จากระบบ Techno-economic ไปสู่ Socio-technical System — เทคโนโลยีเป็นเพียงเครื่องมือ ไม่ใช่ปลายทาง บทความนี้ถอดรหัส Industry 5.0 ให้วิศวกรและผู้บริหารโรงงานไทยเข้าใจอย่างเป็นระบบ พร้อมตัวเลขจริงที่อ้างอิงจากเอกสารวิจัยของสภาอุตสาหกรรมแห่งประเทศไทย (FTPI) ปี 2026 และรายงานระดับโลก Industry 4.0 ติดขัดตรงไหน — 4 ข้อจำกัดที่โลกยอมรับแล้ว ก่อนจะเข้าใจ Industry 5.0 ต้องเข้าใจว่าทำไมโลกถึงต้องการ "อุตสาหกรรม 5.0" ตัวเลขชี้ว่า Industry 4.0 ประสบความสำเร็จด้านประสิทธิภาพ แต่สร้างผลข้างเคียง 4 ข้อที่ยังแก้ไม่ตก: เน้นผลกำไรมากกว่าสังคม — การตัดสินใจลงทุนถูกขับเคลื่อนด้วย ROI และการลดต้นทุน จนแรงงานถูกมองเป็น "ต้นทุนที่ต้องควบคุม" มากกว่าทรัพยากรที่ต้องพัฒนา ความเสี่ยงแทนที่แรงงาน — รายงาน Future of Jobs Report ของ World Economic Forum ระบุว่าภายในปี 2027 จะมีตำแหน่งงานหายไปราว 83 ล้านตำแหน่ง ขณะที่เกิดงานใหม่เพียง 69 ล้านตำแหน่ง เกิด Net Job Loss ประมาณ 14 ล้านตำแหน่งทั่วโลก และแรงงาน 400–800 ล้านคนอาจต้องเปลี่ยนอาชีพภายในปี 2030 ใช้ทรัพยากรเข้มข้นเกินไป — เกิดปรากฏการณ์ Rebound Effect: เทคโนโลยีที่ประหยัดต้นทุนกลับกระตุ้นการผลิตมากขึ้นจนหักล้างประสิทธิภาพที่ทำไว้ รวมถึง AI, Data Center และ Cloud Computing ที่ใช้พลังงานสูง ความเปราะบางของห่วงโซ่อุปทาน — ระบบ Just-in-Time ที่ผองชื่อเรื่องประสิทธิภาพ กลายเป็นจุดอ่อนเมื่อเจอ COVID-19 ความขัดแย้งภูมิรัฐศาสตร์ และการหยุดชะงักของ Global Value Chains Cobot คือสัญลักษณ์ของ Human-Technology…
Read More
Supply Chain Control Tower ยุค Agentic AI: จาก Dashboard เฝ้าดู สู่ศูนย์บัญชาการที่ตัดสินใจแทนคุณในไม่กี่นาที

Supply Chain Control Tower ยุค Agentic AI: จาก Dashboard เฝ้าดู สู่ศูนย์บัญชาการที่ตัดสินใจแทนคุณในไม่กี่นาที

Article
จาก Dashboard บอกเล่าเหตุการณ์ สู่ศูนย์บัญชาการที่ตัดสินใจเอง หลายโรงงานที่ลงทุน "Control Tower" ไปเมื่อ 3-4 ปีก่อน กำลังพบปัญหาเดียวกัน คือระบบสวยงาม ข้อมูลครบ แต่สุดท้ายคนยังต้องนั่งเฝ้าจอ ไล่ดูสถานะรถทุกคัน แล้วโทรไปถามทีมปฏิบัติการเองว่าจะทำอย่างไรต่อ Control Tower รุ่นแรกคือ ชั้นรวบรวมข้อมูล (Data Aggregation Layer) ที่ดึงข้อมูลจาก TMS (ระบบบริหารการขนส่ง) WMS (ระบบบริหารคลังสินค้า) และข้อมูลจากผู้ขนส่งภายนอก มาแสดงบนจอเดียวให้คนตัดสินใจเอง ปี 2026 หน้าที่ของมันกำลังเปลี่ยนไปสู่ AI Control Tower ที่ไม่ใช่แค่รายงานว่าเกิดอะไรขึ้น แต่ประเมินสถานการณ์หลายแบบพร้อมกัน คาดการณ์ผลกระทบ และเสนอหรือลงมือแก้ปัญหาเองภายในไม่กี่นาที แรงผลักดันหลักคือความผันผวนทางภูมิรัฐศาสตร์ การขาดแคลนแรงงาน และต้นทุนที่สูงขึ้น จนองค์กรไม่มีเวลาให้ทีมงานนั่งวิเคราะห์ทุกเหตุการณ์ทีละเคสอีกต่อไป ท่าเรือคอนเทนเนอร์คือจุดที่ความล่าช้าเล็กน้อยถูกขยายเป็นผลกระทบทั้งห่วงโซ่ — AI Control Tower ถูกออกแบบมาเพื่อตัดสินใจ ณ จุดพวกนี้ให้เร็วกว่ามนุษย์ (ภาพ: Wikimedia Commons) ตัวเลขที่อธิบายว่าทำไมทุกคนเร่งตัดสินใจในปี 2026 ข้อมูลจากรายงานอุตสาหกรรมหลายฉบับในปี 2026 ชี้ตรงกันว่า ความไม่แน่นอนทางเศรษฐกิจและภูมิรัฐศาสตร์ เป็นปัจจัยสำคัญที่สุดที่กดดันการตัดสินใจด้าน supply chain ในปีนี้ ขณะที่สัดส่วนองค์กรที่ใช้ AI ในกิจกรรม supply chain เพิ่มจากราว 30% เป็นราว 40% ภายในเวลาเพียงหนึ่งปี — นั่นแปลว่าเกือบครึ่งของคู่แข่งของคุณอาจกำลังให้ AI ช่วยวางแผนสินค้าคงคลังและจัดเส้นทางขนส่งอยู่แล้ว มิติ Control Tower แบบดั้งเดิม AI Control Tower บทบาทหลักรวมข้อมูล แสดงสถานะ (Monitoring)ตัดสินใจและลงมือแก้ปัญหา (Decision + Action) เมื่อรถส่งสินค้าล่าช้าแจ้งเตือนสีแดง รอคนโทรประสานงานระบุเส้นทางทางเลือก จัดสรรสต๊อกระหว่าง DC ใกล้เคียง และจัดลำดับออเดอร์ตาม SLA อัตโนมัติ การตอบสนองชั่วโมงถึงวัน (ผู้เชี่ยวชาญต้องวิเคราะห์)นาที (ระบบประเมินหลายสถานการณ์พร้อมกัน) ข้อมูลที่ใช้TMS + WMS + ผู้ขนส่งเพิ่ม IoT telemetry, สภาพอากาศ, ข่าวภูมิรัฐศาสตร์, ข้อจำกัดท่าเรือแบบ real-time Human-in-the-loopคนตัดสินใจทุกขั้นAI ตัดสินใจชั้นปฏิบัติการ คนกำกับดูแลและยับยั้งได้ คอนเทนเนอร์หลายหมื่นใบในท่าเรือใหญ่ แต่ละใบคือเหตุการณ์ที่ AI Control Tower ต้องติดตามพร้อมกัน — งานที่เกินพิกัดการไล่ด้วยสายตามนุษย์ (ภาพ: Wikimedia Commons) สถาปัตยกรรม 5…
Read More
Spatial Computing ในโรงงานอุตสาหกรรม: เมื่อ Industrial Metaverse โตกว่า Consumer สองเท่า — บทวิเคราะห์สำหรับโรงงานไทย

Spatial Computing ในโรงงานอุตสาหกรรม: เมื่อ Industrial Metaverse โตกว่า Consumer สองเท่า — บทวิเคราะห์สำหรับโรงงานไทย

Article
ปี 2023 คำว่า “Metaverse” เคยถูกล้อเลียนจนกลายเป็นมีม แต่สองปีถัดมา แนวคิดนั้นแยกร่างเป็นสิ่งที่จับต้องได้มากขึ้น — Spatial Computing — และในครั้งนี้ โรงงานอุตสาหกรรมคือลูกค้ากลุ่มแรกที่จริงจังที่สุด รายงาน Tech Trends ของ Deloitte ประเมินว่ารายได้จาก Industrial Metaverse จะแตะราว 100 พันล้านดอลลาร์ภายในปี 2030 แซงหน้าทั้ง Consumer (50 พันล้าน) และ Enterprise ทั่วไป (30 พันล้าน) ส่วนตลาด Spatial Computing โดยรวมบางประมาณการให้สูงถึง 600 พันล้านดอลลาร์ภายในปี 2032 ตัวเลขเหล่านี้ไม่ใช่แค่การคาดเดาของนักวิเคราะห์ — สำรวจของ Deloitte ร่วมกับ Manufacturing Leadership Council พบว่า 92% ของผู้บริหารฝ่ายการผลิตทั่วโลกทดลองหรือใช้งาน immersive use case อย่างน้อยหนึ่งงาน โดยเฉลี่ยแล้วองค์กรหนึ่งทำมากกว่าหก use cases และคาดหวังการปรับปรุงด้านยอดขาย ผลิตภาพ และคุณภาพราว 12-14% ในอนาคตอันใกล้ คำถามจึงไม่ใช่ “ควรลองไหม” แต่คือ “ควรเริ่มจากตรงไหนและเตรียมรับอะไรบ้าง” Spatial Computing คืออะไร: นิยามที่วิศวกรเข้าใจ รายงาน Technology Vision ของผู้ให้บริการเครือข่ายรายใหญ่นิยาม Spatial Computing ว่าเป็นกระบวนทัศน์ใหม่ของปฏิสัมพันธ์ระหว่างมนุษย์กับคอมพิวเตอร์ ที่ “นำสถานที่และวัตถุทางกายภาพเข้ามาในแอปพลิเคชัน แล้วซ้อนทับข้อมูลดิจิทัลลงบนสิ่งเหล่านั้น” ต่างจาก GUI ดั้งเดิมที่บังคับให้เราเลือกว่าจะดูโลกจริงหรือจอคอมพิวเตอร์ Spatial Computing ลบเส้นแบ่งนั้นด้วยการทำให้ข้อมูลดิจิทัล มีตำแหน่งในอวกาศจริง — ลูกศรชี้ไปที่วาล์วตัวนั้นจริงๆ ค่าอุณหภูมิลอยอยู่ข้างปั๊มตัวนั้นจริงๆ และคนสองคนที่ยืนคนละทวีปมองเห็น Annotation เดียวกันบนเครื่องจักรเครื่องเดียวกัน สิ่งที่ทำให้มันทำงานได้คือชั้นเทคโนโลยีห้าชั้นที่รายงานเทคโนโลยีฉบับดังกล่าวเรียกว่า Spatial Computing Technology Stack: แผนภาพที่ 1: Spatial Computing Technology Stack — 5 องค์ประกอบที่ยึดเกาะข้อมูลดิจิทัลเข้ากับโลกกายภาพ (ที่มา: Honey Corporation, อ้างอิงกรอบคิดจากรายงาน Technology Vision ระดับโลก) Spatial User Interfaces: จาก Smart Glasses น้ำหนักเบาไปถึง MR Headset เต็มรูปแบบ รองรับการควบคุมด้วยท่าทาง เสียง และ Eye…
Read More
How-to: MR Maintenance — คู่มือ 6 ขั้นตอนพาทีมซ่อมบำรุงเข้าสู่ยุค Mixed Reality + Digital Twin

How-to: MR Maintenance — คู่มือ 6 ขั้นตอนพาทีมซ่อมบำรุงเข้าสู่ยุค Mixed Reality + Digital Twin

Article
คุณเคยลองนึกภาพช่างที่เพิ่งทำงานได้สามเดือน กำลังยืนหน้าปั๊มไฮดรอลิกขนาดใหญ่ที่มีอาการสั่นผิดปกติ โดยไม่มีคู่มือ ไม่มีผู้เชี่ยวชาญ และไม่รู้ด้วยซ้ำว่าภายในตัวปั๊มมีชิ้นส่วนอะไรซ่อนอยู่บ้างหรือไม่? นี่คือสถานการณ์จริงในโรงงานส่วนใหญ่วันนี้ และเป็นสถานการณ์ที่ Mixed Reality (MR) Maintenance ถูกออกแบบมาแก้ ต่างจาก AR ทั่วไปที่แค่ “วางข้อความทับภาพจริง” MR ทำงานลึกกว่านั้น — มันสร้าง โมเดลสามมิติของชิ้นส่วนภายในเครื่องจักรที่ซ้อนทับกับตัวเครื่องจริง ราวกับมองทะลุ (X-Ray View) พร้อมดึงข้อมูล IoT แบบเรียลไทม์มาแสดงข้างชิ้นส่วนแต่ละชิ้น บทความนี้เป็นคู่มือ How-to แบบทีละขั้น สำหรับวิศวกรและผู้จัดการซ่อมบำรุงที่อยากพาทีมเข้าสู่ยุค MR อย่างเป็นระบบ ทำความเข้าใจก่อน: MR ต่างจาก AR ตรงไหน หลายคนใช้คำ AR/MR สลับกัน แต่ในเชิงเทคนิคมีเส้นแบ่งที่สำคัญ: AR Overlay ธรรมดาคือข้อมูลสองมิติที่ “ลอย” อยู่บนจอ ไม่รับรู้เรขาคณิตของสิ่งรอบตัว ส่วน MR ต้องมี Spatial Understanding — ระบบต้องสร้างแผนที่ความลึก (Depth Map) ของห้อง รู้ว่าพื้นอยู่ตรงไหน เครื่องจักรห่างกันกี่เมตร และตรึงโมเดลสามมิติให้ติดกับวัตถุจริงแม้ผู้สวมจะเดินรอบ รายงาน Technology Vision ของ Nokia อธิบายว่าความสามารถนี้คือหัวใจของ Spatial Computing ยุคใหม่ที่กำลังหลอมรวม Digital Twin เข้ากับงานหน้างานจริง งานวิจัยทางวิชาการ เช่น บทความจากวารสาร Applied Ergonomics และงานสำรวจ Light: Advanced Manufacturing (2025) พบว่างานบำรุงรักษาคือ use case ที่มีงานวิจัยรองรับหนาแน่นที่สุดของ HMD-based AR/MR ในภาคอุตสาหกรรม ด้วยเหตุผลง่ายๆ: มันเป็นงานที่ มือทั้งสองข้างต้องทำงาน สายตาต้องอยู่กับเครื่องจักร และความรู้อยู่ที่ไหนสักแห่งที่ไม่ใช่หน้างาน — สามข้อจำกัดที่จอแท็บเล็ตแก้ไม่ได้พร้อมกัน แผนภาพที่ 1: วงจรงาน MR Maintenance 6 ขั้นตอน — จากเปิด Work Order ด้วยการสแกน ถึงการปิดงานเข้าสู่ CMMS (ที่มา: Honey Corporation) How-to: 6 ขั้นตอนสู่ MR Maintenance ที่ใช้งานได้จริง ขั้นที่ 1 — เลือกเครื่องจักรนำร่องด้วยเกณฑ์ 3 ข้อ อย่าเริ่มกับเครื่องจักรที่ “ง่ายที่สุด” แต่เริ่มกับเครื่องที่ผ่านเกณฑ์นี้: (1)…
Read More