AR Remote Assistance: เมื่อผู้เชี่ยวชาญอยู่ข้างคุณโดยไม่ต้องขึ้นเครื่องบิน — See-What-I-See ในงานซ่อมบำรุงโรงงาน

AR Remote Assistance: เมื่อผู้เชี่ยวชาญอยู่ข้างคุณโดยไม่ต้องขึ้นเครื่องบิน — See-What-I-See ในงานซ่อมบำรุงโรงงาน

Article
เมื่อเครื่องจักรหยุดกลางดึกในโรงงานที่ระยอง ปัญหาแรกที่ผู้จัดการฝ่ายซ่อมบำรุงเผชิญมักไม่ใช่ตัวเครื่องจักร แต่คือคำถามว่า “ผู้เชี่ยวชาญของผู้ผลิตเครื่องจักรอยู่ที่ไหน” — และเขาจะมาถึงโรงงานเมื่อไหร่ ในอดีตคำตอบมักคือ “อีก 2-3 วัน” พร้อมค่าตั๋วเครื่องบินและค่าที่พัก ทุกชั่วโมงที่รอคือยอดผลิตที่หายไป AR Remote Assistance ถูกออกแบบมาเพื่อตัดปัญหานี้ให้หมดไป งานวิจัยชิ้นสำคัญ Remote Technologies as Common Practice in Industrial Maintenance ที่ตีพิมพ์ในวารสาร Sensors ของสำนักพิมพ์ MDPI (2022) ชี้ว่าเทคโนโลยีความช่วยเหลือระยะไกลกำลังกลายเป็น “แนวปฏิบัติมาตรฐาน” ของงานซ่อมบำรุงอุตสาหกรรม โดยเฉพาะในงานที่เป็นเพียง Minor Malfunction ซึ่งการเดินทางของผู้เชี่ยวชาญสามารถหลีกเลี่ยงได้ทั้งหมด บทความนี้พาคุณเจาะลึกว่าเทคโนโลยีนี้ทำงานอย่างไรจริงๆ และโรงงานไทยควรเริ่มต้นอย่างไร หลักการ See-What-I-See: ทำไม “มองเห็นแบบเดียวกัน” สำคัญกว่าที่คิด ปัญหาของการโทรศัพท์ขอความช่วยเหลือแบบดั้งเดิมคือ Information Asymmetry — ผู้เชี่ยวชาญปลายทาง “ไม่เห็น” สิ่งที่ช่างหน้างานเห็น ช่างต้องพยายามบรรยายด้วยคำพูดว่า “ไฟสีแดงกระพริบอยู่ตรงบอร์ดมุมซ้าย ข้างโรเลอ์ตัวเล็กๆ” ซึ่งเป็นกระบวนการที่ผิดพลาดง่ายและเสียเวลา งานวิจัยด้าน Remote Guidance พบซ้ำๆ ว่าการสื่อสารแบบเสียงเพียงอย่างเดียวทำให้เกิดความเข้าใจผิดเกี่ยวกับตำแหน่งและสถานะของอุปกรณ์บ่อยครั้ง AR Remote Assistance แก้ปัญหานี้ด้วยหลักการ See-What-I-See: กล้องบน Smart Glasses หรือ Head-Mounted Display ของช่างหน้างานส่งภาพมุมมองบุคคลที่หนึ่ง (First-Person View) ไปให้ผู้เชี่ยวชาญแบบเรียลไทม์ ผู้เชี่ยวชาญเห็นสิ่งที่ช่างเห็นทันที จากนั้นวาดลูกศร วงกลม หรือข้อความลงบนภาพ และ Annotation เหล่านั้นจะปรากฏลอยอยู่ในมุมมองของช่าง ตรึงกับชิ้นส่วนจริง เมื่อช่างขยับหัวหรือเดินรอบเครื่องจักร สัญลักษณ์เหล่านั้นยังอยู่กับที่บนตำแหน่งของอุปกรณ์ แผนภาพที่ 1: สถาปัตยกรรม AR Remote Assistance — ภาพจริงจากหน้างานไหลขึ้นสู่ผู้เชี่ยวชาญ คำแนะนำไหลกลับลงมาเป็น Annotation ที่ตรึงบนวัตถุจริง (ที่มา: Honey Corporation) เทคโนโลยีเบื้องหลัง: จาก WebRTC ถึง SLAM Anchoring ใต้ประทานของประสบการณ์ที่ดูเหมือนมหัศจรรย์ คือชั้นเทคโนโลยีที่วิศวกรควรเข้าใจ: WebRTC (Web Real-Time Communication): มาตรฐานเปิดที่เป็นหัวใจของการส่งวิดีโอสองทางแบบ Low-Latency โดยทั่วไปหน่วงเวลาอยู่ในระดับหลักร้อยมิลลิวินาที ทำให้การสนทนาเป็นธรรมชาติ โดยไม่ต้องพึ่ง Server แบบดั้งเดิม (Peer-to-Peer) หรือใช้ SFU/MCU เมื่อมีผู้เข้าร่วมหลายคน SRTP และการเข้ารหัส End-to-End: สายวิดีโอจากโรงงานคือข้อมูลอ่อนไหว — เผยทั้งเลย์เอาต์สายการผลิต อุปกรณ์ และกระบวนการ…
Read More
Human Digital Twin: เมื่อสิ่งที่ถูกลืมมากที่สุดในโรงงานอัจฉริยะคือ “คน” — บทวิเคราะห์แนวคิดและโอกาสปี 2026

Human Digital Twin: เมื่อสิ่งที่ถูกลืมมากที่สุดในโรงงานอัจฉริยะคือ “คน” — บทวิเคราะห์แนวคิดและโอกาสปี 2026

Article
เมื่อพูดถึง Digital Twin ในโรงงาน ภาพที่ผุดขึ้นมาเกือบทุกครั้งคือเครื่องจักร ท่อ และสายพานที่ถูกจำลองเป็นโมเดลสามมิติเรืองแสง แต่มี "อะไรบางอย่าง" ที่เดินไปมาท่ามกลางเครื่องจักรเหล่านั้นทุกวัน ทำงาน 8-12 ชั่วโมงต่อวัน ปรับตัวตามคำสั่งผลิตที่เปลี่ยนทุกชั่วโมง — แต่แทบไม่เคยถูกจำลอง นั่นคือ คนงาน Human Digital Twin (HDT) คือแนวคิดการสร้างตัวแบบดิจิทัลของมนุษย์ในระบบการผลิต — ไม่ใช่แค่หุ่นยนต์เสมือนใน software จำลอง แต่คือการผูกข้อมูลการเคลื่อนไหว ท่าทาง ภาระงาน และบางกรณีถึงสัญญาณชีวภาพ เข้ากับโมเดลที่ใช้วิเคราะห์ ทำนาย และออกแบบงานให้กับคนได้ดีขึ้น ในห้วงที่อุตสาหกรรมทั่วโลกกำลังเผชิญภาวะแรงงานขาดแคลนและอัตราการลาออกสูง แนวคิดนี้กำลังขยับจากงานวิจัยสู่หน้างานจริง ทำไมต้องจำลองคน — เมื่อปัญหาของโรงงานคือคน ไม่ใช่เครื่องจักร เครื่องจักรมี datasheet บอกขีดจำกัดชัดเจน แต่คนไม่มี โรงงานส่วนใหญ่รู้ว่าเครื่อง CNC ตัวไหนทำงานได้กี่ชั่วโมงก่อนพัง แต่ไม่รู้ว่าคนงานคนไหนกำลังยกของเกินหลักการยศาสตร์ (ergonomics) มาก่อนจะบาดเจ็บ องค์กรเออร์โกโนมิกส์นานาชาติ (IEA) แบ่งสาขาวิชานี้ออกเป็น 3 ด้าน ซึ่งเป็นโครงของ HDT เช่นกัน: Physical Ergonomics — ท่าทางการทำงาน การยกของ การเคลื่อนไหวซ้ำๆ ซึ่งเป็นต้นเหตุอาการบาดเจ็บสะสม (MSD — Musculoskeletal Disorders) อันดับต้นของโรงงาน Cognitive Ergonomics — ภาระทางการรู้คิด ความเหนื่อยล้าทางสมอง การตัดสินใจภายใต้ความกดดัน ซึ่งสัมพันธ์กับข้อผิดพลาดในการปฏิบัติงาน Organizational Ergonomics — การออกแบบกะการทำงาน โครงสร้างทีม และการสื่อสาร ที่ส่งผลต่อทั้งประสิทธิภาพและความปลอดภัย Motion Capture — หนึ่งในเทคโนโลยีหลักที่ใช้เก็บข้อมูลการเคลื่อนไหวของคนเพื่อสร้าง Human Digital Twin (ภาพ: Wikimedia Commons, CC BY 2.0) Human Digital Twin ต่างจากการประเมินยศาสตร์แบบเดิมอย่างไร การประเมินยศาสตร์แบบดั้งเดิม เช่น การสังเกตการทำงานด้วยตาแล้วให้คะแนนความเสี่ยง เป็นการวัด "ชั่วขณะหนึ่ง" — วิศวกรมาสังเกต 30 นาที แล้วสรุปทั้งกะ HDT เปลี่ยนวิธีนี้สามชั้น: มิติ การประเมินแบบเดิม Human Digital Twin การเก็บข้อมูล สังเกตด้วยตา ถ่ายวิดีโอ แบบสอบถาม Motion capture, เซ็นเซอร์สวมใส่, กล้อง AI posture ต่อเนื่อง ช่วงเวลา…
Read More
Reality Capture สำหรับ Digital Twin: จาก LiDAR และ Point Cloud สู่โมเดลโรงงานที่ตรงความจริง (Scan-to-Twin)

Reality Capture สำหรับ Digital Twin: จาก LiDAR และ Point Cloud สู่โมเดลโรงงานที่ตรงความจริง (Scan-to-Twin)

Article
คำถามที่ทีมวิศวกรรมได้ยินบ่อยที่สุดเมื่อเริ่มโครงการ Digital Twin ของโรงงานเก่าคือ "แผ่น CAD ที่มีอยู่ ใช้ได้เลยไหม?" คำตอบในทางปฏิบัติแทบทุกครั้งคือ — ไม่ได้ หรือไม่แม่นพอ โรงงานที่อายุ 10-20 ปีผ่านการปรับปรุงเปลี่ยนแปลงมานับสิบรอบ ทั้งย้ายเครื่องจักร เพิ่มท่อ เปลี่ยนเลย์เอาต์ แต่แฟ้ม CAD ยังค้างอยู่ที่ฉบับวันเปิดโรงงาน ผลคือ "โมเดลที่สวยแต่โกหก" Reality Capture คือกระบวนการจับข้อมูลโลกจริงมาเป็นโมเดลดิจิทัล — ด้วยการสแกนด้วยเลเซอร์ (LiDAR) หรือการถ่ายภาพหลายมุมเพื่อคำนวณเป็นโมเดลสามมิติ (Photogrammetry) ผลลัพธ์ที่ได้เรียกว่า Point Cloud ซึ่งจะกลายเป็นรากฐานที่แท้จริงของ Digital Twin ที่สะท้อนโรงงาน "ตามที่มันเป็น" (as-built) ไม่ใช่ "ตามที่แบบบอก" กระบวนการทั้งหมดนี้เรียกอีกชื่อหนึ่งว่า Scan-to-Twin ทำความรู้จักเครื่องมือก่อน: LiDAR ทำงานอย่างไร LiDAR (Light Detection and Ranging) ทำงานโดยยิงลำแสงเลเซอร์ไปยังวัตถุแล้ววัดเวลาที่แสงสะท้อนกลับมายังตัวรับ จากนั้นคำนวณระยะทางจากความเร็วแสง เมื่อยิงซ้ำนับล้านครั้งต่อวินาทีพร้อมหมุนสแกนไปทั่วพื้นที่ เครื่องจะได้จุดพิกัดสามมิติจำนวนมหาศาลที่ประกอบกันเป็น "เมฆจุด" ของสภาพแวดล้อมจริง รายละเอียดนั้นสูงมากจนสามารถนำไปใช้วัดขนาดจริงได้ หัวสแกน LiDAR แบบหมุน — ยิงลำเลเซอร์นับล้านครั้งต่อวินาทีแล้ววัดเวลาที่แสงสะท้อนกลับ เพื่อระบุพิกัดสามมิติของทุกจุดในพื้นที่ (ภาพ: Wikimedia Commons, CC BY 2.0) How-to: 6 ขั้นตอนจากโรงงานจริงสู่ Digital Twin ขั้นที่ 1 — สำรวจหน้างานและวางแผนตำแหน่งสแกน (Scan Plan) เดินสำรวจพื้นที่ก่อนเสมอ ระบุอุปสรรคแสง (แสงจ้าจากประตูโรงงาน พื้นสะท้อนแสง ผิวโลหะมันวาว) แล้วกำหนดจุดตั้งกล้องให้ทุกมุมมีความซ้อนทับกันอย่างน้อย 30% ระหว่างสแกนแต่ละจุด หากใช้แบบ Handheld SLAM Scanner จะยืดหยุ่นกว่าสำหรับพื้นที่แคบ เช่น ช่องท่อใต้ผิวดินหรือบริเวณท่อร้อย ขั้นที่ 2 — ลงสแกนในหน้างาน สแกนแต่ละจุดใช้เวลาไม่กี่นาที โรงงานขนาดกลางอาจต้องลงสแกนหลายสิบถึงหลายร้อยจุด สิ่งสำคัญคือควบคุมคนเดินผ่านให้น้อยที่สุดระหว่างสแกน เพราะ "คน" จะกลายเป็น noise ใน point cloud ด้วยเหตุผลเดียวกัน ควรสื่อสารกับฝ่ายผลิตล่วงหน้าเพื่อจองช่วงเวลา เช่น วันหยุดปฏิบัติการหรือช่วงเปลี่ยนกะ ขั้นที่ 3 — รวมจุดสแกน (Registration) ไฟล์สแกนแต่ละจุดคือ "ภาพตัด" ของพื้นที่ ต้องนำมาเชื่อมกันเป็นแผนที่เดียว กระบวนการนี้เรียกว่า Point Set Registration โดยอัลกอริทึมที่ใช้แพร่หลายคือ ICP…
Read More
Soft Sensor (เซ็นเซอร์เสมือน): คำนวณค่าที่วัดไม่ได้จากข้อมูลที่มีอยู่แล้ว — หัวใจที่ถูกลืมของ Digital Twin ระดับกระบวนการ

Soft Sensor (เซ็นเซอร์เสมือน): คำนวณค่าที่วัดไม่ได้จากข้อมูลที่มีอยู่แล้ว — หัวใจที่ถูกลืมของ Digital Twin ระดับกระบวนการ

Article
ในโรงงานกระบวนการผลิต (Process Industry) มีค่าบางอย่างที่วิศวกร "อยากรู้" แต่วัดตรงๆ ไม่ได้ หรือวัดได้แต่ช้าเกินไป ซับซ้อนเกินไป หรือเปลืองเกินไป — ไม่ว่าจะเป็นความเข้มข้นของสารในถังปฏิกิริยา คุณภาพของผลิตภัณฑ์กลางกระบวนการ หรืออัตราการไหลมวลในท่อที่มีสารกัดกร่อน วิธีแก้ดั้งเดิมคือหยิบตัวอย่างส่งแล็บ ซึ่งใช้เวลาเป็นชั่วโมง ทำให้ค่าที่ได้ "สะท้อนอดีต" ไม่ใช่สิ่งที่เกิดขึ้นในถังตอนนี้ Soft Sensor (หรือเรียกอีกชื่อว่า Virtual Sensor / Inferential Sensor) คือคำตอบของปัญหานี้ — มันไม่ใช่ฮาร์ดแวร์ แต่เป็น "เซ็นเซอร์ชิ้นใหม่ที่เกิดจากซอฟต์แวร์" โดยนำค่าจากเซ็นเซอร์จริงหลายสิบถึงหลายร้อยตัวที่มีอยู่แล้วในระบบควบคุม มาประมวลผลร่วมกันเพื่อ "คำนวณ" ค่าที่ต้องการนั้นออกมาแบบเรียลไทม์ โดยไม่ต้องติดตั้งอะไรเพิ่มบนท่อหรือถังเลย Soft Sensor ทำงานอย่างไร — หลักการพื้นฐาน หัวใจของ Soft Sensor อยู่ที่แนวคิดทางทฤษฎีการควบคุมที่เรียกว่า State Observer — ระบบที่ใช้สัญญาณที่วัดได้หลายตัว มาประมาณ "สถานะภายใน" (internal state) ของกระบวนการที่มองไม่เห็น ลองนึกภาพถังปฏิกิริยาเคมี: เราวัดอุณหภูมิ ความดัน อัตราการป้อนวัตถุดิบ และกำลังกวนได้ แต่ความเข้มข้นของผลิตภัณฑ์ในถังต้องรอผลแล็บ Soft Sensor จะเรียนรู้ความสัมพันธ์ระหว่างสัญญาณเหล่านี้กับผลแล็บในอดีต แล้วใช้โมเดลนั้นทำนายความเข้มข้นทุก ๆ วินาที แทนที่จะรอชั่วโมงเดียว แผนภาพหลักการทำงานแบบ Predict–Correct ของ Kalman Filter — อัลกอริทึมตระกูล State Observer คลาสสิกที่ถูกนับเป็น Soft Sensor ยุคแรก (ภาพ: Wikimedia Commons, CC BY-SA 3.0) อัลกอริทึมที่ถูกยกให้เป็นตัวอย่างคลาสสิกของ Soft Sensor คือ Kalman Filter — อัลกอริทึมที่รับชุดการวัดที่มี noise เข้ามาต่อเนื่อง แล้วประมาณค่าตัวแปรที่ไม่รู้ค่าออกมาพร้อมช่วงความไม่แน่นอนของการประมาณ ส่วนการ implement ยุคใหม่นิยมใช้ Neural Network หรือ Fuzzy Computing ซึ่งจับความสัมพันธ์แบบไม่เชิงเส้น (non-linear) ที่ซับซ้อนได้ดีกว่าสมการคณิตศาสตร์แบบดั้งเดิม เปรียบเทียบ Soft Sensor กับเซ็นเซอร์จริงและการวิเคราะห์ในแล็บ ประเด็นเปรียบเทียบ เซ็นเซอร์จริง (Hardware Sensor) การเก็บตัวอย่างส่งแล็บ (Lab Analysis) Soft Sensor (Virtual Sensor) ความถี่ของข้อมูล ต่อเนื่อง (วินาที–มิลลิวินาที) ต่ำมาก (ทุก 2–8…
Read More
บทวิเคราะห์: Digital Twin ออกจากห้วงนำร่องปี 2026 — ทำไม Predictive Maintenance กลายเป็น use case แรกที่ขยายสู่ทั้งโรงงาน

บทวิเคราะห์: Digital Twin ออกจากห้วงนำร่องปี 2026 — ทำไม Predictive Maintenance กลายเป็น use case แรกที่ขยายสู่ทั้งโรงงาน

Article
คำถามที่เปลี่ยนไป — สองปีก่อน คำถามที่ผู้บริหารโรงงานถามเรื่อง Digital Twin คือ "มันคุ้มไหม" ปี 2026 คำถามกลายเป็น "จะขยายจากนำร่องสู่ทั้งโรงงานได้อย่างไร" รายงานแนวโน้มอุตสาหกรรมการผลิตปี 2026 จากหลายสำนักวิเคราะห์ระดับโลกสะท้อนภาพเดียวกัน: Digital Twin และ Smart Factory กำลังก้าวพ้นช่วงทดลอง (Pilot Phase) สู่การใช้งานจริงในระดับองค์กร โดยเฉพาะในงานมอนิเตอร์เครื่องจักรเรียลไทม์และการบำรุงรักษาเชิงคาดการณ์ (Predictive Maintenance) การเปลี่ยนแปลงนี้สำคัญเพราะเกือบทศวรรษที่ผ่านมา เทคโนโลยีโรงงานอัจฉริยะติดอยู่ที่ "Pilot Purgatory" — นำร่องเสร็จ ทำได้จริง แต่ขยายไม่ได้ ครั้งนี้ต่างจากเดิมเพราะตัวแปรหลายตัวเปลี่ยนพร้อมกัน ห้องควบคุมโรงงาน — จุดที่ข้อมูลจาก Digital Twin ต้องมาบรรจบเป็นการตัดสินใจจริง ไม่ใช่แค่ภาพสวยบนจอ (ภาพ: Wikimedia Commons) ทำไมครั้งนี้ถึงออกจาก Pilot ได้จริง: 4 ตัวแปรที่พร้อมพร้อมกัน จากที่เราสังเกตจากงานวางระบบให้โรงงานอุตสาหกรรม การออกจากห้วงนำร่องของ Digital Twin ปี 2026 เกิดจากตัวแปร 4 ตัวที่สุกพร้อมกัน: ข้อมูลเรียลไทม์ราคาถูกลงมาก — เซ็นเซอร์วัดอุณหภูมิ แรงสั่นสะเทือน แรงดัน ความเร็วรอบ และพลังงาน พร้อมโปรโตคอลมาตรฐานอย่าง OPC UA (IEC 62541) และ MQTT ทำให้ต้นทุนการ "เติมเซ็นเซอร์" ให้เครื่องจักรเดิมลดลงจนคุ้มค่าในเชิงพาณิชย์ — เฉพาะงานแรงสั่น เซ็นเซอร์เร่งความเร็วแบบ MEMS รุ่นอุตสาหกรรมปัจจุบันสุ่มข้อมูลได้ระดับหลัก kHz เพียงพอต่อการวิเคราะห์ FFT หาความผิดปกติของลูกปืนและเฟืองตามโซนความรุนแรงของมาตรฐาน ISO 10816/20816 Edge Computing เสถียรแล้ว — การประมวลผลที่ตู้คอนโทรลหรือ Edge Gateway ทำให้การตรวจจับความผิดปกติเกิดขึ้นในหลักมิลลิวินาที ไม่ต้องรอขึ้นคลาวด์ ลดภาระแบนด์วิดท์และความเสี่ยงจากเน็ตขาด AI ตรวจจับความผิดปกติได้จริง — โมเดลเรียนรู้พฤติกรรมปกติของเครื่องจักรแต่ละตัว แล้วแจ้งเตือนเมื่อพฤติกรรมเบี่ยงเบน โดยไม่ต้องรอ failure label ที่มีน้อยมากในโรงงานจริง การผสานระบบที่จำเป็นเริ่มเป็นมาตรฐาน — Digital Twin + CMMS (ระบบซ่อมบำรุง) + ERP + Edge + 5G กำลังถูกออกแบบให้ทำงานร่วมกันตั้งแต่ต้น ไม่ใช่ต่อทีหลัง เซ็นเซอร์ IIoT ติดตั้งภาคสนามเพื่อมอนิเตอร์คุณภาพน้ำและอากาศ — โมเดลมูลค่าเดียวกันกับที่ใช้กับแรงสั่น อุณหภูมิ และแรงดันในงานบำรุงรักษาเชิงคาดการณ์ (ภาพ:…
Read More
บทวิเคราะห์: Small Language Model บน Edge — เมื่อ AI ย้ายจากคลาวด์ลงมาอยู่ในโรงงานจริงๆ ในปี 2026

บทวิเคราะห์: Small Language Model บน Edge — เมื่อ AI ย้ายจากคลาวด์ลงมาอยู่ในโรงงานจริงๆ ในปี 2026

Article
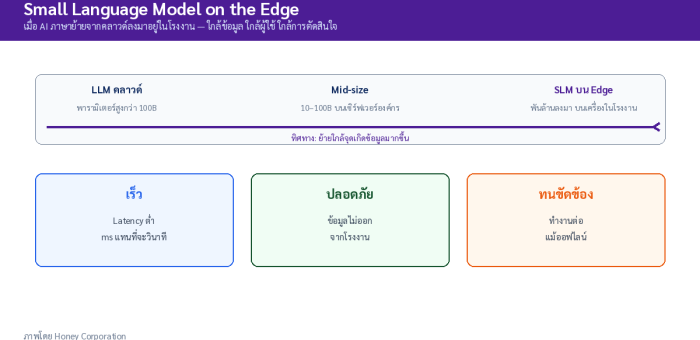
จุดเปลี่ยนที่มาถึงเร็วกว่าที่ใครคาด ตลอดสองปีที่ผ่านมา คนวงการโรงงานพูดถึง Generative AI และ LLM กันเหมือนเป็นของไกลตัว — จริงๆ มันคือบริการคลาวด์ตัวใหญ่ที่โรงงานส่วนใหญ่ “ใช้ไม่ได้จริง” เพราะสามเหตุผลคลาสสิก: Latency สูงเกินไปสำหรับงานควบคุม, ข้อมูลไปอยู่นอกองค์กร และค่าใช้จ่ายต่อการเรียกใช้งานที่ทวีคูณตามปริมาณงาน แต่ปี 2026 ภาพเปลี่ยนไปแล้ว Small Language Model (SLM) ระดับ 1–3 พันล้านพารามิเตอร์กำลังกลายเป็นคำตอบที่จับต้องได้ของโรงงานอุตสาหกรรม สัญญาณที่ชัดที่สุดมาจากงานวิจัยสองชิ้นล่าสุดบน arXiv ที่ทดสอบ SLM ในสถานการณ์จริงของโรงงาน ไม่ใช่แค่ Benchmark ในห้องแล็บ โรงงานสายไฟฟ้าและอิเล็กทรอนิกส์คือกลุ่มแรกๆ ที่ได้ประโยชน์จาก SLM ระดับ Edge — ที่ซึ่ง Latency และความเป็นส่วนตัวของข้อมูลสำคัญที่สุด (ภาพ: Wikimedia Commons) หลักฐานที่ 1: SLM คุม Process Control ได้จริงใน Closed-Loop งานวิจัย “Closed-Loop Control with Rule-Aligned Small Language Models” (มิถุนายน 2026) ทดลองใช้ SLM ขนาดเพียง 1.5B พารามิเตอร์ ทำหน้าที่สร้างและปรับแต่ง Control Policy จาก Requirement แบบภาษาธรรมชาติ โดยไม่ต้องเขียนโค้ดควบคุมใหม่ทั้งหมด ระบบประกอบด้วยสามส่วน: Action Agent ที่สร้างคำสั่งควบคุม, ชั้นตรวจสอบความถูกต้องแบบ Symbolic/Digital-Twin ที่จำลองผลลัพธ์ก่อนสั่งจริง และ Reprompting Agent ที่คอยแก้คำสั่งที่ไม่ผ่านการตรวจสอบ ผลการทดลองในงานควบคุมอุณหภูมิ (30 การทดลอง ๆ ละ 500 ขั้น) ระบบทำได้ 91.5% Action Success Rate — ตัวเลขที่น่าประทับใจมากสำหรับโมเดลขนาดเท่านี้ที่รันอยู่บน Edge โดยไม่พึ่งคลาวด์ จุดสำคัญคือโมเดลถูกฝึกด้วยเทคนิค GRPO (Group Relative Policy Optimization) ให้ “เชื่อฟังกฎ” ก่อนที่จะได้รับอิสระในการตัดสินใจ หลักฐานที่ 2: Multimodal SLM ทำงาน Inspection Assistant ได้ใกล้เคียงโมเดลใหญ่ งานวิจัย RobustMAD (มิถุนายน 2026) สร้าง Benchmark แรกที่ออกแบบมาจากสถานการณ์ Deploy จริง…
Read More
บทวิเคราะห์: XR Collaboration Room — เมื่อ Design Review ย้ายไปอยู่ในโมเดล CAD สเกล 1:1

บทวิเคราะห์: XR Collaboration Room — เมื่อ Design Review ย้ายไปอยู่ในโมเดล CAD สเกล 1:1

Article
Design Review ที่กำลังล้าสมัย นับตั้งแต่มี CAD 3 มิติ การทบทวนแบบ (design review) ของโรงงานก็ถูกจำกัดอยู่ที่สองรูปแบบ คือการดูภาพ render บนจอ และการพิมพ์แบบออกมาบนโต๊ะประชุม ทั้งสองแบบมีข้อจำกัดร่วมกันคือ ผู้ร่วมประชุมไม่ได้ "อยู่ใน" ห้วงอุปกรณ์ที่กำลังออกแบบ มุมมอง 1:1 ระยะการเอื้อม และความรู้สึกของพื้นที่จริง ถูกบีบอัดเหลือแค่ภาพบนจอ 27 นิ้ว ยิ่งไปกว่านั้น ทีมออกแบบและทีมผลิตมักอยู่คนละที่ การเดินทางเพื่อประชุมตรวจแบบหนึ่งครั้งกินเวลาหลายวัน ทำให้จำนวนรอบการ review ถูกลดจนเหลือน้อยเกินความจำเป็น และความคิดเห็นของผู้ที่ต้องเป็นคนเดินตามแบบจริง (ช่างติดตั้ง ทีม maintenance) มักถูกละเลย ทีมงานใช้ VR ร่วมกันในห้องจำลอง — แนวคิดเดียวกับ XR design review ที่ทุกคนเห็นโมเดล 3 มิติร่วมกันในสเกลจริง (ภาพ: Wikimedia Commons) XR Collaboration Room ทำงานอย่างไร XR Collaboration Room คือห้องประชุมเสมือนที่ผู้เข้าร่วมสวม headset แล้วพบกันในรูปแบบ avatar ตรงหน้าโมเดล 3 มิติของสายการผลิต อุปกรณ์ หรืออาคาร ที่ import มาจากไฟล์ CAD โดยตรง องค์ประกอบทางเทคนิคที่สำคัญมี 4 ส่วน: Data Preparation: ไฟล์ CAD ต้นฉบับมักหนักเกินไปสำหรับการ render แบบ real-time จึงต้องผ่านกระบวนการ simplification และ level of detail (LOD) เพื่อลดจำนวน polygon โดยคงความถูกต้องเชิงมิติ Co-location ในเชิงเสมือน: ผู้เข้าร่วมทุกคนเห็นโมเดลเดียวกันในตำแหน่งเดียวกัน สามารถชี้ วาดเส้น และตัดชิ้นส่วน (section cut) ได้พร้อมกันแบบ real-time Scale 1:1: จุดเด่นที่จอทำไม่ได้ ผู้เข้าร่วมเดินเข้าไป "ยืน" ข้างแท่นวางเครื่องจักรจำลองแล้วประเมินความสูง ระยะ clearance และทางเข้าออกได้ด้วยตัวเอง Recording: ระบบบันทึก session รวมถึงความคิดเห็นและ markup ที่เกิดขึ้น เพื่อให้คนที่ไม่ได้เข้าร่วมย้อนดูได้ และให้ทีมออกแบบตามลำดับความเห็นที่ถูกบันทึกไว้ โมเดล CAD 3 มิติคือวัตถุดิบตั้งต้นของ XR design review ก่อนผ่านการ simplification ลด…
Read More
บทวิเคราะห์: Uncertainty Quantification — ทำไม Digital Twin ที่ดีต้องบอกว่า “ตัวเลขนี้เชื่อได้แค่ไหน”

บทวิเคราะห์: Uncertainty Quantification — ทำไม Digital Twin ที่ดีต้องบอกว่า “ตัวเลขนี้เชื่อได้แค่ไหน”

Article
เมื่อดิจิทัลทวินบอกว่า "อุณหภูมิจะเป็น 78°C ใน 30 นาที" — คุณควรเชื่อแค่ไหน? ค่าทำนายที่แม่นยำดูเหมือนของดี แต่ในโลกอุตสาหกรรม ตัวเลขเดียวที่ไม่บอกความมั่นใจคือข้อมูลครึ่งๆ กลางๆ ลองนึกภาพสองระบบ: ระบบ A ทำนายอุณหภูมิ 78°C, ระบบ B ทำนาย 78°C ± 6°C พร้อมช่วงความเชื่อมั่น 95% — ทั้งคู่ให้ตัวเลขกลางเดียวกัน แต่การนำไปใช้ตัดสินใจหยุดสายการผลิตหรือไม่ต่างกันคนละเรื่อง นี่คือเหตุผลที่ Uncertainty Quantification (UQ) กำลังกลายเป็นเกณฑ์ใหม่ของดิจิทัลทวินระดับมืออาชีพ ผลลัพธ์การจำลองเชิงตัวเลข ( finite element simulation) — เมื่อพารามิเตอร์ตั้งต้นไม่แน่นอน ผลลัพธ์ที่ได้ก็เป็นการกระจาย ไม่ใช่ค่าเดียว (ที่มา: Wikimedia Commons, CC BY-SA 3.0) ทำไมตัวเลขเดียวจึงไม่พออีกต่อไป รายงานฉบับสำคัญ Foundational Research Gaps and Future Directions for Digital Twins ของ National Academies of Sciences, Engineering, and Medicine (สหรัฐฯ, 2024) ระบุชัดเจนว่า uncertainty quantification ต้องเป็นส่วนหนึ่งของการออกแบบดิจิทัลทวินตั้งแต่ต้น ไม่ใช่ของตกแต่งท้ายโครงการ เพราะความไม่แน่นอนในระบบ twin มีหลายชั้นมากกว่าที่คิด: ชนิดความไม่แน่นอน ต้นกำเนิด ตัวอย่างในโรงงาน Aleatoric ความสุ่มตามธรรมชาติของกระบวนการ ความแปรปรวนของวัตถุดิบแต่ละล็อต, ความผันแปรของอุณหภูมิแวดล้อม Epistemic ความรู้ที่ยังไม่ครบถ้วน สัมประสิทธิ์สึกหรอที่ยังวัดไม่ได้, พฤติกรรมเครื่องจักรที่ยังไม่เคยเจอในข้อมูล Model การทำให้เป็นโมเดล (assumptions, สมการอย่างง่าย) สมการถ่ายเทความร้อนที่ตัดรายละเอียดมุมตายของหม้อต้มออก Numerical ข้อจำกัดของการคำนวณ ขนาด mesh ที่หยาบเกินไปเพื่อให้คำนวณทันเวลาจริง Data / Sensor ความคลาดเคลื่อนของการวัด เซ็นเซอร์อุณหภูมิความแม่นยำ ±0.5°C, ค่า drift หลังใช้งาน, สัญญาณรบกวน ประเด็นสำคัญที่มักถูกมองข้าม: สองชนิดแรกต้องจัดการคนละวิธี Aleatoric เป็นธรรมชาติของกระบวนการ ลดไม่ได้แต่บรรยายได้ด้วยการกระจายความน่าจะเป็น ส่วน Epistemic ลดได้ด้วยการเก็บข้อมูลเพิ่มหรือทดลองเพิ่ม — การแยกแยะให้ออกว่า error ที่เห็นมาจากไหน จึงกำหนดว่าควรลงทุนซื้อเซ็นเซอร์แม่นขึ้น (แก้ data) หรือปรับโมเดล (แก้ model) หรือทั้งคู่ เครื่องมือหลักของ UQ ในงานอุตสาหกรรม…
Read More
Case Study: Twin Decay — เมื่อ Digital Twin คลาดเคลื่อนเงียบๆ จนคนหยุดเชื่อ และวิธีฟื้นความเชื่อมั่นด้วย VVUQ

Case Study: Twin Decay — เมื่อ Digital Twin คลาดเคลื่อนเงียบๆ จนคนหยุดเชื่อ และวิธีฟื้นความเชื่อมั่นด้วย VVUQ

Article
Case Study: ดิจิทัลทวินที่ "เงียบๆ คลาดเคลื่อน" — บทเรียนจากโครงการจำลองระบบทำความเย็น โครงการดิจิทัลทวินจำนวนมากไม่ได้ตายด้วยการพังเด่นตัว แต่ตายอย่างเงียบๆ — ระบบยังเดินอยู่ dashboard ยังสวย ค่าทำนายยังออกมา แต่ไม่มีใครเชื่อมันอีกแล้ว เพราะตัวเลขคลาดเคลื่อนจากความจริงมากขึ้นเรื่อยๆ จนทีมผลิตกลับไปใช้สมุดบันทึกและประสบการณ์ กรณีศึกษาสมมติข้างนี้รวบรวมจากรูปแบบความล้มเหลวที่พบบ่อยในโครงการจำลองระบบอุตสาหกรรม เพื่อเป็นแผนที่ป้องกันสำหรับทีมที่กำลังจะเริ่ม ห้องควบคุม SCADA — จุดที่ทีมผลิตใช้ตัดสินใจทุกวัน ถ้าค่าทำนายของดิจิทัลทวินเริ่มเบี่ยงจากค่าจริง ความเชื่อมั่นจะหายไปเร็วกว่าที่คิด (ที่มา: Wikimedia Commons, CC BY-SA 4.0) สถานการณ์: โครงการที่เริ่มด้วยดี โรงงานผลิตอาหารแห่งหนึ่งลงทุนสร้างดิจิทัลทวินของระบบทำความเย็น (chiller plant) ที่หล่อเย็นถังหมัก โดยเชื่อมข้อมูลอุณหภูมิ ความดัน และอัตราการไหลจาก SCADA มาป้อนโมเดลทางกายภาพ (physics-based model) ที่จำลองสมการถ่ายเทความร้อน เป้าหมายคือทำนายอุณหภูมิน้ำเย็นที่ตัวถังล่วงหน้า 30 นาที เพื่อปรับตารางเดินเครื่องคอมเพรสเซอร์ให้เหมาะกับช่วงโหลดสูง ช่วง 3 เดือนแรกเป็นเรื่องราวความสำเร็จ: ค่าทำนายตรงกับเซ็นเซอร์จริง คลาดเคลื่อนเฉลี่ยไม่ถึง 0.5°C ทีมงานตื่นเต้นกับ dashboard ที่มองเห็นอนาคตล่วงหน้า แล้วความเชื่อมั่นก็เริ่มถดถอยโดยไม่มีใครทันรู้ตัว อาการ: ความเบี่ยงเบนที่โตขึ้นทีละน้อย หลังเดินระบบ 6 เดือน ค่าทำนายเริ่มเบี่ยงจากค่าจริงเป็น 1.2°C เฉลี่ย และบางช่วงโหลดสูงพุ่งถึง 2.5°C ซึ่งทีมยังอธิบายไม่ได้ว่า "โมเดลผิด" หรือ "เครื่องจักรเปลี่ยน" ปัญหานี้คือสิ่งที่วงวิชาการเรียกว่า twin decay — สภาวะที่โมเดลเสื่อมสภาพเรื่อยๆ เมื่อระบบกายภาพเปลี่ยนไปจากวันที่โมเดลถูกสร้างและพิสูจน์ สาเหตุที่สืบค้นได้จากบันทึกโครงการ ฟิล์มตะกอนในหม้อต้ม (fouling) เปลี่ยนสัมประสิทธิ์ถ่ายเทความร้อน — โมเดลใช้ค่าสัมประสิทธิ์จากข้อมูลตอน commissioning แต่หลอดความร้อนสะสมตะกอนขึ้นเรื่อยๆ ทำให้พฤติกรรมจริงเบี่ยงจากสมการเดิม เซ็นเซอร์ 2 ตัวถูกสอบเทียบใหม่ (recalibration) — ค่าที่เข้าโมเดลเปลี่ยนกระโดด แต่ไม่มีใครบันทึกว่า "input ของโมเดลเปลี่ยนนิยาม" ทำให้การเทียบกับข้อมูลเก่าเสีย โหลดโรงงานเปลี่ยนตามผลิตภัณฑ์ใหม่ — สูตรใหม่ที่หนืดกว่าทำให้ภาระความร้อนที่ถังหมักต่างจากช่วงที่ใช้เทรนและ validate โมเดล (data distribution shift) ไม่มีกระบวนการ revalidation ตามรอบ — ทีมตั้งสมมติฐานว่า "โมเดลถูกแล้วตลอดไป" จึงไม่มีตัวชี้วัดความสดของโมเดล และไม่มีใครรู้ตัวว่าความเชื่อมั่นกำลังไหลออก แนวคิด Control Chart ที่วิศวกรคุ้นเคยนำมาใช้กับ "ความเสื่อมของโมเดล" ได้ — ติดตาม error ระหว่างค่าทำนายกับค่าจริงเหมือนติดตามคุณภาพกระบวนการ แล้วตั้ง control limit ให้แจ้งเตือนเมื่อโมเดลเริ่มเบี่ยง (ที่มา: Wikimedia…
Read More
Knowledge Graph กับ Digital Twin: เมื่อกราฟความรู้ทำให้ดิจิทัลทวินเข้าใจโรงงานของคุณจริงๆ

Knowledge Graph กับ Digital Twin: เมื่อกราฟความรู้ทำให้ดิจิทัลทวินเข้าใจโรงงานของคุณจริงๆ

Article
ทำไมโรงงานจึง "มีข้อมูลมหาศาล แต่ตอบคำถามง่ายๆ ไม่ได้" คำถามที่ดูเหมือนง่ายอย่าง "เครื่องอัดกระแทกเนื้อ (hydraulic press) หมายเลข 7 ที่สาย 2 ใช้ VFD รุ่นไหน ติดตั้งเมื่อไร และเชื่อมกับ HMI ตัวไหน" มักต้องข้ามไปถาม 3 แผนก รอคำตอบ 2 วัน เพราะข้อมูลชิ้นนี้กระจายอยู่ใน Excel ของฝ่ายวิศวกรรม, ไฟล์ PDF แผนภาพ P&ID, ฐานข้อมูล SCADA และใบสั่งซื้อในระบบ ERP — ทุกระบบเก็บ "ข้อเท็จจริง" ไว้คนละที่ แต่ไม่มีระบบใดเก็บ "ความสัมพันธ์" ระหว่างข้อเท็จจริงเหล่านั้นเลย Digital Twin ยุคแรกแก้ปัญหาการ "เห็น" เครื่องจักรผ่านโมเดลสามมิติและข้อมูลเรียลไทม์ได้แล้ว แต่ความท้าทายระยะถัดไปคือการทำให้ดิจิทัลทวิน เข้าใจบริบท (context) ว่าอุปกรณ์แต่ละตัวเป็นใคร อยู่ที่ไหน ติดต่อกับใคร และมีความหมายอย่างไรต่อกระบวนการผลิต — นี่คือจุดที่ Knowledge Graph (กราฟความรู้) เข้ามาเป็นชั้นความหมายที่ขาดหายไป ตัวอย่างโครงสร้าง Knowledge Graph: เอนทิตี (วงกลม) เชื่อมกันด้วยความสัมพันธ์ที่มีความหมายชัดเจน (เส้น) — หลักการเดียวกับที่ใช้จัดระเบียบข้อมูลสินทรัพย์ในโรงงาน (ที่มา: Wikimedia Commons, CC0) Knowledge Graph คืออะไร และต่างจากฐานข้อมูลเดิมอย่างไร ฐานข้อมูลแบบตาราง (relational) ออกแบบมาเพื่อเก็บ "ข้อเท็จจริง" ที่โครงสร้างคงที่ เช่น รายการเครื่องจักร รายการใบสั่งซื้อ ส่วน Knowledge Graph ออกแบบมาเพื่อเก็บ "ความสัมพันธ์" เป็นชุดของ triple สามส่วน: หัวเรื่อง → ความสัมพันธ์ → วัตถุ เช่น Motor-M-201 → isPartOf → Line-2, Motor-M-201 → hasSensor → VIB-014, VIB-014 → measures → VibrationVelocity โครงสร้างพื้นฐานของ RDF triple (subject–predicate–object) ที่ Knowledge Graph ใช้เก็บความสัมพันธ์ระหว่างสินทรัพย์ในโรงงาน (ที่มา: Wikimedia Commons, CC BY-SA 4.0) เมื่อทุกข้อเท็จจริงเชื่อมกันเป็นสายโซ่ของความสัมพันธ์…
Read More