บทวิเคราะห์: WebSocket แก่แล้วจริงหรือ — Head-of-Line Blocking, WebTransport บน QUIC และอนาคต Dashboard แบบ Real-Time ของโรงงาน

บทวิเคราะห์: WebSocket แก่แล้วจริงหรือ — Head-of-Line Blocking, WebTransport บน QUIC และอนาคต Dashboard แบบ Real-Time ของโรงงาน

Article
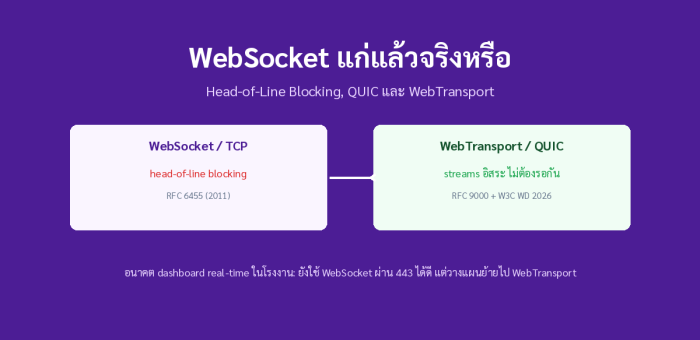
เกือบทุก dashboard แบบ real-time ในโรงงานที่คุณเคยเห็น — Andon board, OEE monitor, energy wall — ส่วนใหญ่ใช้เทคโนโลยีเดียวกันใต้ฝาครอบ: WebSocket โปรโตคอลจากปี 2011 (RFC 6455) ที่เปิดช่องทางสองทางถาวรบน TCP ทำให้เซิร์ฟเวอร์ push ข้อมูลหา browser ได้โดยไม่ต้อง polling คำถามคือ ในปี 2026 ที่ HTTP/3 และ QUIC (RFC 9000) กลายเป็นมาตรฐาน และ W3C เพิ่งประกาศ WebTransport Working Draft ใหม่ล่าสุดเมื่อมีนาคม 2026 — เราควรยังวางแผนสถาปัตยกรรม real-time บน WebSocket อยู่ไหม ปัญหาเก่าที่ยังอยู่: Head-of-Line Blocking จุดอ่อนของ WebSocket ไม่ได้อยู่ที่ตัวโปรโตคอลเอง แต่อยู่ที่ฐานรากคือ TCP ซึ่งรับประกันการส่งถึงตามลำดับ (in-order delivery) เมื่อ packet หนึ่งสูญหาย ทุก byte ที่มาถึงแล้วหลังจากนั้นต้องรอ retransmission แม้ข้อมูลเหล่านั้นจะเป็นคนละ message ก็ตาม — นี่คือ head-of-line blocking ใน dashboard ที่มีทั้งกราฟ trend ชุดใหญ่และ alarm วิกฤตที่ห้ามดองเลย การที่ alarm ติดค้างอยู่หลังกราฟที่กำลัง retransmit คือความเสี่ยงจริงของระบบ monitoring เมื่อ P3 สูญหาย: บน TCP ข้อมูลหลังจากนั้นต้องรอ แต่บน QUIC แต่ละ stream ไหลต่ออย่างอิสระ QUIC แก้ปัญหานี้ที่ราก: stream ที่แยกกันบน connection เดียวมีการรับประกันการส่งถึงแบบอิสระ ข้อมูลของ stream 2 ไม่ต้องรอ stream 1 ที่กำลังส่งใหม่ WebTransport ตาม Working Draft ของ W3C (มีนาคม 2026) ยกระดับความสามารถนี้ขึ้นสู่ browser API: รองรับหลาย stream, unidirectional stream, datagram แบบ…
Read More
API Gateway ในโรงงาน IIoT: ประตูเดียวที่ควบคุมข้อมูล 90 จุดเชื่อมต่อ ให้เหลือ 21 และปลอดภัยขึ้นทั้งระบบ

API Gateway ในโรงงาน IIoT: ประตูเดียวที่ควบคุมข้อมูล 90 จุดเชื่อมต่อ ให้เหลือ 21 และปลอดภัยขึ้นทั้งระบบ

Article
สมมติว่าโรงงานของคุณมีระบบ SCADA เก็บข้อมูลเครื่องจักร ระบบ MES ติดตามการผลิต คลังข้อมูลกลางเก็บ Time-Series Data และแอปพลิเคชันต่าง ๆ กว่า 15 ตัวที่ต้องการดึงข้อมูลจากทั้งหมดนี้ ถ้าทุกแอปพลิเคชันต้องต่อตรงเข้าฐานข้อมูลและระบบควบคุมโดยตรง คุณจะได้จุดเชื่อมต่อแบบ Point-to-Point นับร้อยจุด ที่ไม่มีใครควบคุมการเข้าถึงได้ และแก้ของเดิมทีหนึ่งก็พังสามที่ API Gateway คือคำตอบของปัญหานี้ในระดับสถาปัตยกรรม แร็คอุปกรณ์เครือข่ายและ Patch Panel — เปรียบเสมือนเกตเวย์คือประตูเดียวที่จัดระเบียบการเชื่อมต่อทั้งหมดของโรงงาน — ภาพ: Wikimedia Commons API Gateway คืออะไรในบริบทโรงงาน API Gateway คือชั้นกลาง (Middleware) ที่ทำหน้าที่เป็น "ประตูเดียว" (Single Entry Point) ของข้อมูลและบริการทั้งหมดในโรงงาน แทนที่แอปพลิเคชันจะต่อถึงระบบหลังบ้านโดยตรง ทุกคำขอ (Request) จะผ่านเกตเวย์ที่ทำหน้าที่ 4 เรื่องหลัก: พิสูจน์ตัวตน (Authentication ด้วย OAuth 2.0 / mTLS), กำหนดสิทธิ์ (Authorization แบบ Role-Based), จำกัดปริมาณ (Rate Limiting ป้องกันการดึงข้อมูลจนระบบควบคุมล่วง), และ บันทึกรอยทาง (Audit Logging ทุกการเข้าถึงข้อมูลการผลิต) ตลาด API Management ทั่วโลกมีมูลค่า 10.32 พันล้านดอลลาร์สหรัฐในปี 2026 และคาดว่าจะแตะ 22.11 พันล้านดอลลาร์ภายในปี 2031 หรือเติบโตเฉลี่ยปีละ 16.45% ตามข้อมูล Mordor Intelligence โดย Asia Pacific เป็นภูมิภาคที่เติบโตเร็วที่สุด สะท้อนว่าโรงงานในภูมิภาคเรากำลังเปลี่ยนจากการเชื่อมต่อแบบ Integration-Centric ไปสู่ API-First ที่ทุกข้อมูลถูกเปิดเป็นบริการมาตรฐานที่ควบคุมได้ เปรียบเทียบ: ต่อตรง vs. ผ่าน API Gateway ประเด็น Point-to-Point ตรง ผ่าน API Gateway จำนวนจุดเชื่อมต่อ (15 แอป × 6 ระบบ)90 จุด21 จุด (15+6) การพิสูจน์ตัวตนกระจัดกระจาย แอปละชุดรวมศูนย์ OAuth 2.0 / mTLS Rate Limitingไม่มีจำกัดต่อแอป/ต่อ API ได้ Audit Logไม่มี /…
Read More
How-to: ประเมินความพร้อม AI โรงงานด้วยกรอบ TARI — เช็คลิสต์ 8 มิติ และแผน 90 วัน

How-to: ประเมินความพร้อม AI โรงงานด้วยกรอบ TARI — เช็คลิสต์ 8 มิติ และแผน 90 วัน

Article
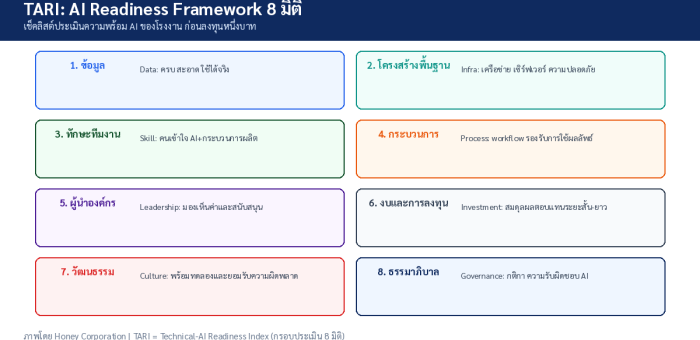
กลางปี 2026 ประเทศไทยมีเครื่องมือใหม่ที่โรงงานควรรู้จัก: Thailand AI Readiness Index (TARI) — ดัชนีวัดความพร้อมด้าน AI ฉบับแรกของประเทศ ผลิตจากความร่วมมือระหว่างหน่วยงานนโยบายด้านอุดมศึกษา วิทยาศาสตร์ วิจัยและนวัตกรรม (MHESI) สภานโยบายการอุดมศึกษา วิทยาศาสตร์ วิจัยและนวัตกรรมแห่งชาติ (NXPO) ร่วมกับภาคเอกชน สาระสำคัญคือ TARI เป็น มาตรฐานกลางระดับชาติ สำหรับประเมินความพร้อม AI อย่างเป็นระบบ ครอบคลุม 3 ระดับ: องค์กร หน่วยงาน (Business Function) และบุคคล — และนี่คือช่วงเวลาที่ดีที่โรงงานไทยควรใช้กรอบนี้จัดระเบียบการเดินทางสู่ AI ของตัวเอง ก่อนที่คู่แข่งจะวัดค่าแล้วไปไกลกว่า ทำไมต้องวัดตอนนี้: รายงานระดับโลกปี 2026 พบว่าองค์กรอุตสาหกรรมกว่า 90% ที่ใช้ AI หน้างานจริงได้ผลลัพธ์วัดได้ แต่เพียง 4% มีกลไกบังคับ Human Oversight ในการตัดสินใจที่ AI สนับสนุน — การวัดความพร้อมจึงไม่ใช่การชะลอตัว แต่คือการป้องกันไม่ให้ AI วิ่งแบบไร้เข็มขัดนิรภัย 8 มิติของ TARI — แปลงเป็น Checklist หน้างานโรงงาน กรอบ TARI ประเมิน 8 มิติ ซึ่งเมื่อแปลงเป็นภาษาโรงงานแล้ว สามารถใช้เป็นแบบสำรวจตัวเองได้ทันที: มิติ TARI คำถามสำรวจสำหรับโรงงาน สัญญาณว่า “ยังไม่พร้อม” 1. กลยุทธ์และภาวะผู้นำ AI มีเป้าหมาย AI ที่ผูกกับตัวเลขธุรกิจหรือไม่ (OEE, Downtime, Yield)? มีแต่คำว่า “ใช้ AI” ในแผน แต่ไม่มี KPI เจ้าของ 2. การจัดการข้อมูล ข้อมูลเครื่องจักรถูกเก็บอัตโนมัติ มีต้นทางชัดเจน และค้นได้หรือไม่? ข้อมูลยังอยู่ในกระดาษ ไฟล์ Excel กระจัดกระจาย หรือฝังใน HMI เก่า 3. เทคโนโลยีและโครงสร้างพื้นฐาน เครื่องจักรหลักเชื่อมต่อข้อมูลได้ (ไม่ใช่แค่เดินเครื่อง)? สายการผลิตสำคัญไม่มีจุดเก็บข้อมูลเลย 4. บุคลากรและทักษะ AI ทีมหน้างานมีคนใช้เครื่องมือวิเคราะห์ข้อมูลได้กี่คน? พึ่ง “คนเดียว” ในบริษัทที่รู้เรื่องข้อมูล 5. ธรรมาภิบาลและการบริหารความเสี่ยง มีกฎว่าใครใช้ AI ตัดสินใจอะไรได้บ้าง และต้องมีคนตรวจกี่ขั้น? ไม่มีใครรู้ว่าหน้างานกำลังใช้ AI หรือ…
Read More
บทวิเคราะห์: Edge หรือ Cloud — ตัวเลขตลาดบอกว่าคำถามนี้ผิดตั้งแต่ต้น (และโรงงานควรถามอะไรแทน)

บทวิเคราะห์: Edge หรือ Cloud — ตัวเลขตลาดบอกว่าคำถามนี้ผิดตั้งแต่ต้น (และโรงงานควรถามอะไรแทน)

Article
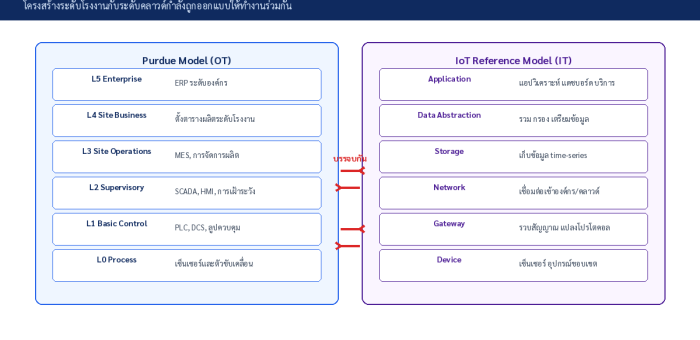
ช่วงสองสามปีที่ผ่านมา วิศวกรโรงงานไทยหลายท่านน่าจะเจอบทสนทนาแบบนี้: “เราควรเอาขึ้นคลาวด์หรือทำ edge ก่อน” คำถามดูเหมือนมีเหตุผล แต่ถ้าดูตัวเลขตลาดล่าสุดแล้ว จะพบว่านี่คือกรอบคิดที่กำลังล้าสมัย เพราะโลกไม่ได้กำลังเลือกระหว่างสองฝั่ง แต่กำลังเติบโต ทั้งสองฝั่งพร้อมกันอย่างก้าวกระโดด ตัวเลขที่ต้องรู้ก่อนตัดสินใจ รายงานล่าสุดของ Grand View Research ระบุว่าตลาด Edge Computing โลกมีมูลค่า 33.4 พันล้านดอลลาร์ในปี 2025 และประมาณการไว้ที่ 46.7 พันล้านดอลลาร์ในปี 2026 ก่อนจะขยายต่อไปถึง 328 พันล้านดอลลาร์ภายในปี 2033 คิดเป็น CAGR 32.1% ตลอดช่วง 2026–2033 — นี่คืออัตราเติบโตที่เร็วกว่าภาพรวมของ smart manufacturing ที่ IoT Analytics ประเมินไว้ที่ CAGR 9.3% (จาก 175 พันล้านดอลลาร์ในปี 2025 สู่ 274 พันล้านดอลลาร์ในปี 2030) ถึงสามเท่าครึ่ง ทำไมถึงเร็วขนาดนั้น? เพราะ edge ไม่ได้แข่งกับคลาวด์ แต่กำลัง เปิดกล่อง use case ใหม่ที่คลาวด์ทำไม่ได้ และเอเชียแปซิฟิกคือภูมิภาคที่โตเร็วที่สุด — Grand View Research ระบุ CAGR ของภูมิภาคเราที่ราว 39% สูงกว่าค่าเฉลี่ยโลก ซึ่งสอดคล้องกับการลงทุน infrastructure ดิจิทัลของไทยในช่วงนี้ Purdue Reference Model เทียบกับ IoT Reference Model — โครงสร้างระดับโรงงานกับระดับคลาวด์กำลังถูกออกแบบให้ทำงานร่วมกัน ไม่ใช่แยกกัน — ภาพ: Wikimedia Commons (CC BY-SA 4.0) คำถามที่ถูกต้อง: Workload นี้ควรอยู่ที่ไหน แทนที่จะถามว่า “เอาขึ้นคลาวด์หรือ edge” ให้ถามว่า “workload นี้มีคุณสมบัติอะไร” แล้วให้คุณสมบัตินั้นตัดสินใจแทน โดยเฉพาะสี่มิติที่ตัดสินได้ชัดเจนที่สุด: มิติการตัดสินใจ ชี้ไปทาง Edge ชี้ไปทาง Cloud Latency ที่ยอมรับได้ ต่ำกว่า ~50 ms เช่น interlock, หยุดเครื่องฉุกเฉิน วินาทีถึงนาที เช่น dashboard, รายงานรายเดือน ปริมาณข้อมูล สูงมากต่อวินาที (vibration 10 kHz, วิดีโอ 30 fps)…
Read More
Case Study: โรงงานอาหาร ‘เสียเครื่อง Edge ตอนตี 2’ — บทเรียนจากการย้าย Orchestration ลงสู่ระดับสายการผลิตด้วย Kubernetes แบบ Lightweight

Case Study: โรงงานอาหาร ‘เสียเครื่อง Edge ตอนตี 2’ — บทเรียนจากการย้าย Orchestration ลงสู่ระดับสายการผลิตด้วย Kubernetes แบบ Lightweight

Article
เรื่องนี้เล่าถึงโรงงานอาหารแห่งหนึ่งในนิคมอุตสาหกรรมภาคตะวันออก ที่เดิมใช้เกตเวย์ IoT แบบ standalone จำนวน 24 ตัวกระจายอยู่ทุกสายการผลิต แต่ละตัวเก็บค่าอุณหภูมิห้องเย็น ความชื้น และสถานะเครื่องจักร แล้วส่งขึ้นคลาวด์ผ่าน MQTT ทุกอย่างทำงานได้ดี… จนกระทั่งคืนหนึ่งที่เกตเวย์ตัวหนึ่งหยุดทำงานเพราะการ์ดหน่วยความจำเสีย และไม่มีใครรู้ตัวจนกระทั่งเช้าวันรุ่งขึ้น ข้อมูลห้องเย็นหายไป 7 ชั่วโมงเต็ม ซึ่งในธุรกิจอาหารแปลว่าต้องเขียนรายงานเหตุการณ์ deviation ยาวเหยียด และต้องประเมินความเสี่ยงต่อสินค้าที่เก็บในช่วงเวลานั้น ปัญหา: ความล้มเหลวแบบเงียบ (Silent Failure) การตรวจสอบย้อนหลังพบว่าปัญหาไม่ได้อยู่ที่ตัวเกตเวย์ แต่อยู่ที่สถาปัตยกรรม ระบบเดิมไม่มีกลไกใดตรวจจับว่าเกตเวย์ “ยังมีชีวิต” หรือไม่ และเมื่อเกตเวย์หนึ่งตัวตาย ก็ไม่มีตัวไหนรับหน้าที่แทน ทีมวิศวกรรมจึงเสนอแนวคิดที่ตอนนั้นดูเกินจำเป็นสำหรับโรงงานอาหาร นั่นคือการนำ container orchestration แบบ Kubernetes รุ่นเบา ลงมาวางที่ระดับสายการผลิต — ไม่ใช่เพื่อความสวยงามทางเทคนิค แต่เพื่อให้ได้สามอย่าง: self-healing, declarative configuration และ rollback ที่ทำได้ในไม่กี่วินาที การวางโหนด Edge หลายชั้นให้ครอบคลุมทุกสายการผลิต คือฐานของ orchestration แบบกระจาย — ภาพ: Wikimedia Commons (CC BY-SA 4.0) ทางออก: Single-node Cluster ที่ทุกสายการผลิต แนวทางที่เลือกไม่ใช่คลัสเตอร์กลางขนาดใหญ่ แต่เป็น คลัสเตอร์เล็กๆ อยู่กับสายการผลิต แต่ละสายมี industrial computer ตั้งแต่ 2 โหนดขึ้นไป รัน Kubernetes distribution แบบ lightweight ที่ตัดส่วนประกอบที่ไม่จำเป็นออก ตัว workload หลักมีสามชนิด: Collector — อ่านค่าจาก PLC ผ่าน OPC UA และเซ็นเซอร์ผ่าน Modbus TCP เขียนลง local time-series storage Rule engine — ประเมินเงื่อนไข alarm เช่น อุณหภูมิห้องเย็นเกิน -18°C นานเกิน 10 นาที แล้วส่งแจ้งเตือนผ่านหลายช่องทาง Forwarder — ส่งข้อมูลแบบ batch ขึ้นคลาวด์ พร้อม store-and-forward เมื่อลิงก์หลุด จุดเปลี่ยนที่สำคัญคือการตั้งค่า liveness/readiness probe ให้กับทุก workload — collector ที่ค้างไม่อ่านค่า PLC…
Read More
Fog Computing กลับมาเป็นข่าวอีกครั้ง: ชั้นคำนวณที่โรงงานไทยมองข้ามไป กำลังกลายเป็นหัวใจของ IIoT ยุค Edge AI

Fog Computing กลับมาเป็นข่าวอีกครั้ง: ชั้นคำนวณที่โรงงานไทยมองข้ามไป กำลังกลายเป็นหัวใจของ IIoT ยุค Edge AI

Article
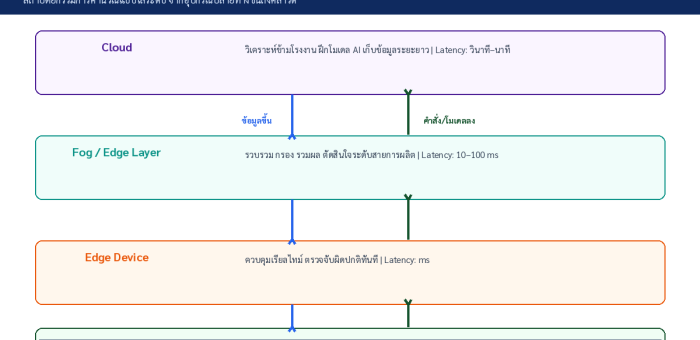
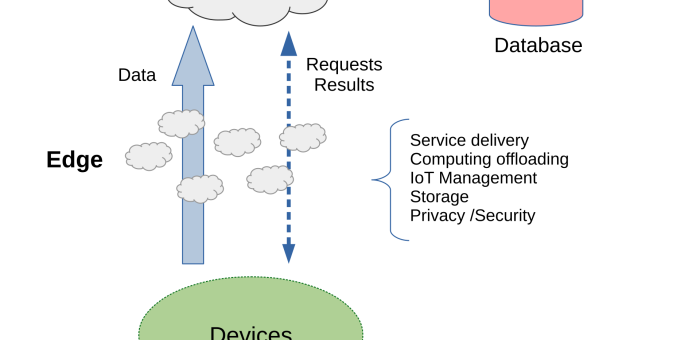
หลายโรงงานในไทยวางแผนธุรกิจดิจิทัลของตัวเองแบบสองขั้ว คือมีอุปกรณ์ IoT และ PLC อยู่ปลายทาง แล้วส่งข้อมูลขึ้นคลาวด์เพื่อประมวลผลทั้งหมด แต่เมื่อปริมาณข้อมูลเพิ่มขึ้นเป็นสิบเท่า และ AI เริ่มถูกใช้ตัดสินใจแบบเรียลไทม์บนพื้นโรงงาน สถาปัตยกรรมแบบสองขั้วนี้ก็เริ่มสะดุด คำตอบที่ถูกที่สุดไม่ใช่การย้ายทุกอย่างกลับมาอยู่ในโรงงาน แต่คือการเพิ่ม ชั้นคำนวณระหว่างกลาง ที่เรียกว่า Fog Computing ซึ่งกำลังกลับมาเป็นที่พูดถึงอีกครั้งในวงการอุตสาหกรรมปี 2026 สถาปัตยกรรมการคำนวณแบบไล่ระดับ ตั้งแต่อุปกรณ์ปลายทาง (Things) ผ่านชั้น Edge/Fog ขึ้นไปถึงคลาวด์ — ภาพ: Wikimedia Commons (CC BY-SA 4.0) ทำไมสองขั้วไม่พออีกต่อไป ลองนึกภาพสายการผลิตที่มีกล้องตรวจคุณภาพ 16 ตัว ส่งภาพความละเอียดสูงกลับคลาวด์เพื่อรันโมเดล Computer Vision ที่ 30 เฟรมต่อวินาที เสียงวิเคราะห์คลื่นเสียงเครื่องจักร และข้อมูล vibration ที่สุ่มที่ 10 kHz — แบนด์วิดท์ที่ต้องใช้ไม่ใช่แค่ “เยอะ” แต่แพงและเปราะ ถ้าเน็ตหลุดแม้เพียง 30 วินาที งานตรวจคุณภาพช่วงนั้นก็หายไปตลอดกาล ในทางกลับกัน การเอาทุกอย่างมาไว้ในเซิร์ฟเวอร์กลางในโรงงานล้มเหลวในอีกแบบ ทีม IT ต้องดูแลฮาร์ดแวร์ ทำ backup อัปเดต patch และขยายระบบทุกครั้งที่เพิ่มสายการผลิต Fog Computing เสนอทางที่สาม — กระจายการคำนวณลงไปในหลายๆ โหนดที่อยู่ใกล้แหล่งข้อมูล แต่ยังจัดการแบบรวมศูนย์ ตามแนวคิดที่ OpenFog Consortium (ซึ่งต่อมาควบรวมเข้ากับ Linux Foundation Edge) เคยสรุปไว้ใน Reference Architecture ว่าต้องมีคุณสมบัติ 8 ด้าน ตั้งแต่ Security, Scalability, Openness, Autonomy, Manageability, Agility, Hierarchical Organization ไปจนถึง Programmability ข้อกำหนดทางเทคนิคที่ต้องรู้ก่อนออกแบบ ประเด็นออกแบบ โจทย์จริงในโรงงาน แนวทาง Fog Latency budget ปิดสวิตช์ฉุกเฉินภายใน 10–50 ms หลังตรวจพบความผิดปกติ ประมวลผลและตัดสินใจที่โหนด Fog ในสายการผลิต ไม่รอ round-trip ไปคลาวด์ แบนด์วิดท์ กล้องตรวจคุณภาพ 16 ตัว ที่ 30 fps กินลิงก์ WAN เกินกว่าที่ลิงก์สำรองจะรับไหว สกัดเฉพาะผลลัพธ์และภาพที่พบ defect ขึ้นคลาวด์ ลดปริมาณข้อมูลขาออกได้ 90%…
Read More
ตลาด SCADA โต CAGR 10% ถึงปี 2032: อ่านตัวเลข MarketsandMarkets ให้ขาด และสิ่งที่โรงงานไทยต้องทำตอนนี้

ตลาด SCADA โต CAGR 10% ถึงปี 2032: อ่านตัวเลข MarketsandMarkets ให้ขาด และสิ่งที่โรงงานไทยต้องทำตอนนี้

Article
ตลาด SCADA ทั่วโลกกำลังเข้าสู่ช่วงเร่งตัว — รายงานฉบับล่าสุดจาก MarketsandMarkets (ตีพิมพ์กันยายน 2026) คาดการณ์ว่ามูลค่าตลาดระบบควบคุมและเฝ้าระวังแบบรวมศูนย์จะเติบโตจาก 13.94 พันล้านดอลลาร์สหรัฐในปี 2026 สู่ 24.69 พันล้านดอลลาร์ในปี 2032 ด้วยอัตราเติบโตเฉลี่ยต่อปี (CAGR) 10.0% ตัวเลขนี้ไม่ได้แค่บอกว่า "มีคนซื้อ SCADA มากขึ้น" แต่สะท้อนการเปลี่ยนแปลงเชิงโครงสร้างว่าระบบ SCADA กำลังถูกมองใหม่จาก "ห้องควบคุมของฝ่ายวิศวกรรม" ไปเป็น "แพลตฟอร์มข้อมูลกลางของทั้งองค์กร" ทีมงาน Honey Corporation ติดตั้งระบบ SCADA และระบบเฝ้าระวังในโรงงานอุตสาหกรรมมากว่าหลายโครงการ และสิ่งที่เราเห็นชัดในรอบ 2-3 ปีคือ ลูกค้าไม่ได้ถามแค่ "จอภาพเก็บค่าจาก PLC ได้กี่จุด" อีกต่อไป แต่ถามว่า "ข้อมูลจาก SCADA จะเชื่อมไปยังระบบ MES, ERP และ Dashboard ผู้บริหารได้อย่างไร" — คำถามที่เปลี่ยนไปนี้แหละคือแรงขับเคลื่อนตัวจริงของตลาด 10.0% ที่รายงานบอก อ่านตัวเลขให้ขาด: SCADA 10.0% หมายความว่าอย่างไร เราลองแยกแยะว่า CAGR 10.0% ในช่วง 2026-2032 มาจากไหน โดยเทียบกับรายงานย่อยที่เกี่ยวข้องจากสำนักเดียวกัน: ตลาด ปีฐาน → ปีเป้า ขนาดตลาด CAGR สิ่งที่บอกเรา SCADA โดยรวม 2026 → 2032 USD 13.94B → 24.69B 10.0% โครงสร้างพื้นฐาน + ซอฟต์แวร์โตพร้อมกันทั้งไลน์ SCADA in BIM (อาคาร) → 2032 USD 16.60B 21.5% อาคารอัจฉริยะ + Digital Twin ดันส่วนผสม BIM Power SCADA (ไฟฟ้า) → 2028 USD 2.9B 7.1% กลุ่มพลังงานเติบโตสม่ำเสมอ ไม่ใช่ตัวขับหลัก ที่มา: MarketsandMarkets, SCADA Market Global Forecast to 2032 (ก.ย. 2026); Power SCADA Market (2024); SCADA in Building Information…
Read More
Time-Series Data Retention และ Compression: ออกแบบนโยบายเก็บข้อมูลโรงงานให้อยู่รอด 10 ปี

Time-Series Data Retention และ Compression: ออกแบบนโยบายเก็บข้อมูลโรงงานให้อยู่รอด 10 ปี

Article
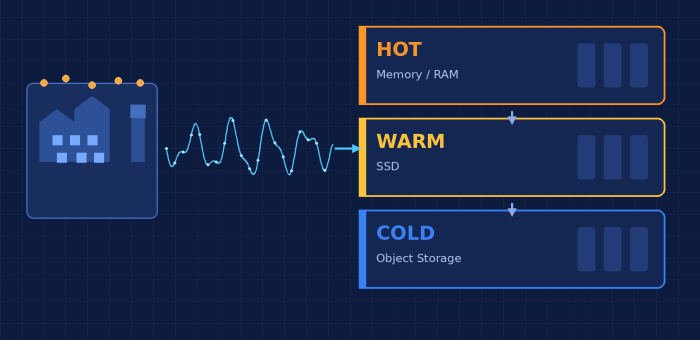
คำถามที่โรงงานเกือบทุกแห่งตอบไม่ได้: ข้อมูล 1 นาทีของเรา เก็บไว้นานแค่ไหน? เมื่อทีมวิศวกรของ Honey Corporation เข้าไปประเมินระบบเก็บข้อมูลโรงงานลูกค้า เรามักเริ่มด้วยคำถามง่ายๆ สามข้อ: “ข้อมูลเซ็นเซอร์ท่านเก็บความละเอียดระดับไหน เก็บไว้กี่ปี และใครเป็นคนตัดสินใจ” คำตอบที่ได้บ่อยที่สุดคือเงียบสนิท เพราะการตั้งค่า retention ในระบบเก็บข้อมูลส่วนใหญ่มาจากค่า default ของระบบ ไม่ใช่นโยบายขององค์กร บทความนี้เจาะลึกมุมที่บทความทั่วไปไม่ค่อยพูดถึง — การออกแบบ นโยบายการเก็บข้อมูลอนุกรมเวลา (Retention Policy) และ เทคนิคบีบอัดข้อมูล (Compression) ที่ทำงานร่วมกัน ซึ่งเป็นตัวชี้ขาดว่าแพลตฟอร์มข้อมูลโรงงานของคุณจะอยู่รอดได้นานแค่ไหนเมื่อจำนวนเซ็นเซอร์โตจาก 500 ตัวเป็น 50,000 ตัว นโยบาย 3 ชั้นที่เราแนะนำเป็นจุดเริ่มต้น: ความละเอียดลดลงตามอายุข้อมูล แต่ระยะเวลาเก็บยืดออกเป็นปี (ภาพประกอบ: Honey Corporation) เบื้องหลังตัวเลข: ทำไม 1 นาที × 5 ปี ถึงไม่ใช่เรื่องง่าย มาคำนวณกันแบบวิศวกรก่อน เซ็นเซอร์แบบที่พบทั่วไปในโรงงานอุตสาหกรรมไทยส่งค่าทุก 1 นาที หนึ่งจุดวัด (tag) หนึ่งปี จะได้ประมาณ 525,600 ค่า ถ้าเก็บแบบไม่บีบอัด ข้อมูล raw ของ 2,000 tags ตลอด 5 ปี จะกินพื้นที่จัดเก็บระดับสิบๆ เทราไบต์ได้ง่ายๆ และยังไม่นับสำเนาสำรองและดัชนี (index) ที่บางระบบใช้พื้นที่มากกว่าตัวข้อมูลเอง ปัญหาที่ตามมามี 3 ข้อ ที่เราเจอซ้ำๆ ในงานจริง: ค่า default ที่โหดร้าย — ระบบเก็บข้อมูลจำนวนมากตั้ง retention เริ่มต้นไว้สั้นมาก เช่น 30-90 วัน พอเกิดปัญหาคุณภาพหรือการร้องเรียนจากลูกค้าที่พบหลังผ่านไป 4 เดือน ข้อมูลช่วงเหตุการณ์ถูกลบไปแล้ว สืบย้อนไม่ได้เลย เก็บทุกอย่างไว้ 1 วินาที ตลอดกาล — กลับกัน บางโรงงานกลัวข้อมูลหายจนเก็บ raw ทุกค่าทุกชั้น ภาระการเก็บรักษาโตเร็วกว่าจำนวนเซ็นเซอร์ ทั้งที่ 95% ของข้อมูลเหล่านั้นไม่มีใครเปิดดูอีกเลย กฎหมายและสัญญา — อุตสาหกรรมอาหารและยาต้องสืบย้อนข้อมูลกระบวนการผลิตได้ตามเกณฑ์ GMP ขณะที่ข้อมูลพลังงานระดับมิเตอร์ใช้สำหรับการอ้างอิงด้านการประหยัดพลังงานและการรายงานคาร์บอนที่ต้องย้อนหลังได้หลายปี นโยบายเดียวทั้งโรงงานจึงใช้ไม่ได้จริง เทคนิคบีบอัดที่คุณต้องเข้าใจก่อนเลือกระบบ ฐานข้อมูลอนุกรมเวลายุคปัจจุบันไม่ได้เก็บข้อมูลเป็นแถวๆ เหมือนฐานข้อมูลทั่วไป แต่ใช้เทคนิคเฉพาะที่ทำให้ข้อมูลโรงงานซึ่ง “เปลี่ยนแปลงทีละนิดและเกิดซ้ำๆ” ถูกบีบอัดได้มหาศาล: หลักการ delta-of-delta ร่วมกับ XOR bit-packing — ข้อมูลเดิมก้อนใหญ่เหลือเศษเสี้ยวโดยไม่เสียความละเอียดแม้แต่บิตเดียว (ภาพประกอบ: Honey…
Read More
บทวิเคราะห์ Cloud Continuum: เลิกถามว่า ‘Edge หรือ Cloud’ แล้วเริ่มกำหนดนโยบายวาง Workload แบบต่อเนื่อง

บทวิเคราะห์ Cloud Continuum: เลิกถามว่า ‘Edge หรือ Cloud’ แล้วเริ่มกำหนดนโยบายวาง Workload แบบต่อเนื่อง

Article
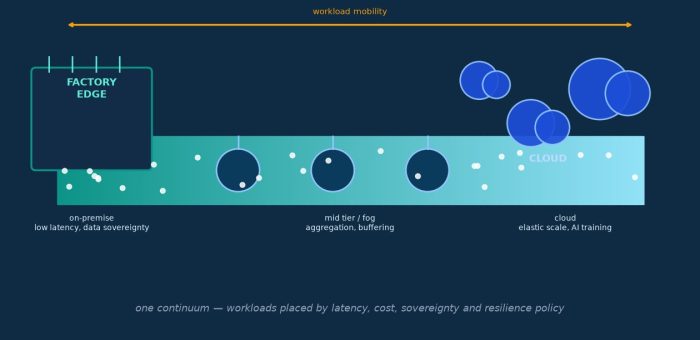
คำถามเก่าที่ยังไม่มีคำตอบสมบูรณ์: "งานนี้ควรอยู่ Edge หรือ Cloud" ตลอดหลายปีที่ผ่านมา การตัดสินใจว่า "งานไหนควรประมวลผลที่ไหน" เป็นคำถามที่ได้คำตอบแบบ binary: ถ้าต้องการเร็วให้อยู่ Edge, ถ้าต้องการ scale ให้อยู่ Cloud แต่เมื่อโรงงานหนึ่งมีทั้ง Edge Computer หลายสิบเครื่อง, on-premise server และบัญชี cloud ผู้ให้บริการหลายราย คำถามไม่ได้เป็นสองทางเลือกอีกต่อไป และเกิดปัญหาใหม่: ภาระการดูแลระบบที่กระจัดกระจาย (distributed sprawl) และ Silo ของข้อมูลที่ย้ายระหว่างกันไม่ได้ แนวคิดที่ตอบโจทย์นี้ในช่วงหลายปีที่ผ่านมาคือ Cloud Continuum — มองทรัพยากรคอมพิวติ้งทั้งหมดขององค์กรเป็น "ช่วงสเปกตรัมต่อเนื่อง" จาก on-premise edge ถึง public cloud ที่เชื่อมถึงกันด้วยเครือข่ายซอฟต์แวร์ (SDN) และ 5G แทนที่จะเป็นกล่องแยกส่วน งาน (workload) สามารถถูกวาง (place) และย้าย (migrate) ตามนโยบาย เช่น latency, อธิปไตยของข้อมูล (sovereignty) และความทนทาน ภาพประกอบ: การวาง workload บน continuum — แกนนอนคือเพดาน latency ที่งานยอมรับได้ (log scale) แกนตั้งคือประโยชน์จาก elasticity งานขวาบน (ฝึกโมเดล AI) ได้ประโยชน์จากคลาวด์มากที่สุด ส่วนงานซ้ายล่าง (motion control) ต้องอยู่ edge เสมอ จาก "เลือกที่" สู่ "กำหนดนโยบาย": วิธีคิดแบบ Continuum จุดเปลี่ยนสำคัญของมุมมองแบบ continuum คือการเปลี่ยนจากคำถาม "งานนี้ควรอยู่ที่ไหน" เป็น "นโยบายอะไรกำหนดว่างานนี้ควรอยู่ที่ไหน" ตัวอย่างเช่น: นโยบาย คำถามที่นโยบายตอบ ผลลัพธ์ต่อการวางงาน Latency ceiling งานยอมรับ delay เกิน X ms ได้หรือไม่? > 100 ms → ขึ้นคลาวด์ได้; < 10 ms → ต้องอยู่ edge/fog Data gravity ข้อมูลเกิดใหม่เร็วแค่ไหน และผู้บริโภคอยู่ไหน? ข้อมูล 1 kHz ต้องกรองที่ edge ก่อนส่งต่อ…
Read More
PREEMPT_RT ใน Linux Kernel 6.12: เมื่อ Edge Computer ของโรงงานกลายเป็น Real-Time Machine อย่างสมบูรณ์

PREEMPT_RT ใน Linux Kernel 6.12: เมื่อ Edge Computer ของโรงงานกลายเป็น Real-Time Machine อย่างสมบูรณ์

Article
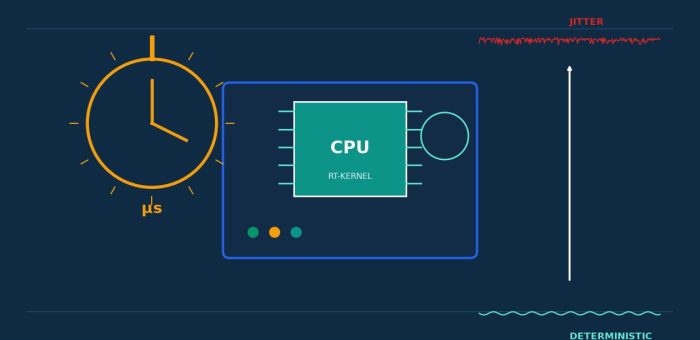
ทำไมโรงงานปี 2026 ยังต้องกังวลเรื่อง "ความหน่วงแบบสุ่ม" บน Edge Computer เมื่อคุณย้ายงานควบคุม การวิเคราะห์ หรือการตรวจจับความผิดปกติ จาก PLC/DCS ลงมาที่ Edge Computer ที่ใช้ระบบปฏิบัติการ Linux ทั่วไป สิ่งหนึ่งที่มักถูกมองข้ามคือ Scheduling Latency แบบสุ่ม (Jitter) — ความหน่วงระหว่าง "เหตุการณ์เกิดขึ้น" กับ "โปรแกรมได้รับโอกาสประมวลผล" ซึ่งบน Linux มาตรฐานอาจแกว่งจากไมโครวินาทีหลักร้อย ไปจนถึง หลายสิบมิลลิวินาที เมื่อระบบพร้อมกันรับภาระงานอื่น เช่น การเข้ารหัส TLS, การบีบอัดไฟล์ log, หรือการอัปเดตฐานข้อมูล local สำหรับ Dashboard หรือ Report ค่า Jitter ระดับนี้ไม่ใช่ปัญหา แต่ถ้างานนั้นคือ การปิด Interlock ภายใน 2 มิลลิวินาที, การสุ่มตัวอย่างแรงสั่นสะเทือน 1,000 ครั้ง/วินาทีแบบ sync กับมุม shaft, หรือการควบคุม Motion แบบ Soft Motion — Latency ที่แกว่ง 30 มิลลิวินาทีโดยไม่ทราบล่วงหน้า อาจหมายถึงชิ้นงานเสีย หรือแย่กว่านั้นคือความเสียหายต่อเครื่องจักร คำตอบที่วงการ Automation ใช้กันมาหลายสิบปีคือ RTOS (Real-Time Operating System) เฉพาะทางบน MCU แต่ปัญหาเปลี่ยนไปเมื่อ Edge AI, Protocol Gateway และ Container เข้ามาอยู่ในตู้คอนโทรลเดียวกัน — คุณต้องการทั้ง Ecosystem ของ Linux (Driver, Library, Toolchain) และ Determinism ของ RTOS ในเครื่องเดียว PREEMPT_RT ใน Linux Kernel 6.12: จุดจบของการติดตั้ง Patch เอง เหตุการณ์สำคัญที่เปลี่ยนเกมในช่วงปลายปี 2024 คือการประกาศรวมแพตช์ PREEMPT_RT เข้าสู่ Linux Kernel 6.12 (หลังพัฒนาต่อเนื่องกว่า 20 ปี) ทำให้ Kernel หลักสามารถเปิดโหมด Fully Preemptible ได้อย่างสมบูรณ์ และ 6.12 ยังเป็น…
Read More