Modbus จาก RTU สู่ TCP: คู่มือ How-to ปลดล็อกข้อมูลอุปกรณ์อุตสาหกรรมจากสายอนุกรมสู่ระบบ IIoT

Modbus จาก RTU สู่ TCP: คู่มือ How-to ปลดล็อกข้อมูลอุปกรณ์อุตสาหกรรมจากสายอนุกรมสู่ระบบ IIoT

Article
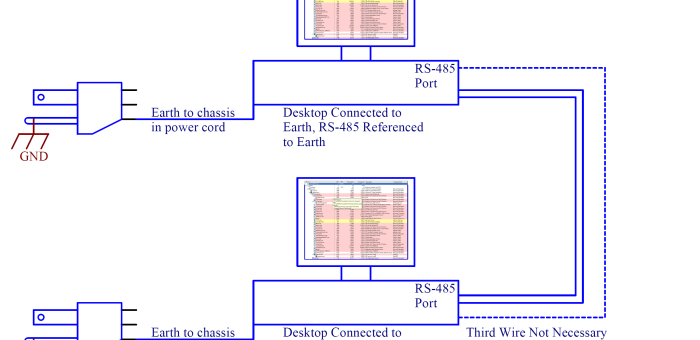
บทนำ: โปรโตคอลอายุ 47 ปีที่ยังไม่ยอมตาย ปี 1979 บริษัท Modicon พัฒนาโปรโตคอลสื่อสารสำหรับ PLC ของตัวเอง ไม่มีใครคิดว่ามันจะกลายเป็นมาตรฐานโลก แต่วันนี้ Modbus กลายเป็นโปรโตคอลที่ฝังตัวอยู่ในอุปกรณ์อุตสาหกรรมมากที่สุดตัวหนึ่งของโลก ทั้งมิเตอร์ไฟฟ้า อินเวอร์เตอร์ ตู้แช่ เครื่องชั่งน้ำหนัก และเซ็นเซอร์ประเภทต่างๆ ปัจจุบันดูแลโดย Modbus Organization โดยเวอร์ชันล่าสุดของข้อกำหนดแอปพลิเคชันคือ V1.1b3 (เม.ย. 2012) เหตุผลที่มันอยู่ได้ทนเพราะความเรียบง่าย: โครงสร้างข้อความมีแค่ Address + Function Code + Data + CRC ไม่มีความซับซ้อนของโปรโตคอลยุคใหม่ อุปกรณ์ราคาประหยัดทำได้ง่าย วิศวกรเข้าใจได้เร็ว และที่สำคัญ เปิดใช้ฟรี ไม่มีลิขสิทธิ์ จึงกลายเป็นภาษากลางที่ทุกแบรนด์ต้องพูดให้ได้ โครงสร้างการเชื่อมต่อ RS-485 ระหว่างอุปกรณ์ 2 ตัว — ฐานล่างของ Modbus RTU ยุคแรกๆ (ที่มา: Wikimedia Commons) ปัญหาจริงในโรงงาน: เกาะข้อมูลบนสายอนุกรม สถานการณ์คลาสสิกที่ทีมงาน Honey Corporation เจอบ่อยในโรงงานไทย: ลูกค้ามี อุปกรณ์ Modbus RTU บน RS-485 เป็นสิบตัว กระจายอยู่ทั่วโรงงาน แต่ละตัวอ่านค่าได้เฉพาะเวลาช่างเอาโน้ตบุ๊กไปเสียบหน้างาน หรือไม่ก็ต้องมี HMI ประจำจุดที่คอย poll ข้อมูลแบบจุดต่อจุด อยากดูยอดรวมแบบเรียลไทม์บนมือถือ ทำไม่ได้เพราะข้อมูลถูกขังอยู่ใน "เกาะ" ของสายอนุกรมแต่ละเส้น ทางออกที่ถูกที่สุดและได้ผลที่สุดในทางปฏิบัติคือ ย้าย Modbus ขึ้นไปวิ่งบนเครือข่าย TCP/IP แล้วรวมศูนย์การเข้าถึงผ่าน Gateway ตัวเดียว ซึ่งเป็นงานที่ทีมงานของเราทำเป็นประจำ ทั้งในงานเก็บข้อมูลตู้แช่อุตสาหกรรมและงานผูกมิเตอร์พลังงานเข้าระบบ Monitoring ของโรงงาน แผงควบคุม PLC — จุดรวมสัญญาณที่ Modbus ยังคงเป็นภาษากลางในการสื่อสารกับอุปกรณ์ฟิลด์ (ที่มา: Wikimedia Commons) เข้าใจโครงสร้างก่อนแปลงร่าง: RTU vs ASCII vs TCP ประเด็น Modbus RTU Modbus ASCII Modbus TCP ตัวกลาง RS-485 / RS-232 RS-485 / RS-232 Ethernet / TCP-IP รูปแบบข้อมูล Binary + CRC-16 ASCII…
Read More
Unified Namespace (UNS): สถาปัตยกรรมข้อมูลกลางยุคใหม่ ที่จบปัญหา Point-to-Point ในโรงงาน IIoT

Unified Namespace (UNS): สถาปัตยกรรมข้อมูลกลางยุคใหม่ ที่จบปัญหา Point-to-Point ในโรงงาน IIoT

Article
ทำไมโรงงานยุค IIoT จึงเจอปัญหา "สปาเกตตี้อินทิเกรชัน" กันทุกแห่ง ถ้าคุณเคยเปิด Excel ที่เก็บรายการ interface ระหว่างระบบในโรงงาน แล้วพบว่ามีเส้นเชื่อมระหว่าง SCADA, MES, ERP, ระบบเก็บพลังงาน และ Dashboard แทบทุกคู่เป็นร้อยเส้น คุณกำลังเจอปัญหาที่วงการอุตสาหกรรมเรียกขึ้นชื่อว่า Point-to-Point Integration Hell ยิ่งจำนวนระบบ (N) เพิ่มขึ้น จำนวนการเชื่อมต่อที่ต้องดูแลจะโตตามสูตร N×(N−1)/2 — มีระบบ 10 ตัวก็คือ 45 การเชื่อมต่อ ทุกจุดต้องเขียนโค้ด mapping แยก ทดสอบแยก และพังคนละจุดกันเงียบๆ ปัญหานี้เป็นผลพลอยได้ของสถาปัตยกรรมแบบชั้นตามแนวคิด ISA-95 / Purdue Model ที่ใช้กันมาหลายสิบปี แบบจำลองนี้ดีมากในเชิง ความปลอดภัยและการแบ่งลำดับชั้นความรับผิดชอบ แต่เมื่อมาถึงยุคที่ธุรกิจต้องการข้อมูลแบบเรียลไทม์ข้ามระบบ มันกลับกลายเป็นกำแพงที่ทำให้ทุก integration ต้องผ่าน "บันได" ทีละขั้น ช้าและเปราะบาง "Unified Namespace คือ single source of truth แบบเรียลไทม์ จัดเรียงตามโครงสร้างธุรกิจ และออกแบบให้เปิดกว้าง ไม่ผูกติดกับผลิตภัณฑ์ใด" — นิยามของ Walker Reynolds ผู้บุกเบิกแนวคิด UNS Unified Namespace (UNS) เสนอทางออกที่ตรงจุด: เปลี่ยนโครงสร้างการเชื่อมต่อจาก point-to-point ที่ต่อกันไปมาเป็น Hub-and-Spoke โดยมี MQTT Broker เป็นศูนย์กลางเดียวที่ทุกระบบมา publish และ subscribe ข้อมูล แทนที่จะต้องเขียน integration เฉพาะทุกคู่ระบบ โรงงานอัตโนมัติยุคใหม่มีระบบผู้ผลิตข้อมูลหลายสิบชุดพร้อมกัน — UNS คือชั้นข้อมูลกลางที่รวมทุกอย่างไว้ที่เดียว (ภาพ: Wikimedia Commons) หัวใจของ UNS: MQTT + โครงสร้าง Topic ตาม ISA-95 UNS ไม่ใช่ซอฟต์แวร์ที่ซื้อมาติดตั้งแล้วจบ แต่เป็น สถาปัตยกรรมการจัดระเบียบข้อมูลที่ประกอบด้วย 3 ส่วนหลัก: MQTT Broker เป็นแกนกลางการส่งข้อมูลแบบ publish/subscribe, โครงสร้าง topic ที่จัดเรียงตามลำดับชั้นธุรกิจ และ payload ที่มีโครงสร้างและความหมายชัดเจน (เช่น JSON ที่ผ่านการ data modeling มาแล้ว) กลไก publish/subscribe ผ่าน MQTT…
Read More
Case Study: Twin Decay — เมื่อ Digital Twin คลาดเคลื่อนเงียบๆ จนคนหยุดเชื่อ และวิธีฟื้นความเชื่อมั่นด้วย VVUQ

Case Study: Twin Decay — เมื่อ Digital Twin คลาดเคลื่อนเงียบๆ จนคนหยุดเชื่อ และวิธีฟื้นความเชื่อมั่นด้วย VVUQ

Article
Case Study: ดิจิทัลทวินที่ "เงียบๆ คลาดเคลื่อน" — บทเรียนจากโครงการจำลองระบบทำความเย็น โครงการดิจิทัลทวินจำนวนมากไม่ได้ตายด้วยการพังเด่นตัว แต่ตายอย่างเงียบๆ — ระบบยังเดินอยู่ dashboard ยังสวย ค่าทำนายยังออกมา แต่ไม่มีใครเชื่อมันอีกแล้ว เพราะตัวเลขคลาดเคลื่อนจากความจริงมากขึ้นเรื่อยๆ จนทีมผลิตกลับไปใช้สมุดบันทึกและประสบการณ์ กรณีศึกษาสมมติข้างนี้รวบรวมจากรูปแบบความล้มเหลวที่พบบ่อยในโครงการจำลองระบบอุตสาหกรรม เพื่อเป็นแผนที่ป้องกันสำหรับทีมที่กำลังจะเริ่ม ห้องควบคุม SCADA — จุดที่ทีมผลิตใช้ตัดสินใจทุกวัน ถ้าค่าทำนายของดิจิทัลทวินเริ่มเบี่ยงจากค่าจริง ความเชื่อมั่นจะหายไปเร็วกว่าที่คิด (ที่มา: Wikimedia Commons, CC BY-SA 4.0) สถานการณ์: โครงการที่เริ่มด้วยดี โรงงานผลิตอาหารแห่งหนึ่งลงทุนสร้างดิจิทัลทวินของระบบทำความเย็น (chiller plant) ที่หล่อเย็นถังหมัก โดยเชื่อมข้อมูลอุณหภูมิ ความดัน และอัตราการไหลจาก SCADA มาป้อนโมเดลทางกายภาพ (physics-based model) ที่จำลองสมการถ่ายเทความร้อน เป้าหมายคือทำนายอุณหภูมิน้ำเย็นที่ตัวถังล่วงหน้า 30 นาที เพื่อปรับตารางเดินเครื่องคอมเพรสเซอร์ให้เหมาะกับช่วงโหลดสูง ช่วง 3 เดือนแรกเป็นเรื่องราวความสำเร็จ: ค่าทำนายตรงกับเซ็นเซอร์จริง คลาดเคลื่อนเฉลี่ยไม่ถึง 0.5°C ทีมงานตื่นเต้นกับ dashboard ที่มองเห็นอนาคตล่วงหน้า แล้วความเชื่อมั่นก็เริ่มถดถอยโดยไม่มีใครทันรู้ตัว อาการ: ความเบี่ยงเบนที่โตขึ้นทีละน้อย หลังเดินระบบ 6 เดือน ค่าทำนายเริ่มเบี่ยงจากค่าจริงเป็น 1.2°C เฉลี่ย และบางช่วงโหลดสูงพุ่งถึง 2.5°C ซึ่งทีมยังอธิบายไม่ได้ว่า "โมเดลผิด" หรือ "เครื่องจักรเปลี่ยน" ปัญหานี้คือสิ่งที่วงวิชาการเรียกว่า twin decay — สภาวะที่โมเดลเสื่อมสภาพเรื่อยๆ เมื่อระบบกายภาพเปลี่ยนไปจากวันที่โมเดลถูกสร้างและพิสูจน์ สาเหตุที่สืบค้นได้จากบันทึกโครงการ ฟิล์มตะกอนในหม้อต้ม (fouling) เปลี่ยนสัมประสิทธิ์ถ่ายเทความร้อน — โมเดลใช้ค่าสัมประสิทธิ์จากข้อมูลตอน commissioning แต่หลอดความร้อนสะสมตะกอนขึ้นเรื่อยๆ ทำให้พฤติกรรมจริงเบี่ยงจากสมการเดิม เซ็นเซอร์ 2 ตัวถูกสอบเทียบใหม่ (recalibration) — ค่าที่เข้าโมเดลเปลี่ยนกระโดด แต่ไม่มีใครบันทึกว่า "input ของโมเดลเปลี่ยนนิยาม" ทำให้การเทียบกับข้อมูลเก่าเสีย โหลดโรงงานเปลี่ยนตามผลิตภัณฑ์ใหม่ — สูตรใหม่ที่หนืดกว่าทำให้ภาระความร้อนที่ถังหมักต่างจากช่วงที่ใช้เทรนและ validate โมเดล (data distribution shift) ไม่มีกระบวนการ revalidation ตามรอบ — ทีมตั้งสมมติฐานว่า "โมเดลถูกแล้วตลอดไป" จึงไม่มีตัวชี้วัดความสดของโมเดล และไม่มีใครรู้ตัวว่าความเชื่อมั่นกำลังไหลออก แนวคิด Control Chart ที่วิศวกรคุ้นเคยนำมาใช้กับ "ความเสื่อมของโมเดล" ได้ — ติดตาม error ระหว่างค่าทำนายกับค่าจริงเหมือนติดตามคุณภาพกระบวนการ แล้วตั้ง control limit ให้แจ้งเตือนเมื่อโมเดลเริ่มเบี่ยง (ที่มา: Wikimedia…
Read More
Cyber Resilience สำหรับโรงงาน: ศาสตร์แห่งการกลับมาผลิตให้เร็วที่สุด เมื่อการโจมตีหยุดไม่ได้

Cyber Resilience สำหรับโรงงาน: ศาสตร์แห่งการกลับมาผลิตให้เร็วที่สุด เมื่อการโจมตีหยุดไม่ได้

Article
เมื่อการโจมตีเปลี่ยนจาก "ขอเงิน" ไปเป็น "หยุดโรงงาน" — คำถามจึงไม่ใช่ว่าจะโดนหรือไม่ แต่คือกลับมาผลิตได้เร็วแค่ไหน ตลอดหลายปีที่ผ่านมา โรงงานอุตสาหกรรมคุ้นเคยกับ ransomware ในรูปแบบ "เข้ารหัสข้อมูล แล้วขอค่าไถ่" แต่แนวโน้มที่ชัดเจนในปี 2026 คือการเปลี่ยนเป้าหมายไปที่ operational disruption — การหยุดการผลิตโดยตรง ไม่จำเป็นต้องเข้ารหัสอะไรเลย อาจเป็นแค่การแก้ control logic ให้ไลน์หยุดเป็นพักๆ หรือปิดระบบ monitoring ชั่วคราวจนโรงงานต้องปิดเครื่องเพื่อความปลอดภัย รายงานจากสายงาน OT security ระบุว่า downtime ที่ไม่ได้วางแผนของบริษัทอุตสาหกรรมในเยอรมนีมีมูลค่าราว 147,000 ยูโรต่อชั่วโมง ตัวเลขนี้อธิบายว่าทำไมผู้โจมตีจึงหันมา "เล่นกับเวลา" แทนการเล่นกับข้อมูล — ทุกชั่วโมงที่ไลน์หยุด คือแรงกดดันที่เพิ่มขึ้นต่อฝ่ายบริหาร และคือ leverage ของฝ่ายโจมตีในการเจรจา ในโลกที่การป้องกันร้อยเปอร์เซ็นต์เป็นไปไม่ได้ Cyber Resilience จึงกลายเป็นคำถามที่วิศวกรโรงงานต้องตอบให้ได้: ไม่ใช่ "จะไม่ให้โดนได้อย่างไร" แต่คือ "เมื่อโดนแล้ว จะกลับมาผลิตได้เร็วแค่ไหน โดยไม่เสียความปลอดภัย" ระบบ IT ที่รองรับการกู้คืนโรงงาน — backup ที่ดีไม่ได้อยู่แค่ในห้องเซิร์ฟเวอร์ แต่ต้องมีสำเนาที่ผู้โจมตีแตะไม่ได้ (ภาพ: Wikimedia Commons, CC BY-SA 3.0) เปลี่ยนกรอบคิด: จาก Prevention เป็น Resilience กรอบคิดเดิมวางเงินไปที่กำแพง — firewall, antivirus, access control ซึ่งยังจำเป็นอยู่ แต่กรอบคิด resilience เพิ่มคำถามอีกสามข้อที่มักถูกลืม: ระบบจะ ตรวจจับการโจมตีได้เร็วแค่ไหน (MTTD), จะ จำกัดความเสียหายไม่ให้ลามไปทั้งโรงงานได้อย่างไร และจะ กู้คืนกลับมาผลิตได้ภายในเวลาเท่าไร (MTTR) มิติ กรอบคิดแบบ Prevention กรอบคิดแบบ Resilience เป้าหมายไม่ให้ผู้โจมตีเข้ามาได้เข้ามาแล้วรอด เห็นเร็ว กลับมาผลิตได้เร็ว ตัวชี้วัดหลักจำนวนการโจมตีที่บล็อกได้MTTD และ MTTR เทียบกับ RTO ที่ธุรกิจกำหนด บทบาทของ backupเป็นงานฝ่าย IT ตามหลังเป็นแกนหลักของการกู้คืน ต้องทดสอบทุกไตรมาส การซ้อมซ้อม table-top ปีละครั้ง (ถ้ามี)restore drill บน testbed ทุกไตรมาส วัดเวลาจริง ผู้รับผิดชอบทีม IT securityทีมผลิต + วิศวกรรม + IT ร่วมกัน หัวใจของการกู้คืนโรงงาน: สำรองสิ่งที่ "เป็นตัวโรงงาน"…
Read More
บทวิเคราะห์: Anti-Surge Control — ทำไม Recycle Valve ตัวเดียวที่เปิดไม่ทันใน 200 มิลลิวินาที ชี้ขาดชะตากรรมของคอมเพรสเซอร์

บทวิเคราะห์: Anti-Surge Control — ทำไม Recycle Valve ตัวเดียวที่เปิดไม่ทันใน 200 มิลลิวินาที ชี้ขาดชะตากรรมของคอมเพรสเซอร์

Article
ในบรรดา Loop ควบคุมทั้งหมดในโรงงานโปรเซส มี Loop หนึ่งที่ไม่มีสิทธิ์ล้มเหลว — Anti-Surge Control ของ Centrifugal Compressor เพราะเมื่อเกิด Surge ขึ้นแล้ว แรงสั่นสะเทือนที่กระทบ Impeller, Thrust Bearing และ Dry Gas Seal จะทำลายเครื่องจักรภายในเวลาเพียงไม่กี่วินาที ผลที่ตามมาคือการเปลี่ยน Rotor ทั้งชุดและเวลาหยุดผลิตที่ยาวนานต่อทุกเหตุการณ์ บทวิเคราะห์นี้ถอดรหัสว่า Surge เกิดขึ้นได้อย่างไร และเพราะเหตุใดหัวใจของการป้องกันจึงอยู่ที่วาล์วตัวเดียวที่ต้องเปิดทันภายในระดับร้อยมิลลิวินาที Centrifugal Compressor ติดตั้งบน Skid พร้อมระบบประกอบ — หน้างานจริงในอุตสาหกรรมโปรเซส (ภาพ: Wikimedia Commons) Surge คืออะไร: วินาทีที่แรงดันไหลย้อนกลับ Centrifugal Compressor เสถียรเฉพาะเมื่อ Flow สูงกว่าค่าต่ำสุดของแต่ละความเร็วรอบและอัตราส่วนความดัน เมื่อ Flow ตกต่ำกว่าจุดนั้น (Surge Point) เครื่องจะไม่สามารถรักษา Differential Pressure ไว้ได้ แก๊สแรงดันสูงด้าน Discharge จะไหลย้อนกลับผ่านเครื่อง ความดันคายตัว เครื่องจักรสร้าง Flow ใหม่ชั่วขณะ แล้ววงจรก็ซ้ำไปซ้ำมา — นี่คือ Surge โดยในเครื่องขนาดเล็กวงรอบการไหลย้อนเกิดที่ความถี่ราว 10–20 Hz สร้างแรงกระชากซ้ำๆ บนชิ้นส่วนหมุนทั้งหมด ความน่ากลัวของ Surge อยู่ที่ความเร็วในการทำลาย: เหตุการณ์เพียง 1–2 วินาทีก็เพียงพอจะทำให้ใบพัดเกิด Fatigue Cracking จากการสั่นพ้อง Thrust Bearing รับแรงเพลามหาศาลระหว่างการไหลย้อน และ Dry Gas Seal เสียหายจากการกลับด้านของ Differential Pressure หลายเหตุการณ์ที่รายงานต่อกันมาจบด้วยการเปลี่ยน Rotor ทั้งชุด Surge Control Line: เส้นเบี่ยง 10–15% ที่ซ่อนความหมายไว้ Anti-Surge Controller คำนวณจุดทำงานของเครื่องแบบ Real-time (มักพล็อตเป็น Head vs Flow หรือ Pressure Ratio vs Reduced Flow) แล้วเทียบกับ Surge Limit Line ที่เก็บไว้ในตัวควบคุม ทางปฏิบัติจะวาง Surge Control Line แบบเว้นระยะ Flow Margin ประมาณ 10–15%…
Read More
How-to: Instrument Loop Check ตั้งแต่ Punch List ถึง Start-up — คู่มือ Commissioning ที่ช่าง Instrument ต้องรู้ก่อนเดินเครื่องครั้งแรก

How-to: Instrument Loop Check ตั้งแต่ Punch List ถึง Start-up — คู่มือ Commissioning ที่ช่าง Instrument ต้องรู้ก่อนเดินเครื่องครั้งแรก

Article
ก่อนโรงงานโปรเซสแห่งหนึ่งจะเดินเครื่องได้ มีขั้นตอนหนึ่งที่ไม่มีใครข้ามได้แต่มักถูกลดบทบาทจนกลายเป็นคอขวดของโครงการ — Instrument Loop Check งานนี้คือช่วงเวลาที่ทุกสายไฟ ทุก Transmitter และทุกวาล์วถูกพิสูจน์ว่าทำงานตรงตาม P&ID จริง บทความนี้เขียนแบบ How-to จากมุมมองคนทำหน้างาน ทีละขั้นตอนตามที่ปฏิบัติจริงในโครงการ Commissioning P&ID คือเอกสารหลักที่ใช้ตรวจสอบระหว่าง Loop Check — ทุก Tag Number ต้องตรงกับสิ่งที่ติดตั้งจริง (ภาพ: Wikimedia Commons) ขั้นที่ 1: เตรียม Loop Folder ให้พร้อมก่อนแตะหน้างาน งาน Loop Check ที่ลื่นไหลเริ่มจากการเตรียมเอกสาร ครึ่งหนึ่งของปัญหาหน้างานเกิดจาก Loop Folder ที่ไม่ตรงกับ As-built รายการที่ต้องมี: P&ID ฉบับล่าสุด, Loop Diagram, Instrument Index, Datasheet ของทุก Tag, Cause & Effect Diagram (สำหรับ SIS) และแบบฟอร์มบันทึกผลที่กำหนด Acceptance Criteria ไว้ล่วงหน้า เช่น ค่าที่อ่านได้ต้องเข้าเกณฑ์ภายใน ±0.5% ของ Span ขั้นที่ 2: Cold Loop Check — พิสูจน์ว่าสายถูกต้องก่อนจ่ายไฟ Cold Loop คือการตรวจสอบเชิงกายภาพก่อนมีกระแสไฟฟ้าไหลจริง: ไล่สายจาก Junction Box ถึง Marshalling Cabinet ตาม Loop Diagram เช็ก Isolation, Shield Ground ฝั่งเดียว, ตรวจ Insulation Resistance ด้วย Megger และยืนยันว่า Tag Number บนแผ่นป้ายตรงกับเอกสาร ข้อผิดพลาดที่พบบ่อยคือสายคู่ Twisted Pair ถูกสลับกันระหว่างฝั่ง Field กับฝั่ง Cabinet ทำให้สัญญาณรบกวนทีหลัง ขั้นที่ 3: Hot Loop Check — จ่ายสัญญาณแล้วดูว่าทุกอย่างพูดกันรู้เรื่อง Hot Loop คือการยิงสัญญาณจำลองเข้า Loop แล้วตรวจว่าค่าวิ่งถูกต้องครบทั้งสาย ทีมหน้างานมักใช้ Loop Calibrator จ่าย 4 / 12 /…
Read More
บทวิเคราะห์: Prescriptive Maintenance (RxM) — เมื่อระบบบำรุงรักษาไม่ใช่แค่ทำนาย แต่บอกว่าควรทำอะไร

บทวิเคราะห์: Prescriptive Maintenance (RxM) — เมื่อระบบบำรุงรักษาไม่ใช่แค่ทำนาย แต่บอกว่าควรทำอะไร

Article
ทุกสายการผลิตเคยเจอคำถามนี้: ระบบแจ้งเตือนว่า "สัญญาณสั่นสะเทือนผิดปกติ" แล้วต่อไปล่ะ? ใครต้องไปดู ต้องซ่อมตอนไหน ถ้ารอก่อนจะเสียผลผลิตเท่าไร ถ้าหยุดเครื่องตอนนี้จะกระทบออร์เดอร์คือไหน — Prescriptive Maintenance (RxM) คือคำตอบที่อุตสาหกรรมกำลังเปลี่ยนไปหาในปี 2026 โดยมีรายงานจาก Hannover Messe ปีนี้ระบุว่า "Predictive Maintenance กำลังกลายเป็น Prescriptive" เป็นหนึ่งใน 12 เทรนด์หลักของปี ห้องควบคุมกลาง — จุดที่การแจ้งเตือนจาก predictive system ต้องถูกแปลงเป็นการตัดสินใจ ซึ่งยังเป็นงานของมนุษย์เต็มตัว (ภาพ: Z22 / Wikimedia Commons, CC BY-SA 4.0) ปัญหาของ Predictive: บอกว่า "จะเกิดอะไร" แต่ไม่บอกว่า "ควรทำอะไร" Predictive Maintenance ที่แข็งแรงแล้วหลายโรงงานยังคงเจอระยะสุดท้ายที่ติดอยู่ที่คน: โมเดลทำนายเก่ง แต่การแปลง prediction ให้เป็นการตัดสินใจยังต้องพึ่งประสบการณ์วิศวกร วิศวกรต้องชั่งน้ำหนักสภาพเครื่องจักรกับตารางผลิต อะไหล่พร้อมหรือไม่ และความสำคัญของสินทรัพย์แต่ละตัว ช่องว่างนี้คือสิ่งที่ RxM มาปิด — จากงานวิเคราะห์เชิงลึกของผู้ให้บริการ CMMS ระดับโลก: "ช่องว่างระหว่างสองกลยุทธ์นี้ไม่ใช่เซ็นเซอร์เพิ่มหรือ dashboard ที่สวยขึ้น แต่คือทีมของคุณได้รับข้อมูลที่ยังต้องตีความ หรือได้รับการตัดสินใจที่ปฏิบัติได้ทันที" RxM ทำงานอย่างไร: 3 ชั้นโครงสร้าง เพื่อให้คำแนะนำที่ "ตัดสินใจแทนได้" ระบบ RxM ต้องมี 3 ชั้นทำงานร่วมกัน ตามการวิเคราะห์ของผู้ให้บริการ CMMS ชั้นนำ: Condition Monitoring หลายโหมดต่อเนื่อง — เก็บสัญญาณ vibration, ultrasound, temperature และ magnetic field ด้วยความละเอียดพอจะเห็น failure signature ระยะต้นทั่วทั้ง fleet เครื่องจักร Automated Diagnostics — ระบุ failure mode เฉพาะเจาะจง ไม่ใช่แค่ "มีบางอย่างเปลี่ยน" การรู้ว่า vibration เพิ่มคือข้อมูล แต่การรู้ว่าแพทเทิร์นนั้นตรงกับ stage-two inner race bearing defect คือจุดเริ่มของการตัดสินใจ Prescription Layer — นำการวินิจฉัยไปชั่งน้ำหนักกับตัวแปรเชิงปฏิบัติการ (ตารางผลิต อะไหล่ในคลัง ความสำคัญของสินทรัพย์ แรงงาน ต้นทุนพลังงาน) แล้วส่งคืนเป็นคำแนะนำเฉพาะพร้อมผลลัพธ์ที่คาดหวัง หลายระบบใช้ digital…
Read More
OT Vulnerability Management: วิธีจัดการช่องโหว่ในระบบควบคุมอุตสาหกรรม ตอนที่ช่องโหว่ Critical เพิ่มขึ้น 49% ในครึ่งปีแรก

OT Vulnerability Management: วิธีจัดการช่องโหว่ในระบบควบคุมอุตสาหกรรม ตอนที่ช่องโหว่ Critical เพิ่มขึ้น 49% ในครึ่งปีแรก

Article
ในช่วงครึ่งปีแรกของปี 2025 มีการเปิดเผยช่องโหว่ที่ส่งผลกระทบต่อระบบ Operational Technology (OT) จำนวน 670 รายการ และ 49% ของช่องโหว่เหล่านี้ถูกจัดระดับความรุนแรงเป็น Critical หรือ High (CVSS ≥ 7.0) ข้อมูลจาก IBM X-Force Vulnerability Database ยังระบุด้วยว่า 21% ของช่องโหว่ระดับ Critical มี exploit code ที่เผยแพร่ต่อสาธารณะ พร้อมใช้งานสำหรับผู้โจมตี เลขเหล่านี้สะท้อนภาพความท้าทายที่ทีมรักษาความปลอดภัย OT ของโรงงานอุตสาหกรรมต้องเผชิญทุกวัน จะทำอย่างไรให้สามารถคัดกรอง ประเมิน และแก้ไขช่องโหว่ได้ทันท่วงที โดยไม่กระทบการผลิตที่ต้องทำงาน 24/7 ไม่หยุดชะงัก บทความนี้จะเจาะลึกกระบวนการ OT Vulnerability Management ตั้งแต่การค้นพบสินทรัพย์ การประเมินความเสี่ยง การจัดลำดับความสำคัญ ไปจนถึงกลยุทธ์การแก้ไขที่เหมาะสมกับสภาพแวดล้อมโรงงานจริง ห้องควบคุม SCADA — จุดที่ช่องโหว่ระดับ Critical สามารถสร้างผลกระทบทางกายภาพได้ทันที (ที่มา: Wikimedia Commons, CC BY-SA) OT Vulnerability Management ต่างจาก IT อย่างไร? การจัดการช่องโหว่ในโลก IT ค่อนข้างตรงไปตรงมา ตรวจพบ แพตช์ รีบูต เสร็จ แต่ในโลก OT เรื่องซับซ้อนกว่ามาก เพราะทุกการเปลี่ยนแปลงบนระบบควบคุมอาจหมายถึงการหยุดสายการผลิต ความเสียหายต่ออุปกรณ์ หรือในกรณีร้ายแรง — อันตรายถึงชีวิตคนงาน ตารางต่อไปนี้เปรียบเทียบความแตกต่างสำคัญ: มิติเปรียบเทียบ IT Vulnerability Management OT Vulnerability Management Patch Window รายสัปดาห์/รายเดือน 3–6 เดือน (ต้องรอ Maintenance Window) วงจรชีวิตอุปกรณ์ 3–5 ปี 10–25 ปี (บางครั้งผู้ผลิตเลิกสนับสนุน) ผลกระทบจาก Scan ต่ำ (ระบบทนได้) สูงมาก (Active Scan อาจ crash PLC) ลำดับความสำคัญ Data Confidentiality Safety & Availability มาก่อน Asset Visibility CMDB ครบถ้วน บ่อยครั้งไม่รู้ว่ามีอุปกรณ์อะไรบ้าง 5 ขั้นตอนของ OT Vulnerability Management…
Read More

ISA-88 Batch Process Control: มาตรฐานที่แยก Recipe ออกจาก Equipment Control — เปลี่ยนสูตรโดยไม่ต้องเขียน PLC ใหม่

Article
ลองนึกภาพโรงงานเภสัชกรรมที่ผลิตยา 50 ชนิด แต่ละชนิดต้องใช้สูตร ขั้นตอน และเงื่อนไขการผลิตที่แตกต่างกัน ถ้าวิศวกรต้องเขียนโปรแกรม PLC แยกสำหรับยาแต่ละชนิด สิ่งที่ตามมาคือโค้ดที่ยากต่อการดูแล ซ้ำซ้อน และเปลี่ยนแปลงยาก — นี่คือปัญหาที่มาตรฐาน ISA-88 (Batch Process Control) เข้ามาแก้ ISA-88 หรือ ANSI/ISA-88 เป็นมาตรฐานสากลที่พัฒนาโดย International Society of Automation สำหรับการควบคุมกระบวนการผลิตแบบ Batch Process — กระบวนการที่ผลิตเป็น "ล็อต" (lot/batch) แทนที่จะผลิตต่อเนื่อง โดยแบ่งการผลิตออกเป็นขั้นตอนที่มีต้นตำรับและตำรับยาเฉพาะ ปรัชญาแกนกลาง: แยก "อะไร" ออกจาก "อย่างไร" หัวใจของ ISA-88 คือการแยกสิ่งที่กระบวนการต้องทำ (Recipe) ออกจากวิธีที่อุปกรณ์ทำงานจริง (Equipment Control) แนวคิดนี้ทำให้: การเปลี่ยนสูตรผลิตภัณฑ์ใหม่ไม่ต้องแก้โค้ด PLC แต่เพียงแก้ Recipe ใน Recipe Editor อุปกรณ์เดียวกันสามารถผลิตหลายผลิตภัณฑ์ได้โดยใช้ Recipe ที่แตกต่างกัน Recipe เดียวกันสามารถใช้กับอุปกรณ์คนละชนิดได้ โดยไม่ต้องเขียนโค้ดใหม่ เปรียบเทียบ: โรงงาน Batch เหมือนห้องครัวอาหาร — Physical Model คือห้องครัว (เตาอบ เตาแม่เหล็ก เครื่องผสม) Procedural Model คือเทคนิคการทำอาหารทั่วไป (อุ่นเตา ผสม อบ พัก) ส่วน Recipe คือเมนูเฉพาะของวันนี้ ที่ใช้ห้องครัวและเทคนิคเดียวกัน แต่ผลลัพธ์ต่างกัน โมเดลทั้ง 3 ของ ISA-88 โรงงานผลิตเคมีและเภสัชกรรมที่ใช้ Batch Process — ISA-88 ช่วยจัดการความซับซ้อนของสูตรและขั้นตอนผลิตที่หลากหลาย (Source: Unsplash) 1. Physical Model (โมเดลอุปกรณ์) อธิบายลำดับชั้นของอุปกรณ์ทางกายภาพในโรงงาน จากสูงไปต่ำ: ระดับ คำอธิบาย ตัวอย่าง Enterprise ชั้นธุรกิจ บริษัทแม่ Site โรงงานเฉพาะที่ โรงงานระยอง Area พื้นที่ผลิต เขตผลิตยาเม็ด Process Cell กลุ่ม Unit ที่ทำ Batch ร่วมกัน สายผลิต Batch A Unit เครื่องปฏิกรณ์หรือภาชนะหลัก Reactor R-101 Equipment…
Read More

High-Performance HMI: Case Study การออกแบบหน้าจอควบคุมที่ลด Alarm Flood 73% และเร่งการตอบสนอง 66%

Article
"หน้าจอเบลอ สีสันสดใสเกินไป ปุ่มเยอะจนไม่รู้จะกดอะไรก่อน" — นี่คือเสียงบ่นของ Operator หน้าเครื่องจักรมาทุกยุคทุกสมัย เมื่อ HMI (Human Machine Interface) หรือ "ส่วนติดต่อระหว่างมนุษย์และเครื่องจักร" ถูกออกแบบมาแบบผิดวิธี ผลลัพธ์ไม่ใช่แค่ความน่ารำคาญ แต่คืออุบัติเหตุในโรงงานที่อาจสูญเสียทั้งชีวิตและทรัพย์สิน บทความนี้นำเสนอ Case Study การออกแบบ HMI ใหม่ให้โรงงานผลิตเคมีแห่งหนึ่ง ที่เปลี่ยนจากหน้าจอรกๆ ที่มีอุบัติเหตุหลายครั้ง ไปสู่ High-Performance HMI ที่ลด Alarm Flood ได้ 73% และลดเวลาตอบสนองต่อเหตุฉุกเฉินลงกว่าครึ่ง ปัญหา: เมื่อ HMI กลายเป็นส่วนหนึ่งของอุบัติเหตุ โรงงานผลิตเคมีขนาดกลางแห่งนี้มี Operator 12 คน ดูแลสายการผลิต 3 สายด้วย HMI แบบเดิมที่ใช้มา 8 ปี ปัญหาที่พบบ่อยได้แก่: Alarm Flood — บางวันมีการแจ้งเตือนถึง 2,400 ครั้งต่อกะ ทำให้ Operator เพิกเฉยต่อ alarm จริง Color Overload — หน้าจอใช้สีแดง เหลือง เขียว ฟ้า ม่วง พร้อมกัน ทำให้ไม่สามารถแยกได้ว่าสีไหนคือสถานการณ์วิกฤต Navigation Complexity — ต้องคลิกผ่าน 4-5 หน้าจอเพื่อดูข้อมูลที่เกี่ยวข้องกับเครื่องจักรเดียว Average Response Time — Operator ใช้เวลาเฉลี่ย 3.5 นาทีตั้งแต่เกิด alarm จนถึงการตัดสินใจแก้ไข ตัวอย่างหน้าจอ Dashboard ที่แสดงข้อมูลแบบ Real-time — High-Performance HMI ที่ดีต้องมีเพียงข้อมูลที่จำเป็น ไม่ใช่ทุกตัวเลขที่วัดได้ (Source: Unsplash) วิธีแก้: High-Performance HMI Design ทีมวิศวกรได้ปรับปรุงระบบตามหลักการ High-Performance HMI ซึ่งเป็นแนวทางการออกแบบที่เน้นการนำเสนอเฉพาะข้อมูลที่จำเป็น โดยมีหลักการดังนี้: 1. ระบบสีแบบ Gray-Scheme เปลี่ยนพื้นหลังจากสีฟ้าสดเป็น สีเทาอ่อน (Gray-Scheme) และใช้สีเพียง 3 ระดับเพื่อสื่อสารความรุนแรง: สี ความหมาย การตอบสนอง เทา (Gray) สถานะปกติ ทุกอย่างทำงานได้ ไม่ต้องดำเนินการ เหลือง (Yellow) คาดการณ์ปัญหา ค่าเกินขอบเขตปกติ ตรวจสอบภายใน 15…
Read More