VR Offline Robot Programming: ก้าวต่อจาก Teach Pendant — สอนงานหุ่นยนต์ในโลกเสมือนก่อนส่งลงไลน์ผลิตจริง

VR Offline Robot Programming: ก้าวต่อจาก Teach Pendant — สอนงานหุ่นยนต์ในโลกเสมือนก่อนส่งลงไลน์ผลิตจริง

Article
โรงงานส่วนใหญ่ในประเทศไทยยังสอนงานหุ่นยนต์อุตสาหกรรมด้วยวิธีเดิมๆ นั่นคือให้ช่างยืนถือ Teach Pendant (จอยควบคุมรูปทรงจอยสติ๊ก) กดทีละแกน เดินหุ่นไปทีละจุด ทั้งที่ไลน์ผลิตต้องหยุดชะงักเพราะหุ่นยนต์กำลังถูก "สอน" อยู่ แถมยังมีความเสี่ยงชนเครื่องจักรหรือ Fixture รอบข้างเสมอ แนวทาง VR Offline Programming (OLP) กำลังเปลี่ยนภาพนี้ โดยให้วิศวกรสวม Headset VR เข้าไป "สอนงาน" หุ่นยนต์เสมือนในโลกดิจิทัลที่จำลอง Cell การผลิตจริงมาทุกมิติ ก่อนส่งโปรแกรมที่ผ่านการตรวจสอบแล้วลงสู่หุ่นยนต์ตัวจริง งานวิจัยล่าสุดที่ตีพิมพ์ใน The International Journal of Advanced Manufacturing Technology (Springer, 2025) ได้นำเสนอระบบ VR-based Offline Programming ที่ผสาน Motion Capture เข้ากับความเป็นจริงเสมือน โดยผู้วิจัยใช้กล้องจับการเคลื่อนไหวของมือและข้อมือผู้สอน แปลงเป็นเส้นทางเคลื่อนที่ (Trajectory) ของ End-effector โดยตรง แทนการกดปุ่มทีละแกนเหมือนเดิม ผลคือกระบวนการสร้างโปรแกรมหุ่นยนต์เร็วขึ้นอย่างมีนัยสำคัญ และลดภาระงานของช่างเฉพาะทางลงอย่างเห็นได้ชัด แผนภาพ: เวิร์กโฟลว์ VR Offline Programming ตั้งแต่สอนงานในโลกเสมือน จำลอง ไปจนถึง Deploy ลงหุ่นยนต์จริง (ภาพ: Honey Corporation) ทำไมการสอนหุ่นยนต์แบบเดิมถึงเป็นคอขวดของโรงงาน ปัญหาของ Teach Pendant ไม่ได้อยู่ที่ตัวเทคโนโลยี แต่อยู่ที่ "ต้นทุนแฝง" ที่โรงงานหลายแห่งมองข้าม: Downtime ของไลน์ผลิต — ทุกนาทีที่หุ่นยนต์ถูกสอนงานคือนาทีที่ไลน์ไม่ได้ผลิต งานศึกษาด้าน Robot Cell Integration หลายชิ้นชี้ว่าการสอนหุ่นยนต์ใหม่หนึ่งงาน (Task) ใช้เวลาหลายชั่วโมงถึงหลายวัน ขึ้นกับความซับซ้อนของ Path ความเสี่ยงต่อคนและเครื่องจักร — การ Jog หุ่นยนต์ใน Cell จริงมีโอกาสชน Fixture หรือส่วนประกอบรอบตัว ความเสียหายที่เกิดขึ้นมักแพงกว่าเวลาที่เสียไปหลายเท่า อินเทอร์เฟซที่ไม่เป็นธรรมชาติ — Teach Pendant บังคับให้ผู้ใช้คิดเป็นพิกัดตัวเลขและระนาบ 2 มิติ ทั้งที่งานจริงเป็นปัญหา 3 มิติเต็มตัว ต้องพึ่งช่างเฉพาะทาง — Process Engineer ที่เข้าใจงานมากที่สุดมักไม่ใช่คนเขียนโปรแกรมหุ่นยนต์ ทำให้ความรู้เชิงกระบวนการถูกแปลงหลายทอดกว่าจะกลายเป็นโปรแกรม ข้อสังเกตสำคัญจากงานวิจัย: ประสบการณ์ของผู้ใช้ (User Experience) ในการโปรแกรมหุ่นยนต์ ส่งผอบโดยตรงต่อคุณภาพของเส้นทางเคลื่อนที่ที่ได้ — VR ไม่ได้แค่ "สวย" แต่เปลี่ยนวิธีคิดของผู้สอนให้เป็นธรรมชาติมากขึ้น กลไกสำคัญ: จากมือมนุษย์ สู่เส้นทางหุ่นยนต์ หัวใจของ…
Read More
Hybrid Twin: เมื่อ Physics-based Model จับมือ Machine Learning เพื่อโมเดลที่แม่นและทนทานกว่า

Hybrid Twin: เมื่อ Physics-based Model จับมือ Machine Learning เพื่อโมเดลที่แม่นและทนทานกว่า

Article
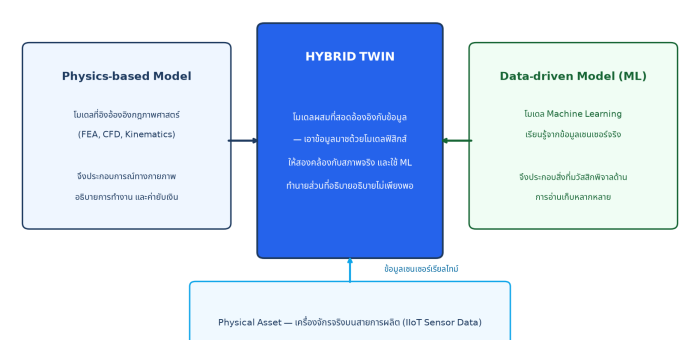
ในโครงการทำ Predictive Twin หลายโครงการที่เราเห็นล้มเหลว มีจุดตายตรงกันคือเลือกใช้ Machine Learning เพียงอย่างเดียว โมเดลทำนายแม่นยำในช่วงทดสอบ แต่พอเครื่องจักรเปลี่ยนสภาวะทำงาน ความแม่นยำก็ไถลลงจนใช้งานจริงไม่ได้ ในทางกลับกัน โมเดลฟิสิกส์ที่แม่นยำสุดๆ ก็มีข้อจำกัดเรื่องเวลาคำนวณและต้นทุนการสร้าง คำตอบที่งานวิจัยอุตสาหกรรมหันไปใช้กันมากขึ้นคือ Hybrid Twin — การผสานจุดแข็งของสองโลกเข้าไว้ในโมเดลเดียว ปัญหา: ทำไมโมเดลชนิดเดียวไม่พอ ลองนึกภาพการทำนายอุณหภูมิแบริ่งของมอเตอร์ไฟฟ้าขนาดใหญ่ วิธีฟิสิกส์ (Physics-based) คือสร้างโมเดลความร้อนและการสั่นสะเทือนจากสมการถ่ายเทความร้อนและพลศาสตร์ วิธีนี้เชื่อถือได้สูงเมื่ออยู่ในเงื่อนไขที่โมเดลออกแบบมา วิศวกรอธิบายได้ว่าทำไมค่าทำนายเป็นเช่นนั้น แต่การสร้างโมเดล FEA หรือ CFD ที่ละเอียดขึ้น มัคช์กับเครื่องจักรจริง ต้องใช้เวลาคำนวณนานและทรัพยากรจำนวนมาก ที่สำคัญข้อผิดพลาดเล็กๆ ในค่าสัมประสิทธิ์ เช่น สัมประสิทธิ์การนำความร้อนของวัสดุ สะสมกันเป็นความคลาดเคลื่อนของผลลัพธ์ ส่วนวิธีข้อมูล (Data-driven) อย่าง Deep Learning เรียนรู้จากข้อมูลเซ็นเซอร์จริงหลายหมื่นจุด ทำนายได้เร็วและแม่นในสภาวะที่เคยเห็น แต่โมเดลไม่เข้าใจกลไกเบื้องหลัง เมื่อเจอสภาวะใหม่ที่ไม่เคยมีในชุดข้อมูลฝึก เช่น เปลี่ยนวัตถุดิบ เปลี่ยนอัตราการผลิต หรือแว่วเสียงแปลกประหลาด โมเดลก็เดาผิดได้อย่างมั่นใจ งานวิจัยที่ตีพิมพ์ในวารสาร Procedia CIRP ปี 2022 เรียกปัญหานี้ว่าช่องว่างระหว่างสองกระบวนทัศน์ และเสนอว่าการผสานกันคือทางออกที่ยั่งยืนกว่า การจำลองทางฟิสิกส์อย่าง crash-test simulation แม่นยำแต่ต้องแลกกับเวลาคำนวณ — ที่มา: Wikimedia Commons (CC BY-SA) แนวทางแก้: โครงสร้างของ Hybrid Twin หลักคิดของ Hybrid Twin มีสามชั้นต่อกัน ชั้นแรกคือโมเดลฟิสิกส์แบบลดทอน (Reduced-order Model) ที่ย่อส่วนจากโมเดล FEA/CFD เต็มรูปแบบให้คำนวณได้เร็วขึ้นหลายเท่าตัว โดยยอมรับความคลาดเคลื่อนเล็กน้อย ชั้นที่สองคือโมเดลแทรกแซง (Correction Model) ที่เป็น Machine Learning หน้าที่เดียวคือเรียนรู้ "ส่วนต่าง" ระหว่างค่าทำนายของโมเดลฟิสิกส์กับค่าจริงจากเซ็นเซอร์ และชั้นที่สามคือวงจรสอบเทียบอัตโนมัติที่อัปเดตโมเดลแทรกแซงอย่างต่อเนื่องเมื่อข้อมูลใหม่ไหลเข้ามา โครงสร้าง Hybrid Twin: โมเดลฟิสิกส์ให้ความเข้าใจกลไก ML ชดเชยส่วนต่างจากข้อมูลจริง — ภาพวาดโดยทีม Honey Corporation ผลลัพธ์ที่ได้คือระบบที่ทำนายเร็วเท่า Machine Learning แต่ยังคงความน่าเชื่อถือนอกเงื่อนไขที่เคยเห็น เพราะเมื่อสภาวะเปลี่ยน โมเดลฟิสิกส์ยังจับพฤติกรรมหลักได้ ส่วน ML แค่ปรับค่าชดเชย แนวทางนี้ถูกนำไปใช้จริงในงานวิจัยระดับสากล เช่น โครงการ Horizon Europe ที่ใช้แนวคิด hybrid modeling ผสาน Digital Twin กับการผลิตจริง และงานวิจัยในวารสาร Journal of Engineering…
Read More
Case Study: ใช้ Digital Twin วิเคราะห์คอขวดและจัดสมดุลสายการผลิต เพิ่ม Throughput 18% โดยไม่ต้องติดตั้งเครื่องจักรเพิ่ม

Case Study: ใช้ Digital Twin วิเคราะห์คอขวดและจัดสมดุลสายการผลิต เพิ่ม Throughput 18% โดยไม่ต้องติดตั้งเครื่องจักรเพิ่ม

Article
สายการผลิตบรรจุภัณฑ์แห่งหนึ่งผลิตชิ้นงานได้เพียง 8,200 ชิ้นต่อกะ ทั้งที่เป้าหมายคือ 9,500 ชิ้น ผู้จัดการโรงงานเชื่อว่าปัญหาคือเครื่องจักรที่เก่าและช้า และวางแผนจะขออนุมัติซื้อเครื่องจักรใหม่ แต่ก่อนตัดสินใจครั้งใหญ่ ทีมวิศวกรเสนอให้สร้าง Digital Twin ของสายการผลิบทั้งสาย แล้วรันการจำลองเพื่อหาคำตอบว่าคอขวด (Bottleneck) อยู่ที่ใดจริงๆ ผลที่ได้คือบทเรียนที่เปลี่ยนวิธีคิดของทั้งโรงงาน ภาพประกอบ: สายการผลิตอัตโนมัติที่มีหลายสถานีทำงานพร้อมกัน การหาคอขวดต้องวิเคราะห์ทั้งระบบ (ที่มา: Unsplash) ปัญหา: Throughput ต่ำกว่าเป้า 15% แต่หาสาเหตุไม่เจอ สายการผลิตแห่งนี้มีสถานี (Station) หลัก 6 ด่าน ได้แก่ การขึ้นรูป (Forming), การบรรจุ (Filling), การปิดผนึก (Sealing), การติดฉลาก (Labeling), การตรวจสอบด้วยกล้อง (Vision Inspection) และการพลีเบคกิ้ง (Palletizing) เมื่อดูจากสเปกเครื่องจักรแต่ละสถานี ทุกเครื่องสามารถผลิตได้มากกว่า 10,000 ชิ้นต่อกะ ทำให้ไม่มีใครสามารถชี้ได้ว่าคอขวดอยู่ที่เครื่องจักรใด ปัญหาจริงคือทุกคนดูแค่ อัตราการผลิตตามสเปก (Nameplate Capacity) แต่ละเครื่องแยกกัน โดยไม่ได้คำนึงถึง ความแปรผัน ที่เกิดขึ้นจริง เช่น เวลาที่ชิ้นงานไหลระหว่างสถานี, เวลาที่เครื่องจักรหยุดเพื่อเติมวัตถุดิบ, และการสะสมของชิ้นงานค้างระหว่างสถานี (WIP Buffer) เป็นตัวแปรที่สเปกเครื่องจักรไม่ได้บอก แนวทางแก้ไข: สร้าง Digital Twin และรัน Discrete Event Simulation ทีมวิศวกรเริ่มจากการติดตั้งเซ็นเซอร์นับชิ้นงานและจับเวลาที่แต่ละสถานี ทำงานสำเร็จ 1 ชิ้น รวบรวมข้อมูลต่อเนื่อง 14 วัน เพื่อสร้างการแจกแจงความน่าจะเป็น (Probability Distribution) ของเวลาทำงานจริงของแต่ละสถานี แทนที่จะใช้ค่าเฉลี่ยจากสเปก จากนั้นสร้างแบบจำลอง Digital Twin ด้วยเทคนิค Discrete Event Simulation (DES) ที่จำลองการไหลของชิ้นงานผ่านสถานีทั้ง 6 ตามลำดับเวลาจริง ข้อมูลสำคัญที่ค้นพบ: เวลาทำงานจริงของสถานี Sealing ไม่ใช่ค่าคงที่ 4.0 วินาทีตามสเปก แต่เป็นการแจกแจงแบบ Triangular ที่ Min = 3.8, Mode = 4.2, Max = 6.5 วินาที — เพราะเครื่องจักรต้องหยุดทุก 50 ชิ้นเพื่อเติมฟิล์มปิดผนึก ภาพประกอบ: การวิเคราะห์ข้อมูลจากแต่ละสถานีการผลิตเพื่อหาคอขวดที่ซ่อนอยู่ (ที่มา: Unsplash) ผลลัพธ์: พบคอขวดที่ไม่มีใครคาดถึง เมื่อรัน DES จำลอง 5,000…
Read More
What-If Analysis ด้วย Digital Twin: เครื่องมือจำลองสถานการณ์เพื่อตัดสินใจผลิตแบบ Data-Driven

What-If Analysis ด้วย Digital Twin: เครื่องมือจำลองสถานการณ์เพื่อตัดสินใจผลิตแบบ Data-Driven

Article
ในโลกการผลิตที่ความผันแปรสูง การตัดสินใจว่า "ถ้าเปลี่ยนตัวแปรนี้ ผลลัพธ์จะเป็นอย่างไร" ไม่สามารถพึ่งพาความรู้สึกหรือประสบการณ์อย่างเดียวอีกต่อไป What-If Analysis ผ่าน Digital Twin คือคำตอบ — เครื่องมือที่ให้ผู้จัดการโรงงานจำลองสถานการณ์หลายพันแบบภายในเวลาไม่กี่นาที ก่อนตัดสินใจลงมือเปลี่ยนแปลงสายการผลิตจริง Digital Twin ที่เราเคยกล่าวถึงในบทความก่อนหน้า — ไม่ว่าจะเป็น Asset Twin, Process Twin หรือ System Twin — ล้วนมีศักยภาพในการรันสถานการณ์สมมติ (Scenario) แต่สิ่งที่ทำให้ What-If Analysis แตกต่างคือ การใช้เทคนิคจำลองทางคณิตศาสตร์ขั้นสูงเพื่อหาคำตอบที่มั่นใจได้ทางสถิติ ไม่ใช่แค่ทดลองดูครั้งเดียวแล้วสรุปผล ภาพประกอบ: การวิเคราะห์ข้อมูลการผลิตผ่านแดชบอร์ดควบคุมกลาง เป็นจุดเริ่มต้นของการสร้างสถานการณ์สมมติ (ที่มา: Unsplash) เทคนิคจำลอง 4 ระดับที่ขับเคลื่อน What-If Analysis What-If Analysis ที่มีประสิทธิภาพต้องอาศัยเทคนิคจำลองที่เหมาะสมกับปัญหา การเลือกผิดเทคนิคอาจให้ผลลัพธ์ที่ทำให้เข้าใจผิดได้ ตารางต่อไปนี้เปรียบเทียบเทคนิคหลัก 4 แบบที่ใช้กันในอุตสาหกรรม: เทคนิค หลักการ เหมาะกับงาน จำนวนรอบจำลอง Discrete Event Simulation (DES) จำลองเหตุการณ์ที่เกิดในช่วงเวลาหนึ่ง เช่น ชิ้นงานเข้าเครื่องจักร รอคิว ประมวลผล สายการผลิต, การจัดคิว, Line Balancing, Capacity Planning 100–10,000 รอบ Monte Carlo Simulation สุ่มค่าจากการแจกแจงความน่าจะเป็น (Normal, Weibull, Triangular) ทดสอบความไวของผลลัพธ์ ประเมินความเสี่ยง, พยากรณ์อายุการใช้งาน, วิเคราะห์ความไม่แน่นอน 10,000–100,000 รอบ Response Surface Methodology (RSM) สร้างพื้นผิวตอบสนองเชิงคณิตศาสตร์เพื่อหาจุดที่เหมาะที่สุด (Optimum) ปรับพารามิเตอร์กระบวนการ, หาสูตรที่เหมาะที่สุด 20–200 รอบ Sensitivity Analysis (Tornado) เปลี่ยนตัวแปรทีละตัวเพื่อดูว่าตัวใดส่งผลต่อผลลัพธ์มากที่สุด จัดลำดับความสำคัญตัวแปรก่อน optimize เท่ากับจำนวนตัวแปร ภาพประกอบ: ข้อมูลจากเซ็นเซอร์และอุปกรณ์ IIoT ถูกส่งเข้าระบบจำลองเพื่อป้อนให้ What-If Analysis (ที่มา: Unsplash) Discrete Event Simulation: หัวใจของการจำลองสายการผลิต Discrete Event Simulation หรือ DES เป็นเทคนิคที่ใช้กันแพร่หลายที่สุดในการจำลองสายการผลิต เพราะสามารถจำลองพฤติกรรมของระบบที่เปลี่ยนแปลงทีละขั้น (Discrete) เช่น ชิ้นงานเข้าเครื่อง CNC, รอคิว 2 นาที, แต่งเครื่อง…
Read More
Topology Optimization: ศาสตร์การออกแบบที่บีบน้ำหนักชิ้นส่วนลงต่ำสุดด้วยอัลกอริทึมและ Additive Manufacturing

Topology Optimization: ศาสตร์การออกแบบที่บีบน้ำหนักชิ้นส่วนลงต่ำสุดด้วยอัลกอริทึมและ Additive Manufacturing

Article
Topology Optimization คือวิธีการออกแบบเชิงคำนวณที่ใช้ขั้นตอนวิธีทางคณิตศาสตร์เพื่อหาการกระจายตัวของวัสดุที่เหมาะสมที่สุด (Optimal Material Distribution) ภายในพื้นที่ออกแบบที่กำหนด (Design Space) โดยมีเป้าหมายลดน้ำหนักหรือเพิ่มความแข็งแรง ผลลัพธ์มักเป็นรูปทรงออร์แกนิกที่มนุษย์ไม่สามารถคิดได้ด้วยสัญชาตญาณ และสามารถผลิตได้จริงผ่าน Additive Manufacturing เท่านั้น หลักการพื้นฐานของ Topology Optimization กระบวนการเริ่มจากการกำหนด Design Space (ปริมาตรสูงสุดที่ชิ้นส่วนอาจอยู่ได้) Load Cases (แรงที่กระทำ) Boundary Conditions (จุดยึด) และ Objective Function (เช่น Minimize Compliance = Maximize Stiffness) จากนั้นอัลกอริทึมจะวนซ้ำกำจัดวัสดุในบริเวณที่ไม่รับแรง (Low Stress Region) และเสริมวัสดุในบริเวณที่รับแรงสูง (High Stress Region) จนกว่าจะบรรลุเป้าหมายภายใต้ข้อจำกัด อัลกอริทึมหลัก 3 ตระกูล SIMP (Solid Isotropic Material with Penalization): วิธีที่นิยมที่สุด กำหนดค่า Density 0–1 ให้แต่ละ Element ค่าต่ำ = กำจัดวัสดุ ค่าสูง = เก็บวัสดุ Penalty Factor (p ≥ 3) บังคับให้ผลลัพธ์เป็น 0 หรือ 1 (ไม่ก้าวกลาง) Level-Set Method: ใช้ฟังก์ชันระดับผิว (Level-Set Function) อธิบายขอบเขตของวัสดุ ขยับขอบเขตไปตาม Gradient ของ Objective เหมาะกับ Surface Modeling และ Smooth Boundary Evolutionary/BESO (Bi-directional Evolutionary Structural Optimization): เพิ่ม-ลด Element ทีละนิดตาม Sensitivity Number เข้าใจง่ายและควบคุมได้ดี พารามิเตอร์และเกณฑ์สำคัญ พารามิเตอร์ คำอธิบาย ค่าทั่วไป ผลกระทบ Volume Fraction เปอร์เซ็นต์วัสดุที่เก็บไว้ 20–40% น้อย = เบาแต่อ่อนแอ Penalty Factor (p) บังคับผลลัพธ์เป็น 0/1 3.0 (มาตรฐาน) สูง = ผลลัพธ์ชัดเจน Mesh Density ความละเอียดตาร่างไซต์ 0.5–2.0…
Read More
AR Head-Mounted Display (HMD): อุปกรณ์สวมใส่แบบดื่มด่ำที่เปลี่ยนการออกแบบและฝึกอบรมในโรงงานด้วย Digital Twin 3 มิติ

AR Head-Mounted Display (HMD): อุปกรณ์สวมใส่แบบดื่มด่ำที่เปลี่ยนการออกแบบและฝึกอบรมในโรงงานด้วย Digital Twin 3 มิติ

Article
AR Head-Mounted Display หรือ HMD คืออุปกรณ์สวมใส่ประเภทหนึ่งที่ให้ประสบการณ์ Augmented Reality แบบดื่มด่ำ (Immersive) มากกว่า Smart Glasses ทั่วไป ด้วยหน้าจอที่กว้างกว่า การติดตามเชิงพื้นที่ (Spatial Tracking) ที่แม่นยำกว่า และความสามารถในการซ้อนภาพดิจิทัล 3 มิติทับบนโลกจริงได้อย่างสมจริง บทความนี้เจาะลึกเทคโนโลยี HMD และความแตกต่างจาก Smart Glasses ในบริบทอุตสาหกรรม AR HMD ต่างจาก Smart Glasses อย่างไร? แม้ทั้งสองจะเป็นอุปกรณ์สวมใส่บนศีรษะ แต่มีจุดประสงค์และขีดความสามารถต่างกันอย่างชัดเจน Smart Glasses ออกแบบเพื่อ การใช้งานต่อเนื่องตลอดวัน โดยแสดงข้อมูลเสริมเล็กน้อย ส่วน AR HMD ออกแบบเพื่อ ประสบการณ์ดื่มด่ำเป็นช่วงเวลาสั้น ที่ต้องการ FOV กว้างและการโต้ตอบ 3 มิติเชิงลึก คุณสมบัติSmart GlassesAR HMD FOV (มุมมอง)20-50 deg90-120 deg น้ำหนัก50-130 กรัม300-600 กรัม เวลาใช้งานต่อเนื่อง8-10 ชม.2-4 ชม. การโต้ตอบเสียง/สายตามือ/ท่าทาง/สายตา กรณีใช้งานPick-by-VisionDesign Review, Training เทคโนโลยีการแสดงผลของ AR HMD เนื่องจาก HMD ต้องแสดงภาพใน FOV ที่กว้างและความละเอียดสูงพอที่จะมองเห็นพิกเซลไม่ได้ (Retina Resolution) เทคโนโลยีหน้าจอจึงก้าวหน้ากว่า Smart Glasses อย่างมาก โดยมี 2 แนวทางหลัก: 1. Optical See-Through (OST) ใช้ Waveguide หรือ Birdbath ให้ผู้สวมมองโลกจริงผ่านเลนส์โปร่งใส พร้อมเห็นภาพดิจิทัลซ้อนทับ ข้อดีคือไม่มีความหน่วง (Latency) ระหว่างโลกจริงกับภาพซ้อนทับ แต่ภาพดิจิทัอาจจางในที่แสงจ้า และ FOV ยังจำกัดที่ประมาณ 50-70 องศา 2. Video See-Through (VST) / Passthrough ผู้สวมไม่ได้มองโลกจริงโดยตรง แต่มองผ่านหน้าจอที่แสดงวิดีโอจากกล้องภายนอกความละเอียดสูง (Passthrough Camera) ทำให้สามารถ ซ้อนภาพดิจิทัลได้แน่นอนและสมบูรณ์ โดยไม่จำกัดด้วยแสง และ FOV กว้างถึง 100-120 องศา แต่ต้องการการประมวลผลความหน่วงต่ำมาก (Motion-to-Photon Latency < 20 ms) ไม่งั้นจะเวียนศีรษะ แนวโน้มล่าสุดคือการใช้…
Read More
Virtual Commissioning ผ่าน Digital Twin: ทดสอบ PLC Logic และสายการผลิตก่อนสร้างจริง

Virtual Commissioning ผ่าน Digital Twin: ทดสอบ PLC Logic และสายการผลิตก่อนสร้างจริง

Article
Virtual Commissioning ผ่าน Digital Twin: ทดสอบสายการผลิตก่อนสร้างจริง Virtual Commissioning คือกระบวนการทดสอบและตรวจสอบการทำงานของระบบอัตโนมัติทั้งหมด ไม่ว่าจะเป็น PLC logic, หุ่นยนต์, ระบบส่งวัสดุ หรือ HMI ผ่าน Digital Twin ในสภาพแวดล้อมเสมือนจริง ก่อนที่จะติดตั้งอุปกรณ์จริงในโรงงาน แนวคิดนี้เปลี่ยน paradigm ดั้งเดิมที่ต้องสร้างสายการผลิตจริงเสร็จก่อนแล้วค่อยเริ่มทดสอบและแก้ปัญหา ซึ่งมักใช้เวลา commissioning นาน 2-6 สัปดาห์ต่อสายการผลิต ตามมาตรฐาน VDI 3681 (Formalized Process Description) และ VDI 4499 (Digital Factory) ของสถาบันวิศวกรเยอรมัน Virtual Commissioning ถูกกำหนดให้เป็นขั้นตอนบังคับในกระบวนการวิศวกรรมสำหรับโรงงานอัจฉริยะ เพื่อลดความเสี่ยงและระยะเวลาในการเดินสายการผลิต (ramp-up) หลักการสำคัญ: "Fail in virtual, succeed in reality" ทุกข้อผิดพลาดที่พบในโลกเสมือนคือเวลาที่ประหยัดได้ในโลกจริง การแก้ bug ใน PLC logic บน Digital Twin ใช้เวลาเพียงไม่กี่ชั่วโมง แต่การแก้บนสายการผลิตจริงอาจใช้เวลาหลายวันและมีต้นทุนสูง สถาปัตยกรรม Virtual Commissioning 1. Behavior Simulation (Plant Simulation) สร้างโมเดลจำลองพฤติกรรมของสายการผลิตทั้งหมด รวมถึงเวลา cycle time ของแต่ละสถานี ความจุ buffer อัตราการไหลของชิ้นงาน และ bottleneck โมเดลนี้ทำงานแบบ discrete event simulation ที่จำลองการเคลื่อนที่ของชิ้นงานผ่านแต่ละขั้นตอน เพื่อยืนยันว่า throughput เป้าหมายทำได้จริง ตัวอย่างเช่น สายการผลิตที่ตั้งเป้า throughput 120 ชิ้น/นาที ต้องตรวจสอบว่า cycle time ของทุกสถานีน้อยกว่า 500 มิลลิวินาทีและมี buffer เพียงพอระหว่างสถานี 2. Kinematic & Dynamic Simulation โมเดล 3 มิติของหุ่นยนต์และกลไกต่างๆ ทำงานด้วยฟิสิกส์จำลอง (physics engine) เพื่อตรวจสอบ reachability, collision detection และ cycle time จริง ระบบคำนวณ trajectory ของหุ่นยนต์ 6 แกน เพื่อยืนยันว่าสามารถเข้าถึงจุดทำงานได้โดยไม่ชนกับ fixture หรือชิ้นงานอื่น…
Read More
Predictive Twin: เมื่อ Digital Twin พยากรณ์ความเสียหายก่อนเกิดด้วย Machine Learning

Predictive Twin: เมื่อ Digital Twin พยากรณ์ความเสียหายก่อนเกิดด้วย Machine Learning

Article
Predictive Twin คืออะไร? เมื่อ Digital Twin เรียนรู้และทำนายอนาคต Predictive Twin คือ Digital Twin ที่ก้าวไปไกลกว่าการแสดงสถานะปัจจุบันของสินทรัพย์ แต่เพิ่มความสามารถในการ พยากรณ์สถานะในอนาคต โดยใช้ Machine Learning ร่วมกับแบบจำลองทางฟิสิกส์ พยากรณ์ว่าสินทรัพย์จะทำงานต่อได้นานเท่าใด เมื่อใดจะเกิดความเสียหาย และสภาวะใดที่จะทำให้เครื่องจักรเสื่อมสภาพเร็วกว่าปกติ แนวคิดนี้อยู่บนพื้นฐานของ Remaining Useful Life (RUL) การประมาณการอายุการใช้งานที่เหลืออยู่ของสินทรัพย์ ซึ่งคำนวณจากแนวโน้มการเสื่อมสภาพ (degradation trend) ที่วิเคราะห์จากข้อมูลเซ็นเซอร์ย้อนหลัง 30-90 วัน ร่วมกับโมเดลพยากรณ์ที่ฝึกด้วยข้อมูลความล้มเหลวในอดีต ความแตกต่างสำคัญ: Digital Twin ทั่วไปตอบคำถาม "ตอนนี้เครื่องเป็นอย่างไร?" แต่ Predictive Twin ตอบคำถาม "เครื่องจะเป็นอย่างไรในอีก 30 วันข้างหน้า และเราควรทำอะไรตอนนี้?" สถาปัตยกรรมของ Predictive Twin Predictive Twin ประกอบด้วย 4 ชั้นการประมวลผลที่ทำงานสอดประสานกัน: ชั้นที่ 1: Data Collection & Feature Extraction ข้อมูลดิบจากเซ็นเซอร์ถูกส่งเข้าระบบด้วยความถี่สูง เช่น vibration sensor ส่งข้อมูลที่ 25.6 kHz ระบบทำ Fast Fourier Transform (FFT) แปลงสัญญาณในโดเมนเวลาเป็นโดเมนความถี่ เพื่อสกัด features สำคัญ เช่น RMS amplitude, peak-to-peak, kurtosis, crest factor และ spectral kurtosis ค่าเหล่านี้บ่งชี้ระดับความเสียหายของตัวเบียริ่งและเฟืองที่ละเอียดกว่าค่าเฉลี่ยทั่วไป ชั้นที่ 2: Physics-Based Degradation Model โมเดลทางฟิสิกส์ เช่น Paris Law สำหรับการเติบโตของรอยร้าว (crack propagation) หรือ Lundberg-Palmgren equation สำหรับอายุการใช้งานตัวเบียริ่ง ใช้คำนวณอัตราการเสื่อมสภาพตามกฎทางวิศวกรรม โมเดลเหล่านี้ให้ผลลัพธ์ที่เชื่อถือได้เมื่อสภาวะการทำงานอยู่ในช่วงที่โมเดลออกแบบมา แต่มีข้อจำกัดเมื่อสภาวะเปลี่ยนแปลงไปจากเดิม ชั้นที่ 3: Machine Learning Prediction โมเดล Machine Learning ที่ใช้บ่อยที่สุดใน Predictive Twin ได้แก่: LSTM (Long Short-Term Memory) เหมาะกับข้อมูลอนุกรมเวลา พยากรณ์แนวโน้มการเสื่อมสภาพล่วงหน้า 7-30 วัน ความแม่นยำ…
Read More
Asset-Level Digital Twin (ดิจิทัลทวินระดับสินทรัพย์): รากฐานของการจำลองเครื่องจักรเชิงอัจฉริยะ

Asset-Level Digital Twin (ดิจิทัลทวินระดับสินทรัพย์): รากฐานของการจำลองเครื่องจักรเชิงอัจฉริยะ

Article
Digital Twin ระดับสินทรัพย์ (Asset-Level Twin) คืออะไร? Digital Twin ระดับสินทรัพย์ หรือ Asset-Level Digital Twin คือการสร้างแบบจำลองเสมือนจริงของสินทรัพย์เดี่ยวหนึ่งชิ้น เช่น ปั๊มน้ำ มอเตอร์ไฟฟ้า วาล์ว หรือคอมเพรสเซอร์ โดยเชื่อมต่อกับข้อมูลเซ็นเซอร์เรียลไทม์จากสินทรัพย์ทางกายภาพอย่างต่อเนื่อง แตกต่างจาก Digital Twin ในวงกว้างที่ครอบคลุมทั้งกระบวนการหรือระบบโรงงาน Asset Twin เจาะจงลึกระดับเครื่องจักรเดียว ทำให้สามารถตรวจสอบพารามิเตอร์ทุกตัวได้อย่างละเอียด ตามกรอบมาตรฐาน ISO 23247 ซึ่งเป็นมาตรฐานสากลสำหรับ Digital Twin ในงานผลิต กำหนดให้ Asset Twin ทำหน้าที่เป็น "เลเยอร์พื้นฐาน" ที่รวบรวมข้อมูลจากชั้น Entity ส่งขึ้นสู่ชั้นฟังก์ชันการวิเคราะห์เพื่อตัดสินใจ โครงสร้างนี้แบ่งเป็น 6 เลเยอร์: Physical Entity, Device Communication, Data Ingestion, Digital Model, Twin Governance และ User Application โครงสร้างข้อมูลที่ Asset Twin ต้องการ เพื่อให้ Asset Twin ทำงานได้อย่างแม่นยำ ต้องอาศัยข้อมูลหลายประเภทที่ไหลเข้าสู่ระบบอย่างต่อเนื่อง: Time-Series Data — การสั่นสะเทือน (vibration) อุณหภูมิ แรงดัน กระแสไฟฟ้า ที่อัปเดตทุก 1–100 มิลลิวินาที CAD/BIM Geometry — โมเดล 3 มิติของสินทรัพย์ที่มีความละเอียดระดับชิ้นส่วนภายใน Asset Metadata — หมายเลขซีเรียล วันที่ติดตั้ง ข้อมูลผู้ผลิต และคู่มือการบำรุงรักษา Historical Records — ประวัติการซ่อมบำรุง การเปลี่ยนอะไหล่ และเหตุการณ์ผิดปกติในอดีต 💡 จุดเด่นของ Asset Twin: สามารถสร้างได้ทีละสินทรัพย์โดยไม่ต้องลงทุนโครงสร้างระบบทั้งโรงงานพร้อมกัน เหมาะกับการเริ่มต้นนำร่อง (pilot) เพื่อพิสูจน์คุณค่าก่อนขยายผล วิธีการสร้างและเชื่อมต่อ Asset-Level Digital Twin 1. การรวบรวมข้อมูลดิบ (Data Acquisition) Asset Twin เริ่มต้นจากการติดตั้งเซ็นเซอร์วัดค่าสำคัญบนสินทรัพย์จริง ตัวอย่างเช่น มอเตอร์ไฟฟ้าขนาด 75 kW ต้องการเซ็นเซอร์วัดการสั่นสะเทือน 3 แกน (sampling rate ≥ 25.6 kHz เพื่อจับความถี่เรโซแนนซ์)…
Read More
Physics-Informed Neural Networks (PINN): ผสานกฎฟิสิกส์เข้ากับ Machine Learning เพื่อการพยากรณ์ที่แม่นยำยิ่งขึ้น

Physics-Informed Neural Networks (PINN): ผสานกฎฟิสิกส์เข้ากับ Machine Learning เพื่อการพยากรณ์ที่แม่นยำยิ่งขึ้น

Article
เมื่อ Machine Learning แบบดั้งเดิมเผชิญข้อจำกัดในการต้องพึ่งพาข้อมูลปริมาณมหาศาล และมักทำนายผิดเพี้ยนเมื่อเจอสภาวะที่ไม่เคยพบมาก่อน Physics-Informed Neural Networks (PINN) จึงเข้ามาเป็นคำตอบที่ผสานความรู้ทางฟิสิกส์เข้ากับพลังของ Deep Learning สร้างโมเดลที่แม่นยำ น่าเชื่อถือ และใช้ข้อมูลน้อยลงอย่างมีนัยสำคัญ PINN คืออะไร? ทำไมอุตสาหกรรมต้องใส่ใจ Physics-Informed Neural Networks (PINN) เป็นสถาปัตยกรรม Neural Network ที่ฝังสมการทางฟิสิกส์ — เช่น Partial Differential Equations (PDE), กฎอนุรักษ์มวล กฎอนุรักษ์พลังงาน หรือสมการความร้อน (Heat Equation) — เข้าไปใน Loss Function โดยตรง แทนที่จะปล่อยให้โมเดลเรียนรู้จากข้อมูลอย่างเดียว PINN จะถูก "บังคับ" ให้เคารพกฎทางฟิสิกส์ตลอดกระบวนการฝึก 💡 หัวใจสำคัญ: PINN ลดปริมาณข้อมูลที่ต้องการในการฝึกโมเดลลงได้ 10-100 เท่า เมื่อเทียบกับ Pure Data-Driven ML เพราะกฎฟิสิกส์ทำหน้าที่เป็น "Regularizer" ที่จำกัดพื้นที่คำตอบที่เป็นไปได้ ปัญหาของ Pure Data-Driven ML ในโรงงาน Machine Learning แบบดั้งเดิมในอุตสาหกรรมมักประสบปัญหาหลายอย่างที่ส่งผลกระทบต่อความน่าเชื่อถือของการทำนาย: Data Scarcity: ข้อมูล failure หรือ anomaly มีน้อยมาก (มักต่ำกว่า 1% ของข้อมูลทั้งหมด) ทำให้โมเดลเรียนรู้ไม่เพียงพอ Extrapolation Failure: โมเดลทำนายผิดพลาดอย่างรุนแรงเมื่อเจอสภาวะที่อยู่นอกช่วงข้อมูลฝึก (Out-of-Distribution) Physical Inconsistency: โมเดลอาจทำนายผลลัพธ์ที่ขัดกับกฎฟิสิกส์ เช่น อุณหภูมิติดลบ หรือการไหลย้อนกลับที่เป็นไปไม่ได้ Black Box Nature: วิศวกรไม่สามารถตรวจสอบได้ว่าโมเดลใช้เหตุผลอะไร ส่งผลต่อความน่าเชื่อถือในการตัดสินใจระดับวิกฤต สถาปัตยกรรม PINN: ทำงานอย่างไร PINN ทำงานโดยกำหนดให้ Loss Function ประกอบด้วย 2 ส่วนหลักที่ต้องถ่วงน้ำหนักให้สมดุล: Total Loss = Data Loss + lambda x Physics Loss โดยที่ Data Loss วัดความคลาดเคลื่อนระหว่างการทำนายกับข้อมูลจริง ส่วน Physics Loss วัดว่าผลลัพธ์ทำนายของโมเดลละเมิดสมการฟิสิกส์มากน้อยเพียงใด ค่า lambda เป็น Hyperparameter ที่ควบคุมน้ำหนักระหว่างข้อมูลกับฟิสิกส์ โดยทั่วไปตั้งอยู่ในช่วง 0.1 ถึง…
Read More