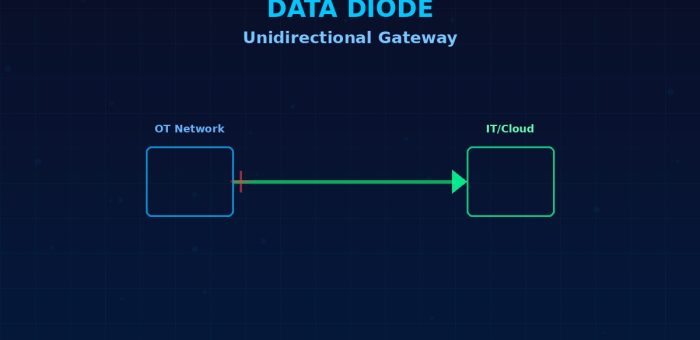
Data Diode และ Unidirectional Gateway: การป้องกันภัยไซเบอร์แบบฮาร์ดแวร์ที่ปลอดภัยที่สุดสำหรับ OT Network

Data Diode และ Unidirectional Gateway: การป้องกันภัยไซเบอร์แบบฮาร์ดแวร์ที่ปลอดภัยที่สุดสำหรับ OT Network

Article
"ข้อมูลได้ทางเดียว แต่ผู้โจมตีเข้ามาไม่ได้เลย" — Data Diode คือสถาปัตยกรรมความปลอดภัยเพียงหนึ่งเดียวที่การันตีการแยกเครือข่าย (Network Isolation) ในระดับกฎของฟิสิกส์ ไม่ใช่แค่การตั้งค่าซอฟต์แวร์ ทำไม Firewalls และ VLANS ยังไม่พอ? ในโลกของ Operational Technology (OT) การแยกเครือข่ายระหว่าง IT และ OT ด้วย Firewall หรือ VLAN Segmentation ถือเป็นมาตรฐานพื้นฐาน แต่เมื่อภัยคุกคามทางไซเบอร์ซับซ้อนขึ้น Firewall ที่อาศัยกฎซอฟต์แวร์เท่านั้นก็มีช่องโหว่ — ทั้งจากการกำหนดค่าผิดพลาด (Misconfiguration), ช่องโหว่เฟิร์มแวร์ หรือการโจมตีแบบ Zero-Day ที่สามารถ Bypass กฎการกรองได้ Data Diode หรือที่เรียกว่า Unidirectional Gateway แก้ปัญหานี้ด้วยแนวทางที่ต่างออกไปโดยสิ้นเชิง: แทนที่จะกรองข้อมูลด้วยซอฟต์แวร์ มันใช้ ออปติกฟาเบอร์ (Fiber Optic) ที่ส่งแสงได้ทางเดียวเท่านั้น — ทำให้การส่งข้อมูลย้อนกลับ (Reverse Communication) เป็นไปไม่ได้ในทางกายภาพ Data Diode คืออะไร? Data Diode คืออุปกรณ์ฮาร์ดแวร์ที่อนุญาตให้ข้อมูลไหลผ่านได้ ทิศทางเดียว (One-Way) เท่านั้น ทำงานโดยใช้ตัวส่งแสง (Transmitter) เช่น Laser LED อยู่ด้านหนึ่ง และตัวรับแสง (Receiver) อยู่อีกด้านหนึ่ง โดยไม่มีองค์ประกอบทางกายภาพใดๆ ที่สามารถส่งสัญญาณย้อนกลับได้ โครงสร้างพื้นฐานของ Data Diode องค์ประกอบ หน้าที่ ระดับความปลอดภัย Transmitter (ฝั่งส่ง) แปลงข้อมูลไฟฟ้าเป็นสัญญาณแสงผ่าน Laser/LED ส่งได้เท่านั้น รับไม่ได้ Receiver (ฝั่งรับ) แปลงสัญญาณแสงกลับเป็นข้อมูลไฟฟ้า รับได้เท่านั้น ส่งไม่ได้ Air Gap Connection เชื่อมต่อด้วย Single-Mode Fiber เส้นเดียว ทางกายภาพไม่มีทางย้อนกลับ Protocol Converter แปลงโปรโตคอล OT (OPC UA, Modbus) เป็นรูปแบบที่เหมาะกับ One-Way Transfer บางรุ่นมี Replication แบบ Read-Only กรณีการใช้งาน Data Diode ในอุตสาหกรรม 1. ส่งข้อมูล SCADA / Historian จาก OT ไปยัง IT…
Read More
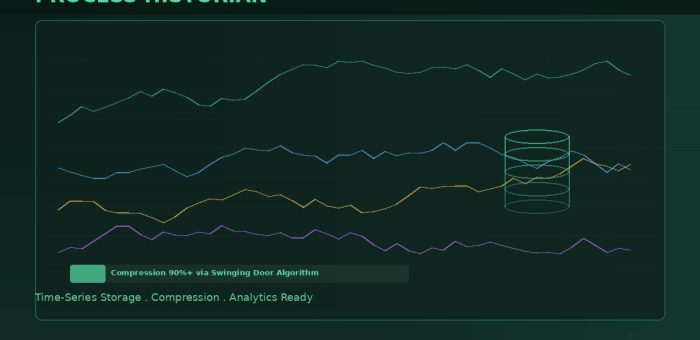
Process Historian: คลังข้อมูลเชิงเวลาที่เปลี่ยน SCADA ให้กลายเป็นแพลตฟอร์มวิเคราะห์ข้อมูลอัจฉริยะสำหรับโรงงานอัตโนมัติ

Process Historian: คลังข้อมูลเชิงเวลาที่เปลี่ยน SCADA ให้กลายเป็นแพลตฟอร์มวิเคราะห์ข้อมูลอัจฉริยะสำหรับโรงงานอัตโนมัติ

Article
ข้อเท็จจริง: โรงงานอัจฉริยะขนาดกลางสร้างข้อมูลมากกว่า 1 เทระไบต์ต่อปี จากเซ็นเซอร์และอุปกรณ์นับหมื่นตัว — หากไม่มีระบบจัดเก็บและเรียกใช้ที่ออกแบบมาเฉพาะสำหรับข้อมูลเชิงเวลา ข้อมูลเหล่านี้จะกลายเป็น Digital Waste ที่ไม่มีวันนำมาใช้ประโยชน์ได้ Process Historian คืออะไร? Process Historian (หรือ Data Historian) คือระบบจัดเก็บข้อมูลแบบ Time-Series ที่ออกแบบเฉพาะสำหรับอุตสาหกรรม ทำหน้าที่รับบันทึกข้อมูลจาก PLC, DCS, SCADA, และเซ็นเซอร์ทุกประเภทอย่างต่อเนื่อง ด้วยอัตราการเก็บข้อมูลตั้งแต่มิลลิวินาทีถึงนาที และเก็บรักษาไว้เป็นปีหรือทศวรรษ โดยไม่สูญเสียความสามารถในการเรียกใช้แบบเรียลไทม์ แม้จะมี Time-Series Database ทั่วไปในตลาด แต่ Process Historian มีความแตกต่างสำคัญคือ การเก็บข้อมูลด้วย Compression Algorithm เฉพาะทาง ที่ลดขนาดข้อมูลได้มากกว่า 90% โดยที่ยังคงความแม่นยำของแนวโน้มข้อมูลไว้ได้ ทำให้สามารถเก็บข้อมูลนับล้าน Tag ได้ในพื้นที่จัดเก็บที่จำกัด ทำไมต้องใช้ Process Historian ไม่ใช่ Database ทั่วไป? Relational Database (SQL) แบบดั้งเดิมถูกออกแบบสำหรับ Transaction Processing ที่เน้นความสมบูรณ์ของข้อมูล (ACID) แต่ Process Historian ต้องเผชิญกับความท้าทายที่แตกต่าง: Write Speed: เขียนข้อมูล 50,000-500,000 Tag ทุก 1 วินาที — SQL Database ไม่สามารถรองรับได้โดยไม่เสียประสิทธิภาพ Data Volume: 1 Tag ที่เก็บทุก 1 วินาทีเท่ากับ 31.5 ล้านค่าต่อปี คูณด้วย 10,000 Tag = 315 พันล้านค่าต่อปี Query Pattern: ส่วนใหญ่เป็นการเรียกดูแนวโน้มในช่วงเวลาหนึ่ง (Time Range Query) ไม่ใช่การค้นหาแบบ Key-Lookup Data Quality: ข้อมูลจากอุปกรณ์อุตสาหกรรมมักมีค่าผิดปกติ (Outlier), หายไป (Missing), หรือรบกวน (Noise) ที่ต้องกรองก่อนบันทึก Compression Algorithm ที่สำคัญ หัวใจของ Process Historian คือวิธีการบีบอัดข้อมูลที่ ลดขนาดได้มากแต่ไม่ทำให้แนวโน้มผิดเพี้ยน Algorithm ที่ใช้กันแพร่หลาย: AlgorithmหลักการอัตราการบีบอัดความเหมาะสมBoxcar (Deviation)เก็บเฉพาะจุดที่เบี่ยงเบนเกินจากเส้นตรงที่กำหนด10:1 - 50:1ข้อมูลที่ค่อนข้างคงที่Swinging Doorเปรียบเทียบความชันสูงสุด/ต่ำสุดจากจุดสุดท้ายที่เก็บ20:1 - 100:1ข้อมูลที่มีทั้งช่วงนิ่งและเปลี่ยนแปลงSlope Projectionพยากรณ์ค่าถัดไปจากแนวโน้ม บันทึกเมื่อผิดพลาดเกินกำหนด30:1 -…
Read More
Retrieval-Augmented Generation (RAG) สำหรับการจัดการความรู้ในโรงงานอัจฉริยะ: เปลี่ยนเอกสารเทคนิคให้กลายเป็นผู้ช่วย AI

Retrieval-Augmented Generation (RAG) สำหรับการจัดการความรู้ในโรงงานอัจฉริยะ: เปลี่ยนเอกสารเทคนิคให้กลายเป็นผู้ช่วย AI

Article
ความรู้ในโรงงานอุตสาหกรรมมักกระจัดกระจายอยู่ทั่วไป — คู่มือเครื่องจักรหลายพันหน้า บันทึกการซ่อมบำรุง ขั้นตอนปฏิบัติมาตรฐาน (SOP) แบบฟอร์มการตรวจสอบ และประสบการณ์ที่สะสมอยู่ในหัวของช่างเทคนิคผู้ช่ำชอง เมื่อผู้เชี่ยวชาญรุ่นเก่าเกษียณ ความรู้เหล่านั้นก็มักหายไปพร้อมกับพวกเขา Retrieval-Augmented Generation (RAG) คือเทคโนโลยีที่เปลี่ยนคลังเอกสารเหล่านี้ให้กลายเป็น "ผู้ช่วยผู้เชี่ยวชาญ" ที่ตอบคำถามได้แม่นยำ อ้างอิงแหล่งที่มา และอัปเดตได้ตลอดเวลา RAG คืออะไร? RAG คือสถาปัตยกรรมที่ผสาน โมเดลภาษาขนาดใหญ่ (Large Language Model) กับ ระบบค้นคืนข้อมูล (Retrieval System) จากฐานความรู้ภายในองค์กร แทนที่จะให้โมเดลตอบจากความรู้ที่ถูกฝึกไว้ตอนสร้างโมเดล (ซึ่งอาจล้าสมัยหรือไม่ตรงกับบริบทเฉพาะของโรงงาน) ระบบจะค้นหาเอกสารที่เกี่ยวข้องจากคลังความรู้ก่อน แล้วจึงนำข้อมูลนั้นมาใช้เป็นบริบทในการสร้างคำตอบ ทำให้ได้ผลลัพธ์ที่ถูกต้อง อ้างอิงได้ และลดปัญหาการแต่งเรื่อง (hallucination) อย่างมีนัยสำคัญ 🔧 หลักการสำคัญ: RAG แยก "ความรู้" ออกจาก "ความสามารถทางภาษา" — โมเดลภาษาทำหน้าที่เข้าใจคำถามและประพันธ์คำตอบ ส่วนความรู้เฉพาะทางอยู่ในฐานข้อมูลเวกเตอร์ที่อัปเดตได้ทันทีโดยไม่ต้องฝึกโมเดลใหม่ ไปป์ไลน์การทำงานของ RAG RAG ทำงานในสองระยะหลัก คือระยะเตรียมข้อมูล (offline indexing) และระยะตอบคำถาม (online retrieval): การนำเข้าและแบ่งส่วน (Ingestion & Chunking): เอกสารทุกประเภท — PDF, Word, ไฟล์ CAD, บันทึกการซ่อม — ถูกแปลงเป็นข้อความแล้วแบ่งเป็นชิ้นเล็ก (chunk) ขนาดประมาณ 300–800 โทเคน พร้อมเก็บข้อมูลเมตา เช่น หมายเลขเครื่องจักรและวันที่ การฝังเวกเตอร์ (Embedding): แต่ละ chunk ถูกแปลงเป็นเวกเตอร์ตัวเลขด้วยโมเดล embedding ซึ่งจับความหมายเชิงอรรถศาสตร์ (semantic meaning) การจัดเก็บในฐานข้อมูลเวกเตอร์ (Vector Database): เวกเตอร์ทั้งหมดถูกจัดทำดัชนีด้วยวิธี Approximate Nearest Neighbor (ANN) เพื่อให้ค้นหาได้รวดเร็วในเวลามิลลิวินาที การค้นคืน (Retrieval): เมื่อช่างถาม "ปั๊มหมายเลข P-204 มีเสียงผิดปกติ ต้องตรวจอะไรก่อน?" ระบบแปลงคำถามเป็นเวกเตอร์และค้นหา chunk ที่ใกล้เคียงที่สุด มักใช้การค้นแบบผสม (hybrid search) ระหว่างความหมายและคำสำคัญ การสร้างคำตอบ (Generation): โมเดลภาษารับ chunk ที่ค้นได้มาเป็นบริบท แล้วสร้างคำตอบที่กระชับ พร้อมระบุแหล่งอ้างอิงว่ามาจากคู่มือหน้าไหน เปรียบเทียบวิธีการปรับแต่งโมเดลภาษา มิติเปรียบเทียบ Prompt อย่างเดียว Fine-Tuning RAG การอัปเดตความรู้ ต้องแก้ prompt ต้องฝึกใหม่ ✅…
Read More
Self-Supervised Learning สำหรับ Industrial AI: เรียนรู้จากข้อมูลไร้ป้ายในโรงงาน

Self-Supervised Learning สำหรับ Industrial AI: เรียนรู้จากข้อมูลไร้ป้ายในโรงงาน

Article
โรงงานอุตสาหกรรมทุกแห่งผลิตข้อมูลมหาศาลทุกวินาที — เซ็นเซอร์สั่นสะเทือน กล้องตรวจสอบคุณภาพ เครื่องวัดอุณหภูมิและแรงดัน — แต่ข้อมูลเหล่านี้ กว่า 95% เป็นข้อมูลปกติที่ไม่มีป้ายกำกับ (unlabeled data) การจะนำข้อมูลเหล่านี้ไปฝึกโมเดลตรวจจับตำหนิแบบมีผู้สอน (supervised) ต้องเสียเวลาและบุคลากรผู้เชี่ยวชาญในการระบุตำหนิทีละภาพ ซึ่งช้าและมีค่าใช้จ่ายสูง Self-Supervised Learning (SSL) คือวิธีที่ทำให้ AI เรียนรู้รูปแบบที่ซ่อนอยู่จากข้อมูลไร้ป้ายเหล่านี้ได้ด้วยตัวมันเอง Self-Supervised Learning คืออะไร? SSL เป็นเทคนิคที่สร้าง "สัญญาณการเรียนรู้" ขึ้นมาจากโครงสร้างของข้อมูลเอง โดยไม่ต้องมีมนุษย์มาติดป้ายกำกับ ระบบจะตั้ง ภารกิจหลอก (pretext task) ให้โมเดลทำนายส่วนหนึ่งของข้อมูลจากส่วนอื่น เช่น ทายทิศทางการหมุนของภาพ หรือเติมส่วนที่ถูกปิดไว้ (masked) จากการทำภารกิจเหล่านี้ โมเดลเรียนรู้ การแทนคุณลักษณะ (representation) ที่สามารถนำไปใช้ต่อกับงานจริงได้ โดยใช้ข้อมูลที่มีป้ายนิดเดียวในขั้นปรับแต่งสุดท้าย (fine-tuning) 🧠 เหตุผลสำคัญ: ผลงานวิจัยพบว่าโมเดลที่ผ่านการฝึกแบบ self-supervised สามารถบรรลุประสิทธิภาพใกล้เคียงหรือบางครั้งสูงกว่า supervised learning ในงานตรวจจับความผิดปกติ ในขณะที่ใช้ข้อมูลที่มีป้ายน้อยลงมาก วิธีการหลักของ SSL ในงานอุตสาหกรรม Contrastive Learning: สอนโมเดจับคู่ข้อมูลที่ "คล้ายกัน" (เช่น ภาพผลิตภัณฑ์ปกติสองมุม) ให้อยู่ใกล้กันในเวกเตอร์สเปซ และดันข้อมูลที่ "ต่างกัน" ให้ออกห่าง เป็นวิธียอดนิยมในการสร้างโมเดลพื้นฐานที่แยกแยะตำหนิได้ Masked Modeling: ปิดบางส่วนของสัญญาณเซ็นเซอร์หรือภาพแล้วให้โมเดลเติมให้ถูกต้อง เหมาะกับข้อมูลอนุกรมเวลา (time-series) จากเครื่องจักร Synthetic Anomaly: ฉีดตำหนิสังเคราะห์ลงในภาพปกติเพื่อสร้างข้อมูลฝึก เนื่องจากตำหนิจริงในโรงงานมีน้อยมาก เทคนิคนี้ช่วยให้ตรวจจับตำหนิได้โดยไม่ต้องรอสะสมตัวอย่างตำหนิจริง Predictive / Reconstruction: ให้โมเดลเรียนรู้สร้างภาพซ้ำจากข้อมูลปกติ เมื่อเจอข้อมูลผิดปกติโมเดลจะ "สร้างได้ไม่ดี" ส่งสัญญาณว่าพบความผิดปกติ เปรียบเทียบกระบวนทัศน์การเรียนรู้ มิติเปรียบเทียบ Supervised Unsupervised Self-Supervised ต้องมีป้ายกำกับ? ✅ มาก ❌ ไม่มี ป้ายน้อย (final step) ใช้ประโยชน์จากข้อมูลไร้ป้าย ❌ ✅ ✅ ดีมาก ตรวจจับตำหนิประเภทใหม่ ❌ (ต้องเคยเห็น) ปานกลาง ✅ ได้ดี คุณภาพ representation ดี (งานเฉพาะ) ต่ำ-ปานกลาง ✅ ดีมาก ภาระการติดป้ายมนุษย์ สูงมาก ไม่มี ต่ำ กรณีประยุกต์ใช้ในโรงงาน ตรวจจับตำหนิที่ไม่เคยพบ (Novel Anomaly Detection): โมเดลที่เรียนรู้แต่ "ความปกติ" จากภาพผลิตภัณฑ์ดีหลายหมื่นภาพ…
Read More
Neuro-Symbolic AI ในอุตสาหกรรมการผลิต: เมื่อ Deep Learning ผสาน Symbolic Reasoning เพื่อ AI ที่ฉลาดและโปร่งใส

Neuro-Symbolic AI ในอุตสาหกรรมการผลิต: เมื่อ Deep Learning ผสาน Symbolic Reasoning เพื่อ AI ที่ฉลาดและโปร่งใส

Article
ในวงการปัญญาประดิษฐ์มาหลายทศวรรษ มีกระบวนทัศน์ (paradigm) ที่สำคัญสองแนวทางที่มักเดินคนละทาง — Deep Learning ที่เก่งเรื่องการรับรู้ (perception) จากข้อมูล แต่เป็นกล่องดำยากต่อการอธิบาย กับ Symbolic AI ที่ใช้ตรรกะและกฎเกณฑ์ (logic & rules) โปร่งใสแต่ไม่ทนต่อความผิดเพี้ยนของข้อมูลโลกจริง Neuro-Symbolic AI คือความพยายามผสานจุดแข็งของทั้งสองแนวเข้าด้วยกัน เพื่อสร้างระบบที่ "เก่งขึ้น โปร่งใสขึ้น และใช้ข้อมูลน้อยลง" ทำไมโรงงานอุตสาหกรรมต้องการ Neuro-Symbolic AI? โมเดล Deep Learning แบบเดิมทำงานได้ดีในงานจำแนกภาพหรือพยากรณ์ แต่มีจุดอ่อนสำคัญในบริบทโรงงาน: มันไม่เข้าใจ ความสัมพันธ์เชิงเหตุผล และไม่สามารถรับประกันว่าจะไม่ละเมิดกฎความปลอดภัยที่วิศวกรกำหนดไว้ ในขณะที่ Symbolic AI แบบดั้งเดิม (เช่นระบบผู้เชี่ยวชาญ) เขียนกฎเป็น if-then ได้ชัดเจน แต่เมื่อเจอข้อมูลเซ็นเซอร์ที่สกปรกหรือสัญญาณรบกวนก็พังทลายทันที 💡 แนวคิดหลัก: Neuro-Symbolic AI ใช้ส่วน Neural ในการ รับรู้และสกัดคุณลักษณะ จากข้อมูลดิบ (ภาพ สัญญาณเสียง ค่าเซ็นเซอร์) แล้วส่งต่อให้ส่วน Symbolic ทำ อนุมานเชิงตรรกะ บนฐานความรู้ (Knowledge Graph) เพื่อตัดสินใจที่สอดคล้องกฎเกณฑ์และอธิบายได้ สถาปัตยกรรมพื้นฐานของ Neuro-Symbolic AI ระบบ Neuro-Symbolic โดยทั่วไปประกอบด้วยสามชั้นหลักที่ทำงานร่วมกัน: ชั้นรับรู้ (Perception Layer): เครือข่ายประสาทเทียมแปลงข้อมูลดิบ เช่น ภาพจากกล้องตรวจสอบคุณภาพ หรือสัญญาณสั่นสะเทือนของเครื่องจักร ให้กลายเป็นเวกเตอร์คุณลักษณะ (feature vector) และแยกแยะวัตถุ/สถานการณ์เบื้องต้น ชั้นความรู้ (Knowledge Layer): Knowledge Graph จัดเก็บความสัมพันธ์ระหว่างเครื่องจักร อะไหล่ กระบวนการผลิต และกฎความปลอดภัย ในรูปแบบเอนทิตีและความสัมพันธ์ (entity-relation triple) เช่น [ปั๊ม-001] —ส่งผลต่อ→ [ประสิทธิภาพสาย A] ชั้นอนุมาน (Reasoning Layer): เอนจินอนุมานเชิงสัญลักษณ์ (เช่น Answer Set Programming หรือตรรกะเชิงคำอธิบาย — Description Logic) ใช้กฎเกณฑ์และผลจากชั้นรับรู้มาตอบคำถาบ เช่น "ถ้าเซ็นเซอร์อุณหภูมิเกิน 85°C และแรงดันต่ำกว่า 2 bar แล้วต้องหยุดเครื่องภายใน 30 วินาที" เปรียบเทียบ 3 กระบวนทัศน์ AI มิติเปรียบเทียบ Deep Learning (เดิม)…
Read More
WebSocket สำหรับ IIoT: โปรโตคอล Full-Duplex เรียลไทม์สำหรับ Web-Based SCADA Dashboard

WebSocket สำหรับ IIoT: โปรโตคอล Full-Duplex เรียลไทม์สำหรับ Web-Based SCADA Dashboard

Article
เมื่อ Dashboard ของ SCADA หรือ HMI ต้องแสดงค่าเซ็นเซอร์ที่เปลี่ยนแปลงทุกวินาที หรือเมื่อผู้ควบคุมต้องการเห็นสถานะเครื่องจักรแบบเรียลไทม์บนเว็บเบราว์เซอร์ โปรโตคอลแบบเดิมอย่าง HTTP Request-Response ก็เริ่มไม่เพียงพอ WebSocket (RFC 6455) จึงกลายเป็นหัวใจสำคัญของการสร้างระบบติดตามและควบคุมโรงงานผ่านเว็บที่ตอบสนองแบบทันที (Real-Time) WebSocket คืออะไร และทำไม IIoT ถึงต้องการ WebSocket เป็นโปรโตคอลสื่อสารแบบ Full-Duplex (สองทางพร้อมกัน) ที่ทำงานบน TCP Connection เดียว แตกต่างจาก HTTP แบบดั้งเดิมที่เป็น Request-Response (ฝั่ง Client ถามแล้ว Server ตอบ แล้วปิดการเชื่อมต่อ) WebSocket เปิดการเชื่อมต่อครั้งเดียวแล้วคงไว้ตลอดเวลา (Persistent Connection) ทำให้ทั้งสองฝั่งสามารถส่งข้อมูลหากันได้ตลอดเวลาโดยไม่ต้องรอฝั่งใดฝั่งหนึ่งเริ่มก่อน การสร้าง WebSocket Connection เริ่มต้นด้วย HTTP Upgrade Handshake - Client ส่ง HTTP Request พร้อม Header Upgrade: websocket เมื่อ Server ตอบรับ (HTTP 101 Switching Protocols) การเชื่อมต่อก็เปลี่ยนจาก HTTP ไปเป็น WebSocket ทันที จุดนี้สำคัญเพราะทำให้ WebSocket สามารถทะลุผ่าน Firewall และ Reverse Proxy มาตรฐานได้โดยใช้พอร์ต 80 หรือ 443 เหมือนเว็บไซต์ทั่วไป เปรียบเทียบวิธีการสื่อสาร Real-Time ใน IIoT วิธีการ ทิศทาง Overhead/ข้อความ Latency การใช้ทรัพยากร HTTP Polling Request-Response ~500-800 bytes (Header ซ้ำทุกครั้ง) สูง (รอทุก N วินาที) สูงมาก Long Polling ครึ่งสองทาง ~500-800 bytes ปานกลาง สูง SSE (Server-Sent Events) Server > Client เท่านั้น ต่ำ ต่ำ ปานกลาง WebSocket Full-Duplex (สองทาง) 2-10 bytes (Frame Header)…
Read More
PROFINET: มาตรฐาน Industrial Ethernet เรียลไทม์ที่ขับเคลื่อน Factory Automation ยุคใหม่

PROFINET: มาตรฐาน Industrial Ethernet เรียลไทม์ที่ขับเคลื่อน Factory Automation ยุคใหม่

Article
ในยุคที่ระบบอัตโนมัติของโรงงานต้องสื่อสารกันด้วยความเร็วระดับมิลลิวินาที การเลือกโปรโตคอลเครือข่ายอุตสาหกรรมจึงไม่ใช่แค่เรื่องของ "เชื่อมต่อได้หรือไม่" แต่คือเรื่องของ "เชื่อมต่อได้แม่นยำและกำหนดเวลาได้แน่นอน (Deterministic)" PROFINET (PROcess Field NET) คือหนึ่งในมาตรฐาน Industrial Ethernet ที่ได้รับความนิยมสูงสุดในโลก โดยพัฒนาภายใต้มาตรฐานสากล IEC 61158 และ IEC 61784 ออกแบบมาเพื่อเชื่อมต่ออุปกรณ์ระดับ Field เช่น เซ็นเซอร์ มอเตอร์ และ Drive เข้ากับระบบควบคุมระดับสูงในแบบเรียลไทม์อย่างแท้จริง PROFINET คืออะไร? ทำไมถึงสำคัญใน Smart Factory PROFINET เป็นมาตรฐาน Industrial Ethernet แบบเปิด (Open Standard) ที่ใช้โครงสร้าง Ethernet มาตรฐาน (IEEE 802.3) เป็นพื้นฐาน แต่เพิ่มกลไกการสื่อสารเรียลไทม์เข้าไปเพื่อให้สามารถรับประกัน Cycle Time ที่แน่นอนได้ ซึ่งเป็นสิ่งที่ Ethernet แบบดั้งเดิมที่ใช้ TCP/IP ทำไม่ได้ เนื่องจากลักษณะของ CSMA/CD ที่ไม่สามารถกำหนดเวลาการส่งข้อมูลได้ จุดเด่นของ PROFINET คือการแบ่งประสิทธิภาพออกเป็น Conformance Classes (CC) ที่ชัดเจน ทำให้วิศวกรสามารถเลือกระดับที่เหมาะสมกับแอปพลิเคชันของตนได้ ไม่ว่าจะเป็นการควบคุมกระบวนการทั่วไปหรือการควบคุม Motion ที่ต้องการความแม่นยำระดับไมโครวินาที สถาปัตยกรรม PROFINET IO: 3 บทบาทหลัก โครงสร้างการสื่อสารของ PROFINET (เรียกว่า PROFINET IO) แบ่งอุปกรณ์ออกเป็น 3 บทบาทหลัก: IO Controller — อุปกรณ์ที่ทำหน้าที่ควบคุม เช่น PLC ที่ประมวลผลโปรแกรมและส่งคำสั่งไปยัง Field Device ทำหน้าที่เป็น "สมอง" ของระบบ IO Device — อุปกรณ์ระดับ Field ที่รับคำสั่งจาก IO Controller เช่น เซ็นเซอร์ I/O Module มอเตอร์ Drive และ Valve แต่ละตัวจะมีหมายเลขประจำตัวเรียกว่า Device Name IO Supervisor — อุปกรณ์สำหรับการวินิจฉัยและบำรุงรักษา เช่น Engineering Tool หรือ HMI ที่ใช้ตรวจสอบสถานะและพารามิเตอร์ของอุปกรณ์ การสื่อสารระหว่างกันใช้แนวคิด Application Relation (AR) และ Communication Relation…
Read More
Digital Transformation Roadmap สำหรับโรงงานอุตสาหกรรม: จาก Assessment สู่ Scale-Up ใน 4 ระยะ

Digital Transformation Roadmap สำหรับโรงงานอุตสาหกรรม: จาก Assessment สู่ Scale-Up ใน 4 ระยะ

Article
งานวิจัยหลายชิ้นชี้ว่า ประมาณ 70% ของโครงการ Digital Transformation ในอุตสาหกรรมไม่บรรลุเป้าหมาย ที่ตั้งไว้ สาเหตุหลักไม่ใช่เทคโนโลยีไม่ดี แต่คือการ ขาดแผนงานที่ชัดเจน (Roadmap) และการกระโดดไป "ซื้อเทคโนโลยี" ก่อนเข้าใจปัญหาจริง บทความนี้นำเสนอแนวทางการสร้าง Digital Transformation Roadmap แบบ 4 ระยะที่พิสูจน์มาแล้วว่าใช้งานได้จริงในโรงงานอุตสาหกรรม หลักคิด: แปลงดิจิทัลไม่ใช่โครงการ แต่คือกระบวนการ ความผิดพลาดที่พบบ่อยที่สุดคือการมอง digital transformation เป็น "โครงการจบใน 6 เดือน" ความจริงคือมันคือ การเปลี่ยนแปลงกระบวนการทำงานอย่างต่อเนื่อง ที่ต้องการทั้งเทคโนโลยี คน และกระบวนการ ขับเคลื่อนไปด้วยกัน โดยมี 4 ระยะ ที่ต้องผ่านตามลำดับ 4 ระยะของ Digital Transformation Roadmap ระยะเป้าหมายผลลัพธ์หลักระยะเวลา 1. Assessประเมินความพร้อมดิจิทัลและไขปัญหาMaturity score + use case backlog1-3 เดือน 2. Pilotทดลองในขอบเขตจำกัด (1 สายการผลิต)POC ที่พิสูจน์ ROI ได้3-6 เดือน 3. Scaleขยายสู่ทุกสายการผลิตPlatform + data foundation12-24 เดือน 4. Optimizeใช้ AI ปรับปรุงอย่างต่อเนื่องAutonomous optimizationต่อเนื่อง ระยะที่ 1: Assess — รู้จักตัวเองก่อน ก่อนลงมือซื้ออะไร ต้อง ประเมินความพร้อมดิจิทัล (Digital Maturity Assessment) ในมิติของเทคโนโลยี กระบวนการ คน และข้อมูล การประเมินมักใช้กรอบอ้างอิงเช่น Acatech Industry 4.0 Maturity Index หรือโมเดลของ Gartner ที่ให้คะแนน 0-5 ในแต่ละด้าน ผลลัพธ์ของระยะนี้คือ use case backlog — รายการโอกาสที่จะปรับปรุง เรียงตามผลตอบแทนและความเป็นไปได้ ตัวอย่างเช่น "ลด unplanned downtime 30%" หรือ "ลดการใช้พลังงาน 15%" ระยะที่ 2: Pilot — พิสูจน์ให้เห็นก่อนลุย เลือก 1 use case ที่มีผลกระทบสูงและความเสี่ยงต่ำ มาทำเป็นนำร่อง (pilot) ในขอบเขตจำกัด เช่น…
Read More
Smart Factory Architecture: Reference Architecture แบบชั้นสำหรับโรงงานอัจฉริยะยุคใหม่

Smart Factory Architecture: Reference Architecture แบบชั้นสำหรับโรงงานอัจฉริยะยุคใหม่

Article
หลายโรงงานเข้าใจผิดว่า "Smart Factory" คือการซื้อหุ่นยนต์หรือติดตั้งซอฟต์แวร์ตัวเดียว แต่ความจริง Smart Factory คือ สถาปัตยกรรมข้อมูล (Data Architecture) ที่เชื่อมโยงทุกชั้นของการผลิตเข้าด้วยกัน โดยให้ข้อมูลไหลจากเซ็นเซอร์ระดับฟิลด์ขึ้นสู่ระบบวิเคราะห์ระดับองค์กรได้อย่างไร้รอยต่อ บทความนี้เจาะลึก Reference Architecture สำหรับ Smart Factory ที่อ้างอิงมาตรฐาน ISA-95 และ RAMI 4.0 (Reference Architecture Model Industrie 4.0) เพื่อให้วิศวกรและผู้บริหารเห็นภาพการออกแบบที่ถูกต้อง 5 ชั้นของ Smart Factory Architecture ตามโมเดล ISA-95 และ RAMI 4.0 สถาปัตยกรรมโรงงานอัจฉริยะแบ่งเป็น 5 ชั้น (layer) ที่ทำงานร่วมกัน: ชั้น (Level)องค์ประกอบหลักหน้าที่โปรโตคอล/มาตรฐาน L0-L1 Field/ControlSensor, Actuator, PLCควบคุมเครื่องจักร real-time (ms)Profinet, EtherCAT, Modbus L2 SCADA/HMISCADA, HMI, DCSมอนิเตอร์และควบคุมกระบวนการOPC UA, DNP3 L3 MES/MOMMES, historianจัดการการผลิต คุณภาพ และการบำรุงรักษาISA-88, ISA-95 B2MML L4 ERPERP, PLM, SCMวางแผนธุรกิจและห่วงโซ่อุปทานREST API, OData L5 Cloud/AnalyticsData lake, AI/MLวิเคราะห์ข้ามโรงงาน และพยากรณ์MQTT Sparkplug B, HTTPS การไหลของข้อมูล: Northbound และ Southbound ข้อมูลใน Smart Factory เคลื่อนที่สองทิศทางเสมอ: Northbound (ขึ้น): ข้อมูลจากเซ็นเซอร์ (อุณหภูมิ, การสั่นสะเทือน, อัตราการผลิต) ไหลขึ้นสู่ MES และ Cloud เพื่อวิเคราะห์และตัดสินใจ Southbound (ลง): คำสั่งจากระบบวิเคราะห์ (เช่น ลดความเร็วมอเตอร์ 5%) ส่งลงไปปรับ setpoint ของ PLC ในระดับ millisecond ความท้าทายหลัก: การตัดขาดระหว่าง L3 (MES) และ L4 (ERP) หรือที่เรียกว่า manufacturing IT-OT gap คือสาเหตุอันดับหนึ่งที่ทำให้ข้อมูลไม่สามารถใช้ตัดสินใจได้แบบ end-to-end Edge Computing ในสถาปัตยกรรม Smart…
Read More
Deployment Gap: ทำไม 80% ของโรงงานยังไม่อัตโนมัติแม้เทคโนโลยีพร้อม

Deployment Gap: ทำไม 80% ของโรงงานยังไม่อัตโนมัติแม้เทคโนโลยีพร้อม

Article
ในช่วงกลางปี 2026 มีรายงานวิเคราะห์ตลาดฉบับหนึ่งที่สร้างคลื่นในวงการอุตสาหกรรม โดยชี้ให้เห็นความขัดแย้งที่น่าตกใจ: แม้ผลิตภัณฑ์ระบบอัตโนมัติและ IIoT จะหลั่งไหลสู่ตลาดอย่างท่วมท้น แต่กว่า 80% ของโรงงานในสหรัฐอเมริกายังคงทำงานแบบดั้งเดิมโดยไม่มีระบบอัตโนมัติแทรกซึมอย่างแท้จริง ปรากฏการณ์นี้ถูกเรียกว่า "Deployment Gap" หรือช่องว่างระหว่างเทคโนโลยีที่มีอยู่กับเทคโนโลยีที่ถูกนำไปใช้จริง บทความนี้เจาะลึกว่าทำไมช่องว่างนี้จึงเกิดขึ้น และวิศวกรระบบอุตสาหกรรมจะเดินข้ามมันได้อย่างไร Deployment Gap คืออะไร และทำไมสำคัญ Deployment Gap ไม่ใช่เรื่องของการ "ไม่มีเทคโนโลยี" เพราะในปัจจุบัน PLC, SCADA, Edge Gateway, Sensor Network และแพลตฟอร์มวิเคราะห์ข้อมูลมีให้เลือกมากมาย แต่เป็นเรื่องของการ "นำไปใช้ไม่ได้จริง" ในขนาดที่สร้างผลลัพธ์ทางธุรกิจ ความเร็วในการพัฒนาเทคโนโลยีเร็วกว่าความสามารถขององค์กรในการดูดซับและปรับตัวอย่างชัดเจน ตัวเลขสะท้อนภาพชัด: เมื่อผลิตภัณฑ์ใหม่ๆ ออกสู่ตลาดเกือบทุกไตรมาส แต่สัดส่วนโรงงานที่ยังไม่มีระบบอัตโนมัติยังสูงถึงราว 80% หมายความว่านวัตกรรมที่วงการภูมิใจ ยังไม่สามารถลดทอนความซับซ้อนในการ Deploy ให้เข้าถึงผู้ผลิตขนาดกลางและขนาดย่อม (SME) ได้ 5 อุปสรรคหลักที่ทำให้โรงงาน "อัตโนมัติไม่ได้จริง" อุปสรรค รายละเอียด กลุ่มที่กระทบมากที่สุด 1. มรดกระบบเดิม (Legacy Systems)เครื่องจักรเก่า 10-30 ปี ไม่มีพอร์ตสื่อสารดิจิทัล ดึงข้อมูลไม่ได้โรงงานทุกขนาด 2. ขาดแคลนบุคลากรด้านดิจิทัลไม่มีวิศวกร OT/IT ที่เข้าใจทั้งสองโลกพร้อมกันSME 3. ความเสี่ยงจากการหยุดชะงัก (Risk Aversion)กลัวว่าการติดตั้งระบบใหม่จะทำให้สายการผลิตหยุดผู้ผลิตขนาดใหญ่ 4. ความซับซ้อนในการเชื่อมต่อ (Integration Complexity)ระบบแต่ละยี่ห้อใช้โปรโตคอลต่างกัน (Modbus, OPC UA, Proprietary)โรงงานหลายสาย 5. ROI ไม่ชัดเจนไม่สามารถคำนวณผลตอบแทนได้ก่อนลงทุนSME / ผู้บริหาร ทำไมเทคโนโลยีดีๆ จึง "ขายยาก" ในโรงงานจริง วิศวกรและนักพัฒนามักคิดว่า "ถ้าเทคโนโลยีดี คนก็จะใช้" แต่ในโลกอุตสาหกรรมจริง การตัดสินใจขับเคลื่อนด้วยปัจจัยที่ซับซ้อนกว่า การติดตั้ง Edge Gateway ตัวเดียวอาจต้องประสานงานระหว่างฝ่ายผลิต ฝ่ายซ่อมบำรุง ฝ่าย IT ฝ่ายความปลอดภัย และผู้จัดการโรงงาน หากไม่มี "ผู้นำการเปลี่ยนแปลงดิจิทัล" ภายในองค์กร โปรเจกต์จะติดอยู่ในสภาพ Pilot ตลอดไป (Pilot Purgatory) อาการ Pilot Purgatory (นรกนักทดลอง) หลายโรงงานเริ่มโปรเจกต์ IIoT เป็น Proof of Concept บนเครื่องจักร 1-2 ตัว จากนั้นก็ไม่สามารถขยายผล (Scale) ไปทั่วโรงงานได้ เพราะขาดแผนงาน ขาดงบประมาณต่อเนื่อง และขาดการวัดผลที่ชัดเจน ผลคือเทคโนโลยีถูกทดสอบแล้วลืม 5 กลยุทธ์เดินข้ามช่องว่าง…
Read More