Agent-Based Simulation และ Knowledge Graph: เมื่อ Digital Twin เลิกรอคำสั่ง แล้วให้ทุกเครื่องจักรคิดเอง

Agent-Based Simulation และ Knowledge Graph: เมื่อ Digital Twin เลิกรอคำสั่ง แล้วให้ทุกเครื่องจักรคิดเอง

Article
เมื่อ Digital Twin เลิกเป็น "หุ่นยนต์เดินตามคำสั่ง": ทำไม Simulation ยุคใหม่ต้องให้ทุกเครื่องจักร "คิดเอง" ถ้าถามว่า Digital Twin คืออะไร คำตอบส่วนใหญ่คือ "โมเดลจำลองโรงงานที่ซิงก์ข้อมูล Real-Time" คำตอบนั้นถูกต้อง — แต่ไม่เพียงพออีกต่อไปแล้ว ปัญหาของ Twin แบบดั้งเดิมคือมันเป็น โมเดลเดี่ยวที่ต้องรอคนสั่ง: อยากรู้ว่าถ้าเพิ่มความเร็วคอนเวเยอร์ 15% จะเกิดอะไรขึ้น ต้องมีวิศวกรมานั่งตั้งค่า รัน What-If แล้วรอผล แนวโน้มใหม่ที่งานวิจัยระดับโลกกำลังพิสูจน์คือการผสาน Agent-Based Simulation (ABS) เข้ากับ Digital Twin — แทนที่จะสร้างโมเดลใหญ่หนึ่งเดียวที่คำนวณทุกอย่างพร้อมกัน ให้แต่ละองค์ประกอบในโรงงาน (เครื่องจักร, AGV, คนงาน, คลังสินค้า) กลายเป็น "เอเจนต์" ที่มีกฎการตัดสินใจของตัวเอง แล้วปล่อยให้พวกมันโต้ตอบกันเอง เหมือนโรงงานจริงที่ไม่มีใครสั่งการทุกจุด ระบบผลิตที่ซับซ้อน มีพฤติกรรม "อุบัติเหตุ" ที่ไม่มีสมการใดพรรณนาได้ — ภาพ: Wikimedia Commons สิ่งที่สมการเดี่ยวทำไม่ได้: Emergent Behavior จุดขายที่แท้จริงของ Agent-Based Simulation คือการจับ Emergent Behavior — พฤติกรรมที่เกิดขึ้นจากการโต้ตอบของส่วนย่อยจำนวนมาก แต่ไม่สามารถคาดเดาได้จากการดูส่วนย่อยแต่ละชิ้นแยกกัน ตัวอย่างคลาสสิกในโรงงาน: Deadlock ที่คลังสินค้า — AGV 8 คันไม่มีคันไหนผิดกติกา แต่ลำดับการเข้า-ออกของทั้งระบบในวันที่ Order เยอะทำให้ติดกับแก่นกันเอง คอขวดที่เคลื่อนตำแหน่ง — Buffer หน้าเครื่องจักรเครื่องหนึ่งเต็มทุกวัน เมื่อเพิ่มกำลังเครื่องนั้น คอขวดกลับไปโผล่ที่จุดที่ไม่มีใครคาดคิด ผลกระทบลูกโซ่ของ Breakdown — เครื่องหนึ่งหยุด 30 นาที ทำไม WIP ในส่วนอื่นของโรงงานแทบไม่ขยับ แต่บางครั้งหยุดแค่ 10 นาทีกลับสร้างความปั่นป่วนทั้งกะ ปรากฏการณ์เหล่านี้เกิดจาก ความแปรปรวนทางสถิติ (Stochastic Variability) ของเวลาทำงาน เวลารอ และลำดับเหตุการณ์ — สิ่งที่ Discrete-Event Simulation แบบดั้งเดิมจำลองได้ระดับหนึ่ง แต่การเพิ่ม "ตัวตนและกฎการตัดสินใจ" ให้แต่ละเอเจนต์ทำให้โมเดลสะท้อนความจริงได้ลึกกว่า โดยเฉพาะเมื่อมีคนและระบบอัตโนมัติทำงานปนกัน หลักฐานจากงานวิจัย: โมเดล 3 ชั้น + Knowledge Graph งานวิจัยที่ตีพิมพ์ในวารสาร Scientific Reports (2025) ได้สาธิตแนวทางนี้ด้วยสถาปัตยกรรมที่น่าสนใจ: แทนที่จะปล่อยให้เอเจนต์ "คิดเองเลือกอะไรก็ได้" พวกเขาคุมโครงสร้างความรู้ด้วย Knowledge Graph…
Read More
บทวิเคราะห์: Edge หรือ Cloud — ตัวเลขตลาดบอกว่าคำถามนี้ผิดตั้งแต่ต้น (และโรงงานควรถามอะไรแทน)

บทวิเคราะห์: Edge หรือ Cloud — ตัวเลขตลาดบอกว่าคำถามนี้ผิดตั้งแต่ต้น (และโรงงานควรถามอะไรแทน)

Article
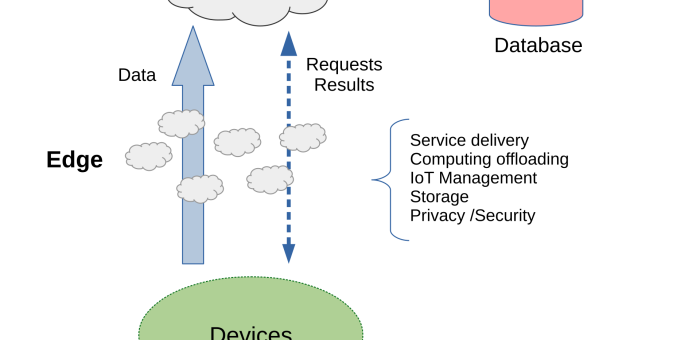
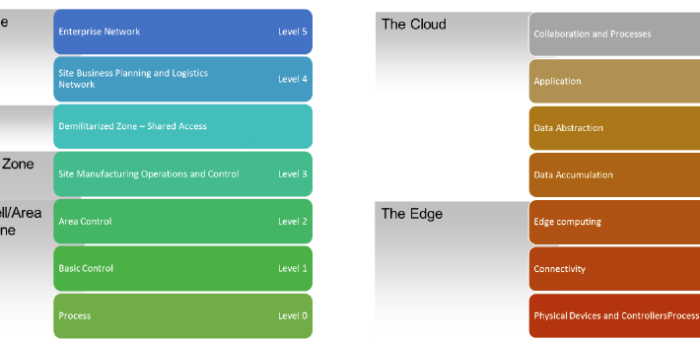
ช่วงสองสามปีที่ผ่านมา วิศวกรโรงงานไทยหลายท่านน่าจะเจอบทสนทนาแบบนี้: "เราควรเอาขึ้นคลาวด์หรือทำ edge ก่อน" คำถามดูเหมือนมีเหตุผล แต่ถ้าดูตัวเลขตลาดล่าสุดแล้ว จะพบว่านี่คือกรอบคิดที่กำลังล้าสมัย เพราะโลกไม่ได้กำลังเลือกระหว่างสองฝั่ง แต่กำลังเติบโต ทั้งสองฝั่งพร้อมกันอย่างก้าวกระโดด ตัวเลขที่ต้องรู้ก่อนตัดสินใจ รายงานล่าสุดของ Grand View Research ระบุว่าตลาด Edge Computing โลกมีมูลค่า 33.4 พันล้านดอลลาร์ในปี 2025 และประมาณการไว้ที่ 46.7 พันล้านดอลลาร์ในปี 2026 ก่อนจะขยายต่อไปถึง 328 พันล้านดอลลาร์ภายในปี 2033 คิดเป็น CAGR 32.1% ตลอดช่วง 2026–2033 — นี่คืออัตราเติบโตที่เร็วกว่าภาพรวมของ smart manufacturing ที่ IoT Analytics ประเมินไว้ที่ CAGR 9.3% (จาก 175 พันล้านดอลลาร์ในปี 2025 สู่ 274 พันล้านดอลลาร์ในปี 2030) ถึงสามเท่าครึ่ง ทำไมถึงเร็วขนาดนั้น? เพราะ edge ไม่ได้แข่งกับคลาวด์ แต่กำลัง เปิดกล่อง use case ใหม่ที่คลาวด์ทำไม่ได้ และเอเชียแปซิฟิกคือภูมิภาคที่โตเร็วที่สุด — Grand View Research ระบุ CAGR ของภูมิภาคเราที่ราว 39% สูงกว่าค่าเฉลี่ยโลก ซึ่งสอดคล้องกับการลงทุน infrastructure ดิจิทัลของไทยในช่วงนี้ Purdue Reference Model เทียบกับ IoT Reference Model — โครงสร้างระดับโรงงานกับระดับคลาวด์กำลังถูกออกแบบให้ทำงานร่วมกัน ไม่ใช่แยกกัน — ภาพ: Wikimedia Commons (CC BY-SA 4.0) คำถามที่ถูกต้อง: Workload นี้ควรอยู่ที่ไหน แทนที่จะถามว่า "เอาขึ้นคลาวด์หรือ edge" ให้ถามว่า "workload นี้มีคุณสมบัติอะไร" แล้วให้คุณสมบัตินั้นตัดสินใจแทน โดยเฉพาะสี่มิติที่ตัดสินได้ชัดเจนที่สุด: มิติการตัดสินใจ ชี้ไปทาง Edge ชี้ไปทาง Cloud Latency ที่ยอมรับได้ ต่ำกว่า ~50 ms เช่น interlock, หยุดเครื่องฉุกเฉิน วินาทีถึงนาที เช่น dashboard, รายงานรายเดือน ปริมาณข้อมูล สูงมากต่อวินาที (vibration 10 kHz, วิดีโอ 30 fps)…
Read More
Case Study: โรงงานอาหาร ‘เสียเครื่อง Edge ตอนตี 2’ — บทเรียนจากการย้าย Orchestration ลงสู่ระดับสายการผลิตด้วย Kubernetes แบบ Lightweight

Case Study: โรงงานอาหาร ‘เสียเครื่อง Edge ตอนตี 2’ — บทเรียนจากการย้าย Orchestration ลงสู่ระดับสายการผลิตด้วย Kubernetes แบบ Lightweight

Article
เรื่องนี้เล่าถึงโรงงานอาหารแห่งหนึ่งในนิคมอุตสาหกรรมภาคตะวันออก ที่เดิมใช้เกตเวย์ IoT แบบ standalone จำนวน 24 ตัวกระจายอยู่ทุกสายการผลิต แต่ละตัวเก็บค่าอุณหภูมิห้องเย็น ความชื้น และสถานะเครื่องจักร แล้วส่งขึ้นคลาวด์ผ่าน MQTT ทุกอย่างทำงานได้ดี... จนกระทั่งคืนหนึ่งที่เกตเวย์ตัวหนึ่งหยุดทำงานเพราะการ์ดหน่วยความจำเสีย และไม่มีใครรู้ตัวจนกระทั่งเช้าวันรุ่งขึ้น ข้อมูลห้องเย็นหายไป 7 ชั่วโมงเต็ม ซึ่งในธุรกิจอาหารแปลว่าต้องเขียนรายงานเหตุการณ์ deviation ยาวเหยียด และต้องประเมินความเสี่ยงต่อสินค้าที่เก็บในช่วงเวลานั้น ปัญหา: ความล้มเหลวแบบเงียบ (Silent Failure) การตรวจสอบย้อนหลังพบว่าปัญหาไม่ได้อยู่ที่ตัวเกตเวย์ แต่อยู่ที่สถาปัตยกรรม ระบบเดิมไม่มีกลไกใดตรวจจับว่าเกตเวย์ "ยังมีชีวิต" หรือไม่ และเมื่อเกตเวย์หนึ่งตัวตาย ก็ไม่มีตัวไหนรับหน้าที่แทน ทีมวิศวกรรมจึงเสนอแนวคิดที่ตอนนั้นดูเกินจำเป็นสำหรับโรงงานอาหาร นั่นคือการนำ container orchestration แบบ Kubernetes รุ่นเบา ลงมาวางที่ระดับสายการผลิต — ไม่ใช่เพื่อความสวยงามทางเทคนิค แต่เพื่อให้ได้สามอย่าง: self-healing, declarative configuration และ rollback ที่ทำได้ในไม่กี่วินาที การวางโหนด Edge หลายชั้นให้ครอบคลุมทุกสายการผลิต คือฐานของ orchestration แบบกระจาย — ภาพ: Wikimedia Commons (CC BY-SA 4.0) ทางออก: Single-node Cluster ที่ทุกสายการผลิต แนวทางที่เลือกไม่ใช่คลัสเตอร์กลางขนาดใหญ่ แต่เป็น คลัสเตอร์เล็กๆ อยู่กับสายการผลิต แต่ละสายมี industrial computer ตั้งแต่ 2 โหนดขึ้นไป รัน Kubernetes distribution แบบ lightweight ที่ตัดส่วนประกอบที่ไม่จำเป็นออก ตัว workload หลักมีสามชนิด: Collector — อ่านค่าจาก PLC ผ่าน OPC UA และเซ็นเซอร์ผ่าน Modbus TCP เขียนลง local time-series storage Rule engine — ประเมินเงื่อนไข alarm เช่น อุณหภูมิห้องเย็นเกิน -18°C นานเกิน 10 นาที แล้วส่งแจ้งเตือนผ่านหลายช่องทาง Forwarder — ส่งข้อมูลแบบ batch ขึ้นคลาวด์ พร้อม store-and-forward เมื่อลิงก์หลุด จุดเปลี่ยนที่สำคัญคือการตั้งค่า liveness/readiness probe ให้กับทุก workload — collector ที่ค้างไม่อ่านค่า PLC…
Read More
Fog Computing กลับมาเป็นข่าวอีกครั้ง: ชั้นคำนวณที่โรงงานไทยมองข้ามไป กำลังกลายเป็นหัวใจของ IIoT ยุค Edge AI

Fog Computing กลับมาเป็นข่าวอีกครั้ง: ชั้นคำนวณที่โรงงานไทยมองข้ามไป กำลังกลายเป็นหัวใจของ IIoT ยุค Edge AI

Article
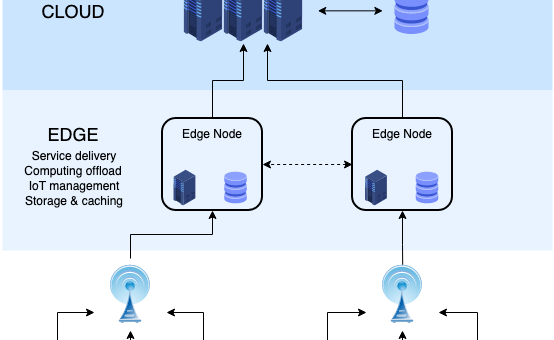
หลายโรงงานในไทยวางแผนธุรกิจดิจิทัลของตัวเองแบบสองขั้ว คือมีอุปกรณ์ IoT และ PLC อยู่ปลายทาง แล้วส่งข้อมูลขึ้นคลาวด์เพื่อประมวลผลทั้งหมด แต่เมื่อปริมาณข้อมูลเพิ่มขึ้นเป็นสิบเท่า และ AI เริ่มถูกใช้ตัดสินใจแบบเรียลไทม์บนพื้นโรงงาน สถาปัตยกรรมแบบสองขั้วนี้ก็เริ่มสะดุด คำตอบที่ถูกที่สุดไม่ใช่การย้ายทุกอย่างกลับมาอยู่ในโรงงาน แต่คือการเพิ่ม ชั้นคำนวณระหว่างกลาง ที่เรียกว่า Fog Computing ซึ่งกำลังกลับมาเป็นที่พูดถึงอีกครั้งในวงการอุตสาหกรรมปี 2026 สถาปัตยกรรมการคำนวณแบบไล่ระดับ ตั้งแต่อุปกรณ์ปลายทาง (Things) ผ่านชั้น Edge/Fog ขึ้นไปถึงคลาวด์ — ภาพ: Wikimedia Commons (CC BY-SA 4.0) ทำไมสองขั้วไม่พออีกต่อไป ลองนึกภาพสายการผลิตที่มีกล้องตรวจคุณภาพ 16 ตัว ส่งภาพความละเอียดสูงกลับคลาวด์เพื่อรันโมเดล Computer Vision ที่ 30 เฟรมต่อวินาที เสียงวิเคราะห์คลื่นเสียงเครื่องจักร และข้อมูล vibration ที่สุ่มที่ 10 kHz — แบนด์วิดท์ที่ต้องใช้ไม่ใช่แค่ "เยอะ" แต่แพงและเปราะ ถ้าเน็ตหลุดแม้เพียง 30 วินาที งานตรวจคุณภาพช่วงนั้นก็หายไปตลอดกาล ในทางกลับกัน การเอาทุกอย่างมาไว้ในเซิร์ฟเวอร์กลางในโรงงานล้มเหลวในอีกแบบ ทีม IT ต้องดูแลฮาร์ดแวร์ ทำ backup อัปเดต patch และขยายระบบทุกครั้งที่เพิ่มสายการผลิต Fog Computing เสนอทางที่สาม — กระจายการคำนวณลงไปในหลายๆ โหนดที่อยู่ใกล้แหล่งข้อมูล แต่ยังจัดการแบบรวมศูนย์ ตามแนวคิดที่ OpenFog Consortium (ซึ่งต่อมาควบรวมเข้ากับ Linux Foundation Edge) เคยสรุปไว้ใน Reference Architecture ว่าต้องมีคุณสมบัติ 8 ด้าน ตั้งแต่ Security, Scalability, Openness, Autonomy, Manageability, Agility, Hierarchical Organization ไปจนถึง Programmability ข้อกำหนดทางเทคนิคที่ต้องรู้ก่อนออกแบบ ประเด็นออกแบบ โจทย์จริงในโรงงาน แนวทาง Fog Latency budget ปิดสวิตช์ฉุกเฉินภายใน 10–50 ms หลังตรวจพบความผิดปกติ ประมวลผลและตัดสินใจที่โหนด Fog ในสายการผลิต ไม่รอ round-trip ไปคลาวด์ แบนด์วิดท์ กล้องตรวจคุณภาพ 16 ตัว ที่ 30 fps กินลิงก์ WAN เกินกว่าที่ลิงก์สำรองจะรับไหว สกัดเฉพาะผลลัพธ์และภาพที่พบ defect ขึ้นคลาวด์ ลดปริมาณข้อมูลขาออกได้ 90%…
Read More
How-to: สร้าง Line-level Digital Twin ใน 6 ขั้นตอน — จาก Data Pipeline ตาม ISA-95 สู่ What-if Simulation ที่ใช้ตัดสินใจจริง

How-to: สร้าง Line-level Digital Twin ใน 6 ขั้นตอน — จาก Data Pipeline ตาม ISA-95 สู่ What-if Simulation ที่ใช้ตัดสินใจจริง

Article
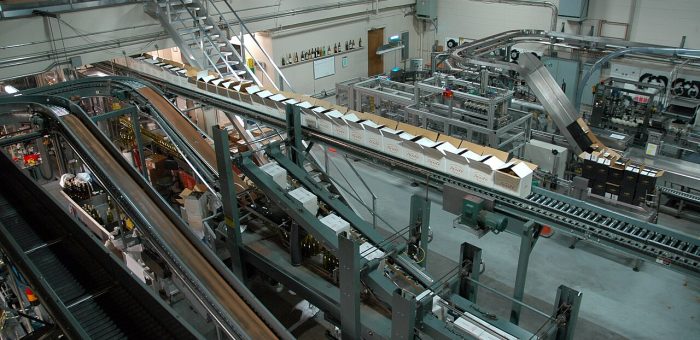
คำถามที่เราได้ยินบ่อยที่สุดในปี 2026: "โรงงานเรามีเครื่องจักรอยู่แล้ว เซ็นเซอร์ติดบ้างแล้ว จะเริ่ม Digital Twin จากตรงไหนดี" — คำตอบจากรายงานแนวโน้มอุตสาหกรรมปี 2026 หลายสำนักชี้ไปทางเดียวกัน: อย่าเริ่มจากเครื่องจักรเดี่ยว ให้เริ่มจากไลน์ผลิต (Production Line) ทั้งเส้น เพราะนั่นคือระดับที่ความล้มเหลวของ Digital Twin ส่วนใหญ่เกิดขึ้น และเป็นระดับที่ให้ผลตอบแทนชัดที่สุด บทวิเคราะห์จากสื่ออุตสาหกรรมการผลิตไทย (Manage & Manufacturing Thailand, ก.พ. 2026) สรุปภาพรวมไว้ว่า Digital Twin กำลังก้าวพ้นช่วงทดลอง (Pilot Phase) สู่การใช้งานจริงในระดับองค์กร โดยเฉพาะการผสานกับ CMMS (ระบบจัดการซ่อมบำรุง), ERP, Edge Computing และเครือข่าย 5G เพื่อลด Downtime และเพิ่มประสิทธิภาพสายการผลิตอย่างเป็นรูปธรรม ไลน์ผลิตจริงคือ "วัตถุดิบ" ของ Line-level Digital Twin — โมเดลที่ดีต้องสะท้อนทั้งจังหวะเครื่องจักร คอขวด และพฤติกรรมคนงาน (ที่มา: Tjeerd Wiersma, CC BY 2.0) ทำไมต้อง Line-level ไม่ใช่ Asset-level Digital Twin ระดับเครื่องจักรเดี่ยว (Asset Twin) เหมาะกับงานวิเคราะห์การสั่นสะเทือนหรืออายุการใช้งานแบริ่ง แต่คำถามที่แท้จริงของผู้จัดการโรงงานอยู่ในระดับที่สูงขึ้น: ถ้าเพิ่มกำลังผลิต 15% จะเกิดอะไรขึ้นกับคอขวด? ถ้าเปลี่ยนสูตรวัตถุดิบ จุดไหนของไลน์จะรับไม่ได้? คำถามเหล่านี้ตอบไม่ได้ด้วยการดูเครื่องจักรเดี่ยว — ต้องจำลอง ปฏิสัมพันธ์ระหว่างเครื่องจักรทุกตัวในไลน์รวมถึง Buffer และรอบเปลี่ยน Batch มิติ Asset Twin (เครื่องจักรเดี่ยว) Line-level Twin (ทั้งไลน์ผลิต) คำถามหลักที่ตอบได้ เครื่องนี้กำลังจะพังไหม? ควรเปลี่ยนอะไหล่เมื่อไร? เพิ่มกำลังผลิตแล้วคอขวดย้ายไปอยู่ตรงไหน? ไลน์รับสูตรใหม่ได้ไหม? ข้อมูลที่ต้องมี Vibration, Temperature, Motor Current ของเครื่องเป้าหมาย ข้อมูลทุกสถานี + อัตราการไหลชิ้นงาน + เวลา Changeover + OEE รายสถานี ผู้ใช้หลัก ทีมซ่อมบำรุง (Maintenance) ผู้จัดการผลิต + Process Engineer + ฝ่ายวางแผน ตัวอย่างการใช้งานเด่น คาดการณ์ความเสียหายแบริ่งล่วงหน้า 2-4 สัปดาห์ ทดสอบ What-if ก่อนเพิ่มกำลังผลิต /…
Read More
บทวิเคราะห์: เมื่อ GPS โดน Jam — ทะเลบอลติกส่งสัญญาณเตือนว่า Time Security คือจุดอ่อนถัดไปของโรงงาน OT

บทวิเคราะห์: เมื่อ GPS โดน Jam — ทะเลบอลติกส่งสัญญาณเตือนว่า Time Security คือจุดอ่อนถัดไปของโรงงาน OT

Article
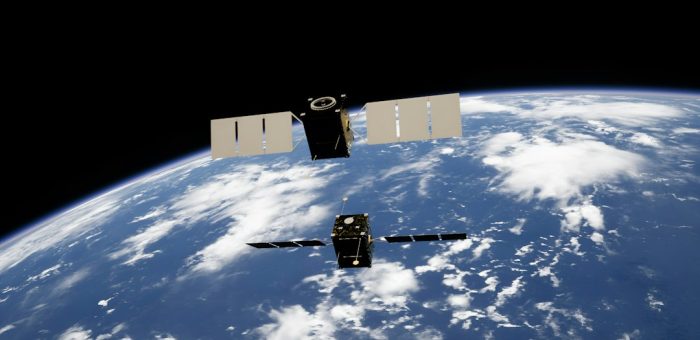
เมื่อเดือนสิงหาคม 2026 ประเทศโปแลนด์เผชิญสถานการณ์ที่ฟังดูเหมือนนิยายวิทยาศาสตร์ — โทรศัพท์แสดงตำแหน่งผิดพลาด โดรนบินเซ และเรือในทะเลบอลติกสูญเสียสัญญาณระบุพิกัด สาเหตุไม่ใช่ไซเบอร์แอตแทคตามความหมายทั่วไป แต่คือ การรบกวนสัญญาณดาวเทียม GNSS จากภายนอกประเทศ ซึ่งสถาบันโทรคมนาคมแห่งชาติของโปแลนด์ระบุว่าเกิดขึ้นกว่า 70% ของทั้งเดือน พฤษภากรรมนี้ไม่ได้กระทบแค่แอปนำทางบนมือถือ แต่ส่งสัญญาณเตือนถึงโรงงานอุตสาหกรรมทั่วโลกเรื่องที่ถูกมองข้ามมานาน: เวลา (Time) คือโครงสร้างพื้นฐานความมั่นคงปลอดภัยที่เปราะบางที่สุดชิ้นหนึ่งของระบบ OT ดาวเทียม GNSS ไม่ได้ให้แค่พิกัด แต่ให้ "เวลา" ที่ระบบไฟฟ้า โทรคมนาคม และโรงงานทั่วโลกใช้ซิงก์กัน — และสัญญาณนี้ถูกรบกวนได้ง่ายกว่าที่คิด (ภาพ: Unsplash) เวลาคือรากฐานที่ถูกลืมของความปลอดภัย OT หลายคนไม่ทราบว่า NTP Server และ PTP Grandmaster Clock จำนวนมากในโรงงานซิงก์เวลาจาก GNSS (GPS, Galileo, GLONASS, BeiDou) โดยตรง และเมื่อสัญญาณเหล่านี้ถูก Jam (บังคับให้ใช้ไม่ได้) หรือ Spoof (ปลอมแปลงให้ผิดพลาด) ระบบที่ส่งผลกระทบไม่ใช่แค่ป้ายบันทึกเวลา แต่รวมถึง: ระบบจัดการใบรับรองดิจิทัล — การตรวจสอบช่วงเวลา Validity ของใบรับรอง TLS ผิดพลาดได้ทั้งระบบ ทำให้การเชื่อมต่อที่ถูกต้องถูกปฏิเสธ หรือใบรับรองหมดอายุผ่านมาแล้วยังใช้ได้ ระบบไฟฟ้าและ Substation — โปรโตคอล IEC 61850 และการส่ง GOOSE/Sampled Values ต้องการความละเอียดเวลาระดับไมโครวินาที เพื่อให้ Relay ตัดสินใจป้องกันไฟฟ้าลัดวงจ้อย่างถูกต้อง การซิงก์ข้อมูลเซ็นเซอร์หลายจุด — ข้อมูล Vibration และ Process Data จากหลาย Edge Gateway ถ้า Timestamp ไม่ตรงกัน การวิเคราะห์หาความผิดปกติจะสับสนเพี้ยนทั้งหมด บันทึกเหตุการณ์เพื่อ Forensics — เมื่อเกิด Incident การไล่ลำดับเหตุการณ์จาก Log หลายระบบที่เวลาไม่ตรงกัน เป็นงานที่แทบทำไม่ได้ กรณีโปแลนด์ชี้ให้เห็นตัวเลขที่จับต้องได้: สถาบันโทรคมนาคมแหน่งชาติรายงานการรบกวนระดับชั่วโมงบนทุกย่านความถี่ GNSS 70% ของวันในเดือนพฤษภาคมและมิถุนายน 2026 และบริษัทที่ปรึกษาด้านเทคโนโลยีดาวเทียมอิสระบันทึกการหยุดชะงักเกือบ 90 ชั่วโมงในภูมิภาคพอเมอเรเนียริมทะเลบอลติกเดือนกรกฎาคม ขณะที่หน่วยงานข่าวกรองของลิทัวเนียประเมินว่าระบบส่งสัญญาณปลอมสามารถบิดเบือนสัญญาณนำทางได้ไกลถึง 450 กิโลเมตร บทเรียนจากทะเลบอลติก: คุณไม่จำเป็นต้องเป็นเป้าหมายของการโจมตีโดยตรง — แค่อยู่ในรัศมี 450 กิโลเมตรจากจุดรบกวน ระบบซิงก์เวลาของคุณก็ถือว่าอยู่ในภาวะเสี่ยงแล้ว ทางออกเชิงเทคนิค: จาก Holdover ถึงนาฬิกาอะตอมิกออปติคอล เมื่อสัญญาณ GNSS ไม่น่าเชื่อถืออีกต่อไป คำตอบเชิงวิศวกรรมมีหลายระดับ ขึ้นกับงบประมาณและความสำคัญของระบบ:…
Read More
Case Study: Chiller Plant 2,000 RT ลด kW/RT ได้ 22.8% โดยไม่เปลี่ยนเครื่องจักรใหญ่ — เรื่องจริงจากข้อมูล 1 นาที

Case Study: Chiller Plant 2,000 RT ลด kW/RT ได้ 22.8% โดยไม่เปลี่ยนเครื่องจักรใหญ่ — เรื่องจริงจากข้อมูล 1 นาที

Article
โรงงานผลิตชิ้นส่วนแห่งหนึ่งในนิคมอุตสาหกรรมภาคตะวันออกมี Chiller Plant ขนาด 2,000 ตันเย็น (RT) ให้บริการทั้งระบบปรับอากาศและน้ำเย็นกระบวนการผลิต ทุกคนในทีมซ่อมบำรุงรู้ดีว่า "ค่าไฟห้อง Chillers สูงผิดปกติ" มาหลายปี แต่ไม่มีใครตอบได้ว่าสูงเพราะอะไร เพราะข้อมูลที่มีคือยอด kWh รวมต่อเดือนจากมิเตอร์เดียว และค่าการตั้งค่าที่ "ถูกปรับครั้งสุดท้ายเมื่อคนเก่ายังอยู่" กรณีศึกษานี้ถอดบทเรียนจากโครงการปรับปรุงประสิทธิภาพระบบน้ำเย็นด้วยการติดตั้ง IIoT Monitoring และการวิเคราะห์ข้อมูลแบบ Fault Detection ตั้งแต่วันแรกจนถึงการเปลี่ยนแปลงที่วัดผลได้ — แบบเดียวกับที่โรงงานอื่นต่างประเทศทำและได้ผลยืนยันจากงานวิจัยระดับชาติสหรัฐฯ ปัญหา: เครื่องจักรปกติ แต่ระบบไม่ปกติ สิ่งที่ทีมวิศวกรพบหลังติดตั้งเซ็นเซอร์วัดอุณหภูมิน้ำเข้า/ออกทุกเครื่อง วัดกำลังไฟฟ้าของคอมเพรสเซอร์แยกทีละตัว และดึงค่าจาก BMS มาวิเคราะห์ร่วมกัน คือภาพที่ต่างจากความเชื่อเดิมโดยสิ้นเชิง: เครื่อง Chiller เดิน 3 เครื่องพร้อมกันทั้งวัน ทั้งที่โหลดจริงเฉลี่ยเพียง 58% ของกำลังติดตั้ง — ปัญหา Staging Logic ผิดพลาด อุณหภูมิน้ำเย็นออกถูกตั้งไว้ 6.0°C ทั้งที่กระบวนการผลิตรับ 7.2°C ได้ — ทุก 1°C ที่ลดลงเกินจำเป็น กินพลังงานเพิ่มราว 2-3% Condenser Approach ของเครื่องที่ 2 สูงผิดปกติ (เกิน 3°C) — สัญญาณท่อคอนเดนเซอร์มีตะกอน ปั๊มน้ำเดินที่ความเร็วเต็ม (100%) ตลอดเวลาแม้โหลดต่ำ — ไม่มี VFD ควบคุมตามความต้องการจริง ระบบท่อน้ำเย็นของ Chiller Plant อุตสาหกรรม — จุดวัดอุณหภูมิและความดันทุกจุดคือข้อมูลที่เปลี่ยนวิธีดูแลทั้งระบบ (ภาพ: Wikimedia Commons) โซลูชัน: มองเห็นก่อน แล้วค่อยแก้ หลักการของโครงการคือ "ไม่เดา ไม่ลองผิดลองถูก ใช้ข้อมูลตัดสิน" โดยแบ่งเป็น 3 เส้นทาง: 1. ติดตั้งชั้นข้อมูล (Instrumentation Layer) เพิ่มเซ็นเซอร์อุณหภูมิแม่นยำ ±0.1°C ที่ท่อน้ำเข้า/ออกทุกเครื่อง มิเตอร์วัดกำลังไฟฟ้าทุกตัวขับหลัก (คอมเพรสเซอร์ ปั๊ม พัดลมหอ้นเย็น) และเกตเวย์ IIoT เก็บข้อมูลทุก 1 นาที ส่งขึ้นแพลตฟอร์มวิเคราะห์แบบเรียลไทม์ ตัวชี้วัดหลักที่คำนวณอัตโนมัติคือ kW/RT (กิโลวัตต์ต่อตันเย็น) — ตัวเลขเดียวที่บอกสุขภาพทั้งระบบ 2. วิเคราะห์หาความผิดปกติ (Fault Detection) แพลตฟอร์มเทียบพฤติกรรมจริงกับ Baseline ทางเทคนิค เช่น ความสัมพันธ์ระหว่างโหลด-อุณหภูมิ-กำลังไฟที่ควรเป็นตามหลักอุณหพลศาสตร์ ความผิดปกติที่ตรวจพบถูกจัดคิวตามผลกระทบด้านพลังงาน ไม่ใช่ตามลำดับที่คนเห็นเป็นเรื่องเป็นราวก่อน วิธีนี้เป็นแนวทางเดียวกับ…
Read More
บทวิเคราะห์: ทำไมฐานผลิตแอร์ AI อัจฉริยะ ‘แห่งแรกของโลก’ ถึงมาตั้งในไทย — โครงสร้างพื้นฐานดิจิทัลของนิคมอุตสาหกรรมคือปัจจัยชี้ขาด

บทวิเคราะห์: ทำไมฐานผลิตแอร์ AI อัจฉริยะ ‘แห่งแรกของโลก’ ถึงมาตั้งในไทย — โครงสร้างพื้นฐานดิจิทัลของนิคมอุตสาหกรรมคือปัจจัยชี้ขาด

Article
เมื่อบริษัทเครื่องใช้ไฟฟ้าระดับโลกประกาศสร้าง ฐานการผลิตเครื่องปรับอากาศอัจฉริยะ (AI Intelligent Manufacturing Base) แห่งที่ 3 ในประเทศไทย — และเป็นโรงงาน AI Intelligent Factory สำหรับแอร์ส่วนกลางแห่งแรกของโลก ใหญ่ที่สุดในเอเชียตะวันออกเฉียงใต้ — คำถามที่วิศวกรและผู้บริหารโรงงานไทยควรถามไม่ใช่ "เขามาทำไม" แต่คือ "เขาเลือกไทยเพราะอะไร และเราเอาปัจจัยนั้นมาใช้กับโรงงานของเราได้อย่างไร" คำตอบจากข้อมูลจริงของโครงการชัดเจนกว่าที่คิด: มันไม่ใช่แค่ค่าแรง ไม่ใช่แค่แรงจูงใจภาษี แต่คือชั้นโครงสร้างพื้นฐานดิจิทัลของนิคมอุตสาหกรรมที่ถูกออกแบบมาตั้งแต่วางแผนหลักปรับของพื้นที่ ข้อเท็จจริงจากโครงการ: อะไรทำให้การตัดสินใจเกิด โครงการนี้ตั้งอยู่ในนิคมอุตสาหกรรมระยองแห่งใหม่ (พื้นที่รวมประมาณ 7,000 ไร่ เฟส 1 พร้อมกว่า 80%) ภายใต้แนวคิด Smart Eco Industrial Estate จุดเด่นที่ถูกอ้างถึงตอนเปิดตัวคือ: Underground fiber optic (FTTx) ทั่วทั้งนิคม พร้อมเครือข่าย 5G — เส้นเลือดดิจิทัลระดับที่โรงงาน AI ต้องการตั้งแต่วันแรก ระบบบริหารจัดการพลังงานอัจฉริยะ ที่รองรับการเชื่อมต่อทั้งโรงงานอัจฉริยะและดาต้าเซ็นเตอร์ขนาดใหญ่ พลังงานสะอาดและระบบน้ำหมุนเวียน (โซลาร์ส่องสว่างถนน Reclamation Water) ตอบโจทย์คาร์บอนฟุตพรินต์ของ brand ระดับโลก โรงงานตั้งเป้าใช้ระบบอัตโนมัติขับเคลื่อนด้วย AI มากกว่า 65% พร้อม R&D Center เฉพาะสภาพอากาศเขตร้อน แผนภาพ: 4 ชั้นโครงสร้างพื้นฐานของ Smart Eco Industrial Estate — จากฐานกายภาพถึงบริการดิจิทัล (ที่มา: Honey Corporation) วิเคราะห์: 4 ชั้นโครงสร้างพื้นฐานที่นักลงทุนระดับโลกดู จากประกาศโครงการและแนวโน้มการลงทุนในภูมิภาค เราสรุปเป็น framework 4 ชั้นที่นักลงทุนอุตสาหกรรมใช้ประเมินพื้นที่: ชั้น องค์ประกอบ ทำไมสำคัญต่อโรงงาน AI 1. ฐานกายภาพทำเล EEC ถนน ไฟฟ้า น้ำอุตสาหกรรมเงื่อนไขจำเป็น แต่ไม่เพียงพอ — ทุกประเทศในภูมิภาคมี 2. พลังงานสะอาดSolar, น้ำหมุนเวียน, ระบบกักเก็บน้ำฝนโรงงานที่ส่งของไป EU/สหรัฐต้องมีคาร์บอนฟุตพรินต์ที่ตรวจสอบได้ 3. การเชื่อมต่อFTTx ใต้ดิน, 5G, redundant uplinkสายการผลิต AI ส่งข้อมูล vision และ sensor ปริมาณมหาศาลต่อวินาที — แบนด์วิดท์และ latency คือข้อจำกัดจริง 4. บริการดิจิทัลUtility monitoring ระดับนิคมฯ แพลตฟอร์ม ESGลดภาระของโรงงานแต่ละแห่งในการสร้างระบบเองตั้งแต่ศูนย์…
Read More
Case Study: เมื่อ ‘เอลนีโญ’ บังคับให้โรงงาน EEC ต้องลดการใช้น้ำ 10-15% — Smart Water Management ด้วย IIoT คือคำตอบของปี 2569-2570

Case Study: เมื่อ ‘เอลนีโญ’ บังคับให้โรงงาน EEC ต้องลดการใช้น้ำ 10-15% — Smart Water Management ด้วย IIoT คือคำตอบของปี 2569-2570

Article
"โรงงานในนิคมอุตสาหกรรมต้องลดการใช้น้ำลง 10-15% และต้องนำน้ำเสียกลับมาบำบัดหมุนเวียนใช้ใหม่ไม่น้อยกว่า 15% ของปริมาณน้ำที่ใช้" — นี่ไม่ใช่คำแนะนำ แต่คือเป้าหมายบังคับที่หน่วยงานบริหารทรัพยากรน้ำแห่งชาติ (สทนช.) ประกาศผ่านแผนรับมือสภาวะเอลนีโญ ปี 2569-2570 สำหรับพื้นที่เขตเศรษฐกิจพิเศษภาคตะวันออก (EEC) อันประกอบด้วยฉะเชิงเทรา ชลบุรี และระยอง ทำไมถึงเข้มงวดขนาดนี้? เพราะตัวเลขของแท้เล่าเรื่องเดียวกันทั้งหมด: สถานการณ์เอลนีโญปีนี้ถูกประเมินว่ารุนแรงที่สุดในรอบ 140 ปี อ่างเก็บน้ำหลักของ EEC ทั้ง 16 แห่ง (ใหญ่ 4 + กลาง 12) มีน้ำรวมกันเพียง 534 ล้านลูกบาศก์เมตร หรือ 44% ของความจุกักเก็บ ขณะที่ความต้องการใช้น้ำทั้งปี 2570 ของพื้นที่ EEC คาดการณ์ที่ 2,888 ล้าน ลบ.ม. ช่องว่างนี้ไม่มีทางปิดด้วยการรอฝนเพียงอย่างเดียว Problem: เมื่อ "น้ำ" กลายเป็นความเสี่ยงด้านกำลังผลิต สำหรับโรงงานจำนวนมาก น้ำคือ input ที่ถูกประเมินต่ำเกินไปตลอดหลายสิบปี มันปรากฏในกระบวนการผลิตแทบทุกขั้น — ล้างชิ้นงาน หล่อเย็น boiler ระบบปรับอากาศ และคลังสินค้าควบคุมอุณหภูมิ เมื่อนโยบายส่วนกลางสั่งลดการใช้ 10-15% ภายในกรอบเวลาไม่กี่ปี โรงงานส่วนใหญ่เผชิญ 3 ปัญหาคลาสสิก: ไม่รู้ว่าน้ำหายไปตรงไหน — ไม่มี meter ย่อยรายจุด รู้แค่ยอดรวมจากใบแจ้งหนี้ประปาต้นเดือน ไม่รู้ baseline ต่อหน่วยผลิต — ไม่เคยคำนวณว่าผลิต 1 หน่วยใช้น้ำกี่ลิตร จึงตั้งเป้า "ลด 10%" ไม่ได้จริง น้ำเสียถูกมองเป็นต้นทุนกำจัด — ทั้งที่หลายกระบวนการ น้ำ used ยังผ่าน treatment กลับมาใช้ในงานที่ต้องการคุณภาพต่ำกว่าได้ Solution: Smart Water Loop ด้วย IIoT ใน 4 ขั้น กรณีศึกษาจากโครงการประหยัดน้ำในนิคมอุตสาหกรรมหลายแห่งชี้ว่า เส้นทางที่ได้ผลจริงมี 4 ขั้นตอนต่อเนื่องกัน: แผนภาพ: วงจร Smart Water Management 4 ขั้นตอนจากการวัดค่าจริงสู่การรายงาน ESG (ที่มา: Honey Corporation) ขั้นที่ 1: Measure — ติด meter ให้ครบก่อนคิดอะไรอื่น หัวใจคือการติด smart flow meter (แบบ ultrasonic…
Read More