Autonomous Factory ของโรงงานเซมิคอนดักเตอร์ Backend: ถอดบทเรียนจากโรงงานชิป Power Module มูลค่า 48,000 ล้านบาทที่เพิ่งเปิดในไทย

Autonomous Factory ของโรงงานเซมิคอนดักเตอร์ Backend: ถอดบทเรียนจากโรงงานชิป Power Module มูลค่า 48,000 ล้านบาทที่เพิ่งเปิดในไทย

Article
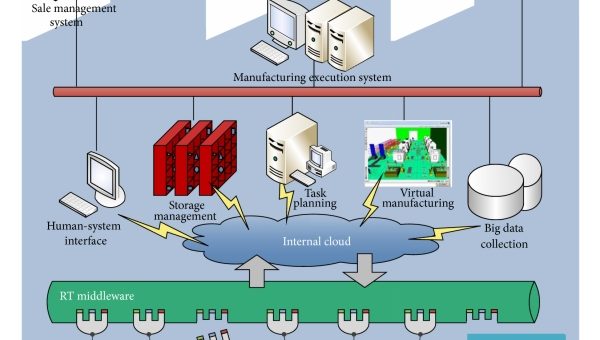
วันที่ 1 ตุลาคม 2569 ถือเป็นหมุดหมายสำคัญของอุตสาหกรรมการผลิตไทย — โรงงานผลิตเซมิคอนดักเตอร์ขั้นปลาย (Backend) แห่งใหม่มูลค่าการลงทุนกว่า 48,000 ล้านบาท ในจังหวัดสมุทรปราการเปิดตัวอย่างเป็นทางการ โดยมีนายกรัฐมนตรีเป็นประธานในพิธี นี่ไม่ใช่แค่ข่าวการลงทุนต่างชาติอีกหนึ่งชิ้น แต่คือ โรงงานอัตโนมัติ (Autonomous Factory) แห่งแรกของบริษัทเจ้าของโครงการที่รวมการทดสอบเวเฟอร์ (Wafer Testing) เข้ากับการประกอบโมดูลกำลัง (Power Module) และการทดสอบวงจรรวม (IC Final Test) ไว้ในสถานที่เดียวกัน บทความนี้ถอดรหัสว่า "Autonomous Factory" ในบริบท Backend Semiconductor หน้าตาเป็นอย่างไร ใช้เทคโนโลยีอะไรบ้าง และวิศวกรอุตสาหกรรมไทยจะเรียนอะไรได้จากโครงการระดับโลกที่มาตั้งอยู่ในประเทศเรา ความจำเพาะของโครงการที่ต้องรู้ก่อน ตัวเลขสำคัญของโครงการนี้อธิบายขนาดความทะเยอทะยานได้ดี: พื้นที่ห้องคลีนรูมเฟสแรก 30,000 ตารางเมตร ออกแบบให้ขยายได้สูงสุด 5 โมดูล รวม 150,000 ตร.ม. — มากกว่าโรงงานที่ใหญ่ที่สุดปัจจุบันของบริษัทราว 2 เท่า เป็นฐานผลิต Power Module แห่งที่ 3 ของโลก ต่อจากเยอรมนีและจีน และหากขยายครบทุกเฟส ไทยจะขึ้นเป็นฐาน Backend ที่ใหญ่ที่สุดในโลกของบริษัท ใช้พลังงานไฟฟ้าสีเขียว 100% พร้อมแผงโซลาร์เซลล์ ระบบหมุนเวียนน้ำ และระบบกักเก็บน้ำฝน คาดการณ์การจ้างงาน 5,000 ตำแหน่ง เมื่อครบทุกเฟส (ประมาณ 1,000 คนต่อเฟส) เน้นวิศวกรและช่างเทคนิค เงื่อไขถ่ายทอดเทคโนโลยี: พัฒนาบุคลากรไทยด้านวิทยาศาสตร์เทคโนโลยี 600 คน ส่งไปฝึกอบรมต่างประเทศ 130 คน ร่วมพัฒนาหลักสูตร 60 วิชา และวิจัยร่วม 680 โครงการ แผนภาพ: สถาปัตยกรรม Autonomous Backend Factory ที่รวม 3 กระบวนการหลักไว้ในโรงงานเดียว (ที่มา: Honey Corporation) ทำไม Backend ต้อง Autonomous มากกว่า Frontend? คนนอกวงการมักคิดว่าขั้นตอน Frontend (การผลิตเวเฟอร์) ซับซ้อนกว่า แต่ในมุมของวิศวกร Automation ขั้นตอน Backend กลับเป็นโจทย์ที่ท้าทายไม่แพ้กัน เพราะต้องจัดการกับ: ความหลากหลายของผลิตภัณฑ์ — โมดูลกำลังหนึ่งรุ่นอาจมี package หลายขนาด ทำให้ changeover บ่อยและต้องพึ่งระบบลำเลียงอัตโนมัติที่ยืดหยุ่น ความต้องการความสะอาดระดับสูงแต่ไม่สูงเท่า Frontend — โดยทั่วไปอยู่ในช่วง ISO…
Read More
บทวิเคราะห์ Powder Lifecycle Management: เมื่อผงโลหะ 90% ของเตียงพิมพ์ต้องถูกติดตามทุกรอบ ไม่ใช่แค่นับ reuse

บทวิเคราะห์ Powder Lifecycle Management: เมื่อผงโลหะ 90% ของเตียงพิมพ์ต้องถูกติดตามทุกรอบ ไม่ใช่แค่นับ reuse

Article
ในโลกของ Metal Additive Manufacturing มีตัวแปรที่ถูกพูดถึงน้อยกว่าเครื่องพิมพ์และดีไซน์ แต่ส่งผลต่อคุณภาพชิ้นงานโดยตรงเท่ากัน: ผงโลหะที่ใช้แล้วนำกลับมาใช้ใหม่ (powder reuse) เพราะในกระบวนการ Powder Bed Fusion ผงทั้งเตียงไม่ได้ถูกหลอมหมด — มีเพียงส่วนที่เป็นชิ้นงานจริงเท่านั้น ที่เหลือกว่า 90–95% ของผงต้องถูกเก็บ ร่อน ผสม และนำกลับเข้าเตียงพิมพ์รอบถัดไป คำถามที่ทุกโรงพิมพ์ต้องตอบให้ได้คือ "ผงรอบที่เท่าไหร่ที่ยังปลอดภัย และเรารู้ได้อย่างไรว่าถึงรอบนั้นแล้ว" กลไกเบื้องหลัง: อะไรเปลี่ยนไปในผงทุกครั้งที่ถูกพิมพ์ ทุกครั้งที่ผงผ่านวงจร heat exposure ในเตียงพิมพ์ มี 4 กลไกหลักที่เปลี่ยนแปลงคุณสมบัติของผงอย่างสะสม: Oxygen pickup — ไทเทเนียมและอัลลอยที่มีองค์ประกอบไวปฏิกิริยาดูดซับออกซิเจนเพิ่มขึ้นทุกรอบ แม้ในบรรยากาศก๊าซเฉื่อยที่ควบคุมดีแล้วก็ตาม ระดับออกซิเจนในผงจะไต่ขึ้นเรื่อยๆ จนกระทบความเหนียวของชิ้นงาน Morphology degradation — ผงเม็ดกลม (spherical) ที่ไหลดีค่อยๆ เปลี่ยนรูปทรงเปลี่ยน บางส่วน sinter ติดกันเป็นเม็ดผิดรูป (satellites) ส่งผลต่อ flowability และ bulk density ที่เทลงเตียง PSD shift — particle size distribution เลื่อนไปทางเม็ดใหญ่ขึ้น เพราะเม็ดเล็กถูก heat ทำลายหรือร่อนออกก่อน Spatter contamination — ฟองไอโลหะที่กระเด็นออกจาก melt pool กลายเป็นเม็ดผงเผาไหม้ (oxidized spatter) ปนเปื้อนอยู่ในผงที่เก็บกลับ ภาพ SEM ผงสแตนเลส 316L ช่วง atomize แรก — เม็ดกลมสม่ำเสมอคือสิ่งที่ reuse หลายรอบจะค่อยๆ ทำลาย (ภาพ: Wikimedia Commons, CC BY 4.0) งานวิจัยบอกอะไรเรา งานวิจัยจำนวนมากในทศวรรษที่ผ่านมาพยายามตอบคำถามนี้ด้วยการทดสอบ reuse หลายสิบรอบต่อเนื่อง ภาพรวมที่เห็นสอดคล้องกันคือ การเปลี่ยนแปลงของผงเกิดขึ้นจริงและวัดได้ตั้งแต่รอบแรกๆ แต่ทิศทางและอัตราไม่ได้เลวร้ายเสมอไป — หลายการทดสอบพบว่าค่า flowability บางตัวชี้วัดดีขึ้นในช่วงแรกเพราะความชื้นและไอระเหยถูกกำจัดออก ก่อนที่ผลจาก morphology และออกซิเจนจะกลับมากดลงในรอบถัดๆ ไป สรุปได้ว่าไม่มีตัวเลข "จำนวนรอบมหัศจรรย์" ที่ใช้ได้กับทุกวัสดุ ทุกเครื่อง และทุกชิ้นงาน — สิ่งที่เป็นสากลคือ ผงต้องถูกทดสอบอย่างเป็นระบบทุกครั้งที่ผ่านการใช้งาน ไม่ใช่นับรอบอย่างเดียว มุมมองจาก Honey Corporation: เราเห็นแนวโน้มเดียวกันนี้ในหลายโครงการ industrial — ปัญหาไม่ใช่การขาดเครื่องมือทดสอบผง แต่คือการที่ข้อมูลการทดสอบถูกเก็บกระจัดกระจายในไฟล์ Excel ของแต่ละกะ…
Read More
How-to: Industrial CT ตรวจชิ้นงาน Additive Manufacturing ตั้งแต่เลือก Voxel ถึง Porosity Analysis ใน 7 ขั้นตอน

How-to: Industrial CT ตรวจชิ้นงาน Additive Manufacturing ตั้งแต่เลือก Voxel ถึง Porosity Analysis ใน 7 ขั้นตอน

Article
Industrial Computed Tomography (Industrial CT) คือเทคโนโลยีถ่ายภาพ 3 มิติด้วยรังสีเอกซ์ที่ก้าวขึ้นมาเป็น "มาตรฐานใหม่" ของการตรวจสอบชิ้นส่วน Additive Manufacturing ในช่วงหลายปีที่ผ่านมา เพราะมันตอบโจทย์ที่ NDT วิธีอื่นตอบไม่ได้: มองเห็นภายในชิ้นงานทั้งชิ้นโดยไม่ต้องทำลาย จากภายนอกจนถึงแกนกลาง ในหนึ่งการสแกน ทั้งยังได้ไฟล์โมเดล 3 มิติครบถ้วนที่นำไปเทียบกับไฟล์ CAD ต้นฉบับได้เลย หลักการทำงานสรุปได้ง่าย: หลอดเอกซ์เรย์หมุนรอบชิ้นงาน (หรือชิ้นงานหมุนรอบแหล่งกำเนิด) ตรวจจับด้วย flat panel detector นับพันภาพ 2 มิติจากมุมต่างๆ แล้วสร้างแบบจำลอง 3 มิติคืนกลับด้วยอัลกอริทึม reconstruction ผลลัพธ์คือ voxel model — คือพิกเซลที่มีความหนา จุดข้อมูลที่เล็กที่สุดของภาพ ซึ่งขนาด voxel กำหนดว่าเราจะมองเห็นรู (porosity) เล็กแค่ไหนได้ เครื่อง Industrial CT ยุคใหม่ใช้ digital direct detection — ความละเอียดและความไวต่อความหนาแน่นวัสดุสูงกว่า film ดั้งเดิมหลายเท่า (ภาพ: Wikimedia Commons, CC BY-SA 4.0) เจ็บปวดที่ CT มาแก้: Defect ที่ซ่อนอยู่ใต้พื้นผิว ชิ้นงาน AM มี defect จำเพาะที่โปรเซสแบบดั้งเดิมไม่มี — lack of fusion (หลอมไม่ติดกันเพราะพลังงานต่ำเกิน) กลายเป็นรูเปล่ายืดยาวพร้อมขอบแหลม, keyhole porosity (เปิดโพรงไอโลหะแล้วพังทลายกลายเป็นรูกลม), และ trapped powder ในช่องภายในที่ออกแบบให้เป็น channel หรือ lattice สิ่งเหล่านี้อยู่ "ใต้ผิว" การตรวจด้วยตา (VT) มองไม่เห็น Penetrant Testing (PT) ก็จับไม่ได้เพราะรูไม่เปิดออกผิว และ Ultrasonic Testing (UT) แบบดั้งเดิมเจอปัญหาพื้นผิวหยาบของ AM ที่ทำให้ coupling แย่ — CT จึงเป็นคำตอบที่เหลืออยู่เพียงคำตอบเดียวสำหรับชิ้นงาน AM ที่มีความซับซ้อนสูง ตัวอย่าง void ที่ CT ตรวจพบภายในชิ้นงาน — defect ประเภทนี้ VT/PT มองไม่เห็นเพราะไม่เปิดออกสู่ผิว (ภาพ: Wikimedia Commons, CC BY-SA…
Read More
Case Study: AR Indoor Navigation ในคลังสินค้า — เมื่อ BLE 5.1 AOA ตรงเข้าบินหาชั้นวางที่ 40 ซม. และลด Visual Search Time ด้วยลูกศรบนแว่น

Case Study: AR Indoor Navigation ในคลังสินค้า — เมื่อ BLE 5.1 AOA ตรงเข้าบินหาชั้นวางที่ 40 ซม. และลด Visual Search Time ด้วยลูกศรบนแว่น

Article
คลังสินค้าขนาดกลางแห่งหนึ่งของไทยมีปัญหาที่ฟังดูง่ายแต่แก้ยาก: พนักงานใหม่ใช้เวลา 3 สัปดาห์จึงจำตำแหน่ง SKU (Stock Keeping Unit) ได้ครบ และพนักงานที่จำได้ก็เผชิญปัญหาเมื่อมีการจัดเรียงสินค้าใหม่ (Slotting Optimization) ทำให้ "แผนที่ในหัว" ใช้ไม่ได้ทันที ผลลัพธ์คือ Pick Rate ตก และ Error Rate เพิ่ม กรณีศึกษาสังเคราะห์นี้ถอดบทเรียนจากงานวิจัยระบบตำแหน่งภายในอาคารระดับเซนติเมตรของมหาวิทยาลัยเทคโนโลยีพระจอมเกล้าธนบุรี (KMUTNB) ปี 2022 มาผสานกับแนวคิด Visual Search Theory และ AR Overlay เพื่อแสดงวิธีแก้ปัญหานี้อย่างเป็นระบบ คลังสินค้าชิ้นส่วนย่อยแบบอัตโนมัติ — สภาพแวดล้อมที่ตำแหน่งผิด 1 เมตรหมายถึงชั้นวางผิดทั้งแถว (ภาพ: Wikimedia Commons / Logi.cool, CC BY-SA 4.0) ปัญหา: Visual Search คือตัวกินเวลาที่ถูกมองข้าม ในงานคลังสินค้า เวลาของพนักงานแบ่งเป็นการเดิน การหา และการหยิบ มนุษย์หาสิ่งของด้วยกระบวนการที่จิตวิทยาการรับรู้เรียกว่า Visual Search — การสแกนสภาพแวดล้อมเพื่อหาเป้าหมายท่ามกลางสิ่งรบกวน (Distractors) งานวิจัยพบว่าถ้าเป้าหมายมีลักษณะเด่นจำเพาะ (เช่น สีเดียวที่ต่างจากทุกอย่างรอบตัว) การค้นหาจะเป็นแบบ "Pop-out" ที่เวลาไม่ขึ้นกับจำนวนสิ่งรบกวนเลย แต่ถ้าต้องจับคู่หลายลักษณะพร้อมกัน (Conjunction Search เช่น หากล่องสีน้ำเงินที่มีป้ายเหลือง) เวลาค้นหาจะเพิ่มขึ้นเชิงเส้นตามจำนวนสิ่งรบกวน นั่นคือเหตุผลที่ชั้นวางที่ดูเหมือนกันหมด 60 ช่อง ทำให้พนักงานใหม่หาของช้าอย่างเป็นระบบ ไม่ใช่เพราะขาดสมาธิ ทางออกที่ 1: ตำแหน่งที่แม่นระดับเซนติเมตรด้วย BLE 5.1 AOA ระบบนำทางในอาคารต้องการความแม่นยำสูงกว่า GPS ที่ให้ได้ 3–8 เมตร ตามงานวิจัยของ KMUTNB เทคโนโลยีดั้งเดิมอย่าง RSSI (Received Signal Strength Indicator) ของ Bluetooth ให้ความคลาดเคลื่อน 3–5 เมตร และ Wi-Fi คลาดเคลื่อนเกิน 5 เมตร — ไม่พอสำหรับการชี้ชั้นวาง แต่มาตรฐาน Bluetooth 5.1 Direction Finding ที่วัดมุมมาของสัญญาณ (Angle of Arrival: AOA) โดยใช้เสาอากาศแถว (Antenna Array) หลายตัวรับสัญญาณจาก Tag เดียว เปลี่ยนเกมไปเลย: ต้นแบบของงานวิจัยเดียวกันทำความคลาดเคลื่อนเฉลี่ยได้ 67.1 ซม.…
Read More
How-to: Expert Knowledge Capture ด้วย AR — 6 ขั้นตอนกู้ความรู้จากวิศวกรอาวุโสก่อนเกษียณ พร้อมเปลี่ยนเป็น Digital Work Instructions

How-to: Expert Knowledge Capture ด้วย AR — 6 ขั้นตอนกู้ความรู้จากวิศวกรอาวุโสก่อนเกษียณ พร้อมเปลี่ยนเป็น Digital Work Instructions

Article
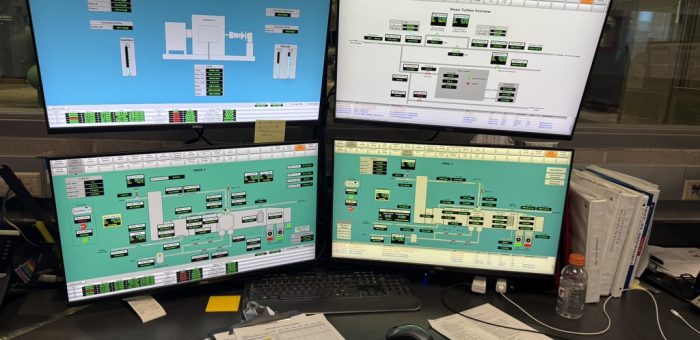
โรงงานหลายแห่งในไทยกำลังเผชิญความเสี่ยงที่ไม่ปรากฏในงบการเงิน: วิศวกรอาวุโสที่ดูแลเครื่องจักรสายหลักมา 25 ปี กำลังจะเกษียณ และความรู้ที่อยู่ในหัวของเขา — วิธีฟังเสียงเบาล์วก่อนจะเสีย จุดไหนของไฮดรอลิกที่ต้องเช็คก่อนเสมอ หรือเคล็ดลับตั้งค่าเครื่องหลังเปลี่ยนรุ่นผลิต — จะหายไปพร้อมกัน เทคโนโลยี AR (Augmented Reality) ช่วยแก้ปัญหานี้ได้ด้วยแนวทางที่เรียกว่า Expert Knowledge Capture คือบันทึกความรู้ของผู้เชี่ยวชาญในรูปแบบที่ผูกกับตำแหน่งจริงบนเครื่องจักร (World-Anchored Annotations) แล้วแปลงเป็นคู่มือปฏิบัติงานดิจิทัลที่คนรุ่นใหม่เรียกดูได้บนแว่น AR เหมือนมีอาจารย์ยืนอยู่ข้างๆ ช่างเทคนิคใช้ AR ในงานบริการภาคสนาม — โหมดเดียวกับที่ใช้บันทึกความรู้ผู้เชี่ยวชาญแบบ See-What-I-See (ภาพ: Wikimedia Commons, CC BY-SA 4.0) ทำไมต้องเป็น AR ไม่ใช่วิดีโอธรรมดา คำถามแรกที่ผู้จัดการโรงงานมักถามคือ "ถ่ายวิดีโอไว้ดูก็ได้ ทำไมต้องลงทุน AR" คำตอบมีสามชั้น: บริบทเชิงพื้นที่: วิดีโอบันทึกภาพ 2 มิติที่ต้อง "เลื่อนหา" ว่าช่วงไหนพูดถึงชิ้นส่วนไหน ส่วน Annotation บน AR ผูกกับพิกัด 3 มิติบนเครื่องจักรจริง เมื่อช่างรุ่นใหม่สวมแว่นแล้วเดินไปหน้าเครื่อง คำอธิบายจะปรากฏตรงจุดที่ผูกไว้เสมอ แม้มุมมองจะเปลี่ยน Hands-free: งานซ่อมบำรุงต้องใช้มือสองข้าง การหยิบแท็บเล็ตมาเลื่อนดูวิดีโอทำลายสมาธิและเพิ่มความเสี่ยงปนเปื้อน ต่อยอดเป็นฐานข้อมูล: ความรู้ที่บันทึกแบบ AR เป็นข้อมูลมีโครงสร้าง (Object + ตำแหน่ง + คำอธิบาย + สื่อ) ที่สามารถเชื่อมกับ CMMS หรือระบบ MES ภายหลัง กลายเป็นเนื้อหาของ Digital Work Instructions อัตโนมัติ 6 ขั้นตอนบันทึกความรู้ ขั้นที่ 1: จัดลำดับความรู้ตามความเสี่ยง (Knowledge Audit) อย่าเริ่มจาก "อยากบันทึกทุกอย่าง" เพราะจะล้มเพราะขอบเขตกว้างเกินไป ให้ทำเมทริกซ์ 2 แกน: แกนนอนคือระดับความเสี่ยงถ้าความรู้หาย (หยุดสายการผลิต? กระทบความปลอดภัย?) แกนตั้งคือจำนวนคนที่รู้เรื่องนั้นอยู่ (Single Point of Knowledge) — เริ่มบันทึกจากช่อง "เสี่ยงสูง + คนรู้น้อย" ก่อนเสมอ ขั้นที่ 2: เตรียมพื้นที่และเครื่องจักร เลือกสภาพแวดล้อมที่แสงเพียงพอสำหรับ Marker-based หรือ Markerless Tracking (ใช้จุดเด่นของเครื่องจักรเป็น Landmark) หากพื้นผิวเป็นโลหะมันวาวหรือมีการเคลื่อนไหวของคนในพื้นที่ ต้องเผื่อเวลา Calibration เพิ่ม ควรบันทึกทีเดียวให้ครบทุกมุมของสถานีนั้น เพราะการกลับมาบันทึกซ้ำทำให้เกิด Anchor…
Read More
Eye Tracking ใน AR อุตสาหกรรม: จาก Gaze Analytics สู่ Foveated Rendering — Deep Dive จาก Pupil-Corneal Reflection ถึง Attention Data ของโรงงาน

Eye Tracking ใน AR อุตสาหกรรม: จาก Gaze Analytics สู่ Foveated Rendering — Deep Dive จาก Pupil-Corneal Reflection ถึง Attention Data ของโรงงาน

Article
เมื่อพูดถึง AR (Augmented Reality) ในโรงงาน คนส่วนใหญ่นึกถึงภาพ "แว่นสมาร์ทที่ฉายคู่มือประกอบลอยอยู่กลางอากาศ" แต่สำหรับวิศวกรที่ทำงานจริง คำถามที่สำคัญกว่านั้นคือ ระบบรู้ได้อย่างไรว่าคนงานกำลัง "มอง" อะไรอยู่ คำตอบของคำถามนี้คือ Eye Tracking หรือการติดตามการกวาดสายตา ซึ่งกำลังเปลี่ยนจากฟีเจอร์หรูในหูฟัง VR ระดับไฮเอนด์ มาเป็นเครื่องมือวัดผลและออกแบบงาน (Ergonomics และ Work Study) ที่โรงงานสามารถใช้ได้จริง แว่นตาอเนกประสงค์ที่ติดตั้งกล้องติดตามดวงตา (สังเกตโมดูลกล้องใกล้ขอบเลนส์) — ฮาร์ดแวร์พื้นฐานของระบบ Eye Tracking แบบสวมใส่ (ภาพ: Wikimedia Commons / Anatolich1, CC BY-SA 3.0) หลักการทำงาน: ตามนัยตาไม่ทันเห็น กล้องเห็นก่อน Eye Tracker รุ่นใหม่ใช้หลักการ Video-based Oculography — ส่องแสงอินฟราเรด (Near-IR) ความถี่ต่ำเข้าตา แล้วใช้กล้องความเร็วสูงจับภาพ ระบบจะคำนวณตำแหน่งจากจุดสองจุดหลัก คือ ศูนย์กลางม่านตา (Pupil Center) และ จุดสะท้อนบนกระจกตา (Corneal Reflection หรือ Purkinje Image) เมื่อหัวขยับหรือตาหมุน มุมระหว่างสองจุดนี้เปลี่ยน ระบบก็คำนวณทิศทางการมอง (Gaze Vector) ออกมาได้แบบเรียลไทม์ ความเร็วในการสุ่มตัวอย่าง (Sampling Rate) คือหัวใจของการเลือกใช้งาน ตามข้อมูลอ้างอิงทางวิชาการ ระบบทั่วไปใช้ 30 Hz เป็นขั้นต่ำ 50–60 Hz เป็นมาตรฐานที่พบบ่อย ส่วนงานวิจัยหรืองานที่ต้องวิเคราะห์การเคลื่อนไหวของตาอย่างละเอียด เช่น การวัด Saccade Dynamics ต้องใช้เครื่อง 240, 350 หรือแม้กระทั่ง 1000/1250 Hz การใช้งานในโรงงาน Sampling Rate ที่ต้องการ สิ่งที่วัดได้ Heat Map จุดสนใจบนแผงควบคุม30–60 HzFixation, Dwell Time Work Study ท่าทาง + สายตา60–120 HzScan Path, AOI Sequence ตรวจ Saccade ตอนสัญญาณเตือนดัง240 Hz ขึ้นไปSaccade Latency, Velocity สังเกตการณ์ละเอียดสำหรับ Human Factors Research1000–1250 HzMicro-saccade, Drift, Tremor Heat Map…
Read More
บทวิเคราะห์: Digital Twin กับปัญหา Model Drift — เมื่อโมเดล PdM เริ่มเพี้ยน Fleet Learning จะช่วยได้จริงหรือไม่

บทวิเคราะห์: Digital Twin กับปัญหา Model Drift — เมื่อโมเดล PdM เริ่มเพี้ยน Fleet Learning จะช่วยได้จริงหรือไม่

Article
โมเดล AI ทำนายความเสียหายของเครื่องจักร (Predictive Maintenance) ตัวหนึ่งในโรงงานสิ่งทอทำงานได้แม่นยำมากในปีแรก แต่ปีที่สองความแม่นยำเริ่มถดลง เพราะสภาพเครื่องจักรเปลี่ยน โหลดการผลิตเปลี่ยน และพฤติกรรม "ปกติ" ของเครื่องจักรเลื่อนไปจากเดิม นี่คือปัญหา Model Drift ที่ทุกโรงงานต้องเจอ และเป็นคำถามเปิดของวงการว่า Digital Twin จะช่วยแก้ได้จริงหรือไม่ บทวิเคราะห์นี้มองปัญหาจากมุมวิศวกรรม ไม่ใช่มุมการตลาด ปัญหา Model Drift ในโรงงาน: ทำไมโมเดลเก่าเร็วจนน่าใจหาย โมเดล Anomaly Detection ส่วนใหญ่เรียนรู้จากข้อมูลในอดีต แล้วตั้งสมมติฐานว่าอนาคตจะคล้ายอดีต แต่ในโรงงานจริง ไม่มีอะไรนิ่ง: ชิ้นส่วนสึกหรอ, สูตรผลิตเปลี่ยน, ผู้ปฏิบัติงานเปลี่ยนวิธีเดินเครื่อง, อุณหภูมิแวดล้อมตามฤดูกาล หรือแม้แต่การซ่อมบำรุงที่ "ปรับ" พฤติกรรมเครื่องจักรไปโดยสิ้นเชิง ผลคือเกิดการแจ้งเตือนเท็จ (False Alarm) เพิ่มขึ้นเรื่อยๆ จนทีมซ่อมบำรุงเริ่มกด "Dismiss" โดยไม่อ่าน — และวันหนึ่ง Alarm จริงก็ถูกกดไปพร้อมกับพวกเท็จ แนวทางแก้แบบดั้งเดิมคือ การเทรนซ้ำ (Retraining) ด้วยข้อมูลใหม่ แต่คำถามคือใครจะ Label ข้อมูลว่าอะไรคือ "ปกติ" ในสถานการณ์ใหม่ และต้องรอนานแค่ไหนจึงจะมีข้อมูลเพียงพอ เพราะความเสียหายจริงเกิดไม่บ่อยนัก แนวคิดใหม่: Fleet Learning ผ่าน Digital Twin แนวคิดที่กำลังได้รับความสนใจคือการใช้ Digital Twin เป็น "ผู้เรียนรู้ร่วมกัน" ของกลุ่มเครื่องจักรลักษณะเดียวกัน แทนที่จะปล่อยให้แต่ละเครื่องเรียนรู้ลำพัง: สถาปัตยกรรม Smart Factory ยุคใหม่เชื่อมทุกชั้นข้อมูลเข้าด้วยกัน — Fleet Learning เป็นการขยายแนวคิดนี้สู่กลุ่มเครื่องจักรข้ามไซต์ (ภาพ: Wikimedia Commons, CC BY 4.0) หลักการคือ เมื่อเครื่องจักร A ในไซต์ 1 เจอ Failure Mode ใหม่และถูกบันทึกไว้ใน Twin ของมัน ความรู้นั้นสามารถถ่ายทอด (Transfer) ไปยังโมเดลของเครื่องจักร B, C, D ที่อยู่คนละไซต์แต่มีลักษณะเดียวกันได้ทันที เครื่องจักรอื่นๆ จึง "รู้" ล่วงหน้าโดยไม่ต้องเจอเองก่อน นี่คือความต่างสำคัญจากการเทรนโมเดลแบบเก่าที่ต้องรอเครื่องเสียจริงทีละตัวเพื่อสะสมประสบการณ์ วิเคราะห์กลไกทางเทคนิค: Twin ช่วยแก้ Drift ได้อย่างไร กลไก วิธีการทำงาน ข้อดี ข้อจำกัดที่ต้องยอมรับ Simulation Augmentationใช้ Twin จำลองสถานการณ์ที่ยังไม่เคยเกิดจริง สร้างข้อมูล Synthetic สำหรับเทรนโมเดลได้ข้อมูล Failure…
Read More
How-to: สร้าง Digital Twin ของระบบควบคุมเครื่องจักรเก่า — ถอด Logic สู่ Behavioral Twin ใน 6 ขั้นตอน

How-to: สร้าง Digital Twin ของระบบควบคุมเครื่องจักรเก่า — ถอด Logic สู่ Behavioral Twin ใน 6 ขั้นตอน

Article
โรงงานที่มีเครื่องจักรอายุ 10–20 ปีกำลังเจอปัญหาเดียวกัน: ระบบควบคุมเก่า อะไหล่หายาก และไม่มีใครกล้าแตะ Logic ที่เขียนไว้สมัยคนละยุค — เพราะแก้แล้วไลน์อาจหยุดทั้งวัน บทความนี้คือคู่มือทีละขั้น การสร้าง Digital Twin ของระบบควบคุมเครื่องจักรเก่า เพื่อทดสอบทุกอย่างในโลกเสมือนก่อนแตะโลกจริง แม้เครื่องจักรตัวนั้นจะอายุ 15 ปีแล้วก็ตาม ทำไมต้องเป็น Twin ของ "ระบบควบคุม" ไม่ใช่แค่หน้าตาเครื่องจักร Digital Twin ของเครื่องจักรเก่ามี 2 ระดับ ระดับแรกคือ 3D Model ที่สวยงามเหมาะกับการนำเสนอ ระดับที่สองคือ Behavioral Twin ที่จำลองพฤติกรรมการควบคุมจริง: Logic การทำงาน, Sequence การเริ่มเครื่อง, Interlock, และการตอบสนองต่อคำสั่ง ระดับที่สองนี่แหละที่มีคุณค่าทางวิศวกรรม เพราะมันทำให้คุณทดลองแก้ Logic, ทดสอบ Patch ใหม่ และฝึกคน โดยไม่เสี่ยงหยุดไลน์ผลิตจริง ระบบ SCADA เก่าของโรงงานจำนวนมากยังใช้งานอยู่ แต่ Logic ที่ซ่อนอยู่ด้านหลังคือความเสี่ยงเมื่อผู้พัฒนาดั้งเดิมไม่อยู่แล้ว — Twin ช่วยถอดรหัสนี้ได้ (ภาพ: Wikimedia Commons, CC0) ภาพรวมก่อนเริ่ม: สิ่งที่ต้องมี ขั้นตอน สิ่งที่ได้ ระยะเวลาอ้างอิง* 1. ตรวจจับ Logic เดิมคลัง Logic ที่ถอดออกมาได้ครบ1–2 สัปดาห์ 2. สร้าง Behavioral Modelโมเดลจำลองพฤติกรรมเครื่องจักร2–4 สัปดาห์ 3. เชื่อมข้อมูลจริง (Soft Sensor)ข้อมูลสถานะเครื่องจักรเก่าแบบเรียลไทม์1–3 สัปดาห์ 4. Validate ด้วยข้อมูลจริงค่าความคลาดเคลื่อนของโมเดลที่ยอมรับได้ต่อเนื่อง 5. ทดลองแก้ Logic บน TwinPatch ที่ทดสอบแล้วว่าปลอดภัยตามโจทย์ 6. Deploy + ฝึกทีมทีมใหม่ที่เข้าใจเครื่องจักรเก่าต่อเนื่อง *ระยะเวลาขึ้นกับความซับซ้อนของเครื่องจักรและความสมบูรณ์ของเอกสารเดิม ขั้นที่ 1: ถอด Logic เดิมออกจากเครื่องจักร (Logic Extraction) เริ่มจากดึงโปรแกรมควบคุม (Ladder Diagram, Function Block) ออกจาก PLC เดิมให้ได้มากที่สุด ปัญหาคือหลายโรงงานสูญเสีย Source Code ต้นฉบับ เหลือแค่ไฟล์ Compile แล้ว หรือระบบเก่าจน Software สำหรับเปิดไม่รองรับ OS ปัจจุบัน แนวทางที่ใช้ได้จริง: Reverse Engineering…
Read More
บทวิเคราะห์ Cloud Continuum: เลิกถามว่า ‘Edge หรือ Cloud’ แล้วเริ่มกำหนดนโยบายวาง Workload แบบต่อเนื่อง

บทวิเคราะห์ Cloud Continuum: เลิกถามว่า ‘Edge หรือ Cloud’ แล้วเริ่มกำหนดนโยบายวาง Workload แบบต่อเนื่อง

Article
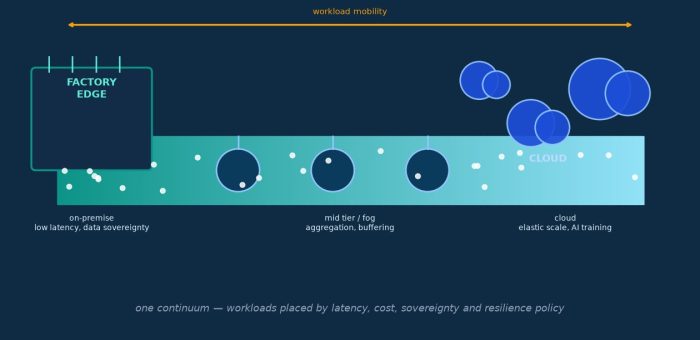
คำถามเก่าที่ยังไม่มีคำตอบสมบูรณ์: "งานนี้ควรอยู่ Edge หรือ Cloud" ตลอดหลายปีที่ผ่านมา การตัดสินใจว่า "งานไหนควรประมวลผลที่ไหน" เป็นคำถามที่ได้คำตอบแบบ binary: ถ้าต้องการเร็วให้อยู่ Edge, ถ้าต้องการ scale ให้อยู่ Cloud แต่เมื่อโรงงานหนึ่งมีทั้ง Edge Computer หลายสิบเครื่อง, on-premise server และบัญชี cloud ผู้ให้บริการหลายราย คำถามไม่ได้เป็นสองทางเลือกอีกต่อไป และเกิดปัญหาใหม่: ภาระการดูแลระบบที่กระจัดกระจาย (distributed sprawl) และ Silo ของข้อมูลที่ย้ายระหว่างกันไม่ได้ แนวคิดที่ตอบโจทย์นี้ในช่วงหลายปีที่ผ่านมาคือ Cloud Continuum — มองทรัพยากรคอมพิวติ้งทั้งหมดขององค์กรเป็น "ช่วงสเปกตรัมต่อเนื่อง" จาก on-premise edge ถึง public cloud ที่เชื่อมถึงกันด้วยเครือข่ายซอฟต์แวร์ (SDN) และ 5G แทนที่จะเป็นกล่องแยกส่วน งาน (workload) สามารถถูกวาง (place) และย้าย (migrate) ตามนโยบาย เช่น latency, อธิปไตยของข้อมูล (sovereignty) และความทนทาน ภาพประกอบ: การวาง workload บน continuum — แกนนอนคือเพดาน latency ที่งานยอมรับได้ (log scale) แกนตั้งคือประโยชน์จาก elasticity งานขวาบน (ฝึกโมเดล AI) ได้ประโยชน์จากคลาวด์มากที่สุด ส่วนงานซ้ายล่าง (motion control) ต้องอยู่ edge เสมอ จาก "เลือกที่" สู่ "กำหนดนโยบาย": วิธีคิดแบบ Continuum จุดเปลี่ยนสำคัญของมุมมองแบบ continuum คือการเปลี่ยนจากคำถาม "งานนี้ควรอยู่ที่ไหน" เป็น "นโยบายอะไรกำหนดว่างานนี้ควรอยู่ที่ไหน" ตัวอย่างเช่น: นโยบาย คำถามที่นโยบายตอบ ผลลัพธ์ต่อการวางงาน Latency ceiling งานยอมรับ delay เกิน X ms ได้หรือไม่? > 100 ms → ขึ้นคลาวด์ได้; < 10 ms → ต้องอยู่ edge/fog Data gravity ข้อมูลเกิดใหม่เร็วแค่ไหน และผู้บริโภคอยู่ไหน? ข้อมูล 1 kHz ต้องกรองที่ edge ก่อนส่งต่อ…
Read More
Humanoid Robot แบบ RaaS: คู่มือตัดสินใจ Rent vs Buy จาก 3 Use Case จริงปี 2026 — เมื่อผู้ผลิตชิ้นส่วนรายใหญ่ตั้งเป้า 2,000 ตัวภายในปี 2032

Humanoid Robot แบบ RaaS: คู่มือตัดสินใจ Rent vs Buy จาก 3 Use Case จริงปี 2026 — เมื่อผู้ผลิตชิ้นส่วนรายใหญ่ตั้งเป้า 2,000 ตัวภายในปี 2032

Article
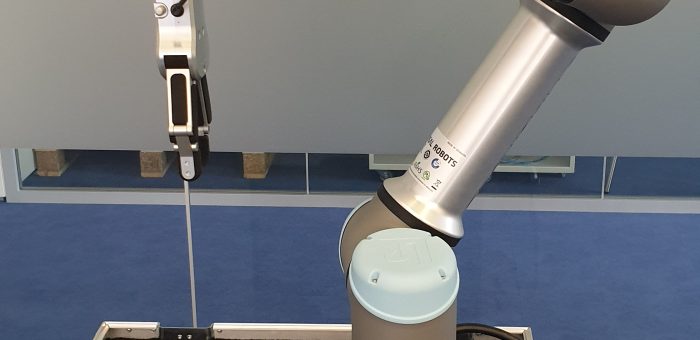
ปี 2026 หุ่นยนต์ฮิวแมนนอยด์ข้ามจากหน้าข่าวสู่สายการผลิตจริงแล้ว ตัวเลขล่าสุดที่น่าสนใจที่สุดคือแผนของผู้ผลิตชิ้นส่วนยานยนต์แถวหน้าของโลกรายหนึ่ง ที่จะติดตั้งหุ่นยนต์รูปแบบมนุษย์ 1,000–2,000 ตัวในโรงงานทั่วโลกภายในปี 2032 เริ่มที่โรงงานในเยอรมนีปลายปีนี้ ในรูปแบบ Robot-as-a-Service (RaaS) แต่ประเด็นของบทความนี้ไม่ใช่ "หุ่นยนต์เก่งแค่ไหน" แต่คือ คำถามที่ผู้จัดการโรงงานทุกคนต้องตอบก่อนเซ็นสัญญา: RaaS หรือซื้อขาด? เพราะเทคโนโลยีที่เปลี่ยนเร็วที่สุดในรอบสิบปี ความผิดพลาดในการเลือกรูปแบบการได้มาสามารถกินกำไรทั้งปีได้ 3 Use Case จริงที่กำหนดสนามแห่งใหม่ ก่อนตัดสินใจ เรามาดูว่าปี 2026 หุ่นยนต์ฮิวแมนนอยด์ทำอะไรได้จริงใน 3 กรณีอ้างอิงจากภาคการผลิต: Use Case รายละเอียดงาน ตัวเลขสำคัญ งานโหลดชิ้นงานงานเชื่อม (สหรัฐฯ)ทำงานร่วมกับสายการประกอบยานยนต์กว่า 11 เดือน, 5 วัน/สัปดาห์, กะละ 10 ชั่วโมง, ร่วมประกอบรถยนต์ 30,000+ คัน, โหลดโลหะ 90,000+ ชิ้นสำหรับฟิกเจอร์งานเชื่อมความแม่นยำการหยิบจับ >99% งานโลจิสติกส์และซัพพลายเชน (แคนาดา)ผู้ผลิตรถยนต์รายใหญ่ขยายการใช้งานสู่งานขนส่งภายในและซัพพลายเชนครบวงจรขยายจากงานทดลองสู่การผลิตจริง แผนปรับใช้ทั่วโลก (เยอรมนี)ผู้ผลิตชิ้นส่วนยานยนต์เริ่มต้นที่โรงงานในเยอรมนีปลายปี 2026 ผ่านรูปแบบ RaaSเป้า 1,000–2,000 ตัวภายในปี 2032 หุ่นยนต์รูปแบบมนุษย์ต้องทำงานร่วมกับคนและเครื่องจักรเดิมในพื้นที่เดียวกัน — ความปลอดภัยและการผสานระบบคือโจทย์ใหญ่กว่าความเก่งของตัวหุ่น (ภาพ: Wikimedia Commons, CC BY-SA 4.0) ทำไม RaaS กลายเป็นคำตอบของปี 2026 เมื่อเทคโนโลยีเปลี่ยนเร็ว การเป็นเจ้าของคือการแบกความเสี่ยงความล้าสมัยเอง RaaS เปลี่ยนหุ่นยนต์จากสินทรัพย์ที่ต้องเกษียณเป็นบริการที่อัปเกรดตามสัญญา ผู้ผลิตชิ้นส่วนรายใหญ่ที่ประกาศแผน 2,000 ตัวเลือก RaaS ไม่ใช่เพราะไม่มีเงิน แต่เพราะ ในช่วงที่ฮาร์ดแวร์และโมเดล AI อัปเกรดทุก 6–12 เดือน การล็อกตัวเองกับรุ่นใดรุ่นหนึ่งคือความเสี่ยง กรอบตัดสินใจ Rent vs Buy — งานที่ยังเปลี่ยนแปลงเร็วเหมาะกับ RaaS งานที่ล็อกแล้วเหมาะกับการซื้อขาด (แผนภาพ: Honey Corporation) Checklist 8 ข้อ ก่อนเซ็นสัญญา RaaS หุ่นยนต์ฮิวแมนนอยด์ เคสงานต้อง "เป็นรูปเป็นร่าง" ก่อน — เริ่มจากงานซ้ำที่วัดผลได้ เช่น การโหลดชิ้นงาน การยกสินค้าขึ้นแท่นวาง ก่อนคิดงานผสานทักษะ ถามเรื่อง Uptime ในสัญญา — บริการที่ดีต้องมี SLA ระบุเวลาทำงานจริงต่อสัปดาห์ ไม่ใช่แค่สเปกกระดาษ อ้างอิงมาตรฐานจาก use case จริง: 5 วัน ×…
Read More