บทวิเคราะห์: Edge หรือ Cloud — ตัวเลขตลาดบอกว่าคำถามนี้ผิดตั้งแต่ต้น (และโรงงานควรถามอะไรแทน)

บทวิเคราะห์: Edge หรือ Cloud — ตัวเลขตลาดบอกว่าคำถามนี้ผิดตั้งแต่ต้น (และโรงงานควรถามอะไรแทน)

Article
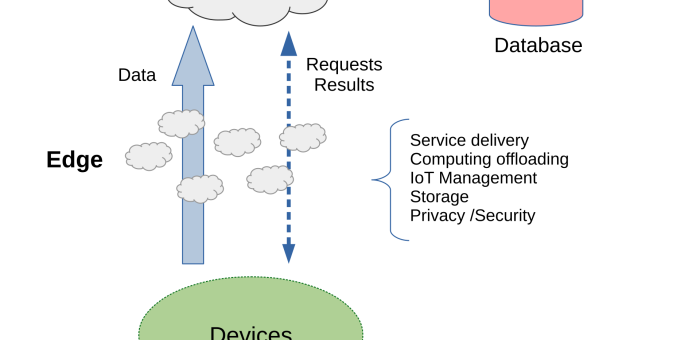
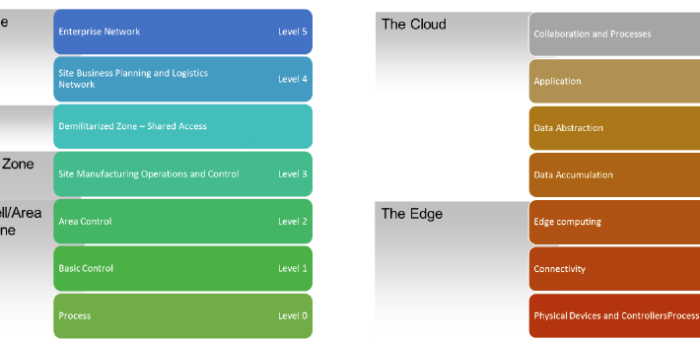
ช่วงสองสามปีที่ผ่านมา วิศวกรโรงงานไทยหลายท่านน่าจะเจอบทสนทนาแบบนี้: "เราควรเอาขึ้นคลาวด์หรือทำ edge ก่อน" คำถามดูเหมือนมีเหตุผล แต่ถ้าดูตัวเลขตลาดล่าสุดแล้ว จะพบว่านี่คือกรอบคิดที่กำลังล้าสมัย เพราะโลกไม่ได้กำลังเลือกระหว่างสองฝั่ง แต่กำลังเติบโต ทั้งสองฝั่งพร้อมกันอย่างก้าวกระโดด ตัวเลขที่ต้องรู้ก่อนตัดสินใจ รายงานล่าสุดของ Grand View Research ระบุว่าตลาด Edge Computing โลกมีมูลค่า 33.4 พันล้านดอลลาร์ในปี 2025 และประมาณการไว้ที่ 46.7 พันล้านดอลลาร์ในปี 2026 ก่อนจะขยายต่อไปถึง 328 พันล้านดอลลาร์ภายในปี 2033 คิดเป็น CAGR 32.1% ตลอดช่วง 2026–2033 — นี่คืออัตราเติบโตที่เร็วกว่าภาพรวมของ smart manufacturing ที่ IoT Analytics ประเมินไว้ที่ CAGR 9.3% (จาก 175 พันล้านดอลลาร์ในปี 2025 สู่ 274 พันล้านดอลลาร์ในปี 2030) ถึงสามเท่าครึ่ง ทำไมถึงเร็วขนาดนั้น? เพราะ edge ไม่ได้แข่งกับคลาวด์ แต่กำลัง เปิดกล่อง use case ใหม่ที่คลาวด์ทำไม่ได้ และเอเชียแปซิฟิกคือภูมิภาคที่โตเร็วที่สุด — Grand View Research ระบุ CAGR ของภูมิภาคเราที่ราว 39% สูงกว่าค่าเฉลี่ยโลก ซึ่งสอดคล้องกับการลงทุน infrastructure ดิจิทัลของไทยในช่วงนี้ Purdue Reference Model เทียบกับ IoT Reference Model — โครงสร้างระดับโรงงานกับระดับคลาวด์กำลังถูกออกแบบให้ทำงานร่วมกัน ไม่ใช่แยกกัน — ภาพ: Wikimedia Commons (CC BY-SA 4.0) คำถามที่ถูกต้อง: Workload นี้ควรอยู่ที่ไหน แทนที่จะถามว่า "เอาขึ้นคลาวด์หรือ edge" ให้ถามว่า "workload นี้มีคุณสมบัติอะไร" แล้วให้คุณสมบัตินั้นตัดสินใจแทน โดยเฉพาะสี่มิติที่ตัดสินได้ชัดเจนที่สุด: มิติการตัดสินใจ ชี้ไปทาง Edge ชี้ไปทาง Cloud Latency ที่ยอมรับได้ ต่ำกว่า ~50 ms เช่น interlock, หยุดเครื่องฉุกเฉิน วินาทีถึงนาที เช่น dashboard, รายงานรายเดือน ปริมาณข้อมูล สูงมากต่อวินาที (vibration 10 kHz, วิดีโอ 30 fps)…
Read More
Case Study: โรงงานอาหาร ‘เสียเครื่อง Edge ตอนตี 2’ — บทเรียนจากการย้าย Orchestration ลงสู่ระดับสายการผลิตด้วย Kubernetes แบบ Lightweight

Case Study: โรงงานอาหาร ‘เสียเครื่อง Edge ตอนตี 2’ — บทเรียนจากการย้าย Orchestration ลงสู่ระดับสายการผลิตด้วย Kubernetes แบบ Lightweight

Article
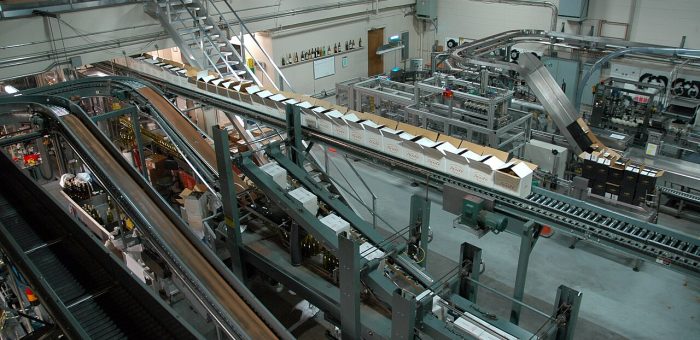
เรื่องนี้เล่าถึงโรงงานอาหารแห่งหนึ่งในนิคมอุตสาหกรรมภาคตะวันออก ที่เดิมใช้เกตเวย์ IoT แบบ standalone จำนวน 24 ตัวกระจายอยู่ทุกสายการผลิต แต่ละตัวเก็บค่าอุณหภูมิห้องเย็น ความชื้น และสถานะเครื่องจักร แล้วส่งขึ้นคลาวด์ผ่าน MQTT ทุกอย่างทำงานได้ดี... จนกระทั่งคืนหนึ่งที่เกตเวย์ตัวหนึ่งหยุดทำงานเพราะการ์ดหน่วยความจำเสีย และไม่มีใครรู้ตัวจนกระทั่งเช้าวันรุ่งขึ้น ข้อมูลห้องเย็นหายไป 7 ชั่วโมงเต็ม ซึ่งในธุรกิจอาหารแปลว่าต้องเขียนรายงานเหตุการณ์ deviation ยาวเหยียด และต้องประเมินความเสี่ยงต่อสินค้าที่เก็บในช่วงเวลานั้น ปัญหา: ความล้มเหลวแบบเงียบ (Silent Failure) การตรวจสอบย้อนหลังพบว่าปัญหาไม่ได้อยู่ที่ตัวเกตเวย์ แต่อยู่ที่สถาปัตยกรรม ระบบเดิมไม่มีกลไกใดตรวจจับว่าเกตเวย์ "ยังมีชีวิต" หรือไม่ และเมื่อเกตเวย์หนึ่งตัวตาย ก็ไม่มีตัวไหนรับหน้าที่แทน ทีมวิศวกรรมจึงเสนอแนวคิดที่ตอนนั้นดูเกินจำเป็นสำหรับโรงงานอาหาร นั่นคือการนำ container orchestration แบบ Kubernetes รุ่นเบา ลงมาวางที่ระดับสายการผลิต — ไม่ใช่เพื่อความสวยงามทางเทคนิค แต่เพื่อให้ได้สามอย่าง: self-healing, declarative configuration และ rollback ที่ทำได้ในไม่กี่วินาที การวางโหนด Edge หลายชั้นให้ครอบคลุมทุกสายการผลิต คือฐานของ orchestration แบบกระจาย — ภาพ: Wikimedia Commons (CC BY-SA 4.0) ทางออก: Single-node Cluster ที่ทุกสายการผลิต แนวทางที่เลือกไม่ใช่คลัสเตอร์กลางขนาดใหญ่ แต่เป็น คลัสเตอร์เล็กๆ อยู่กับสายการผลิต แต่ละสายมี industrial computer ตั้งแต่ 2 โหนดขึ้นไป รัน Kubernetes distribution แบบ lightweight ที่ตัดส่วนประกอบที่ไม่จำเป็นออก ตัว workload หลักมีสามชนิด: Collector — อ่านค่าจาก PLC ผ่าน OPC UA และเซ็นเซอร์ผ่าน Modbus TCP เขียนลง local time-series storage Rule engine — ประเมินเงื่อนไข alarm เช่น อุณหภูมิห้องเย็นเกิน -18°C นานเกิน 10 นาที แล้วส่งแจ้งเตือนผ่านหลายช่องทาง Forwarder — ส่งข้อมูลแบบ batch ขึ้นคลาวด์ พร้อม store-and-forward เมื่อลิงก์หลุด จุดเปลี่ยนที่สำคัญคือการตั้งค่า liveness/readiness probe ให้กับทุก workload — collector ที่ค้างไม่อ่านค่า PLC…
Read More
Fog Computing กลับมาเป็นข่าวอีกครั้ง: ชั้นคำนวณที่โรงงานไทยมองข้ามไป กำลังกลายเป็นหัวใจของ IIoT ยุค Edge AI

Fog Computing กลับมาเป็นข่าวอีกครั้ง: ชั้นคำนวณที่โรงงานไทยมองข้ามไป กำลังกลายเป็นหัวใจของ IIoT ยุค Edge AI

Article
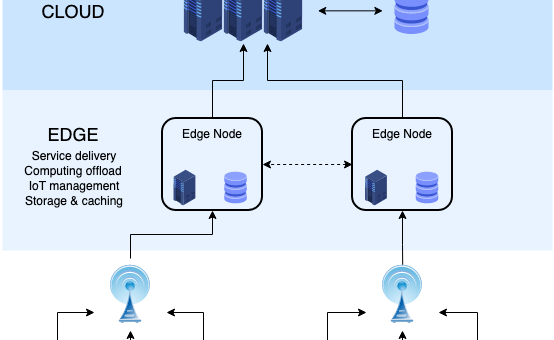
หลายโรงงานในไทยวางแผนธุรกิจดิจิทัลของตัวเองแบบสองขั้ว คือมีอุปกรณ์ IoT และ PLC อยู่ปลายทาง แล้วส่งข้อมูลขึ้นคลาวด์เพื่อประมวลผลทั้งหมด แต่เมื่อปริมาณข้อมูลเพิ่มขึ้นเป็นสิบเท่า และ AI เริ่มถูกใช้ตัดสินใจแบบเรียลไทม์บนพื้นโรงงาน สถาปัตยกรรมแบบสองขั้วนี้ก็เริ่มสะดุด คำตอบที่ถูกที่สุดไม่ใช่การย้ายทุกอย่างกลับมาอยู่ในโรงงาน แต่คือการเพิ่ม ชั้นคำนวณระหว่างกลาง ที่เรียกว่า Fog Computing ซึ่งกำลังกลับมาเป็นที่พูดถึงอีกครั้งในวงการอุตสาหกรรมปี 2026 สถาปัตยกรรมการคำนวณแบบไล่ระดับ ตั้งแต่อุปกรณ์ปลายทาง (Things) ผ่านชั้น Edge/Fog ขึ้นไปถึงคลาวด์ — ภาพ: Wikimedia Commons (CC BY-SA 4.0) ทำไมสองขั้วไม่พออีกต่อไป ลองนึกภาพสายการผลิตที่มีกล้องตรวจคุณภาพ 16 ตัว ส่งภาพความละเอียดสูงกลับคลาวด์เพื่อรันโมเดล Computer Vision ที่ 30 เฟรมต่อวินาที เสียงวิเคราะห์คลื่นเสียงเครื่องจักร และข้อมูล vibration ที่สุ่มที่ 10 kHz — แบนด์วิดท์ที่ต้องใช้ไม่ใช่แค่ "เยอะ" แต่แพงและเปราะ ถ้าเน็ตหลุดแม้เพียง 30 วินาที งานตรวจคุณภาพช่วงนั้นก็หายไปตลอดกาล ในทางกลับกัน การเอาทุกอย่างมาไว้ในเซิร์ฟเวอร์กลางในโรงงานล้มเหลวในอีกแบบ ทีม IT ต้องดูแลฮาร์ดแวร์ ทำ backup อัปเดต patch และขยายระบบทุกครั้งที่เพิ่มสายการผลิต Fog Computing เสนอทางที่สาม — กระจายการคำนวณลงไปในหลายๆ โหนดที่อยู่ใกล้แหล่งข้อมูล แต่ยังจัดการแบบรวมศูนย์ ตามแนวคิดที่ OpenFog Consortium (ซึ่งต่อมาควบรวมเข้ากับ Linux Foundation Edge) เคยสรุปไว้ใน Reference Architecture ว่าต้องมีคุณสมบัติ 8 ด้าน ตั้งแต่ Security, Scalability, Openness, Autonomy, Manageability, Agility, Hierarchical Organization ไปจนถึง Programmability ข้อกำหนดทางเทคนิคที่ต้องรู้ก่อนออกแบบ ประเด็นออกแบบ โจทย์จริงในโรงงาน แนวทาง Fog Latency budget ปิดสวิตช์ฉุกเฉินภายใน 10–50 ms หลังตรวจพบความผิดปกติ ประมวลผลและตัดสินใจที่โหนด Fog ในสายการผลิต ไม่รอ round-trip ไปคลาวด์ แบนด์วิดท์ กล้องตรวจคุณภาพ 16 ตัว ที่ 30 fps กินลิงก์ WAN เกินกว่าที่ลิงก์สำรองจะรับไหว สกัดเฉพาะผลลัพธ์และภาพที่พบ defect ขึ้นคลาวด์ ลดปริมาณข้อมูลขาออกได้ 90%…
Read More
How-to: สร้าง Line-level Digital Twin ใน 6 ขั้นตอน — จาก Data Pipeline ตาม ISA-95 สู่ What-if Simulation ที่ใช้ตัดสินใจจริง

How-to: สร้าง Line-level Digital Twin ใน 6 ขั้นตอน — จาก Data Pipeline ตาม ISA-95 สู่ What-if Simulation ที่ใช้ตัดสินใจจริง

Article
คำถามที่เราได้ยินบ่อยที่สุดในปี 2026: "โรงงานเรามีเครื่องจักรอยู่แล้ว เซ็นเซอร์ติดบ้างแล้ว จะเริ่ม Digital Twin จากตรงไหนดี" — คำตอบจากรายงานแนวโน้มอุตสาหกรรมปี 2026 หลายสำนักชี้ไปทางเดียวกัน: อย่าเริ่มจากเครื่องจักรเดี่ยว ให้เริ่มจากไลน์ผลิต (Production Line) ทั้งเส้น เพราะนั่นคือระดับที่ความล้มเหลวของ Digital Twin ส่วนใหญ่เกิดขึ้น และเป็นระดับที่ให้ผลตอบแทนชัดที่สุด บทวิเคราะห์จากสื่ออุตสาหกรรมการผลิตไทย (Manage & Manufacturing Thailand, ก.พ. 2026) สรุปภาพรวมไว้ว่า Digital Twin กำลังก้าวพ้นช่วงทดลอง (Pilot Phase) สู่การใช้งานจริงในระดับองค์กร โดยเฉพาะการผสานกับ CMMS (ระบบจัดการซ่อมบำรุง), ERP, Edge Computing และเครือข่าย 5G เพื่อลด Downtime และเพิ่มประสิทธิภาพสายการผลิตอย่างเป็นรูปธรรม ไลน์ผลิตจริงคือ "วัตถุดิบ" ของ Line-level Digital Twin — โมเดลที่ดีต้องสะท้อนทั้งจังหวะเครื่องจักร คอขวด และพฤติกรรมคนงาน (ที่มา: Tjeerd Wiersma, CC BY 2.0) ทำไมต้อง Line-level ไม่ใช่ Asset-level Digital Twin ระดับเครื่องจักรเดี่ยว (Asset Twin) เหมาะกับงานวิเคราะห์การสั่นสะเทือนหรืออายุการใช้งานแบริ่ง แต่คำถามที่แท้จริงของผู้จัดการโรงงานอยู่ในระดับที่สูงขึ้น: ถ้าเพิ่มกำลังผลิต 15% จะเกิดอะไรขึ้นกับคอขวด? ถ้าเปลี่ยนสูตรวัตถุดิบ จุดไหนของไลน์จะรับไม่ได้? คำถามเหล่านี้ตอบไม่ได้ด้วยการดูเครื่องจักรเดี่ยว — ต้องจำลอง ปฏิสัมพันธ์ระหว่างเครื่องจักรทุกตัวในไลน์รวมถึง Buffer และรอบเปลี่ยน Batch มิติ Asset Twin (เครื่องจักรเดี่ยว) Line-level Twin (ทั้งไลน์ผลิต) คำถามหลักที่ตอบได้ เครื่องนี้กำลังจะพังไหม? ควรเปลี่ยนอะไหล่เมื่อไร? เพิ่มกำลังผลิตแล้วคอขวดย้ายไปอยู่ตรงไหน? ไลน์รับสูตรใหม่ได้ไหม? ข้อมูลที่ต้องมี Vibration, Temperature, Motor Current ของเครื่องเป้าหมาย ข้อมูลทุกสถานี + อัตราการไหลชิ้นงาน + เวลา Changeover + OEE รายสถานี ผู้ใช้หลัก ทีมซ่อมบำรุง (Maintenance) ผู้จัดการผลิต + Process Engineer + ฝ่ายวางแผน ตัวอย่างการใช้งานเด่น คาดการณ์ความเสียหายแบริ่งล่วงหน้า 2-4 สัปดาห์ ทดสอบ What-if ก่อนเพิ่มกำลังผลิต /…
Read More
ตลาด SCADA โต CAGR 10% ถึงปี 2032: อ่านตัวเลข MarketsandMarkets ให้ขาด และสิ่งที่โรงงานไทยต้องทำตอนนี้

ตลาด SCADA โต CAGR 10% ถึงปี 2032: อ่านตัวเลข MarketsandMarkets ให้ขาด และสิ่งที่โรงงานไทยต้องทำตอนนี้

Article
ตลาด SCADA ทั่วโลกกำลังเข้าสู่ช่วงเร่งตัว — รายงานฉบับล่าสุดจาก MarketsandMarkets (ตีพิมพ์กันยายน 2026) คาดการณ์ว่ามูลค่าตลาดระบบควบคุมและเฝ้าระวังแบบรวมศูนย์จะเติบโตจาก 13.94 พันล้านดอลลาร์สหรัฐในปี 2026 สู่ 24.69 พันล้านดอลลาร์ในปี 2032 ด้วยอัตราเติบโตเฉลี่ยต่อปี (CAGR) 10.0% ตัวเลขนี้ไม่ได้แค่บอกว่า "มีคนซื้อ SCADA มากขึ้น" แต่สะท้อนการเปลี่ยนแปลงเชิงโครงสร้างว่าระบบ SCADA กำลังถูกมองใหม่จาก "ห้องควบคุมของฝ่ายวิศวกรรม" ไปเป็น "แพลตฟอร์มข้อมูลกลางของทั้งองค์กร" ทีมงาน Honey Corporation ติดตั้งระบบ SCADA และระบบเฝ้าระวังในโรงงานอุตสาหกรรมมากว่าหลายโครงการ และสิ่งที่เราเห็นชัดในรอบ 2-3 ปีคือ ลูกค้าไม่ได้ถามแค่ "จอภาพเก็บค่าจาก PLC ได้กี่จุด" อีกต่อไป แต่ถามว่า "ข้อมูลจาก SCADA จะเชื่อมไปยังระบบ MES, ERP และ Dashboard ผู้บริหารได้อย่างไร" — คำถามที่เปลี่ยนไปนี้แหละคือแรงขับเคลื่อนตัวจริงของตลาด 10.0% ที่รายงานบอก อ่านตัวเลขให้ขาด: SCADA 10.0% หมายความว่าอย่างไร เราลองแยกแยะว่า CAGR 10.0% ในช่วง 2026-2032 มาจากไหน โดยเทียบกับรายงานย่อยที่เกี่ยวข้องจากสำนักเดียวกัน: ตลาด ปีฐาน → ปีเป้า ขนาดตลาด CAGR สิ่งที่บอกเรา SCADA โดยรวม 2026 → 2032 USD 13.94B → 24.69B 10.0% โครงสร้างพื้นฐาน + ซอฟต์แวร์โตพร้อมกันทั้งไลน์ SCADA in BIM (อาคาร) → 2032 USD 16.60B 21.5% อาคารอัจฉริยะ + Digital Twin ดันส่วนผสม BIM Power SCADA (ไฟฟ้า) → 2028 USD 2.9B 7.1% กลุ่มพลังงานเติบโตสม่ำเสมอ ไม่ใช่ตัวขับหลัก ที่มา: MarketsandMarkets, SCADA Market Global Forecast to 2032 (ก.ย. 2026); Power SCADA Market (2024); SCADA in Building Information…
Read More
Case Study: กู้ 87 Interface สปาเกตตี้ด้วยสถาปัตยกรรม ISA-95 — จากตัวเลขไม่ตรงกันสู่แหล่งความจริงเดียว

Case Study: กู้ 87 Interface สปาเกตตี้ด้วยสถาปัตยกรรม ISA-95 — จากตัวเลขไม่ตรงกันสู่แหล่งความจริงเดียว

Article
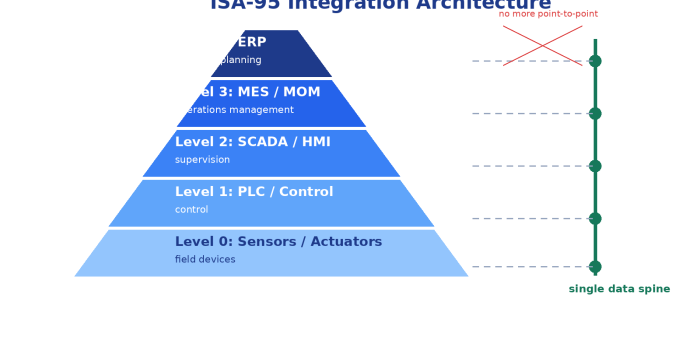
กรณีศึกษาจากงานติดตั้งจริงของทีม System Integration หลายโครงการในโรงงานอุตสาหกรรมไทย — รายละเอียดบางส่วนปรับปรุงเพื่อความเป็นส่วนตัวของลูกค้า จุดเริ่มต้น: ไฟล์ Excel หนึ่งไฟล์ที่ไม่มีใครกล้าแตะ โรงงานผลิตชิ้นส่วนแห่งหนึ่งที่ทีม Honey Corporation เข้าไปช่วย มี "อนุสาวรีย์" อยู่บนเครื่องคอมพิวเตอร์ของหัวหน้าแผนกผลิต — ไฟล์ Excel เก็บรายชื่อ interface ระหว่างระบบ ทั้งหมด 87 รายการ เชื่อมระบบเก็บข้อมูลการผลิต ระบบบริหารจัดการวัตถุดิบ ระบบซื้อ ระบบคลัง และหน้าจอเฝ้าระวังสายการผลิต แทบทุกคู่ บางเส้นวาดตั้งแต่สมัยที่ยังไม่มีใครในทีมปัจจุบันเกิดด้วยซ้ำ อาการที่โรงงานเจอก่อนมาหาเราคือคลาสสิกสุดๆ ของงานอินทิเกรชันแบบ point-to-point: ตัวเลขบนหน้าจอเฝ้าระวังกับตัวเลขในรายงานสิ้นวันไม่ตรงกัน ทีมไอทีโทษเครื่องจักร ทีมผลิตโทษระบบไอที ไม่มีใครหาต้นตอเจอเพราะทุก interface ถูกเขียนขึ้นคนละยุค คนละมาตรฐาน และคนละสไตล์ ทำไมเรื่องนี้ถึงเกิดซ้ำๆ ทุกโรงงาน: จุดบอดของ "เส้นเชื่อม" ปัญหาไม่ใช่ความผิดของใครคนใดคนหนึ่ง แต่เป็นคณิตศาสตร์ล้วนๆ เมื่อระบบหนึ่งเชื่อมกับอีกระบบหนึ่งแบบตรงๆ จำนวนเส้นเชื่อมจะเติบโตแบบยกกำลังสอง — 6 ระบบเท่ากับ 15 เส้น, 10 ระบบเท่ากับ 45 เส้น และทุกเส้นคือจุดเสี่ยงที่ข้อมูลอาจเพี้ยน พัง หรือถูกลืมเมื่อระบบใดระบบหนึ่งอัปเดตเวอร์ชัน ซ้าย: ปัญหาสปาเกตตี้ interface ที่โตแบบยกกำลังสอง | ขวา: การเชื่อมผ่านชุดข้อกำหนดกลางตามแนวคิด ISA-95 ที่โตแบบเส้นตรง (ภาพประกอบ: Honey Corporation) ทางออกที่วงการอุตสาหกรรมทั่วโลกใช้คือ มาตรฐาน ISA-95 (หรือ IEC 62264) ซึ่งไม่ใช่ซอฟต์แวร์ แต่คือชุดข้อกำหนดที่แบ่งโรงงานเป็นชั้นๆ พร้อมนิยามข้อมูลที่แลกเปลี่ยนกันระหว่างชั้นให้ชัดเจน ทำให้ทุกระบบพูด "ภาษาเดียวกัน" โดยไม่ต้องเขียน interface เฉพาะทีละคู่ ระดับ บทบาทหลัก ข้อมูลที่ไหลผ่าน กรอบเวลาการตัดสินใจ Level 4 — ธุรกิจ วางแผนขาย วางแผนวัตถุดิบ การเงิน แผนการผลิต ใบสั่งซื้อ ข้อมูลหลัก สัปดาห์-เดือน Level 3 — ปฏิบัติการผลิต จัดตารางผลิต ติดตามงาน เก็บประวัติล็อต คำสั่งผลิต ผลการผลิต การใช้วัตถุดิบ นาที-วัน Level 0-2 — ควบคุม ควบคุมเครื่องจักรและกระบวนการ ค่าเซ็นเซอร์ สถานะ สัญญาณควบคุม มิลลิวินาที-ชั่วโมง หัวใจของการแก้ปัญหาอยู่ที่รอยต่อระหว่าง Level 3 กับ Level…
Read More
How-to: เตรียมโรงงานเข้าสู่ยุค DPPA ใน 6 ขั้นตอน — เมื่อไฟฟ้าสะอาดระยะยาวเริ่มต้นที่ข้อมูล ไม่ใช่แผงโซล่าร์

How-to: เตรียมโรงงานเข้าสู่ยุค DPPA ใน 6 ขั้นตอน — เมื่อไฟฟ้าสะอาดระยะยาวเริ่มต้นที่ข้อมูล ไม่ใช่แผงโซล่าร์

Article
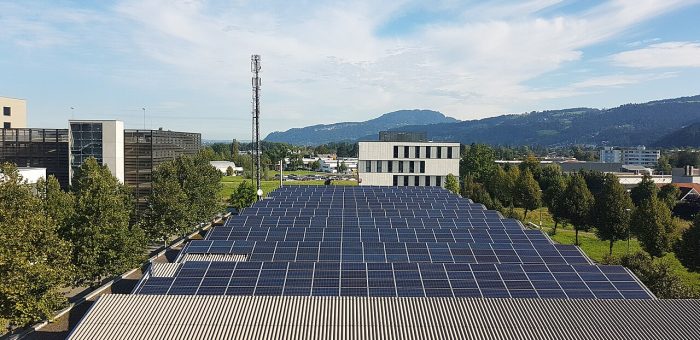
เมื่อกรอบการซื้อขายไฟฟ้าโดยตรง (Direct PPA: DPPA) ขนาด 2,000 เมกะวัตต์ เริ่มมีผลบังคับใช้ตั้งแต่เดือนมกราคม 2569 วงการพลังงานของไทยก้าวเข้าสู่บทใหม่ โรงงานอุตสาหกรรมไม่ได้ถูกจำกัดอยู่แค่ "ติดโซล่าร์บนหลังคาเอง" อีกต่อไป แต่สามารถซื้อไฟฟ้าสะอาดจากโครงการหมุนเวียนภายนอกผ่านสองช่องทางหลัก คือ Utility Green Tariff (UGT) และ Third-Party Access (TPA) ที่อาศัยโครงข่ายส่งของผู้ให้บริการไฟฟ้าในการขนส่ง คำถามที่วิศวกรและผู้บริหารโรงงานต้องตอบให้ได้ไม่ใช่ "จะเข้าร่วมหรือไม่" แต่คือ "โรงงานของเราพร้อมแค่ไหน" — เพราะการเจรจา PPA ระยะยาว 10-20 ปี ต้องการข้อมูลโหลดที่แม่นยำ รูปแบบการใช้ไฟ (Load Profile) ที่พิสูจน์ได้ และระบบวัดมิเตอริ่งที่ผ่านมาตรฐาน ซึ่งทั้งหมดนี้คืองานของ IIoT ที่ควรเริ่มวางตั้งแต่วันนี้ โซล่าร์หลังคาโรงงานคือจุดเริ่มต้นของการเปลี่ยนผ่าน แต่เมื่อศักยภาพพื้นที่ถูกใช้หมด DPPA คือก้าวถัดไป (ภาพ: Wikimedia Commons) ทำไมโรงงานต้องสนใจ DPPA ตั้งแต่ตอนนี้ ข้อมูลจากวงกลมประชุมผู้มีส่วนได้ส่วนเสียภาคพลังงานสะอาดของไทย (พ.ค. 2569) ชี้ภาพที่ชัดเจน ยอดขอใช้อนุมัติโครงการดาต้าเซ็นเตอร์ในเขต EEC มีถึง 17 โครงการที่ยืนยันแล้ว และอีก 47 โครงการรอพิจารณา คิดเป็นความต้องการไฟฟ้ารวมกว่า 17,000 เมกะวัตต์ แม้ตัวเลขนี้จะต้องกรองความน่าเชื่อถือ แต่ก็ส่งสัญญาณว่า โควตา 2,000 เมกะวัตต์รอบแรกอาจถูกจองรวดเร็ว และโรงงานอุตสาหกรรมที่มีโหลดใหญ่ไม่ควรรอให้รอบสองมาถึงก่อนค่อยเตรียมตัว อีกแรงกดดันสำคัญคือ CBAM ของสหภาพยุโรปและข้อกำหนดห่วงโซ่อุปทานของลูกค้าพหุชาติ ผู้ซื้อต้องการให้ผู้ผลิตรายงานคาร์บอนสโคป 2 ที่มาจากไฟฟ้าที่ใช้จริง การอ้างว่า "ใช้ไฟจากกริดเหมือนกันทุกคน" จะไม่เพียงพออีกต่อไป สถานประกอบการที่มีพลังงานสะอาดที่ตรวจสอบย้อนกลับได้จะได้เปรียบในการเจรจาค้าส่ง 6 ขั้นตอนเตรียมโรงงานเข้าสู่ DPPA ขั้นที่ 1: สำรวจ Baseline การใช้ไฟฟ้า 12-24 เดือน เริ่มจากดึงข้อมูลมิเตอร์หลัก (Main Meter) ย้อนหลังอย่างน้อย 1 ปีเต็ม เพื่อจับฤดูกาลการผลิต วันหยุดพักเครื่อง และช่วง Peak ที่เกิดซ้ำ ถ้าโรงงานยังอ่านค่าได้เฉพาะจากใบแจ้งหนี้รายเดือน ให้ติดตั้ง Power Quality Meter ที่บันทึกค่าทุก 15 นาที หรือดีที่สุดคือทุก 1 นาที ตามแนวทาง Time-Synchronized Metering เพราะการเจรจา PPA ต้องการ Load Profile รายชั่วโมง ไม่ใช่ยอดรวมรายเดือน ขั้นที่ 2: แยกโหลดตามกระบวนการผลิตด้วย Submetering…
Read More
How-to ออกแบบตู้ควบคุมตาม IEC 61439: จาก Rated Diversity Factor ถึง Temperature Rise Verification ที่วิศวกรต้องรู้

How-to ออกแบบตู้ควบคุมตาม IEC 61439: จาก Rated Diversity Factor ถึง Temperature Rise Verification ที่วิศวกรต้องรู้

Article
ตู้ควบคุมไฟฟ้าแล้วเสร็จสวยงาม ส่งมอบงานได้ตรงกำหนด แต่หกเดือนถัดมาเทอร์มินัลจุดต่อหลวม คอนแทคเตอร์ร้อนผิดปกติ และเซ็นเซอร์แอนะล็อกอ่านค่ากระโดด ปัญหาแบบนี้แทบทั้งหมดไม่ได้เกิดจากอุปกรณ์เสีย แต่เกิดจากการออกแบบและประกอบตู้ที่ไม่ผ่านการตรวจสอบตามมาตรฐาน บทความนี้เป็นคู่มือฉบับวิศวกร สรุปขั้นตอนออกแบบและตรวจรับตู้ควบคุมแรงต่ำให้สอดคล้องกับมาตรฐานสากล IEC 61439 ทีละขั้น IEC 61439 คืออะไร และเปลี่ยนอะไรจาก IEC 60439 มาตรฐาน IEC 61439 แทนที่ IEC 60439 ที่ใช้มากว่าสามทศวรรษ โดยเปลี่ยนปรัชญาการรับรองจาก "การทดสอบตามตัวเลือก (type testing)" มาเป็นการพิสูจน์ด้วยการออกแบบและการตรวจสอบร่วมกัน (design and verification) แบ่งเป็น 2 วิธีคือการทดสอบ (testing) การเปรียบเทียบกับการออกแบบอ้างอิงที่ทดสอบแล้ว (comparison with a tested reference design) และการประเมินด้วยการวัดหรือคำนวณ (assessment by measurement or calculation) ผู้ประกอบตู้จึงเลือกวิธีที่คุ้มค่าที่สุดต่อโครงการได้ โดยไม่ต้องทดสอบทุกการจัดวางใหม่ โครงสร้างมาตรฐานแบ่งเป็น 2 ส่วนหลัก คือ IEC 61439-1 กฎทั่วไป และ IEC 61439-2 สำหรับตู้ควบคุมกำลัง (power switchgear and controlgear assemblies) ซึ่งเป็นส่วนที่โรงงานอุตสาหกรรมไทยพบมากที่สุด นอกจากนี้ยังมีส่วนขยายสำหรับตู้ที่คนที่ไม่ใช่ช่างเข้าถึงได้ (-3) และตู้สำหรับไซต์ก่อสร้าง (-5) อีกด้วย ตู้ Motor Control Center (MCC) ตู้หนึ่งในสายการผลิต การตรวจรับตาม IEC 61439 ช่วยยืนยันว่าอุณหภูมิภายใน ความแข็งแรงเชิงกล และระยะฉนวน อยู่ในเกณฑ์ที่ออกแบบไว้จริง (ภาพ: Wikimedia Commons) ขั้นตอนที่ 1: กำหนดด้วยลบและกระแสใช้งานจริง (Rating and Duty) จุดเริ่มต้นของการออกแบบที่ถูกต้องคือการกำหนดค่ากระแสใช้งานให้สอดคล้องกับโหลดจริง ไม่ใช่เลือกเทอร์มินัลใหญ่สุดแล้วคิดว่าปลอดภัย ค่าที่ต้องระบุให้ครบได้แก่: Rated current (InA): กระแสของแถววงจร (circuit) และของตู้ทั้งตู้ พร้อมข้อมูลว่ากำหนดที่กระแสกระจายหรือกระแสวงจรหลักRated diversity factor (RDF): ตัวคูณที่บอกว่าโหลดทั้งหมดจะพร้อมกันกี่เปอร์เซ็นต์จริง เช่น 0.7 หมายถึงออกแบบให้ทน 70% ของผลรวมกระแสพร้อมกัน ค่านี้ต้องระบุบน nameplate ของตู้Rated peak withstand current (Ipk): ค่ากระแสความเค้นสั้นที่ตู้ต้องทนได้ ปกติกำหนดเป็นสัดส่วนของกระแสลัดวงจร เช่น n = 10 หรือ 20…
Read More
Supply Chain Control Tower ยุค Agentic AI: จาก Dashboard เฝ้าดู สู่ศูนย์บัญชาการที่ตัดสินใจแทนคุณในไม่กี่นาที

Supply Chain Control Tower ยุค Agentic AI: จาก Dashboard เฝ้าดู สู่ศูนย์บัญชาการที่ตัดสินใจแทนคุณในไม่กี่นาที

Article
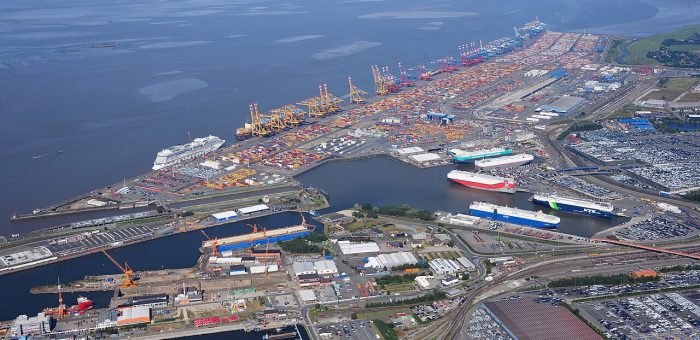
จาก Dashboard บอกเล่าเหตุการณ์ สู่ศูนย์บัญชาการที่ตัดสินใจเอง หลายโรงงานที่ลงทุน "Control Tower" ไปเมื่อ 3-4 ปีก่อน กำลังพบปัญหาเดียวกัน คือระบบสวยงาม ข้อมูลครบ แต่สุดท้ายคนยังต้องนั่งเฝ้าจอ ไล่ดูสถานะรถทุกคัน แล้วโทรไปถามทีมปฏิบัติการเองว่าจะทำอย่างไรต่อ Control Tower รุ่นแรกคือ ชั้นรวบรวมข้อมูล (Data Aggregation Layer) ที่ดึงข้อมูลจาก TMS (ระบบบริหารการขนส่ง) WMS (ระบบบริหารคลังสินค้า) และข้อมูลจากผู้ขนส่งภายนอก มาแสดงบนจอเดียวให้คนตัดสินใจเอง ปี 2026 หน้าที่ของมันกำลังเปลี่ยนไปสู่ AI Control Tower ที่ไม่ใช่แค่รายงานว่าเกิดอะไรขึ้น แต่ประเมินสถานการณ์หลายแบบพร้อมกัน คาดการณ์ผลกระทบ และเสนอหรือลงมือแก้ปัญหาเองภายในไม่กี่นาที แรงผลักดันหลักคือความผันผวนทางภูมิรัฐศาสตร์ การขาดแคลนแรงงาน และต้นทุนที่สูงขึ้น จนองค์กรไม่มีเวลาให้ทีมงานนั่งวิเคราะห์ทุกเหตุการณ์ทีละเคสอีกต่อไป ท่าเรือคอนเทนเนอร์คือจุดที่ความล่าช้าเล็กน้อยถูกขยายเป็นผลกระทบทั้งห่วงโซ่ — AI Control Tower ถูกออกแบบมาเพื่อตัดสินใจ ณ จุดพวกนี้ให้เร็วกว่ามนุษย์ (ภาพ: Wikimedia Commons) ตัวเลขที่อธิบายว่าทำไมทุกคนเร่งตัดสินใจในปี 2026 ข้อมูลจากรายงานอุตสาหกรรมหลายฉบับในปี 2026 ชี้ตรงกันว่า ความไม่แน่นอนทางเศรษฐกิจและภูมิรัฐศาสตร์ เป็นปัจจัยสำคัญที่สุดที่กดดันการตัดสินใจด้าน supply chain ในปีนี้ ขณะที่สัดส่วนองค์กรที่ใช้ AI ในกิจกรรม supply chain เพิ่มจากราว 30% เป็นราว 40% ภายในเวลาเพียงหนึ่งปี — นั่นแปลว่าเกือบครึ่งของคู่แข่งของคุณอาจกำลังให้ AI ช่วยวางแผนสินค้าคงคลังและจัดเส้นทางขนส่งอยู่แล้ว มิติ Control Tower แบบดั้งเดิม AI Control Tower บทบาทหลักรวมข้อมูล แสดงสถานะ (Monitoring)ตัดสินใจและลงมือแก้ปัญหา (Decision + Action) เมื่อรถส่งสินค้าล่าช้าแจ้งเตือนสีแดง รอคนโทรประสานงานระบุเส้นทางทางเลือก จัดสรรสต๊อกระหว่าง DC ใกล้เคียง และจัดลำดับออเดอร์ตาม SLA อัตโนมัติ การตอบสนองชั่วโมงถึงวัน (ผู้เชี่ยวชาญต้องวิเคราะห์)นาที (ระบบประเมินหลายสถานการณ์พร้อมกัน) ข้อมูลที่ใช้TMS + WMS + ผู้ขนส่งเพิ่ม IoT telemetry, สภาพอากาศ, ข่าวภูมิรัฐศาสตร์, ข้อจำกัดท่าเรือแบบ real-time Human-in-the-loopคนตัดสินใจทุกขั้นAI ตัดสินใจชั้นปฏิบัติการ คนกำกับดูแลและยับยั้งได้ คอนเทนเนอร์หลายหมื่นใบในท่าเรือใหญ่ แต่ละใบคือเหตุการณ์ที่ AI Control Tower ต้องติดตามพร้อมกัน — งานที่เกินพิกัดการไล่ด้วยสายตามนุษย์ (ภาพ: Wikimedia Commons) สถาปัตยกรรม 5…
Read More
บทวิเคราะห์ PEEK บนเครื่องพิมพ์ FFF: เมื่อโพลิเมอร์ทน 260°C ย้ายจากห้องแล็บสู่สายการผลิตจริง

บทวิเคราะห์ PEEK บนเครื่องพิมพ์ FFF: เมื่อโพลิเมอร์ทน 260°C ย้ายจากห้องแล็บสู่สายการผลิตจริง

Article
ในโลกของ Additive Manufacturing โพลิเมอร์ การพิมพ์ PLA และ ABS บนเครื่อง FFF สำนักงานเป็นเรื่องปกติมานาน แต่ปี 2025–2026 คือช่วงเวลาที่ PEEK (Polyether Ether Ketone) — โพลิเมอร์เกรดวิศวกรรมกึ่งผลึกที่ทนอุณหภูมิ 260°C ต่อเนื่อง — เริ่มย้ายจากห้องแล็บสู่โรงงานจริง บทวิเคราะห์นี้มองว่าเกิดอะไรขึ้นกับตลาด และโรงงานไทยควรวางตำแหน่งตัวเองอย่างไร PEEK แตกต่างจาก PLA/ABS อย่างไร PEEK เป็นพอลิเมอร์กึ่งผลึก (semi-crystalline) ในตระกูล polyaryletherketone (PAEK) จุดเด่นคือ อุณหภูมิใช้งานต่อเนื่องราว 260°C (สูงกว่า ULTEM และ PPSU), ทนสารเคมีเกือบทุกชนิดที่พบในโรงงาน, ค่าความต้านทานแรงดันไฟฟ้า (dielectric) ดี และมีความแข็งแรงต่อน้ำหนักใกล้เคียงโลหะบางชนิดในบางแอปพลิเคชัน งานวิจัยที่ตีพิมพ์ใน Polymer Testing ยืนยันว่าคุณสมบัติเชิงกลของชิ้นงาน PEEK ที่พิมพ์ด้วย FDM ขึ้นกับ อุณหภูมิหัวฉีด (nozzle temperature) และ building orientation อย่างมีนัยสำคัญ — พารามิเตอร์สองตัวนี้กำหนดระดับความผลึก (crystallinity) ที่ได้ ซึ่งส่งผลต่อความแข็งแรงและความทนความร้อนโดยตรง หลักการ FFF/FDM — เส้นใยหลอมเหลวถูกอัดผ่านหัวฉีด สำหรับ PEEK หัวฉีดต้องทนถึง 400–500°C และห้องพิมพ์ต้องร้อน (ภาพ: Wikimedia Commons, CC BY-SA 4.0) อะไรทำให้ PEEK AM มาถึงตอนนี้ สามแรงกดดันมาบรรจบกัน: (1) เครื่องพิมพ์ FFF ห้องร้อน (heated chamber) ระดับอุตสาหกรรมหาซื้อได้ง่ายขึ้นมาก (2) อุปสรรคด้านความต้องการช่างเทคนิคที่เข้าใจพารามิเตอร์ crystallinity ลดลง เพราะผู้ผลิตเครื่องมี material profile สำเร็จรูปมากขึ้น และ (3) อุตสาหกรรมเป้าหมาย — โดยเฉพาะ semiconductor และ medical — เร่งหาชิ้นส่วนที่ PLA/ABS ทำไม่ได้ เปรียบเทียบวัสดุโพลิเมอร์สำหรับงานอุตสาหกรรม คุณสมบัติ PLA ABS PEEK อุณหภูมิใช้งานต่อเนื่อง~50–60°C~80–90°C~260°C ทนสารเคมีต่ำปานกลางสูงมาก ความแข็งแรงเชิงกลปานกลาง (เปราะ)ปานกลางสูง — ใกล้เคียงโลหะบางชนิด ความยากการพิมพ์ง่ายที่สุดปานกลางยาก — ต้องการห้องร้อน +…
Read More