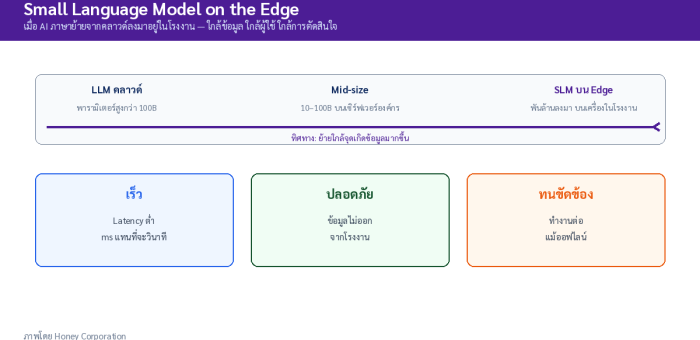
บทวิเคราะห์: Small Language Model บน Edge — เมื่อ AI ย้ายจากคลาวด์ลงมาอยู่ในโรงงานจริงๆ ในปี 2026

บทวิเคราะห์: Small Language Model บน Edge — เมื่อ AI ย้ายจากคลาวด์ลงมาอยู่ในโรงงานจริงๆ ในปี 2026

Article
จุดเปลี่ยนที่มาถึงเร็วกว่าที่ใครคาด ตลอดสองปีที่ผ่านมา คนวงการโรงงานพูดถึง Generative AI และ LLM กันเหมือนเป็นของไกลตัว — จริงๆ มันคือบริการคลาวด์ตัวใหญ่ที่โรงงานส่วนใหญ่ “ใช้ไม่ได้จริง” เพราะสามเหตุผลคลาสสิก: Latency สูงเกินไปสำหรับงานควบคุม, ข้อมูลไปอยู่นอกองค์กร และค่าใช้จ่ายต่อการเรียกใช้งานที่ทวีคูณตามปริมาณงาน แต่ปี 2026 ภาพเปลี่ยนไปแล้ว Small Language Model (SLM) ระดับ 1–3 พันล้านพารามิเตอร์กำลังกลายเป็นคำตอบที่จับต้องได้ของโรงงานอุตสาหกรรม สัญญาณที่ชัดที่สุดมาจากงานวิจัยสองชิ้นล่าสุดบน arXiv ที่ทดสอบ SLM ในสถานการณ์จริงของโรงงาน ไม่ใช่แค่ Benchmark ในห้องแล็บ โรงงานสายไฟฟ้าและอิเล็กทรอนิกส์คือกลุ่มแรกๆ ที่ได้ประโยชน์จาก SLM ระดับ Edge — ที่ซึ่ง Latency และความเป็นส่วนตัวของข้อมูลสำคัญที่สุด (ภาพ: Wikimedia Commons) หลักฐานที่ 1: SLM คุม Process Control ได้จริงใน Closed-Loop งานวิจัย “Closed-Loop Control with Rule-Aligned Small Language Models” (มิถุนายน 2026) ทดลองใช้ SLM ขนาดเพียง 1.5B พารามิเตอร์ ทำหน้าที่สร้างและปรับแต่ง Control Policy จาก Requirement แบบภาษาธรรมชาติ โดยไม่ต้องเขียนโค้ดควบคุมใหม่ทั้งหมด ระบบประกอบด้วยสามส่วน: Action Agent ที่สร้างคำสั่งควบคุม, ชั้นตรวจสอบความถูกต้องแบบ Symbolic/Digital-Twin ที่จำลองผลลัพธ์ก่อนสั่งจริง และ Reprompting Agent ที่คอยแก้คำสั่งที่ไม่ผ่านการตรวจสอบ ผลการทดลองในงานควบคุมอุณหภูมิ (30 การทดลอง ๆ ละ 500 ขั้น) ระบบทำได้ 91.5% Action Success Rate — ตัวเลขที่น่าประทับใจมากสำหรับโมเดลขนาดเท่านี้ที่รันอยู่บน Edge โดยไม่พึ่งคลาวด์ จุดสำคัญคือโมเดลถูกฝึกด้วยเทคนิค GRPO (Group Relative Policy Optimization) ให้ “เชื่อฟังกฎ” ก่อนที่จะได้รับอิสระในการตัดสินใจ หลักฐานที่ 2: Multimodal SLM ทำงาน Inspection Assistant ได้ใกล้เคียงโมเดลใหญ่ งานวิจัย RobustMAD (มิถุนายน 2026) สร้าง Benchmark แรกที่ออกแบบมาจากสถานการณ์ Deploy จริง…
Read More
บทวิเคราะห์ MRP vs PRP vs HSR: วิธีเลือก Network Redundancy ให้โรงงานให้คุ้มค่า ก่อนที่สายแลนจะขาดกลางดึก

บทวิเคราะห์ MRP vs PRP vs HSR: วิธีเลือก Network Redundancy ให้โรงงานให้คุ้มค่า ก่อนที่สายแลนจะขาดกลางดึก

Article
คำถามที่ควรถามก่อนเครือข่ายโรงงานล่ม ทุกครั้งที่เราเข้าไปประเมินระบบเครือข่ายในโรงงานอุตสาหกรรม คำถามแรกที่เราถามเสมอคือ "ถ้าสาย LAN เส้นนี้ขาดตอนกลางดึก ระบบจะกลับมาใช้ได้ในกี่วินาที และใครจะเป็นคนรู้ก่อน" คำตอบที่ได้กลับมามักเป็นเงียบ หรือไม่ก็ "คงต้องรอช่างมาดูตอนเช้า" ซึ่งแปลว่าโรงงานนั้นยังพึ่ง Spanning Tree Protocol แบบดั้งเดิม ที่ใช้เวลากู้คืนเป็นสิบวินาทีถึงหลักนาที — นานเกินกว่าที่สายการผลิตที่วิ่ง 24 ชั่วโมงจะยอมรับได้ ในโลกของ OT ที่ downtime ของเครือข่ายเท่ากับ downtime ของการผลิต วงการอุตสาหกรรมจึงพัฒนามาตรฐานความซ้ำซ้อนของเครือข่ายขึ้นมาเป็นชุด ภายใต้ IEC 62439 ซึ่งครอบคลุมทั้ง MRP (ส่วนที่ 2), PRP และ HSR (ส่วนที่ 3) บทความนี้วิเคราะห์ว่าแต่ละตัวเหมาะกับโรงงานแบบไหน และจุดไหนที่คุ้มค่าที่จะลงทุน โทโพโลยีวงแหวน (Ring) — รากฐานของ MRP ที่เปลี่ยนเส้นทางสำรองให้พร้อมใช้เสมอ (ที่มา: Wikimedia Commons) ทำไม RSTP ไม่พอแล้วสำหรับสายการผลิต Rapid Spanning Tree Protocol (RSTP) เป็นมาตรฐานเปิดที่หาได้ในสวิตช์แทบทุกตัว แต่เวลากู้คืนของมันอยู่ในระดับ หลักวินาทีถึงหลักสิบวินาที ซึ่งสำหรับเครือข่ายสำนักงานถือว่ารับได้ แต่สำหรับสายการผลิตที่ Controller ต้องคุยกับ Drive ทุก 10–100 มิลลิวินาที ช่วงเวลาขนาดนั้นเท่ากับคำสั่งควบคุมหายไปหลายรอบ สินค้าเสียหาย และอาจถึงขั้นต้องหยุดเครื่อง มาตรฐาน IEC 62439 ถูกออกแบบมาเพื่อลดเวลานี้ให้เหลือระดับที่สายการผลิตอยู่รอดได้: MRP การันตี recovery ในระดับ 10–200 มิลลิวินาที (ขึ้นกับขนาดวงแหวนและคลาสอุปกรณ์) ส่วน PRP และ HSR ให้ "zero recovery time" เพราะเฟรมถูกส่งซ้ำสองทางพร้อมกันตั้งแต่ต้น ไม่มีช่วงเปลี่ยนผ่านให้ข้อมูลหายเลย แคร็กสวิตช์ในโรงงาน — ทุกพอร์ตและทุกเส้นสายคือจุดล้มเหลวที่ต้องออกแบบรองรับล่วงหน้า (ที่มา: Wikimedia Commons) ตารางวิเคราะห์: MRP vs PRP vs HSR เลือกอย่างไรให้คุ้ม ประเด็น MRP (IEC 62439-2) PRP (IEC 62439-3) HSR (IEC 62439-3) โทโพโลยี วงแหวนเดียว สองเครือข่ายขนานแยกกัน วงแหวนเดี่ยว เฟรมวิ่งสองทิศ เวลากู้คืน 10–200 ms (ตามคลาส) 0 ms (seamless)…
Read More
Modbus จาก RTU สู่ TCP: คู่มือ How-to ปลดล็อกข้อมูลอุปกรณ์อุตสาหกรรมจากสายอนุกรมสู่ระบบ IIoT

Modbus จาก RTU สู่ TCP: คู่มือ How-to ปลดล็อกข้อมูลอุปกรณ์อุตสาหกรรมจากสายอนุกรมสู่ระบบ IIoT

Article
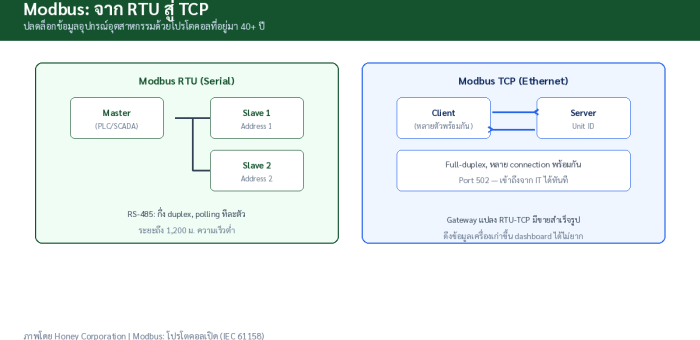
บทนำ: โปรโตคอลอายุ 47 ปีที่ยังไม่ยอมตาย ปี 1979 บริษัท Modicon พัฒนาโปรโตคอลสื่อสารสำหรับ PLC ของตัวเอง ไม่มีใครคิดว่ามันจะกลายเป็นมาตรฐานโลก แต่วันนี้ Modbus กลายเป็นโปรโตคอลที่ฝังตัวอยู่ในอุปกรณ์อุตสาหกรรมมากที่สุดตัวหนึ่งของโลก ทั้งมิเตอร์ไฟฟ้า อินเวอร์เตอร์ ตู้แช่ เครื่องชั่งน้ำหนัก และเซ็นเซอร์ประเภทต่างๆ ปัจจุบันดูแลโดย Modbus Organization โดยเวอร์ชันล่าสุดของข้อกำหนดแอปพลิเคชันคือ V1.1b3 (เม.ย. 2012) เหตุผลที่มันอยู่ได้ทนเพราะความเรียบง่าย: โครงสร้างข้อความมีแค่ Address + Function Code + Data + CRC ไม่มีความซับซ้อนของโปรโตคอลยุคใหม่ อุปกรณ์ราคาประหยัดทำได้ง่าย วิศวกรเข้าใจได้เร็ว และที่สำคัญ เปิดใช้ฟรี ไม่มีลิขสิทธิ์ จึงกลายเป็นภาษากลางที่ทุกแบรนด์ต้องพูดให้ได้ โครงสร้างการเชื่อมต่อ RS-485 ระหว่างอุปกรณ์ 2 ตัว — ฐานล่างของ Modbus RTU ยุคแรกๆ (ที่มา: Wikimedia Commons) ปัญหาจริงในโรงงาน: เกาะข้อมูลบนสายอนุกรม สถานการณ์คลาสสิกที่ทีมงาน Honey Corporation เจอบ่อยในโรงงานไทย: ลูกค้ามี อุปกรณ์ Modbus RTU บน RS-485 เป็นสิบตัว กระจายอยู่ทั่วโรงงาน แต่ละตัวอ่านค่าได้เฉพาะเวลาช่างเอาโน้ตบุ๊กไปเสียบหน้างาน หรือไม่ก็ต้องมี HMI ประจำจุดที่คอย poll ข้อมูลแบบจุดต่อจุด อยากดูยอดรวมแบบเรียลไทม์บนมือถือ ทำไม่ได้เพราะข้อมูลถูกขังอยู่ใน “เกาะ” ของสายอนุกรมแต่ละเส้น ทางออกที่ถูกที่สุดและได้ผลที่สุดในทางปฏิบัติคือ ย้าย Modbus ขึ้นไปวิ่งบนเครือข่าย TCP/IP แล้วรวมศูนย์การเข้าถึงผ่าน Gateway ตัวเดียว ซึ่งเป็นงานที่ทีมงานของเราทำเป็นประจำ ทั้งในงานเก็บข้อมูลตู้แช่อุตสาหกรรมและงานผูกมิเตอร์พลังงานเข้าระบบ Monitoring ของโรงงาน แผงควบคุม PLC — จุดรวมสัญญาณที่ Modbus ยังคงเป็นภาษากลางในการสื่อสารกับอุปกรณ์ฟิลด์ (ที่มา: Wikimedia Commons) เข้าใจโครงสร้างก่อนแปลงร่าง: RTU vs ASCII vs TCP ประเด็น Modbus RTU Modbus ASCII Modbus TCP ตัวกลาง RS-485 / RS-232 RS-485 / RS-232 Ethernet / TCP-IP รูปแบบข้อมูล Binary + CRC-16 ASCII…
Read More
Single Pair Ethernet (10BASE-T1L): เทคโนโลยีสาย 2 เส้นที่ส่ง Ethernet ไกล 1 กิโลเมตร ถึงเซ็นเซอร์ระดับฟิลด์

Single Pair Ethernet (10BASE-T1L): เทคโนโลยีสาย 2 เส้นที่ส่ง Ethernet ไกล 1 กิโลเมตร ถึงเซ็นเซอร์ระดับฟิลด์

Article
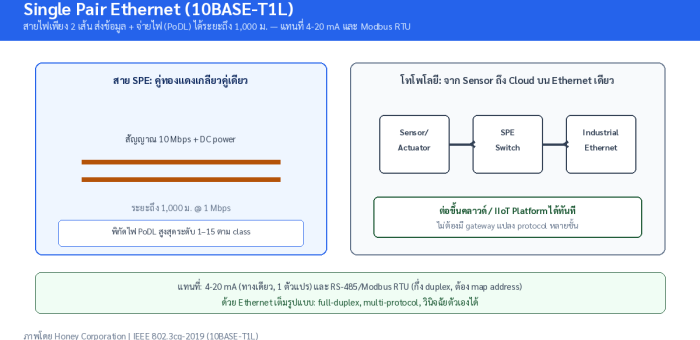
ทำไมสาย 2 เส้นกำลังเปลี่ยนโฉมหน้าการเดินสายในโรงงาน ตลอดสิบกว่าปีที่ผ่านมา วิศวกรอุตสาหกรรมต้องออกแบบเครือข่ายโรงงานโดยยอมรับข้อจำกัดข้อหนึ่งเสมอมา นั่นคือ Ethernet แบบดั้งเดิมวิ่งได้แค่ 100 เมตร พอเกินระยะนั้นต้องพึ่งสายไฟเบอร์ พร้อมสวิตช์ขยายสัญญาณ หรือไม่ก็ยอมใช้ระบบ analog 4–20 mA ที่ส่งได้ทีละค่า เก็บข้อมูลการวินิจฉัยไม่ได้เลย Single Pair Ethernet (SPE) คือคำตอบที่ IEEE ตอบโจทย์นี้ด้วยมาตรฐาน IEEE 802.3cg-2019 ซึ่งกำหนด Ethernet ความเร็ว 10 Mbps บนสาย twisted pair เพียง คู่เดียว (2 เส้น) โดยตัวที่โรงงานอุตสาหกรรมสนใจมากที่สุดคือ 10BASE-T1L ที่รองรับระยะส่งสูงสุดถึง 1,000 เมตร — ยาวกว่า Ethernet ปกติถึง 10 เท่า และยังส่งไฟเลี้ยงผ่านสายเดียวกันได้ด้วยเทคโนโลยี PoDL (Power over Data Lines) ที่จ่ายไฟให้อุปกรณ์ปลายทางได้สูงสุดราว 50 วัตต์ Media Converter สำหรับ SPE รุ่น 10BASE-T1S — อุปกรณ์แปลงสัญญาณ Ethernet คู่เดียวให้เชื่อมกับคอมพิวเตอร์ผ่าน USB (ที่มา: Wikimedia Commons) จุดเปลี่ยนสำคัญ: จาก Fieldbus Island สู่เครือข่ายเดียวจากเซ็นเซอร์ถึงคลาวด์ ปัญหาใหญ่ที่สุดของโรงงานไทยหลายแห่งไม่ใช่การขาดเซ็นเซอร์ แต่คือ เซ็นเซอร์ที่มีอยู่พูดภาษาต่างกันหมด ยกตัวอย่างโรงงานอาหารทั่วไป: มิเตอร์วัดการไหลใช้ระบบ 4–20 mA, เซ็นเซอร์วัดอุณหภูมิตู้แช่ใช้ RS-485, สายพานผลิตวิ่งบน Industrial Ethernet แล้วพอจะเก็บข้อมูลขึ้นคลาวด์ ต้องผ่าน Protocol Gateway หลายชั้น ข้อมูลหายและหน่วงตามทาง SPE ตัดปัญหานี้ด้วยการทำให้ เซ็นเซอร์ระดับฟิลด์เข้าสู่โลก Ethernet ได้โดยตรง เพราะสายคู่เดียวราคาถูกกว่าสาย 4 คู่แบบ Cat 5e/6 ทั้งยังเบากว่า เดินผ่านท่อร้อยสายเดิมที่มีขนาดเล็กได้ ทีมงาน Honey Corporation มีประสบการณ์ติดตั้งระบบเก็บข้อมูล IoT ในโรงงานอุตสาหกรรมที่เจอข้อจำกัดแบบเดียวกันนี้ เช่น งานติดตั้งระบบ Monitoring ตู้แช่แข็งที่ต้องดึงสัญญาณจากจุดที่อยู่ไกลจากตู้คอนโทรลกลาง การวางแผนชนิดสายและระยะทางตั้งแต่ต้นจึงเป็นงานที่เราให้ความสำคัญเป็นพิเศษ โครงสร้างสาย Twisted Pair แบบ F-UTP — SPE ใช้เพียงคู่สายเดียวในลักษณะนี้ ลดปริมาณทองแดงและน้ำหนักสายได้มาก (ที่มา: Wikimedia…
Read More
บทวิเคราะห์: Data Contract — สัญญาที่โรงงานยุค AI ต้องมี ก่อนที่ dashboard จะเบรกอีกครั้ง

บทวิเคราะห์: Data Contract — สัญญาที่โรงงานยุค AI ต้องมี ก่อนที่ dashboard จะเบรกอีกครั้ง

Article
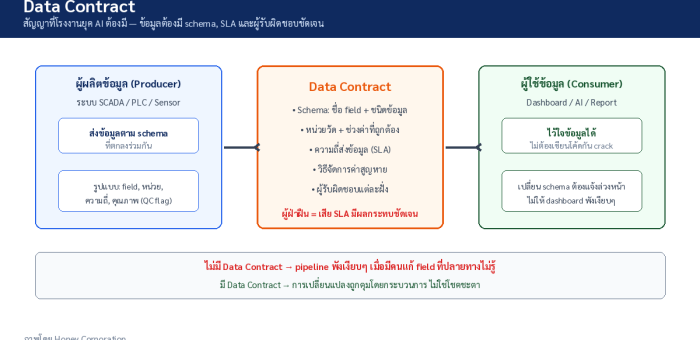
คำถามที่เราได้ยินบ่อยขึ้นเรื่อยๆ ในวงการโรงงานไทย ช่วงสองสามปีที่ผ่านมา ทีมงาน Honey Corporation ถูกถามคำถามแบบเดิมซ้ำๆ จากผู้บริหารโรงงานหลายแห่ง: “เราลงทุนเก็บข้อมูลจากเครื่องจักรมาทั้งที ทำไม dashboard ยังเบรก รายงานยังเพี้ยน และทีม AI ยังบ่นว่าข้อมูลใช้ไม่ได้?” คำตอบที่เราพบบ่อยที่สุดไม่ได้อยู่ที่เครื่องมือ แต่อยู่ที่ข้อเท็จจริงที่หลายองค์กรยังมองข้าม — โรงงานส่วนใหญ่ยังไม่มี “สัญญา” ว่าข้อมูลที่ส่งให้กันจะหน้าตาเป็นอย่างไร โรงงานยุคใหม่มีผู้ผลิตและผู้บริโภคข้อมูลมากขึ้นเรื่อยๆ — ปัญหาย้ายไปอยู่ที่ “คุณภาพการส่งมอบ” ไม่ใช่ปริมาณข้อมูล (ภาพ: Wikimedia Commons) Data Contract คืออะไร และทำไมกระแสมันมาเร็วในตอนนี้ Data Contract คือข้อตกลงที่เป็นทางการระหว่าง ผู้ผลิตข้อมูล (data producer — เช่น ทีมที่ดูแล IIoT gateway, ระบบ SCADA หรือ MES) กับ ผู้บริโภคข้อมูล (data consumer — เช่น ทีม dashboard, ทีม AI/ML, ฝ่ายบัญชี) ที่ระบุร่วมกันว่า คุณภาพ โครงสร้าง ความหมาย และความพร้อมใช้ของข้อมูลจะเป็นแบบไหน ต่างจากสัญญาธุรกิจทั่วไปตรงที่มัน เขียนด้วยโค้ด (YAML/JSON) จึงบังคับใช้ด้วยระบบอัตโนมัติได้จริง ไม่ต้องพึ่งความทรงจำของคน แนวคิดนี้ถูกเปรียบโดยนักวิเคราะห์หลายท่านว่ามีผลต่อวงการข้อมูล เทียบเท่ากับสิ่งที่ API ทำให้วงการพัฒนาซอฟต์แวร์ — API นิยามกติกาการสื่อสารระหว่างโปรแกรม ส่วน data contract นิยามกติกาการส่งมอบข้อมูลระหว่างทีม และเหมือนกันตรงที่พอมีตั้งแต่วันแรก ทุกอย่างที่หลังจากนี้จะเกิดขึ้นจะเร็วขึ้นทั้งระบบ ทำไมกระแสนี้มา “ตอนนี้” พอดี? คำตอบสั้นๆ คือ ผู้บริโภคข้อมูลในโรงงานเพิ่มขึ้นแบบทวีคูณ — จากเดิมที่มีแค่ SCADA กับ Historian ตอนนี้มี OEE dashboard, ระบบพยากรณ์การซ่อมบำรุง, โมเดล AI ตรวจคุณภาพ, ระบบรายงาน ESG และ application ใหม่ๆ ที่ไปขอข้อมูลจากทีม OT อยู่ตลอดเวลา ข้อมูลชุดเดิมถูก consume หลายทาง แต่ไม่มีใครรับประกันความเสถียรของมัน “คุณได้ข้อมูลที่ดีกว่าเข้าสู่ระบบ คุณจะได้ garbage in, garbage out ที่ดีกว่าเดิม” — Jean-Georges Perrin นักวิเคราะห์สถาปัตยกรรมข้อมูล อธิบายว่าทำไม data contract จึงเป็นเรื่องพื้นฐานของงาน AI ยุคใหม่…
Read More
Case Study: Event Streaming Backbone — เมื่อข้อมูลโรงงานอาหาร 3 ไซต์ ไหลเร็วกว่าสินค้าขึ้นหน้าร้าน

Case Study: Event Streaming Backbone — เมื่อข้อมูลโรงงานอาหาร 3 ไซต์ ไหลเร็วกว่าสินค้าขึ้นหน้าร้าน

Article
โจทย์: โรงงานอาหาร 3 ไซต์ ที่ข้อมูลเดินทางช้ากว่าสินค้า ลองนึกภาพโรงงานอาหารกลางในภาคตะวันออก ผลิตของว่างบรรจุถุงส่งให้ร้านค้าปลีกทั่วประเทศ มี 3 ไซต์ผลิต แต่ละไซต์มีสายการผลิต 4–6 ไลน์ ปัญหาที่ฝ่ายผู้อำนวยการเล่าให้ฟังตอนเริ่มโครงการคือ — "ตอนสินค้าถึงมือหน้าร้าน ข้อมูลการผลิตยังไปไม่ถึงโต๊ะผม" รายงาน OEE รายไลน์ต้องรอรวบรวมถึงเช้าวันถัดไป ส่วนข้อมูล lot ที่ถูกเรียกคืน (recall) ต้องใช้เวลานานหลายชั่วโมงในการไล่หาว่าวัตถุดิบก้อนไหนเข้าสายการผลิตไหน สายการผลิตอาหารบรรจุพร้อมส่ง — สินค้าออกจากไลน์เร็วกว่าข้อมูลขึ้นรายงานหลายชั่วโมง (ภาพ: Wikimedia Commons) เมื่อไล่ปัญหาลึกลงไป เจอรากที่แท้จริง 3 ข้อ: Point-to-Point เต็มระบบ — MES ดึงข้อมูลจาก SCADA ทุกไลน์ด้วย interface เฉพาะ 6 ชุด, ระบบคลังดึงจาก MES อีกชุด, ฝ่ายพลังงานต่อมิเตอร์แบบแยกเดียว รวมแล้ว interface ที่ต้องดูแลเกือบ 20 จุด แก้ทีไรกระทบลูกโซ่ทุกครั้ง รูปแบบข้อมูลไม่เหมือนกัน — แต่ละไซต์ตั้งชื่อ tag ตามใจ integrator ที่ติดตั้งปีไหนปีนั้น คำว่า "อุณหภูมิห้องเย็น" มีถึง 4 ชื่อต่างกันข้ามไซต์ ข้อมูลถึงสาย แต่ไม่มีใครกล้าใช้ — เพราะไม่มีใครรับประกันว่าค่าที่เห็นบน dashboard เป็นค่าปัจจุบันหรือค่าค้างจากอุปกรณ์ที่หลุดไปแล้ว ทางออก: วาง Event Streaming Backbone พร้อม Event Carried State Transfer ทีม integrator เสนอแนวทางที่ไม่ใช่การซื้อ "อีกระบบนึงมาต่อพ่วง" แต่เป็นการวาง แกนกลางกระจายเหตุการณ์ (Event Streaming Backbone) ให้ทั้ง 3 ไซต์ โดยออกแบบตามแนวคิด Event Carried State Transfer — ทุกเหตุการณ์สำคัญบนสายการผลิต (เปลี่ยนรุ่นผลิต, หยุดไลน์, ผลิตครบ lot, อ่านค่า QC ผ่าน/ไม่ผ่าน) จะถูกแปลงเป็น "เหตุการณ์" ที่พกสถานะล่าสุดของตัวเองมาด้วยเสมอ เหตุการณ์ (Event) คือบันทึกที่เปลี่ยนแปลงไม่ได้ (immutable record) ว่า "เกิดอะไรขึ้น" ประกอบด้วย key ที่ระบุตัวตน, value ที่เก็บข้อมูลจริง, และ timestamp บอกเวลาที่เกิดเหตุการณ์ — นิยามตามเอกสารของ…
Read More
Unified Namespace (UNS): สถาปัตยกรรมข้อมูลกลางยุคใหม่ ที่จบปัญหา Point-to-Point ในโรงงาน IIoT

Unified Namespace (UNS): สถาปัตยกรรมข้อมูลกลางยุคใหม่ ที่จบปัญหา Point-to-Point ในโรงงาน IIoT

Article
ทำไมโรงงานยุค IIoT จึงเจอปัญหา "สปาเกตตี้อินทิเกรชัน" กันทุกแห่ง ถ้าคุณเคยเปิด Excel ที่เก็บรายการ interface ระหว่างระบบในโรงงาน แล้วพบว่ามีเส้นเชื่อมระหว่าง SCADA, MES, ERP, ระบบเก็บพลังงาน และ Dashboard แทบทุกคู่เป็นร้อยเส้น คุณกำลังเจอปัญหาที่วงการอุตสาหกรรมเรียกขึ้นชื่อว่า Point-to-Point Integration Hell ยิ่งจำนวนระบบ (N) เพิ่มขึ้น จำนวนการเชื่อมต่อที่ต้องดูแลจะโตตามสูตร N×(N−1)/2 — มีระบบ 10 ตัวก็คือ 45 การเชื่อมต่อ ทุกจุดต้องเขียนโค้ด mapping แยก ทดสอบแยก และพังคนละจุดกันเงียบๆ ปัญหานี้เป็นผลพลอยได้ของสถาปัตยกรรมแบบชั้นตามแนวคิด ISA-95 / Purdue Model ที่ใช้กันมาหลายสิบปี แบบจำลองนี้ดีมากในเชิง ความปลอดภัยและการแบ่งลำดับชั้นความรับผิดชอบ แต่เมื่อมาถึงยุคที่ธุรกิจต้องการข้อมูลแบบเรียลไทม์ข้ามระบบ มันกลับกลายเป็นกำแพงที่ทำให้ทุก integration ต้องผ่าน "บันได" ทีละขั้น ช้าและเปราะบาง "Unified Namespace คือ single source of truth แบบเรียลไทม์ จัดเรียงตามโครงสร้างธุรกิจ และออกแบบให้เปิดกว้าง ไม่ผูกติดกับผลิตภัณฑ์ใด" — นิยามของ Walker Reynolds ผู้บุกเบิกแนวคิด UNS Unified Namespace (UNS) เสนอทางออกที่ตรงจุด: เปลี่ยนโครงสร้างการเชื่อมต่อจาก point-to-point ที่ต่อกันไปมาเป็น Hub-and-Spoke โดยมี MQTT Broker เป็นศูนย์กลางเดียวที่ทุกระบบมา publish และ subscribe ข้อมูล แทนที่จะต้องเขียน integration เฉพาะทุกคู่ระบบ โรงงานอัตโนมัติยุคใหม่มีระบบผู้ผลิตข้อมูลหลายสิบชุดพร้อมกัน — UNS คือชั้นข้อมูลกลางที่รวมทุกอย่างไว้ที่เดียว (ภาพ: Wikimedia Commons) หัวใจของ UNS: MQTT + โครงสร้าง Topic ตาม ISA-95 UNS ไม่ใช่ซอฟต์แวร์ที่ซื้อมาติดตั้งแล้วจบ แต่เป็น สถาปัตยกรรมการจัดระเบียบข้อมูลที่ประกอบด้วย 3 ส่วนหลัก: MQTT Broker เป็นแกนกลางการส่งข้อมูลแบบ publish/subscribe, โครงสร้าง topic ที่จัดเรียงตามลำดับชั้นธุรกิจ และ payload ที่มีโครงสร้างและความหมายชัดเจน (เช่น JSON ที่ผ่านการ data modeling มาแล้ว) กลไก publish/subscribe ผ่าน MQTT…
Read More
บทวิเคราะห์: Reverse Logistics ยุค IIoT — เมื่อกระแสสินค้าไหลกลับกลายเป็น ‘เหมืองทองข้อมูล’ ที่โรงงานไทยมองข้าม

บทวิเคราะห์: Reverse Logistics ยุค IIoT — เมื่อกระแสสินค้าไหลกลับกลายเป็น ‘เหมืองทองข้อมูล’ ที่โรงงานไทยมองข้าม

Article
กระแสที่ไหลสวนทาง — และถูกมองข้ามมานานเกินไป ทุกครั้งที่พูดถึง supply chain ของโรงงาน ภาพที่เราถูกฝึกให้เห็นคือลูกศรเดียว: วัตถุดิบเข้า → ผลิต → ส่งออก แต่ความจริงของปี 2026 คือ กระแสที่สองที่ไหลย้อนกลับ — สินค้าส่งกลับ บรรจุภัณฑ์ใช้ซ้ำ ชิ้นส่วนเพื่อ remanufacture และเศษวัสดุเพื่อรีไซเคิล — กำลังโตเร็วกว่าที่องค์กรส่วนใหญ่เตรียมรับไว้ โดยเฉพาะอย่างยิ่งเมื่อ e-commerce ทำให้การคืนสินค้าเป็นเรื่องปกติ และ COD (เก็บเงินปลายทาง) ในตลาดหลายประเทศสร้างปริมาณ "สินค้าถูกปฏิเสธ ณ ประตูบ้าน" ที่ต้องไหลกลับเข้าระบบเช่นกัน Reverse logistics ตามนิยามครอบคลุมทุกกิจกรรมที่เกี่ยวกับการไหลกลับของสินค้าและวัสดุเพื่อการเก็บคุณค่าหรือกำจัดอย่างเหมาะสม — ไม่ใช่แค่ "คลังสินค้าคืน" แต่รวมถึงการหลีกเลี่ยงการคืน (returns avoidance) การคัดกรองที่จุดรับ (gatekeeping) การ remanufacture และการ dispose ที่ถูกต้อง งานวิจัยเชิงวิชาการชี้ตรงกันว่า reverse logistics เชื่อมโยงกับ Service Lifecycle Management (SLM) และกลายเป็นเวทีแข่งขันด้านความพึงพอใจของลูกค้าโดยตรง สนามจริงของ reverse logistics: การคัดแยกวัสดุที่ไหลกลับมา — งานที่ยังอยู่ในมือคนเกือบทั้งหมด และคือจุดที่ข้อมูลหายไปมากที่สุด (ภาพ: Wikimedia Commons) มุมมองของเรา: ปัญหาไม่ใช่ "ของไหลกลับ" แต่คือ "ข้อมูลหายไปตอนไหลกลับ" จากประสบการณ์ของทีม Honey Corporation ในการติดตั้งระบบ IoT Monitoring และ system integration ในโรงงานอุตสาหกรรม เราสังเกตรูปแบบเดียวกันซ้ำๆ: ข้อมูลของกระแสไหลออก (forward) ถูกดูแลอย่างดี — มี WMS, มี TMS, มี tracking — แต่ทันทีที่สินค้าคืนหรือบรรจุภัณฑ์ไหลกลับ ข้อมูลจะกลายเป็น "โซนรก" ที่พึ่งพาการจดบันทึกด้วยมือและความจำของพนักงานคลัง ผลลัพธ์คือสามช่องโหว่ที่โรงงานจ่ายแพงโดยไม่รู้ตัว: มูลค่าคงค้างที่มองไม่เห็น — พาเลท กล่อง และตัวถังที่ใช้ซ้ำได้ (เช่น ถังแก๊ส ถังเบียร์) หายไปเงียบๆ เพราะไม่มีระบบติดตามสถานะการยืม-คืน โอกาส remanufacture ที่ถูกทิ้ง — ชิ้นส่วนที่คืนมาถูกจัดเป็น "เศษ" ทั้งที่สภาพยังใช้งานได้ เพราะไม่มีข้อมูลสภาพและประวัติของชิ้นนั้น ความเสี่ยงประเทศนำเข้าขยะ — กฎระเบียบด้านสิ่งแวดล้อมของปลายทางเข้มขึ้นทุกปี การพิสูจน์แหล่งที่มาและเส้นทางของวัสดุที่ไหลกลับจึงกลายเป็นข้อกำหนด ไม่ใช่ทางเลือก บทวิเคราะห์: ถ้าเทคโนโลยี IIoT ถูกนำมาใช้กับกระแสย้อนกลับจะเกิดอะไรขึ้น…
Read More
Case Study: จากสายพานพลาสติกที่พังกลางดึก สู่ Blockchain Traceability ที่ช่วยเรียกคืนสินค้าเฉพาะจุดใน 2 ชั่วโมง

Case Study: จากสายพานพลาสติกที่พังกลางดึก สู่ Blockchain Traceability ที่ช่วยเรียกคืนสินค้าเฉพาะจุดใน 2 ชั่วโมง

Article
03:40 น. — สายพานลำเลียงหยุด และคำถามที่ตอบไม่ได้ กรณีศึกษาสังเคราะห์นี้ยึดตามรูปแบบปัญหาที่พบซ้ำๆ ในโรงงานอาหารแปรรูปขนาดกลางแห่งหนึ่งในภาคตะวันออก ซึ่งส่งออกผลิตภัณฑ์แช่แข็งให้แบรนด์ใหญ่ในต่างประเทศ คืนวันนั้นสายพานพลาสติก (modular belt) ของตู้แช่แข็ง IQF ราวกลางสายการผลิตหักพับลงกลางดึก เจ้าหน้าที่เปลี่ยนสายพานใหม่และเดินสายการผลิตต่อภายใน 40 นาที ปัญหาไม่ได้อยู่ที่เวลาหยุด — แต่อยู่ที่ว่าเช้าวันรุ่งขึ้น ทีม quality ตอบคำถามแบรนด์เจ้าของไม่ได้ว่า "ช่วง 40 นาทีที่สายพานเก่าแตะสินค้าก่อนหัก มีผลิตภัณฑ์กี่กล่อง และกล่องไหนบ้างที่ต้องกักตัวเพื่อตรวจโลหะหรือเศษพลาสติก" ในระบบกระดาษและ spreadsheet ยุคเก่า คำตอบคือ "ต้องเรียกคืนทั้งล็อตการผลิต 8 ชั่วโมง" — กว่า 12,000 กล่อง เพราะไม่มีทางพิสูจน์ได้ว่ากล่องไหนปลอดภัย นี่คือจุดที่ทุกโรงงานเริ่มตระหนักว่าปัญหา traceability ไม่ใช่เรื่อง "ระบบ IT สวยงาม" แต่คือเรื่องการเงินและชื่อเสียงโดยตรง ปัญหาราก: ข้อมูลอยู่คนละที่ ในคนละภาษา เมื่อทีมงานเข้าไปประเมิน พบภาพเดิมที่คุ้นเคยในโรงงานไทยจำนวนมาก: เครื่องสแกนบาร์โค้ด 14 จุด ส่งข้อมูลเข้าไฟล์ CSV แยกตามจุด ไม่มีการ standardize ข้อมูลการผลิตล็อต (batch record) อยู่ในระบบ MES เก่า ที่ต้อง export ผ่านหน้าจอ เนื่องจากไม่มี API สถานะอุณหภูมิตู้แช่อยู่ในที่เดียวกับข้อมูลพลังงาน ไม่เคยถูกผูกกับล็อตการผลิต ผู้ขนส่งเก็บ GPS และอุณหภูมิระหว่างขนส่งในระบบของตัวเอง เข้าถึงได้เฉพาะผ่านเว็บพอร์ทัล ความท้าทายคือทั้งหมดนี้ต้องกลายเป็น "เรื่องเล่าเดียว" ที่ย้อนได้ทั้งเส้นทาง — จากวัตถุดิบถึงหน้าร้าน — ภายในไม่กี่นาที ไม่ใช่ไม่กี่วัน ทางออก: EPCIS เป็นกระดูกสันหลัง + Blockchain เป็น notary ข้ามองค์กร สถาปัตยกรรมที่เลือกใช้แบ่งเป็น 3 ชั้นตามหน้าที่ ไม่ใช่ตามฮิต: โครงสร้าง Merkle Tree — กลไก cryptographic ที่ blockchain ใช้ตรวจสอบความถูกต้องของข้อมูลทั้งก้อนจาก hash รากเพียงค่าเดียว (ภาพ: Wikimedia Commons) ชั้นเก็บเหตุการณ์ (EPCIS layer) — ทุกจุดสแกนและเหตุการณ์สำคัญถูกแปลงเป็น EPCIS event มาตรฐาน GS1: Object Event เมื่อกล่องผ่านจุดสแกน, Aggregation Event เมื่อกล่องใส่พาเลท, Transformation Event เมื่อวัตถุดิบกลายเป็นล็อตผลิตภัณฑ์ และ…
Read More
EPCIS 2.0: มาตรฐาน GS1 สำหรับ Supply Chain Traceability ที่ทำให้ทุกชิ้นส่วนบอกได้ว่า ‘ตัวเองคือใคร อยู่ที่ไหน เมื่อไหร่ และทำไม’

EPCIS 2.0: มาตรฐาน GS1 สำหรับ Supply Chain Traceability ที่ทำให้ทุกชิ้นส่วนบอกได้ว่า ‘ตัวเองคือใคร อยู่ที่ไหน เมื่อไหร่ และทำไม’

Article
ทำไมโรงงานยุค IIoT จำเป็นต้องมี "ภาษากลาง" ของเหตุการณ์สินค้า ลองนึกภาพโรงงานที่ติดตั้งเซ็นเซอร์ IIoT ไปทั่วสายการผลิต ทุกจุดสแกนบาร์โค้ดส่งข้อมูลเข้าระบบ WMS ของตัวเอง หน่วยงาน QA ใช้ฐานข้อมูลแยกของตัวเอง และผู้ขนส่งเก็บ GPS log ในระบบ TMS อีกชุดหนึ่ง — เวลาลูกค้าโทรมาถามว่า "ล็อตที่ 825 ที่เราได้รับเมื่อวาน ผลิตจากวัตถุดิบล็อตไหน ผ่านคิวบัฟเฟอร์ที่สามหรือไม่" คำตอบที่ได้มักคือ "ขอเวลาตรวจสอบ 2-3 วัน" เพราะข้อมูลกระจัดกระจายอยู่ในระบบที่ไม่เคยคุยกัน นี่คือปัญหาที่มาตรฐาน EPCIS (Electronic Product Code Information Services) ของ GS1 ถูกออกแบบมาแก้โดยตรง โดยเวอร์ชันล่าสุด EPCIS 2.0 ได้รับการรับรองจาก GS1 เมื่อเดือนมิถุนายน 2022 (พร้อม Core Business Vocabulary หรือ CBV 2.0) และขณะนี้เวอร์ชัน 2.1 อยู่ระหว่างพัฒนา คาดว่าจะเผยแพร่ภายในสิ้นปี 2026 ซึ่งสะท้อนว่าโลก supply chain กำลังเคลื่อนจาก "ติดตามสินค้าในองค์กร" ไปสู่ "แลกเปลี่ยนเหตุการณ์ข้ามองค์กร" ด้วยโครงสร้างข้อมูลร่วมกันจริงๆ EPCIS คืออะไร — แกะกล่องมาตรฐานให้เห็นชิ้นส่วนจริง EPCIS เริ่มต้นจากความพยายามของ MIT Auto-ID Center ในปี 2001 ที่เสนอแนวคิด PML (Physical Markup Language) เพื่ออธิบายวัตถุทางกายภาพ ก่อนถูกพัฒนาต่อเป็นมาตรฐานสากลภายใต้ GS1 และตีพิมพ์เวอร์ชัน 1.0 ครั้งแรกในปี 2007 จุดร่วมสำคัญคือ EPCIS ไม่ได้ผูกกับ RFID อย่างที่หลายคนเข้าใจ — ตั้งแต่เวอร์ชัน 1.1 ไม่บังคับให้ระบุระดับ instance และใช้กับแอปพลิเคชันที่ใช้บาร์โค้ดล้วนหรือผสม RFID ได้ (ชื่อ EPC ที่ฝังอยู่เป็นเพียงมรดกทางประวัติศาสตร์) หัวใจของ EPCIS คือการแลกเปลี่ยน "visibility event data" — เหตุการณ์ที่บอกว่า อะไร (What), ที่ไหน (Where), เมื่อไหร่ (When) และ ทำไม (Why) ผ่านสถาปัตยกรรม 3 ส่วน: EPCIS Capture…
Read More