VR Offline Robot Programming: ก้าวต่อจาก Teach Pendant — สอนงานหุ่นยนต์ในโลกเสมือนก่อนส่งลงไลน์ผลิตจริง

VR Offline Robot Programming: ก้าวต่อจาก Teach Pendant — สอนงานหุ่นยนต์ในโลกเสมือนก่อนส่งลงไลน์ผลิตจริง

Article
โรงงานส่วนใหญ่ในประเทศไทยยังสอนงานหุ่นยนต์อุตสาหกรรมด้วยวิธีเดิมๆ นั่นคือให้ช่างยืนถือ Teach Pendant (จอยควบคุมรูปทรงจอยสติ๊ก) กดทีละแกน เดินหุ่นไปทีละจุด ทั้งที่ไลน์ผลิตต้องหยุดชะงักเพราะหุ่นยนต์กำลังถูก "สอน" อยู่ แถมยังมีความเสี่ยงชนเครื่องจักรหรือ Fixture รอบข้างเสมอ แนวทาง VR Offline Programming (OLP) กำลังเปลี่ยนภาพนี้ โดยให้วิศวกรสวม Headset VR เข้าไป "สอนงาน" หุ่นยนต์เสมือนในโลกดิจิทัลที่จำลอง Cell การผลิตจริงมาทุกมิติ ก่อนส่งโปรแกรมที่ผ่านการตรวจสอบแล้วลงสู่หุ่นยนต์ตัวจริง งานวิจัยล่าสุดที่ตีพิมพ์ใน The International Journal of Advanced Manufacturing Technology (Springer, 2025) ได้นำเสนอระบบ VR-based Offline Programming ที่ผสาน Motion Capture เข้ากับความเป็นจริงเสมือน โดยผู้วิจัยใช้กล้องจับการเคลื่อนไหวของมือและข้อมือผู้สอน แปลงเป็นเส้นทางเคลื่อนที่ (Trajectory) ของ End-effector โดยตรง แทนการกดปุ่มทีละแกนเหมือนเดิม ผลคือกระบวนการสร้างโปรแกรมหุ่นยนต์เร็วขึ้นอย่างมีนัยสำคัญ และลดภาระงานของช่างเฉพาะทางลงอย่างเห็นได้ชัด แผนภาพ: เวิร์กโฟลว์ VR Offline Programming ตั้งแต่สอนงานในโลกเสมือน จำลอง ไปจนถึง Deploy ลงหุ่นยนต์จริง (ภาพ: Honey Corporation) ทำไมการสอนหุ่นยนต์แบบเดิมถึงเป็นคอขวดของโรงงาน ปัญหาของ Teach Pendant ไม่ได้อยู่ที่ตัวเทคโนโลยี แต่อยู่ที่ "ต้นทุนแฝง" ที่โรงงานหลายแห่งมองข้าม: Downtime ของไลน์ผลิต — ทุกนาทีที่หุ่นยนต์ถูกสอนงานคือนาทีที่ไลน์ไม่ได้ผลิต งานศึกษาด้าน Robot Cell Integration หลายชิ้นชี้ว่าการสอนหุ่นยนต์ใหม่หนึ่งงาน (Task) ใช้เวลาหลายชั่วโมงถึงหลายวัน ขึ้นกับความซับซ้อนของ Path ความเสี่ยงต่อคนและเครื่องจักร — การ Jog หุ่นยนต์ใน Cell จริงมีโอกาสชน Fixture หรือส่วนประกอบรอบตัว ความเสียหายที่เกิดขึ้นมักแพงกว่าเวลาที่เสียไปหลายเท่า อินเทอร์เฟซที่ไม่เป็นธรรมชาติ — Teach Pendant บังคับให้ผู้ใช้คิดเป็นพิกัดตัวเลขและระนาบ 2 มิติ ทั้งที่งานจริงเป็นปัญหา 3 มิติเต็มตัว ต้องพึ่งช่างเฉพาะทาง — Process Engineer ที่เข้าใจงานมากที่สุดมักไม่ใช่คนเขียนโปรแกรมหุ่นยนต์ ทำให้ความรู้เชิงกระบวนการถูกแปลงหลายทอดกว่าจะกลายเป็นโปรแกรม ข้อสังเกตสำคัญจากงานวิจัย: ประสบการณ์ของผู้ใช้ (User Experience) ในการโปรแกรมหุ่นยนต์ ส่งผอบโดยตรงต่อคุณภาพของเส้นทางเคลื่อนที่ที่ได้ — VR ไม่ได้แค่ "สวย" แต่เปลี่ยนวิธีคิดของผู้สอนให้เป็นธรรมชาติมากขึ้น กลไกสำคัญ: จากมือมนุษย์ สู่เส้นทางหุ่นยนต์ หัวใจของ…
Read More
Remaining Useful Life (RUL): คำถามสุดท้ายของ Predictive Maintenance ที่โมเดลใหญ่ตอบไม่ได้

Remaining Useful Life (RUL): คำถามสุดท้ายของ Predictive Maintenance ที่โมเดลใหญ่ตอบไม่ได้

Article
คำถามที่ยากที่สุดของ Predictive Maintenance ไม่ใช่ "เสียหรือยัง" แต่คือ "เหลือเวลาอีกนานเท่าไร" ตลอดหลายปีที่ผ่านมา Predictive Maintenance ในโรงงานส่วนใหญ่หยุดอยู่ที่คำถามแรก: เครื่องจักรตัวนี้ "ผิดปกติหรือไม่" — ซึ่ง Anomaly Detection ตอบได้ค่อนข้างดีแล้ว แต่คำถามที่มีผลต่อการวางแผนจริงๆ คือคำถามที่สอง: "ควรจัดซ่อมเมื่อไร" จัดเร็วเกินไปเสียโอกาสใช้งานชิ้นส่วนเต็มอายุ จัดช้าเกินไปก็กลายเป็น downtime ที่วางแผนไม่ได้ คำตอบของคำถามนี้มีชื่อเฉพาะในวงการวิศวกรรมความน่าเชื่อถือ: Remaining Useful Life (RUL) หรืออายุการใช้งานที่เหลืออยู่ RUL คือหัวใจของสาขา Prognostics and Health Management (PHM) ซึ่งเป็นขั้นสูงสุดของการบำรุงรักษาเชิงพยากรณ์ — ขณะที่ diagnostics บอกว่า "เกิดอะไรขึ้น" prognostics บอกว่า "จะไปต่ออีกนานแค่ไหน" ความต่างนี้คือความต่างระหว่างการรู้ว่าแบริ่งเริ่มมีรอย กับการรู้ว่าแบริ่งนั้นจะทนได้อีก 12 วันหรือ 12 ชั่วโมง ซึ่งนำไปสู่การตัดสินใจที่ต่างกันโดยสิ้นเชิง เครื่องยนต์เทอร์โบแฟน — กลุ่มเครื่องจักรที่งานวิจัย RUL ทำมากที่สุด เพราะความเสียหายระหว่างการใช้งานรุนแรงเกินจะรอให้เกิดขึ้น (ภาพ: Wikimedia Commons) จุดเปลี่ยน 2026: เมื่อ benchmark กลับหน้าไม่เป็นที่คาด เดือนเมษายน 2026 มีงานวิจัยเปรียบเทียบเทคนิค RUL ตีพิมพ์บน arXiv (Goel et al., 2026) ที่ให้ผลลัพธ์ "สะเทือนวงการ" ไม่ใช่เพราะตัวเลขสวย แต่เพราะมันตอกย้ำบทเรียนที่วิศวกรสาย reliability สงสัยกันมานาน งานวิจัยนี้ทดสอบบนชุดข้อมูลมาตรฐาน NASA C-MAPSS turbofan ซึ่งเป็น benchmark ที่ใช้กันทั่วโลกมาเกือบ 20 ปี โดยเปรียบเทียบ 3 ตระกูลวิธีบน subset FD001 และ FD003 ภายใต้ preprocessing เดียวกัน: โมเดล ตระกูล RMSE (FD001) RMSE (FD003) Ridge RegressionClassical (raw features)—— LSTM single-layer (Goel et al. 2026)Deep Learning14.9314.20 Deep LSTM (Zheng et al.)Deep Learning16.1416.18 1D CNNDeep Learning16.9715.68 XGBoostClassical…
Read More
Airborne Ultrasound Inspection: ตรวจจับรอยโรคเครื่องจักรด้วยคลื่นเสียงความถี่สูงก่อนใครจะรู้ตัว

Airborne Ultrasound Inspection: ตรวจจับรอยโรคเครื่องจักรด้วยคลื่นเสียงความถี่สูงก่อนใครจะรู้ตัว

Article
ทำไมคลื่นเสียงความถี่สูงถึงเป็น "สัญญาณเตือนภัยล่วงหน้า" ที่โรงงานมักมองข้าม ในโลกของ Predictive Maintenance หลายคนนึกถึง Vibration Analysis และ Infrared Thermography เป็นอันดับแรก แต่มีเทคโนโลยีหนึ่งที่ถูกใช้งานในโรงงานอุตสาหกรรมมานานกว่า 40 ปี กลับถูกใช้ต่ำกว่าศักยภาพจริงอย่างมาก นั่นคือ Airborne Ultrasound Inspection หรือการตรวจวัดคลื่นเสียงความถี่สูง หลักการทำงานเรียบง่ายแต่ทรงพลัง: ทุกปรากฏการณ์ที่เกิดขึ้นก่อนการเสียหายของเครื่องจักร — ไม่ว่าจะเป็น แรงเสียดทาน (friction), ความปั่นป่วนของก๊าซ (turbulence), การกระแทก (impact) หรือ ปรากฏการณ์ไฟฟ้าผิดปกติ — ล้วนปล่อยพลังงานคลื่นเสียงความถี่สูงออกมาในช่วง 20 kHz ขึ้นไป ซึ่งหูมนุษย์ได้ยินไม่ได้ แต่เซ็นเซอร์อัลตร้าโซนิกได้ยิน "ชัดเจน" ระบบแอร์คอมเพรสเซอร์แบบโรตารีสกรูในโรงงาน — จุดที่ระบบอัลตร้าโซนิกล็อกหาจุดรั่วได้เร็วที่สุด เพราะการรั่วของอากาศอัดเกิด "ความปั่นป่วน" ที่ปล่อยคลื่นเสียง 20-100 kHz ออกมา (ภาพ: Wikimedia Commons / public domain) จุดเด่นที่ทำให้อัลตร้าโซนิกแตกต่างจากเทคโนโลยี PdM อื่นคือ ความไวในระยะเริ่มต้นของความเสียหาย หลาย failure mode ปล่อยพลังงานอัลตร้าโซนิกออกมา ก่อนที่ระดับการสั่นสะเทือนจะเพิ่มขึ้น หรือก่อนที่อุณหภูมิพื้นผิวจะร้อนจนมองเห็นด้วยกล้อง Thermography ทำให้เป็นเทคโนโลยี early warning ที่แท้จริง เทคโนโลยี PdM หลักเปรียบเทียบกันแบบมืออาชีพ เทคโนโลยี สัญญาณที่ตรวจจับ จุดแข็ง ข้อจำกัด Ultrasoundคลื่นเสียง 20-100 kHzตรวจจับได้เร็วที่สุดในระยะเริ่มต้น, หาจุดรั่วแม่นยำ, ทำงานขณะเดินเครื่องบอกตำแหน่งเก่งกว่าบอกความรุนแรง Vibrationการสั่นสะเทือน 0-20 kHzวิเคราะห์ failure mode เชิงลึกได้ ( imbalance, misalignment, bearing defect )ต้องติดตั้งเซ็นเซอร์, ต้องมีข้อมูลเชิงลึก Thermographyอุณหภูมิผิว -20 ถึง 1,500°Cเห็นภาพรวมทั้งบริเวณ, non-contactพบปัญหาหลังความร้อนสะสมแล้ว ( ช้ากว่า ) Oil Analysisอนุภาคสึกหรอในน้ำมันยืนยันสาเหตุการสึกหรอได้ชัดเจนต้องเก็บตัวอย่างส่งแล็บ, ไม่ real-time จะเห็นได้ว่าไม่มีเทคโนโลยีใดชนะขาด แต่ Ultrasound โดดเด่นที่สุดในมิติของ ความเร็วในการตรวจจับ และ ความคุ้มค่า — การสำรวจอัลตร้าโซนิกไม่ต้องหยุดเครื่อง ไม่ต้องติดตั้งเซ็นเซอร์ถาวร และให้ผลตอบแทน (ROI) เร็วที่สุดในบรรดาเทคโนโลยี PdM ทั้งหมด จนหลายโรงงานใช้เป็น "จุดเริ่มต้น" ที่สร้างงบประมาณให้โปรแกรม PdM ทั้งหมด 5…
Read More
Case Study: เมื่อ Work Order เกิดเอง — เชื่อม IIoT Sensor เข้า CMMS เปลี่ยนซ่อมบำรุงแบบไหน

Case Study: เมื่อ Work Order เกิดเอง — เชื่อม IIoT Sensor เข้า CMMS เปลี่ยนซ่อมบำรุงแบบไหน

Article
ปัญหา: เมื่อ Work Order เกิดช้ากว่าความเสียหาย ลองนึกภาพโรงงานผลิตชิ้นส่วนแห่งหนึ่งที่มีเครื่องจักรหลักกว่า 120 เครื่อง ทีมซ่อมบำรุง 12 คน และระบบบันทึกงานซ่อม ( CMMS ) ที่ใช้มานานกว่าสิบปี ทุกอย่างดูเรียบร้อยบนกระดาษ — แต่ในความจริง กระบวนการซ่อมบำรุงยังคง "รอ" สามสิ่ง: รอช่างเดินตรวจ, รอคนกรอกใบสั่งงาน และรอผู้จัดการอนุมัติ ผลคือเหตุการณ์เสียหายเล็กๆ กลายเป็น downtime ใหญ่เพราะมาถึงหูทีมซ่อมช้าเกินไป ช่างเทคนิคกับเอกสารงานซ่อมหน้าเครื่องจักร — ขั้นตอน "กรอกใบสั่งงาน" ที่ดูเล็กน้อยคือคอขวดที่แท้จริงของการซ่อมบำรุงสมัยใหม่ (ภาพ: Wikimedia Commons / U.S. Air Force, public domain) สิ่งที่เกิดขึ้นที่โรงงานแห่งนี้สะท้อนภาพอุตสาหกรรมกว้างๆ ตามข้อมูลจากการวิเคราะห์ของผู้ให้บริการแพลตฟอร์ม IIoT ปี 2025: การบริหารซ่อมบำรุงแบบดั้งเดิมที่พึ่งการตรวจด้วยตนเอง การซ่อมเมื่อเสีย และตารางซ่อมตามปฏิทิน นำไปสู่ downtime ที่หลีกเลี่ยงได้และต้นทุนสูงเกินจำเป็น ขณะที่การซ่อมบำรุงเชิงพยากรณ์ ( Predictive Maintenance ) ที่ขับเคลื่อนด้วย IoT ช่วยลดต้นทุนซ่อมบำรุงได้ถึง 30% และขจัดการเสียหายกระจาย ( breakdown ) ได้ 70-75% ทางออก: ต่อเซ็นเซอร์เข้ากับ CMMS ให้ Work Order "เกิดเอง" หัวใจของการแก้ปัญหาไม่ใช่การซื้อเซ็นเซอร์เพิ่ม แต่คือการ เชื่อมช่องว่างระหว่างโลกของข้อมูลกับโลกของการปฏิบัติงาน สถาปัตยกรรมที่ใช้แก้ปัญหามี 5 ขั้นตอน ซึ่งล้วนทำงานอัตโนมัติตั้งแต่ขั้นที่ 1 ถึง 4: เซ็นเซอร์เก็บข้อมูล — เซ็นเซอร์ไร้สาย ( vibration, temperature, pressure, humidity ) ตรวจวัดสภาพเครื่องจักรต่อเนื่อง ส่งข้อมูลขึ้นแพลตฟอร์ม — ค่าที่วัดได้ส่งตรงสู่ระบบ CMMS แบบ real-time ผ่านเกตเวย์ IIoT แจ้งเตือนและสร้าง Work Order อัตโนมัติ — เมื่อค่าใดๆ เกินเกณฑ์ที่กำหนด ระบบสร้างใบสั่งงานทันทีโดยไม่ต้องมีคนกรอก ทีมซ่อมรับมือ — ช่างได้รับแจ้งเตือนแบบ real-time ลดเวลาตอบสนองลงอย่างมีนัยสำคัญ ข้อมูลสะสมเป็นฐานของ AI — ข้อมูลย้อนหลังถูก Machine Learning วิเคราะห์หาแนวโน้ม กลายเป็น Predictive Maintenance ที่แท้จริง เซ็นเซอร์วัดการสั่นสะเทือนไร้สายที่ติดตั้งกับเครื่องจักร —…
Read More
Hybrid Twin: เมื่อ Physics-based Model จับมือ Machine Learning เพื่อโมเดลที่แม่นและทนทานกว่า

Hybrid Twin: เมื่อ Physics-based Model จับมือ Machine Learning เพื่อโมเดลที่แม่นและทนทานกว่า

Article
ในโครงการทำ Predictive Twin หลายโครงการที่เราเห็นล้มเหลว มีจุดตายตรงกันคือเลือกใช้ Machine Learning เพียงอย่างเดียว โมเดลทำนายแม่นยำในช่วงทดสอบ แต่พอเครื่องจักรเปลี่ยนสภาวะทำงาน ความแม่นยำก็ไถลลงจนใช้งานจริงไม่ได้ ในทางกลับกัน โมเดลฟิสิกส์ที่แม่นยำสุดๆ ก็มีข้อจำกัดเรื่องเวลาคำนวณและต้นทุนการสร้าง คำตอบที่งานวิจัยอุตสาหกรรมหันไปใช้กันมากขึ้นคือ Hybrid Twin — การผสานจุดแข็งของสองโลกเข้าไว้ในโมเดลเดียว ปัญหา: ทำไมโมเดลชนิดเดียวไม่พอ ลองนึกภาพการทำนายอุณหภูมิแบริ่งของมอเตอร์ไฟฟ้าขนาดใหญ่ วิธีฟิสิกส์ (Physics-based) คือสร้างโมเดลความร้อนและการสั่นสะเทือนจากสมการถ่ายเทความร้อนและพลศาสตร์ วิธีนี้เชื่อถือได้สูงเมื่ออยู่ในเงื่อนไขที่โมเดลออกแบบมา วิศวกรอธิบายได้ว่าทำไมค่าทำนายเป็นเช่นนั้น แต่การสร้างโมเดล FEA หรือ CFD ที่ละเอียดขึ้น มัคช์กับเครื่องจักรจริง ต้องใช้เวลาคำนวณนานและทรัพยากรจำนวนมาก ที่สำคัญข้อผิดพลาดเล็กๆ ในค่าสัมประสิทธิ์ เช่น สัมประสิทธิ์การนำความร้อนของวัสดุ สะสมกันเป็นความคลาดเคลื่อนของผลลัพธ์ ส่วนวิธีข้อมูล (Data-driven) อย่าง Deep Learning เรียนรู้จากข้อมูลเซ็นเซอร์จริงหลายหมื่นจุด ทำนายได้เร็วและแม่นในสภาวะที่เคยเห็น แต่โมเดลไม่เข้าใจกลไกเบื้องหลัง เมื่อเจอสภาวะใหม่ที่ไม่เคยมีในชุดข้อมูลฝึก เช่น เปลี่ยนวัตถุดิบ เปลี่ยนอัตราการผลิต หรือแว่วเสียงแปลกประหลาด โมเดลก็เดาผิดได้อย่างมั่นใจ งานวิจัยที่ตีพิมพ์ในวารสาร Procedia CIRP ปี 2022 เรียกปัญหานี้ว่าช่องว่างระหว่างสองกระบวนทัศน์ และเสนอว่าการผสานกันคือทางออกที่ยั่งยืนกว่า การจำลองทางฟิสิกส์อย่าง crash-test simulation แม่นยำแต่ต้องแลกกับเวลาคำนวณ — ที่มา: Wikimedia Commons (CC BY-SA) แนวทางแก้: โครงสร้างของ Hybrid Twin หลักคิดของ Hybrid Twin มีสามชั้นต่อกัน ชั้นแรกคือโมเดลฟิสิกส์แบบลดทอน (Reduced-order Model) ที่ย่อส่วนจากโมเดล FEA/CFD เต็มรูปแบบให้คำนวณได้เร็วขึ้นหลายเท่าตัว โดยยอมรับความคลาดเคลื่อนเล็กน้อย ชั้นที่สองคือโมเดลแทรกแซง (Correction Model) ที่เป็น Machine Learning หน้าที่เดียวคือเรียนรู้ "ส่วนต่าง" ระหว่างค่าทำนายของโมเดลฟิสิกส์กับค่าจริงจากเซ็นเซอร์ และชั้นที่สามคือวงจรสอบเทียบอัตโนมัติที่อัปเดตโมเดลแทรกแซงอย่างต่อเนื่องเมื่อข้อมูลใหม่ไหลเข้ามา โครงสร้าง Hybrid Twin: โมเดลฟิสิกส์ให้ความเข้าใจกลไก ML ชดเชยส่วนต่างจากข้อมูลจริง — ภาพวาดโดยทีม Honey Corporation ผลลัพธ์ที่ได้คือระบบที่ทำนายเร็วเท่า Machine Learning แต่ยังคงความน่าเชื่อถือนอกเงื่อนไขที่เคยเห็น เพราะเมื่อสภาวะเปลี่ยน โมเดลฟิสิกส์ยังจับพฤติกรรมหลักได้ ส่วน ML แค่ปรับค่าชดเชย แนวทางนี้ถูกนำไปใช้จริงในงานวิจัยระดับสากล เช่น โครงการ Horizon Europe ที่ใช้แนวคิด hybrid modeling ผสาน Digital Twin กับการผลิตจริง และงานวิจัยในวารสาร Journal of Engineering…
Read More
Asset Administration Shell (AAS): บัตรประจำตัวดิจิทัลมาตรฐาน IEC 63278 ของทุกสินทรัพย์ในโรงงาน

Asset Administration Shell (AAS): บัตรประจำตัวดิจิทัลมาตรฐาน IEC 63278 ของทุกสินทรัพย์ในโรงงาน

Article
ถ้าถามว่าอะไรคือคอขวดที่แท้จริงของ Digital Twin ในปี 2026 คำตอบไม่ใช่การสร้างโมเดลสามมิติสวยงาม แต่คือการทำให้ข้อมูลของเครื่องจักรจากผู้ผลิตหลายสิบราย เข้าใจกันได้โดยไม่ต้องแปลเป็นภาษากลางทีละคู่ โจทย์นี้คือที่มาของ Asset Administration Shell หรือ AAS มาตรฐานที่ถูกขนานนามว่า "บัตรประจำตัวดิจิทัลมาตรฐานของทุกสินทรัพย์" ในขบวนการ Industrie 4.0 ของยุโรป AAS ถูกพัฒนาต่อยอดเป็นมาตรฐานสากล IEC 63278 ดูแลโดย Industrial Digital Twin Association (IDTA) ซึ่งมีสมาชิกรวมทั้งผู้ผลิตเครื่องจักรอุตสาหกรรมและผู้ให้บริการซอฟต์แวร์รายใหญ่ทั่วโลก แนวคิดหลักเรียบง่าย: ทุกสินทรัพย์ ไม่ว่าเครื่องจักร เซ็นเซอร์ ซอฟต์แวร์ หรือทั้งโรงงาน ควรมี "เปลือก" (Shell) ดิจิทัลที่อธิบายตัวเองด้วยโครงสร้างเดียวกัน ทำให้ระบบใดก็ตามอ่านความสามารถและข้อมูลของสินทรัพย์นั้นได้ทันที โดยไม่ต้องรู้จักผู้ผลิตเป็นการส่วนตัว โครงสร้าง AAS: สินทรัพย์จริงหนึ่งชิ้นมี Submodels มาตรฐานหลายด้าน — ภาพวาดโดยทีม Honey Corporation Submodels: หัวใจของความเข้ากันได้ ความแข็งแรงของ AAS อยู่ที่ระบบ Submodels ที่แบ่งข้อมูลของสินทรัพย์ออกเป็นมุมมองเฉพาะด้าน แต่ละ Submodel มีเทมเพลตมาตรฐานที่ IDTA เผยแพร่และดูแล ตัวอย่างเช่น Nameplate เก็บข้อมูลผู้ผลิตและหมายเลขซีเรียล, Technical Data เก็บสเปกการทำงาน, Documentation เก็บคู่มือและแบบ CAD, Handover Documentation เก็บเอกสารส่งมอบโรงงาน, Time Series Data เก็บค่าเซ็นเซอร์ย้อนหลัง และ Carbon Footprint เก็บข้อมูลคาร์บอนที่สำคัญขึ้นเรื่อยๆ ตามกระแส ESG การที่โครงสร้างพวกนี้เป็นมาตรฐานเปิดหมายความว่า ระบบ CMMS, MES, หรือแพลตฟอร์ม Digital Twin จากค่ายใดก็อ่านข้อมูลได้เหมือนกัน การเปลี่ยนผู้ให้บริการซอฟต์แวร์จึงไม่ได้แปลว่าต้องเสียข้อมูลไปทั้งกอง นี่คือสิ่งที่ต่างจาก data sheet แบบ PDF ที่มนุษย์อ่านอย่างเดียว เพราะ AAS ออกแบบมาเพื่อให้เครื่องอ่านเครื่องโดยตรง รองรับทั้งรูปแบบ JSON, XML, RDF และไฟล์แพ็กเกจ AASX ที่รวมไบนารีประกอบ เทคโนโลยีเดิมที่คุ้นเคย ยังใช้ได้ทั้งหมด จุดที่ทำให้ AAS ลงมือทำได้จริงคือมันไม่ได้มาแทนที่โปรโตคอลที่โรงงานใช้อยู่ แต่ทำงานร่วมกับ OPC UA ผ่าน companion specification, MQTT สำหรับข้อมูลเซ็นเซอร์แบบเบา และ REST API ตามสเปก OpenAPI สำหรับระบบคลาวด์…
Read More
ISO 23247: มาตรฐาน Digital Twin Framework ที่ทำให้โรงงานพูดภาษาเดียวกัน

ISO 23247: มาตรฐาน Digital Twin Framework ที่ทำให้โรงงานพูดภาษาเดียวกัน

Article
หลายโรงงานที่เริ่มต้นทำ Digital Twin มักเจอปัญหาเดียวกัน คือระบบที่ได้มา “ติด” กับผู้ให้บริการรายใดรายหนึ่งเต็มที่ ขยายไปเครื่องจักรตระกูลอื่นไม่ได้ เชื่อมกับระบบเดิมอย่าง MES หรือ ERP ต้องเขียน adapter ใหม่ทุกครั้ง สาเหตุลึกๆ ไม่ใช่เทคโนโลยี แต่เป็นการที่ยังไม่มี “ภาษากลาง” ในการจัดโครงสร้างดิจิทัลทวินร่วมกัน ซึ่งเป็นช่องว่างที่มาตรฐาน ISO 23247 ถูกออกแบบมาเติมให้ครบ ชุดมาตรฐาน ISO 23247 ชื่ออย่างเป็นทางการว่า “Automation systems and integration — Digital twin framework for manufacturing” เผยแพร่ครั้งแรกในปี 2021 ครอบคลุมตั้งแต่แนวคิดภาพรวม สถาปัตยกรรมอ้างอิง การแทนค่าข้อมูล ไปจนถึงการแลกเปลี่ยนข้อมูลระหว่างเอนทิตี้ จุดเด่นที่ทำให้มันต่างจากเอกสารแนวคิดทั่วไปคือ มาตรฐานนี้ไม่ได้บอกแค่ว่า Digital Twin คืออะไร แต่กำหนดโครงสร้างอ้างอิงที่แบ่งระบบออกเป็นชั้นทำงานชัดเจน พร้อมชื่อเรียก ขอบเขต และหน้าที่ของแต่ละส่วน ทำให้ทีมงานจากคนละองค์กรนั่งโต๊ะเดียวกันแล้วเข้าใจกันได้ทันที รากฐานมาจากสถาปัตยกรรม IoT ระดับสากล สิ่งที่น่าสนใจสำหรับผู้ที่ทำงานด้าน IIoT คือ ISO 23247 ไม่ได้คิดโครงสร้างขึ้นมาใหม่จากศูนย์ แต่ยืมพื้นฐานจากสถาปัตยกรรมอ้างอิง IoT อย่าง ISO/IEC 30141 แล้วปรับแต่ง functional entities ให้เหมาะกับบริบทการผลิต หมายความว่าถ้าโรงงานของคุณมีระบบเก็บข้อมูลเครื่องจักรผ่าน OPC UA หรือ MQTT อยู่แล้ว คุณมีวัตถุดิบชั้นที่สองของมาตรฐานนี้พร้อมใช้แล้วโดยไม่ต้องเริ่มใหม่ แนวคิดพื้นฐาน: ความต่างระหว่าง Digital Model (ไม่มีการไหลของข้อมูลอัตโนมัติ), Digital Shadow (ไหลทางเดียว) และ Digital Twin (ไหลสองทาง) — ที่มา: Wikimedia Commons (สาธารณะ) สถาปัตยกรรมอ้างอิง 4 ชั้น ที่หัวใจของ ISO 23247 แกนกลางของมาตรฐานคือการแบ่งระบบ Digital Twin เพื่อการผลิตออกเป็น 4 ชั้น โดยแต่ละชั้นเป็น “Entity” ที่มีหน้าที่และความรับผิดชอบของตัวเอง และการสื่อสารข้ามชั้น (Cross-Entity Exchange) ถูกกำหนดไว้อย่างเป็นทางการ สถาปัตยกรรมอ้างอิง 4 ชั้นตาม ISO 23247 — ภาพวาดโดยทีม Honey Corporation ชั้นที่ 1: Observable Manufacturing Elements คือทุกสิ่งบนสายการผลิตที่ต้องการจะสร้างแฝดดิจิทัล…
Read More
MEC + Private 5G ในโรงงาน: บทวิเคราะห์ว่า Edge ของค่ายโทรคมนาคมคืออนาคตหรือแค่ Hype

MEC + Private 5G ในโรงงาน: บทวิเคราะห์ว่า Edge ของค่ายโทรคมนาคมคืออนาคตหรือแค่ Hype

Article
ในแวดวง Smart Factory ตอนนี้ แทบไม่มีงานสัมมนาไหนที่ไม่พูดถึง Multi-Access Edge Computing (MEC) — แนวคิดที่ ETSI กำหนดมาตรฐานไว้ เพื่อย้ายทรัพยากรคำนวณไปไว้ที่ "ขอบ" ของเครือข่ายโทรคมนาคม ใกล้ผู้ใช้และอุปกรณ์มากที่สุด คำถามที่ผู้บริหารโรงงานหลายท่านถามเราคือ "มันต่างจาก Edge Server ที่วางในโรงงานเองยังไง และคุ้มไหม" บทความนี้วิเคราะห์แบบตรงไปตรงมา จากมุมมองของผู้ติดตั้งระบบจริง MEC คืออะไร ในมุมของโรงงาน สถาปัตยกรรม MEC ตามมาตรฐาน ETSI แบ่งเป็น 2 ระดับหลัก คือ System Level ที่ทำหน้าที่ orchestrate และบริหารทรัพยากรทั้งหมด และ Server Level ที่เป็นที่รันแอปพลิเคชันจริง อยู่ใกล้ base station หรือจุดเข้าเครือข่าย จุดที่ทำให้ MEC พิเศษคือมันไม่ใช่แค่ "เซิร์ฟเวอร์ที่วางใกล้ ๆ" แต่มาพร้อมกลไกระดับมาตรฐาน เช่น การจัดการ service registry, DNS handling ที่ edge และ API สำหรับแอปให้เรียกดูสถานะเครือข่าย (เช่น ตรวจว่าอุปกรณ์ตัวนี้อยู่ cell ไหน) ซึ่งเปิด use case ที่เครือข่ายปกติทำไม่ได้ เมื่อ MEC จับคู่กับ Private 5G — เครือข่ายมือถือเฉพาะกิจที่โรงงานถือใบอนุญาตหรือใช้ spectrum ส่วนตัว — ผลลัพธ์คือโรงงานได้ทั้งการเชื่อมต่อไร้สายที่ทั้งเร็วและคาดเดาได้ (deterministic) และแหล่งคำนวณที่อยู่ใกล้มากจน latency เหลือระดับมิลลิวินาทีหลักเดียว การติดตั้งเสาอากาศของระบบเครือข่าย 5G — จุดเริ่มต้นของการนำ MEC เข้าสู่พื้นที่โรงงาน (ภาพ: Wikimedia Commons, CC BY-SA 4.0) เส้นแบ่งสำคัญ: MEC กับ Edge Server ในโรงงาน มิติ Edge Server ในโรงงาน (On-Prem) MEC บน Private 5G ความเป็นเจ้าของโรงงานถือฮาร์ดแวร์และดูแลเองทั้งหมดอาจเป็นของผู้ให้บริการเครือข่ายหรือเป็นของโรงงาน แล้วแต่โมเดล ความครอบคลุมจำกัดที่พื้นที่มีสาย LAN/Wi-Fiครอบคลุมทั้งโรงงานผ่านคลื่นวิทยุ รวมพื้นที่ที่เดินสายยาก การเคลื่อนที่อุปกรณ์ต้องนิ่ง หรือใช้ Wi-Fi roaming ที่มักกระตุกรองรับ mobility จริง เหมาะกับ AGV/AMR…
Read More
Fog Computing ในโรงงานอุตสาหกรรม: ชั้นคำนวณแบบหลายชั้น (Multi-tier) ที่ต่างจาก Edge Computing อย่างไร

Fog Computing ในโรงงานอุตสาหกรรม: ชั้นคำนวณแบบหลายชั้น (Multi-tier) ที่ต่างจาก Edge Computing อย่างไร

Article
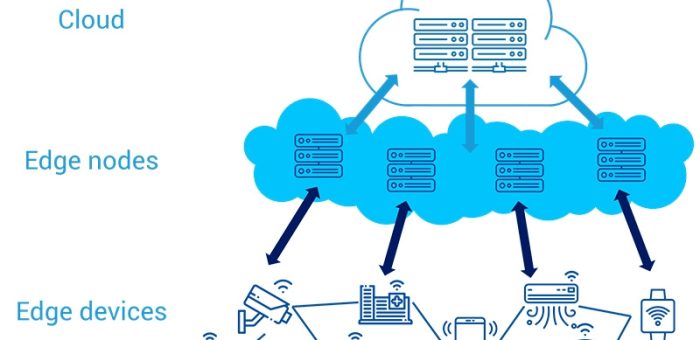
หลายโรงงานที่เริ่มทำ IIoT มักเจอคำถามเดียวกัน คือ "เราควรวิเคราะห์ข้อมูลที่ Edge หรือส่งขึ้น Cloud ดี" คำตอบที่งานวิจัยและการใช้งานจริงชี้ตรงกันคือ ไม่ต้องเลือกอย่างใดอย่างหนึ่ง เพราะระบบ IIoT สมัยใหม่ควรเป็นสถาปัตยกรรมแบบหลายชั้น (Multi-tier) ที่เรียกชั้นกลางระหว่างเครื่องจักรกับคลาวด์ว่า Fog Computing — ชั้นคำนวณที่กระจายอยู่ตามโหนดเกตเวย์และเซิร์ฟเวอร์ระดับโรงงาน ก่อนข้อมูลจะไหลขึ้นสู่คลาวด์จริง บทความนี้เจาะลึกว่า Fog Computing ทำงานอย่างไร ต่างจาก Edge Computing ตรงไหน และโรงงานควรออกแบบชั้น Fog อย่างไรให้คุ้มค่ากับการลงทุน หลักการทำงานของ Fog Computing แนวคิด Fog Computing เกิดจากข้อจำกัดของ Cloud Computing แบบศูนย์กลาง คือ หากส่งข้อมูลดิบจากเซ็นเซอร์ทุกตัวขึ้นคลาวด์ แบนด์วิดธ์และค่า latency จะบานปลายทันทีเมื่อจำนวนอุปกรณ์เพิ่มขึ้นเป็นพันเป็นหมื่นตัว Fog Computing จึงแทรก "ชั้นหมอก" ของทรัพยากรคำนวณลงไประหว่างอุปกรณ์ปลายทางกับคลาวด์ ทำหน้าที่ 3 อย่างหลักคือ รวบรวมและกรองข้อมูล (Aggregation) — รับข้อมูลจากหลาย ๆ Edge Device ในโซนเดียวกัน บีบอัด ลดความถี่ และส่งเฉพาะข้อมูลที่มีค่าขึ้นคลาวด์ ประสานงานระหว่างโหนด (Orchestration) — จัดสรรงานคำนวณให้เหมาะกับทรัพยากรของแต่ละโหนดในโรงงาน ทำหน้าที่เป็นสะพาน (Bridge) — แปลงโปรโตคอลจาก Modbus TCP, OPC UA ให้เป็น MQTT หรือ REST API ก่อนส่งออกสู่ภายนอก สถาปัตยกรรม Fog Computing: ชั้นหมอกของโหนดคำนวณ (Fog Nodes) ทำหน้าที่รวบรวมและกรองข้อมูลจากอุปกรณ์ก่อนส่งขึ้นคลาวด์ (ภาพ: Wikimedia Commons, CC BY 4.0) Fog vs Edge vs Cloud — ตารางเปรียบเทียบ ประเด็น Edge Computing Fog Computing Cloud Computing ตำแหน่งบนหรือใกล้เครื่องจักรโดยตรงโหนดกลางระหว่าง Edge กับ Cloudดาต้าเซ็นเตอร์ภายนอก Latencyต่ำสุด (ระดับมิลลิวินาที)ต่ำ แต่สูงกว่า Edgeสูง (อาจถึงหลายสิบมิลลิวินาที) การประมวลผลข้อมูลเรียลไทม์บนเครื่องรวมกรองข้อมูลหลาย Edge ก่อนส่งต่อการวิเคราะห์เชิงลึกและเก็บถาวร ขนาดระบบระดับเครื่อง/เซลล์เดียวระดับโรงงาน/หลายไลน์ผลิตระดับองค์กร/หลายสาขา กรณีใช้งานPredictive Maintenance, Machine Vision, ควบคุมเรียลไทม์เชื่อมหลายไลน์, จัดการข้อมูลหลายไซต์,…
Read More
วิธีวาง Kubernetes สำหรับ Edge Computing ในโรงงาน: คู่มือเลือก Lightweight K8s แบบ Step-by-Step

วิธีวาง Kubernetes สำหรับ Edge Computing ในโรงงาน: คู่มือเลือก Lightweight K8s แบบ Step-by-Step

Article
ถ้าคุณกำลังวางแผนรันแอปพลิเคชัน IIoT บนเครื่อง Edge Gateway ในโรงงาน คำถามที่เจอตั้งแต่วันแรกคือ "Kubernetes ตัวเต็มเลย หรือต้องใช้ Lightweight Distribution" — บทความนี้เป็นคู่มือแบบทีละขั้นตอน อิงข้อมูลจากคู่มือและเอกสารปี 2026 ล่าสุด ว่าควรเลือกอย่างไรและวางระบบอย่างไรให้รอดจากสภาพแวดล้อมจริงของโรงงาน ทำไม Kubernetes ตัวเต็มถึงไม่เหมาะกับ Edge Kubernetes ดั้งเดิมถูกออกแบบมาเพื่อดาต้าเซ็นเตอร์ที่มีเครือข่ายเสถียร หน่วยความจำเหลือเฟือ และ Control Plane ที่ออนไลน์ตลอดเวลา แต่เครื่อง Edge ในโรงงานคือสภาพตรงข้ามทุกข้อ — อินเทอร์เน็ตเป็น 4G ที่หลุดบ่อย, เครื่องเป็นกล่อง fanless RAM 512 MB ถึง 2 GB และบางครั้งออฟไลน์เป็นชั่วโมง Lightweight Distribution จึงเกิดขึ้นเพื่อ "ตัดของที่ Edge ไม่ใช้ออก" เช่น Legacy Storage Driver และ In-tree Cloud Provider เพื่อคืนหน่วยความจำให้แอปพลิเคชันโรงงาน ตัวเลขสำคัญที่ควรจำ: Lightweight Distribution ยอดนิยมตัวหนึ่งสามารถบรรจุ Control Plane และ Kubelet ทั้งหมดไว้ใน binary เดียวขนาดไม่ถึง 100 MB รันได้บนอุปกรณ์ RAM 512 MB และใช้ SQLite เป็น datastore แทน etcd cluster ในโหมด single-node Step 1: ประเมินข้อจำกัดของเครื่อง Edge ก่อนเลือก ก่อนตัดสินใจ ให้เช็ค 4 ข้อจำกัดหลักของสถานการณ์คุณ: Footprint — เครื่อง Edge มี RAM เท่าไหร่ (512 MB–2 GB คือช่วงปกติ) และพื้นที่ดิสก์พอสำหรับ container images หลายเวอร์ชันหรือไม่ Offline Autonomy — ถ้า WAN หลุด 2 ชั่วโมง Pod ที่รันอยู่ต้องไม่ตาย และต้อง restart container ที่ crash ได้เองโดยไม่ต้องหา API Server Fleet Scale…
Read More